AI各种概念:从 LLM 到 Agent Skill
·
从 LLM 到 Agent Skill,一期视频带你打通底层逻辑!
内容是这个视频里的,文案是评论区里【霉菌爱思考】总结的,这里仅记录学习过程
概念体系层级关系
LM(核心引擎)→ Token(数据单元)→ Context(记忆空间)→ Prompt(交互接口)→ Tool(外部能力)→ MCP(工具标准)→ Agent(决策系统)→ Agent Skill(任务定制)
自我总结(不权威,仅自己的理解)
- LLM:大语言模型,相当于 AI 的大脑,只负责分析、理解与推理,不直接执行外部操作。本质是文字接龙,通过预测下一个概率最高的 token,生成连贯文本。所以模型的训练数据与质量很重要,直接决定它的能力上限。
- Transformer:是所有现代大语言模型的底层架构。最核心能力是 Self-Attention(自注意力机制),即可以理解句子中谁和谁相关、谁更重要,从而理解语义与逻辑。
- Token:LLM 处理文本的最小数据单元,类似前端里的 “字节”。
- Prompt:提示词,相当于给 LLM 的入参 + 指令,LLM 完全依据提示词来理解任务、分析信息并输出结果,提示词写得准确,输出才会精准、符合预期。
- Tool:工具,相当于 LLM 可调用的第三方接口 / 能力,比如查询天气、调用接口、读取数据、执行计算等。
- Skills:技能,封装好的通用能力,类似 Vue 插件或公共工具方法,可以让 Agent 重复使用某一类功能。
- Context:上下文,本次对话的全部历史 + 最新输入的总和,是模型当前能 “看到” 的所有信息。
- Context Window:上下文窗口,模型一次性最多能处理的 token 总量,超过这个长度,早期信息会被遗忘或截断。
- MCP:模型上下文协议,是LLM 与外部 Tool 之间的标准连接通道,让模型能安全、统一地调用各种工具。
一、底层引擎:大语言模型(LLM)
核心定义与架构
- LM全称:Large Language Model(大语言模型),简称大模型
- 底层架构:基于Transformer(2017年Google团队在论文《Attention is All You Need》中提出)
- 工作原理:本质是文字接龙游戏,通过预测下一个概率最高的词生成连续文本
二、数据处理单元:Token
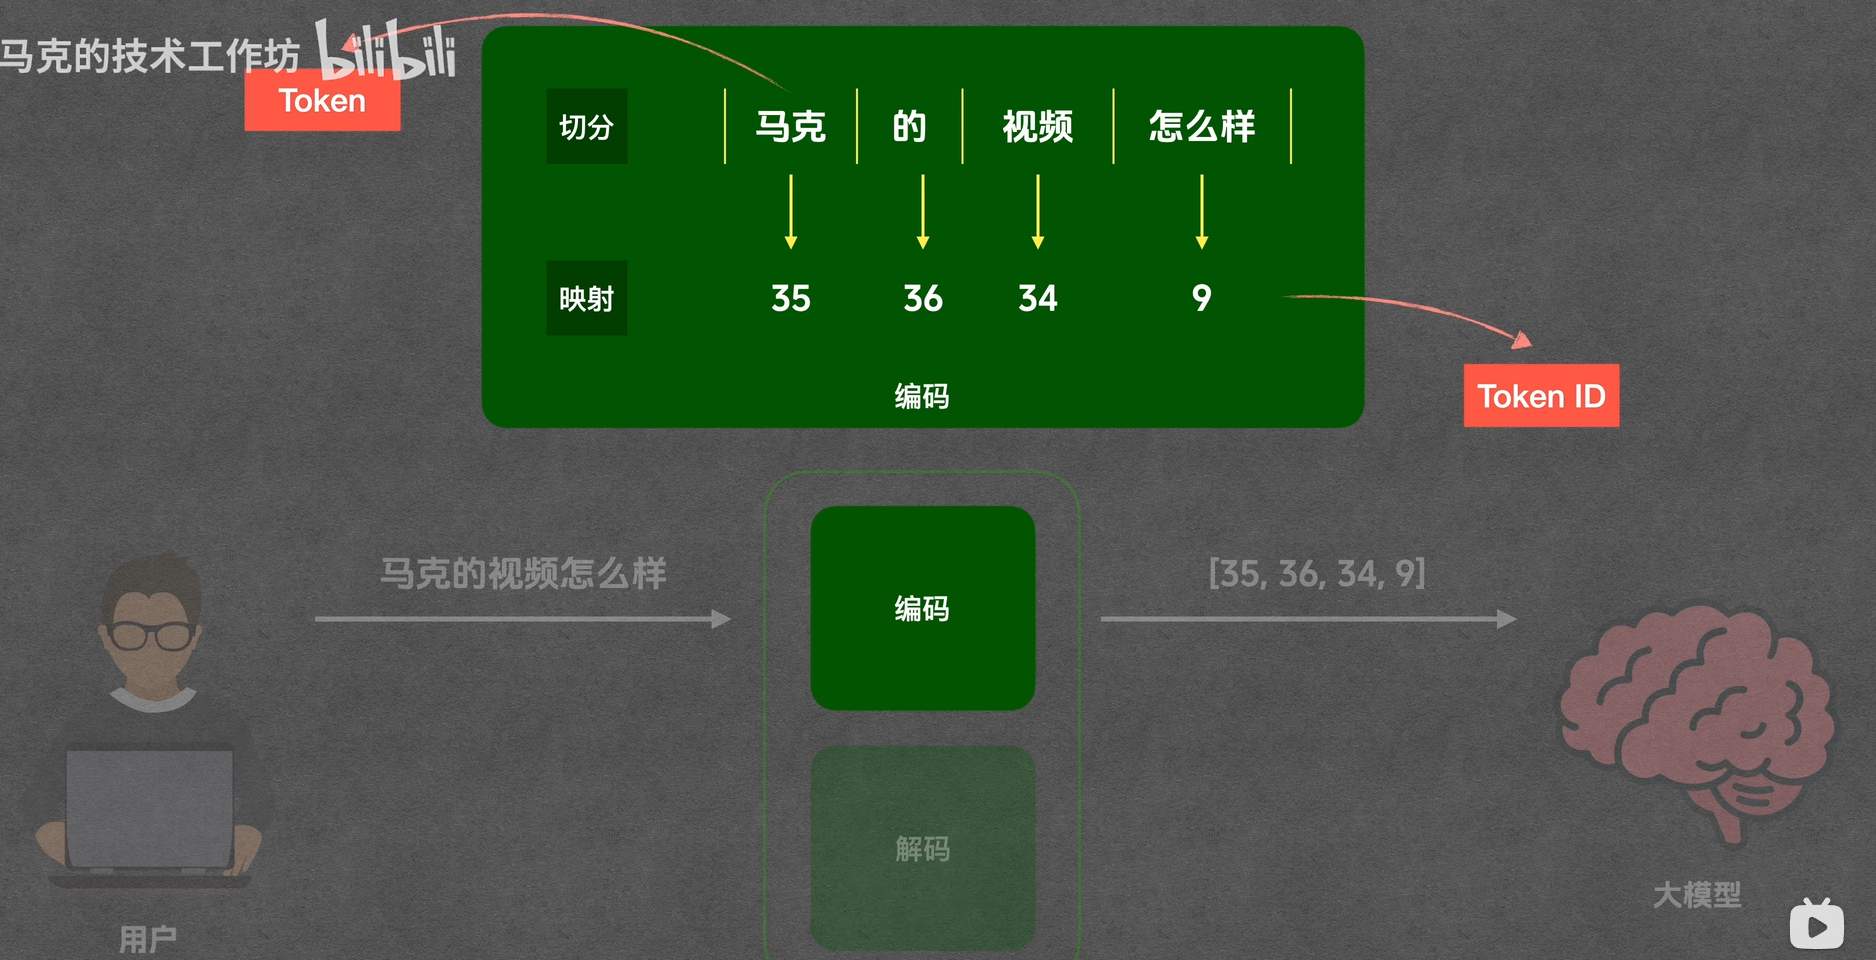
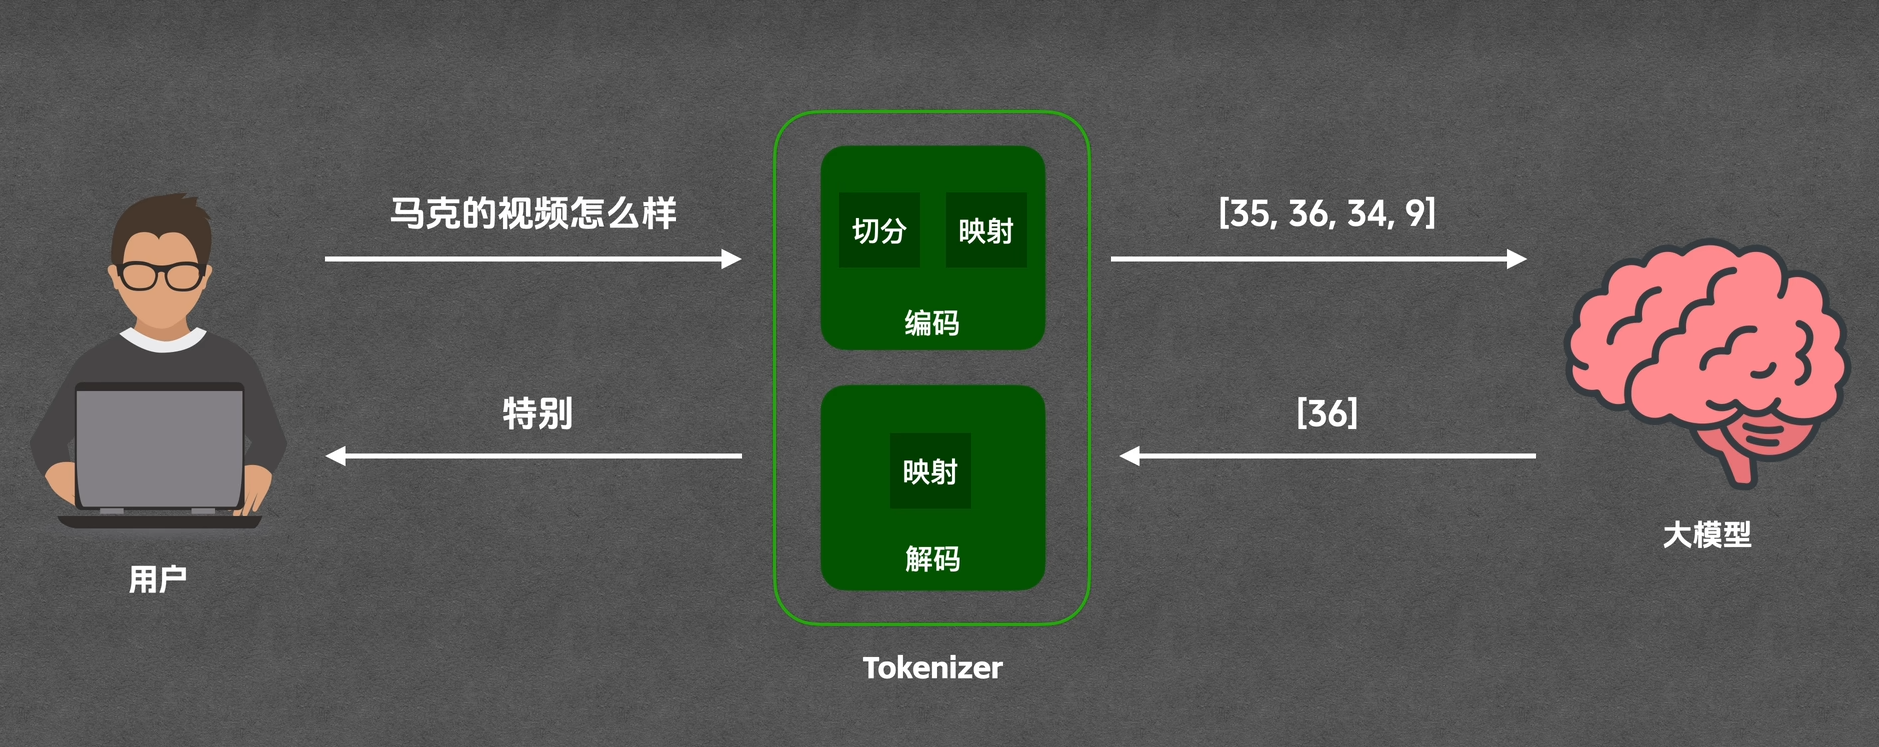
核心特性
- 定义:大模型处理文本的最小单位,通过Tokenizer(分词器)将文本切分为片段
- 编码过程:分两步——①文本切分为Token ②映射为Token ID(数字)
- 解码过程:将Token ID还原为文本(无需切分步骤)
Token与自然语言单位的关系
| 语言单位 | 与Token的关系 | 示例 |
|---|---|---|
| 中文词语 | 非一一对应,可能被拆分 | “工作坊”→“工作”+“坊” |
| 英文单词 | 常见词通常对应1个Token | “hello”→1个Token |
| 复杂单词 | 可能被拆分 | “helpful”→“help”+“ful” |
| 特殊字符 | 可能需多个Token表示 | “✅”→3个Token |
量化参考
- 1个Token ≈ 0.75个英文单词
- 1个Token ≈ 1.5-2个汉字
- 40万Token ≈ 60-80万汉字 或 30万英文单词
三、临时记忆体:Context
核心概念
- 定义:大模型每次处理任务时接收的信息总和(就是接连上面所有的对话的总和加上新的对话),相当于模型的“临时记忆”,
- 组成部分:用户问题、对话历史、当前输出Token、工具列表、System Prompt等
- 容量限制:由Context Window(上下文窗口)定义,即最大可处理的Token数量
突破Context Window限制的方案
- RAG技术(检索增强生成):从知识库中抽取与问题最相关的片段,仅将关键信息送入模型,降低Token消耗
四、指令交互:Prompt
定义与分类
- Prompt:给大模型的问题或指令,决定模型输出质量
- Prompt分类:
- User Prompt:用户输入的具体任务(如“帮我写一首诗”)
- System Prompt:开发者后台配置的人设与做事规则(如“你是一个耐心的数学老师,当学生问你数学问题时,不要直接给答案,而是要一步步引导学生思考,帮助他们理解解题的思路”)
五、外部能力扩展:Tool
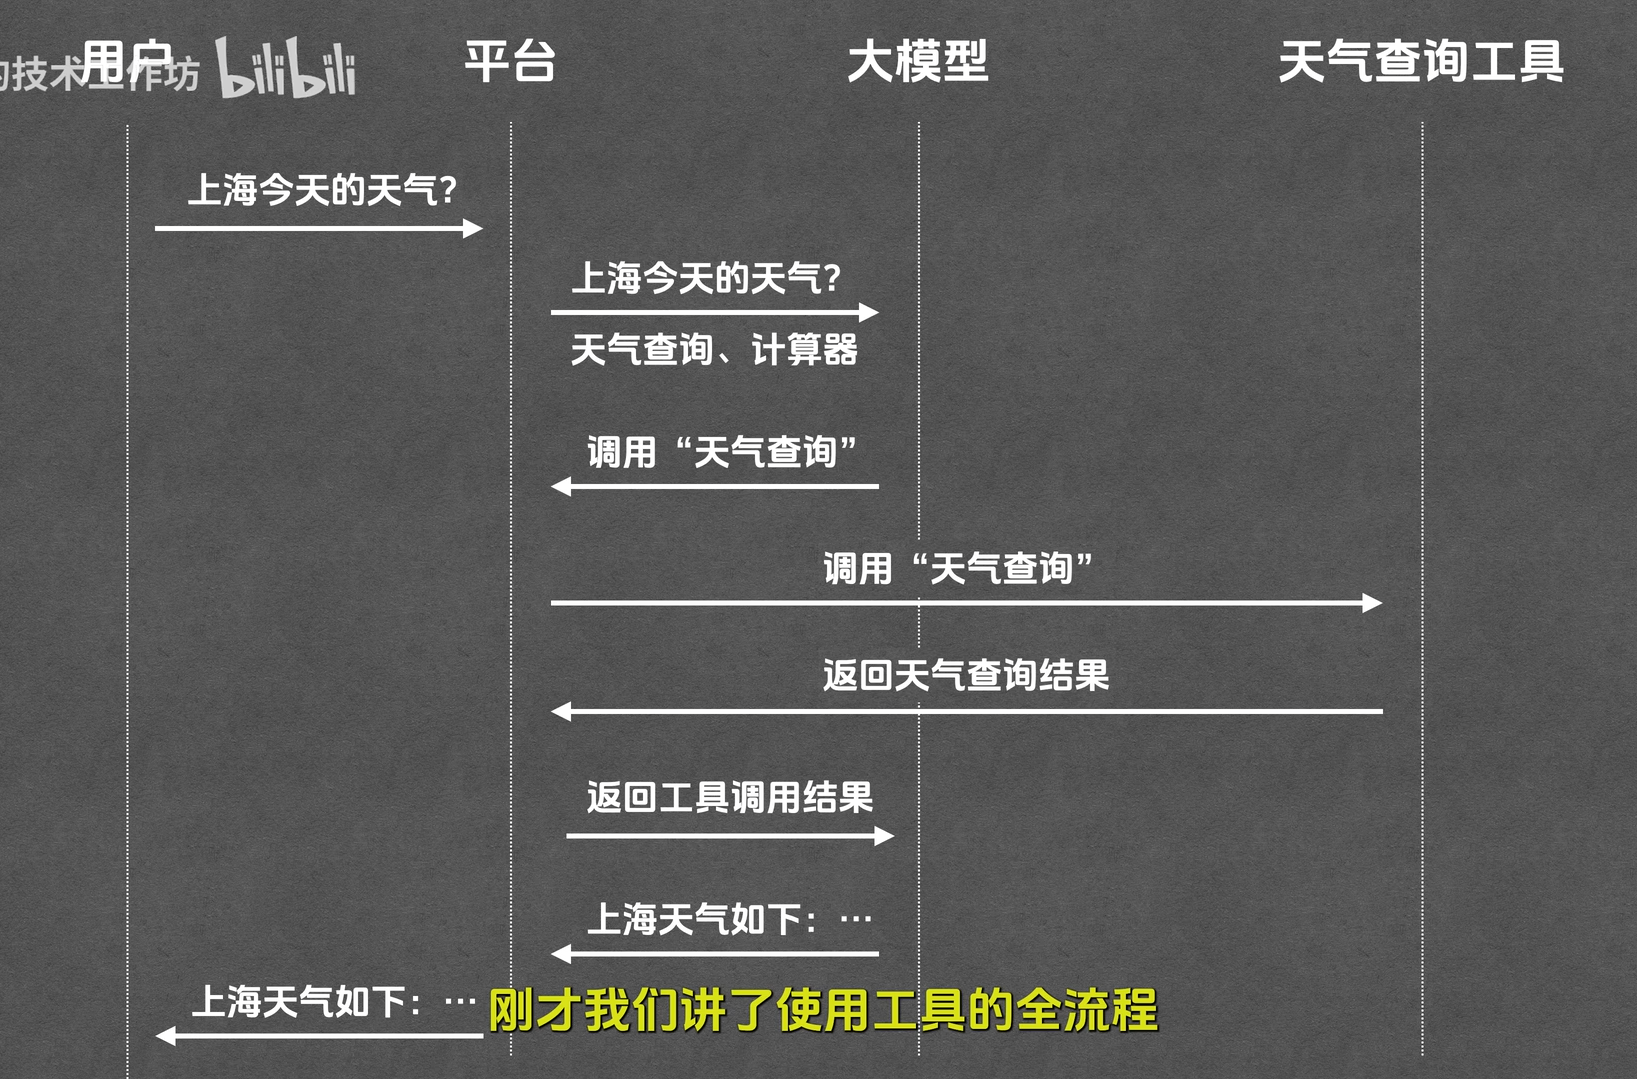
核心作用
- 定义:大模型调用的外部函数,使其能够感知和影响外部环境
- 解决痛点:弥补大模型无法获取实时信息(如天气)、计算能力有限等弱点
工作流程
- 用户提问→平台转发(含工具列表)
- 大模型分析→生成工具调用指令
- 平台执行调用→获取结果
- 大模型整理结果→自然语言输出
角色分工
| 角色 | 职责 |
|---|---|
| 大模型 | 选择工具、生成参数、归纳结果 |
| 工具 | 执行具体功能(如查询天气) |
| 平台 | 转发信息、执行工具调用 |
六、工具标准化:MCP
- 全称:Model Context Protocol(模型上下文协议)
- 本质:理解为统一的工具接入标准,解决不同平台工具接入规范不统一的问题
- 比如:openAI、Anthropic、Google三个平台各自有接入规范,用一个要写一个接入规范。所以想搞一个统一的技术规范标准
- 就像手机都统一用type c充电口统一标准
- 价值:工具开发者只需按MCP规范开发一次,即可在所有支持MCP的平台使用(类比手机Type-C接口)
七、自主决策系统:Agent
- Agent定义:能够自主规划、自主调用工具,持续工作直至完成用户任务的系统
- 核心能力:多步骤推理、工具选择、流程控制
- 代表产品:Claude Code、Codex、Gemini CLI等
- 典型构建模式:React、Plan and Execute等
八、任务定制:Agent Skill
核心功能
- 定义:给Agent的说明文档,包含任务规则、执行步骤、输出格式等
- 结构:
- 元数据层:名称(name)、描述(description)、示例
- 指令层:目标、执行步骤、判断规则、输出格式、示例
技术实现
- 存储形式:Markdown文档(文件名必须为
SKILL.md) - 存放位置:特定目录(如Claude Code找到用户目录的
claude/skills文件夹) - 加载机制:仅在用户问题与技能名称/描述相关时加载与整合指令
- 加载时机:仅在用户问题与技能名称/描述匹配时加载完整指令

AtomGit 是由开放原子开源基金会联合 CSDN 等生态伙伴共同推出的新一代开源与人工智能协作平台。平台坚持“开放、中立、公益”的理念,把代码托管、模型共享、数据集托管、智能体开发体验和算力服务整合在一起,为开发者提供从开发、训练到部署的一站式体验。
更多推荐

 9
 0
- 0


 已为社区贡献1条内容

所有评论(0)