程序员什么时候会被AI取代
程序员是否会被AI取代
程序员这个职业会被AI取代吗?自从AI展现出超强编码能力以来,这个问题就被业内翻来覆去不断讨论,AI发展过程中每一个新概念(其实就是新概念并不是新技术或者LLM模型底层能力的创新)的提出,都要被拿出来重新讨论一轮,比如Agent、Skills、OpenClaw等等。甚至,并非业内人士、对编程一窍不通的各路自媒体也会轮番发表意见,这类媒体要么为了赚流量、要么为了卖课,信誓旦旦、言之凿凿发表自己的观点。
我最近在朋友圈看到有不少从业多年的程序员朋友,在惊讶于“AI真的能写代码”的同时,也对程序员这个行业的前景深表担忧。我的惊讶在于,你为什么到现在才知道AI居然能写代码了,为什么知道的这么晚?
还有,有些自媒体,像张雪峰当初劝家长不要让自己的孩子学文科一样,在评论区回答用户的“还有必要让孩子学计算机和编程吗”这类问题下回复“个人认为没必要了”,脸大的或者不要脸的人真是太多了。
提前把结论放这儿,程序员这个职业绝对不会被AI取代。
你家孩子还有没有必要学编程,取决于他的兴趣志向,不取决于这个职业会不会被AI取代这个问题的答案。如果现在担心将来会被AI取代而没有人愿意学软件了,AI这个行业也会被干掉!将来如果中国人都不学了,会写代码的就都是老外,会训练AI的也都是老外,想想都觉得非常荒诞!
但是如果你换一个说法,就会成立,比如:某些程序员、或者某一类程序员、或者某几个程序员会不会被AI取代?这个问题就成立了,问题是有针对性的,所以答案也是有针对性的,不能一概而论。
举个简单的例子,我刚从业的时候(那是很久远的事情了…),刚毕业的小白叫初级程序员,在学校学了一些简单的概念,毕业以后也能轻松找到工作,他们会写CRUD代码而且也只会写CRUD而且写的也不好,但是市场上真有他们的岗位,真的需要他们,虽然工资低一点活脏点累点。
但是,早在AI出现之前这类岗位就已经被低代码、代码生成器(绝不是基于AI的,是基于规则的,写死的)全部代替了,注意是全部代替不是部分代替,当年的这个初级程序员岗位在5年前甚至更早一点就已经不存在了。
现在,AI来了,另外一类初级程序员一定会被代替。但是经验丰富愿意学习底层技术的程序员,永远不会被现在的AI代替。除非,AI在某一天真的会进化的更好更NB。
目前LLM的能力边界
现在但凡提到AI,在80%甚至90%的场景下大家说的都是LLM,有一小部分说的是多模态的模型,我们现在所说的是否会取代程序员的AI,其实也是指LLM,因为现在会写代码的AI其实就是LLM。
LLM进入大家的视野其实也就是2022年ChatGPT 2.0发布以后,在此之前一直都是行业内的人关注,行业之外的人几乎无人提及,不像现在,我老家农村老太太都开口闭口AI。
LLM直到2022年才爆发的主要原因是他的底层架构Transformer的论文是在2017年才由google的8人专家团队发表,在此之后,基于Transformer架构的大语言模型才在OpenAI的带领下(我指的是开始爆发,之后当然,我们肯定是遥遥领先,不可能被别人带领)逐步发展起来,2022年之后呈井喷之势,一发而不可收,才发展到今天这种势不可挡要横扫一切的势头。
但是个人认为基于Transformer的LLM的最大的在应用层的无法解决的问题就是他其实没有任何记忆能力,我说的在应用层的意思是他落地要解决一个具体的行业问题、而不是实验室做推理测试。就比如我们现在说的他要代替程序员的话,就是要在软件工程领域要落地解决需求分析、设计、编码、测试等一系列问题。这个时候他没有任何记忆就是硬伤------这个硬伤就是他的天花板。
插一段:目前AI这个词已经烂大街了,人尽知AI。不过了解LLM底层原理的毕竟少数,大模型就像是一个黑箱,魔术箱,大家都知道怎么用,都知道他在各方面都很NB,但是他为什么这么NB他底层到底是怎么工作的,很少有人知道。我们作为程序员应该是比其他行业最靠近内幕的职业,但是他太复杂了所以我们也不知道他的原理。老实说我当然也不知道、或者叫不是很理解他的底层原理,但是我知道一些皮毛,这些皮毛恰好能够解释很多问题,比如我们现在正在讨论的这个问题。所以我就把他写出来,尽可能写清楚,让尚且没有了解到这点皮毛的人读了之后也能有所了解,也能用这点皮毛去解释一些问题,总比跟风胡乱吹牛逼要好点吧?
如果你通过API调用大模型,比如你告诉大模型,我叫张三,我2020年清华大学人工智能专业博士毕业,现在创立了一家AI公司,很牛逼。然后转头再问他:我是谁?他是不可能知道的。你在同一个模型的官网或者通过他的APP问这个问题的话,大模型就能很好的回答。两者之间之所以有这个区别的原因是,官网或者APP做了上下文处理,他会在后台(注意,一定不是模型端,模型没有这个能力)存储你的最近的历史会话信息,每次你发起新问题的时候官网或者APP后台会根据一定的策略提取部分历史信息作为上下文一起发给模型,所以模型才能正确的回答这类问题。
作为一个记忆力不是很好的普通人,你应该都能记得起绝大部分跟你来往相对密切的朋友最近5年甚至更久远的对话记录,所以你才能认识你的老朋友。但是LLM不可能,大模型根据上下文获取到的历史会话信息一定是有限的,更要命的是,可能是矛盾的、混乱的,因此他回答问题的质量就会大打折扣!
各大模型厂商在提高参数量从而提高模型推理能力的同时,也在不断提高上下文长度,但是无论如何上下文长度一定是有限制的,所以模型能力也一定会因此而受限。
现在比模型迭代要频繁得多快得多也更容易吹牛逼的是围绕模型的各种技术,比如RAG,graphRAG,Agent,Skills等等,其实大都是围绕为模型提供外挂记忆从而提升模型记忆能力这一问题做文章的。每一个新概念(我觉得都不能说是什么新技术)提出的时候,跟风最紧疯狂吹牛逼的往往是所谓的科技自媒体,不要脸的大有人在,吹牛逼的终极归宿就是培训。
我总在想一个问题:外挂记忆理论上来说只有两种解决方案,一种是传统的方案,就是用算法、规则从历史对话记录中提取相关信息,追加到本轮用户query中一起发给大模型让大模型参考提取的历史信息回答用户本轮的问题。另外一种就是AI方案,就是在应用后台把用户当前轮次的问题通过和LLM模型的多轮对话,多次提交历史信息给大模型让大模型自己总结历史信息中和本轮对话有关信息提取出来、最终再让大模型结合已经提取到的终极历史信息回答用户本轮问题。或者是两种方案的结合,除此之外我是没想到有什么其他方案。如果有人知道其他方案的话,欢迎能不吝赐教告诉我。
在此基础上,我们假设你作为软件工程师需要解决某一个客户需求,这个客户需求不是三言两语就能说清楚的(这太常见了,否则如果软件工程师被AI替代了的话就不是因为AI能力强而是因为你的工作太简单了),假设你需要设计一个功能模块来满足这个用户需求,这个功能模块也不是两三个一两百行的代码就能解决的。这个场景下,如果你想让AI帮你解决问题,你就需要不断的反复的跟AI沟通清楚需求,然后交给他生成代码,这个时候,如果模型能力还可以的话,一般来讲还是美好的,AI生成的代码质量大概率不会太差。假设你经过测试发现一些问题,你就需要反复沟通解释现有系统和用户需求之间的差异,让AI理解并通过修改代码来弥补这个差异,这个时候,噩梦可能就开始了,你一定要非常谨慎地一步一步控制好AI,否则的话,大概率你就会发现,A功能补全了,B功能丢失了,而且,一个代码文件如果超过1000行代码的话,大部分模型都没有能力处理好反复变更的需求或问题。然而,你如果是一个经验丰富的程序员,你就应该知道软件项目实施过程中,需求变化或者设计变更是多么自然而频繁发生的一件事情。
这个时候肯定就有人会说,不是AI解决不了你的问题,是你用AI的姿势不正确,是你不会不了解不懂不知道怎么用AI,你要用Agent,用Skills,用reAct。或者你要用claude code,要用open code,要用openClaw…等等。
我个人非常肯定的认识到,所有这些工具的底层逻辑其实就是提示词工程,要解决的问题其实就是大模型没有记忆、而你要想办法加强大模型的记忆。不可避免的问题是,无论你用什么工具,底层逻辑其实就是:你需要跟大模型一轮一轮沟通问题,让模型测底理解你的需求、现状的情况下给出解决方案并生成代码。这个过程中,无论用什么工具都不可避免的要碰到的一个问题就是:你第n轮跟AI沟通过的问题,在第m轮可能被推翻了,但是第n-1轮的、第m+1轮的还生效,不能被推翻,第n、n+1…m、m+1轮你的描述可能会有某几个彼此矛盾、但是综合起来看的其实并不矛盾,这在人与人之间沟通的时候是容易理解、最终通过多轮沟通总能达成一致的。但是对大模型来说,或者说对agent、skills等等之类的工具来说,这太难了很有可能是无解的。
个人认为这就是模型的边界,就是他的天花板。
对了,还有一种是基于RAG的知识库,和处理记忆的手段其实类似,只不过补充的不是大模型的记忆,而是大模型知识匮乏导致的胡言乱语胡说八道。RAG技术、关键词搜索或者两者结合、或者再用后排序算法也是一个非常复杂的领域,也有不可解决的痛点,这是另外一个话题,和我们今天要讨论的问题没有任何关系,所以就不说了。
这个边界有希望突破吗
作为普通人,我肯定只能说一下自己的理解,按照我的理解,基于Transformer架构的LLM模型是无法突破我们上面所说的模型边界的。
但是也并不是说LLM或者AI在软件领域就没有用武之地,我从来没这么说过,反之,AI在软件或者编程领域其实也是他特别适合的领域,因为模型训练的时候无论是设计模式、软件工程方法论、软件项目管理,还是编程语言语法、技巧、成功经验等,都是非常标准的语料,他很容易通过学习变成这个领域人类无法比拟的专家。所以,他解决单一问题的能力,计算机领域的天才专家可能都比不了,何况我们这些戚戚无名的普通程序员?。 这个其实也不需要我多说,据说,已经有78%的程序员天天都在用AI了(数据来源忘记了)。
我怎么用AI编程
我大概在24年开始用AI写代码,但是应该是在25年初或者年中的时候才大量、大范围用AI写。目前我个人大概80%以上的代码都是用AI写。综合效率提升2-3倍,需求简单、技术相对复杂的(偏技术、业务场景简单的)场景效率提升5-10倍。
cursor用过一段时间,后来从claude模型掐断之后就没再用过。Claude code用过一段时间,总感觉效果不太好,最近没怎么用了。我还是不希望用什么skills、直接交给agent啥的让他黑箱操作,你睡一觉之后再来检查结果这种方式,试过几次很不靠谱。
我现在的用法很简单,直接在模型官网通过对话的模式用。deepseek、kimi、智谱、千问等等很多模型都用过,对比过多次之后,目前感觉相对比较靠谱的是Google AI Studio + Google Gemini 3 pro。效果真的非常好,自我感觉甩其他几个模型好几条街,不在可比范围内。GPT 5用的比较少,因为要么就是速度特别慢、要么就是各种限制。
Google AI Studio是我用过的模型中为数不多(其实我没见过任何其他模型官网有过)的可以写系统提示词、可以调温度的官方应用。
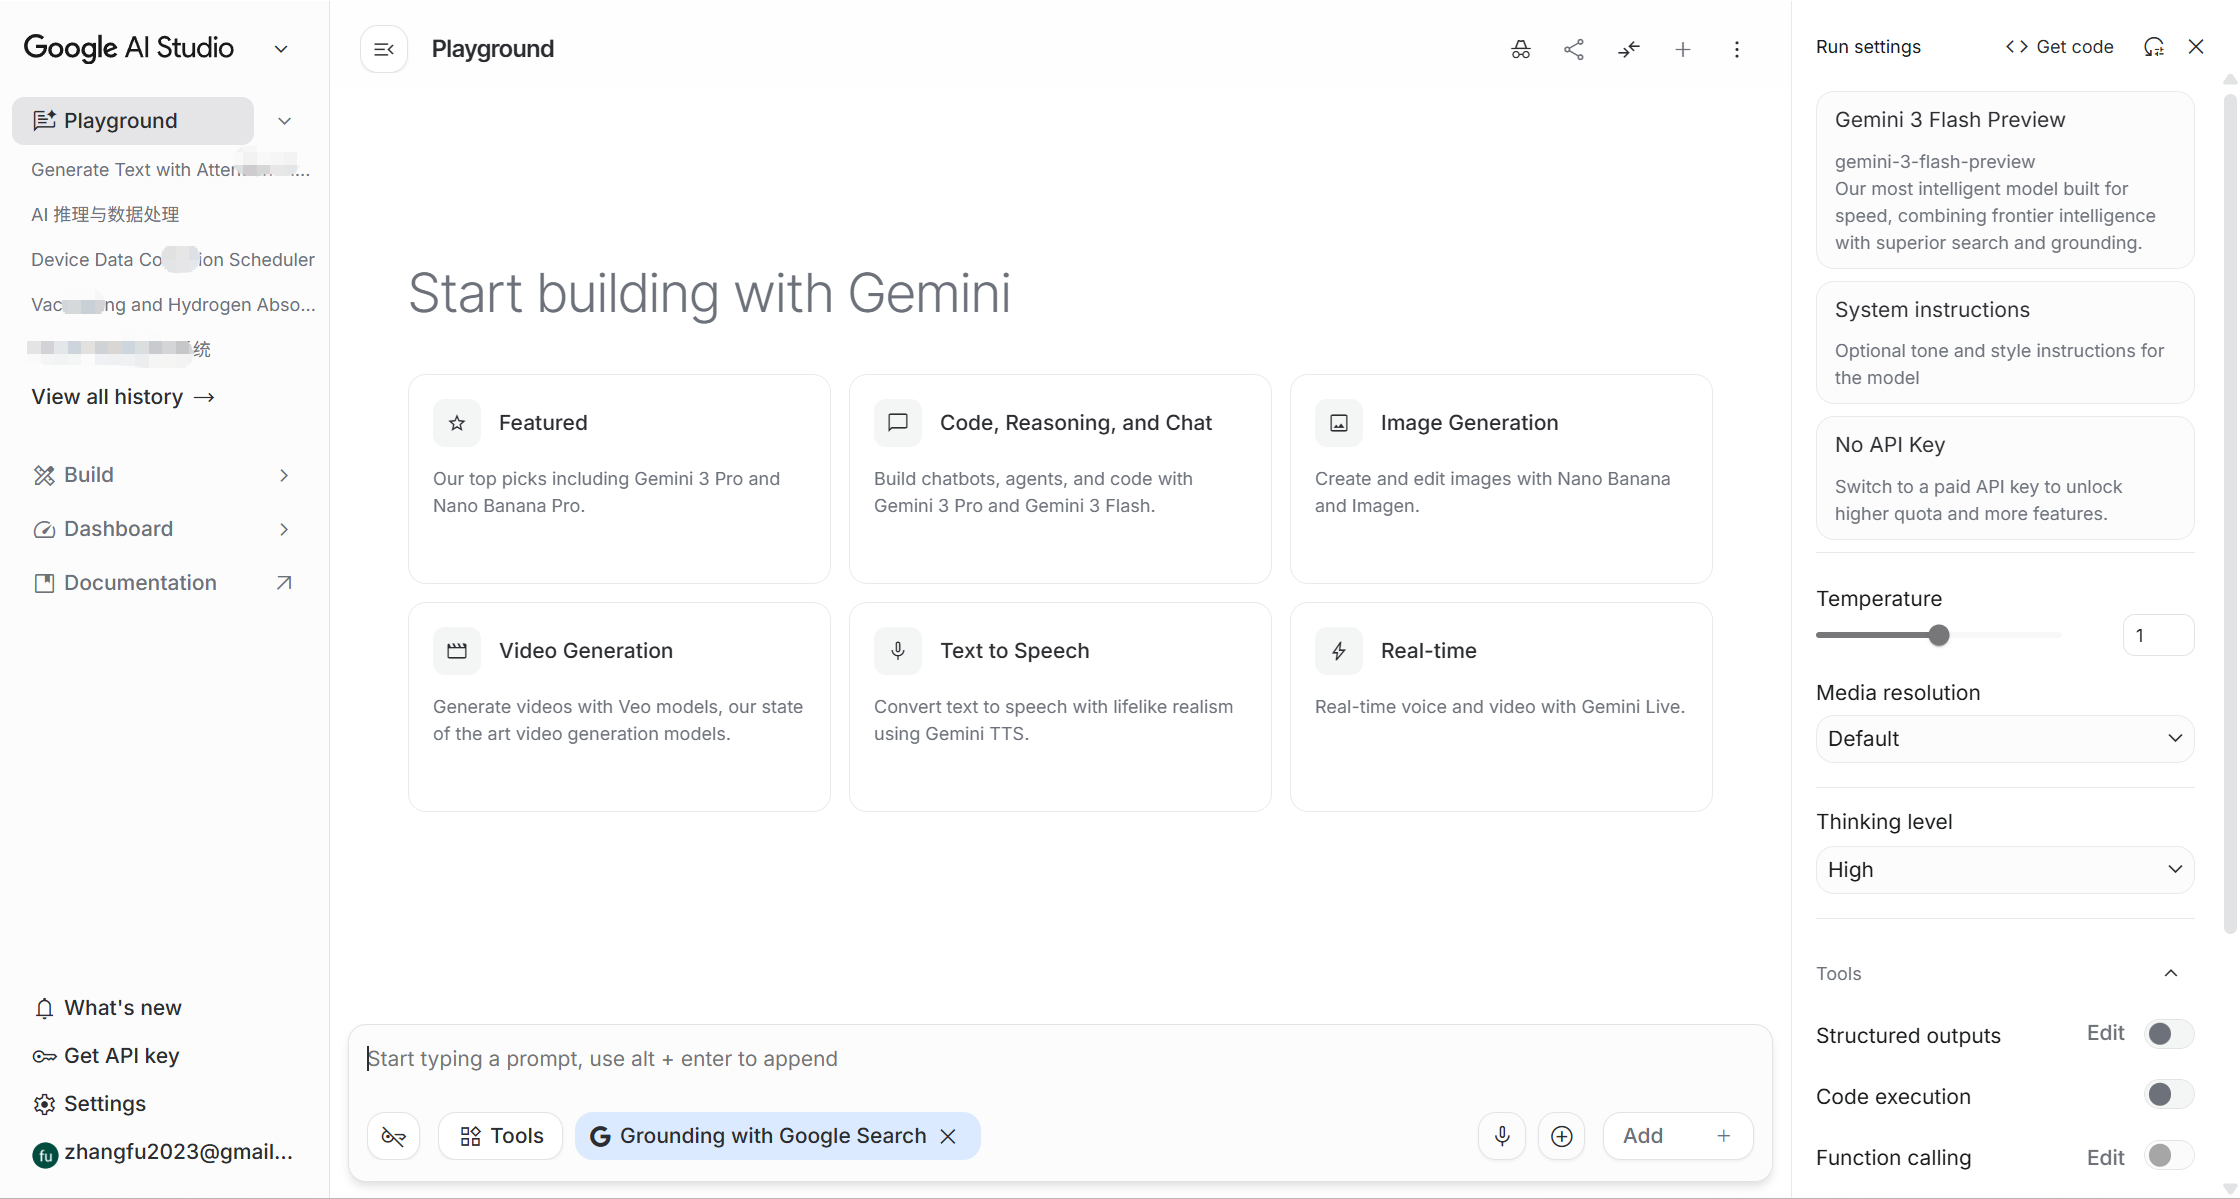
Google AI Studio最近限制也比较多了,连续用的话基本用不了,几天不用突然用一次,大概还能用半天时间,我指的是需要不断沟通的那种,连续沟通大概20-30次之后就开始限制没办法用了。然后就切换到Google AI Studio + Gemini 3 Flash之类的模型,能非常明显的感觉到模型之间的差异。
在使用AI执行编码任务的过程中,我不断的体会上面我提到的想法,就是需求不断变化(不是用户需求变化,而是你的设计思路或者解决bug的方案会有变化)、反复沟通过程中,随着轮次变多、上下文变得越来越复杂,效果就会越来越差。这个时候最好开启新对话,花点时间用简单精炼明确的语言交代好上下文,效果立刻翻倍提升。
最后
发一张图,但是没能力做评论,供各位参考:
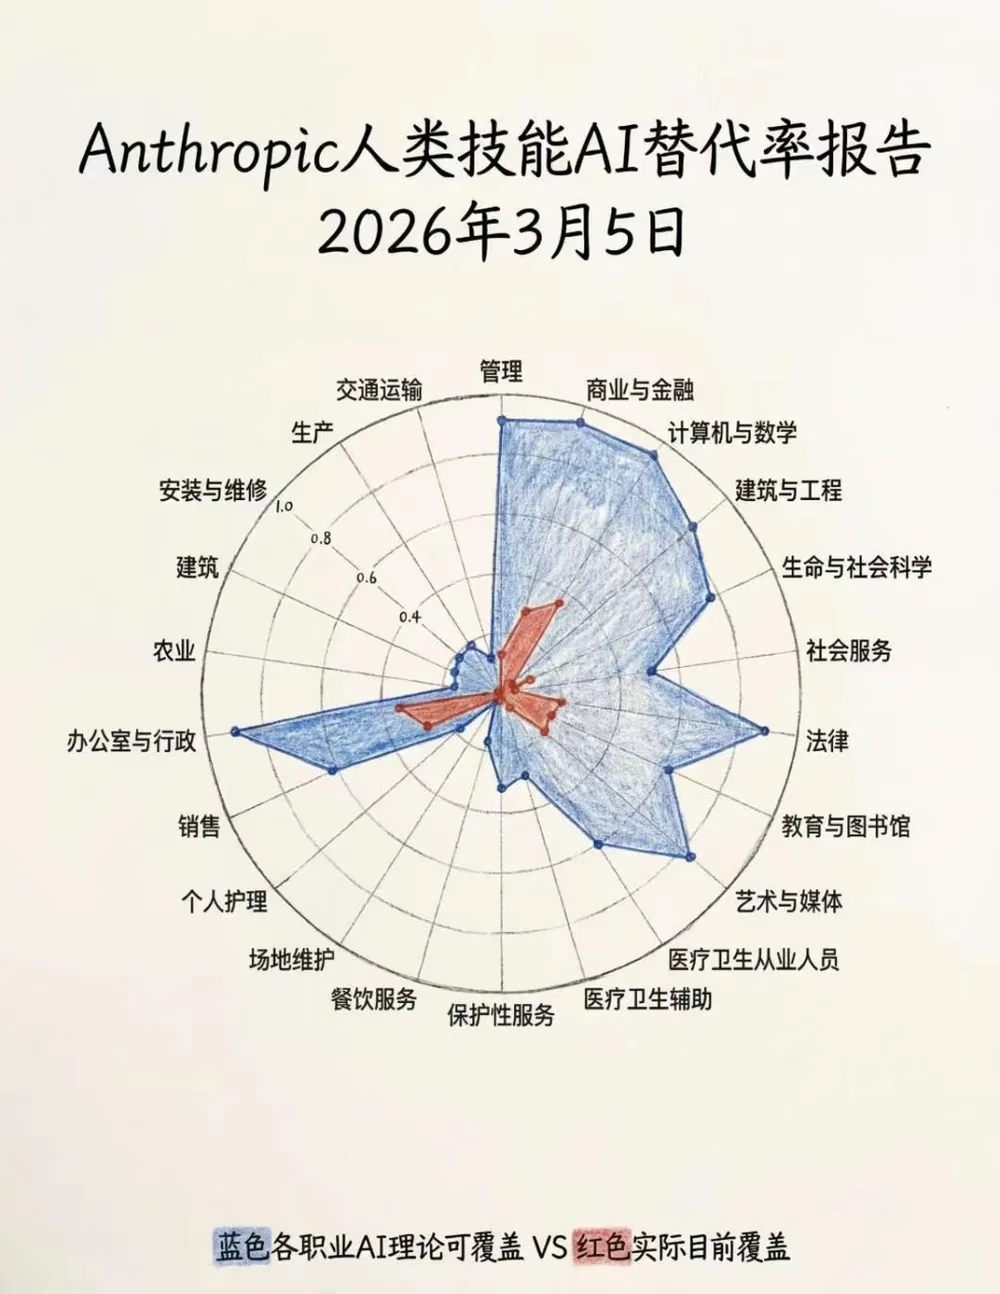
程序员这个职业永远不会被AI代替,但是很多程序员岗位很快就会被AI代替,因为有很多程序员不太愿意学习,但是与此同时也有很多程序员特别愿意学习,非常积极主动的拥抱AI,最终,由于他们效率成倍提升,他们会替代他们。
程序员还是很有必要学习自己领域内的底层技术,比如你是JAVA程序员,你就很有必要继续学习Spring、Springboot、JAVA虚拟机等等底层技术,虽然你可能很快就能让AI帮你解决这类底层技术问题,但是如果AI生成的代码、或者提出的方案你根本就看不懂、你根本没有办法判断或者选择AI给出的方案的优劣,那么你根本就不可能让AI帮你写出高质量的代码。你可能也就看不懂AI生成的代码,最后你的项目中就会有很多AI生成的但是你根本就看不懂出了问题你不知道怎么解决也没有办法交接、知识传递的屎山代码。这样的话,你很快就会被AI代替。

AtomGit 是由开放原子开源基金会联合 CSDN 等生态伙伴共同推出的新一代开源与人工智能协作平台。平台坚持“开放、中立、公益”的理念,把代码托管、模型共享、数据集托管、智能体开发体验和算力服务整合在一起,为开发者提供从开发、训练到部署的一站式体验。
更多推荐



 11
 0
- 0


 已为社区贡献1条内容

所有评论(0)