深度学习篇学习回顾与心得1
pytorch框架
说到深度学习 ,首先要提到的就是pytorch框架 ,
```
安装pytorch方法
pip install torch
```
这个框架的主要作用就是将数据转换成张量进行处理 ,而张量就是 同一种数据类型组成的多维矩阵
在进行神经网络训练的时候 ,通过反向传播优化权重参数的操作 ,是十分常见的 ,而当我们通过梯度下降公式 即 w新=w旧-学习率*梯度值 进行参数优化的时候 ,梯度值的获取就用到了对损失函数求导的操作 ,pytorch框架中有专门对求导操作开发的模块 ,即 自动微分模块
调用这个模块时代码为: torch.autoguard()
再进行反向传播时,使用 torch.backward() ,在进行反向传播时,反向传播需要你提供的值是一个标量张量 ,通过sum() ,或者mean() 将张量转换成对应格式后再进行反向传播
其他的一些张量的创建以及使用都比较简单 ,当我们在程序中遇到的时候 ,随查随用即可
ANN神经网络
神经网络由多个神经元组成 ,构建神经网络就是构建神经元
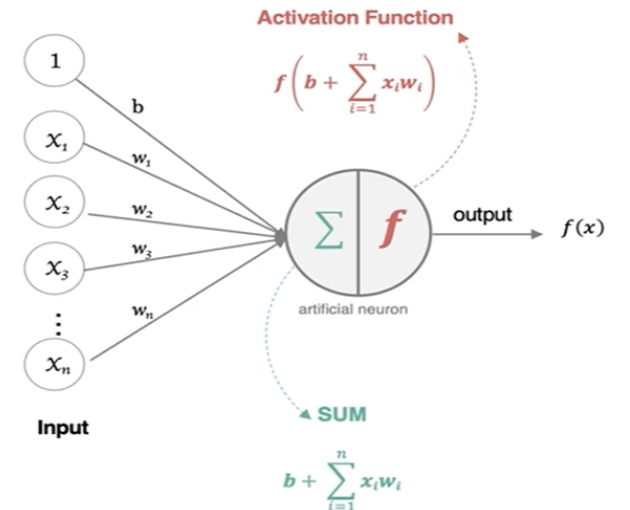
全连接神经网络
神经网络中信息只向一个方向移动 ,即从输入节点向前移动 ,通过隐藏节点 ,再向输出节点移动
- 输入层
- 输出层
- 隐藏层
特点:
-
同一层的神经元之间没有连接
-
第N层的每个神经元和第N-1层的所有神经元相连
-
全连接神经网络接收的样本数据是二维的 ,数据在每一层之间需要以二维形式传递
全连接神经网络的核心层是全连接层,他的数学本质是一个矩阵乘法,在这个运算中input通常是一个二维张量形状为(batch_size,input_features)全连接网络本质上要求每个样本的特征被组织成一维形式(即单个样本本身必须是一维向量),因此批量输入的数据就是二维的了 -
第N-1层神经元的输出是第N层神经元的输入
-
每个连接都有一个权重值 ( w系数 和 b系数 )
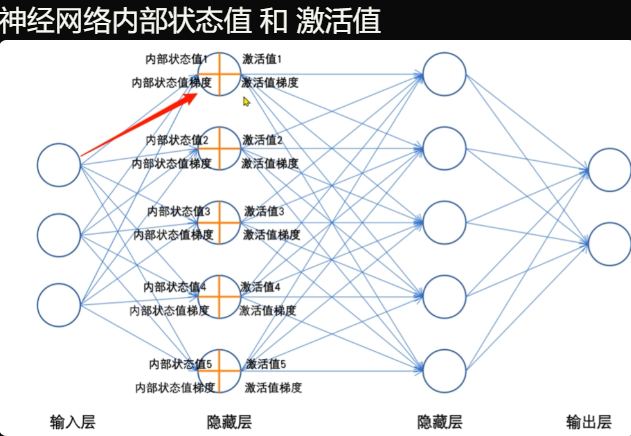
神经网络的传播分为两部分 : 正向传播和反向传播
每一个神经元工作时 ,正向传播会产生两个值 ,内部状态值(没经过激活函数激活) 和 激活值(带入激活函数直接求值) ,当正向传播结束 ,进行反向传播优化权重参数的时候 ,会产生两种梯度值但它们是先结合成 (内部状态梯度),再乘以输入来优化权重参数 ,一个是激活值梯度(对激活函数求导) 和 上一个状态的内部状态值梯度(损失函数对内部状态值求导)
- 反向传播注意点: 反向传播中激活函数与损失函数不能一概而论 ,这两个并不是相同 ,而是共同起作用(相乘关系)向前传播
激活函数介绍
激活函数的作用是向神经网络中添加非线性因素 ,此时 ,神经网络就可以拟合各种曲线
而如果没有激活函数 ,那么这样的网络本质上就是一个大的线性回归模型
激活函数分类:
- softmax()
- tanh()
- sigmoid()
- relu()
-
隐藏层: 优先ReLU(注意Dead ReLU问题 ,避免出现神经元死亡) ,其次LeakyReLu ,再其次PReLU ,再其次Tanh ,再其次Sigmoid
-
输出层二分类: Sigmoid()
-
输出层多分类: Softmax()
-
输出层回归: Identity()
sigmoid 激活函数
代码: torch.sigmoid()
一般用于浅层神经网络二分类的输出层
x是加权求和 ,x越大 ,函数值越大
-
从sigmoid函数图像可以得到,sigmoid 函数可以将任意的输入映射到 (0, 1) 之间,当输入的值大致在 <-6 或者 >6 **时,意味着输入任何值得到的激活值都是差不多的,这样会丢失部分的信息。比如:输入100和输入10000经过 sigmoid的激活值几乎都是等于1的,但是输入的数据之间相差100倍的信息就丢失了。
-
对于sigmoid函数而言,输入值在[-6, 6]之间输出值才会有明显差异,输入值在[-3, 3]之间才会有比较好的效果
-
通过上述导数图像,我们发现导数数值范围是 (0, 0.25),当输入的值 <-6 或者 >6 时,sigmoid激活函数图像的导数接近为 0,此时网络参数将更新极其缓慢,或者无法更新。**
-
一般来说,sigmoid网络在5层之内就会产生梯度消失现象。而且,该激活函数的激活值并不是以0为中心(中心点在0.5左右)的,激活值总是偏向正数,导致梯度更新时,只会对某些特征产生相同方向的影响,所以在实践中这种激活函数使用的很少。sigmoid函数一般只用于二分类的输出层。
Tanh 激活函数
代码: torch.tanh()
主要用在隐藏层 ,网络层数相对较多
x是加权求和 ,x越大 ,函数值越大 ,整体越接近1
x越小 ,函数值越小 ,整体越接近-1
-
由上面的函数图像可以看到,Tanh函数将输入映射到(-1, 1)之间,图像以0为中心,激活值在0点对称,当输入的值大概 <-3 或者 >3 时将被映射为-1或者1。其导数值范围 (0, 1),当输入的值大概 <-3或者 >3 **时,其导数近似0。
-
与Sigmoid相比,它是以0为中心的,使得其收敛速度要比Sigmoid快,减少迭代次数。然而,从图中可以看出,Tanh两侧的导数也为0,同样会造成梯度消失。
-
若使用时可在隐藏层使用tanh函数,在输出层使用sigmoid函数。
ReLU 激活函数
代码: torch.relu()
主要用在隐藏层( 如果在激活函数中暂时没有任何的想法 ,那么优先在隐藏层中使用ReLu )
x是加权求和 ,求导后导数值永远为1
-
ReLU 激活函数将小于0的值映射为0,而大于0的值则保持不变,它更加重视正信号,而忽略负信号,这种激活函数运算更为简单,能够提高模型的训练效率。
-
当x<0时,ReLU导数为0,而当x>0时,则不存在饱和问题。所以,ReLU 能够在x>0时保持梯度不衰减,从而缓解梯度消失问题。然而,随着训练的推进,部分输入会落入小于0区域,导致对应权重无法更新。这种现象被称为“神经元死亡”。
-
ReLU是目前最常用的激活函数。与sigmoid相比,RELU的优势是:
- 采用sigmoid函数,计算量大(指数运算),反向传播求误差梯度时,计算量相对大;而采用Relu激活函数,整个过程的计算量节省很多
- sigmoid函数反向传播时,很容易就会出现梯度消失的情况,从而无法完成深层网络的训练;而采用relu激活函数,当输入的值>0时,梯度为1,不会出现梯度消失的情况
- Relu会使一部分神经元的输出为0,这样就造成了网络的稀疏性,并且减少了参数的相互依存关系,缓解了过拟合问题的发生
SoftMax 激活函数
主要使用在输出层
softmax用于多分类过程中 ,它是二分类函数sigmoid函数在多分类上的推广 ,目的是将多分类的结果以概率的形式展现出来
权重参数 w 和 b 怎样进行初始化
我们在构建网络之后,网络中的参数是需要初始化的。我们需要初始化的参数主要有权重和偏置,偏置一般初始化为0即可,而对权重的初始化则会更加重要。
- 均匀分布初始化
- nn.init.uniform(linear.weight)
- nn.init.uniform(linear.bias)
- 权重参数初始化从区间均匀取值 ,默认区间为 ( 0,1 )
- 正态分布初始化
nn.init.normal(linear.weight)
nn.init.normal(linear.bias)
随机初始值从均值为0 ,标准差是1的高斯分布中取样 ,使用一些很小的值对参数 w 进行初始化 - 全0初始化 主要用来对 b 进行初始化 ,不能用来对 w 进行初始化
nn.init.zeros_(linear.bias)
神经网络中全部参数初始化为0 - 全1初始化
nn.init.ones(linear.weight)
nn.init.ones(linear.bias)
神经网络中全部参数初始化为1 - 固定值初始化
nn.init.constant(linear.weight,66)
nn.init.constant(linear.bias,6)
神经网络中全部参数初始化为某个固定值 - kaiming 初始化 ( HE初始化 ) 凯明初始化
nn.init.kaimingnormal(linear.weight)
- xavier 初始化 ( Glorot初始化 ) 泽维尔初始化
nn.init.xaviernormal(linear.weight)
凯明初始化和泽维尔初始化都只能对 w 权重进行初始化 ,不能对 b 进行初始化 ,如果进行初始化会报错
总结:
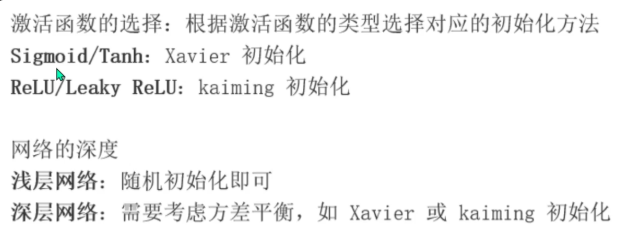
浅层网络一般为网络层数小于10层
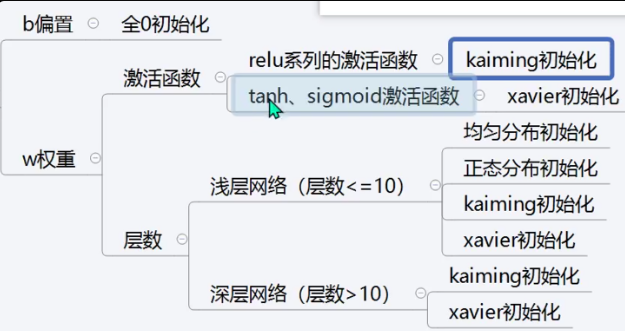
凯明初始化和泽维尔初始化都只能对 w 权重进行初始化 ,不能对 b 进行初始化 ,如果进行初始化会报错

AtomGit 是由开放原子开源基金会联合 CSDN 等生态伙伴共同推出的新一代开源与人工智能协作平台。平台坚持“开放、中立、公益”的理念,把代码托管、模型共享、数据集托管、智能体开发体验和算力服务整合在一起,为开发者提供从开发、训练到部署的一站式体验。
更多推荐
 13
 0
- 0


 已为社区贡献2条内容

所有评论(0)