登录社区云,与社区用户共同成长
邀请您加入社区
本文介绍了三个算法问题的解决思路和代码实现:1. 环形链表检测(使用C++ STL set存储节点指针);2. 两个数组求交集(使用set去重后对比);3. 随机链表的深拷贝(提供C语言节点插入法和C++ map映射法)。重点讲解了利用STL容器简化算法实现的过程,包括set的去重特性、map的节点映射关系等技巧。对于每个问题,文章都给出了题目描述、解决思路和完整代码实现,并分析了算法的时间复杂度
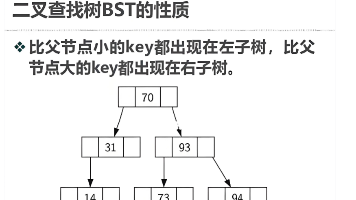
本文详细介绍了二叉搜索树的概念、性能分析及实现方法。首先阐述了二叉搜索树的定义和特性,分析了其最优和最差情况下的时间复杂度。然后重点讲解了二叉搜索树的增删查操作的具体实现,包括节点定义、基本结构、插入、查找和删除算法,并提供了完整的代码示例。接着介绍了key和(key,value)两种结构的二叉搜索树,说明了它们的使用场景差异。最后给出了二叉搜索树在实际应用中的典型场景,如车库管理系统、词典翻译等
1.qsort是库函数,包含在<stdlib.h>中,原理是利用快速排序法进行元素排序,可以排列任意类型变量。cplusplus对qsort的官方定义和描述返回值是void第一个参数是要排序的数组的首元素地址第二个参数是要排序的数组的元素个数第三个参数是要排序的数组的元素类型的大小(sizeof)第四个参数是一个自定义函数(compare),返回类型是int 参数是两个const void *那么
红黑树是一种自平衡二叉搜索树,通过节点颜色(红/黑)和四条规则确保近似平衡:1)节点非红即黑;2)根节点为黑;3)红色节点的子节点必须为黑;4)任意路径黑节点数相同。其最长路径不超过最短路径的2倍,保证操作时间复杂度为O(logN)。相比AVL树,红黑树通过更宽松的平衡条件减少了旋转次数,实际应用中性能更优。实现时需处理插入后的颜色调整(变色/旋转)以维持平衡性,主要包括处理叔叔节点为红(变色)或
【代码】10.6作业。
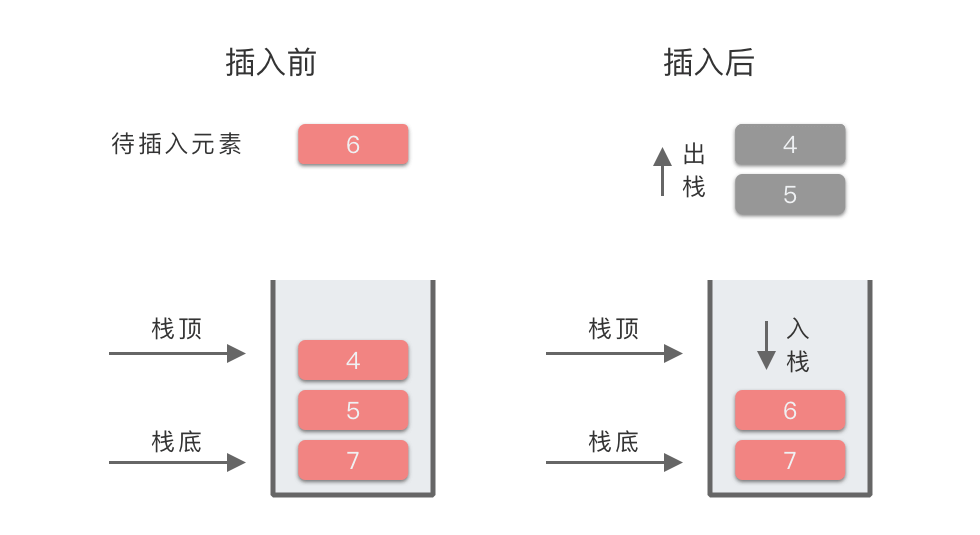
单调栈(Monotone Stack):一种特殊的栈。在栈的「先进后出」规则基础上,要求「从栈顶到栈底的元素是单调递增(或者单调递减)」。其中满足从栈顶到栈底的元素是单调递增的栈,叫做「单调递增栈」。满足从栈顶到栈底的元素是单调递减的栈,叫做「单调递减栈」。注意:这里定义的顺序是从「栈顶」到「栈底」。有的文章里是反过来的。本文全文以「栈顶」到「栈底」的顺序为基准来描述单调栈。
按照套路,先来一通理论层面的陈述:1、冒泡排序基本思想:通过对待排序序列从前向后(从下标较小的元素开始),依次对相邻两个元素的值进行两两比较,若发现逆序则交换,使值较大的元素逐渐从前移向后部,就如果水底下的气泡一样逐渐向上冒。2、先以一个数组讲解一下,然后再写代码:待排序数组:3,9,-1,10,20第一轮排序:(1)3,9,-1,10,20----3跟9比较,不交换(2)3,-1,9,...
在笔试题时,可能会遇到一个关于常见排序算法稳定性判别的问题,往往还是多选。当然如果你笔试之前已经记住了数据结构书上哪些是稳定的,哪些不是稳定的,做起来应该可以轻松搞定。本文是针对老是记不住这个或者想真正明白到底为什么是稳定或者不稳定的人准备的。先放结论:选择排序、快速排序、希尔排序、堆排序不是稳定的排序算法。冒泡排序、插入排序、归并排序和基数排序是稳定的排序算法。首先,排序算法的稳定性大家应该都知
选择排序:选择排序( Selection sort)是一种简单直观的排序算法。它的工作原理是每一趟从待排序的数据元素中选出最小(或最大)的一个元素,顺序放在已排好序的数列的最后,直到全部待排序的数据元素排完。选择排序算法通过选择和交换来实现排序,其排序流程如下:(1)首先从原始数组中选择最小的1个数据,将其和位于第1个位置的数据交换。(2)接着从剩下的n-1个数据中选择次小的...
排序算法是《数据结构与算法》中最基本的算法之一。排序算法可以分为内部排序和外部排序。内部排序是数据记录在内存中进行排序。而外部排序是因排序的数据很大,一次不能容纳全部的排序记录,在排序过程中需要访问外存。常见的内部排序算法有:插入排序、希尔排序、选择排序、冒泡排序、归并排序、快速排序、堆排序、基数排序等。用一张图概括:时间复杂度与空间复杂度关于时间复杂度:平方阶 (O(...
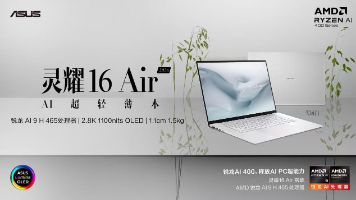
搭载AMD锐龙AI 9 H 465处理器,10核20线程,最高主频5.0GHz,配合华硕冰锋散热系统,无论是多任务办公、大型Excel处理,还是轻度视频剪辑,都能流畅应对。华硕灵耀16 Air 2026将16英寸大屏机身做到了轻约1.5kg、薄至1.1cm,放在16寸大屏轻薄本中,属于“身材姣好”的类型,搭配68W的小尺寸电源适配器,便携性相当突出。一台真正值得选择的2026年轻薄本选购指南,应当
嘿,屏幕前那位对着空白Word文档发呆超过两小时的朋友,先别划走。今天这篇文章,不讲大道理,不灌鸡汤,我就想安利一个我自己偷偷用了很久、真香到不行的东西——。*或者微信搜一搜「书匠策AI」公众号,都能找到它。我知道你在想什么:"又是一个AI写论文的?别急,听我说完。
各位正在被论文折磨到头秃的宝子们,今天我不聊选题、不讲框架,咱们来聊一个能让你从"啥也不会"直接跳到"初稿已出"的狠角色——书匠策AI的期刊论文功能。先说句掏心窝的话:我做论文写作科普这么久,见过太多同学卡在第一步就放弃了。不是不想写,是真的不知道从哪儿下手。而书匠策AI(官网: 官网直达:www.shujiangce.com*)这个工具,说白了就是帮你把"从0到1"最痛苦的那段路,直接铺成了高速
我做论文科普这么久,最怕的就是同学们用蛮力去对抗检测系统。其实工具选对了,效率能翻十倍。书匠策AI这个工具,我自己用了两个月,真心觉得它是2025年论文党的必备装备。不管你是本科生、研究生还是在职写论文,都值得去试一试。***,或者微信搜**书匠策AI**,别再说我没告诉你!
这篇文章分析了列车车厢重排问题,指出其本质是计算排列的逆序对数。文章比较了两种解法:冒泡排序法和删除法,两者都能正确求解且时间复杂度均为O(L²)。冒泡排序法通过模拟排序过程统计交换次数,而删除法则依次查找最小元素并计算其移动代价。两种方法都适用于题目给定的L≤50的数据规模,代码实现简洁高效。最终结论是:最少交换次数等于序列的逆序对数,这是解决此类相邻交换排序问题的关键所在。
本文深入剖析了两种经典排序算法——快速排序和归并排序,揭示了分治策略在算法设计中的核心地位。文章从排序算法的信息论本质出发,论证了比较排序的Ω(n log n)下界,并通过决策树模型和主定理进行了数学证明。详细对比了两种算法的实现原理、时间复杂度、空间复杂度及适用场景,包括快速排序的Lomuto分区方案和归并排序的递归实现。特别探讨了工业级优化技术如Dual-Pivot QuickSort、Tim
ArrayList 是 Java 集合框架中的一个动态数组实现,属于java.util包。它基于数组实现,支持动态扩容和随机访问,适合频繁查询和遍历的场景,但插入和删除操作效率较低。HashMap 是 Java 中基于哈希表的 Map 接口实现,用于存储键值对(key-value pairs)。它允许使用 null 键和 null 值,并且是非线程安全的。泛型(Generics)是编程语言中用于增
论文这件事,脑子必须是你自己的,但表达可以让工具帮你打磨得更安全、更干净。书匠策AI不是替你写,而是帮你把写好的东西洗到查重系统和AIGC检测都挑不出毛病。,微信搜**书匠策AI**。别再对着满屏红色怀疑人生了。试一次,你会回来谢我的。🚀。
2026年智能数据一体化平台技术实施方案摘要 本项目旨在构建一套先进的智能数据一体化平台,解决企业多源异构数据治理滞后、业务与技术脱节、AI应用落地困难等核心痛点。平台采用**.NET微服务架构**、湖仓一体存储、AI大模型及数字孪生等2026年前沿技术,覆盖数据采集、治理、分析、应用全生命周期,实现以下目标: 高效采集:支持10+数据源接入,实时采集延迟≤50ms,成功率≥99.95%。 智能治
本文系统介绍了企业级软件开发中的DevOps理念和Git分支管理模型。主要内容包括:1)DevOps如何弥合开发与运维的鸿沟;2)企业级Git分支模型(master、develop、release、feature、hotfix五大分支)及其职责;3)分支命名规范和环境绑定策略;4)基于GitFlow的实战操作流程,涵盖新需求开发、测试修复、紧急Bug处理等典型场景。文章通过清晰的流程图示和规范表格
摘要:select系统调用实现多路复用I/O模型,允许程序监控多个文件描述符(fd)的状态变化。它通过位图(fd_set)机制高效管理最多1024个fd,支持读、写和异常事件监听。select具有跨平台兼容性高、资源开销低和接口简单的优势,适用于嵌入式等资源受限场景。其函数原型包含nfds(最大fd+1)、超时参数和三个事件集(readfds/writefds/exceptfds),返回值指示就绪
本文主要介绍了排序算法(直接插入排序、希尔排序、选择排序、堆排序、冒泡排序、快速排序、归并排序、计数排序),内容全由作者原创(无AI),同时深度解析了每个排序算法的具体实现和拓展,并带有配图帮助博友们更好的理解,点个关注不迷路,下面进入正文~~
本文揭示了古代算命术背后的数理逻辑本质,认为其是一套基于离散时空编码的早期宇宙模型。文章指出,《易经》、奇门遁甲和八字系统实质上是古人构建的二进制状态机、时空编码矩阵和初始参数组,12地支与5行对应着空间闭合与锁合步进的几何关系。作者分析算命时准时不准的原因在于古人用连续圆逼近离散空间产生的系统性误差。现代混沌理论和分形几何印证了古人关于初始条件决定系统演化的直觉判断。文章最终提出,算命术实为被历
堆与优先队列篇的三道题,每一道都是 Top K 或中位数问题的教科书式例题。第 K 个最大元素用固定大小的小顶堆维护前 K 大;前 K 个高频元素在统计频率后套用同样的堆思路;数据流的中位数则用两个堆实现了动态取中位数的神奇效果。这三种模型不光在面试里反复出现,在很多真实业务(比如实时排行榜、滑动窗口统计)里也经常用到。把这三种堆的用法刻进脑子里,以后再遇到类似的问题,基本都能秒反应。下一篇准备写
本文通过钓鱼的生动比喻,系统讲解了五种IO模型及其区别。核心观点是:IO操作包含等待和拷贝两个阶段,高效IO的关键在于减少等待时间占比。文章详细对比了阻塞IO、非阻塞IO、信号驱动IO、多路复用IO和异步IO的特点,特别强调同步IO与异步IO的本质区别在于是否全程参与IO过程。通过fcntl函数设置非阻塞IO的代码示例,展示了非阻塞IO的实现方式及其轮询机制。最后指出多路复用IO效率最高,因其能同
只需输入你的专业方向(如“生物学”“经济学”)或感兴趣的话题(如“气候变化”“社交媒体”),AI会像“学术侦探”一样,分析海量文献和最新研究趋势,为你推荐多个细分领域的选题。AI生成的大纲包括“研究背景”“文献综述”“研究方法”“实证分析”“结论与建议”等部分,他在此基础上增加了“国内外对比”章节,使论文更具深度。例如,你写“短视频营销的优势”,AI会提供“传播速度快”“互动性强”“成本低”等角度
模型内主要包含DC直流电压源、三相逆变器、感应(异步)电机、采样模块、SVPWM、Clark、Park、Ipark、PID、速度环、电流环等模块,其中,SVPWM、Clark、Park、Ipark、PID模块采用Matlab funtion编写,其与C语言编程较为接近,容易进行实物移植。咱们边看代码边唠嗑,看看这波自动化怎么实现的。本仿真中最大的亮点是双环PI参数自整定,只需输入正确的电机参数(电
最后留一个关键问题:👉 当用户不再自己筛选信息,而是直接相信 AI 推荐时——
本文对比了三种基础排序算法:冒泡排序、选择排序和插入排序。这三种算法都属于比较类排序,通过元素间的比较和交换实现排序,且都是原地排序算法。冒泡排序通过相邻元素比较交换将最大元素"冒泡"到末尾,时间复杂度O(n²),适合小数据集;选择排序每次选择最小元素放到已排序部分末尾,交换次数较少但不稳定;插入排序则将未排序元素逐个插入已排序部分的正确位置,对部分有序数据效率较高。文章通过P
该仓库收集了10大经典排序算法(冒泡、插入、选择、快速、归并、堆排序、希尔、计数、桶、基数排序)的多语言实现,涵盖C/C++/Java/Python/JavaScript/Go/Rust等11种编程语言。每个算法提供2-6种不同实现思路,包含详细注释说明时间复杂度、空间复杂度和稳定性分析。特色包括性能对比测试、可视化排序过程和多种解法思路,适合学习算法原理、对比语言特性及掌握编程基础。所有代码开源
用两个平行数组存储所有键值对:键数组始终保持有序,值数组与键数组下标一一对应。核心操作是 ——返回小于 key 的键的个数,也就是 key 在有序数组中应处的位置。所有其他操作都建立在之上。输入:插入新键时,比 key 大的所有键整体右移一格腾出位置:三、rank() 的两种实现3.1 递归版(更直观)#mermaid-svg-gvATi7CnpJlYKWOG{font-family:"trebu
快速排序是实际应用中使用最广泛的排序算法。它的优点:快速排序和归并排序都用了"分而治之"的思想,但方向相反:用 ASCII 图示:三、核心:分区(Partition)操作分区是快速排序的灵魂。目标是选一个"基准元素",把数组重新排列成:分区过程图解分区的 C++ 实现四、完整快速排序(C++ 完整可运行代码)五、递归调用树(以 QUICKSORTEXAMPLE 为例)#mermaid-svg-qG
生活类比:就像整理扑克牌,如果手里有很多牌,一次只按相隔一定间距(比如每隔10张牌)把牌插入到已排好的位置,先把大块牌大致排好序,再缩小间距,一次次精细调整,最后整个牌堆就排好了。:统计每个元素出现的次数,用额外数组记录到对应下标,再按顺序输出,实现排序,不进行元素比较。:就像整理一堆水果,把最大的放在顶上,每次取出最顶上的水果放到盘子里,然后让剩下的水果重新“自动堆成一座山”,下一次再取最大的。
基于SPH-FEM泥石流模拟冲击拦挡坝视频教程此教程为SPH泥石流浆体冲击FEM拦挡坝,详细介绍了浆体和拦挡坝建模,两者之间的耦合,以及在lsdyna参数设置。视频模型和K文件最近在研究泥石流灾害模拟这块,发现了一个超棒的基于SPH - FEM泥石流模拟冲击拦挡坝的视频教程,今天就来跟大家分享分享其中的精彩内容。
RAG高阶检索与重排序技术精要 本文深入解析RAG系统中的检索与重排序核心技术,帮助开发者突破精度瓶颈。核心内容包括: 检索算法原理:详解余弦相似度(语义匹配)和BM25(关键词匹配)的底层逻辑,强调向量归一化对精度的影响 混合检索策略:通过权重调节(语义0.4-0.7/关键词0.3-0.6)适配不同场景,解决专业术语和长文本检索难题 重排序优化:对比三种重排序方案(大模型过滤/专用模型/云API
本文摘要:文章系统探讨了Dijkstra算法在不同图论问题中的应用与调整。主要内容包括:1) 算法在不同场景(如单对、单终点最短路径)下的调整策略;2) 通过实例和反例说明算法特性;3) 证明算法在正权图上的正确性;4) 针对DAG设计线性算法;5) 将算法应用于最小总和问题;6) 用物理模型形象解释最短路径概念。特别指出:对于单对问题可提前终止算法,单终点问题需反转边方向;负权图需使用其他算法;
这段代码定义了两个函数:merge 用于合并两个已排序的子数组,mergeSort 是递归的归并排序函数。在 main 函数中,我们创建了一个待排序的数组,并调用了 mergeSort 函数进行排序。排序完成后,我们输出了排序后的数组。归并排序(Merge Sort)是一种分治(Divide and Conquer)策略的排序算法。它将一个大问题分解成两个或更多个相同或相似的小问题,递归地解决这些