KingbaseES V9 物理备份实战:用 sys_rman 做增量备份与 PITR 时间点恢复
KingbaseES V9 物理备份实战:用 sys_rman 做增量备份与 PITR 时间点恢复
说个真事。去年有位同事在生产库上跑了个 DROP TABLE,订单表,五百多万行。当时是周五下午快下班,整个人都懵了。最后靠物理备份加 WAL 归档把数据全救回来了——从删表到恢复大概四十分钟。从那以后我对备份这事儿就有点强迫症了。
金仓的物理备份工具叫 sys_rman,跟 pgBackRest 一个路子。原理不难懂,先拷一份数据文件当底子,然后持续把 WAL 日志归档存着。出事了就把底子铺回去,日志一段段重放,想恢复到哪秒都行。这个能力叫 PITR(Point-In-Time Recovery)。sys_dump 做不到这个,它只能恢复到你上次导出的那一刻,中间的数据全没了。
还有俩词儿混个脸熟就行:RPO 就是"能容忍丢多少数据",sys_dump 的 RPO 就是上次导出到出事这段时间,可能差好几个小时甚至一天;RTO 是"多久能把库拉起来"。物理备份加归档能把 RPO 压到秒级,所以生产基本都会配这套,不是可选项,是底线。
下面在一台单机 V9R1C10 上走一遍完整流程。环境很简单:数据目录 /opt/kingbase/data,备份仓库放 /opt/kingbase/backup。仓库和数据目录别放同一块盘啊,盘坏了备份跟着一起没,等于白做。
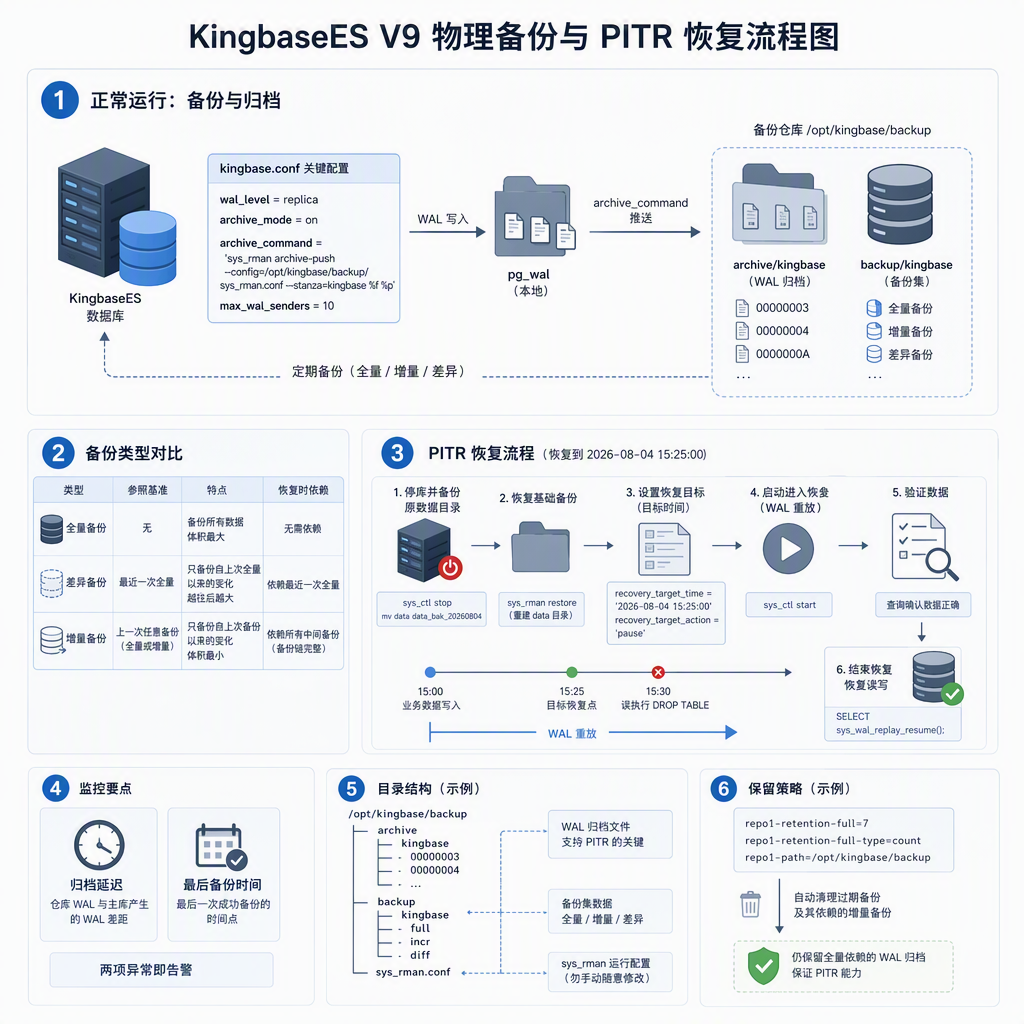
先把归档打开
PITR 的前提是 WAL 归档开着。改 kingbase.conf:
wal_level = replica
archive_mode = on
archive_command = 'sys_rman archive-push --config=/opt/kingbase/backup/sys_rman.conf --stanza=kingbase %f %p'
max_wal_senders = 10
逐行说下干嘛的。wal_level=replica 是流复制和归档的最低门槛,再低就不行了。archive_command 就是 WAL 段写满之后(默认 16MB 一个)执行这条命令把它推到仓库,%f 是文件名,%p 是路径。max_wal_senders=10 留够连接数给复制和归档用,一般够。
改完 sys_ctl reload 就生效了,不用重启。
这里有个坑我踩过。archive_mode=on 之后如果归档命令一直失败,比如仓库路径权限不对,WAL 会堆在 pg_wal 里直到磁盘撑爆。别问我怎么知道的——第一次配的时候就是仓库目录属主搞错了,第二天早上运维打电话说磁盘 95% 了才发现。所以开之前务必确认仓库路径可写,这个真不是废话。
另外 sys_hba.conf 要放行备份用的超级用户:
host    all    system    127.0.0.1/32    md5
host    replication    system    127.0.0.1/32    md5
第一条让 sys_rman 能连库调内部函数,第二条给流复制拉 WAL 用。改完 reload。
初始化备份环境
sys_rman 自己有一份运行时配置 sys_rman.conf,描述仓库在哪、实例是谁。金仓推荐用脚本自动生成,手改容易漏字段出问题。你需要先准备一份初始化配置 sys_backup.conf:
target-db=127.0.0.1
target-port=54321
target-user=system
target-pass=你的密码
repo-path=/opt/kingbase/backup
repo-arch-path=/opt/kingbase/backup/archive
oper-user=kingbase
这份跟 kingbase.conf 不是一回事啊——前者是告诉 sys_rman 工具去哪连库、备份往哪存;后者是数据库自己的运行参数。两套东西各管各的,别搞混了。
然后执行初始化:
cd /opt/kingbase/install/Server/bin
./sys_backup.sh init
./sys_backup.sh start
init 这一步做的事情挺多的:校验仓库能不能写、创建 stanza(给实例贴个标签用的)、做一次全量基线备份、跑一轮归档自测。任何一步不过直接报错,不会让你带着隐患往下走。start 是把定时任务挂进系统 crontab。
其实 init 内部等价于这两条命令,知道的话排错方便:
# 创建 stanza(实例标签,备份前必须有)
./sys_rman --config=/opt/kingbase/backup/sys_rman.conf --stanza=kingbase stanza-create

# 自检:仓库、归档、链路通不通
./sys_rman --config=/opt/kingbase/backup/sys_rman.conf --stanza=kingbase check
check 通过会打印一堆 ok,看着挺爽的。这一步能提前暴露仓库不可写、归档命令不通之类的问题,比真到了要恢复的时候才发现强太多了。
还有一句——仓库目录里面存着备份集状态和 WAL 归属这些元数据,千万别手动去删改里面的文件,否则恢复能力直接废掉。别手贱。
日常备份怎么跑
初始化完了之后日常备份就两条命令的事。全量:
./sys_rman --config=/opt/kingbase/backup/sys_rman.conf --stanza=kingbase backup
增量(只存变过的数据块):
./sys_rman --config=/opt/kingbase/backup/sys_rman.conf --stanza=kingbase --type=incr backup
也支持 --type=diff(差异备份,基于最近一次全量)。很多人搞不清增量和差异的区别。简单说吧,差异备份始终拿最近一次全量做参照,所以越往后备份越大;增量是基于上一次任意备份(不管全量还是增量),只存变化块,最省空间,但恢复的时候得沿着备份链一路往前拼,缺了中间任何一环都不行。我这边 412 MB 的数据目录,全量大概 180 MB,每天增量只有几 MB。线上常见做法是周末做一次全量、工作日做差异、日间再做增量,在空间和恢复速度之间取平衡。
看备份集状态:
./sys_rman --config=/opt/kingbase/backup/sys_rman.conf --stanza=kingbase info
输出长这样:
stanza: kingbase
    status: ok
    db (current)
        wal archive min/max : 000000010000000000000003 / 00000001000000000000000A
        full backup: 20260804-093000F
            timestamp start/stop: 2026-08-04 09:30:00 / 09:31:12
            lsn start/stop     : 0/3000028 / 0/3000138
            database size      : 412MB, backup size: 180MB
        incr backup: 20260804-093000F_20260805-020000I
            timestamp start/stop: 2026-08-05 02:00:00 / 02:00:18
            backup size        : 4.2MB
重点看 wal archive min/max 这行——它告诉你归档里 WAL 覆盖的时间范围。要做 PITR 恢复到某个时间点,那个时间点对应的 WAL 必须在这个区间内,否则恢复不了。
平时顺手确认一下归档是不是真的在流动:
ls -lh /opt/kingbase/backup/archive/kingbase/
看到文件时间戳在更新就说明通了。也可以在库里查:
SELECT archived_count, last_archived_wal FROM sys_stat_archiver;
last_archived_wal 在往前走就没问题。建议把这个检查接到监控里,别靠人肉去看。
来一次真实的 PITR 恢复
假设下午 15:30 有人误执行了 DROP TABLE perf_demo.orders;,但 15:00 还有一批业务数据刚写入。目标:恢复到 15:25——删表之前、且包含那批新数据。
先停库、挪走旧数据目录(先确认备份和归档都在!):
./sys_ctl stop -D /opt/kingbase/data
mv /opt/kingbase/data /opt/kingbase/data_bak_20260804
注意是 mv 不是 rm 啊,旧的留着,万一恢复出来不对还能推倒重来。这一步没得商量——别偷懒直接 rm,出了事哭都没地方哭。
然后 restore 把基础备份铺回去:
./sys_rman --config=/opt/kingbase/backup/sys_rman.conf --stanza=kingbase restore
这步会重建 data 目录并自动写入 restore_command。目标时间需要补进 kingbase.auto.conf:
restore_command = 'sys_rman archive-get --config=/opt/kingbase/backup/sys_rman.conf --stanza=kingbase %f %p'
recovery_target_time = '2026-08-04 15:25:00'
recovery_target_action = 'pause'
recovery_target_action='pause' 就是重放到 15:25 后暂停,库处于只读恢复态,给你机会上去验数据。除了 pause 还有 promote(直接打开结束恢复)和 shutdown(到了就关库)。我个人习惯用 pause,毕竟恢复完不验一下就开出去,万一不对更麻烦。
嫌手动改配置麻烦的话,一步到位也行:
./sys_rman --config=/opt/kingbase/backup/sys_rman.conf \
  --stanza=kingbase --target-time='2026-08-04 15:25:00' restore
工具会自动把时间写进去。
接着启动库进入恢复模式:
./sys_ctl start -D /opt/kingbase/data
启动后看日志能看到它在不断回放 WAL,到达 15:25 后暂停。这时候连上去验证:
\c test
SELECT count(*) FROM perf_demo.orders;
-- 应该返回 5000000
表还在,数据完整。没问题的话结束恢复:
SELECT sys_wal_replay_resume();
执行完库脱离恢复模式,正常读写。整个过程没动过原来的 data_bak_20260804,随时可以重来。
恢复成功后数据目录会多出一个 .history 文件,比如 00000002.history:
ls /opt/kingbase/data/*.history
这说明本次恢复产生了一条新时间线(timeline)。每次 PITR 恢复都会进新时间线,避免"恢复出来的日志"和"原来的日志"打架。以后想换个时间点恢复?直接重跑 restore --target-time=... 就行,时间线继续递增。
几件日常要注意的事
备份策略这块我们线上是每天一次全量(cron 默认就会跑),业务高峰期中间再加几次增量。这样恢复的时候选"最近的全量 + 中间的增量 + 归档 WAL 重放",比纯靠全量恢复快得多。
备份越来越多仓库迟早被撑爆。设个保留策略让它自动清理:
repo1-retention-full=7
repo1-retention-full-type=count
repo1-path=/opt/kingbase/backup
意思是保留最近 7 份全量,超出的连同依赖的增量一起回收。注意只要某份全量还在保留期内,它依赖的 WAL 归档就不会被删,PITR 能力不受影响。
监控方面盯两件事就够了:归档延迟(仓库里的 WAL 跟不上主库产生的速度),以及最后一次成功备份的时间。这两个任何一个异常容灾就有缺口。接到告警群里吧,人肉巡检不靠谱,半夜三更谁盯着看啊。
最后这条最重要——备份不做恢复验证等于没备份。每个月拿最近的备份在隔离环境里 restore 一次,确认能起来、数据对得上。真出事了你才知道流程哪里会卡住。我们现在是写进了每月运维清单里强制执行的,不跑完不算完。
踩坑记录
说几个我踩过的坑。
有一次归档命令一直失败,pg_wal 堆了几十个 G,磁盘直接报警。原因是开 archive_mode 前没确认仓库路径可写,修了权限就好了。这种问题排查起来其实不难,就是出事的时候慌。
还有一次 info 报 WAL 缺失,恢复直接报错退出。查了半天发现有人觉得归档占空间,手动删了一段。补回来才恢复成功。所以归档目录千万不能手动删,哪怕看着没用。
恢复完库只读那次也挺有意思。业务那边反馈连不上数据库,以为恢复了其实没完——忘了跑 sys_wal_replay_resume(),pause 模式下库确实只读。这事儿后来变成了我们组里的段子。
最坑的是手动改了 sys_rman.conf,备份行为变得很奇怪,查了半天发现改错了一个路径。后来直接用 init 重新生成了一份,再也不手改了。
还有个低级错误——仓库和数据放同一块盘,结果盘坏了备份也没了。后来迁到独立磁盘上。这种常识性的东西真出事的时候才会想起来。
最后
sys_rman 这套东西上手不难,真要靠得住就两件事:归档链路不能断,恢复流程要练熟。它和 sys_dump 不是替代关系——sys_dump 适合跨版本迁移或者单表级恢复,物理备份加归档才是整机崩溃和时间点回滚的正解。
前面说的那位同事删表的事之后,我们把恢复演练写进了每月运维清单。到现在还没再出过大事故,希望你们也用不上这套恢复流程吧。但真要用的时候,至少得确保它真能跑通——不然备份做了等于白做。

AtomGit 是由开放原子开源基金会联合 CSDN 等生态伙伴共同推出的新一代开源与人工智能协作平台。平台坚持“开放、中立、公益”的理念,把代码托管、模型共享、数据集托管、智能体开发体验和算力服务整合在一起,为开发者提供从开发、训练到部署的一站式体验。
更多推荐



 7
 0
- 0


 已为社区贡献50条内容

所有评论(0)