手写 priority_queue + 仿函数,一次把堆和比较器彻底吃透
前言
优先级队列这东西,刷力扣的同学肯定不陌生。std::priority_queue 默认是大顶堆,想要小顶堆得写成 priority_queue<int, vector<int>, greater<int>>,麻烦得很。很多人只停留在"会用"的层面,至于它底层怎么实现的、那个 greater<int> 到底是什么玩意,一问就卡壳。
这篇文章就带你从零撸一个 priority_queue,顺便把仿函数(Functor)这层窗户纸捅破。代码不玩花活,确保你在任何老项目里都能直接抄。
一、堆的本质:向上调整 & 向下调整
priority_queue 的底层就是一个堆(Heap),用数组存储,利用下标关系模拟二叉树。两个核心操作:
- push:把新元素塞到数组末尾,然后"向上调整"到正确位置。
- pop:把堆顶和最后一个元素交换,删掉最后一个,然后从根节点"向下调整"。
我们先来看一下库里面的使用 -
priority_queue<int, vector, greater> pq;
pq.push(4);
pq.push(1);
pq.push(5);
pq.push(7);
pq.push(9);
while (!pq.empty())
{
cout << pq.top() << " ";
pq.pop();
}
cout << endl;
return 0;
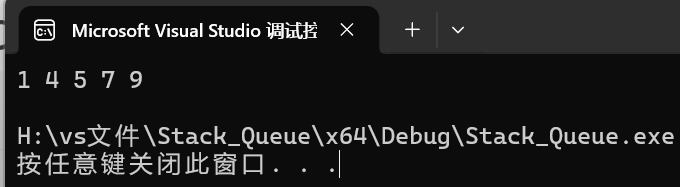
int main ()
{
priority_queue<int, vector<int>, greater<int>> pq;
pq.push(4);
pq.push(1);
pq.push(5);
pq.push(7);
pq.push(9);
while (!pq.empty())
{
cout << pq.top() << " ";
pq.pop();
}
cout << endl;
return 0;
}
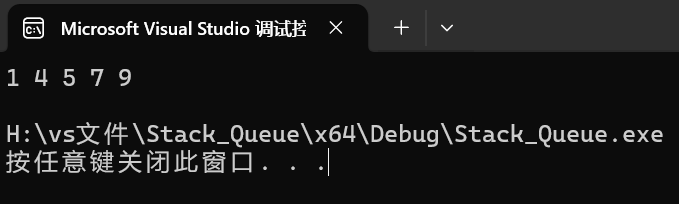
向上调整(AdjustUp)
新来的元素一开始待在数组最后面,也就是堆的最底层。我们拿它跟父节点比:如果比父节点大(大顶堆的逻辑),就交换,然后继续往上比,直到爬到合适的位置或者成为根节点。
怎么找父节点?数组下标从 0 开始,下标为 child 的节点,它爹的下标就是 (child - 1) / 2。这个公式拿张草稿纸画一下二叉树就明白了。
void Adjustup(int child)
{
    Compare com;
    size_t parent = (child - 1) / 2;
    while (child > 0)
    {
        if (com(_con[parent], _con[child]))
        {
            swap(_con[child], _con[parent]);
            child = parent;
            parent = (child - 1) / 2;
        }
        else
        {
            break;
        }
    }
}
注意这里的比较方向:com(_con[parent], _con[child])。如果仿函数 com 是 Less(即 a < b),那这个条件就是"父节点 < 子节点",满足就交换——这就是大顶堆的逻辑,大的往上浮。
向下调整(AdjustDown)
pop 的时候,先把堆顶和最后一个元素交换,然后删掉最后一个(原来的堆顶就这么没了)。新的堆顶是从底部换上来,大概率不满足堆的性质,需要一路往下沉。
向下调整的逻辑:从当前节点出发,找到左右孩子中"更符合堆性质"的那个(大顶堆就找更大的孩子),跟当前节点比,如果当前节点不如那个孩子,就交换,继续往下。
void AdjustDown(int parent)
{
    size_t child = parent * 2 + 1;  // 左孩子下标
    Compare com;
    while (child < _con.size())
    {
        // 如果有右孩子,且右孩子比左孩子更"优先"
        if (child + 1 < _con.size() && com(_con[child + 1], _con[child]))
        {
            ++child;
        }
        // 如果孩子比父节点更"优先",交换
        if (com(_con[child], _con[parent]))
        {
            swap(_con[child], _con[parent]);
            parent = child;
            child = parent * 2 + 1;
        }
        else
        {
            break;
        }
    }
}
这两个算法是堆的命根子。理解了它们,priority_queue 剩下的接口都是搭积木,向下调整和向上调整我们在之前讲过,不熟悉的小哥哥小姐姐可以去看之前的内容
堆算法基础
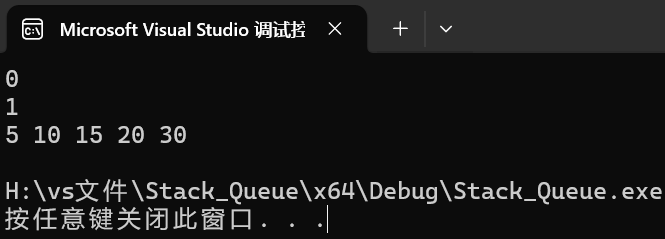
int main()
{
	int myints[] = { 10,20,30,5,15 };
	sort(myints, myints + 5);
	std::vector<int> v(myints, myints + 5);
	cout << is_heap(v.begin(), v.end());
	cout << endl;
	make_heap(v.begin(), v.end());
	cout << is_heap(v.begin(), v.end());
	cout << endl;
	std::sort_heap(v.begin(), v.end());

	for (auto e : v)
	{
		cout << e << " ";
	}
	cout << endl;
	return 0;
}
-
初始状态
sort()后v = {5, 10, 15, 20, 30}(升序)
→ 不是最大堆(最大堆要求根节点为最大值,但此处最大值30在末尾) -
is_heap()检查- 输入:升序序列
{5,10,15,20,30} - 输出:
0(false) - 原因:堆性质要求
v[0]必须是最大值,但此处v[0]=5是最小值
- 输入:升序序列
-
make_heap()构建堆- 将序列转为最大堆(如
{30,20,15,5,10}) - 堆性质:
v[0] = 30(最大值)- 所有父节点 ≥ 子节点(例如
v[0] ≥ v[1]且v[0] ≥ v[2])
- 将序列转为最大堆(如
-
sort_heap()排序- 前提:输入必须是合法堆(由
make_heap保证) - 结果:堆被转为升序序列
{5,10,15,20,30} - 注意:排序后堆结构被破坏,不能再调用堆操作函数
- 前提:输入必须是合法堆(由
二、仿函数是个啥?
上面代码里反复出现的 Compare com 就是仿函数。说白了,仿函数就是一个重载了 operator() 的类,让对象可以像函数一样被调用。
template <class T>
class Less
{
public:
    bool operator()(const T& x, const T& y)
    {
        return x < y;
    }
};

template <class T>
class Greater
{
public:
    bool operator()(const T& x, const T& y)
    {
        return x > y;
    }
};
用法很简单:
Less<int> lessfunc;
cout << lessfunc(1, 2) << endl;           // 输出 1 (true, 1<2)
cout << lessfunc.operator()(1, 2) << endl; // 等价写法
lessfunc(1, 2) 看起来像函数调用,实际上调用的是 lessfunc.operator()(1, 2)。这就是"仿函数"名字的由来——长得像函数,本质是对象。
为什么不用函数指针?
函数指针当然也能传比较逻辑,但仿函数是类型的一部分,可以作为模板参数。编译器在编译期就知道要调用哪个 operator(),可以直接内联优化,性能比函数指针高出一截。而且仿函数可以携带状态,函数指针做不到。
实战:用仿函数改造冒泡排序
传统冒泡排序把比较逻辑写死了:
if (a[i] < a[i-1]) // 只能升序
用了仿函数之后:
template<class Compare>
void bubbleSort(int* a, int n, Compare com)
{
    for (int j = 0; j < n; j++)
    {
        int flag = 0;
        for (int i = 1; i < n - j; i++)
        {
            if (com(a[i], a[i - 1]))
            {
                swap(a[i - 1], a[i]);
                flag = 1;
            }
        }
        if (flag == 0)
            break;
    }
}
同一个函数,传 Less<int>() 就是升序,传 Greater<int>() 就是降序,零成本抽象。
三、完整的 priority_queue 实现
把上面的零件组装起来:
template<class T, class Container = vector<T>, class Compare = Less<T>>
class priority_queue
{
public:
    void push(const T& x)
    {
        _con.push_back(x);
        Adjustup(_con.size() - 1);
    }

    void pop()
    {
        swap(_con[0], _con[_con.size() - 1]);
        _con.pop_back();
        AdjustDown(0);
    }

    const T& top()
    {
        return _con[0];
    }

    size_t size() const
    {
        return _con.size();
    }

    bool empty() const
    {
        return _con.empty();
    }

private:
    void Adjustup(int child)   { /* 见上文 */ }
    void AdjustDown(int parent) { /* 见上文 */ }
    Container _con;
};
三个模板参数:
| 参数 | 含义 | 默认值 |
|---|---|---|
T | 存储的元素类型 | 无(必须指定) |
Container | 底层容器 | vector<T> |
Compare | 比较仿函数 | Less<T>(大顶堆) |
默认 Less<T> 是大顶堆——因为 Less 是 a < b,在 AdjustUp 里 com(parent, child) 为真时交换,也就是父小于子的时候交换,大的往上走。
想用小顶堆?传 Greater<T> 就行,com(parent, child) 变成 parent > child,父大于子时交换,小的往上走。
四、自定义类型怎么玩?
场景一:存储 Date 对象(大顶堆)
Date 类自己重载了 < 和 >:
class Date
{
public:
    bool operator<(const Date& d) const
    {
        return (_year < d._year) ||
            (_year == d._year && _month < d._month) ||
            (_year == d._year && _month == d._month && _day < d._day);
    }
    bool operator>(const Date& d) const { /* 对称实现 */ }
private:
    int _year, _month, _day;
};
直接用默认的大顶堆就行:
priority_queue<Date> q1;
q1.push(Date(2018, 10, 29));
q1.push(Date(2018, 10, 28));
q1.push(Date(2018, 10, 30));
cout << q1.top() << endl;  // 2018-10-30,最大的日期在堆顶
场景二:存储指针(需要自定义仿函数)
如果存的是 Date*,默认的 Less<Date*> 比较的是指针地址,而不是日期本身。这显然不对。此时需要自己写一个仿函数:
class Dateless
{
public:
    bool operator()(Date* p1, Date* p2)
    {
        return *p1 < *p2;  // 解引用后比较 Date 对象
    }
};

priority_queue<Date*, vector<Date*>, Dateless> q2;
q2.push(new Date(2018, 10, 29));
q2.push(new Date(2018, 10, 28));
q2.push(new Date(2018, 10, 30));
cout << *q2.top() << endl;  // 2018-10-30,按日期值排的
这个场景很经典:STL 默认的比较器处理不了指针语义,仿函数给了我们介入比较逻辑的入口。
五、总结
一张表收尾:
| 概念 | 一句话解释 |
|---|---|
| 堆 | 用数组模拟的完全二叉树,父子下标有固定关系 |
| 向上调整 | 新元素从末尾往上浮,时间复杂度 O(log n) |
| 向下调整 | 堆顶元素往下沉,时间复杂度 O(log n) |
| 仿函数 | 重载了 operator() 的类,对象能当函数用 |
| 模板参数 Compare | 把比较逻辑从算法中剥离,编译期多态,零开销 |
搞懂了这些,你就不是 priority_queue 的"调包侠"了。下次面试官让你手写堆排序或者聊聊仿函数和函数指针的区别,直接拿这篇文章的内容怼上去就行。

AtomGit 是由开放原子开源基金会联合 CSDN 等生态伙伴共同推出的新一代开源与人工智能协作平台。平台坚持“开放、中立、公益”的理念,把代码托管、模型共享、数据集托管、智能体开发体验和算力服务整合在一起,为开发者提供从开发、训练到部署的一站式体验。
更多推荐



 5
 0
- 0


 已为社区贡献14条内容

所有评论(0)