2026 最新:解决 DeepSeek / 豆包 API 频繁 429 Too Many Requests 的姿势(附生产级重试代码)
最近把业务从 GPT 切换到 DeepSeek 和火山引擎(豆包 API),发现这两家的流控(Rate Limit)抓得非常紧。稍微跑几个并发,控制台就疯狂弹出 429 Too Many Requests。
尤其是 DeepSeek,最近由于全网调用量激增,哪怕你没到 RPM(每分钟请求数)上限,服务器偶尔也会因为过载主动吐出 429。本文配套的完整重试代码、多模型自动切换实现、429错误速查表,我整理成了一个资源包放在文末,包含文章里提到但没展开写的异步并发版和Hybrid Routing完整代码,可以直接拿去用。
这篇文章不废话,直接聊聊怎么通过指数退避(Exponential Backoff)算法优雅地处理 429 报错,并给出我自己在生产环境下用的重试代码。
1. 现象描述:报错日志
当你看到类似下面的报错时,说明你被限流了:
code Text
downloadcontent_copy
expand_less
openai.RateLimitError: Error code: 429 - {'error': {'message': 'Rate limit reached', 'type': 'requests', 'param': None, 'code': 'rate_limit_exceeded'}}
或者在火山引擎(豆包)接口中返回:
code Text
downloadcontent_copy
expand_less
{"error":{"code":"ResourceExhausted","message":"request limit reached"}}
2. 为什么会 429?
除了你充钱不够(Tier等级低)之外,主要卡在两个维度:
- RPM (Requests Per Minute) :每分钟请求数。
- TPM (Tokens Per Minute) :每分钟消耗的 Token 总量。
对于 429,直接 retry 是没用的,因为你立刻重试依然大概率在同一个限流窗口内。
3. 生产级解决方案:指数退避重试
解决 429 最稳的方法是:发现限流 -> 等待 t 秒 -> 再试 -> 还不行 -> 等待 2t 秒 -> 再试… 。
为了防止多个线程在同一秒同时重试(惊群效应),我们还需要给等待时间加一个随机抖动(Jitter) 。
方案 A:原生 Python 实现(不依赖第三方库)
适合写简单的脚本。
code Python
downloadcontent_copy
expand_less
import time
import random
from openai import OpenAI

client = OpenAI(api_key="你的KEY", base_url="https://api.deepseek.com")

def chat_with_retry(prompt, max_retries=5):
    base_delay = 1  # 基础等待1秒
    for i in range(max_retries + 1):
        try:
            response = client.chat.completions.create(
                model="deepseek-chat",
                messages=[{"role": "user", "content": prompt}]
            )
            return response
        except Exception as e:
            if "429" in str(e) and i < max_retries:
                # 计算等待时间:2^i + 随机抖动
                wait_time = base_delay * (2 ** i) + random.uniform(0, 1)
                print(f"⚠️ 触发流控,第 {i+1} 次重试,等待 {wait_time:.2f}s...")
                time.sleep(wait_time)
                continue
            raise e

# 使用
# res = chat_with_retry("帮我写个Java单例模式")
方案 B:使用 Tenacity 库(推荐,更优雅)
生产环境下,我更倾向于用 tenacity 这个库,代码逻辑非常干净。
code Python
downloadcontent_copy
expand_less
from tenacity import retry, stop_after_attempt, wait_random_exponential, retry_if_exception

def is_rate_limit_error(exception):
    # 只要报错里带 429 或者是 RateLimitError 就重试
    return "429" in str(exception)

@retry(
    wait=wait_random_exponential(min=1, max=60), # 最小等1秒,最大等60秒,指数增长
    stop=stop_after_attempt(6),                  # 最多试6次
    retry=retry_if_exception(is_rate_limit_error),
    reraise=True
)
def get_completion(prompt):
    return client.chat.completions.create(
        model="deepseek-chat",
        messages=[{"role": "user", "content": prompt}]
    )
4. 进阶:如何彻底规避 429?
靠重试只是被动防御,如果你是做爬虫或者大规模数据处理,建议从源头控制:
-
异步并发控制(Semaphore) :
如果你用 asyncio,一定要加信号量,控制同时发出的请求数。code Python
downloadcontent_copy
expand_less
sem = asyncio.Semaphore(5) # 最多同时跑5个并发 async with sem: await call_api(...) -
多模型分流(Hybrid Routing) :
代码逻辑里写一个 Fallback。比如 DeepSeek 429 了,自动切换到豆包 API,或者切换到硅基流动(SiliconFlow)的 API。 -
本地缓存:
对于相同的 Prompt,一定要做 Redis 缓存。
429 不是 Bug,是平台对资源的一种保护。作为开发者,我们要做的就是在代码里预见并处理它。
我整理成了一个更完整的版本,包含:
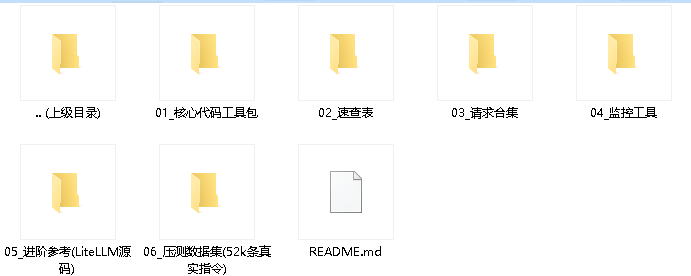
- 重试工具包(原生版 + Tenacity版 + 异步并发版)
- 多模型自动切换(DeepSeek 429 自动切豆包/硅基流动)
- Redis缓存装饰器
- 国内主流大模型限流机制对比表 + HTTP错误码速查卡
- 5家平台curl鉴权示例
- 实时RPM/TPM监控脚本
- 进阶参考:LiteLLM核心源码摘录
- 52k条真实指令压测数据集
链接:https://pan.quark.cn/s/0c190e2f9e96
提取码:FRWG
如果你在对接 DeepSeek 或火山引擎时遇到了更奇怪的报错(比如 503 或 Connection Timeout),欢迎在评论区贴出来,我最近踩了不少坑,可以交流一下。

AtomGit 是由开放原子开源基金会联合 CSDN 等生态伙伴共同推出的新一代开源与人工智能协作平台。平台坚持“开放、中立、公益”的理念,把代码托管、模型共享、数据集托管、智能体开发体验和算力服务整合在一起,为开发者提供从开发、训练到部署的一站式体验。
更多推荐



 6
 0
- 0


 已为社区贡献13条内容

所有评论(0)