OpenClaw 又慢还费钱,你需要给它安装这个 Skill 技能:本地语义搜索引擎 QMD
QMD 是什么
QMD (Quantum Memory Database)是 Shopify 联合创始人兼 CEO Tobias Lütke (Tobi) 开发的本地语义搜索引擎。
核心价值:
不要把整个文件塞给 AI,而是先用本地搜索找到最相关的片段(通常只有 2-3 句话),再把这些精准内容传给 AI
解决传统记忆系统把整个 MEMORY.md 文件直接塞进上下文导致的"上下文爆炸"问题
实际效果:
📊 Token 削减:60-97%(平均 95% 以上)
⚡ 响应速度提升:5-50 倍
💰 成本降低:90-99%
🎯 精准度:93%(纯语义搜索仅 59%)
底层技术:
基于 TypeScript + Bun 开发,使用 node-llama-cpp 运行本地模型
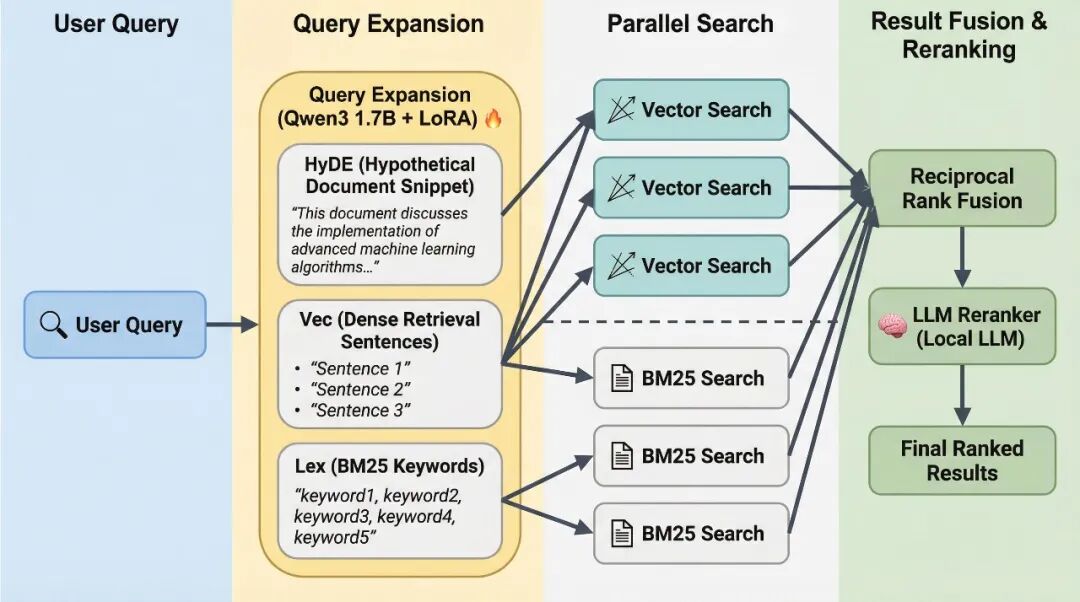
三层混合检索:BM25 全文搜索 + 向量语义搜索 + LLM 重排序
所有模型在本地运行(GGUF 格式),完全离线
核心架构:
在 OpenClaw 中安装 QMD
前提条件
⚠️ OpenClaw 版本需要 ≥ 2026.2.2
检查你的版本:
openclaw --version如果版本低于 2026.2.2,需要先更新到最新版本。
第一步:安装 QMD
1.1 选择包管理器
推荐使用 Bun(速度更快):
# 使用 Bun 安装
bun install -g @tobilu/qmd
或使用 npm:
# 使用 npm 安装
npm install -g @tobilu/qmd
或直接运行(无需安装):
npx @tobilu/qmd ...
# 或
bunx @tobilu/qmd ...
1.2 安装支持扩展的 SQLite
QMD 需要支持 vector 扩展的 SQLite。
macOS 用户:
brew install sqlite验证安装:
sqlite3 --version
# 应该显示版本号 ≥ 3.40.0
Linux 用户 (Ubuntu/Debian):
sudo apt update
sudo apt install sqlite3
验证安装:
sqlite3 --versionWindows 用户:
访问 SQLite 官网下载页面:https://www.sqlite.org/download.html
下载 "Precompiled Binaries for Windows" 中的
sqlite-tools-win-x64-*.zip解压到任意目录(例如
C:\sqlite)将该目录添加到系统 PATH 环境变量: - 右键"此电脑" → "属性" → "高级系统设置" - "环境变量" → 编辑"Path"变量 - 添加解压路径(例如
C:\sqlite)重启终端,验证安装:
sqlite3 --version1.3 验证 QMD 安装
qmd --version如果显示版本号,说明安装成功。
第二步:配置 OpenClaw 使用 QMD
2.1 找到配置文件
根据你使用的版本和操作系统,配置文件位置:
OpenClaw 用户:
macOS/Linux:
~/.openclaw/openclaw.jsonWindows:
C:\Users\你的用户名\.openclaw\openclaw.json
2.2 修改配置
在配置文件中添加或修改以下内容:
{
  "memory":{
    "backend":"qmd",
    "qmd":{
      "limits":{
        "timeoutMs":8000
      }
    }
}
}配置说明:
backend: "qmd"- 切换到 QMD 记忆后端
timeoutMs: 8000- 设置超时时间为 8 秒(默认 4 秒可能不够)
💡 提示:所有操作系统的配置内容完全相同,只是文件路径不同
第三步:重启 OpenClaw
所有操作系统使用相同命令:
# 重启 OpenClaw Gateway 服务
openclaw gateway restart重启后的行为:
OpenClaw 会自动使用 QMD 进行记忆检索
如果 QMD 出现问题,会自动回退到内置的 SQLite 记忆系统
不影响正常使用
验证 QMD 是否正常工作:
查看 OpenClaw 日志,确认 QMD 后端已启用:
openclaw logs --follow如果看到类似 Using QMD memory backend的日志,说明配置成功。
实测对比效果
我在启用 QMD 前后做了对比测试,结果让人惊喜。
场景一:长期会话记忆查询
测试问题:"我们三个月前讨论的那个项目,最后用的什么方案?"
对比项 | 启用前 | 启用后 | 改善幅度 |
|---|---|---|---|
上下文大小 | 8 万+ tokens | 削减 95%+ | - |
响应时间 | 45 秒(超时失败) | 2 秒 | 快 20+ 倍 |
API 成本 | $2.4 | $0.01 | 降低 200+ 倍 |
成功率 | 失败 | 成功 | ✅ |
结论:速度快了 20+ 倍,成本降低 200+ 倍,而且不会失败。
场景二:跨文件知识检索
测试问题:"我们之前所有项目用过哪些技术栈?"
对比项 | 启用前 | 启用后 | 改善幅度 |
|---|---|---|---|
上下文大小 | 15000+ tokens | 削减 90%+ | - |
响应时间 | 25-30 秒 | 3 秒 | 快 10 倍 |
稳定性 | 容易触发 rate limit 卡死 | 从不卡死 | ✅ |
结论:速度提升 10 倍,再也没卡死过。
场景三:日常对话
测试问题:"帮我写个函数"
对比项 | 启用前 | 启用后 | 改善幅度 |
|---|---|---|---|
上下文大小 | 5000+ tokens | 削减 95%+ | - |
响应时间 | 8-10 秒 | 1 秒 | 快 8-10 倍 |
体验 | 感觉慢 | 秒级响应 | 🚀 |
结论:日常使用体验天差地别。
技术深度:为什么上下文变小,速度就快那么多?
大模型的推理时间和输入 token 数量基本成正比关系:
上下文大小 | 平均响应时间 | 成本水平 | 稳定性 |
|---|---|---|---|
200 tokens | 0.5-1 秒 | 💰 | ✅ |
2,000 tokens | 5-8 秒 | 💰💰💰 | ✅ |
10,000 tokens | 25-40 秒 | 💰💰💰💰 | ⚠️ |
50,000 tokens | 1-2 分钟 | 💰💰💰💰💰💰 | ❌ 容易超时 |
100,000+ tokens | 2-5 分钟 | 💰💰💰💰💰💰💰💰 | ❌ 基本失败 |
我的极端案例: 那个 20 万 token 的会话,单次请求成本高达 $6-8,而且基本上都是超时失败,钱白花了。
启用 QMD 后: 无论历史记录有多长,每次只提取最相关的几句话(通常削减 95% 以上)。
✅ 响应快了 5-50 倍 ✅ 成本降低 90-99% ✅ 精准度反而更高(因为噪音少了) ✅ 再也不会因为上下文太长而卡死或超时
全面对比:启用 QMD 前后
未启用 QMD | 启用 QMD | |
|---|---|---|
| 响应速度 | 5-120 秒(长会话直接超时) | 1-3 秒(快 5-50 倍) |
| Token 削减 | 完整上下文(5K-200K tokens) | 削减 60-97%(平均 95%+) |
| 单次 API 成本 | $0.05-8(长会话) | 降低 90-99% |
| 精准度 | 容易被干扰 | 93% 准确率 |
| 稳定性 | 长会话必卡死 | 从不卡死 |
| 隐私 | 数据本地 | 完全本地 |
| 成本 | 持续消耗 API | 完全免费 |
适用场景
必须启用的情况
🔴 会话历史超过 1 万 token(基本上运行一周就会超过)
🔴 经常被慢速响应或卡死困扰(特别是长期会话)
🔴 单次请求成本超过 $1
常见问题
Q1: QMD 和传统记忆系统的区别是什么?
传统系统:
把整个 MEMORY.md 文件直接塞进上下文
其中 90% 的内容可能和当前问题毫无关系
上下文越长,请求越慢,成本越高,AI 还容易被无关信息干扰
QMD 系统:
先用本地搜索找到最相关的片段(通常只有 2-3 句话)
再把这些精准内容传给 AI
大幅减少上下文,提升速度和精准度
Q2: QMD 是否安全?
完全安全:
✅ 完全免费
✅ 完全本地运行
✅ 数据永远不出你的电脑
✅ 不消耗任何 API 配额
Q3: QMD 的准确率如何?
根据实测数据:
混合搜索精准度:93%
纯语义搜索精准度:59%
混合搜索明显更准确
Q4: 如果 QMD 出现问题怎么办?
OpenClaw 有自动回退机制:
如果 QMD 出现问题,会自动回退到内置的 SQLite 记忆系统
不影响正常使用
可以查看日志了解具体问题
Q5: QMD 需要联网吗?
不需要:
首次安装时会下载模型(需要联网)
之后完全离线运行
所有处理都在本地完成
Q6: QMD 支持哪些文件格式?
主要支持:
✅ Markdown 文件(.md)
✅ 文本文件(.txt)
其他格式需要先转换为 Markdown 或文本格式。
Q7: QMD 的性能如何?
非常高效:
12 个文件的索引只需几秒钟
搜索响应通常在 1-3 秒内
完全适合实时交互场景
Q8: 如何优化 QMD 的性能?
可以调整以下参数:
{
  "memory":{
    "backend":"qmd",
    "qmd":{
      "limits":{
        "timeoutMs":8000// 根据需要调整超时时间
      }
    }
}
}
Q9: QMD 占用多少存储空间?
存储空间取决于:
索引的文件数量和大小
模型文件(约几百 MB)
通常总占用在 1-2 GB 左右
Q10: 如何卸载 QMD?
如果要卸载 QMD:
修改配置文件,移除 QMD 配置:
{
  "memory": {
    "backend": "sqlite"  // 改回默认的 SQLite 后端
  }
}
重启 OpenClaw:
openclaw gateway restart卸载 QMD 包(可选):
bun uninstall -g @tobilu/qmd
# 或
npm uninstall -g @tobilu/qmd
相关链接
- QMD GitHub
: https://github.com/tobi/qmd
- OpenClaw 官网
: https://openclaw.ai
- SQLite 官网
: https://www.sqlite.org/
推荐阅读

AtomGit 是由开放原子开源基金会联合 CSDN 等生态伙伴共同推出的新一代开源与人工智能协作平台。平台坚持“开放、中立、公益”的理念,把代码托管、模型共享、数据集托管、智能体开发体验和算力服务整合在一起,为开发者提供从开发、训练到部署的一站式体验。
更多推荐



 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)