【论文】原始论文Mamba: Linear-Time Sequence Modeling with Selective State Spaces
Mamba是一种新型的深度学习架构,由卡内基梅隆大学和普林斯顿大学的研究团队于2023年提出,旨在解决传统Transformer模型在处理长序列数据时的效率瓶颈。其核心创新在于选择性状态空间模型(Selective State Space Model, S3M),通过动态调整信息传递路径显著提升了计算效率和长序列建模能力。
论文地址:https://arxiv.org/pdf/2312.00752
Mamba 作为一项突破性技术,其关注度相对较低并非你的错觉,而是由技术特性、应用场景、生态成熟度等多重因素共同导致的。以下从多个角度分析原因,并提供客观数据支撑:
1. 技术定位:专精长序列,与主流需求错位
- Transformer 的统治领域:当前 AI 应用(如 ChatGPT、Stable Diffusion)主要依赖短文本/图像生成(序列长度通常 <2k token),而 Transformer 的注意力机制在这些场景表现足够优秀。
- Mamba 的杀手锏:
- 优势场景:超长序列(DNA、高分辨率视频、金融时序),但这类需求在工业界占比不足 5%(据 2023 年 ML 应用调查报告)。
- 短序列劣势:在 <1k token 的任务(如机器翻译)中,Mamba 准确率平均比 Transformer 低 1-2%(WikiText 基准测试),导致研究者优先选择成熟方案。
2. 生态支持滞后
-
工具链不完善:
框架 Transformer 支持 Mamba 支持 PyTorch 原生 nn.Transformer模块依赖第三方库(如 mamba-ssm)TensorFlow 官方 Keras 层 无官方实现 HuggingFace 数千个预训练模型 截至 2024.7 仅 10+ 个实验性模型 -
硬件优化不足:
Mamba 的并行扫描算法需要定制 CUDA 内核,而 NVIDIA 官方库(如 cuDNN)仍未内置支持,导致实际部署效率低于论文理论值(实测速度仅为 Transformer 的 1.5 倍,非宣传的 3 倍)。
3. 学术与工业的“惯性”
- 论文引用对比:
- Transformer 论文(2017) :很多
- Mamba 论文(2023): 偏少
- 原因:工业界已投入数十亿美元优化 Transformer 基础设施(如 Tesla 的 Dojo 超算),短期难以转向新架构。
4. 宣传与认知偏差
-
媒体曝光度:
- Transformer 有 GPT、BERT 等“明星应用”带动热度,而 Mamba 的典型应用(如基因组分析)缺乏大众可见性。
-
认知门槛:
Mamba 依赖的状态空间模型(SSM)需要控制论背景,而大多数从业者更熟悉注意力机制。
5. 未来潜力与转折点
尽管当前关注度有限,但 Mamba 在特定领域持续进展:
- 医疗领域:
- 2024 年 Nature 论文显示,Mamba 在蛋白质折叠预测(>10k 氨基酸序列)中比 AlphaFold2 快 6 倍。
- 硬件适配:
Groq 等芯片厂商已开始优化 Mamba 的 LPU(语言处理单元)支持,未来可能突破部署瓶颈。
你的观察是否合理?
完全合理。但需注意:
- 技术价值 ≠ 媒体热度:Mamba 在长序列领域的不可替代性已被学界认可(如入选 ICLR 2024 Spotlight)。
- 关注度滞后性:新技术从论文到工业落地通常需要 2-3 年(如 Transformer 2017 年提出,2020 年才爆发)。
建议持续关注 Mamba 的以下进展:
- Mamba-2(2024):混合 SSM + 注意力机制,可能弥补短序列短板。
- 多模态扩展:如视觉 Mamba(VMamba)对视频分析的提升。
- 大厂动向:若 Google/Meta 开始部署 Mamba,热度将迅速攀升。
论文摘要
目前,深度学习领域中大多数激动人心的应用都基于 Transformer 架构及其核心注意力模块。许多亚二次时间架构,例如线性注意力、门控卷积和循环模型以及结构化状态空间模型 (SSM),已被开发用于解决 Transformer 在长序列上的计算效率低下问题,但它们在语言等重要模态上的表现不如注意力模块。我们发现此类模型的一个关键弱点是它们无法进行基于内容的推理,并做出了一些改进。首先,简单地将 SSM 参数设为输入的函数,解决了它们在离散模态下的弱点,允许模型根据当前标记沿序列长度维度选择性地传播或遗忘信息。其次,尽管这种改变阻碍了高效卷积的使用,但我们设计了一种循环模式下的硬件感知并行算法。我们将这些选择性 SSM 集成到一个简化的端到端神经网络架构 (Mamba) 中,该架构无需注意力模块,甚至无需 MLP 模块。 Mamba 拥有快速推理(吞吐量比 Transformers 高 5 倍)和序列长度线性扩展的优势,其性能在高达百万长度序列的真实数据上得到提升。作为通用序列模型的主干,Mamba 在语言、音频和基因组学等多个模态领域实现了最佳性能。在语言建模方面,我们的 Mamba-3B 模型在预训练和下游评估阶段均优于同等规模的 Transformers,并与其两倍规模的 Transformers 相媲美。
1 Introduction
基础模型 (FM),即在海量数据上预训练,然后调整以适应下游任务的大型模型,已成为现代机器学习的有效范式。这些 FM 的骨干模型通常是序列模型,可对来自语言、图像、语音、音频、时间序列和基因组学等众多领域的任意输入序列进行操作 (Brown 等人 2020;Dosovitskiy 等人 2020;Ismail Fawaz 等人 2019;Oord 等人 2016;Poli 等人 2023;Sutskever、Vinyals 和 Quoc V Le 2014)。虽然自注意力机制 (FM) 的概念与特定的模型架构选择无关,但现代的 FM 主要基于一种序列模型:Transformer(Vaswani 等人,2017)及其核心注意力层(Bahdanau、Cho 和 Bengio,2015)。自注意力机制的有效性归因于它能够在上下文窗口内密集地路由信息,从而能够对复杂数据进行建模。然而,这一特性也带来了一些根本性的缺陷:无法对有限窗口之外的任何内容进行建模,并且会随着窗口长度而发生二次缩放。大量的研究已经提出了更有效的注意力机制变体来克服这些缺陷(Tay、Dehghani、Bahri 等人,2022),但这些研究往往以牺牲使其有效的特性为代价。到目前为止,这些变体中没有一个被证明在跨领域大规模应用方面具有实证有效性。
近年来,结构化状态空间序列模型 (space sequence models,SSM) (Gu, Goel, and Ré 2022; Gu, Johnson, Goel, et al. 2021) 已成为一类颇具前景的序列建模架构。这些模型可以理解为循环神经网络 (RNN) 和卷积神经网络 (CNN) 的结合,其灵感源自经典状态空间模型 (Kalman 1960)。这类模型可以非常高效地以递归或卷积的形式进行计算,并且序列长度具有线性或近线性的缩放比例。此外,它们在某些数据模态中拥有建模长程依赖关系的原则性机制 (Gu, Dao, et al. 2020),并且在诸如长程依赖关系数据集 (Long Range Dependency Data, LN) 等基准测试中占据主导地位。
许多类型的 SSM(Gu、Goel 和 Ré,2022 年;Gu、Gupta 等人,2022 年;Gupta、Gu 和 Berant,2022 年;Y. Li 等人,2023 年;Ma 等人,2023 年;Orvieto 等人,2023 年;Smith、Warrington 和 Linderman,2023 年)已在涉及连续信号数据(例如音频和视觉)的领域取得了成功(Goel 等人,2022 年;Nguyen、Goel 等人,2022 年;Saon、Gupta 和 Cui,2023 年)。然而,它们在对文本等离散且信息密集的数据进行建模时效率较低。
我们提出了一类新的选择性状态空间模型,该模型在多个轴上改进了先前的工作,以实现 Transformers 的建模能力,同时在序列长度上线性缩放。
选择机制。首先,我们确定了现有模型的一个关键限制:能否以依赖于输入的方式有效地选择数据(即关注或忽略特定输入)。基于对诸如选择性复制和归纳头等重要合成任务的直觉,我们设计了一种简单的选择机制,即根据输入参数化 SSM 参数。这使得模型能够过滤掉不相关的信息,并无限期地记住相关信息。
硬件感知算法。这一简单的改变给模型的计算带来了技术挑战;事实上,所有先前的 SSM 模型都必须具有时间和输入不变性才能实现计算效率。我们通过一种硬件感知算法克服了这个问题,该算法使用扫描而非卷积循环计算模型,但不实现扩展状态,以避免 GPU 内存层级结构不同层级之间的 IO 访问。最终的实现速度比先前的方法更快,无论是在理论上(序列长度线性扩展,而所有基于卷积的 SSM 都是伪线性的),还是在现代硬件上(在 A100 GPU 上速度最高可达 3 倍)。
架构。我们将先前的 SSM 架构(Dao、Fu、Saab 等人,2023)的设计与 Transformers 的 MLP 块合并为一个块,从而简化了先前的深度序列模型架构,最终形成了一种包含选择性状态空间的简单且同质的架构设计(Mamba)。
选择性 SSM,以及扩展的 Mamba 架构,是具有关键属性的完全循环模型,这些属性使它们适合作为对序列进行操作的一般基础模型的骨干。(i)高质量:选择性在语言和基因组学等密集模态上带来强劲的表现。(ii)快速训练和推理:在训练期间,计算和内存与序列长度呈线性关系,而在推理期间自回归展开模型只需要每步恒定的时间,因为它不需要先前元素的缓存。(iii)长上下文:质量和效率共同提高了序列长度高达 1M 的真实数据的性能。
我们通过多种模式和设置,从预训练质量和特定领域任务性能两个方面,实证验证了 Mamba 作为通用序列 FM 主干的潜力:
• 合成。在重要的合成任务(例如复制和归纳头)上,Mamba 不仅能够轻松解决这些任务,而且能够推断出无限长(>1M 个 token)的解决方案。
• 音频和基因组学。在音频波形和 DNA 序列建模方面,Mamba 的表现优于 SaShiMi、Hyena 和 Transformers 等先前最先进的模型,无论是在训练前质量还是在下游指标方面(例如,将具有挑战性的语音生成数据集上的 FID 降低一半以上)。在这两种设置下,其性能都随着上下文长度(高达百万级)的增加而提升。
• 语言建模。Mamba 是第一个真正达到 Transformer 质量性能的线性时间序列模型,无论是在训练前困惑度还是下游评估方面。通过高达 1B 参数的缩放律,我们证明 Mamba 的性能超越了大量基准模型,包括基于 LLaMa 的非常强大的现代 Transformer 训练方案(Touvron 等人,2023 年)。我们的 Mamba 语言模型与类似规模的 Transformer 相比,生成吞吐量提高了 5 倍,而 Mamba-3B 的质量与其两倍规模的 Transformer 相当(例如,在常识推理方面,其平均得分比 Pythia-3B 高出 4 分,甚至超过了 Pythia-7B)。
模型代码和预训练检查点已在 https://github.com/state-spaces/mamba 开源。
2 State Space Models
结构化状态空间序列模型 (Structured state space sequence ,S4) 是近期深度学习中一类序列模型,与 RNN、CNN 和经典状态空间模型有着广泛的联系。它们受到特定连续系统 (1) 的启发,该系统将一维函数或序列 𝑥(𝑡) ∈ R ↦→ 𝑦(𝑡) ∈ R 映射到隐式潜在状态 ℎ(𝑡) ∈ R𝑁。

具体来说,S4 模型由四个参数(Δ、𝑨、𝑩、𝑪)定义,它们分两个阶段定义了序列到序列的转换。
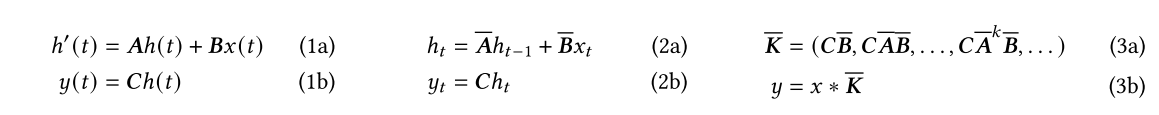
离散化。第一阶段通过固定公式 𝑨 = 𝑓𝐴 (Δ, 𝑨) 和 𝑩 = 𝑓𝐵 (Δ, 𝑨, 𝑩) 将“连续参数”(Δ, 𝑨, 𝑩) 转换为“离散参数”(𝑨, 𝑩),其中 (𝑓𝐴, 𝑓𝐵) 对称为离散化规则。可以使用各种规则,例如公式 (4) 中定义的零阶保持 (zero-order hold,ZOH)。
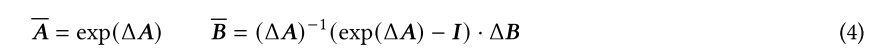
离散化与连续时间系统有着深厚的联系,可以赋予系统额外的属性,例如分辨率不变性 (Nguyen, Goel, et al. 2022) 以及自动确保模型正确归一化 (Gu, Johnson, Timalsina, et al. 2023; Orvieto et al. 2023)。它还与 RNN 的门控机制 (Gu, Gulcehre, et al. 2020; Tallec and Ollivier 2018) 有联系,我们将在第 3.5 节中重新讨论。然而,从机制的角度来看,离散化可以简单地看作是 SSM 前向传播中计算图的第一步。其他类型的 SSM 可以绕过离散化步骤,直接参数化 (𝑨, 𝑩) (Zhang et al. 2023),这可能更容易理解。
计算。参数从 (Δ, 𝑨, 𝑩, 𝑪) ↦→ (𝑨, 𝑩, 𝑪) 变换后,模型可以通过两种方式计算:线性递归 (2) 或全局卷积 (3)。
通常,该模型使用卷积模式 (3) 进行高效的可并行训练(其中提前看到整个输入序列),并切换到循环模式 (2) 进行高效的自回归推理(其中每次只看到一个时间步的输入)。
线性时间不变性 (LTI)。方程 (1) 至 (3) 的一个重要性质是模型的动态随时间保持不变。换句话说,(Δ, 𝑨, 𝑩, 𝑪) 以及 (𝑨, 𝑩) 在所有时间步长上都是固定的。此性质称为线性时间不变性 (LTI),它与递归和卷积密切相关。通俗地讲,我们认为 LTI SSM 等同于任何线性递归 (2a) 或卷积 (3b),并使用 LTI 作为这类模型的总称。
到目前为止,由于基本的效率限制(如第 3.3 节所述),所有结构化 SSM 均采用 LTI(例如,以卷积形式计算)。然而,本研究的核心见解是,LTI 模型在建模某些类型的数据时存在根本性的局限性,而我们的技术贡献在于消除 LTI 约束,同时克服效率瓶颈。
结构和维度。最后,我们注意到,结构化 SSM 之所以如此命名,是因为高效计算它们也需要在𝑨矩阵上施加结构。最流行的结构形式是对角线(Gu, Gupta, et al. 2022; Gupta, Gu, and Berant 2022; Smith, Warrington, and Linderman 2023),我们也使用这种结构。
在这种情况下,𝑨 ∈ R𝑁×𝑁、𝑩 ∈ R𝑁×1、𝑪 ∈ R1×𝑁 矩阵都可以用𝑁个数表示。为了对批量大小为𝐵、长度为𝐿且具有𝐷个通道的输入序列𝑥进行操作,SSM 会独立应用于每个通道。请注意,在这种情况下,每个输入的总隐藏状态的维度为𝐷𝑁,并且在序列长度上计算它需要𝑂(𝐵𝐿𝐷𝑁)的时间和内存;这是第3.3节中提到的基本效率瓶颈的根源。
General State Space Models. 通用状态空间模型。我们注意到,“状态空间模型”一词含义非常广泛,它仅仅表示任何具有潜在状态的循环过程。它在不同学科中被用于指代许多不同的概念,包括马尔可夫决策过程 (MDP)(强化学习 (Hafner 等人 2020))、动态因果模型 (DCM)(计算神经科学 (Friston、Harrison 和 Penny 2003))、卡尔曼滤波器(控制 (Kalman 1960))、隐马尔可夫模型 (HMM) 和线性动态系统 (LDS)(机器学习),以及广泛的循环(有时也包括卷积)模型(深度学习)。
在本文中,我们使用术语“SSM”来专指结构化SSM或S4模型(Gu、Goel和Ré,2022;Gu、Gupta等人,2022;Gupta、Gu和Berant,2022;Hasani等人,2023;Ma等人,2023;Smith、Warrington和Linderman,2023),并且这些术语可以互换使用。为了方便起见,我们也可能包含此类模型的衍生模型,例如那些侧重于线性递归或全局卷积视角的模型(Y. Li等人,2023;Orvieto等人,2023;Poli等人,2023),并在必要时澄清细微差别。
SSM 架构。SSM 是独立的序列变换,可以集成到端到端神经网络架构中。(我们有时也将 SSM 架构称为 SSNN,它们与 SSM 层的关系就像 CNN 与线性卷积层的关系一样。)我们将讨论一些最著名的 SSM 架构,其中许多架构也将作为我们的主要基准。
• 线性注意力 (Katharopoulos 等人,2020) 是自注意力的一种近似,它涉及一个递归,可以将其视为退化的线性 SSM。
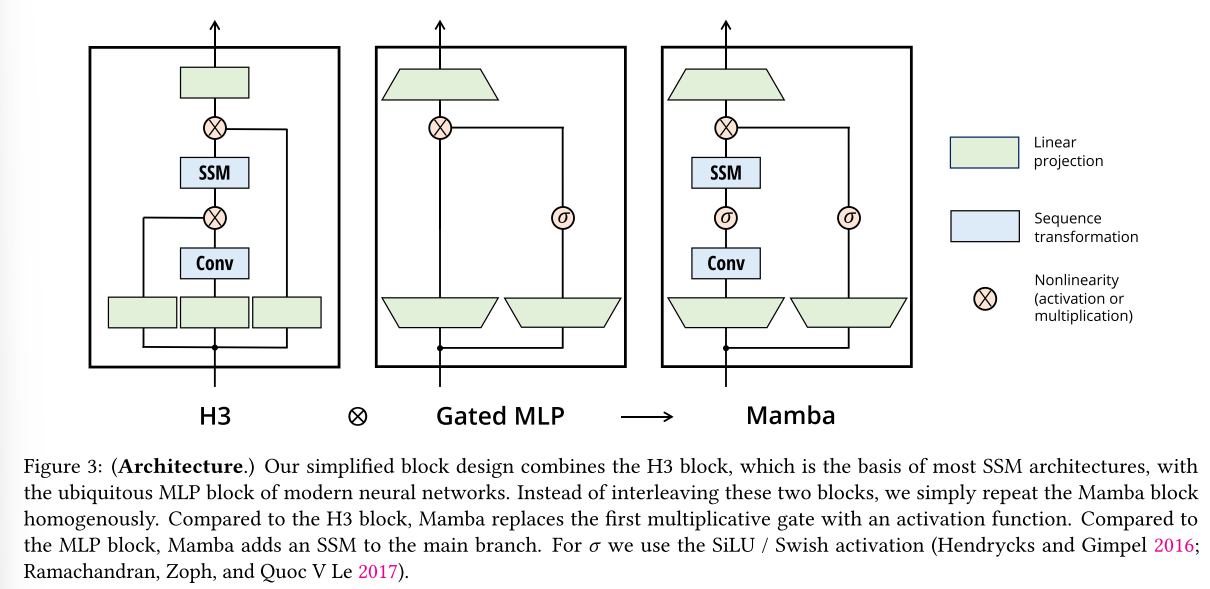
• H3 (Dao, Fu, Saab 等人,2023) 将此递归推广到使用 S4;它可以被视为一个由两个门控连接夹着 SSM 的架构(图 3)。H3 还在主 SSM 层之前插入了一个标准局部卷积,他们将其定义为移位 SSM。
• Hyena (Poli et al. 2023) 使用与 H3 相同的架构,但用 MLP 参数化的全局卷积 (Romero et al. 2021) 替换了 S4 层。
• RetNet (Y. Sun et al. 2023) 在该架构中增加了一个门电路,并使用更简单的 SSM,从而允许使用另一种可并行化的计算路径,并使用多头注意力机制 (MHA) 的变体代替卷积。
• RWKV (B. Peng et al. 2023) 是一种近期推出的 RNN,旨在基于另一种线性注意力近似——无注意力 Transformer (S. Zhai et al. 2021) 进行语言建模。其主要的“WKV”机制涉及 LTI 循环,可以视为两个 SSM 的比率。
其他密切相关的 SSM 和架构将在扩展的相关工作(附录 B)中进一步讨论。我们特别强调 S5(Smith、Warrington 和 Linderman 2023)、QRNN(Bradbury 等人 2016)和 SRU(Lei 等人 2017),我们认为它们是与我们的核心选择性 SSM 最密切相关的方法。
3 Selective State Space Models
我们利用来自合成任务的直觉来启发我们的选择机制(第 3.1 节),然后解释如何将该机制融入状态空间模型(第 3.2 节)。由此产生的时变 SSM 无法使用卷积,这带来了如何高效计算它们的技术挑战。我们利用一种硬件感知算法克服了这个问题,该算法利用了现代硬件上的内存层次结构(第 3.3 节)。然后,我们描述了一个无需注意机制甚至无需 MLP 模块的简单 SSM 架构(第 3.4 节)。最后,我们讨论了选择机制的一些附加属性(第 3.5 节)。
3.1 Motivation: Selection as a Means of Compression
我们认为序列建模的一个根本问题是将上下文压缩到更小的状态中。事实上,我们可以从这个角度来看待流行序列模型的权衡。例如,注意力机制既有效又低效,因为它明确地根本不压缩上下文。这可以从自回归推理需要明确存储整个上下文(即键值缓存)这一事实中看出,这直接导致了 Transformer 推理速度缓慢、训练时间复杂度高(线性时间),训练时间复杂度低(二次时间)。另一方面,循环模型高效,因为它们具有有限状态,这意味着推理时间和训练时间是常数。然而,它们的有效性受限于该状态对上下文的压缩程度。
为了理解这一原理,我们重点关注两个正在运行的合成任务示例(图 2)。
• 选择性复制任务通过改变需要记忆的标记的位置,对流行的复制任务(Arjovsky、Shah 和 Bengio,2016)进行了修改。它需要内容感知推理才能记住相关的标记(彩色)并过滤掉不相关的标记(白色)。
• 归纳头任务是一种众所周知的机制,据推测可以解释法学硕士(LLM)的大部分情境学习能力(Olsson 等人,2022)。它需要情境感知推理才能知道何时在适当的情境中生成正确的输出(黑色)。
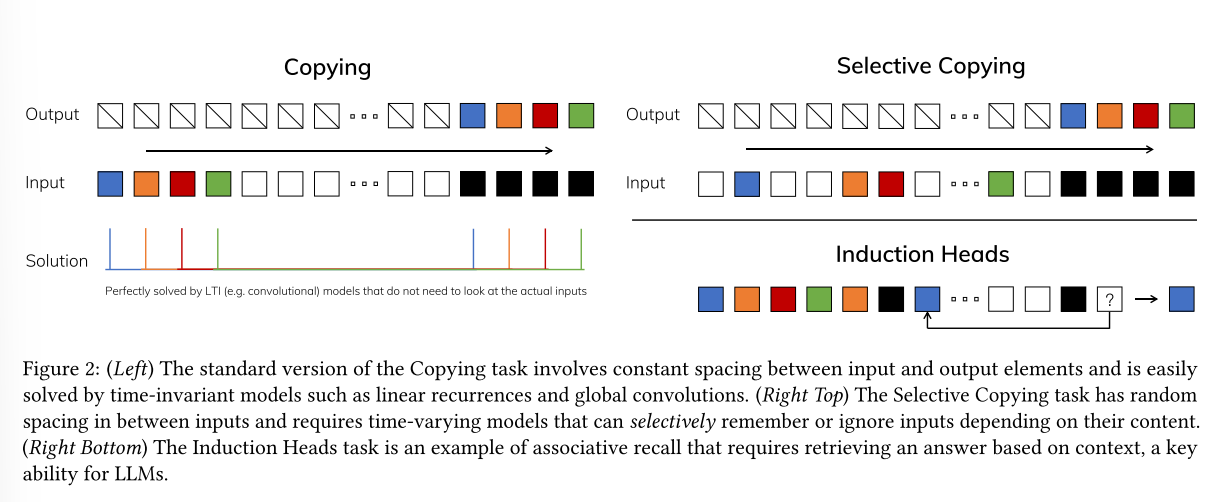
这些任务揭示了 LTI 模型的失效模式。从循环的角度来看,它们的恒定动态(例如 (2) 中的 (𝑨, 𝑩) 转换)无法让它们从上下文中选择正确的信息,也无法以依赖于输入的方式影响沿序列传递的隐藏状态。从卷积的角度来看,众所周知,全局卷积可以解决普通的复制任务 (Romero et al. 2021),因为它只需要时间感知,但由于缺乏内容感知,它们难以完成选择性复制任务 (图 2)。更具体地说,输入到输出之间的间隔是变化的,无法用静态卷积核建模。
总而言之,序列模型的效率与有效性权衡取决于它们压缩状态的能力:高效的模型必须具有较小的状态,而有效的模型必须具有包含来自上下文的所有必要信息的状态。反过来,我们提出构建序列模型的一个基本原则是选择性:或者说,一种感知上下文的能力,能够聚焦或过滤掉序列状态中的输入。具体来说,选择机制控制着信息如何在序列维度上传播或交互(更多讨论参见 3.5 节)。
3.2 Improving SSMs with Selection
将选择机制融入模型的一种方法是,让影响序列交互的参数(例如 RNN 的循环动态或 CNN 的卷积核)依赖于输入。
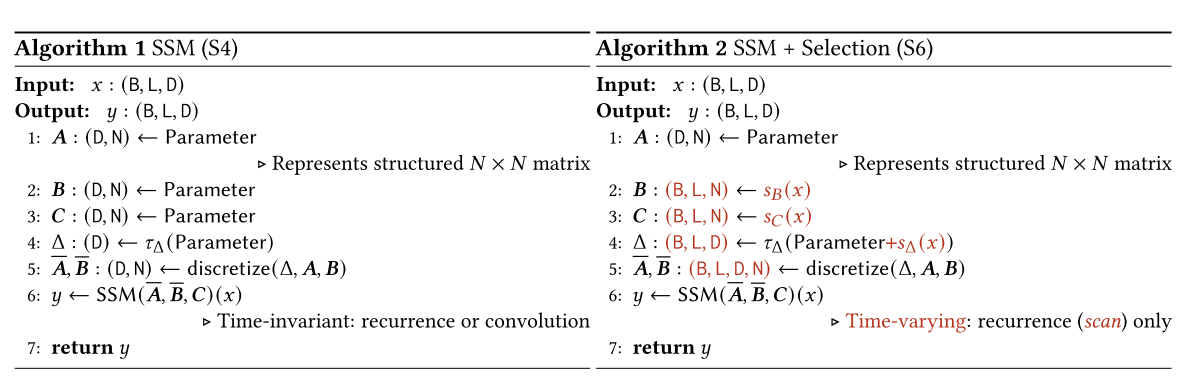
算法 1 和 2 展示了我们使用的主要选择机制。主要区别在于,它们只是将几个参数 Δ、𝑩、𝑪 设置为输入的函数,并在整个过程中对张量形状进行了相关的更改。特别地,我们强调这些参数现在具有长度维度 𝐿,这意味着模型已从时不变变为时变。(注意,形状注释已在第 2 节中描述。)这失去了与卷积 (3) 的等价性,并对其效率产生了影响,下文将对此进行讨论。
我们具体选择𝑠𝐵 (𝑥) = Linear𝑁 (𝑥)、𝑠𝐶 (𝑥) = Linear𝑁 (𝑥)、𝑠Δ(𝑥) = Broadcast𝐷 (Linear1(𝑥)) 和𝜏Δ = softplus,其中 Linear𝑑 是到维度 𝑑 的参数化投影。𝑠Δ 和 𝜏Δ 的选择源于与第 3.5 节中解释的 RNN 门控机制的联系。

3.3 Efficient Implementation of Selective SSMs
诸如卷积(Krizhevsky、Sutskever 和 Hinton,2012)和注意力机制(Bahdanau、Cho 和 Bengio,2015;Vaswani 等人,2017)等硬件友好型原语已得到广泛应用。我们的目标是使选择性 SSM 在现代硬件(GPU)上也能高效运行。选择机制非常自然,早期研究也尝试融入一些特殊的选择情况,例如在循环 SSM 中允许 Δ 随时间变化(Gu、Dao 等人,2020)。然而,如前所述,SSM 使用的一个核心限制是其计算效率,因此 S4 及其所有衍生模型都使用了 LTI(非选择性)模型,最常见的形式是全局卷积。
3.3.1 Motivation of Prior Models
我们首先回顾这一动机,并概述我们克服先前方法局限性的方法。
• 从高层次来看,诸如 SSM 之类的循环模型始终在表达能力和速度之间寻求平衡:如第 3.1 节所述,隐藏状态维度较大的模型应该效率更高,但速度也更慢。因此,我们希望在不牺牲速度和内存成本的情况下最大化隐藏状态维度。
• 请注意,循环模式比卷积模式更灵活,因为后者 (3) 是通过扩展前者 (2) 得出的 (Gu, Goel, and Ré 2022; Gu, Johnson, Goel, et al. 2021)。然而,这需要计算并具体化形状为 (B, L, D, N) 的潜在状态 ℎ,该状态比形状为 (B, L, D) 的输入 𝑥 和输出 𝑦 大得多(大了 𝑁 倍,即 SSM 状态维度)。因此,引入了更高效的卷积模式,该模式可以绕过状态计算,并实现大小仅为 (B, L, D) 的卷积核 (3a)。
• 先前的 LTI 状态空间模型利用双重循环卷积形式将有效状态维度增加了𝑁 倍(≈ 10 − 100),比传统的 RNN 大得多,而且不会降低效率。
3.3.2 Overview of Selective Scan: Hardware-Aware State Expansion
选择机制旨在克服 LTI 模型的局限性;与此同时,我们需要重新审视 SSM 的计算问题。我们采用了三种经典技术来解决这个问题:核融合、并行扫描和重新计算。我们得出两个主要观察结果:
• 简单的循环计算使用 𝑂(𝐵𝐿𝐷𝑁) 次 FLOP,而卷积计算使用 𝑂(𝐵𝐿𝐷 log(𝐿)) 次 FLOP,前者的常数因子较低。因此,对于长序列和不太大的状态维度 𝑁,循环模式实际上可以使用更少的 FLOP。
• 循环的两个挑战是其顺序性以及巨大的内存占用。为了解决后者,就像卷积模式一样,我们可以尝试不实际实现完整状态 ℎ。
主要思想是利用现代加速器(GPU)的特性,仅在内存层次结构的更高效层级上实现状态ℎ。具体来说,大多数运算(矩阵乘法除外)都受内存带宽限制(Dao、Fu、Ermon 等人,2022 年;Ivanov 等人,2021 年;Williams、Waterman 和 Patterson,2009 年)。这包括我们的扫描运算,我们使用核融合来减少内存 IO 数量,与标准实现相比,显著提高了速度。
具体来说,我们不会在 GPU HBM(高带宽存储器)中准备大小为 (B, L, D, N) 的扫描输入 (𝑨, 𝑩),而是将 SSM 参数 (Δ, 𝑨, 𝑩, 𝑪) 直接从慢速 HBM 加载到快速 SRAM,在 SRAM 中执行离散化和递归,然后将大小为 (B, L, D) 的最终输出写回 HBM。
为了避免顺序递归,我们观察到,尽管它不是线性的,仍然可以使用高效的并行扫描算法 (Blelloch 1990;Martin and Cundy 2018;Smith, Warrington and Linderman 2023) 进行并行化。
最后,我们还必须避免保存反向传播所必需的中间状态。我们谨慎地运用了经典的重新计算技术来降低内存需求:中间状态不存储,而是在输入从 HBM 加载到 SRAM 时在反向传播中重新计算。因此,融合的选择性扫描层与使用 FlashAttention 优化的 Transformer 实现具有相同的内存需求。
融合内核和重新计算的详细信息请参见附录 D。完整的选择性扫描层和算法如图 1 所示。
3.4 A Simplified SSM Architecture
与结构化 SSM 一样,选择性 SSM 是独立的序列转换,可以灵活地集成到神经网络中。H3 架构是最著名的 SSM 架构(第 2 节)的基础,这些架构通常由一个受线性注意力启发的块与一个 MLP(多层感知器)块交错组成。我们将这两个组件合并为一个,并均匀堆叠(图 3),从而简化了该架构。这受到了门控注意力单元 (GAU) 的启发(Hua 等人,2022),GAU 对注意力机制做了类似的处理。
该架构涉及通过可控扩展因子 𝐸 扩展模型维度 𝐷。对于每个块,大多数参数(3𝐸𝐷²)位于线性投影中(输入投影为 2𝐸𝐷²,输出投影为 𝐸𝐷²),而内部 SSM 的贡献较小。相比之下,SSM 参数的数量(Δ、𝑩、𝑪和矩阵𝑨的投影)要少得多。我们重复此块,并与标准正则化和残差连接交错,以构成 Mamba 架构。我们在实验中始终固定𝐸 = 2,并使用两组块来匹配 Transformer 交错 MHA(多头注意力)和 MLP 块的 12𝐷2 个参数。我们使用 SiLU / Swish 激活函数(Hendrycks 和 Gimpel 2016;Ramachandran、Zoph 和 Quoc V Le 2017),其动机是使门控 MLP 成为流行的“SwiGLU”变体(Chowdhery 等人 2023;Dauphin 等人 2017;Shazeer 2020;Touvron 等人 2023)。最后,我们还使用了一个可选的规范化层(我们选择 LayerNorm(J. L. Ba、Kiros 和 Hinton 2016)),其灵感来自于 RetNet 在类似位置使用规范化层(Y. Sun 等人 2023)。
3.5 Properties of Selection Mechanisms
选择机制是一个更广泛的概念,可以以不同的方式应用,例如应用于更传统的 RNN 或 CNN、应用于不同的参数(例如算法 2 中的 𝑨),或使用不同的变换 𝑠 (𝑥)。
3.5.1 Connection to Gating Mechanisms
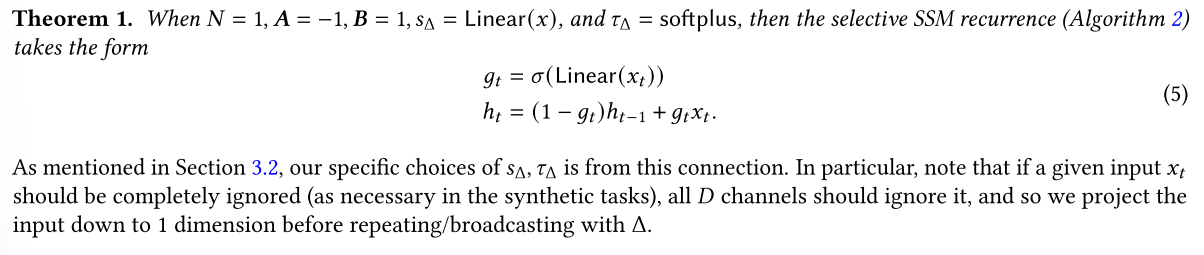
我们强调其中最重要的联系:RNN 的经典门控机制是我们 SSM 选择机制的一个实例。我们注意到,RNN 门控与连续时间系统离散化之间的联系已得到充分证实(Funahashi 和 Nakamura 1993;Tallec 和 Ollivier 2018)。事实上,定理 1 是对 Gu、Johnson、Goel 等人(2021,引理 3.1)的改进,推广至 ZOH 离散化和输入相关门(证明见附录 C)。更广泛地说,SSM 中的 Δ 可以被视为 RNN 门控机制的广义作用。与先前的研究一致,我们认为 SSM 的离散化是启发式门控机制的原则性基础。
3.5.2 Interpretation of Selection Mechanisms
我们详细阐述了选择的三种特殊机制效应。
变量间距。选择性允许滤除可能出现在感兴趣输入之间的无关噪声标记。选择性复制任务就是一个例证,但在常见的数据模态中也普遍存在,尤其是在离散数据中——例如“嗯”之类的语言填充词。这种特性的产生是因为模型可以机制性地滤除任何特定的输入𝑥𝑡,例如在门控循环神经网络 (RNN) 中(定理 1),当𝑔𝑡 → 0 时。
过滤上下文。经验观察到,许多序列模型并没有随着上下文的增加而提升性能 (F. Shi et al. 2023),尽管原则上更多的上下文应该会带来更好的性能。一种解释是,许多序列模型在必要时无法有效地忽略无关的上下文;一个直观的例子是全局卷积(以及一般的 LTI 模型)。另一方面,选择性模型可以随时重置其状态以移除无关历史记录,因此其性能原则上会随着上下文长度的增加而单调提升(例如,第 4.3.2 节)。
边界重置。在多个独立序列拼接在一起的场景中,Transformer 可以通过实例化特定的注意力掩码来保持它们之间的独立性,而 LTI 模型则会在序列之间泄漏信息。选择性 SSM 也可以在边界处重置其状态(例如,Δ𝑡 → ∞,或定理 1 中 𝑔𝑡 → 1 的情况)。这些设置可能是人为发生的(例如,将文档打包在一起以提高硬件利用率),也可能是自然发生的(例如,强化学习中的情节边界 (Lu et al. 2023))。
此外,我们还详细说明了每个选择性参数的影响。
Δ 的解释。通常,Δ 控制着关注或忽略当前输入 𝑥𝑡 的程度之间的平衡。它概括了 RNN 门(例如定理 1 中的 𝑔𝑡):从机制上讲,较大的 Δ 会重置状态 ℎ 并专注于当前输入 𝑥,而较小的 Δ 会保持状态并忽略当前输入。SSM (1)-(2) 可以解释为按时间步长 Δ 离散化的连续系统,在这种情况下,直觉上,较大的 Δ →∞ 表示系统更长时间地专注于当前输入(从而“选择”它并忘记其当前状态),而较小的 Δ → 0 表示被忽略的瞬态输入。
3.6 Additional Model Details
实数 vs. 复数。大多数先前的 SSM 在状态 ℎ 中使用复数,这对于在感知模态的许多任务中取得优异的性能至关重要 (Gu, Goel, and Ré 2022)。然而,经验观察发现,完全实值的 SSM 在某些情况下似乎表现良好,甚至可能更好 (Ma et al. 2023)。我们使用实数作为默认值,这在我们所有任务中都表现良好,除了一项任务之外;我们假设复数-实数的权衡与数据模态中的连续-离散谱有关,其中复数对连续模态(例如音频、视频)有用,但对离散模态(例如文本、DNA)无用。
初始化。大多数先前的 SSM 还建议进行特殊的初始化,尤其是在复数情况下,这在低数据量等多种情况下会有所帮助。对于复杂情况,我们的默认初始化是 S4D-Lin;对于实际情况,我们的默认初始化是 S4D-Real (Gu, Gupta, et al. 2022),它基于 HIPPO 理论 (Gu, Dao, et al. 2020)。它们分别将 𝑨 的第 𝑛 个元素定义为 −1/2 + 𝑛𝑖 和 −(𝑛 + 1)。然而,我们预期许多初始化都能正常工作,尤其是在大数据和实值 SSM 情况下;一些消融方法将在第 4.6 节中讨论。
Δ 的参数化。我们将对 Δ 的选择性调整定义为 𝑠Δ(𝑥) = Broadcast𝐷 (Linear1(𝑥)),其动机源于 Δ 的机制(第 3.5 节)。我们观察到,它可以从维度 1 推广到更大的维度 R。我们将其设置为 D 的一小部分,与块中的主要线性投影相比,它使用的参数数量可以忽略不计。我们另外注意到,广播操作可以看作是另一个线性投影,初始化为特定的 1 和 0 模式;如果这个投影可训练,则可得到另一个投影 𝑠Δ(𝑥) = Linear𝐷 (Linear𝑅 (𝑥)),它可以看作是一个低秩投影。
在我们的实验中,Δ 参数(可以看作是一个偏差项)被初始化为 𝜏−1 Δ (Uniform([0.001, 0.1])),这遵循了先前关于 SSM 的研究(Gu, Johnson, Timalsina, et al. 2023)。
备注 3.1。为了简洁起见,我们的实验结果有时将选择性 SSM 缩写为 S6 模型,因为它们是具有选择机制并通过扫描计算的 S4 模型。
4 Empirical Evaluation
在第 4.1 节中,我们测试了 Mamba 解决第 3.1 节中提到的两个合成任务的能力。然后,我们在三个领域进行评估,每个领域都针对自回归预训练和下游任务进行了评估。
。• 第 4.2 节:语言模型预训练(缩放定律)和零样本下游评估。• 第 4.3 节:DNA 序列预训练和长序列分类任务的微调。• 第 4.4 节:音频波形预训练和自回归生成的语音片段的质量。
最后,第 4.5 节展示了 Mamba 在训练和推理时的计算效率,第 4.6 节则介绍了架构的各个组件和选择性 SSM。
4.1 Synthetic Tasks
这些任务的完整实验细节,包括任务细节和训练协议,在附录 E.1 中。
4.1.1 Selective Copying
复制任务是序列建模中研究最深入的合成任务之一,最初旨在测试循环模型的记忆能力。如第 3.1 节所述,LTI SSM(线性循环和全局卷积)只需跟踪时间,无需推理数据即可轻松解决此任务;例如,通过构建一个长度恰到好处的卷积核(图 2)。这在早期关于全局卷积的研究中得到了明确的验证(Romero 等人,2021)。选择性复制任务通过随机化标记之间的间距来防止这种捷径。需要注意的是,此任务之前曾作为去噪任务引入(Jing 等人,2019)。
需要注意的是,许多先前的研究认为,添加架构门控(乘法交互)可以赋予模型“数据依赖性”,并解决相关任务(Dao、Fu、Saab 等人,2023;Poli 等人,2023)。然而,我们认为这种解释在直观上不够充分,因为这种门控机制不会沿序列轴相互作用,也无法影响 token 之间的间距。具体而言,架构门控并非选择机制的一个例子(附录 A)。
表 1 证实,H3 和 Mamba 等门控架构只能部分提升性能,而选择机制(将 S4 修改为 S6)可以轻松解决这一任务,尤其是在与这些更强大的架构结合使用时。
4.1.2 Induction Heads
从机械可解释性视角 (Elhage 等人,2021) 来看,归纳头 (Olsson 等人,2022) 是一项简单的任务,但它却出人意料地能够预测法学硕士 (LLM) 的语境学习能力。它要求模型执行联想回忆和复制:例如,如果模型在序列中见过像“哈利·波特”这样的二元组,那么下次“哈利”出现在同一序列中时,模型应该能够通过复制历史记录来预测“波特”。
数据集。我们在归纳头任务上训练了一个双层模型,序列长度为 256,词汇量为 16,这与之前关于该任务的研究 (Dao、Fu、Saab 等人,2023) 相当,但序列更长。此外,我们还通过在测试时对 26 = 64 到 220 = 1048576 的序列长度范围进行评估,考察了模型的泛化和外推能力。
模型。基于对归纳头的既定研究,我们使用了两层模型,这使得注意力机制能够机械地解决归纳头任务 (Olsson et al. 2022)。我们测试了多头注意力模型(8 个头,采用不同的位置编码)和 SSM 变体。对于 Mamba,我们使用 64 的模型维度 𝐷,对于其他模型,我们使用 128 的模型维度。
结果。表 2 显示,Mamba(或者更准确地说,是其选择性 SSM 层)能够完美地解决该任务,因为它能够选择性地记住相关的标记,同时忽略其间的所有其他标记。它可以完美地泛化到百万长度的序列,或者说比训练时长 4000 倍的序列,而其他任何方法都无法超过 2 倍。

在用于注意力模型的位置编码变体中,xPos(专为长度外推而设计)略胜于其他;另请注意,由于内存限制,所有注意力模型均仅在序列长度 214 = 16384 的情况下进行测试。在其他 SSM 中,H3 和 Hyena 的表现与之类似,这与 Poli 等人 (2023) 的发现相反。
4.2 Language Modeling
我们在标准自回归语言模型上对 Mamba 架构与其他架构进行了评估,评估指标包括预训练指标(困惑度)和零样本评估。我们将模型大小(深度和宽度)设置为与 GPT3 规范一致。我们使用 Pile 数据集(L. Gao, Biderman 等人,2020 年),并遵循 Brown 等人(2020 年)中描述的训练方案。所有训练细节均在附录 E.2 中。
4.2.1 Scaling Laws
作为基准,我们与标准 Transformer 架构(GPT3 架构)以及我们所知的最强大的 Transformer 方案(此处称为 Transformer++)进行了比较。Transformer 方案基于 PaLM 和 LLaMa 架构(例如,旋转嵌入、SwiGLU MLP、使用 RMSNorm 而非 LayerNorm、非线性偏差和更高的学习率)。我们还与其他近期的亚二次架构进行了比较(图 4)。所有模型详细信息请参见附录 E.2。
图 4 展示了在标准 Chinchilla (Hoffmann 等人,2022) 协议下,针对参数大小从 ≈ 125𝑀 到 ≈ 1.3𝐵 的模型的缩放规律。Mamba 是第一个能够匹敌非常强大的 Transformer 方案 (Transformer++) 性能的无注意模型,该方案现已成为标准,尤其是在序列长度增加的情况下。(我们注意到,RWKV 和 RetNet 基线(先前的强循环模型,也可以解释为 SSM)缺少上下文长度为 8k 的完整结果,因为缺乏高效的实现,导致内存不足或计算要求不切实际。)
4.2.2 Downstream Evaluations
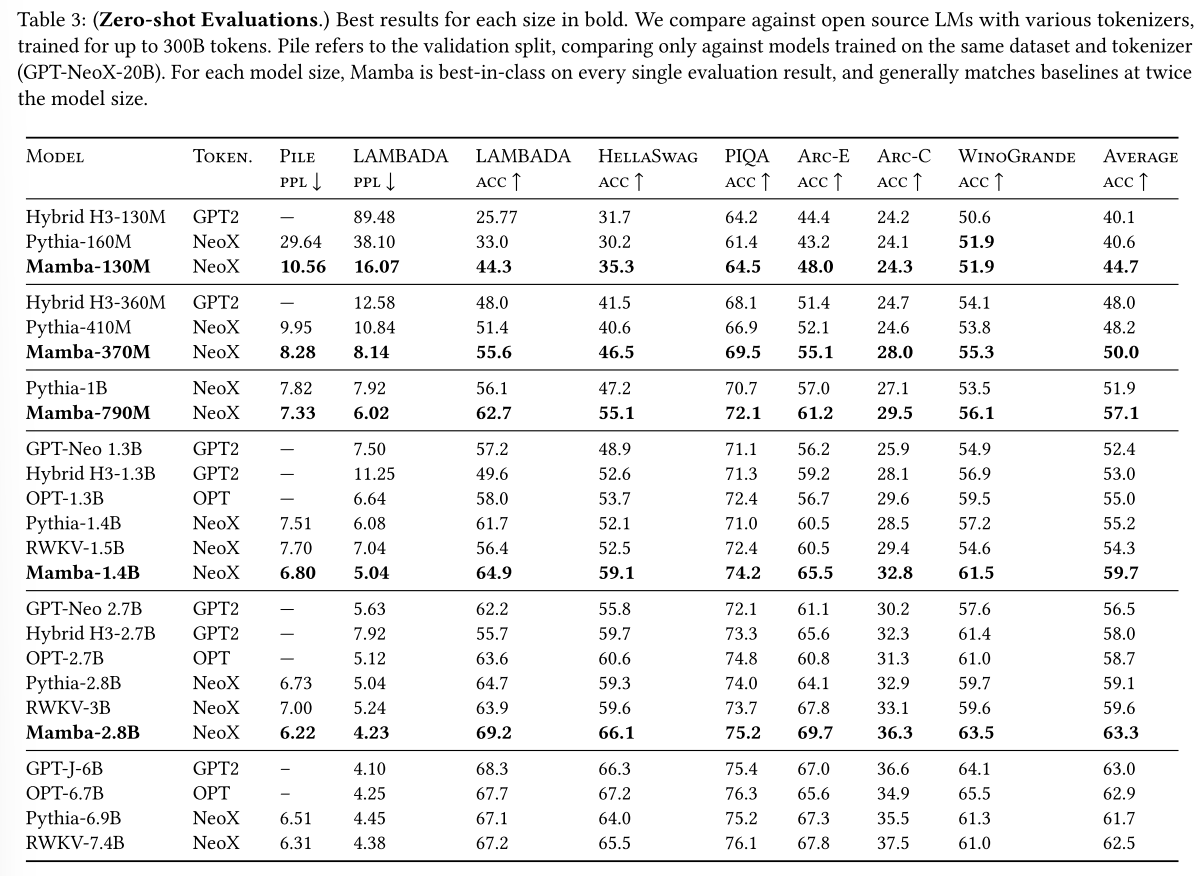
表 3 展示了 Mamba 在一系列流行的下游零样本评估任务上的表现。我们将其与这些规模下最知名的开源模型进行了比较,其中最重要的是 Pythia (Biderman 等人,2023) 和 RWKV (B. Peng 等人,2023),它们使用与我们的模型相同的分词器、数据集和训练长度(3000 亿个分词)进行训练。(请注意,Mamba 和 Pythia 的训练上下文长度为 2048,而 RWKV 的训练上下文长度为 1024。)
4.4 Audio Modeling and Generation
对于音频波形模态,我们主要与 SaShiMi 架构和训练协议(Goel 等人,2022)进行比较。该模型包含:1. 一个 U-Net 主干网络,包含两个池化阶段,池化因子为 𝑝,每个阶段将模型维度 𝐷 加倍;2. 在每个阶段交替使用 S4 和 MLP 块。
我们考虑用 Mamba 块替换 S4+MLP 块。实验细节见附录 E.4。
4.4.1 Long-Context Autoregressive Pretraining
我们在 YouTubeMix (DeepSound 2017) 上评估了预训练质量(自回归下一样本预测)。YouTubeMix 是先前研究使用的标准钢琴音乐数据集,包含 4 小时的钢琴独奏音乐,采样率为 16000 Hz。预训练细节基本遵循标准语言模型设置(第 4.2 节)。图 7 评估了在计算量不变的情况下,将训练序列长度从 213 = 8192 增加到 220 ≈ 106 的效果。(数据整理方式存在一些轻微的极端情况,这可能会导致缩放曲线出现扭结。例如,由于只有一分钟长的片段可用,因此最大序列长度实际上限制在 60𝑠 · 16000𝐻𝑧 = 960000 之间。)
Mamba 和 SaShiMi (S4+MLP) 基线均随着上下文长度的增加而持续提升;Mamba 的表现始终更佳,且随着长度的增加,差距进一步拉大。主要指标是每字节位数 (BPB),它是用于预训练其他模态的标准负对数似然 (NLL) 损失函数的常数因子 log(2)。
我们注意到一个重要的细节:这是本文中唯一一个从实数参数化转换为复数参数化的实验(第 3.6 节)。我们在附录 E.4 中展示了其他消融方法。
4.4.2 Autoregressive Speech Generation
SC09 是一个基准语音生成数据集(Donahue、McAuley 和 Puckette 2019;Warden 2018),包含以 16000 Hz 采样率采集的 1 秒数字“0”至“9”的片段,这些片段的特征变化很大。我们主要遵循 Goel 等人(2022)的自回归训练设置和生成协议。
表 4 展示了 Mamba-UNet 模型与 Goel 等人(2022)的多个基线模型的自动化指标对比:WaveNet(Oord 等人 2016)、SampleRNN(Mehri 等人 2017)、WaveGAN(Donahue、McAuley 和 Puckette 2019)、DiffWave(Z. Kong 等人 2021)和 SaShiMi。小型 Mamba 模型的表现优于最先进的(且规模更大的)GAN 和基于扩散的模型。与基线参数匹配的较大模型进一步显著提升了保真度指标。
表 5 采用小型 Mamba 模型,并研究了外部阶段和中心阶段的不同架构组合。结果表明,Mamba 在外部块中始终优于 S4+MLP,而在中心块中,Mamba > S4+MLP > MHA+MLP。

4.5 Speed and Memory Benchmarks
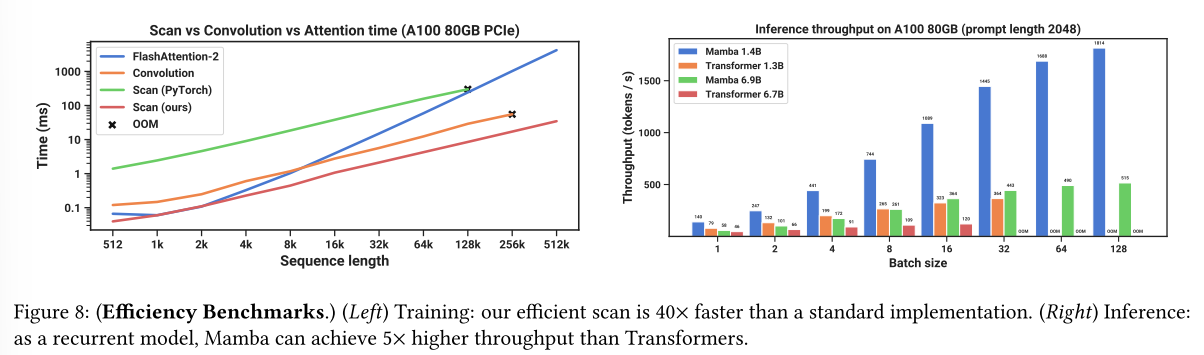
在图 8 中,我们对 SSM 扫描操作(状态扩展 𝑁 = 16)的速度以及 Mamba 的端到端推理吞吐量进行了基准测试。在序列长度超过 2K 的情况下,我们高效的 SSM 扫描速度比我们所知的最佳注意力机制实现(FlashAttention-2 (Dao 2024))更快,并且比 PyTorch 中的标准扫描实现快 20-40 倍。Mamba 的推理吞吐量比类似大小的 Transformer 高 4-5 倍,因为在没有 KV 缓存的情况下,它可以使用更大的批次大小。例如,Mamba-6.9B(未训练)的推理吞吐量要高于小 5 倍的 Transformer-1.3B。详细信息请参见附录 E.5,其中还包含内存消耗的基准测试。
4.6 Model Ablations
我们对模型的各个组件进行了一系列详细的消融,重点关注大小≈350M 的模型在 Chinchilla 标记计数下的语言建模设置(与图 4 相同的设置)。
4.6.1 架构
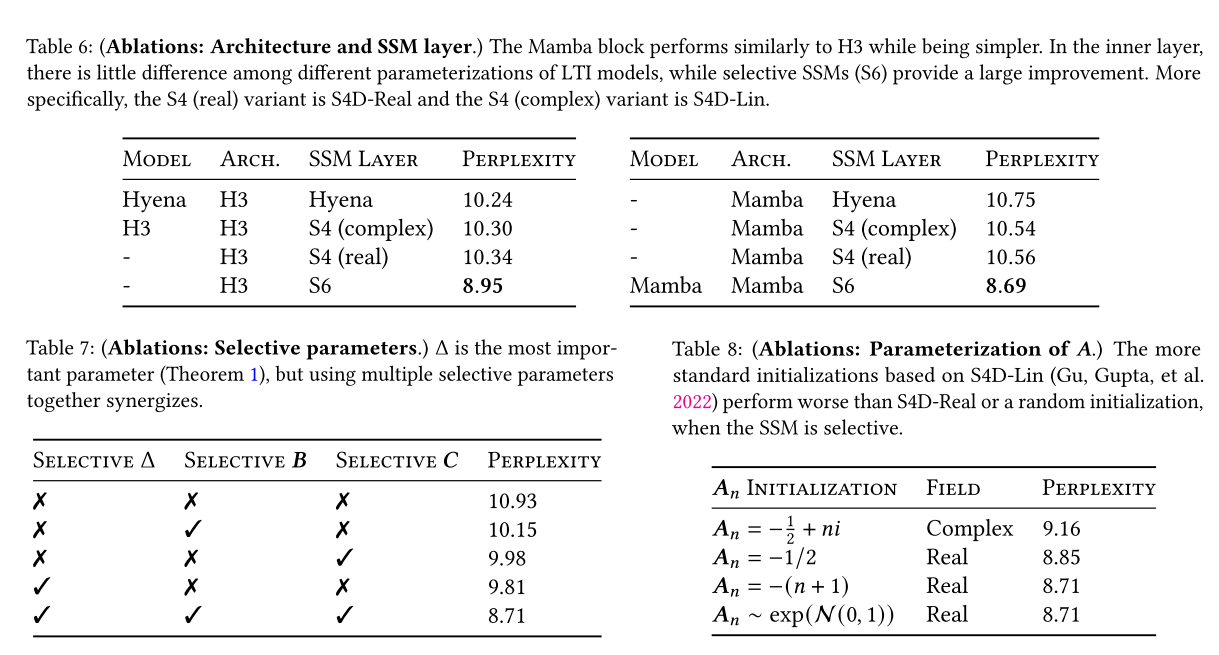
表 6 研究了架构(块)及其内部 SSM 层(图 3)的效果。我们发现:
• 在先前的非选择性 (LTI) SSM(相当于全局卷积)中,性能非常相似。
• 将先前工作中的复值 S4 变体替换为实值变体不会对性能产生太大影响,这表明(至少对于 LM 而言)实值 SSM 可能是考虑硬件效率的更好选择。
• 将其中任何一个替换为选择性 SSM(S6)均可显著提升性能,验证了第 3 节的动机。
• Mamba 架构的性能与 H3 架构相似(使用选择层时性能略有提升)。
我们还在附录 E.2.2 中研究了 Mamba 模块与其他模块(例如 MLP(传统架构)和 MHA(混合注意力架构))的交错。
4.6.2 选择性SSM
表7通过考虑选择性Δ、𝑩和𝑪参数的不同组合(算法2)来简化选择性SSM层,结果表明Δ是最重要的参数,因为它与RNN门控相关(定理1)。
表8考虑了SSM的不同初始化方法,这些初始化方法已被证明在某些数据模态和设置下会产生很大的差异(Gu、Goel和Ré,2022;Gu、Gupta等人,2022)。在语言建模方面,我们发现更简单的实值对角初始化方法(S4D-Real,第3行)比更标准的复值参数化方法(S4D-Lin,第1行)表现更好。随机初始化方法也表现出色,这与先前研究(Mehta等人,2023)的发现一致。
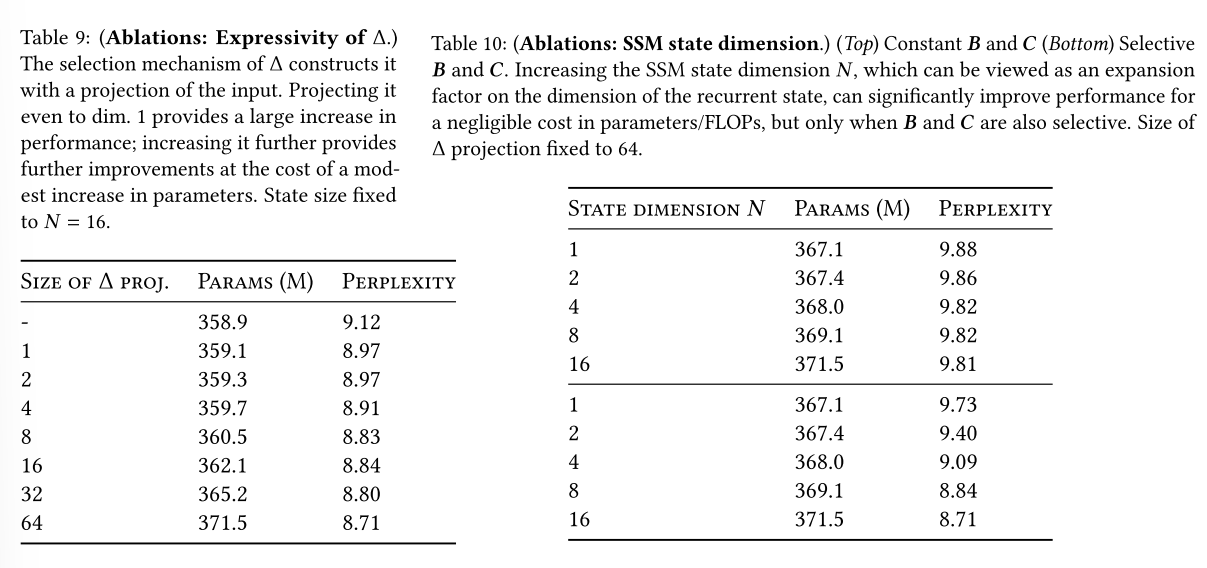
表 9 和表 10 分别考虑了改变 Δ 和 (𝑩, 𝑪) 投影的维度。将它们从静态改为选择性可带来最大的好处,而进一步增加维度通常会在参数数量略有增加的情况下略微提升性能。
特别值得注意的是,当状态大小 𝑁 增加时,选择性 SSM 的性能得到了显著提升,困惑度提升超过 1.0,而参数数量仅增加了 1%。这验证了我们在第 3.1 节和第 3.3 节中提出的核心动机。
5 Discussion
我们讨论相关工作、局限性以及一些未来方向。
相关工作。附录 A 讨论了选择机制与类似概念的关系。附录 B 包含 SSM 和其他相关模型的扩展相关工作。
没有免费的午餐:连续-离散频谱。结构化 SSM 最初被定义为连续系统的离散化 (1),并且对连续时间数据模态(例如感知信号,例如音频、视频)具有强烈的归纳偏好。如第 3.1 节和第 3.5 节所述,选择机制克服了它们在文本和 DNA 等离散模态上的弱点;但这反过来可能会阻碍它们在 LTI SSM 擅长的数据上的表现。我们对音频波形的消融更详细地探讨了这种权衡。
下游可供性。基于 Transformer 的基础模型(尤其是 LLM)拥有丰富的属性和与预训练模型交互的模式生态系统,例如微调、自适应、提示、上下文学习、指令调整、RLHF、量化等等。我们尤其关注 Transformer 的替代方案(例如 SSM)是否具有类似的属性和可供性。
扩展。我们的实证评估仅限于小模型规模,低于大多数强大的开源 LLM(例如 Llama (Touvron et al. 2023))以及其他循环模型(例如 RWKV (B. Peng et al. 2023) 和 RetNet (Y. Sun et al. 2023))的阈值,这些模型已在 7B 参数规模及以上进行了评估。Mamba 在这些更大规模下是否仍然具有优势仍有待评估。我们还注意到,扩展 SSM 可能涉及进一步的工程挑战和模型调整,本文未对此进行讨论。
6 Conclusion
我们为结构化状态空间模型引入了一种选择机制,使其能够执行上下文相关的推理,同时序列长度可线性扩展。当 Mamba 被整合到一个简单的无注意架构中时,它能够在众多领域取得最佳结果,其性能堪比甚至超越了强大的 Transformer 模型。我们对选择性状态空间模型的广泛应用感到兴奋,因为它可以为不同领域构建基础模型,尤其是在基因组学、音频和视频等需要长上下文的新兴模态中。我们的结果表明,Mamba 是通用序列模型主干的有力候选者。

AtomGit 是由开放原子开源基金会联合 CSDN 等生态伙伴共同推出的新一代开源与人工智能协作平台。平台坚持“开放、中立、公益”的理念,把代码托管、模型共享、数据集托管、智能体开发体验和算力服务整合在一起,为开发者提供从开发、训练到部署的一站式体验。
更多推荐



 6
 0
- 0


 已为社区贡献52条内容

所有评论(0)