影刀RPA新手教程_自动化流程测试方法论如何保证你的流程跑一个月不出错
影刀RPA新手教程:自动化流程测试方法论如何保证你的流程跑一个月不出错
你花两天写了一个数据采集流程。
手动测试跑了三次,数据都对。
你满意地把它设成了每天凌晨3点的定时任务。
五天后,业务方找你:“这几天数据怎么少了一半?”
你打开日志一看——第四天,目标网站改版了,页面结构变了,你的流程在第三步就停了。
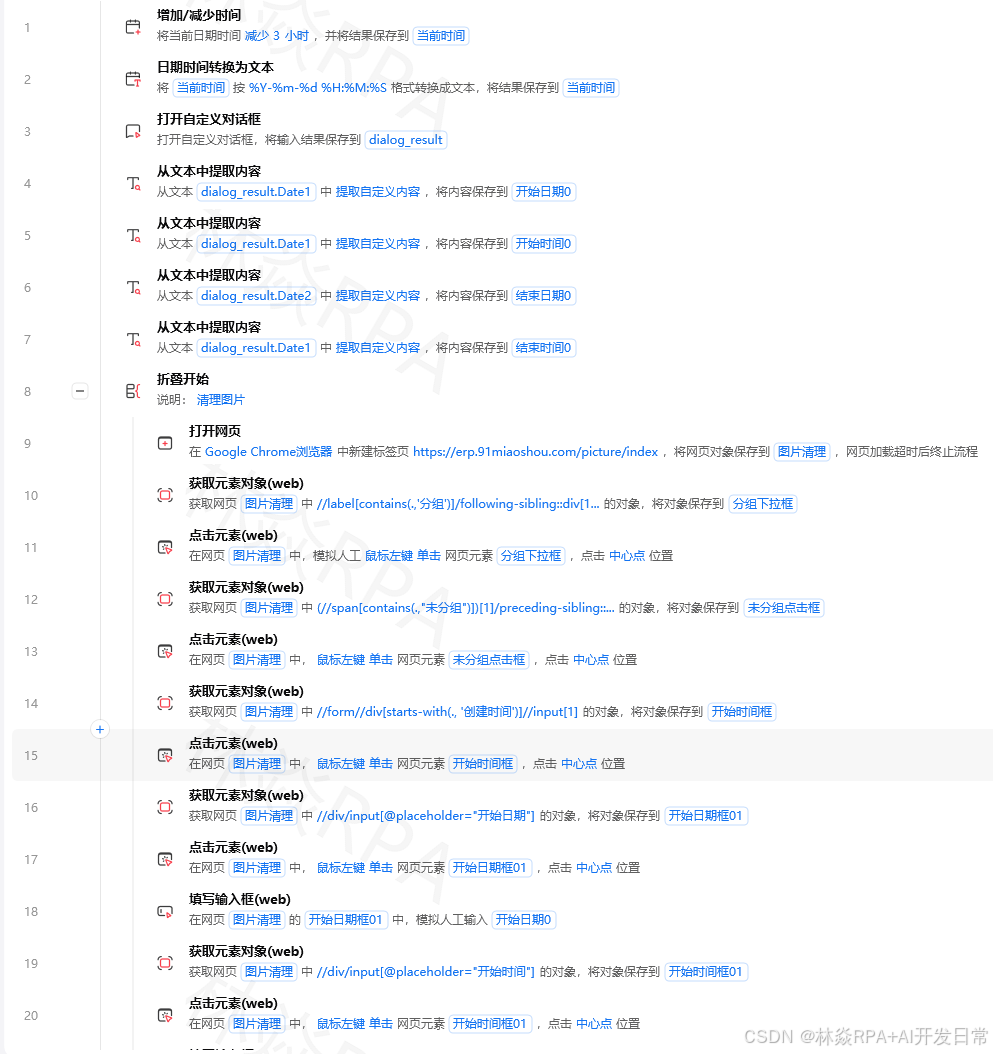
测试三次不出错 ≠ 跑一个月不出错。
自动化流程为什么会"偷偷坏掉"
自动化流程和普通软件有一个关键区别:
普通软件的操作环境是固定的(你自己的代码),自动化流程的操作环境是别人的(网页、系统、数据)。
这意味着你的代码没变,但"外部环境"变了,流程就坏了。
最常见的五种"偷偷坏掉"的方式:
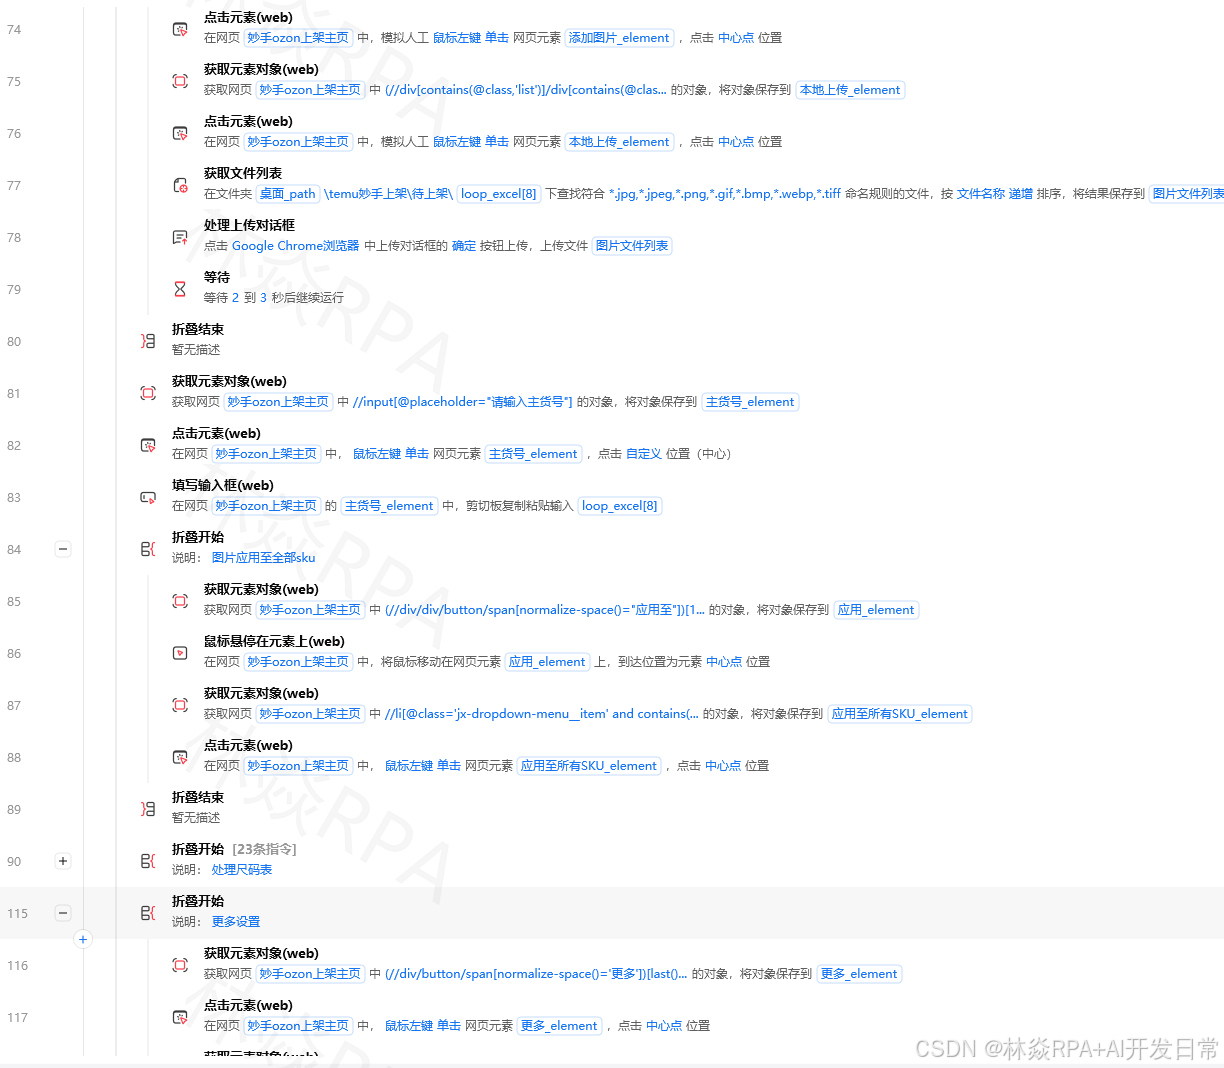
| 故障类型 | 原因 | 发生频率 |
|---|---|---|
| 目标网页改版 | 元素选择器失效 | 高 |
| 数据格式变化 | 字段名、类型变了 | 中 |
| 网络波动 | 页面加载超时 | 高 |
| 账号登录态失效 | Cookie过期 | 中 |
| 系统弹窗/更新 | 意外窗口遮挡 | 低但致命 |
测试金字塔:三个层级
店群矩阵自动化突破运营极限!
        /\
       /E2E\        ← 端到端测试(流程全跑一遍)
      /------\
     /集成测试\      ← 关键节点测试(登录→采集→写入)
    /----------\
   /单元测试   \     ← 单个操作测试(元素定位、API调用、数据校验)
  /--------------\
第一层:单元测试(最基础,必须做)
每一个独立的操作,单独测试:
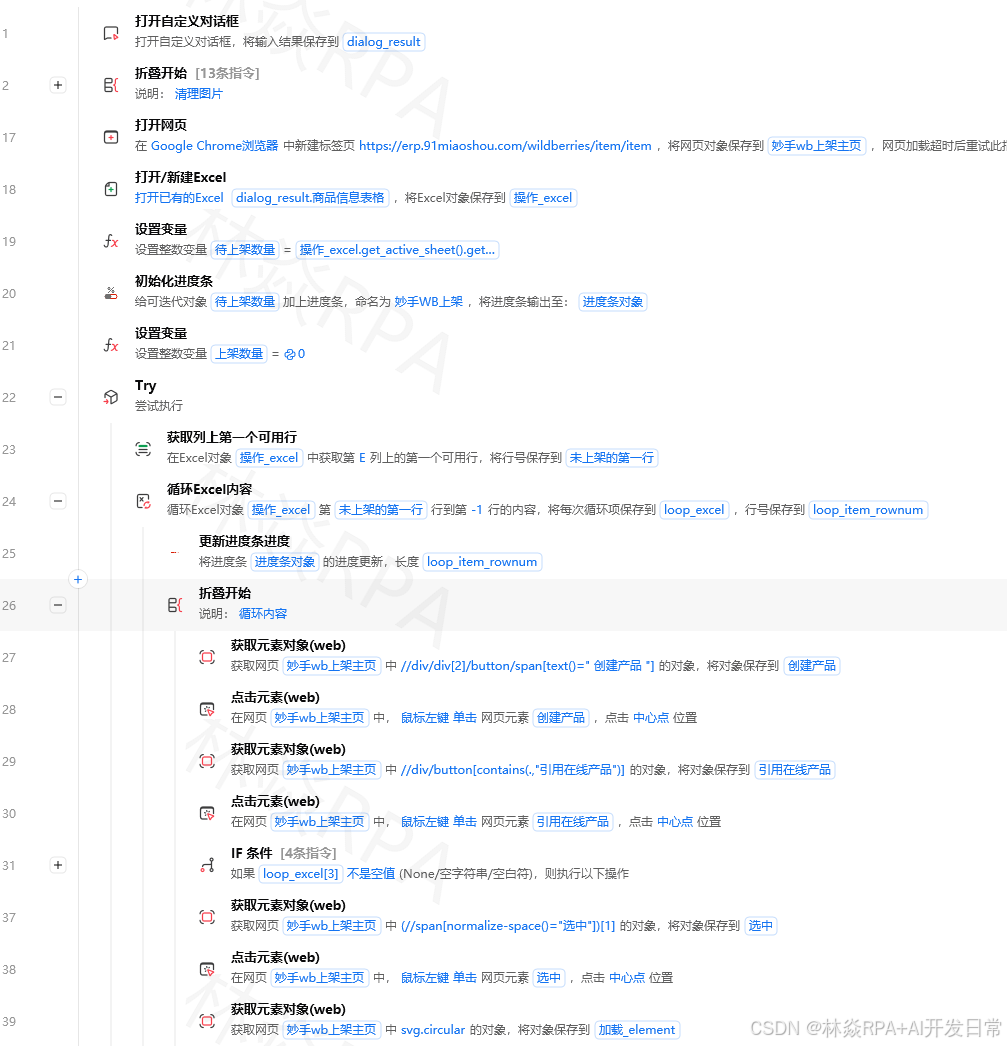
- 元素定位测试:XPath选择器在当前页面能否找到元素
- API测试:接口能否正常返回数据
- 文件读写测试:Excel路径是否正确、文件是否占用
- 数据校验测试:解析出来的数据格式是否正确
在影刀里怎么测:把关键操作单独放在一个测试流程里,改参数测不同场景。
比如元素定位测试流程:
流程参数:输入URL、输入XPath
1. 打开网页(URL)
2. 等待页面加载
3. 判断元素是否存在(XPath)
   - 存在 → 打印"PASS"
   - 不存在 → 打印"FAIL: 元素不存在"
4. 如果存在,获取元素文本 → 打印
第二层:集成测试
测试"一个完整的业务动作":
- 登录 → 进入目标页面(登录取token流程)
- 搜索 → 翻页 → 提取列表(采集子流程)
- 读取数据 → 清洗 → 写入Excel(处理子流程)
- 
关键:每个集成测试要有明确的"通过条件"。
比如"搜索→翻页→提取列表"的通过条件:提取出的数据行数 > 0 且 翻页次数 = 预期次数。
第三层:端到端测试(E2E)
完整跑一遍主流程,验收最终结果。
E2E测试不需要每次都跑(太耗时),但以下情况必须跑:
- 新流程上线前
- 影刀版本更新后
- 业务流程有修改后
- 每月至少一次(目标网站可能悄悄改版)
具体测试清单
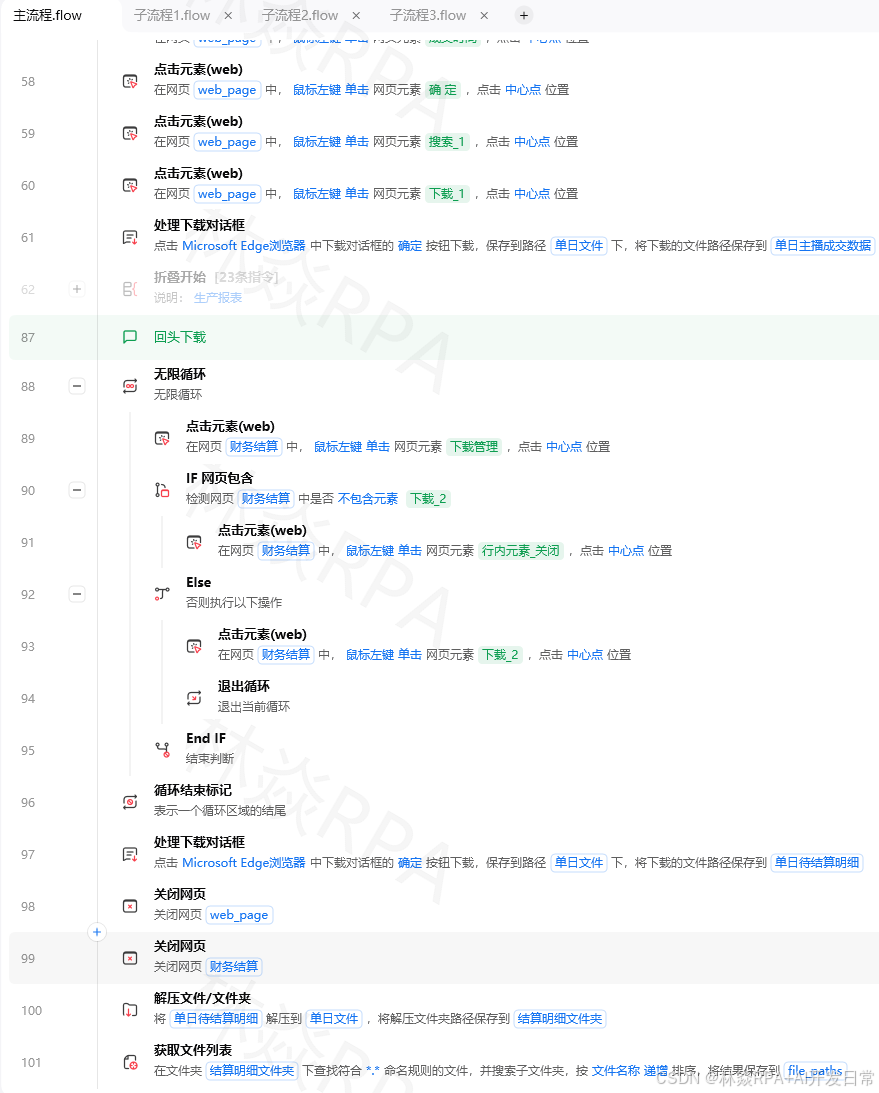
正常场景测试
先验证"流程在正常条件下能跑通"。
输入正常的数据、正常的网页、正常的网络环境,从头到尾跑一遍。
边界场景测试
| 边界场景 | 测试要点 |
|---|---|
| 数据为空 | 列表页0条数据,流程是否崩溃 |
| 数据只有一条 | 是否还能正常翻页(应该跳过翻页) |
| 数据量巨大 | 100页+时内存是否够用 |
| 网络缓慢 | 页面加载30秒后是否能正常超时重试 |
| 文件名有特殊字符 | : / ? 等能否正常处理 |
边界测试最容易被忽略,但80%的线上故障来自边界情况。
异常场景测试
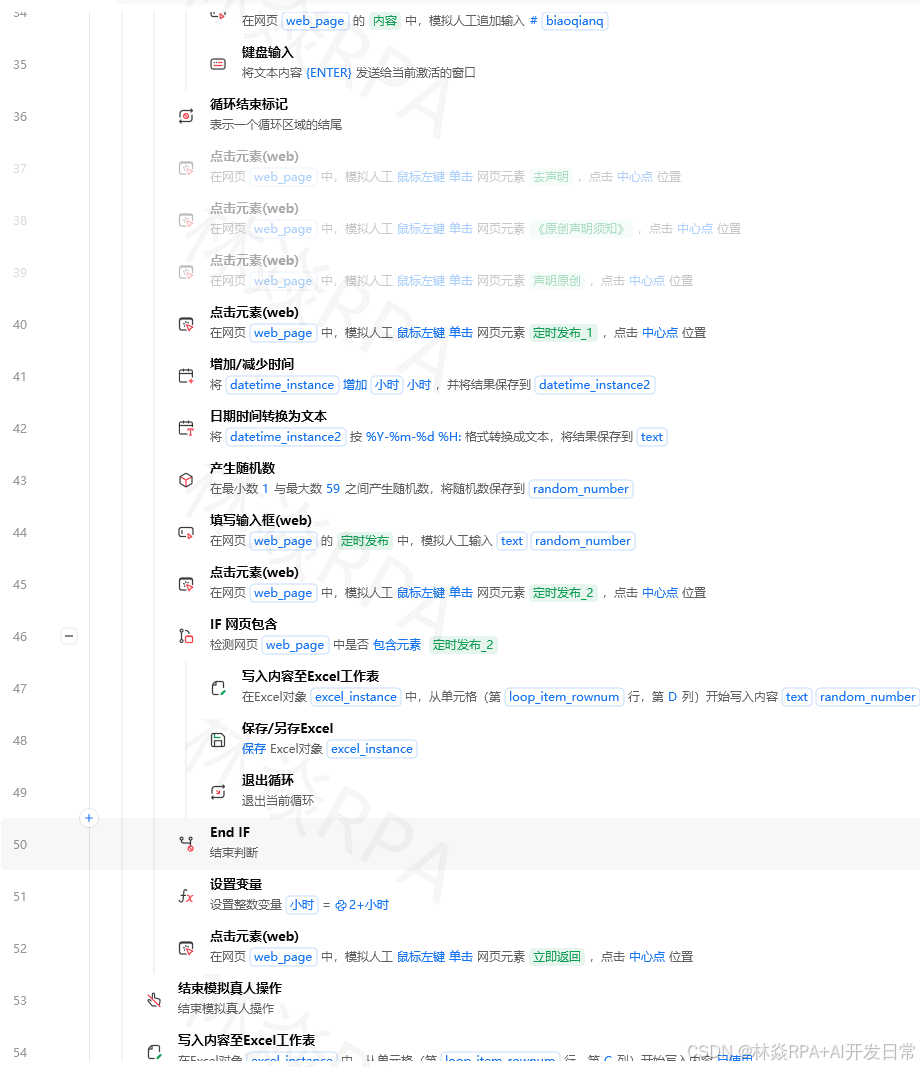
模拟各种"出错了"的情况:
| 异常场景 | 预期行为 |
|---|---|
| 目标网页404 | 打印错误日志,跳过,继续下一条 |
| API返回500 | 重试3次,仍失败则告警 |
| Excel文件被占用 | 等待10秒重试,超时则另存为新文件 |
| 登录页面弹验证码 | 发送企微通知人工介入 |
| 元素定位不到 | 尝试备用XPath,都失败则跳过 |
原则:流程不能无声无息地停掉——要么自动重试,要么告警通知。
自动化测试脚本示例
用Python写一个流程健康检查脚本:
temu店群自动化报活动案例
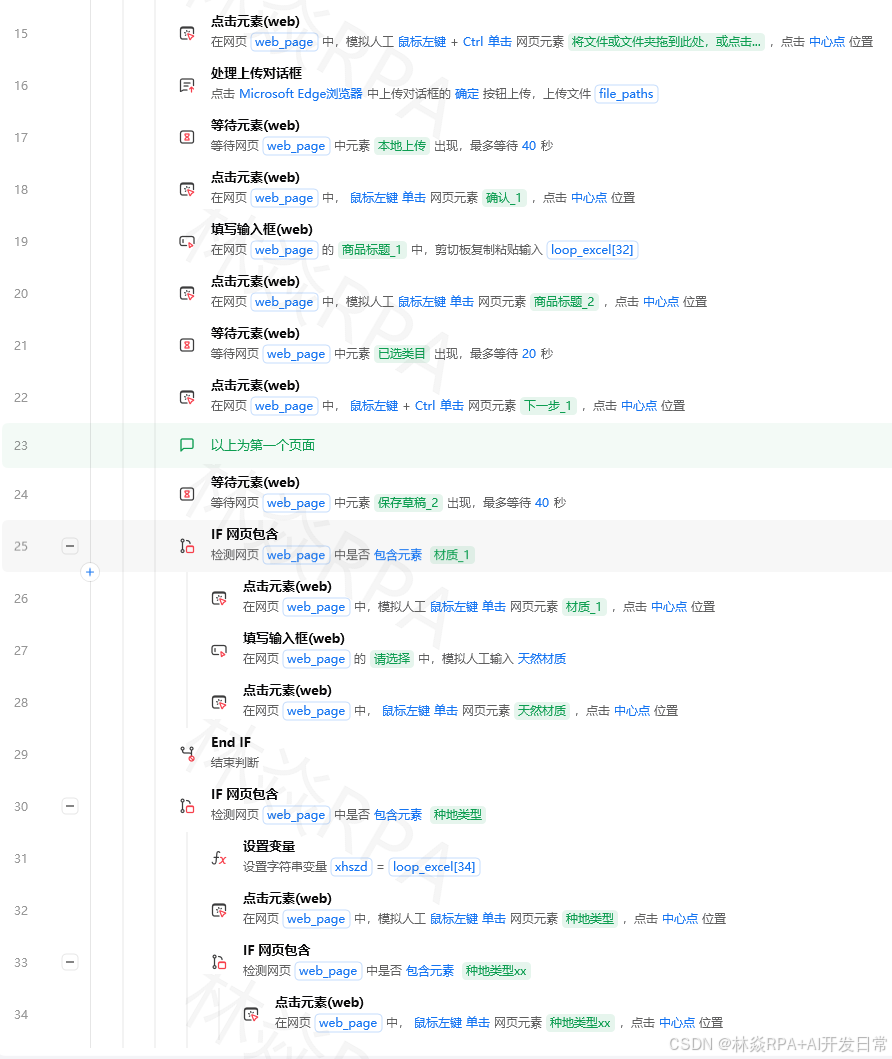
import requests
from datetime import datetime

class FlowHealthCheck:
    def __init__(self):
        self.results = []

    def check_url_reachable(self, url, timeout=10):
        """检查目标URL是否可达"""
        try:
            resp = requests.get(url, timeout=timeout)
            status = "PASS" if resp.status_code == 200 else "WARN"
            self.results.append({
                "check": f"URL可达: {url}",
                "status": status,
                "detail": f"HTTP {resp.status_code}"
            })
        except Exception as e:
            self.results.append({
                "check": f"URL可达: {url}",
                "status": "FAIL",
                "detail": str(e)[:100]
            })

    def check_file_exists(self, file_path):
        """检查关键文件是否存在"""
        import os
        exists = os.path.exists(file_path)
        self.results.append({
            "check": f"文件存在: {file_path}",
            "status": "PASS" if exists else "FAIL",
            "detail": "存在" if exists else "文件不存在"
        })

    def check_data_integrity(self, excel_path, expected_min_rows=1):
        """检查Excel数据量是否合理"""
        import pandas as pd
        try:
            df = pd.read_excel(excel_path)
            rows = len(df)
            status = "PASS" if rows >= expected_min_rows else "WARN"
            self.results.append({
                "check": f"数据完整性: {excel_path}",
                "status": status,
                "detail": f"{rows} 行 (最低要求 {expected_min_rows})"
            })
        except Exception as e:
            self.results.append({
                "check": f"数据完整性: {excel_path}",
                "status": "FAIL",
                "detail": str(e)[:100]
            })

    def print_report(self):
        """输出检查报告"""
        pass_count = sum(1 for r in self.results if r['status'] == 'PASS')
        fail_count = sum(1 for r in self.results if r['status'] == 'FAIL')
        warn_count = sum(1 for r in self.results if r['status'] == 'WARN')

        print(f"\n{'='*50}")
        print(f"流程健康检查报告 - {datetime.now().strftime('%Y-%m-%d %H:%M')}")
        print(f"通过: {pass_count} | 警告: {warn_count} | 失败: {fail_count}")
        print(f"{'='*50}")

        for r in self.results:
            icon = {'PASS': '✓', 'WARN': '⚠', 'FAIL': '❌'}[r['status']]
            print(f"{icon} {r['check']}: {r['detail']}")

        return fail_count == 0

# 使用
checker = FlowHealthCheck()
checker.check_url_reachable('https://target-website.com')
checker.check_file_exists('D:/RPA/data.db')
checker.check_data_integrity('D:/RPA/output.xlsx', expected_min_rows=10)
all_pass = checker.print_report()
上线前的checklist
把这个清单打出来贴在电脑旁边,每个新流程上线前过一遍:
□ 正常场景:从头到尾跑一遍,数据正确
□ 空数据场景:目标页面无数据时流程不崩溃
□ 单条数据场景:只有1条数据时翻页逻辑正确
□ 网络超时:断网或限速测试,重试逻辑生效
□ 文件冲突:输出文件被占用时流程不崩溃
□ 元素缺失:删除一个关键元素定位,备用方案生效
□ 夜间模式:考虑无人值守时的弹窗和更新
□ 数据校验:写入Excel后的行数与预期一致
□ 日志记录:每个关键步骤有日志输出
□ 告警通知:异常时有企微/邮件通知
持续监控:让流程"自己报告健康状况"
流程上线不是终点,还需要持续监控。
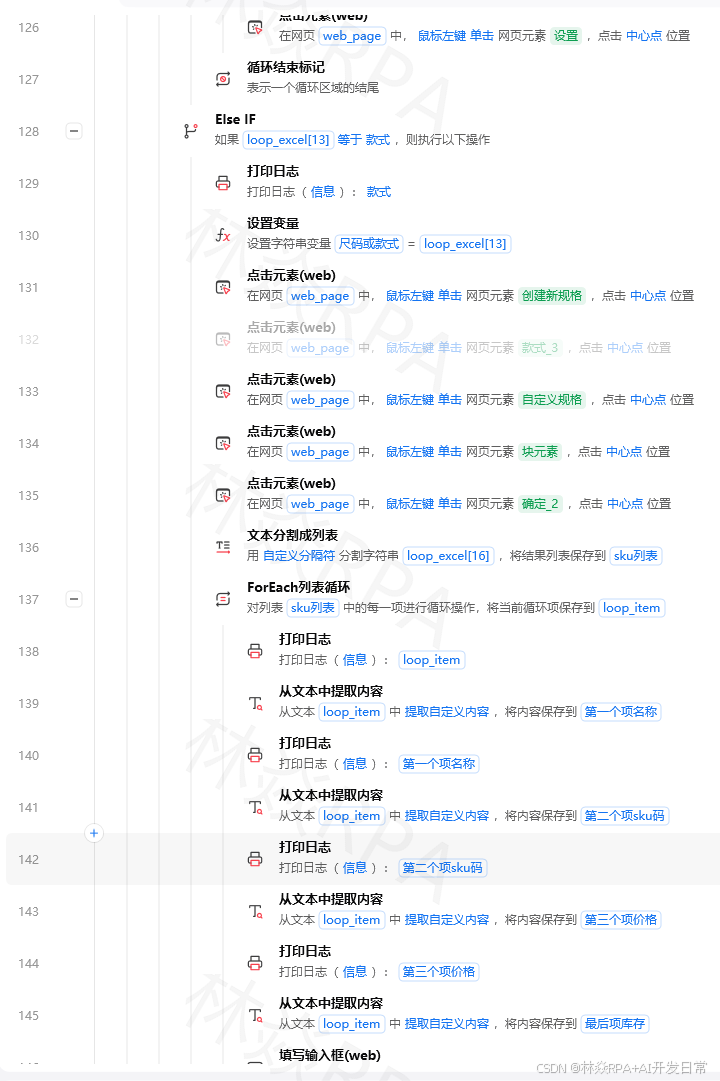
监控指标
- 每次运行耗时(突然变长说明哪里卡住了)
- 采集数据行数(突然变少说明部分数据丢了)
- 错误率(错误次数/总运行次数)
- 连续失败次数(连续3次失败就该人工介入)
监控脚本嵌入到流程末尾
流程末尾:
1. 统计本次运行数据:耗时、采集行数、错误次数
2. 写入运行日志表(SQLite)
3. 异常检测:
   - 如果 本次耗时 > 历史平均 × 2:发送"性能降级"告警
   - 如果 采集行数 < 历史平均 × 0.5:发送"数据量异常"告警
   - 如果 连续失败 ≥ 3次:发送"流程需要人工检查"告警
总结
测试三次不出错不等于跑一个月不出错。
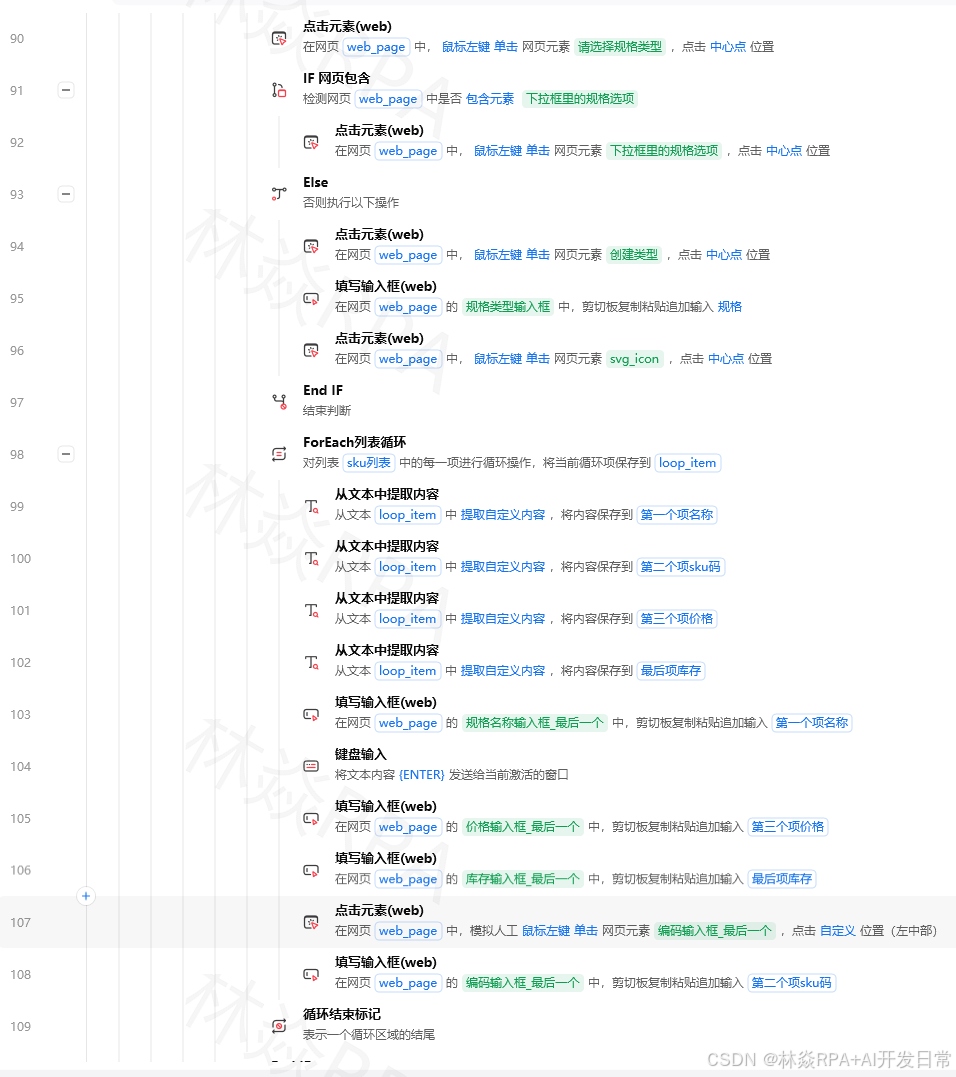
自动化流程的"敌人"是变化的外部环境——网页改版、网络波动、数据格式变化。
三层测试(单元→集成→E2E)+ 上线checklist + 持续监控,三件套让流程的稳定性从"靠运气"变成"靠体系"。
花在测试上的每一分钟,都会在未来省下你十倍的排错时间。
内容标签:#影刀RPA #流程测试 #稳定性 #运维 #测试方法论
作者:林焱
系列:影刀RPA新手教程系列——让自动化流程经得起时间考验

AtomGit 是由开放原子开源基金会联合 CSDN 等生态伙伴共同推出的新一代开源与人工智能协作平台。平台坚持“开放、中立、公益”的理念,把代码托管、模型共享、数据集托管、智能体开发体验和算力服务整合在一起,为开发者提供从开发、训练到部署的一站式体验。
更多推荐



 5
 0
- 0


 已为社区贡献28条内容

所有评论(0)