CVPR 2026 | HyperNAS:通过超网络增强 NAS Predictor 的架构表征
CVPR 2026 | HyperNAS:通过超网络增强 NAS Predictor 的架构表征
01 论文信息
- 论文题目: HyperNAS: Enhancing Architecture Representation for NAS Predictor via Hypernetwork
- 论文作者: Jindi Lv, Yuhao Zhou, Yuxin Tian, Qing Ye, Wentao Feng, Jiancheng Lv
- 发表单位: Sichuan University
- 发表会议/期刊: CVPR 2026
- 代码链接: 暂未找到官方开源仓库
02 论文主要贡献
这篇论文关注的是 Neural Architecture Search(NAS)中的性能预测器问题。在传统 NAS 中,想要判断一个候选网络结构好不好,最直接的方式是把这个网络完整训练一遍,然后看它在验证集上的精度。但这种方式计算成本极高,尤其在搜索空间很大时,往往需要训练成百上千个候选网络,代价非常夸张。
因此,近年来 predictor-based NAS 成为一个重要方向。它的核心思想是:不再对每个候选架构都完整训练,而是先采样一小部分架构并获得真实精度,再训练一个神经预测器,让它学习“架构表示 → 性能”的映射关系。训练完成后,对于新的候选架构,只需要一次前向推理,就可以快速预测其性能。
但是,现有 predictor-based NAS 仍然存在两个关键问题:
第一,很多方法只对单个 cell 进行编码。
在 cell-based 搜索空间中,一个完整网络通常由多个 normal cell 和 reduction cell 堆叠而成。过去的一些 predictor 方法为了简化问题,往往只拿一个孤立 cell 代表整个网络。这种做法虽然计算简单,但会忽略 cell 与 cell 之间的依赖关系,也无法充分表达 reduction cell 在宏观结构中的作用。
第二,少样本场景下泛化能力不足。
预测器通常只能拿到很少的 architecture-accuracy pairs 作为训练数据,而搜索空间中的结构关系又非常复杂、非线性。如果只用一个普通的回归器去拟合“架构—精度”关系,很容易过拟合到已有样本,导致对未见架构的排序能力下降。
针对这两个痛点,本文提出了 HyperNAS。它不是简单换一个更大的 predictor,而是从“架构表示学习”的角度重新设计 predictor 训练范式:一方面通过 Global Architecture Encoding 捕获完整网络的宏观结构信息;另一方面引入 Shared Hypernetwork 作为辅助任务,让共享的 GCN 架构编码器在预测精度之外,还要学习如何为不同架构生成参数。这样一来,编码器不仅学习“这个架构精度是多少”,还被迫学习不同架构之间更深层的结构规律,从而提升少样本下的泛化能力。
03 论文创新点
-
提出 HyperNAS:一种面向 NAS Predictor 的多任务架构表示学习范式。
HyperNAS 将传统的架构性能预测任务,与超网络参数生成任务结合起来,让二者共享同一个 GCN 架构编码器,从而增强架构表示的泛化能力。 -
设计 Global Architecture Encoding,全局建模完整网络结构。
相比只编码单个 cell 的传统方式,本文将多个 cell 顺序送入共享 GCN,并通过前一个 cell 的特征影响后一个 cell 的输入,使模型能够感知 normal cell、reduction cell 以及 cell 间上下文关系。 -
引入 Shared Hypernetwork 作为辅助任务,而不是直接作为性能评估器。
以往一些 hypernetwork-based NAS 方法会直接用超网络生成权重并评估架构性能,但这种方式容易受到超网络优化目标限制。HyperNAS 则把 hypernetwork 作为辅助监督,让它帮助共享编码器学习更稳健的架构关系。 -
提出 Dynamic Adaptive Multi-task Loss,实现预测任务与参数生成任务之间的自适应平衡。
论文设计了带偏好系数 qqq 的多任务损失函数,使模型能够在不同任务之间动态分配权重,并在 Pareto front 上探索更合适的解。 -
在多个 NAS 搜索空间中验证少样本优势。
实验覆盖 NAS-Bench-101、NAS-Bench-201、DARTS、MobileNetV3 以及 ViT 搜索空间。结果显示,HyperNAS 在少量训练样本下仍然具有较强的 ranking ability,并在 CIFAR-10 和 ImageNet 上取得了有竞争力的搜索结果。
04 方法
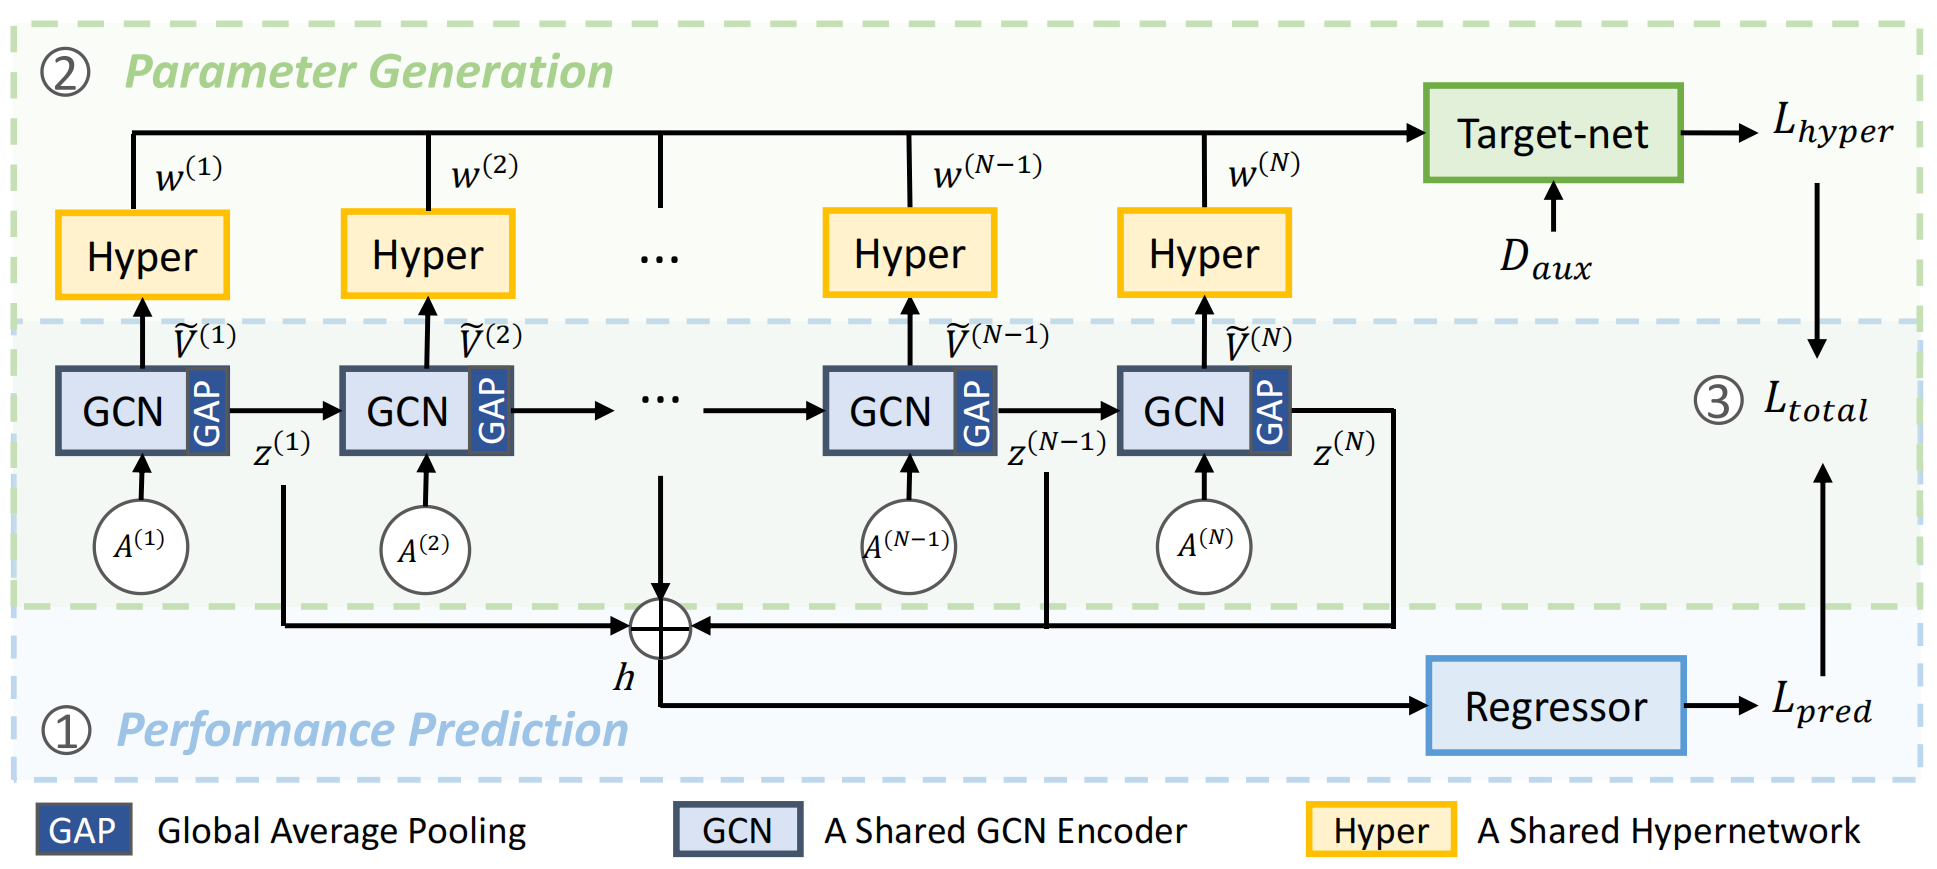
4.1 整体框架:一个共享编码器,两个训练任务
HyperNAS 的整体结构可以用一句话概括:
用共享 GCN 编码器提取架构表示,然后同时服务于“性能预测任务”和“参数生成任务”。
根据论文 Figure 1,HyperNAS 可以分成两条分支:
第一条分支是 Performance Prediction Branch。
这一分支是传统 predictor-based NAS 的主线。输入一个候选架构,先经过 GCN 编码器得到架构表示,再通过 regressor 输出预测精度 y^\hat{y}y^。然后用预测精度和真实精度 yyy 计算预测损失 LpredL_{pred}Lpred。
第二条分支是 Parameter Generation Branch。
这一分支使用 shared hypernetwork。GCN 编码器输出节点特征后,hypernetwork 根据这些节点特征为目标网络生成参数。生成的参数会被放入 target network,再通过辅助数据集 DauxD_{aux}Daux 计算目标网络任务损失 LhyperL_{hyper}Lhyper。
这两个任务共享同一个 GCN 编码器。也就是说,GCN 既要服务于精度预测,又要服务于参数生成。这样做的好处是:架构编码器不能只记住少量架构和精度之间的表面映射,而需要学到能够支撑参数生成的、更具结构意义的表示。
训练结束后,论文主要关注 predictor 的性能,因此在实际评估时,hypernetwork 分支可以关闭,只保留 predictor 分支进行快速架构性能预测。
4.2 架构空间表示:把网络看成多个 Cell 的集合
在 cell-based NAS 搜索空间中,一个完整架构 AAA 可以表示为多个 cell 的集合:
A=A(i)i=1N A = { A^{(i)} }_{i=1}^{N} A=A(i)i=1N
其中,A(i)A^{(i)}A(i) 表示第 iii 个 cell。每个 cell 又可以表示为一个 DAG:
A(i)=E(i),V(i) A^{(i)} = {E^{(i)}, V^{(i)}} A(i)=E(i),V(i)
这里:
- E(i)E^{(i)}E(i) 是邻接矩阵,用来描述 cell 内节点之间的连接关系;
- V(i)V^{(i)}V(i) 是节点特征矩阵,用来描述每个节点对应的操作或特征;
- NNN 是整个网络中的 cell 数量。
这一步非常关键,因为 HyperNAS 并不是只看一个孤立 cell,而是要依次处理完整网络中的多个 cell,从而获取全局结构信息。
4.3 Shared GCN Encoder:用于 DAG 的双向信息传播
论文使用一个面向 DAG 的 GCN 作为共享架构编码器。GCN 的更新公式如下:
Vl+1=12ReLU(EVlWl+)+12ReLU(ETVlWl−) V_{l+1} = \frac{1}{2} ReLU(EV_lW_l^+) + \frac{1}{2} ReLU(E^TV_lW_l^-) Vl+1=21ReLU(EVlWl+)+21ReLU(ETVlWl−)
其中:
- VlV_lVl 表示第 lll 层节点特征;
- EEE 是邻接矩阵;
- ETE^TET 表示反向邻接关系;
- Wl+W_l^+Wl+ 和 Wl−W_l^-Wl− 分别对应正向传播和反向传播的可学习参数。
这个设计的直观理解是:
在一个 cell 的 DAG 中,节点之间存在前驱和后继关系。如果只沿一个方向传播信息,可能会丢失部分结构上下文。因此,GCN 同时考虑正向连接和反向连接,让每个节点能够融合来自前后结构的信息。
4.4 Global Architecture Encoding:从孤立 Cell 到全局结构
这是本文最核心的创新之一。
传统 predictor 只编码单个 cell,这会导致一个问题:如果两个 cell 内部结构相同,但它们出现在网络不同位置,或者前后连接环境不同,那么它们对最终网络性能的影响可能并不一样。单独看 cell 是无法区分这些上下文差异的。
HyperNAS 的做法是:按顺序编码每个 cell,并把前一个 cell 的特征传递给下一个 cell。
具体来说,对于第 iii 个 cell,输入 GCN 之前,其节点特征会加上前一个 cell 的特征 z(i−1)z^{(i-1)}z(i−1):
V(i)=v+z(i−1)∣v∈V(i) V^{(i)} = {v + z^{(i-1)} \mid v \in V^{(i)}} V(i)=v+z(i−1)∣v∈V(i)
初始时:
z(0)=0 z^{(0)} = 0 z(0)=0
每个 cell 经过 GCN 后,会得到节点特征 V~(i)\tilde{V}^{(i)}V~(i)。然后通过 pooling 得到 cell-level feature:
z(i)=pool(V~(i)) z^{(i)} = pool(\tilde{V}^{(i)}) z(i)=pool(V~(i))
最后,所有 cell 的表示会被平均聚合成整个架构的全局表示:
h=1N∑i=1Nz(i) h = \frac{1}{N}\sum_{i=1}^{N}z^{(i)} h=N1i=1∑Nz(i)
这个全局表示 hhh 再送入 regressor:
y^=fθ(h) \hat{y} = f_{\theta}(h) y^=fθ(h)
预测损失采用 MSE:
Lpred=MSE(y^,y) L_{pred} = MSE(\hat{y}, y) Lpred=MSE(y^,y)
这部分设计的意义在于:
HyperNAS 不再把一个 cell 当成完整网络的代表,而是让每个 cell 的表示都带有前面 cell 的上下文信息。这样,模型可以更好地区分 normal cell、reduction cell,以及不同 cell 在整个网络中的位置与作用。
从实现角度看,这一部分可以理解成如下伪代码:
z_prev = 0
cell_features = []

for cell in architecture.cells:
    node_features = cell.node_features + z_prev
    node_features_out = shared_gcn(cell.adj, node_features)
    z_i = global_avg_pool(node_features_out)
    cell_features.append(z_i)
    z_prev = z_i

h = mean(cell_features)
pred_acc = regressor(h)
4.5 Shared Hypernetwork Auxiliary Task:让编码器学习更深的架构关系
HyperNAS 的第二个关键设计是引入 shared hypernetwork。
Hypernetwork 的作用是:输入一个表示向量,输出另一个网络的参数。简单来说,它不是直接做分类或回归,而是“生成权重”。
在本文中,hypernetwork 的输入来自 GCN 输出的节点特征。对于某个节点特征 vvv,hypernetwork 生成对应权重:
wv=H(v;ϕ) w_v = H(v; \phi) wv=H(v;ϕ)
对于整个架构,所有节点生成的权重组成目标网络的参数:
w=H(v;ϕ)∣v∈G(z(i−1),A(i);φ)i=1N w = {H(v;\phi) \mid v \in G(z^{(i-1)}, A^{(i)}; \varphi)}_{i=1}^{N} w=H(v;ϕ)∣v∈G(z(i−1),A(i);φ)i=1N
这里:
- GGG 是共享 GCN 编码器;
- HHH 是 shared hypernetwork;
- φ\varphiφ 是 GCN 的参数;
- ϕ\phiϕ 是 hypernetwork 的参数;
- www 是生成出来的 target network 参数。
然后,把这些生成参数放入目标网络中,通过辅助数据集 DauxD_{aux}Daux 计算任务损失 LhyperL_{hyper}Lhyper。论文中使用的是标准 cross-entropy loss。
这里需要注意一个很重要的点:
HyperNAS 并不是用 hypernetwork 直接评价架构好坏,而是把它当成辅助任务。也就是说,最终 NAS 搜索时主要还是依赖 predictor 的排序能力,而 hypernetwork 的作用是在训练阶段给编码器提供额外监督。
这种设计的好处有两个:
第一,hypernetwork 需要根据不同架构生成不同参数,因此它会迫使 GCN 编码器学习更有结构意义的表示,而不是只记住少量 architecture-accuracy pairs。
第二,不同架构共享同一个 hypernetwork,可以形成一种 soft weight-sharing 机制,有利于跨架构知识迁移,从而提升少样本泛化能力。
从实现角度可以理解成:
# shared encoder
node_features_out, cell_features = shared_gcn_encoder(architecture)

# predictor branch
h = aggregate(cell_features)
pred_acc = regressor(h)
loss_pred = mse(pred_acc, gt_acc)

# hypernetwork branch
generated_weights = hypernetwork(node_features_out)
target_net.load_generated_weights(generated_weights)
logits = target_net(aux_images)
loss_hyper = cross_entropy(logits, aux_labels)
4.6 Adaptive Multi-task Objective:平衡两个任务的训练
由于 HyperNAS 同时包含性能预测任务和参数生成任务,因此如何平衡两个任务非常重要。
最简单的方法是手动设置权重:
L=λ1Lpred+λ2Lhyper L = \lambda_1 L_{pred} + \lambda_2 L_{hyper} L=λ1Lpred+λ2Lhyper
但这种方法有明显问题:
不同任务的损失尺度可能不同,训练阶段的重要性也可能变化。如果手动设置 λ\lambdaλ,需要大量调参,而且不一定适合所有阶段。
因此,论文提出了动态自适应多任务损失:
Ltotal=∑t∈TLt(q−1)2ut2⋅Lt+ln(1+ut2) L_{total} = \sum_{t \in T} \frac{L_t^{(q-1)}}{2u_t^2} \cdot L_t + \ln(1+u_t^2) Ltotal=t∈T∑2ut2Lt(q−1)⋅Lt+ln(1+ut2)
也可以直观理解为:
Ltotal=∑t∈TLtq2ut2+ln(1+ut2) L_{total} = \sum_{t \in T} \frac{L_t^q}{2u_t^2} + \ln(1+u_t^2) Ltotal=t∈T∑2ut2Ltq+ln(1+ut2)
其中:
- TTT 是任务集合,在本文中主要包含 predictor task 和 hypernetwork task;
- LtL_tLt 是第 ttt 个任务的损失;
- utu_tut 是可学习的任务权重参数;
- qqq 是 preference coefficient,用来控制不同任务在 Pareto front 上的偏好;
- ln(1+ut2)\ln(1+u_t^2)ln(1+ut2) 是正则项,防止 utu_tut 过大。
这部分可以理解为:模型会自动学习每个任务应该占多大权重,而不是由人工固定指定。与此同时,qqq 可以调整不同任务之间的偏好,使模型在多任务优化中更加灵活。
论文的实验也验证了 qqq 的影响。在多个设置下,q=1.5q=1.5q=1.5 往往比传统的 q=2q=2q=2 表现更好,说明这个 preference coefficient 确实可以改善多任务平衡。
05 实验分析
5.1 NAS-Bench-101 和 NAS-Bench-201:验证 Ranking Ability
NAS predictor 的关键能力不是直接输出一个绝对精度,而是能不能正确排序候选架构。因此,论文在 NAS-Bench-101 和 NAS-Bench-201 上使用 Kendall’s Tau 来评估预测排序和真实排序之间的相关性。
NAS-Bench-101 包含 423,624 个唯一架构,每个架构由多个重复 cell 构成。NAS-Bench-201 包含 15,625 个架构,宏观结构固定,但 cell 内操作组合不同。
在实验中,HyperNAS 特别关注少样本场景。例如:
- NAS-Bench-101 使用 0.01%、0.02%、0.04%、0.1% 等训练样本;
- NAS-Bench-201 使用 0.25%、0.5%、1%、3% 等训练样本。
结果显示,HyperNAS 在不同训练样本比例下基本都取得了最优 Kendall’s Tau。尤其在 NAS-Bench-201 上,相比 PINAT 等 Transformer-based predictor,HyperNAS 在少样本下提升非常明显。
这说明一个重要结论:
HyperNAS 并不是靠更复杂的 backbone 取胜。它使用的仍然是 GCN 编码器,但通过全局编码和 hypernetwork 辅助任务,显著增强了架构表示质量。
5.2 CIFAR-10:在 DARTS 搜索空间中的搜索结果
在 DARTS 搜索空间上,论文比较了 HyperNAS 与多种 NAS 方法的搜索效果。
这里有两个版本需要区分:
- HyperNAS-P: 只使用 predictor 和 global encoding,不使用 hypernetwork 辅助任务;
- HyperNAS: 完整版本,同时使用 predictor 和 hypernetwork 辅助任务。
实验结果中,HyperNAS-P 使用 1000 个 architecture-accuracy pairs,取得了 97.61% 的 best accuracy 和 97.55±0.00% 的 average accuracy,搜索成本仅为 0.1 GPU days。
完整的 HyperNAS 只使用 200 个 architecture-accuracy pairs,就取得了 97.60% 的 best accuracy 和 97.48±0.01% 的 average accuracy。
这个结果说明:
即使训练样本减少到原来的五分之一,HyperNAS 仍然能保持非常强的搜索能力。这也正是论文强调的 few-shot predictor 优势。
5.3 ImageNet:CNN 和 ViT 搜索空间上的验证
论文还在 ImageNet 上进行了更大规模的实验,包括 DARTS 搜索空间和 ViT 搜索空间。
在 DARTS 搜索空间中,HyperNAS 搜索得到的架构在 ImageNet 上达到 75.4% Top-1 accuracy,与已有 predictor-based NAS 方法相比表现较强。
在 ViT-Small 搜索空间中,HyperNAS 得到:
- 参数量:22.8M
- FLOPs:4.8G
- Top-1:81.8%
- Top-5:95.7%
- Queries:0.2K
在 ViT-Base 搜索空间中,HyperNAS 得到:
- 参数量:54M
- FLOPs:11G
- Top-1:82.4%
- Top-5:95.8%
- Queries:0.2K
与 AutoFormer 相比,HyperNAS 只使用约 20% 的 query cost,却取得了相当甚至略优的结果。这说明 HyperNAS 的 predictor 具有较好的泛化能力,能够迁移到 ViT 搜索空间,而不局限于 CNN cell-based 搜索空间。
5.4 消融实验:每个模块是否真的有效?
论文做了比较充分的消融实验,主要验证三个问题。
1. Global Encoding 是否有效?
论文比较了 NP 和 HyperNAS-P。二者都使用 GCN 编码器,不同点在于:
- NP 使用传统单 cell 编码;
- HyperNAS-P 使用本文提出的 global architecture encoding。
结果显示,HyperNAS-P 在不同训练样本设置下均优于 NP,说明全局编码确实提升了 predictor 的排序能力。
此外,论文还通过 t-SNE 可视化比较了不同架构表示。使用 cell feature 进行上下文传递的 global encoding,在 ranking performance 上明显优于只使用 cell position embedding 的方案。这说明简单加入位置编码并不能完全替代前序 cell 特征,前后 cell 的上下文信息对架构表示非常重要。
2. Hypernetwork 是否有效?
论文比较了 HyperNAS-P 和完整 HyperNAS。
结果显示,引入 hypernetwork 后,HyperNAS 在多数数据划分下的 Kendall’s Tau 更高。同时,t-SNE 可视化也表明,加入 hypernetwork 后,架构特征的聚类效果更好。
这说明 hypernetwork 作为辅助任务确实可以帮助 GCN 编码器学习更深层的架构模式,而不只是拟合训练样本中的精度标签。
3. 多任务范式是否有效?
论文还比较了:
- HyperNAS-P:只保留 predictor;
- HyperNAS-H:只保留 hypernetwork;
- HyperNAS:二者共同训练。
结果显示,完整 HyperNAS 中 predictor 的 ranking ability 优于 HyperNAS-P,同时 hypernetwork 的验证性能也优于 HyperNAS-H。这说明两个任务之间并不是互相干扰,而是可以互相促进。
4. q 值对多任务平衡的影响
论文测试了 q=1.25,1.5,2,3q = 1.25, 1.5, 2, 3q=1.25,1.5,2,3 等不同取值。结果发现,在多数数据划分下,q=1.5q=1.5q=1.5 对 predictor ranking ability 和 hypernetwork parameter generation ability 都更友好。
这说明本文提出的 preference coefficient 并不是一个形式上的设计,而是真正影响多任务优化过程。
06 总结与个人理解
我认为这篇论文的关键价值不在于提出了一个更复杂的搜索算法,而在于重新思考了 NAS predictor 的训练方式。
传统 predictor-based NAS 的目标比较直接:给定架构,预测精度。但如果训练样本很少,模型很容易只学到表面的 architecture-accuracy 映射关系。HyperNAS 的思路是:既然架构表示不够强,那就给编码器增加一个辅助任务,让它不仅要预测性能,还要具备为架构生成参数的能力。
这种设计带来的好处是,GCN 编码器被迫学习更具结构意义的架构表示。Global Encoding 负责补足宏观结构信息,Hypernetwork Auxiliary Task 负责增强跨架构关系建模,Adaptive Multi-task Loss 则负责平衡两个任务之间的优化关系。
如果从复现或后续改进角度看,我认为这篇论文有几个值得关注的方向:
-
可以尝试替换 GCN Encoder。
虽然本文使用 GCN 已经取得不错效果,但对于更复杂的搜索空间,也可以尝试 Graph Transformer、GIN、Graphormer 等更强的图编码器。 -
可以研究更轻量的 Hypernetwork。
论文也提到,面对极大规模架构时,hypernetwork 仍然可能带来额外开销。因此,如何保留辅助任务的表示增强效果,同时降低生成参数成本,是一个很自然的后续方向。 -
可以迁移到具体任务 NAS。
本文主要验证分类任务中的 NAS 搜索空间。如果扩展到目标检测、语义分割、多模态融合等任务,HyperNAS 的全局架构编码和辅助任务思想也可能有启发意义。
总体来看,HyperNAS 给 predictor-based NAS 提供了一个很有价值的方向:不要只关注 predictor 最后一层回归得准不准,而要关注架构表示本身是否足够好。对于少样本 NAS 场景,这一点尤其重要。
07 个人声明
本文为作者对原论文的学习笔记与心得分享,受个人学识与理解所限,文中对论文内容的解读或有不够周全之处,一切以原论文正式表述为准。本文仅用于学术交流与传播,内容均由作者独立整理完成,不代表本公众号立场。如文中所涉文字、图片等内容存在版权争议,请及时与作者联系,作者将在第一时间核实并妥善处理。

AtomGit 是由开放原子开源基金会联合 CSDN 等生态伙伴共同推出的新一代开源与人工智能协作平台。平台坚持“开放、中立、公益”的理念,把代码托管、模型共享、数据集托管、智能体开发体验和算力服务整合在一起,为开发者提供从开发、训练到部署的一站式体验。
更多推荐
 10
 0
- 0


 已为社区贡献3条内容

所有评论(0)