DeepexiMQL模型训练实践
企业经营洞察的关键,不是让模型⽣成⼀段看起来合理的 SQL,⽽是把⽤户的⾃然语⾔问题稳定转换成可治理、可执⾏的业务查询结构。Text2Metric 任务把查询⽬标从底层 SQL 收敛到指标语义层,先描述⽤户要查什么指标、使⽤什么时间和过滤条件、是否分组排序,再交给后续系统执⾏。在本⽂讨论的实现⾥,这个结构化查询表示就是 MQL(Metric Query Language)。
直接调⽤通⽤⼤模型⽣成 MQL,结构解析效果仍然难以达到⽣产要求。本⽂介绍 DeepexiMQL 模型的训练实践:为什么企业指标分析需要⾯向 Text2Metric 任务⾃训练模型,训练数据如何通过 MQL2Query 反向构造,训练⽬标如何通过 Special Token 做字段级建模,以及这套能⼒如何进⼊产品化链路。
⼀、背景:为什么企业经营洞察Ω要从 Text2SQL ⾛向Text2Metric
Text2SQL 的⽬标很直观:给定⾃然语⾔问题和数据库 Schema,让模型⽣成可执⾏ SQL。这个⽅向已经有很多研究和评测集,也很适合做演示。但进⼊企业指标分析场景后,直接让⼤模型⽣成底层 SQL,通常会遇到⼏个问题。
第⼀,业务指标和物理 Schema 不完全⼀致。业务⽤户问“华东区⼥鞋的净利润是多少”,数据库⾥未必有⼀个叫净利润的单列。净利润可能由订单⾦额、退款⾦额、成本、渠道过滤和组织规则共同定义。SQL 语法正确,不代表业务⼝径正确。
第⼆,SQL 执⾏会触碰治理边界。企业数据系统通常有指标⼝径、⾏列权限、脱敏规则和查询治理。模型如果直接⽣成底层 SQL,就容易绕过应⽤层的治理逻辑。
第三,通⽤模型⽣成 SQL 仍然有执⾏⻛险。在真实数仓⾥,表和字段数量多、命名不规整、关联关系复杂。模型
可能编造字段,写错关联条件,或者触发⾼成本扫描。
更稳妥的做法,是不要让模型直接⾯对底层物理表。模型不直接⽣成底层 SQL,⽽是先完成 Text2Metric:把⾃然语⾔问题转换成指标语义层可以理解的结构化查询。这个任务关⼼的不是 SQL ⾥的表名、字段名和关联路径,⽽是⽤户要查什么指标、在什么时间范围内查、有哪些过滤条件、是否需要分组、排序和限制返回条数。
为了让这个结构既能表达业务问题,⼜能被后续系统稳定校验和编译,我们需要⼀种⾯向指标分析的中间表示。本⽂把这种中间表示称为MQL(Metric Query Language)。模型先把⾃然语⾔问题解析成 MQL,下游语义引擎再根据 MQL 完成指标⼝径、权限治理、SQL ⽣成和查询执⾏。
⼀个典型问题是:
看⼀下华东区域品牌 A ⼥鞋,近半年各⻔店每周销售额超过 500 的前 10 名。
MQL 需要表达的是这次分析请求⾥的业务结构:
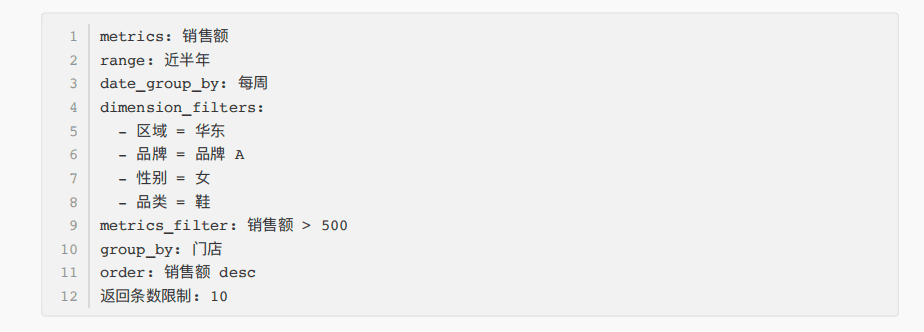
这类结构不关心底层表怎么关联,也不直接决定 SQL 方言。它把用户意图先收敛到指标语义层:查什么指标、在什么时间范围内查、用哪些维度过滤、是否分组、是否排序、是否限制返回条数。
企业经营洞察需要的不是让模型直接写 SQL,⽽是先把⾃然语⾔问题转换成可治理、可执⾏的指标语义结构。Text2Metric 解决的是这个前置解析问题,MQL 则是本⽂中承接这⼀解析结果的结构化表示。
⼆、问题:为什么通⽤⼤模型难以稳定完成 Text2Metric 任务
既然 MQL 已经把输出约束成结构化表示,⼀个⾃然想法是:是否可以直接让 GPT-4o、GPT-5.2 这类通⽤⼤模型⽣成 MQL?
我们早期也尝试过这条路径。通过较⻓ Prompt,把当前时间、候选指标、候选维度、维度示例值、MQL 字段说明、时间规则、操作符规则和 few-shot 示例都放进去,通⽤模型确实可以覆盖⼀部分常⻅问题。
但这条路径的结构解析效果仍然不够稳定:
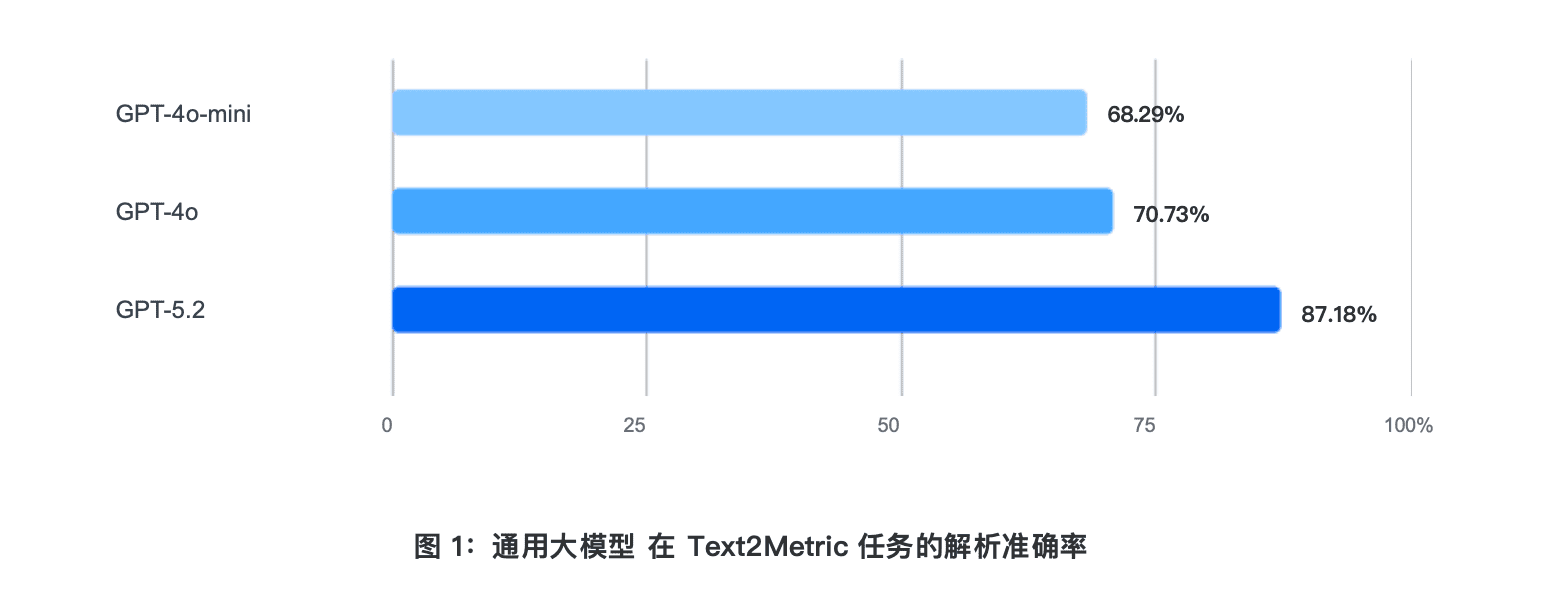
这⾥的通⽤⼤模型基线采⽤完整 MQL JSON ⼀次性⽣成的⽅式,也就是在⼀次推理中同时输出指标、时间范围、
时间粒度、维度过滤、指标过滤、分组、排序和返回条数限制等多个字段。
问题在于,Text2Metric 不是普通 JSON ⽣成任务,⽽是受业务 Schema 约束的多意图分析与字段归因任务。模型不仅要输出格式正确的结构,还要完成指标选择、业务表达拆解、时间语义归⼀化、过滤条件识别、分组判断、排序⽅向判断和返回条数限制识别。通⽤模型能⼒越强,效果会提升,但它仍然依赖⻓ Prompt 临时解释规则,稳定性、成本和可控性都不适合作为⽣产链路的唯⼀依赖。
通⽤⼤模型⼀次性⽣成完整 MQL JSON 时,可以覆盖⼀部分常⻅问题,但 Text2Metric 任务的多字段结构解析效果仍然难以满⾜⽣产要求。我们需要把这类能⼒沉淀到⾯向 Text2Metric 的专⽤模型⾥。
三、⽅案:DeepexiMQL模型是什么,以及怎么做
3.1 DeepexiMQL模型是什么
DeepexiMQL模型的边界很明确:
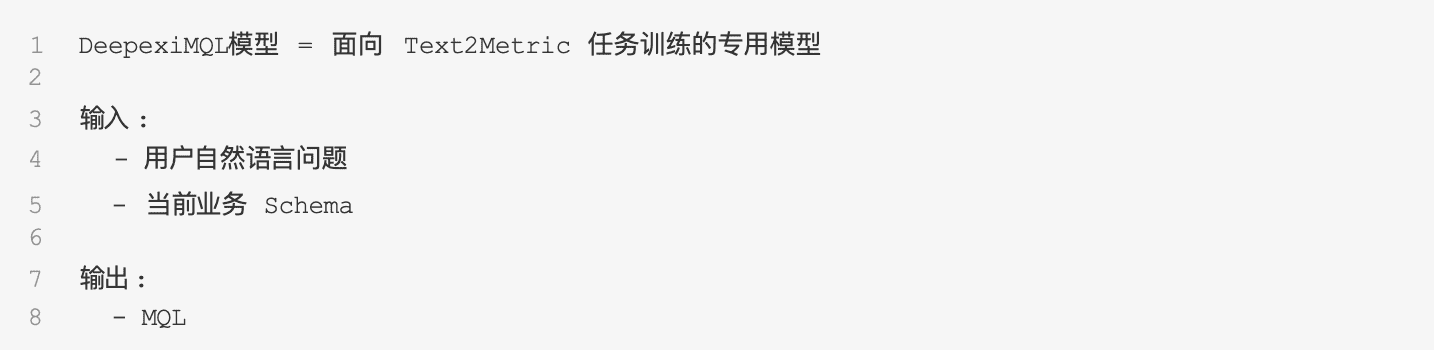
它不是通用聊天模型,不是完整数据分析系统,也不是直接生成底层 SQL 的模型。它负责的是指标分析链路中的前置解析:

其中 Schema Context 通常包含:
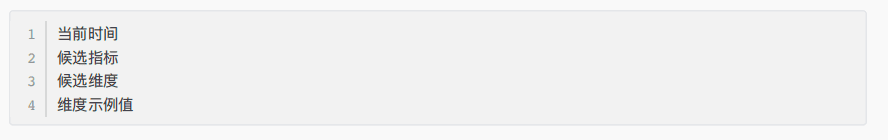
模型需要在当前 Schema 约束下,完成多意图分析、业务表达拆解、时间语义归⼀化和字段归因,并把指标、时间范围、时间粒度、维度过滤、指标过滤、分组、排序和返回条数限制等结果组织成 MQL。下游语义引擎再接过MQL,处理指标⼝径、权限、SQL 编译、执⾏和结果组织。
DeepexiMQL模型的定位是 Text2Metric 前置解析模型:输⼊⾃然语⾔问题和当前 Schema,输出可被下游语义引擎承接的 MQL。
如果把这个过程形式化,可以把⽤户问题记为x,当前业务 Schema 上下⽂记为,s模型要输出的 MQL 结构记为y。Text2Metric 要学习的就是:Text2Metric 要学习的就是:
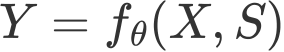
也就是在 Schema 约束下,把⾃然语⾔问题映射到可执⾏的指标语义结构。这个定义很重要,因为它把任务边界从“⽣成⼀段 SQL ⽂本”收敛为“在业务语义空间⾥预测结构化查询”。
3.2 训练数据怎么构造:MQL2Query 反向构造
训练 DeepexiMQL模型⾸先要解决样本来源问题。Text2Metric 不是开放问答任务,⼀条有效样本不仅要有⾃然语⾔ Query,还要有当前 Schema Context 和对应的 MQL Label。
这件事难在三个地⽅:客户真实⽇志和指标⼝径不能直接进⼊训练;⼈⼯标注 MQL 成本⾼且覆盖不可控;让教师模型“先写 Query,再猜 MQL”⼜容易引⼊ Label 噪声,例如漏过滤条件、写错⽐较符或字段归因错误。因此,我们没有采⽤“先⽣成 Query,再让教师模型猜 MQL”的路径,⽽是反过来做:先构造合法 MQL,再⽣成⾃然语⾔ Query。这个过程称为MQL2Query。
从概率建模⻆度看,直接让教师模型从⾃然语⾔反推结构,本质上是在做:
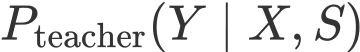
但这⾥的y是训练标签,⼀旦教师模型在指标、过滤条件或时间字段上判断错误,错误就会进⼊监督数据。MQL2Query 把路径反过来,先在 Schema 约束下采样合法结构y,再让教师模型⽣成⾃然语⾔表达:
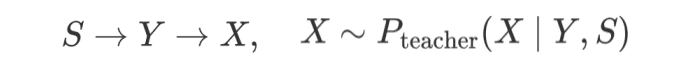
这样教师模型只负责把已经确定的结构条件改写成⾃然语⾔,⽽不是决定最终 Label。
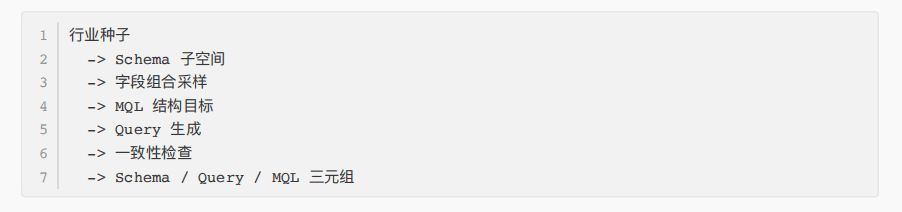
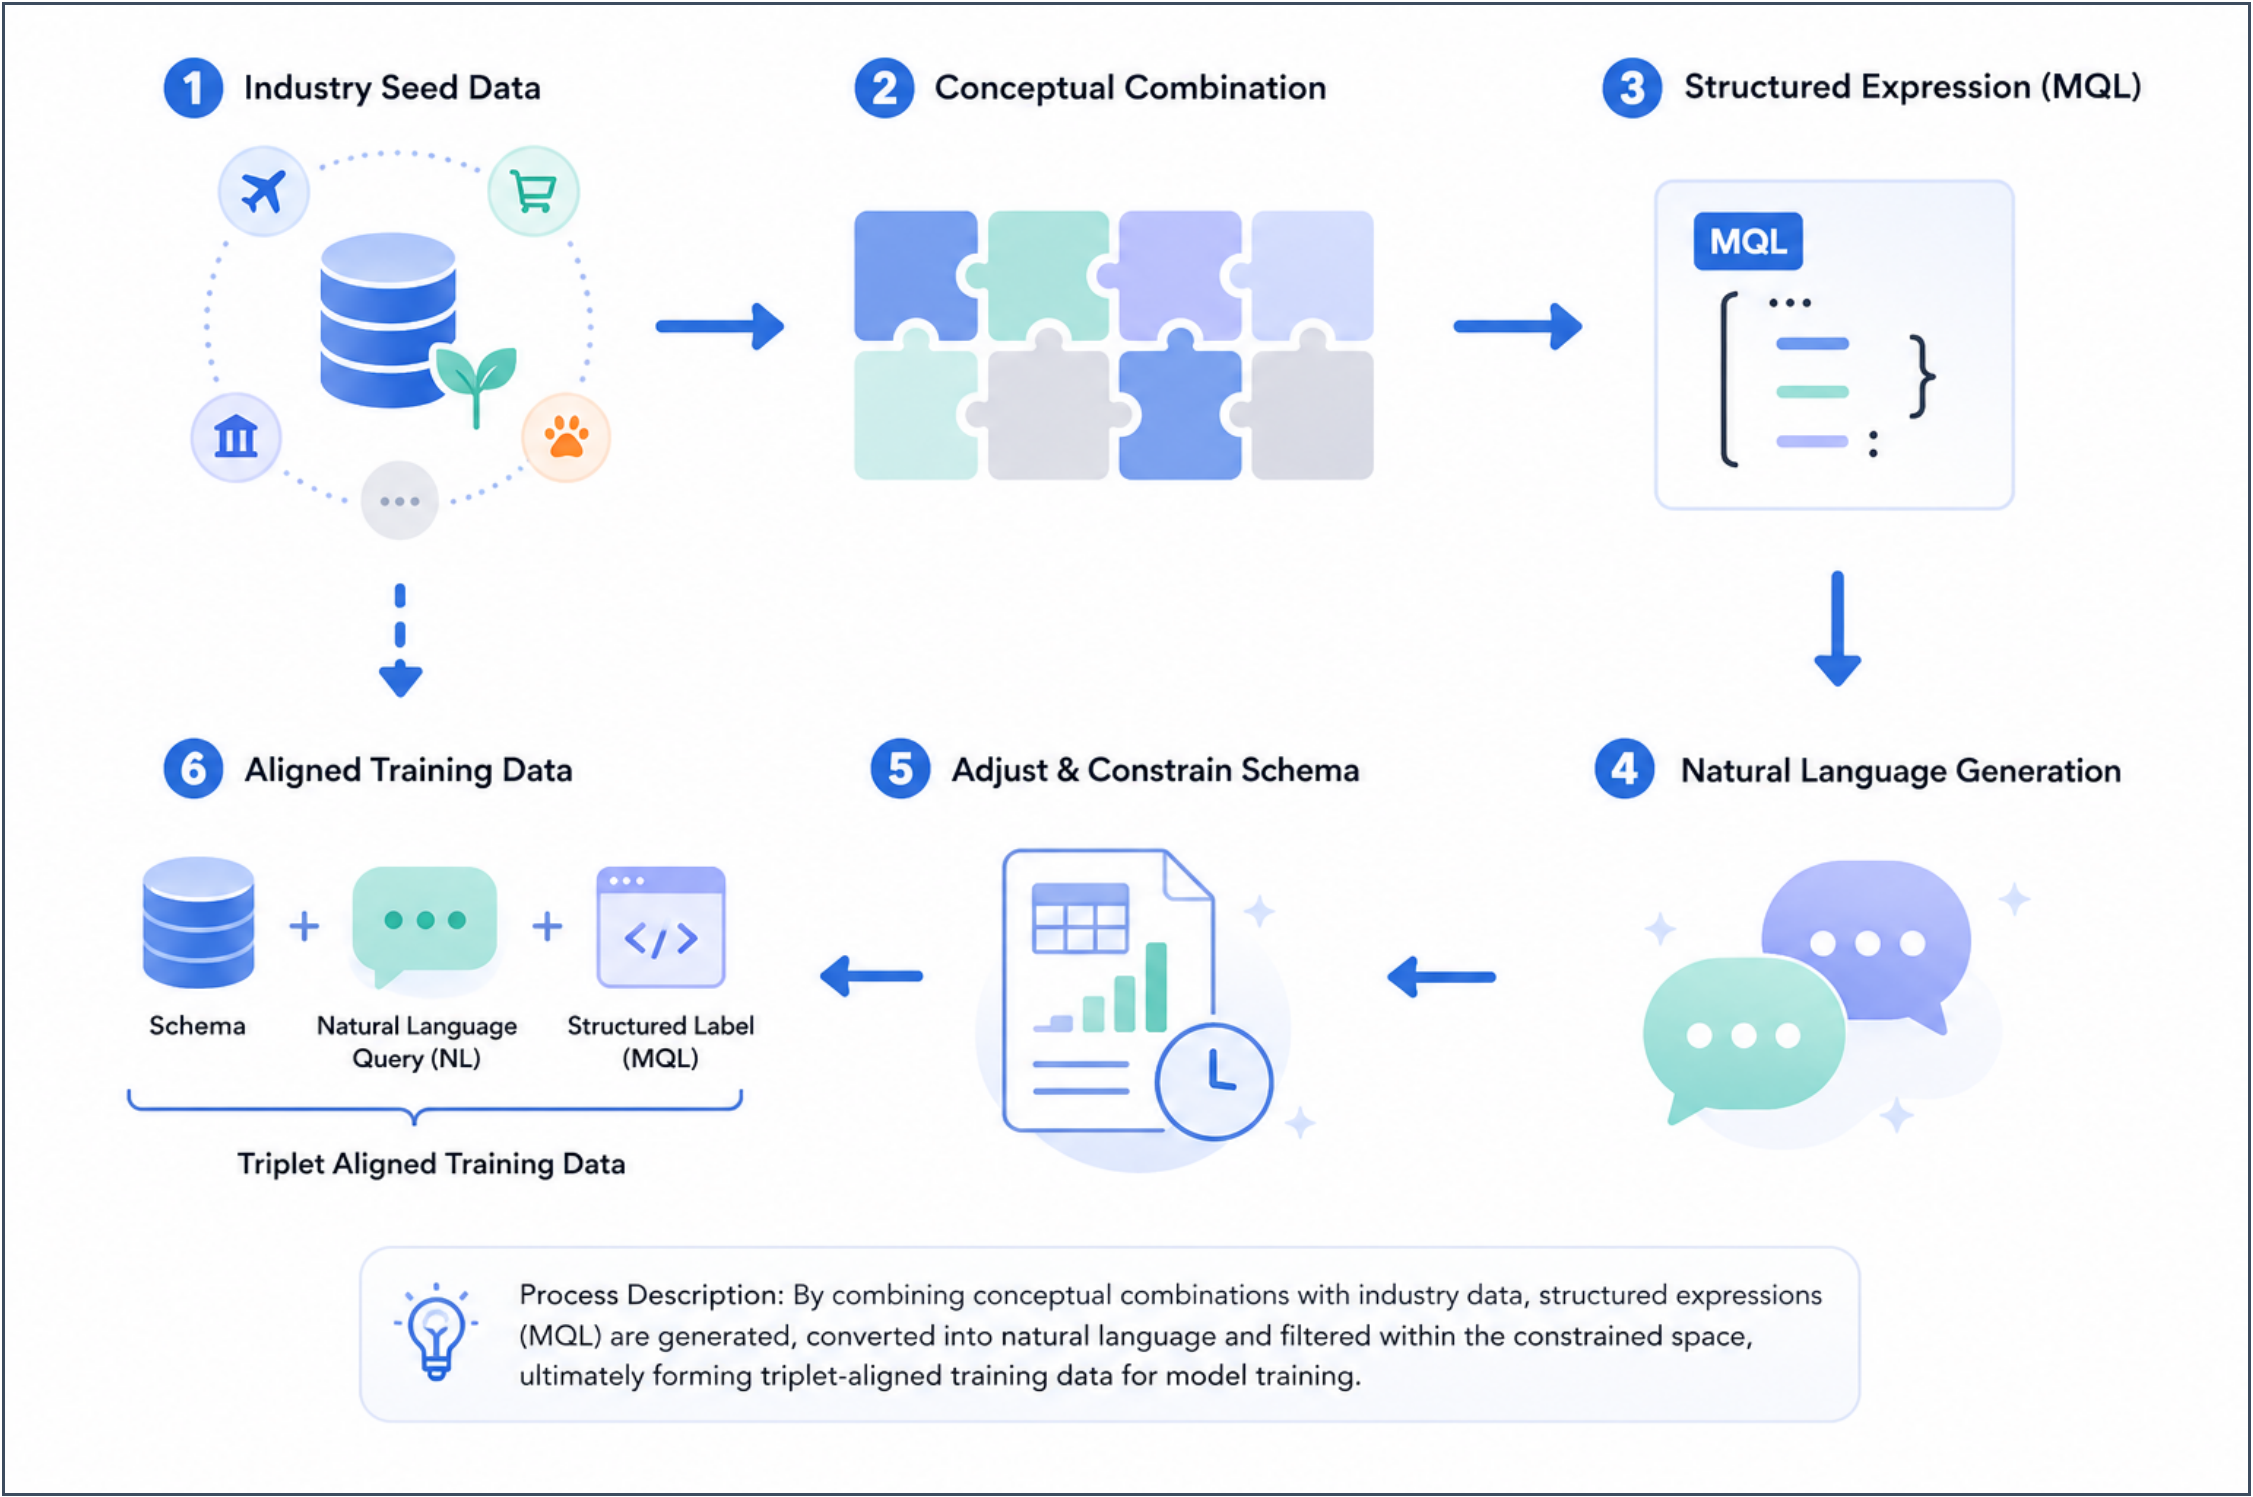
图 2:MQL2Query 反向数据构造流程MQL2Query 可以概括为三段。
第⼀,构建可控的 Schema 空间。基于⾏业场景抽象出指标、维度和值空间,再从中采样候选指标、候选维度和维度示例值。这个过程不使⽤客户真实数据,但保留业务 Schema 的形态。
第⼆,先⽣成结构⽬标,再⽣成⾃然语⾔问题。系统对 MQL 的 8 类字段做组合采样,过滤不合理依赖,再由字段⽣成器⽣成 MQL 结构⽬标。到这⼀步,样本 Label 已经确定;教师模型只负责把结构条件改写成⾃然语⾔Query。
第三,做⼀致性检查和候选 Schema 调整。⽣成后的 Query 不能遗漏 MQL 条件,也不能新增结构⾥没有的条件;⽐较符、排序⽅向和相对时间语义不能改变。同时,数据构造会模拟真实推理输⼊:控制候选数量、加⼊⼲扰项、删除部分⽬标值或只保留相似示例值。最终样本是三者对⻬:

形式化地看,传统构造⽅式更接近:

MQL2Query 则是:

这样做带来三个直接收益:不使⽤客户真实隐私数据;Label 在结构⽬标侧确定,更可靠;字段覆盖更可控。MQL 输出可以拆成 8 类字段:
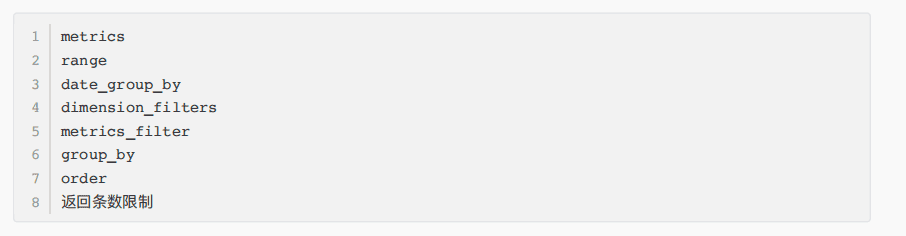
理论上,8 类字段可以形成:

种⾮空组合。过滤掉不合理依赖后,我们保留 159 类有效组合,⽤于覆盖简单查询、多字段查询和边界场景。
这个组合覆盖可以写成:
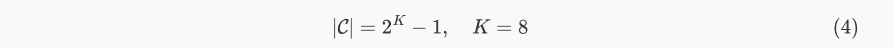
其中表示⾮空字段组合空间。实际训练时并不会机械保留全部组合,⽽是通过规则约束过滤掉语义上不成⽴的组合,得到更接近业务查询分布的有效集合Cualid
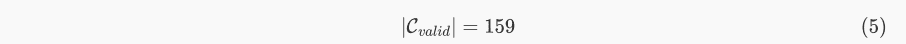
MQL2Query 的价值不只是合成更多⽂本,⽽是把数据质量控制放到结构⽬标侧:先确定 MQL Label,再⽣成⾃然语⾔ Query,从⽽让字段覆盖、Label 准确性和 Schema 对⻬更可控。
3.3 训练⽬标怎么组织:Special Token 字段级建模
数据构造解决了“样本从哪⾥来”和“Label 是否可靠”的问题,但完整 MQL JSON 训练仍然会带来多字段⼲扰。⼀次性⽣成完整 JSON 时,模型既要学习括号、引号、字段名和字段顺序,也要学习指标、时间、过滤、分组、排序和返回条数限制等业务判断。
这会带来四类问题:格式 token 稀释关键监督信号;不同字段的学习⽬标相互⼲扰;⾃回归⽣成会让靠前字段错误影响后续字段;线上 badcase 集中到某类字段时,完整 JSON 训练也不⽅便局部迭代。
因此,DeepexiMQL模型采⽤ Special Token 字段级任务建模:不让模型⼀次性⽣成完整 MQL,⽽是把 MQL 拆成字段级任务。
如果⼀次性⽣成完整 MQL JSON,标准⾃回归训练⽬标可以写成:
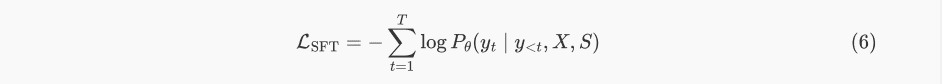
JSON 越⻓,格式 token 对损失的占⽐越⾼,模型越容易把优化能⼒消耗在“输出格式正确”上,⽽不是业务字段归因。
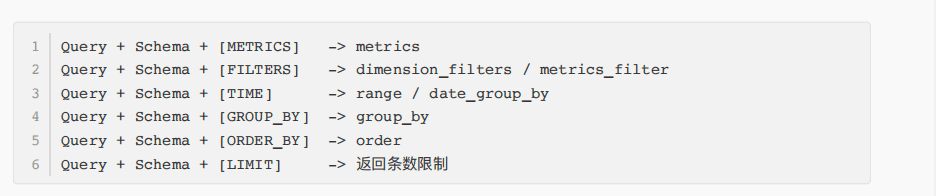
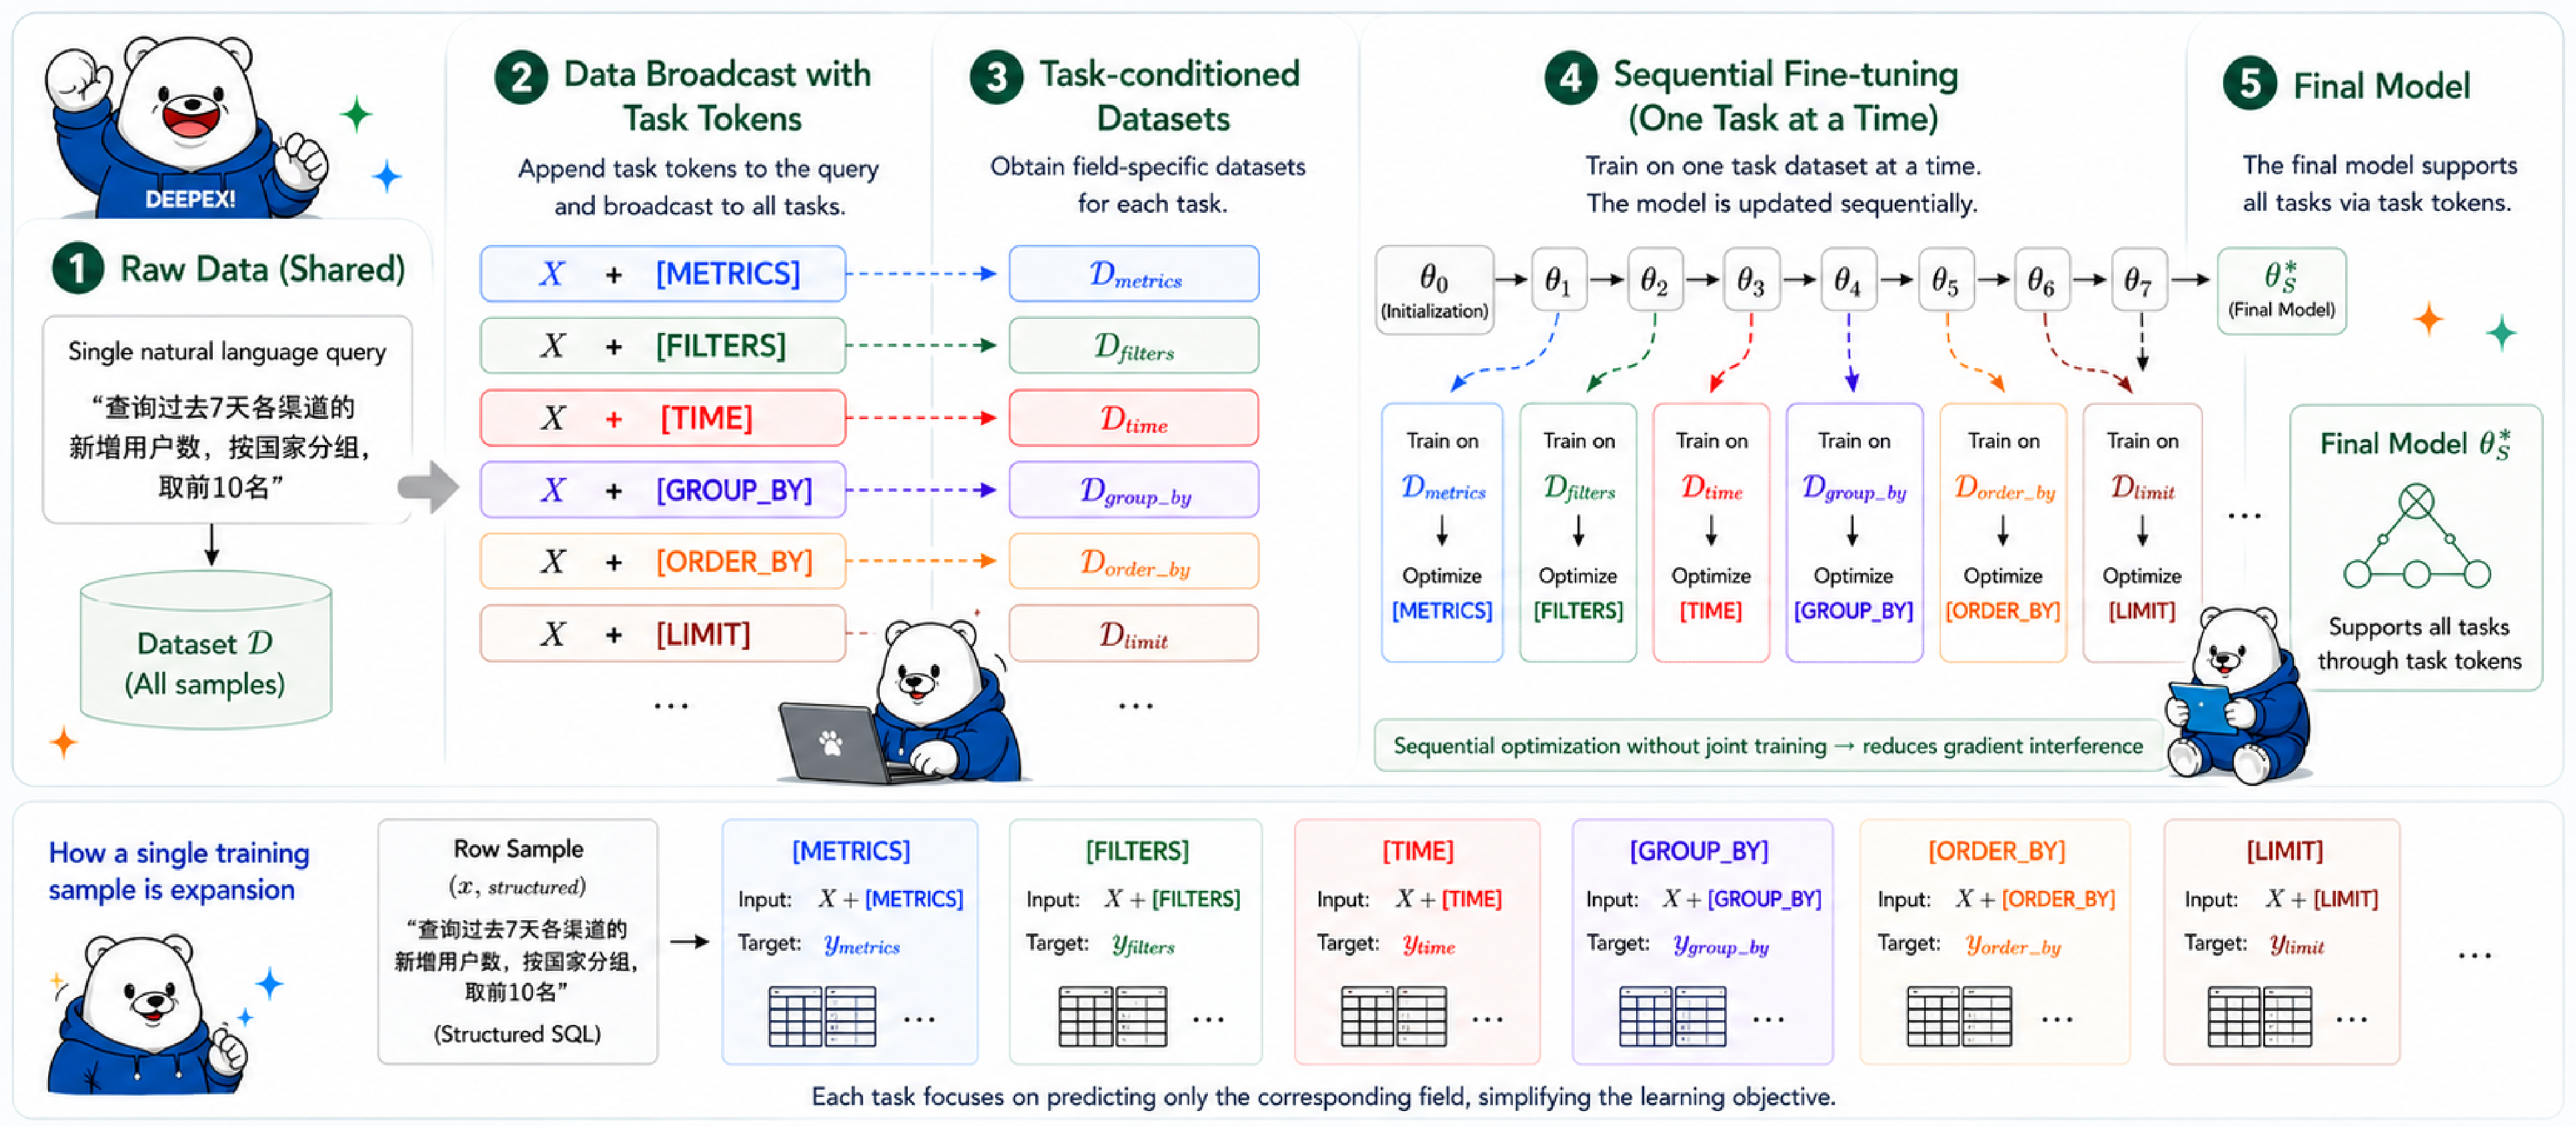
图 3:Special Token 驱动的字段级任务建模流程
这个设计不是训练多个模型,也不是为每个字段维护⼀套独⽴参数。最终仍然是同⼀个 DeepexiMQL模型,只是通过任务 Token 指定当前要解析的字段。⼀条完整样本会被展开成多条字段级训练样本:
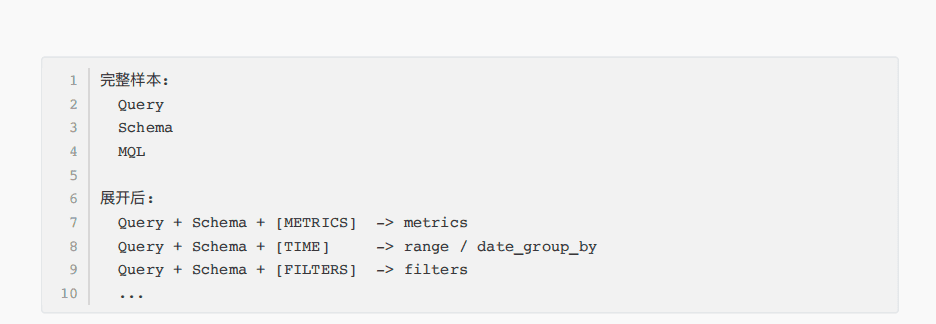
训练时,同⼀条样本会被⼴播到多个任务 Token 下,每条样本的⽬标只对应⼀个字段或⼀类字段。部分空字段样本也会被保留,让模型学会在⽤户没有触发分组、排序或返回条数限制时输出空结果,⽽不是强⾏补全条件。
形式化地看,我们把完整结构y拆成k个字段⼦结构:

每个字段任务对应⼀个 Special Token tk,例如[METRICS]、[TIME]、[FILTERS]。训练⽬标也从完整 JSON 的单序列⽣成,变成多个字段任务的加权解耦损失:
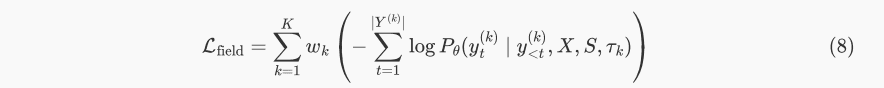
其中wk是字段权重。线上如果发现某类 badcase 集中在复杂维度过滤或时间粒度判断上,就可以优先补充该字段
的训练样本,必要时提⾼对应wk,⽽不需要重构整条 MQL JSON 的训练⽬标。
总结来看,Special Token 字段级任务建模主要带来三点收益。
第⼀,监督信号更集中,关键判断不会被⼤量 JSON 格式 token 稀释。第⼆,字段之间的训练⼲扰更⼩,不同字段可以共享语义表示,但由任务 Token 明确当前输出⽬标。第三,迭代更容易定位,后续可以优先补充出错字段对应的训练样本,⽽不必每次重构完整 MQL JSON 数据集。
Special Token 字段级建模把完整 MQL JSON ⽣成拆成多个字段级任务,使监督信号更集中,字段之间的训练⼲扰更⼩,也让后续 badcase 能按字段补充和迭代。
回头来看,DeepexiMQL模型的核⼼不是简单微调⼀个模型,⽽是同时重构训练数据和训练⽬标:⽤ MQL2Query 控制数据与 Label,⽤ Special Token 降低多字段训练⼲扰。
四、效果:结构解析准确率是否满⾜⽣产要求
经过 MQL2Query 数据构造和 Special Token 字段级训练后,我们在内部评测和端测中⽐较 DeepexiMQL模型和通⽤⼤模型的结构解析表现。这⾥的通⽤⼤模型基线采⽤完整 MQL JSON ⼀次性⽣成的⽅式,也就是在⼀次推理中同时输出指标、时间、过滤、分组、排序和返回条数限制等多个字段。
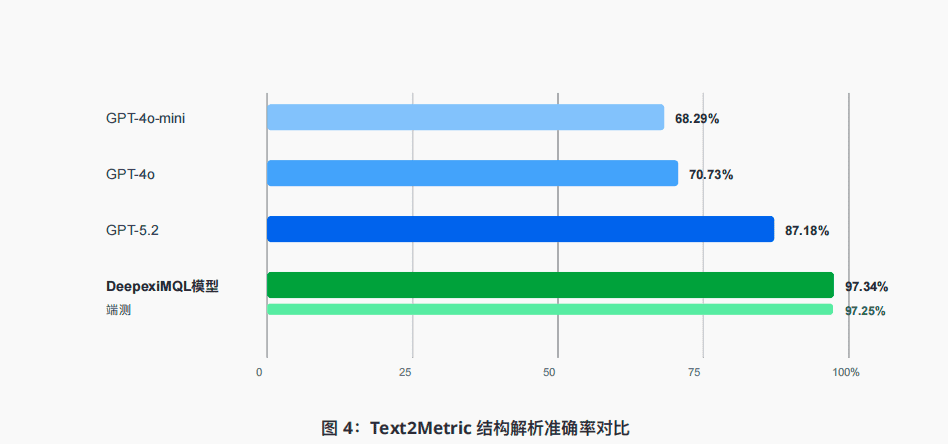
内部评测覆盖指标选择、时间范围、时间粒度、维度过滤、指标过滤、分组、排序和返回条数限制等 MQL 字段,⽤来观察模型在统⼀样本集上的结构解析能⼒。端测更接近真实业务链路中的输⼊分布和调⽤⽅式,⽤来验证模型接⼊系统后的可⽤性。
DeepexiMQL模型在内部评测中达到 97.34%,端测达到 97.25%,两组结果接近,说明模型不仅在离线测试集中有效,也能迁移到实际业务调⽤形态中。
这组结果对应前⾯的训练设计:MQL2Query 反向构造让训练数据的字段覆盖和 Label 质量更可控,Special Token 字段级建模降低了完整 MQL JSON 训练中的多字段⼲扰。对于 Text2Metric 这种强 Schema、强结构、强执⾏约束的任务,专⻔的数据构造和训练⽬标设计能够带来更稳定的解析效果。
评测结果说明,MQL2Query 数据构造和 Special Token 字段级训练对 Text2Metric 任务是有效的:它们提升了多字段结构解析的稳定性,也减少了对超⻓ Prompt 和外部⼤模型 API 的依赖。从经济性⻆度看,这意味着前置解析能⼒可以⽤更可控的模型规模、部署⽅式和调⽤成本进⼊⽣产链路。
五、结论:从模型训练到产品化能⼒
DataSense 产品是基于多智能体协同的下⼀代企业级数据智能分析系统,致⼒于打造全员可⽤、业务驱动、闭环决策的智能数据中枢。⾯向的是企业运营智能体场景:⽤户不是只想和模型聊天,⽽是希望系统接得上企业数据、对得上统⼀业务⼝径、跑得动流程、管得住权限,并能在多轮对话和⼯具调⽤中持续完成分析和⾏动。DeepexiMQL服务于 DataSense 产品链路中的前置解析模块。
这件事看起来只是“⽣成⼀个结构”,但它决定了后续链路能不能接得稳。只有 MQL ⾜够准确,语义引擎才能继续完成指标⼝径匹配、权限控制、SQL 编译、查询执⾏和结果组织;如果前置解析错了,后续 Agent 规划、⼯具调⽤和分析建议都会建⽴在错误的数据请求上。
因此,DeepexiMQL模型带来的价值主要体现在⼏个⽅⾯:
-
降低对⻓ Prompt 和外部闭源模型的依赖;
-
⽀持私有化和低成本部署;
-
企业 Schema、指标⼝径和元数据不需要⻓期暴露给外部 API;
-
Schema 对⻬、字段归因、复合表达、时间规则等能⼒可以持续迭代;
-
让⾃然语⾔⼊⼝更稳定地连接 DataSense 的指标语义层。
DeepexiMQL模型是把⾃然语⾔⼊⼝接⼊企业语义层的关键前置能⼒。它的价值不只是模型指标提升,⽽是把Text2Metric 前置解析变成可训练、可评测、可部署、可持续迭代的产品化能⼒,从⽽⽀撑后续语义引擎、Agent 规划、Skills 调⽤和结果组织稳定运⾏。
下⼀篇会继续讨论 DeepexiMQL模型进⼊真实企业⽣产环境后的推理问题。训练阶段解决的是“模型能不能学会⽣成 MQL”,但线上使⽤还会遇到更具体的⽣产级别的挑战:复杂语义场景下的稳定推理以及对响应时间的要求等,
例如复合业务表达拆解、示例值不完整时的实体归因、复杂相对时间计算,响应时间的要求。推理篇会围绕这些问题展开,重点讨论如何在保证结构准确率的同时,让 DeepexiMQL模型更稳定地服务⽣产链路。
参考⽂献
1. Dong, Y. et al. Spider 2.0: Evaluating Language Models on Enterprise Text-to-SQL Workloads. 2024.
2. Wang, Y. et al. Self-Instruct: Aligning Language Models with Self-Generated Instructions. ACL 2023.
3. Geirhos, R. et al. Shortcut Learning in Deep Neural Networks. Nature Machine Intelligence, 2020.

AtomGit 是由开放原子开源基金会联合 CSDN 等生态伙伴共同推出的新一代开源与人工智能协作平台。平台坚持“开放、中立、公益”的理念,把代码托管、模型共享、数据集托管、智能体开发体验和算力服务整合在一起,为开发者提供从开发、训练到部署的一站式体验。
更多推荐



 4
 0
- 0


 已为社区贡献2条内容

所有评论(0)