我复刻了一个企业级 API 开放平台
我复刻了一个企业级 API 开放平台
一个后端开发者的自白:我是如何从"调用公司开放接口"到"亲手复刻一整套微服务架构",把每天工作中那些黑盒系统变成自己能够掌控的代码的。
项目地址:https://github.com/DevYangJC/intelli_hub
写在前面
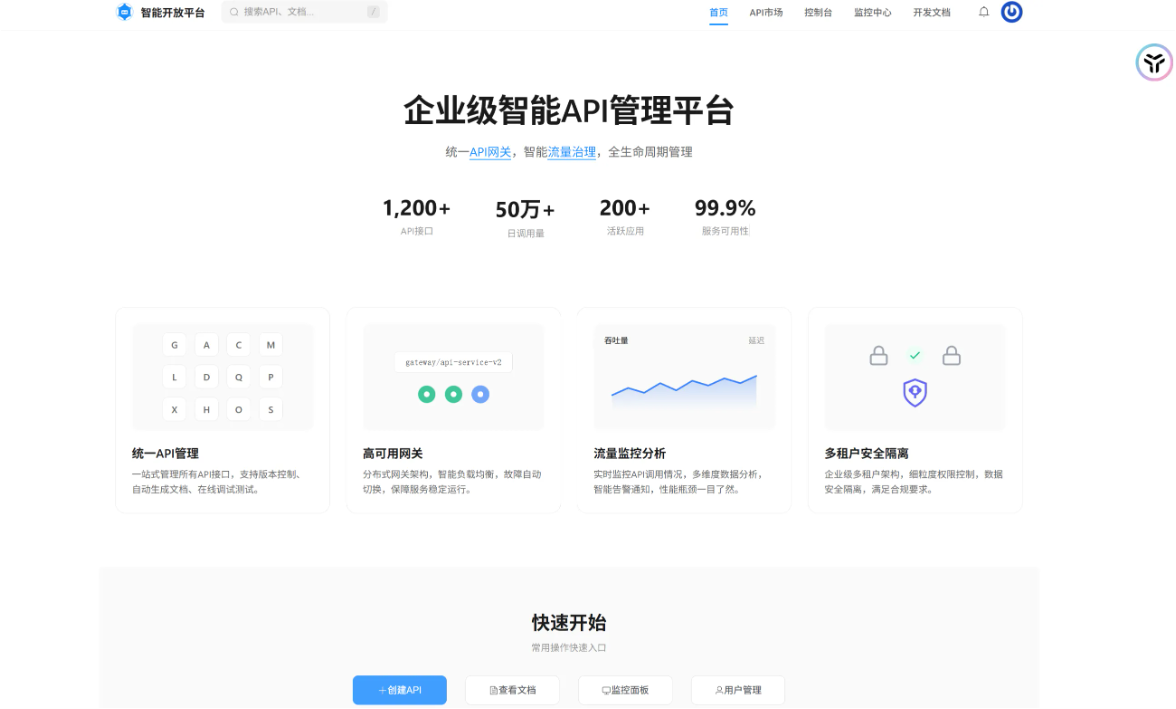
前段时间,我做了一件看起来有点"傻"的事——把我们公司内部用的那套企业级 API 开放平台,从零开始完整复刻了一遍。
不是简单模仿界面,也不是写个 Demo 跑通流程,而是真正按照生产级标准,搭建了一整套微服务架构,并且全部开源到了 GitHub 上。
很多人问我:“公司不是已经有现成的系统了吗?干嘛还要自己重写?”
说实话,我也问过自己这个问题。但答案很朴素:我想真正搞懂它。
每天在工作中调用那些开放接口,看着监控面板上百万级的 QPS,我心里总有个声音在问:"这背后到底是怎么运作的?"文档再详细,也不如亲手搭一遍来得透彻。
于是,我给自己定了一个目标:不做玩具项目,要做出一个能跑、能看、能改、结构清晰的"最小可行生产系统"。
现在项目已经完整跑起来了,这篇文章就是我对这段旅程的完整记录——踩过的坑、做出的抉择、以及那些让我真正理解"企业级"的崩溃时刻。
一、项目定位与技术选型
1.1 我要做一个什么样的系统?
在动手之前,我先想清楚了一件事:我不需要复刻公司系统的全部功能,但核心链路必须完整。
一个 API 开放平台最核心的能力是什么?我画了一张图:
说白了就是:外部调用方通过网关访问内部服务,过程中完成认证、鉴权、限流、日志记录,最后还能看到统计数据。
基于这个核心链路,我拆出了这几个模块:
| 模块 | 一句话说明 |
|---|---|
| 网关 | 所有流量的统一入口,负责路由、鉴权、限流 |
| IAM 认证中心 | 用户、角色、权限、租户管理 |
| API 平台 | API 注册、发布、版本管理 |
| 应用中心 | 第三方应用管理、AppKey 签发、订阅关系 |
| 治理中心 | 调用日志、统计聚合、告警检测 |
| 事件中心 | 异步事件的分发与重试 |
| 搜索服务 | 跨模块的聚合搜索 |
| AIGC 服务 | AI 问答与告警智能分析 |
1.2 为什么选这套技术栈?
确定了"做什么"之后,接下来是"用什么做"。作为一个 Java 后端,技术选型对我来说其实没什么悬念——Spring Boot 全家桶是标配。但有几个关键选择,我想展开说说。
网关选型:Zuul → Spring Cloud Gateway
一开始我用的是 Zuul 1.x,为什么?因为网上教程最多,资料最全。结果一压测就傻眼了——4 核 8G 的机器,压到 500 QPS CPU 就飙到了 95%。查了一圈才知道,Zuul 1.x 是基于 Servlet 的同步模型,每个请求占用一个线程,线程一多上下文切换开销直接爆炸。
换成 Spring Cloud Gateway 之后,同样的机器同样的压测条件,CPU 稳定在 40% 左右。原因很简单——Gateway 基于 Spring WebFlux 和 Netty,用的是响应式模型,线程数量少得多。
RPC 选型:为什么是 Dubbo 不是 Feign?
这个决定其实纠结了一阵。Feign 是 Spring Cloud 原生支持的,用起来更"Spring"。但我想到了一个问题:网关在转发开放 API 请求时,需要调用后端任意一个服务的方法,但网关不可能引入所有服务的接口 JAR。
Dubbo 的泛化调用(GenericService)正好解决这个问题——不需要接口 JAR,只需要知道接口名、方法名和参数,就能通过反射调用。
而且 Dubbo 3.x 对 Nacos 注册中心有原生支持,跟 Spring Cloud Alibaba 集成得很好。
消息队列:Kafka 还是 RabbitMQ?
治理中心需要处理每天的调用日志,量级预计在百万级。Kafka 的吞吐能力和日志持久化特性天然适合这种场景。同时事件中心也需要消息能力,统一用一种 MQ 可以减少运维成本。
最终选了 Kafka,但在单机部署场景下,它的运维复杂度确实比 RabbitMQ 高不少。
最终的技术栈清单
| 层次 | 技术 | 版本 | 为什么选它 |
|---|---|---|---|
| 基础框架 | Spring Boot | 2.7.18 | 生态最成熟,社区资源最丰富 |
| 微服务套件 | Spring Cloud | 2021.0.9 | 与 Spring Boot 版本对应 |
| 注册配置 | Spring Cloud Alibaba + Nacos | 2021.0.6.0 / 2.2.0 | 国产方案,文档中文友好 |
| 网关 | Spring Cloud Gateway | 3.1.x | 响应式模型,性能碾压 Zuul |
| RPC | Apache Dubbo | 3.1.11 | 泛化调用能力是关键 |
| 消息队列 | Apache Kafka | 3.x | 高吞吐,适合日志采集 |
| 数据库 | MySQL 8.0 | 8.0.33 | 最熟悉,稳定可靠 |
| ORM | MyBatis-Plus | 3.5.5 | 多租户拦截器是刚需 |
| 缓存 | Redis 6 | 6.x | 缓存 + 限流 + 分布式锁,一鱼多吃 |
| 搜索 | Elasticsearch | 7.4.2 | 全文搜索的标准答案 |
| 前端 | Vue 3 + Element Plus | - | 个人偏好,Composition API 真香 |
二、第一步:网关 —— 最折腾的模块
2.1 从"先跑起来"开始
最开始我其实没想那么多,就想着"先把网关跑起来,能转发请求就行"。于是我花了一个周末,搭了一个最简网关——配了几个路由规则,指向一个 Mock 服务。
真跑起来之后,感觉还挺像那么回事的。但很快就发现问题了:
没有认证,谁都能调我的接口。
这就好比你开了一家店,门是敞开的,谁都可以进来拿东西走。于是我开始往网关上加认证逻辑。
2.2 JWT 认证过滤器
认证方案我选了 JWT,原因很简单——无状态,不需要 Session,适合微服务架构。
网关的 JWT 认证过滤器逻辑是这样的:
请求到达网关 → 检查是否在白名单(登录/注册/文档等)
  ├── 在白名单 → 直接放行
  └── 不在白名单 → 从请求头提取 Token
       ├── Token 有效 → 解析用户信息,注入请求头,放行
       ├── Token 过期 → 返回 401
       └── Token 无效 → 返回 401
看起来很简单对吧?但有一个细节折腾了我好久——Token 过期了怎么办?
如果 Token 过期就让用户重新登录,体验太差了。但如果 Token 有效期设得太长(比如 7 天),安全性又下降。最终我采用了双 Token 机制:Access Token 有效期 2 小时,Refresh Token 有效期 7 天。Access Token 过期后,前端自动用 Refresh Token 换取新的 Access Token,用户无感知。
2.3 AppKey 认证:给第三方开发者用的
除了管理员通过浏览器访问管理后台,平台还需要支持第三方开发者通过 API 调用接入。这时候 JWT 就不太合适了——你不能让每个第三方应用都去登录拿 Token。
业界通用的做法是 AppKey + AppSecret + 签名认证。流程如下:
第三方应用调用 API:
1. 带上 AppKey、时间戳、随机数
2. 用 AppSecret 对请求参数做 HMAC-SHA256 签名
3. 网关收到请求后:
   a. 根据 AppKey 查到对应的 AppSecret
   b. 用同样的算法重新计算签名
   c. 对比两个签名是否一致
这里有一个很容易踩的坑——时间戳容差。如果客户端和服务器的时间不同步,签名验证会失败。我设置了一个 300 秒的容差窗口,只要时间差在 5 分钟内都算有效。
还有一个问题是重放攻击——攻击者截获了一个合法请求,然后重复发送。解决方案是用随机数(Nonce),每个 Nonce 只能使用一次,我把它存在 Redis 里,600 秒后自动过期。
2.4 踩坑:从 Zuul 到 Gateway 的迁移
前面提到过,一开始我用的是 Zuul。压测翻车之后,我不得不迁移到 Spring Cloud Gateway。
迁移过程比我想象的麻烦。虽然两个都是网关,但编程模型完全不同——Zuul 是 Servlet 同步模型,Gateway 是 WebFlux 响应式模型。这意味着:
- 过滤器接口变了(
ZuulFilter→GatewayFilter/GlobalFilter) - 不能再用
ServletRequest/ServletResponse - 所有阻塞操作(比如调数据库、调 Redis)都得用响应式方式
最坑的是,Gateway 的过滤器链跟 Zuul 完全不是一个概念。Zuul 的过滤器分 pre、route、post、error 四种类型,通过 filterType() 和 filterOrder() 控制。Gateway 则是用的 Spring WebFlux 的 WebFilter 链,通过 @Order 或 getOrder() 控制顺序。
我花了整整一个周末才把所有过滤器迁移完。但效果也是立竿见影的——同样 500 QPS 的压测,CPU 从 95% 降到了 40%。
三、IAM 认证中心:没有它,网关就是个空壳
3.1 为什么需要单独的认证服务?
网关有了认证能力,但认证数据从哪来?用户信息存在哪?谁管理角色和权限?
一开始我想的是:这些逻辑直接写在网关里不就行了?反正也不复杂。
但仔细一想就发现不对——网关的职责是请求转发,不应该处理业务逻辑。而且如果有多个系统需要用户认证(比如管理后台和开放 API),认证逻辑就得重复写。
所以我决定把认证抽出来做一个单独的服务——IAM(Identity and Access Management)。
3.2 RBAC 权限模型
权限模型我选用了经典的 RBAC(基于角色的访问控制),核心就四张表:
- 一个用户可以有多个角色
- 一个角色可以有多个权限
- 权限用编码表示,比如
api:create、user:delete
校验的时候,先查用户有哪些角色,再通过角色查到所有权限,最后判断是否有目标权限。
这套模型的优点是简单、灵活、经过了大量生产验证。缺点是角色多了之后管理起来有点麻烦——这也是为什么后来我在管理后台做了角色权限的树形选择器。
3.3 密码安全:BCrypt 不是选项,是必须
用户密码存储直接用明文?当然不行。MD5 或 SHA-256 哈希?也不行——彩虹表攻击了解一下。
BCrypt 是目前最主流的密码哈希算法,特点是每次哈希的结果都不一样(内置了随机盐值),而且可以调节计算成本。我在 IAM 服务中配置了 BCrypt 的 strength = 10,意味着一秒大约只能计算 10 次哈希——对于正常登录来说完全够用,但攻击者想暴力破解就难了。
四、多租户:一个 tenant_id 引发的三天折腾
4.1 需求很简单,实现不简单
多租户的需求说起来一句话:不同组织的数据要严格隔离,互不可见。
实现方式主要有三种:
| 方案 | 隔离程度 | 复杂度 |
|---|---|---|
| 独立数据库 | 最高 | 最高(每个租户一个库) |
| 共享库 + 独立表 | 中 | 中(每个租户一套表) |
| 共享库 + 共享表 + tenant_id 字段 | 最低 | 最低 |
我选了第三种——所有租户共用数据库和表,通过 tenant_id 字段隔离。理由很简单:我的目标不是服务百万级租户,隔离性够用就行,运维简单更重要。
但实现起来,这个"简单"的方案一点都不简单。
4.2 第一层:网关识别租户
请求到达网关时,需要知道这个请求属于哪个租户。我设计了一个 GlobalTenantFilter,从请求头 X-Tenant-Id 提取租户 ID。
但有个问题——恶意用户伪造租户 ID 怎么办?所以过滤器拿到租户 ID 后,会通过 Dubbo 调用 IAM 服务的 isValidTenant() 验证。验证结果缓存到 Redis,避免每次请求都调一次 Dubbo。
4.3 第二层:MyBatis-Plus 自动注入
租户 ID 传到下游服务后,怎么让每个 SQL 都带上 WHERE tenant_id = ??
MyBatis-Plus 提供了 TenantLineHandler 接口,可以拦截 SQL 执行,自动追加租户条件。我实现了一个 IntelliHubTenantLineHandler:
@Component
public class IntelliHubTenantLineHandler implements TenantLineHandler {

    @Override
    public Expression getTenantId() {
        String tenantId = UserContextHolder.getCurrentTenantId();
        if (tenantId == null) {
            tenantId = "default";
        }
        return new StringValue(tenantId);
    }

    @Override
    public String getTenantIdColumn() {
        return "tenant_id";
    }

    @Override
    public boolean ignoreTable(String tableName) {
        // 全局配置表、字典表等不需要租户隔离
        return TenantProperties.getIgnoreTables().contains(tableName);
    }
}
这样一来,每个微服务都不需要手动写 tenant_id 条件——MyBatis-Plus 自动帮你加上了。
4.4 第三层:ThreadLocal 的噩梦(重点!)
前面说到,在普通 HTTP 请求中,我用 UserContextInterceptor 从请求头解析租户 ID 存入 UserContextHolder(底层是 ThreadLocal),一切正常。
但问题出在异步任务上。
比如 API 发布后需要发送事件通知,事件发送是在异步线程里执行的。这时 ThreadLocal 里的租户 ID 已经没了,MyBatis-Plus 的租户拦截器拿到 null,就不知道往 SQL 里加什么条件。
这个问题折磨了我整整三天。最后我用了三层策略才搞定:
HTTP 请求层:拦截器自动解析和注入,这是基础。
异步线程池:通过 TaskDecorator 包装 Runnable,在提交任务时快照当前租户上下文,在子线程中恢复:
ThreadPoolTaskExecutor executor = new ThreadPoolTaskExecutor();
executor.setTaskDecorator(runnable -> {
    String tenantId = UserContextHolder.getCurrentTenantId();
    return () -> {
        try {
            UserContextHolder.setCurrentTenantId(tenantId);
            runnable.run();
        } finally {
            UserContextHolder.clear();
        }
    };
});
Kafka 消费者:生产者在发送消息时把租户 ID 写入消息头,消费者在消费前提取并设置到 UserContextHolder。
这套策略让我意识到:多租户不是一个"加个字段"的问题,而是一个全链路的设计问题。 请求从网关到服务、从同步逻辑到异步逻辑、从生产者到消费者,每个环节都要有租户上下文的传递机制。
五、动态路由:Dubbo 泛化调用差点让我放弃
5.1 需求:一个路径对应一个后端服务
API 平台的核心功能是什么?注册 API。比如注册一个 GET /open/v1/user/get,配置它的后端是 Dubbo 服务 com.example.UserService.getUserById,然后网关就能把请求转发过去。
这里的难点在于:网关不知道后端服务有哪些接口。 接口是 API 平台上动态注册的,注册完成后要实时生效。
5.2 路由动态加载
我的方案是:API 发布时,把路由配置写入 Redis(Hash 结构),网关的 OpenApiRouteMatchFilter 按请求路径从 Redis 中查找匹配的路由配置。
路由配置包含了后端类型(HTTP / Dubbo / Mock)、后端地址、超时时间等信息。
5.3 Dubbo 泛化调用的坑
HTTP 转发很好实现,WebClient 一把梭。Mock 更简单,直接返回配置的 JSON 就行。
Dubbo 泛化调用才是真正的噩梦。
Dubbo 的泛化调用(GenericService)允许你在不引入接口 JAR 的情况下调用任意 Dubbo 服务。听起来很美好对吧?但实际用起来,参数格式把我折磨得够呛。
直接说结论吧——GenericService.$invoke() 的第三个参数是参数类型数组,第四个参数是参数值数组。但参数类型的写法有严格的格式要求:
// 基本类型
"int" / "java.lang.Integer"
"long" / "java.lang.Long"
"boolean" / "java.lang.Boolean"

// 对象类型
"com.example.UserDTO"

// 数组
"java.util.List" 或 "java.util.List<com.example.UserDTO>"
// 注意:泛型信息在某些版本的 Dubbo 中会丢失
我花了整整一个晚上调试参数格式,反复尝试,才把所有类型都调通。
最后我用了策略模式来封装不同参数数量的调用逻辑:
public interface InvocationStrategy {
    Object invoke(GenericService service, String method, Object[] args);
}

// 零参数
public class NoArgInvocationStrategy implements InvocationStrategy {
    public Object invoke(GenericService service, String method, Object[] args) {
        return service.$invoke(method, new String[]{}, new Object[]{});
    }
}

// 单参数
public class SingleArgInvocationStrategy implements InvocationStrategy {
    public Object invoke(GenericService service, String method, Object[] args) {
        String paramType = resolveType(args[0]);
        return service.$invoke(method, new String[]{paramType}, new Object[]{args[0]});
    }
}

// 多参数
public class MultiArgInvocationStrategy implements InvocationStrategy {
    public Object invoke(GenericService service, String method, Object[] args) {
        String[] types = resolveTypes(args);
        return service.$invoke(method, types, args);
    }
}
还有一个性能问题:GenericService 实例的创建开销不小。我用 Caffeine 缓存了这些实例,key 是 interface:version:group,30 分钟过期,最多缓存 100 个。
六、限流:从内存计数到 Redis Lua
6.1 第一版:内存计数
限流的需求很清楚:防止某个调用方突发大量请求把后端冲垮。
我的第一版实现非常简单——内存里放一个 ConcurrentHashMap<IP+Path, AtomicInteger>,每秒重置一次。超过阈值就返回 429。
代码不到 50 行,跑起来也没问题。但上线集群部署之后就傻眼了——
每个实例的计数器是独立的。
用户请求经过负载均衡到了实例 A,调了 80 次;然后又到了实例 B,又调了 80 次。限流阈值是 100 次/分钟,结果用户实际调了 160 次都没有被限流。限流形同虚设。
6.2 第二版:Redis + 三种算法
既然单机不行,那就上分布式——用 Redis 做统一计数器。
我实现了三种算法,通过配置切换:
固定窗口(FIXED_WINDOW)
用 Redis 的 INCR + EXPIRE,实现最简单。但在窗口边界会出现"两倍流量"的突刺——比如 0:59 秒调了 100 次,1:00 秒又调了 100 次,虽然每个窗口内都没超限,但实际 2 秒内调了 200 次。
滑动窗口(SLIDING_WINDOW)
用 Redis 的 Sorted Set + Lua 脚本,精确统计过去 N 秒内的请求数。没有边界突刺问题,推荐默认使用。
-- 滑动窗口 Lua 脚本(简化版)
local key = KEYS[1]
local window = tonumber(ARGV[1])
local limit = tonumber(ARGV[2])
local now = tonumber(ARGV[3])

redis.call('ZREMRANGEBYSCORE', key, 0, now - window * 1000)
local count = redis.call('ZCARD', key)
if count < limit then
    redis.call('ZADD', key, now, now + math.random())
    redis.call('EXPIRE', key, window)
    return 1  -- 允许
else
    return 0  -- 拒绝
end
令牌桶(TOKEN_BUCKET)
用 Redis Hash 存令牌数和时间戳,支持突发流量。适合需要短时峰值的场景。
6.3 限流配置的灵活性
不同接口的限流需求不一样——登录接口要严格(5 次/分钟),搜索接口可以宽松(200 次/分钟)。所以我的设计是分层的:
全局默认 → 路径匹配 → API 级别策略
网关配置了默认限流参数,支持按路径覆盖。同时 API 平台服务可以创建限流策略,绑定到具体的 API 上,实现 API 级别的精细化控制。
被限流时,网关会在响应头返回 X-RateLimit-Limit、X-RateLimit-Remaining、X-RateLimit-Reset,让调用方知道自己的限流状态。
七、治理中心:百万级日志怎么搞?
7.1 同步写日志?不行
网关每转发一个请求,都要记录调用日志。如果同步写入 MySQL,会有三个问题:
- 网关要等数据库写完才能响应,增加了延迟
- 高并发下数据库写入成为瓶颈
- 数据库挂了,网关也挂了——这是最不能接受的
7.2 Kafka 异步管道
解决方案是用 Kafka 做异步缓冲:
网关发送日志到 Kafka,治理中心消费并批量写入 MySQL。这样一来,网关和数据库之间有了缓冲层,互不依赖。
7.3 两层统计聚合
原始调用日志增长很快,不能每次都全表扫描做统计。我设计了两层预聚合:
- 小时级:
StatsAggregationJob每小时跑一次,从api_call_log聚合到api_call_stats_hourly - 日级:基于小时数据再聚合到
api_call_stats_daily
统计指标包括总调用次数、成功/失败次数、平均/最大/最小延迟,还有 P95 和 P99 延迟。这些数据在后来的管理后台图表中发挥了重要作用。
7.4 告警系统
有了统计数据和实时日志,就可以做告警了。告警规则支持多种指标:
| 指标类型 | 说明 | 示例 |
|---|---|---|
| 错误率 | 一定时间内的失败比例 | 错误率 > 5% 持续 5 分钟 |
| 延迟 | 平均/最大响应时间 | P99 > 2000ms 持续 3 分钟 |
| 调用量 | 请求数量 | 调用量骤降 50% |
告警触发后,通过定时任务发送通知。通知渠道支持钉钉、邮件、Webhook,目前是通过策略模式实现的——每种渠道一个实现类,以后加新渠道只需要加一个类。
八、通用 Starter:让微服务开发"开箱即用"
8.1 痛点:每个微服务都在重复写同一套代码
8 个微服务,每个都需要 MyBatis-Plus 配置、Redis 操作、Kafka 生产消费、AOP 日志、ES 搜索……
如果每个服务都自己写一遍这些代码,不仅工作量爆炸,而且配置不一致的时候排查起来更是灾难。
8.2 解决方案:自定义 Spring Boot Starter
我把通用能力封装成了 8 个 Spring Boot Starter,放在 inner-intergration 目录下:
| Starter | 解决什么问题 | 一句话说明 |
|---|---|---|
mybatis-helper | 每个服务都要配置 MyBatis-Plus | 分页、自动填充、多租户一键集成 |
redis-cache | Redis 序列化配置太麻烦 | 自动配置 Jackson 序列化,提供 RedisUtil |
kafka | Kafka 生产者和消费者配置重复 | 统一生产者、主题常量、自动配置 |
aop | 每个接口都要加日志 | API 日志切面,自动埋点注入 traceId |
elasticsearch | ES 客户端配置复杂 | 封装操作模板,统一搜索模型 |
aigc-client | AI 客户端接入 | 百度千帆 API 封装 |
common-dubbo-api | 跨服务调用接口 | DTO + Dubbo 接口定义 |
common-helper | 每个服务都有通用工具 | 响应封装、常量、异常、上下文 |
每个 Starter 都是一个独立的 Maven 模块,通过 spring.factories 实现自动装配,支持 @ConditionalOnProperty 开关控制。
比如 redis-cache-spring-boot-starter 的核心自动配置:
@Configuration
@ConditionalOnClass(RedisTemplate.class)
@EnableConfigurationProperties(RedisCacheProperties.class)
public class RedisCacheAutoConfiguration {

    @Bean
    @ConditionalOnMissingBean
    public RedisTemplate<String, Object> redisTemplate(RedisConnectionFactory factory) {
        RedisTemplate<String, Object> template = new RedisTemplate<>();
        template.setConnectionFactory(factory);
        // 用 Jackson 序列化替代默认的 JDK 序列化
        // 这样存到 Redis 里的数据是 JSON,可读性强,跨语言消费也方便
        Jackson2JsonRedisSerializer<Object> serializer =
            new Jackson2JsonRedisSerializer<>(Object.class);
        template.setDefaultSerializer(serializer);
        template.setKeySerializer(new StringRedisSerializer());
        return template;
    }
}
8.3 效果
在新的微服务中引入 Starter,只需要加一行 maven 依赖,然后在 application.yml 里配置开关即可。
一个全新的微服务,5 分钟内就能获得完整的安全、日志、缓存、消息能力——这就是"企业级积木"的威力。
九、前端管理台:Vue 3 + Element Plus
9.1 技术选型
后端搭完了,总得有个管理界面吧?前端选了 Vue 3 + TypeScript + Element Plus 的组合,理由如下:
- Vue 3 Composition API:逻辑组织更清晰,同样的功能用 Options API 可能要分散在 data、methods、computed 里,用 Composition API 可以按功能聚合
- TypeScript:类型安全,编译期就能发现大量问题
- Element Plus:Element UI 的 Vue 3 版本,组件丰富,文档完善
- Pinia:Vue 3 官方推荐的状态管理,比 Vuex 轻量得多
9.2 路由结构
管理后台的路由是按功能模块组织的,总共 16 个页面:
/console
  ├── /                    → 数据看板(ECharts 图表)
  ├── api/list             → API 管理列表
  ├── api/create           → 创建 API
  ├── api/groups           → API 分组管理
  ├── gateway/routes       → 网关路由管理
  ├── gateway/ratelimit    → 限流策略管理
  ├── app/list             → 应用管理
  ├── tenant/list          → 多租户管理
  ├── users/list           → 用户管理
  ├── users/roles          → 角色权限管理
  ├── stats                → 调用统计
  ├── logs                 → 调用日志
  ├── alert/rules          → 告警规则
  ├── alert/records        → 告警记录
  ├── event/definitions    → 事件定义
  └── settings             → 系统设置
每个页面都是懒加载的,按需加载,首屏加载速度还不错。
9.3 API 客户端自动生成
前后端联调最痛苦的是什么?接口变更后前端不知道,手动改类型定义改到崩溃。
我用 @umijs/openapi 根据后端的 OpenAPI 规范自动生成 TypeScript 类型定义和 API 客户端代码。后端接口变了,前端重新生成一下就好,不需要手动维护。
十、Java SDK:给开发者的工具包
10.1 为什么需要 SDK?
开放 API 面向的是第三方开发者,他们需要一种方便的方式来调用 IntelliHub 的 API。虽然 HTTP 接口是通用的,但每次都要自己算签名、拼接参数,体验太差了。
所以我写了一个 Java SDK,封装了签名认证和 HTTP 请求的细节。
10.2 签名算法
SDK 的核心是签名认证,算法如下:
1. 将 AppKey、时间戳、随机数、请求参数按字典序拼接
2. 用 AppSecret 作为密钥,对拼接后的字符串做 HMAC-SHA256
3. 将签名结果 Base64 编码
4. 将签名放到请求头 X-Signature 中
SDK 的使用方式很简洁:
IntelliHubClient client = new IntelliHubClient(
    IntelliHubConfig.builder()
        .baseUrl("https://api.intellihub.com")
        .appKey("your-app-key")
        .appSecret("your-app-secret")
        .build()
);

ApiResponse<UserDTO> response = client.get("/open/v1/user/get",
    Map.of("id", "1"), UserDTO.class);
SDK 自动处理了签名生成、请求发送、响应解析的全过程,开发者只需要关心业务逻辑。
十一、运行指南
11.1 环境要求
| 组件 | 版本要求 | 用途 |
|---|---|---|
| JDK | 1.8+ | 后端运行 |
| Maven | 3.6+ | 后端构建 |
| Node.js | ^20.19.0 或 ^22.12.0 | 前端构建 |
| Docker & Docker Compose | 最新版 | 中间件容器化 |
11.2 启动中间件
cd docker
docker-compose up -d
这行命令会启动 Nacos、MySQL、Redis、ZooKeeper、Kafka、Elasticsearch、Kibana 共 7 个服务。第一次启动需要拉取镜像,耗时取决于网络。
11.3 构建和启动
# 后端
cd intellihub-parent
mvn clean install -DskipTests

# 按顺序启动:IAM → API平台 → 应用中心 → 治理中心 → 事件中心 → 搜索 → AIGC → 网关
java -jar intelli-auth-iam-service/target/*.jar
java -jar intelli-api-platform-service/target/*.jar
# ... 以此类推

# 前端
cd intellihub-frontend
npm install
npm run dev
启动完成后,访问 http://localhost:8080 就能看到管理后台了。
11.4 验证
# 测试登录
curl -X POST http://localhost:8080/api/auth/v1/auth/login \
  -H "Content-Type: application/json" \
  -d '{"username":"admin","password":"123456"}'
十二、后续规划
项目目前已经完整跑起来了,但还有很多可以改进的地方:
| 版本 | 计划内容 |
|---|---|
| V2.0 | 灰度发布:支持按比例、按地域、按用户标签灰度,网关层面实现流量权重控制 |
| V2.1 | API 市场:开发者自助注册、自动签发 AppKey、在线调试、SDK 自动生成 |
| V2.2 | 全链路追踪:集成 OpenTelemetry,覆盖网关到数据库的完整调用链 |
写在最后
从零开始复刻一个企业级 API 开放平台,这段旅程让我学到了太多。
最大的收获不是技术,而是"掌控感"。
以前在公司用那些系统,出了问题上线排查,看到报错日志却不知道从哪看起。现在不一样了——每一个请求怎么进来、怎么鉴权、怎么路由、怎么记日志,我都清清楚楚。出了问题,我能在 10 分钟内定位到是网关的哪个过滤器、哪行代码、哪个条件分支出了问题。
这种感觉,是在使用黑盒系统时永远得不到的。
当然,坑也没少踩。
- Zuul 换 Gateway 时,过滤器顺序调了整整一个下午
- Dubbo 泛化调用的参数格式,反复调试到怀疑人生
- ThreadLocal 在多线程下的丢失问题,折腾了三天
- 限流算法从内存到 Redis 的迁移,因为集群环境的不一致性
- Kafka 消费者配置的 auto-offset-reset,让我丢过一次测试数据
每一个坑都是一次"顿悟时刻"——原来是这样!原来企业级系统是这么考虑的!
最后想说的是:别怕造轮子。
很多人说"不要重复造轮子",但我觉得,造轮子本身不是目的,理解轮子为什么是圆的才是。如果你也在使用一套复杂的系统,不妨想想——你有没有勇气把它从零复刻一遍?哪怕只完成了 10%,也比原地观望强。
毕竟,真正的成长,从来不在舒适区里。
项目地址:https://github.com/DevYangJC/intelli_hub
Star、Fork、提 Issue 都行,你的一个建议,可能就是我下次迭代的方向。

AtomGit 是由开放原子开源基金会联合 CSDN 等生态伙伴共同推出的新一代开源与人工智能协作平台。平台坚持“开放、中立、公益”的理念,把代码托管、模型共享、数据集托管、智能体开发体验和算力服务整合在一起,为开发者提供从开发、训练到部署的一站式体验。
更多推荐
 8
 0
- 0


 已为社区贡献3条内容

所有评论(0)