【助睿ETL实战】从考勤到消费,手把手教你构建学生画像标签体系(附完整代码+踩坑经验总结!)
第一部分:学生用户画像——考勤主题标签构建
一、实验背景
1.1 实验目的
本次实验将基于 “数智教育” 大赛的数据集,设计并实现学生多维度考勤统计。使用助睿ETL转换流,掌握ETL数据处理的全流程,主要包括:数据接入、关联、衍生、聚合、落地、导出。
落地实际,很好地帮助解决了校园考勤依靠人工统计的效率低、口径不统一、数据冗杂等问题;同时结合实验的实际数据情况,可以高效优化空值的处理逻辑,确保转换流可以正常运行,输出准确的多维度统计结果。
1.2 实验环境
- 工具:助睿数智(Uniplore)的数据集成平台(ETL)、MySQL数据库
- 产品官网为 https://www.uniplore.com/,本次实验的访问地址为 https://lab.guilian.cn/
- 数据源:“数智教育”大赛数据集(共7张核心业务表)
- 要求:具备平台数据库的连接权限
1.3 业务场景
本次实验的业务场景包括校园环境下,高效地统计学生的考勤情况,根据场景制作转换流,输出准确地多维度统计结果。
二、数据与标签梳理
2.1 源数据说明
本次项目的数据来源于“数智教育”大赛数据集,原始数据集共包含7张表:
-
1_teacher.csv:教师信息
-
2_student_info.csv:学生信息
-
3_kaoqin.csv:考勤主表
-
4_kaoqintype.csv:考勤类型码表
-
5_chengji.csv:成绩信息
-
6_exam_type.csv:考试类型
-
7_consumption.csv:消费信息
本小节实验 “学生考勤行为统计” 所用的的为其中的3张表:
-
3_kaoqin.csv:考勤主表,核心事实表,记录每次考勤行为
-
4_kaoqintype.csv:考勤类型码表,提供考勤行为的标准化名称,是行为标签生成的关键
-
2_student_info.csv:学生信息,提供学生基础属性(住校、性别等),支撑维度拆分
这三张表形成了“事实表 + 维度表 + 属性表”的完整星型模型结构。
2.2 标签字段说明【考勤行为统计标签】
2.2.1 学生基础属性标签
| 标签字段 | 数据来源 | 选择依据 |
|---|---|---|
| 学生ID | 考勤主表/学生信息表 | 学生唯一标识,用于关联和去重 |
| 学生姓名 | 考勤主表/学生信息表 | 便于结果查阅和人工核对 |
| 班级ID | 考勤主表/学生信息表 | 班级唯一标识,用于班级维度统计 |
| 班级名称 | 考勤主表/学生信息表 | 班级名称,用于提取年级和校区类型 |
| 性别 | 学生信息表 | 学生性别,可按性别维度分析考勤行为差异 |
| 出生日期 | 学生信息表 | 学生出生年份,可用于年龄维度分析,识别不同年龄段的考勤特点 |
| 政治面貌 | 学生信息表 | 学生政治面貌,可按政治面貌维度分析不同群体的考勤行为 |
选表依据:这些字段是学生的基础身份信息,主要从学生信息表(2_student_info)获取。考勤主表中也包含部分学生信息,可作为交叉验证。这些基础属性是后续分维度统计的核心依据。
示例用途:可按性别分析男生与女生的迟到考勤差异异,可按政治面貌分析不同群体的考勤行为特点。
2.2.2 学生画像维度标签
| 标签字段 | 衍生逻辑 | 选择依据 |
|---|---|---|
| 年级 | 从班级名称(cla_name)中提取 | 学校管理通常按年级统计考勤情况,便于分层管理 |
| 是否住校 | 映射学生信息表bf_zhusu字段 | 住校生与走读生的考勤行为模式不同,便于针对性管理 观察数据可以发现:1→“是”,0→“否”,空值→“未知” |
| 校区类型 | 从班级名称(cla_name)中判断 | 数据说明中提到2017年启用新校区,新校区统一命名为型为“白-高二(01)”和“东-高二(01)”的班级名 |
选表依据:这三个标签字段属于衍生维度,原始数据中没有直接提供,需要根据班级名称和住校字段进行二次加工。年级维度有助于学校按年级进行考勤管理和对比分析;住校维度用于区分住校生和走读生,两者的考勤行为模式存在差异;校区类型维度源于数据说明中提到的2017-2018年新校区启用情况,不同校区的管理规则可能不同。
示例用途:可按住校状态分析走读生是否更容易迟到,可按校区类型对比新旧校区的校服穿戴规范执行情况。
2.2.3 考勤行为统计标签
| 标签字段 | 选择依据 |
|---|---|
| 迟到次数 | 学生行为规范的核心指标之一 |
| 早退次数 | 学生行为规范的核心指标之一 |
| 请假次数 | 区分正常缺勤与异常缺勤 |
| 没穿校服次数 | 学校日常行为规范的重要维度 |
选表依据:这四类异常考勤行为是学校日常学生管理的核心关注点。迟到和早退反映学生的时间管理能力和纪律意识,请假次数可用于区分正常缺勤与异常缺勤,校服穿戴是学校行为规范的重要考核项。根据数据说明中的描述,“校服[移动考勤]”特指未穿校服的情况。
示例用途:可分析学生不同异常考勤次数,判断考勤风险等级。
2.3 数据加工流程
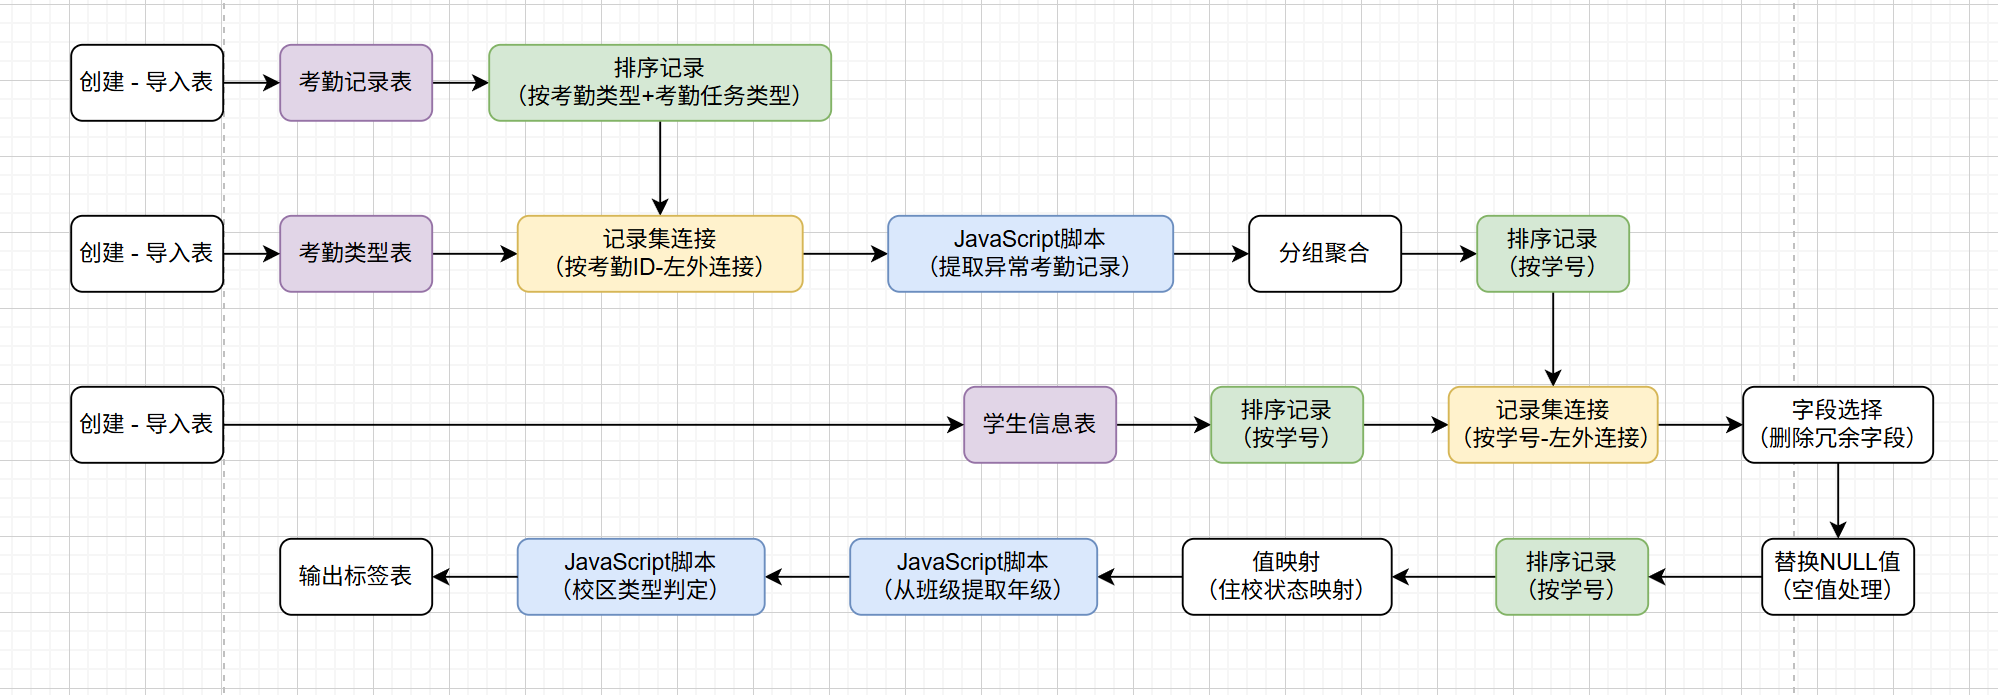
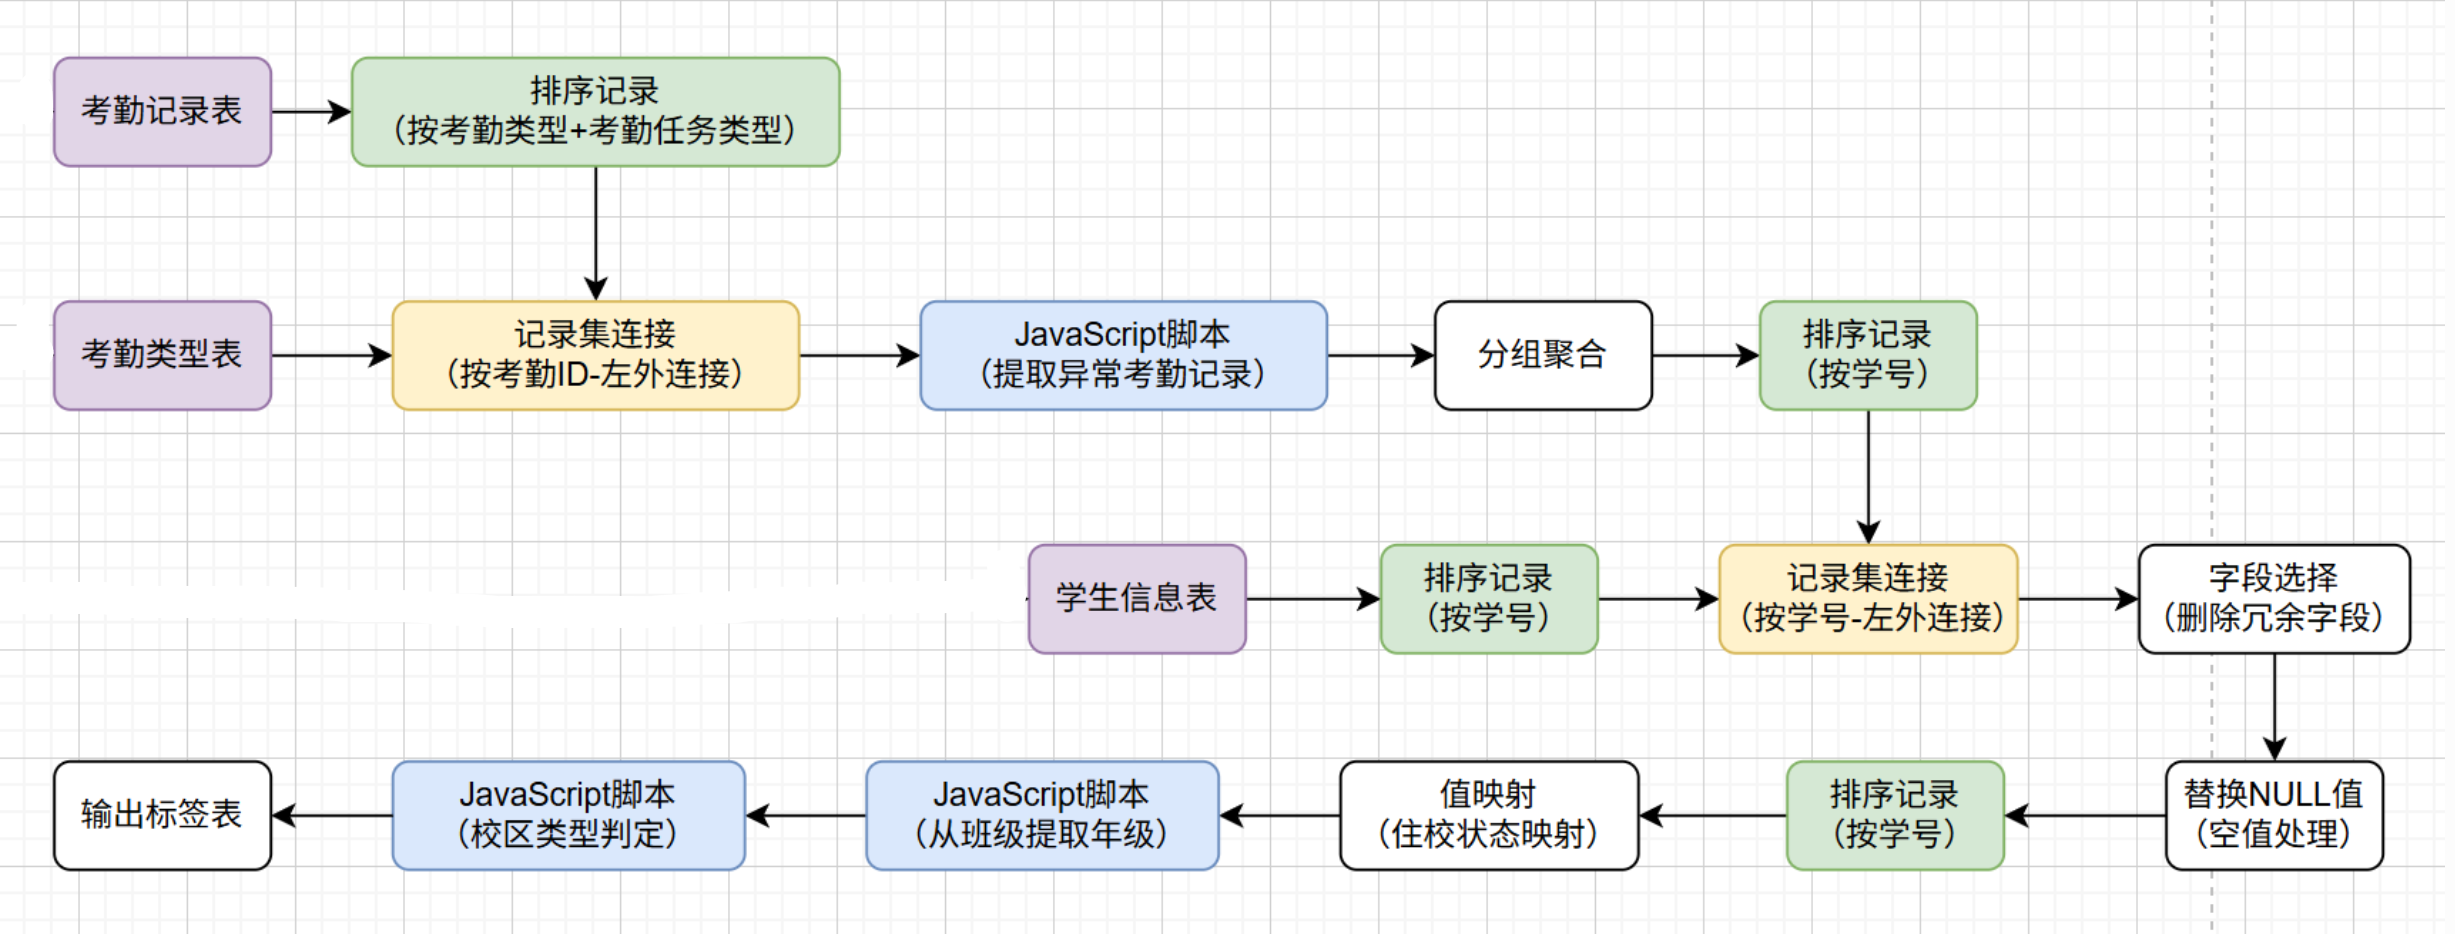
根据标签字段说明,我们可以从多维度拆解、合并、处理,构建数据处理的转换流,达成我们的实验目的。主要的操作流程如下图所示:
三、实验步骤
3.1 创建实验项目
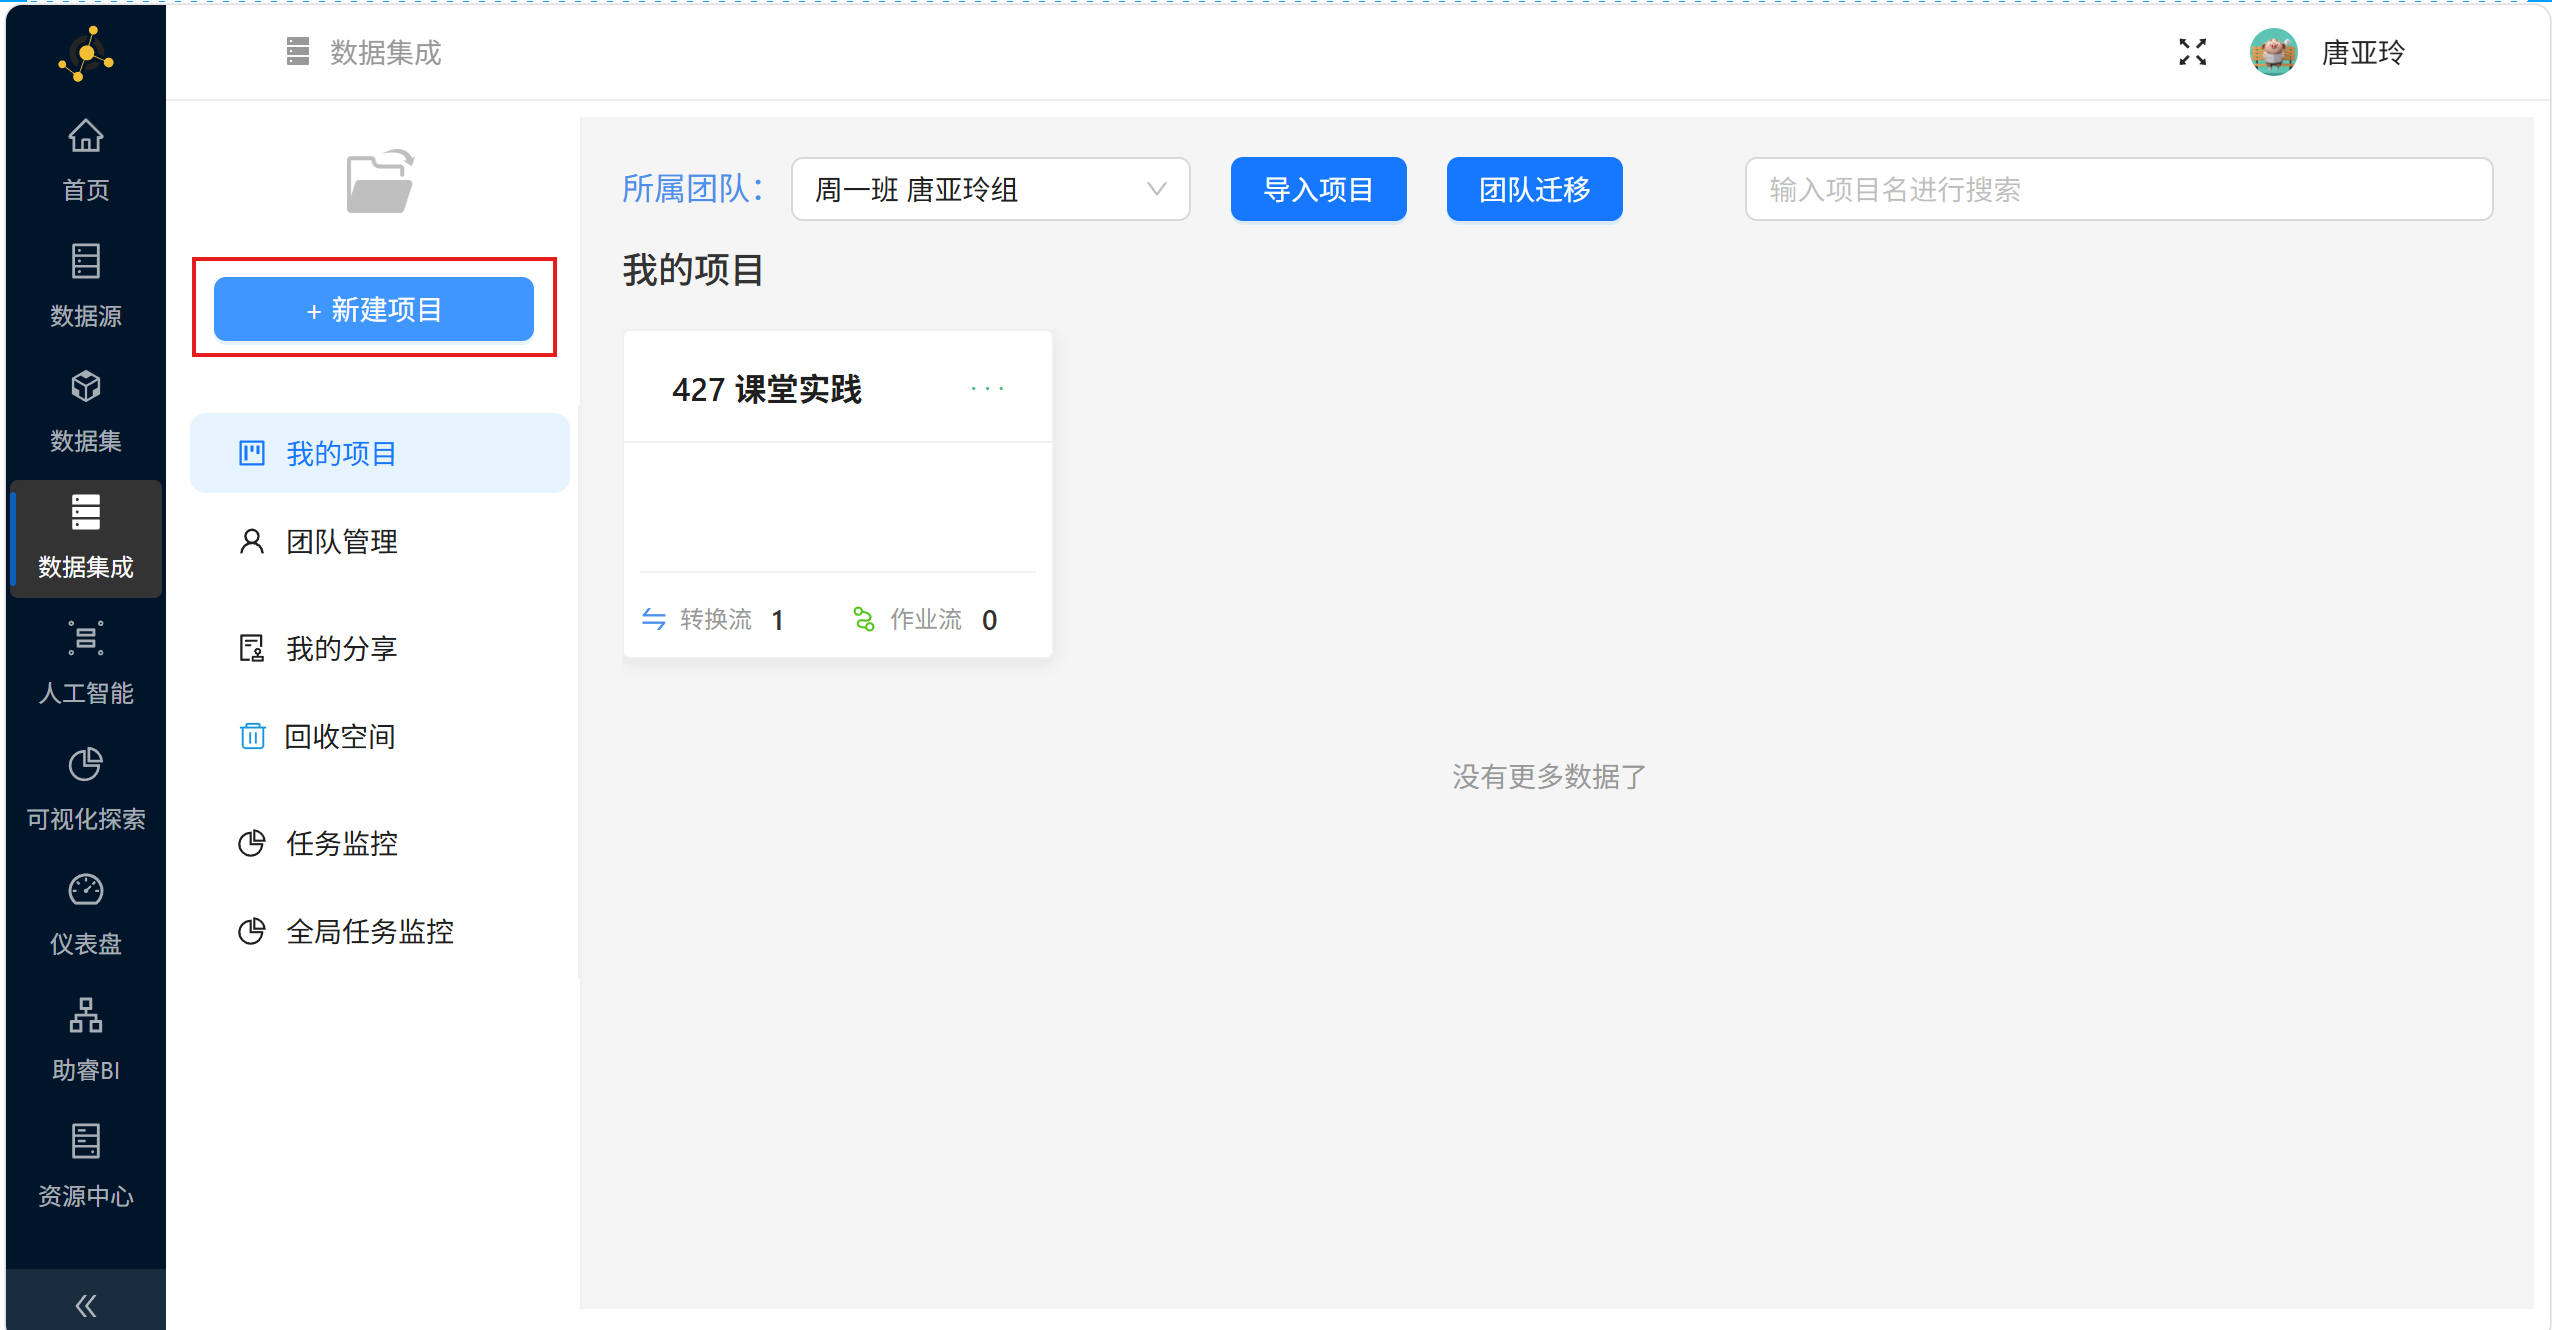
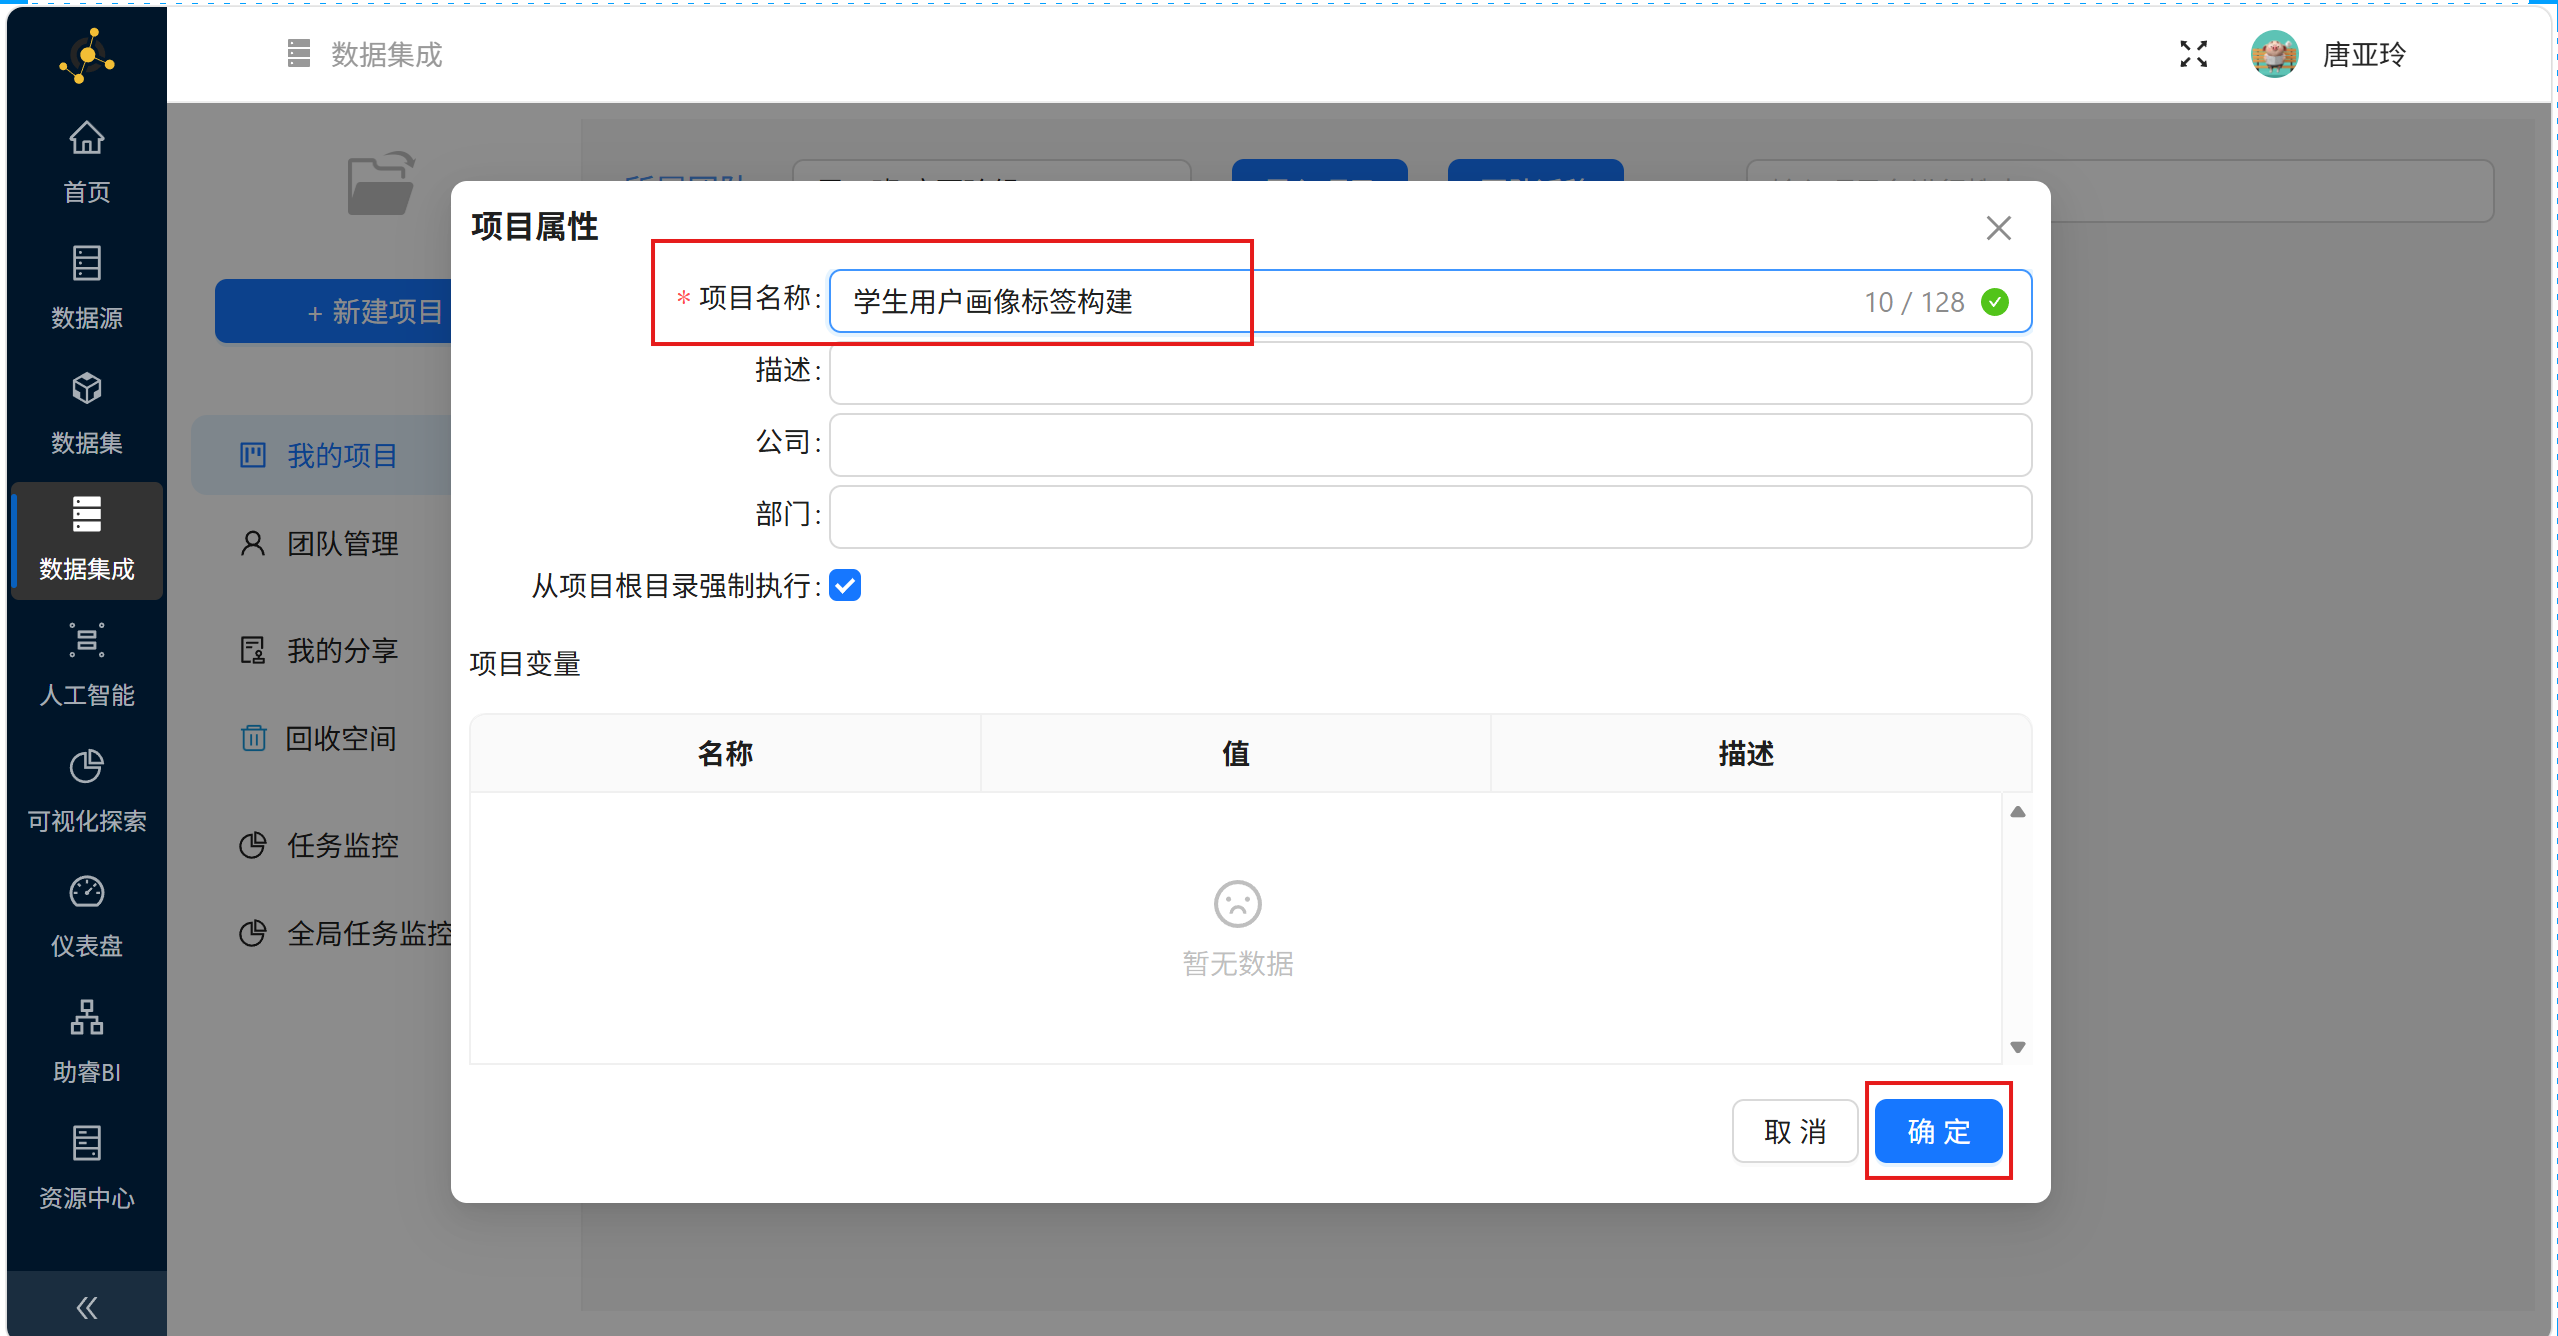
- 点击 “新建项目” ,在弹框中输入项目名称 “学生用户画像标签构建” ,点击 “确定”
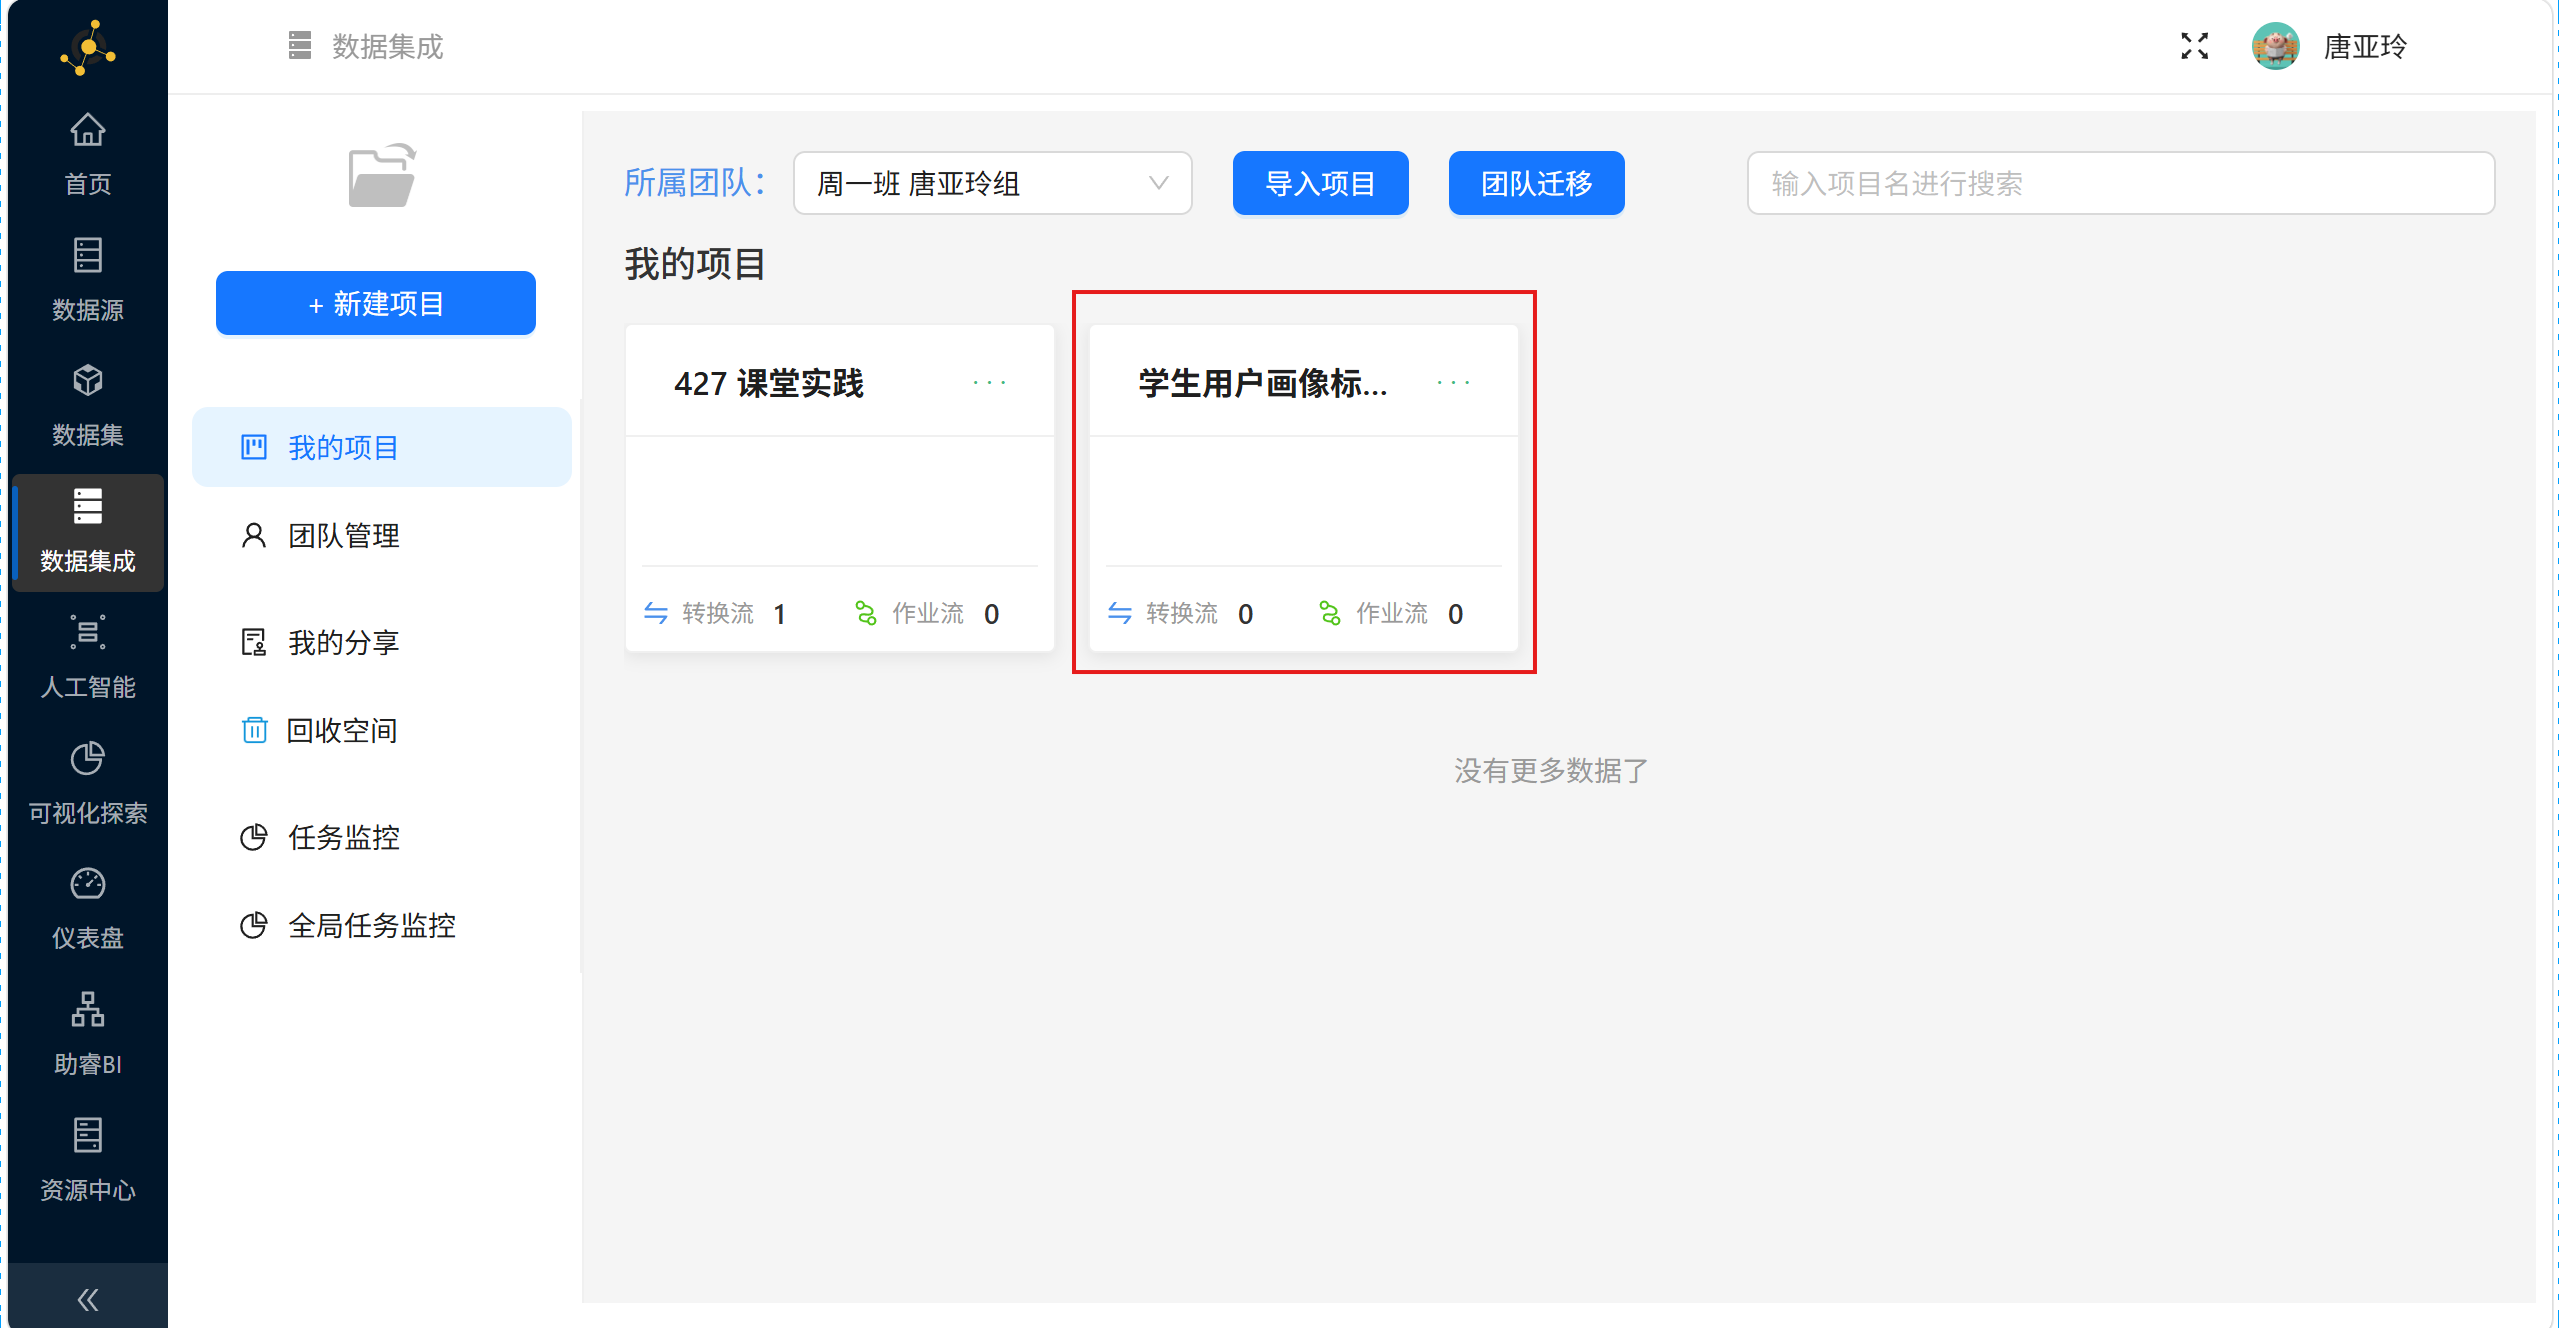
- 创建成功后即可看到新创建的项目
3.2 数据资源获取
首先,我们需要将原始数据导入到我们团队的团队私有数据库。
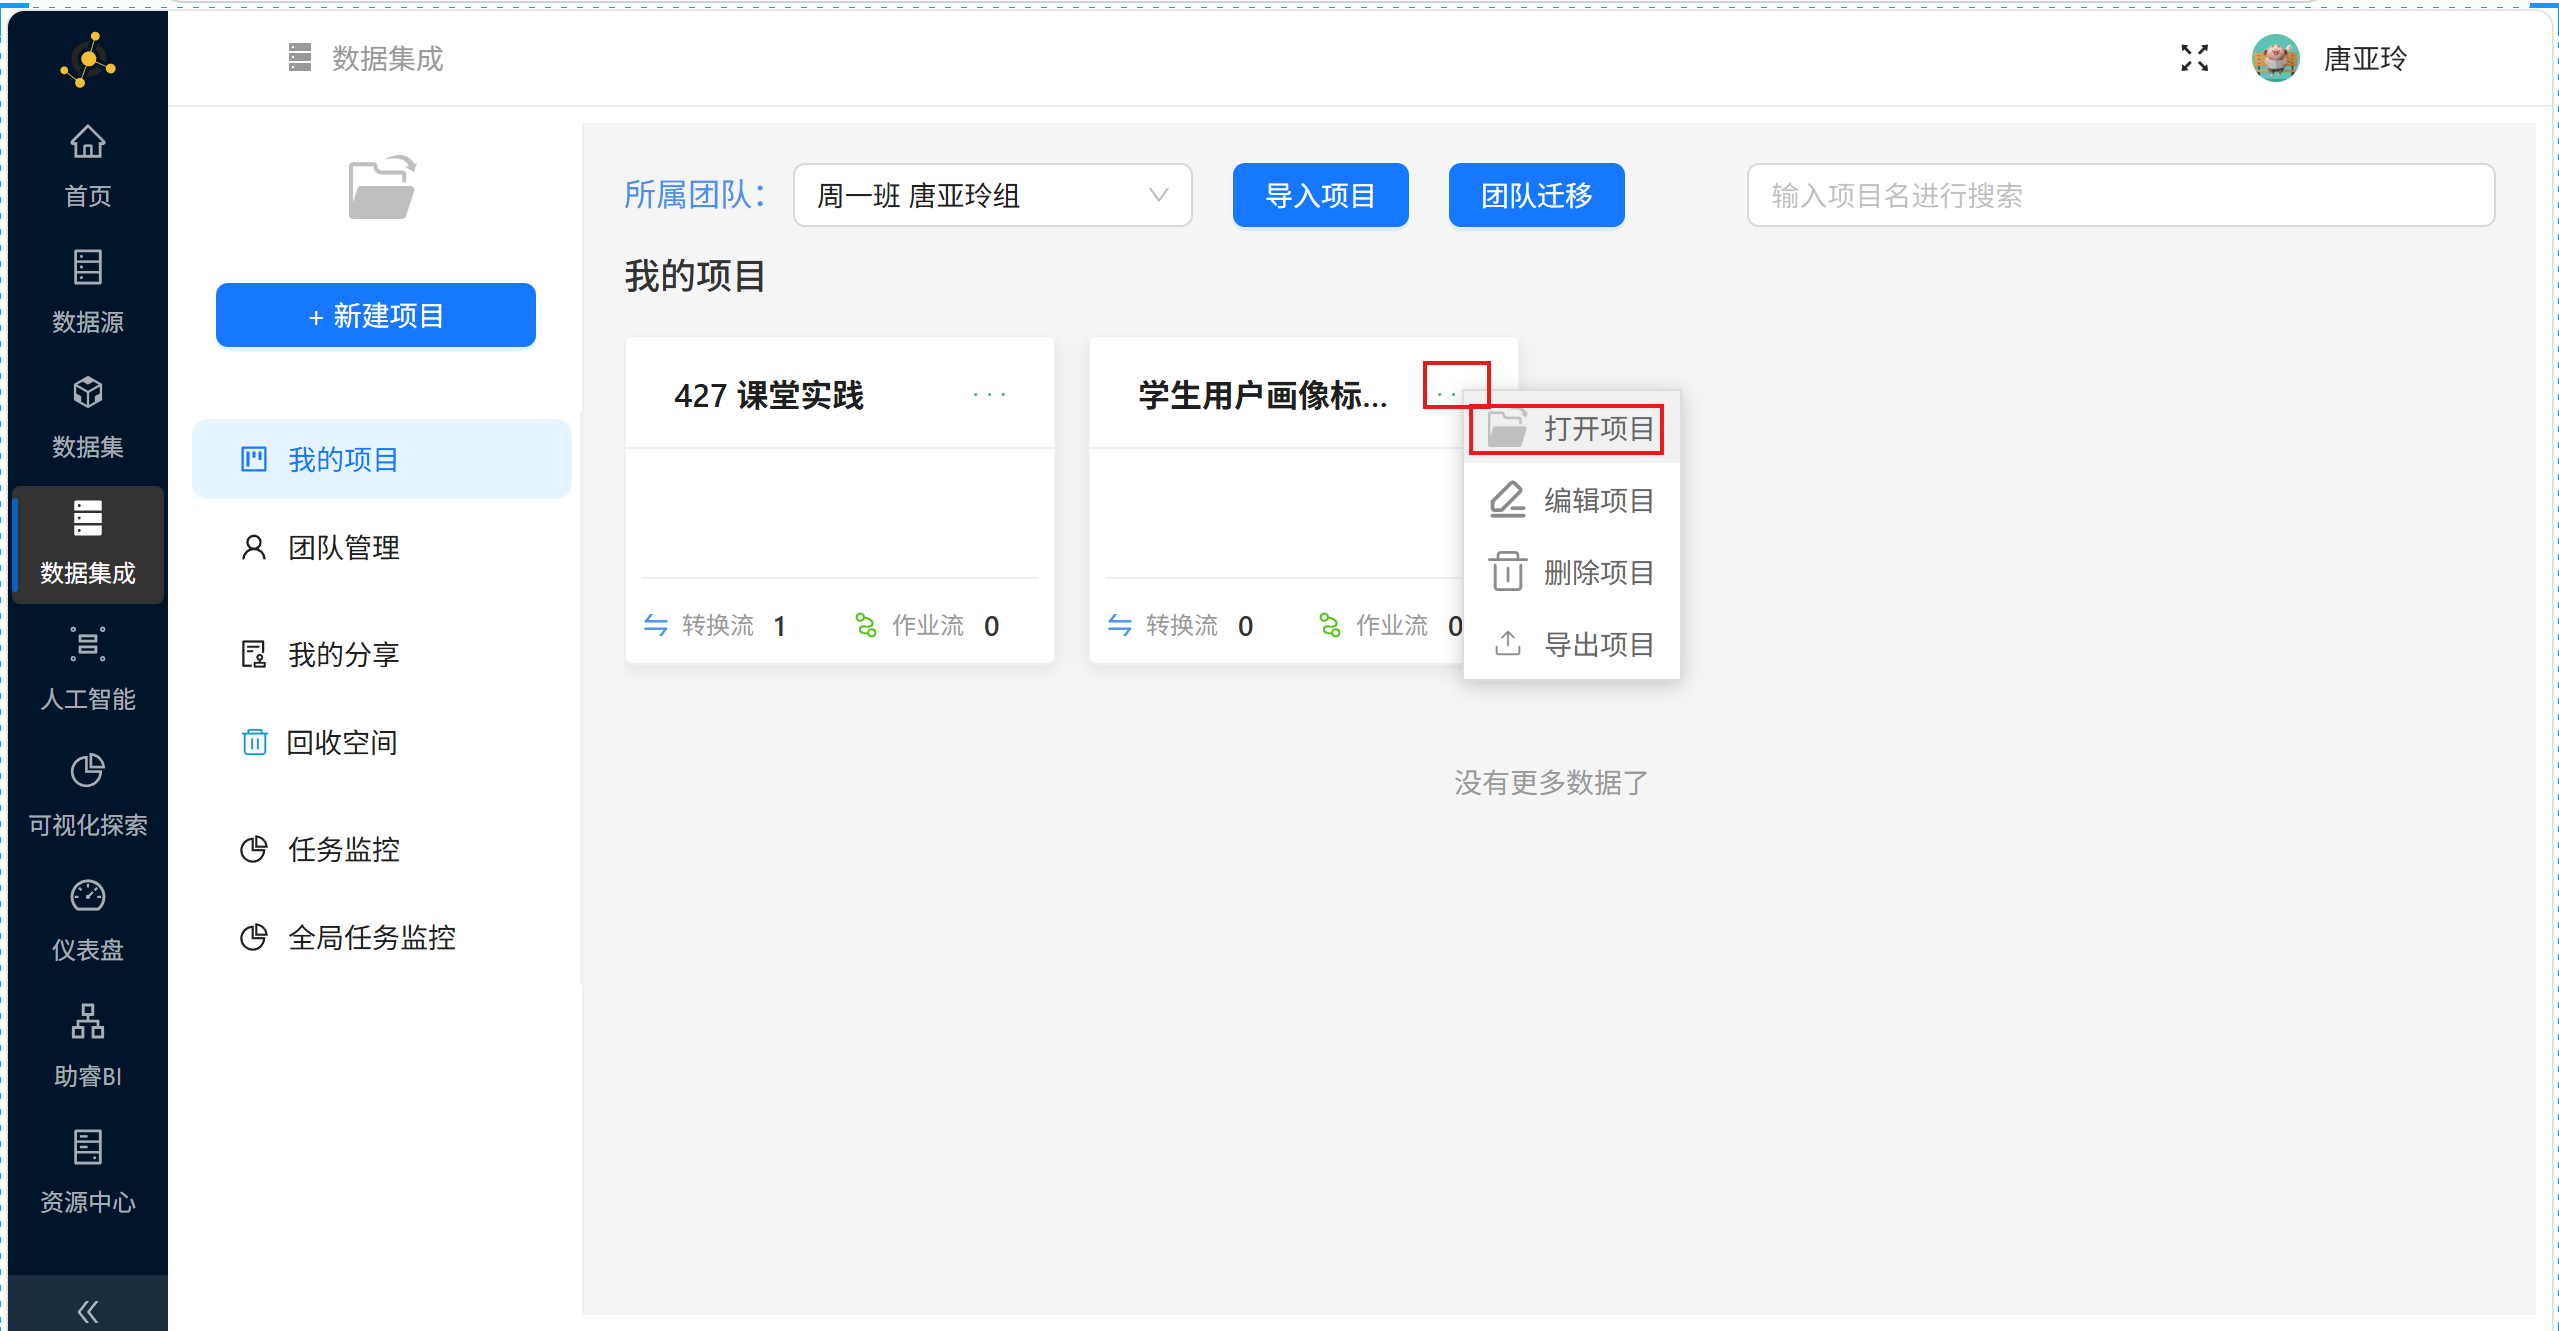
- 点击项目右上角的 “...”,点击 “打开项目”
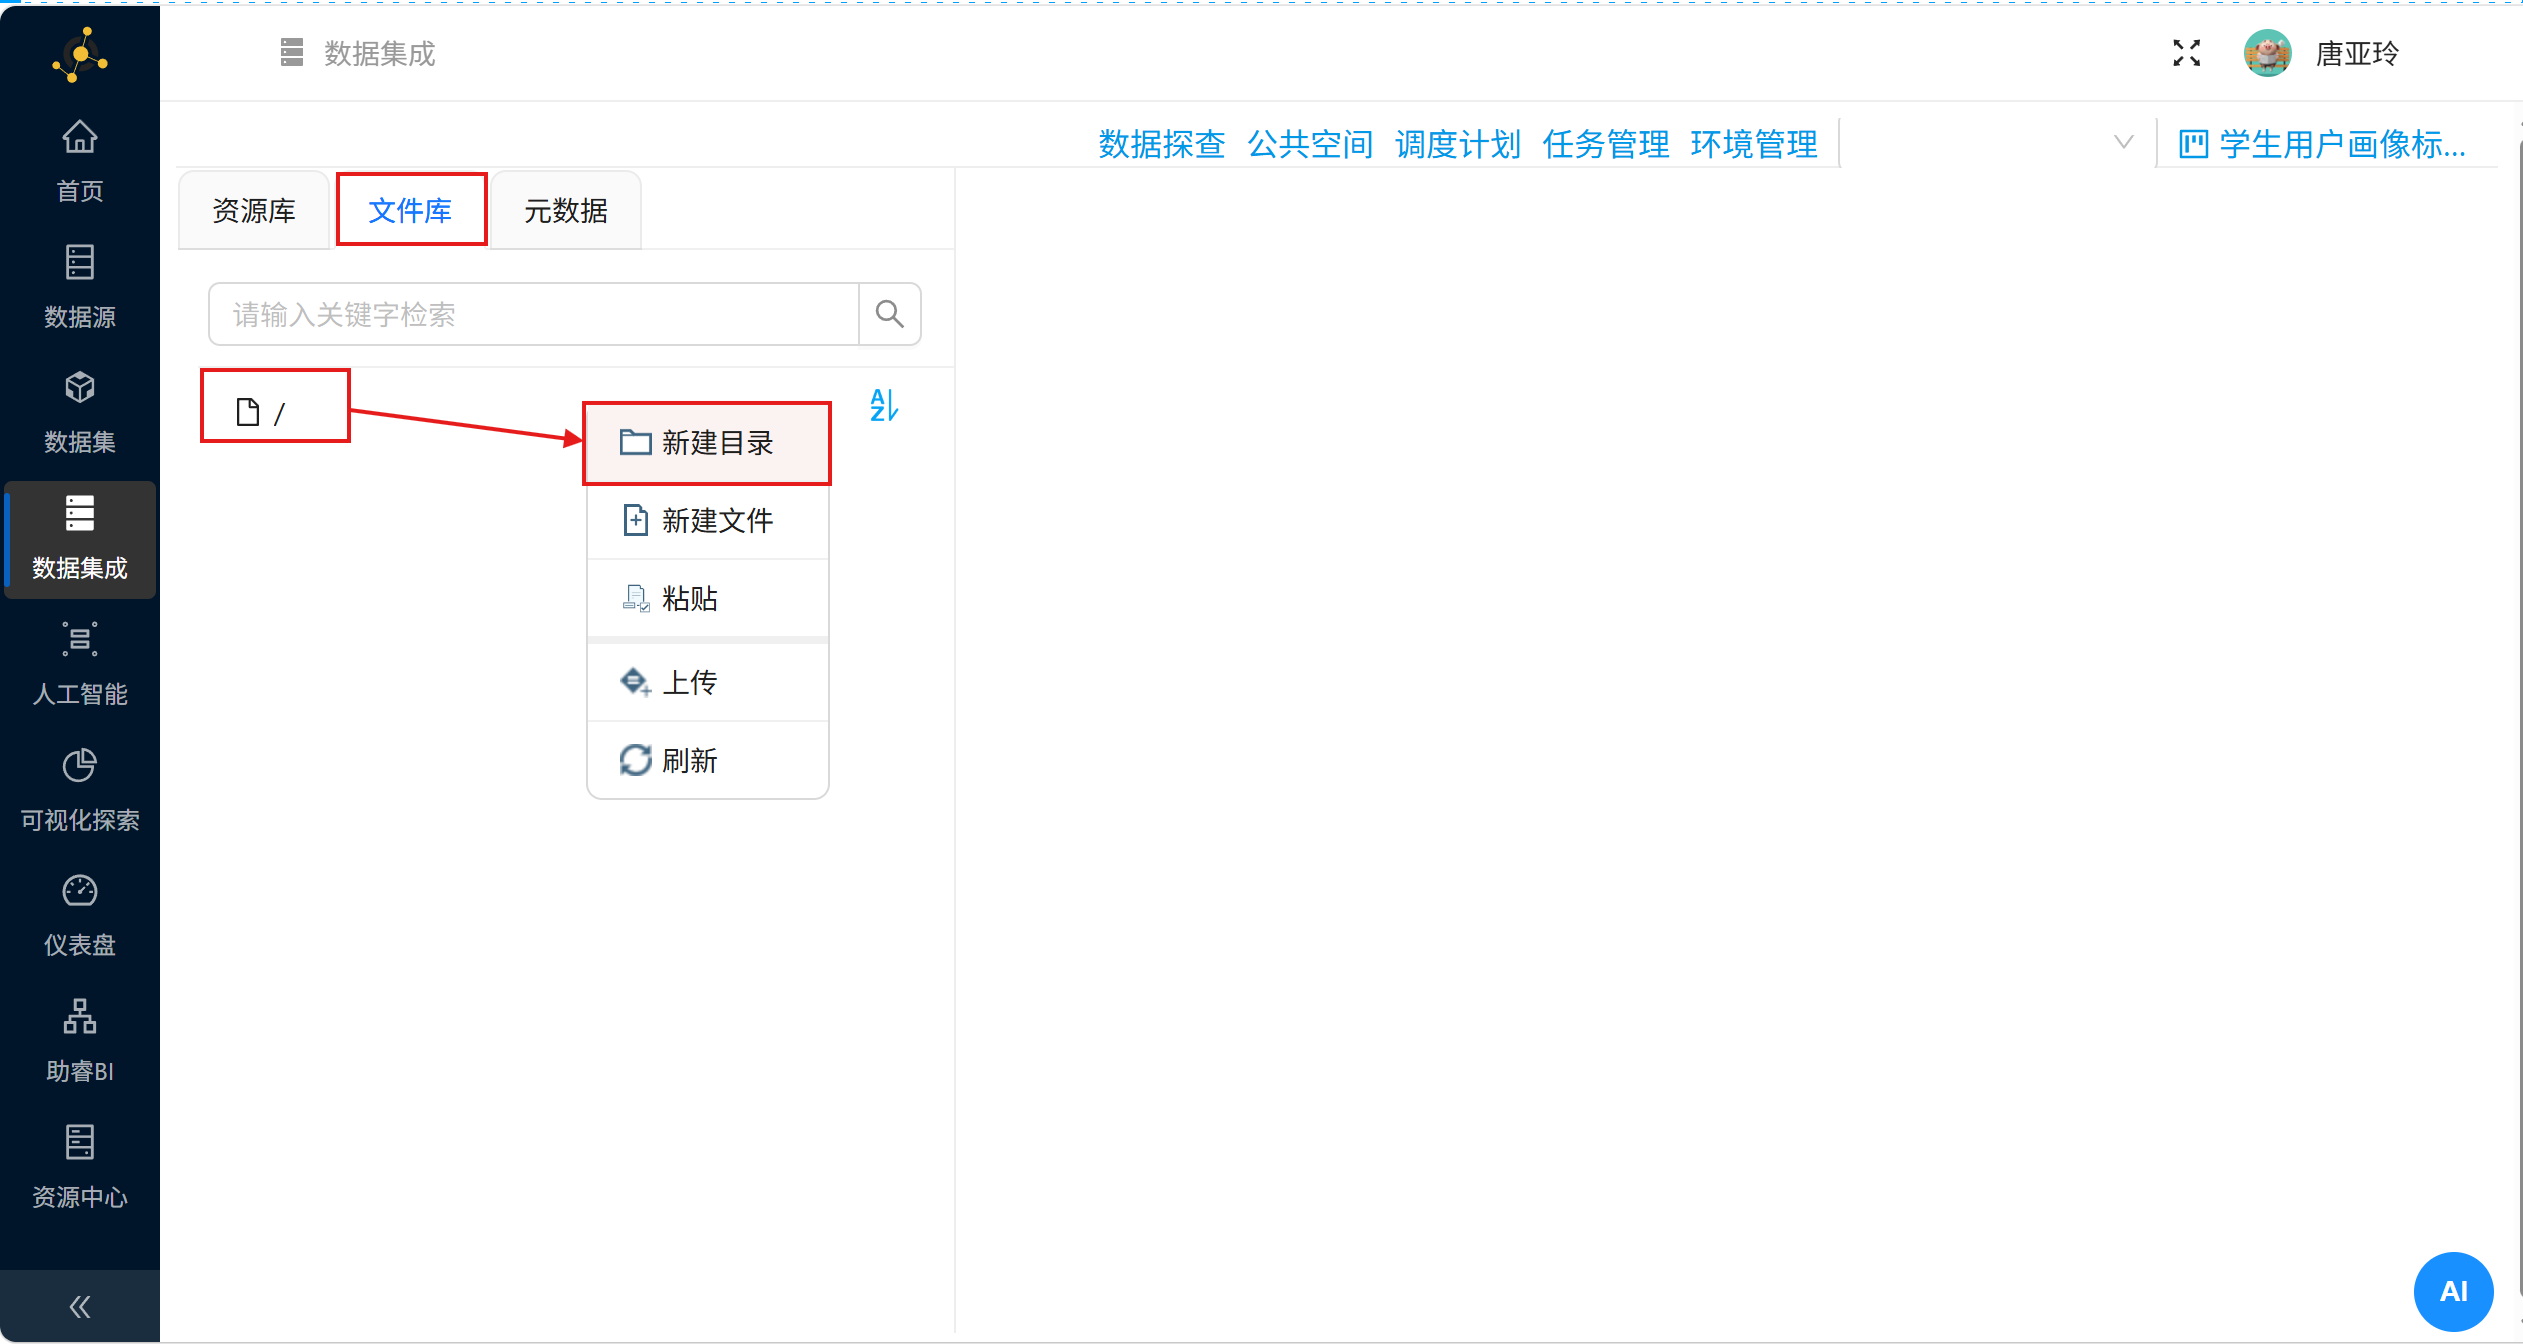
- 获取本次实验的数据集,点击 “文件库”,右键项目根目录,点击 “新建目录”
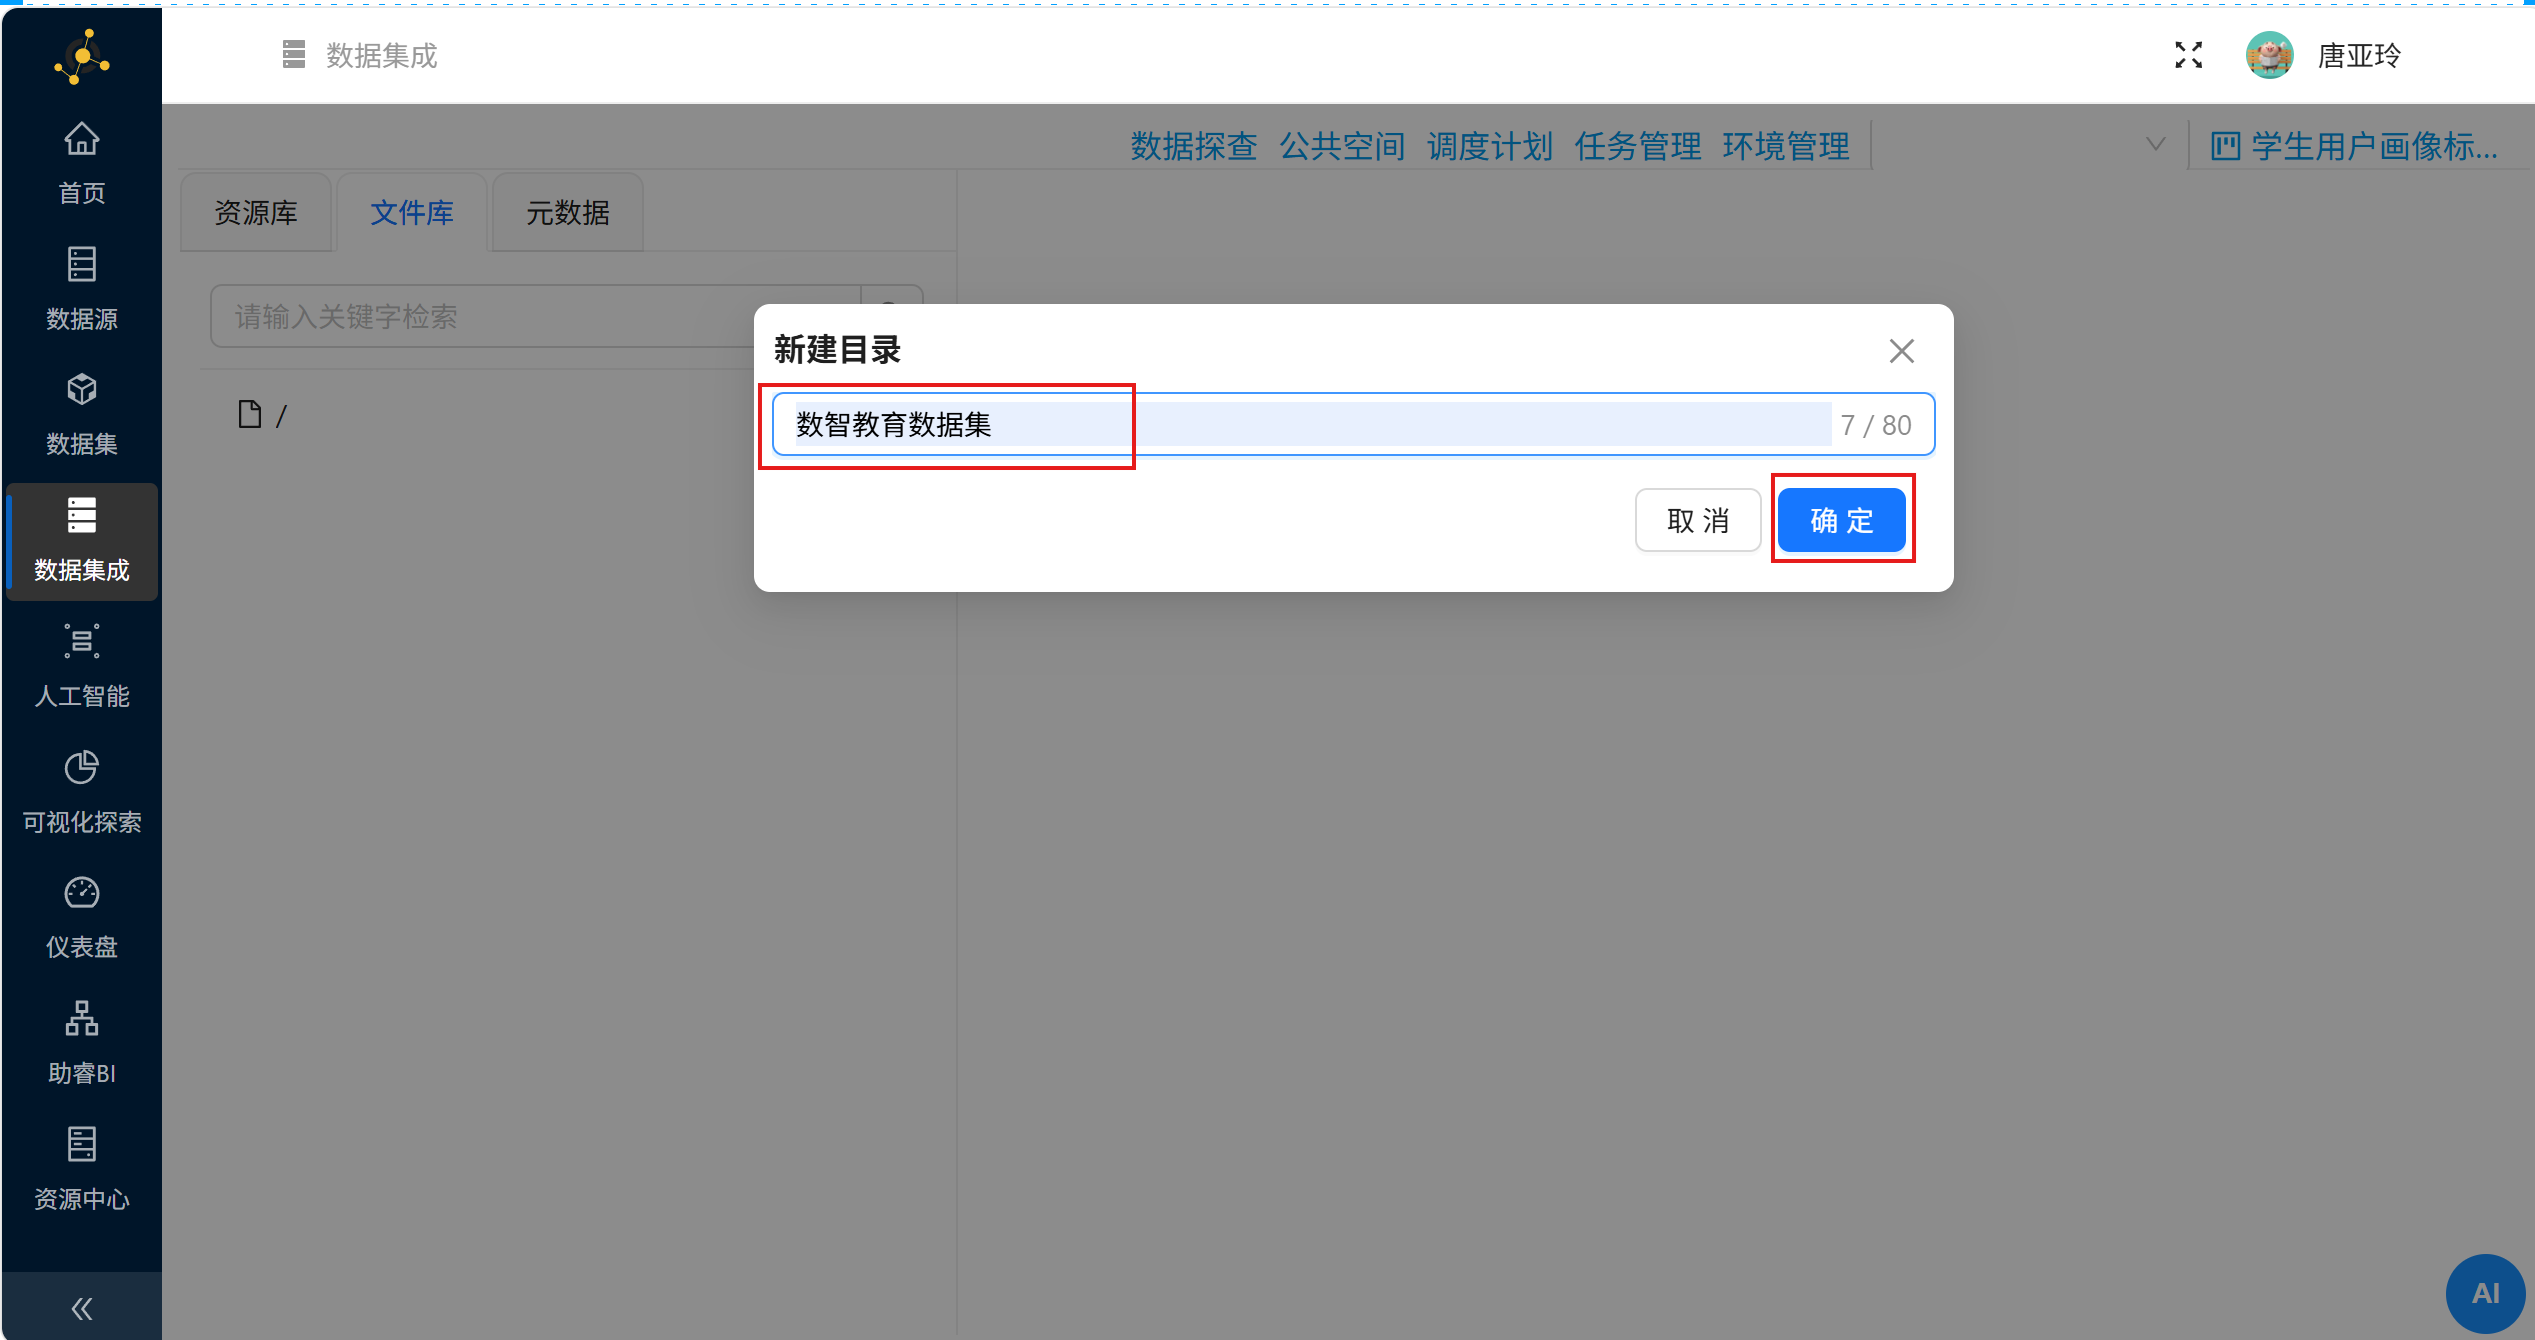
- 输入目录名称为 “数智教育数据集”,点击 “确定”
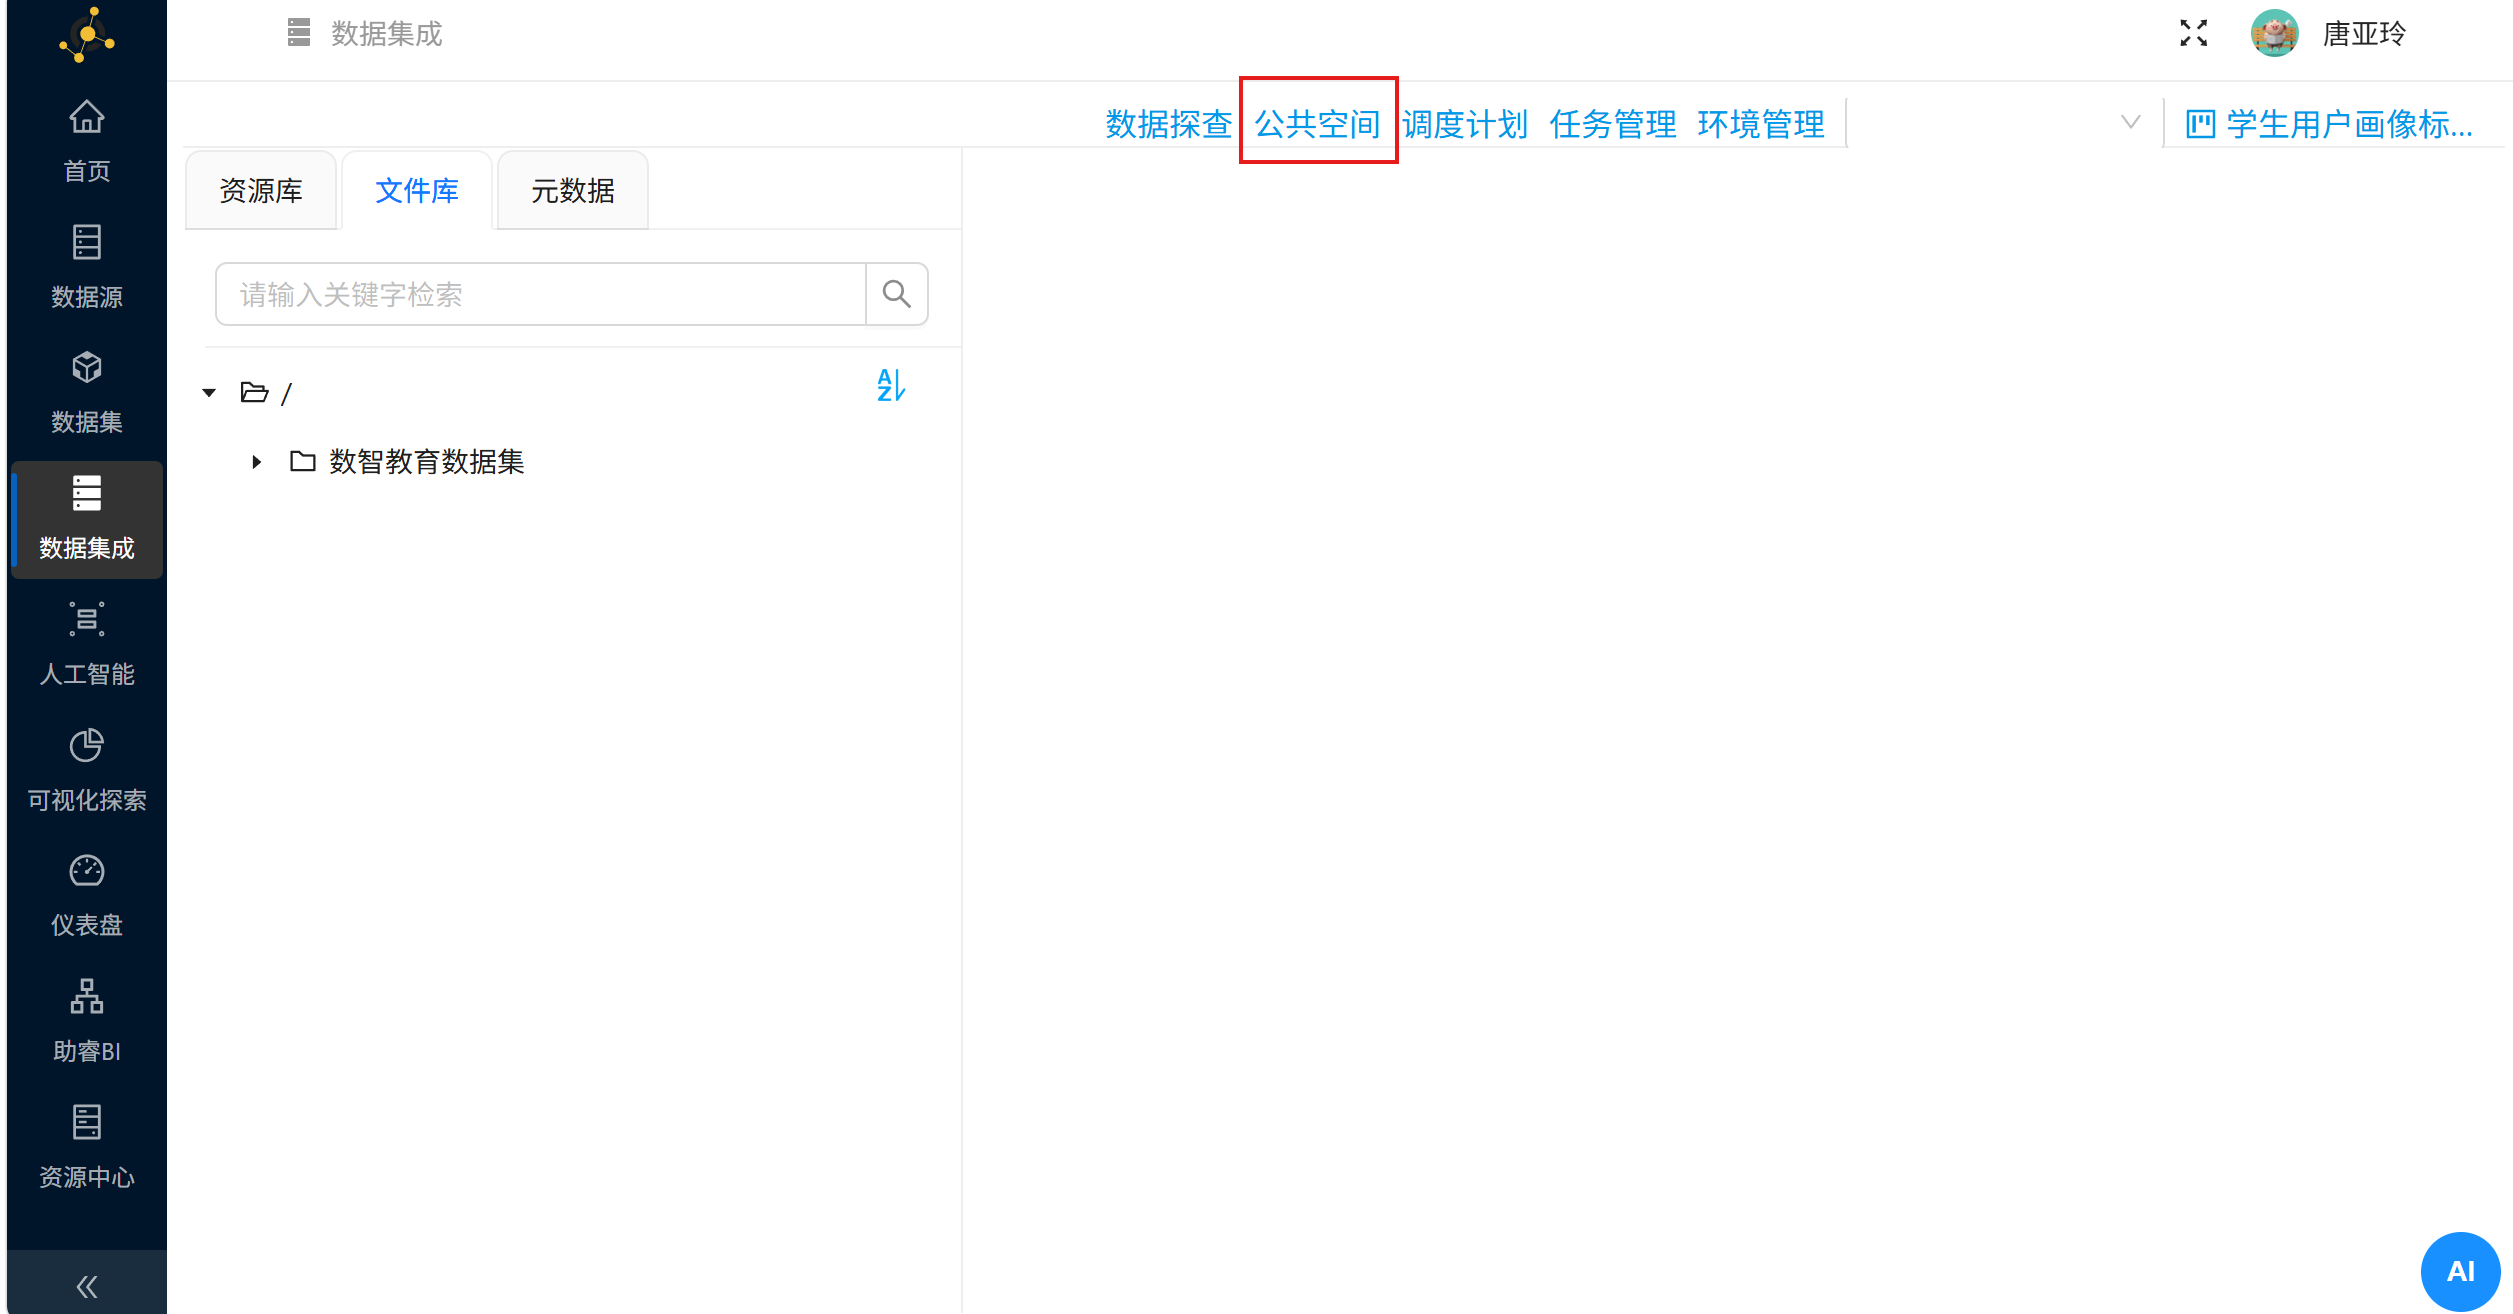
点击 “公共空间” ,再点击“数据资源”,即可查看到所需的数据集
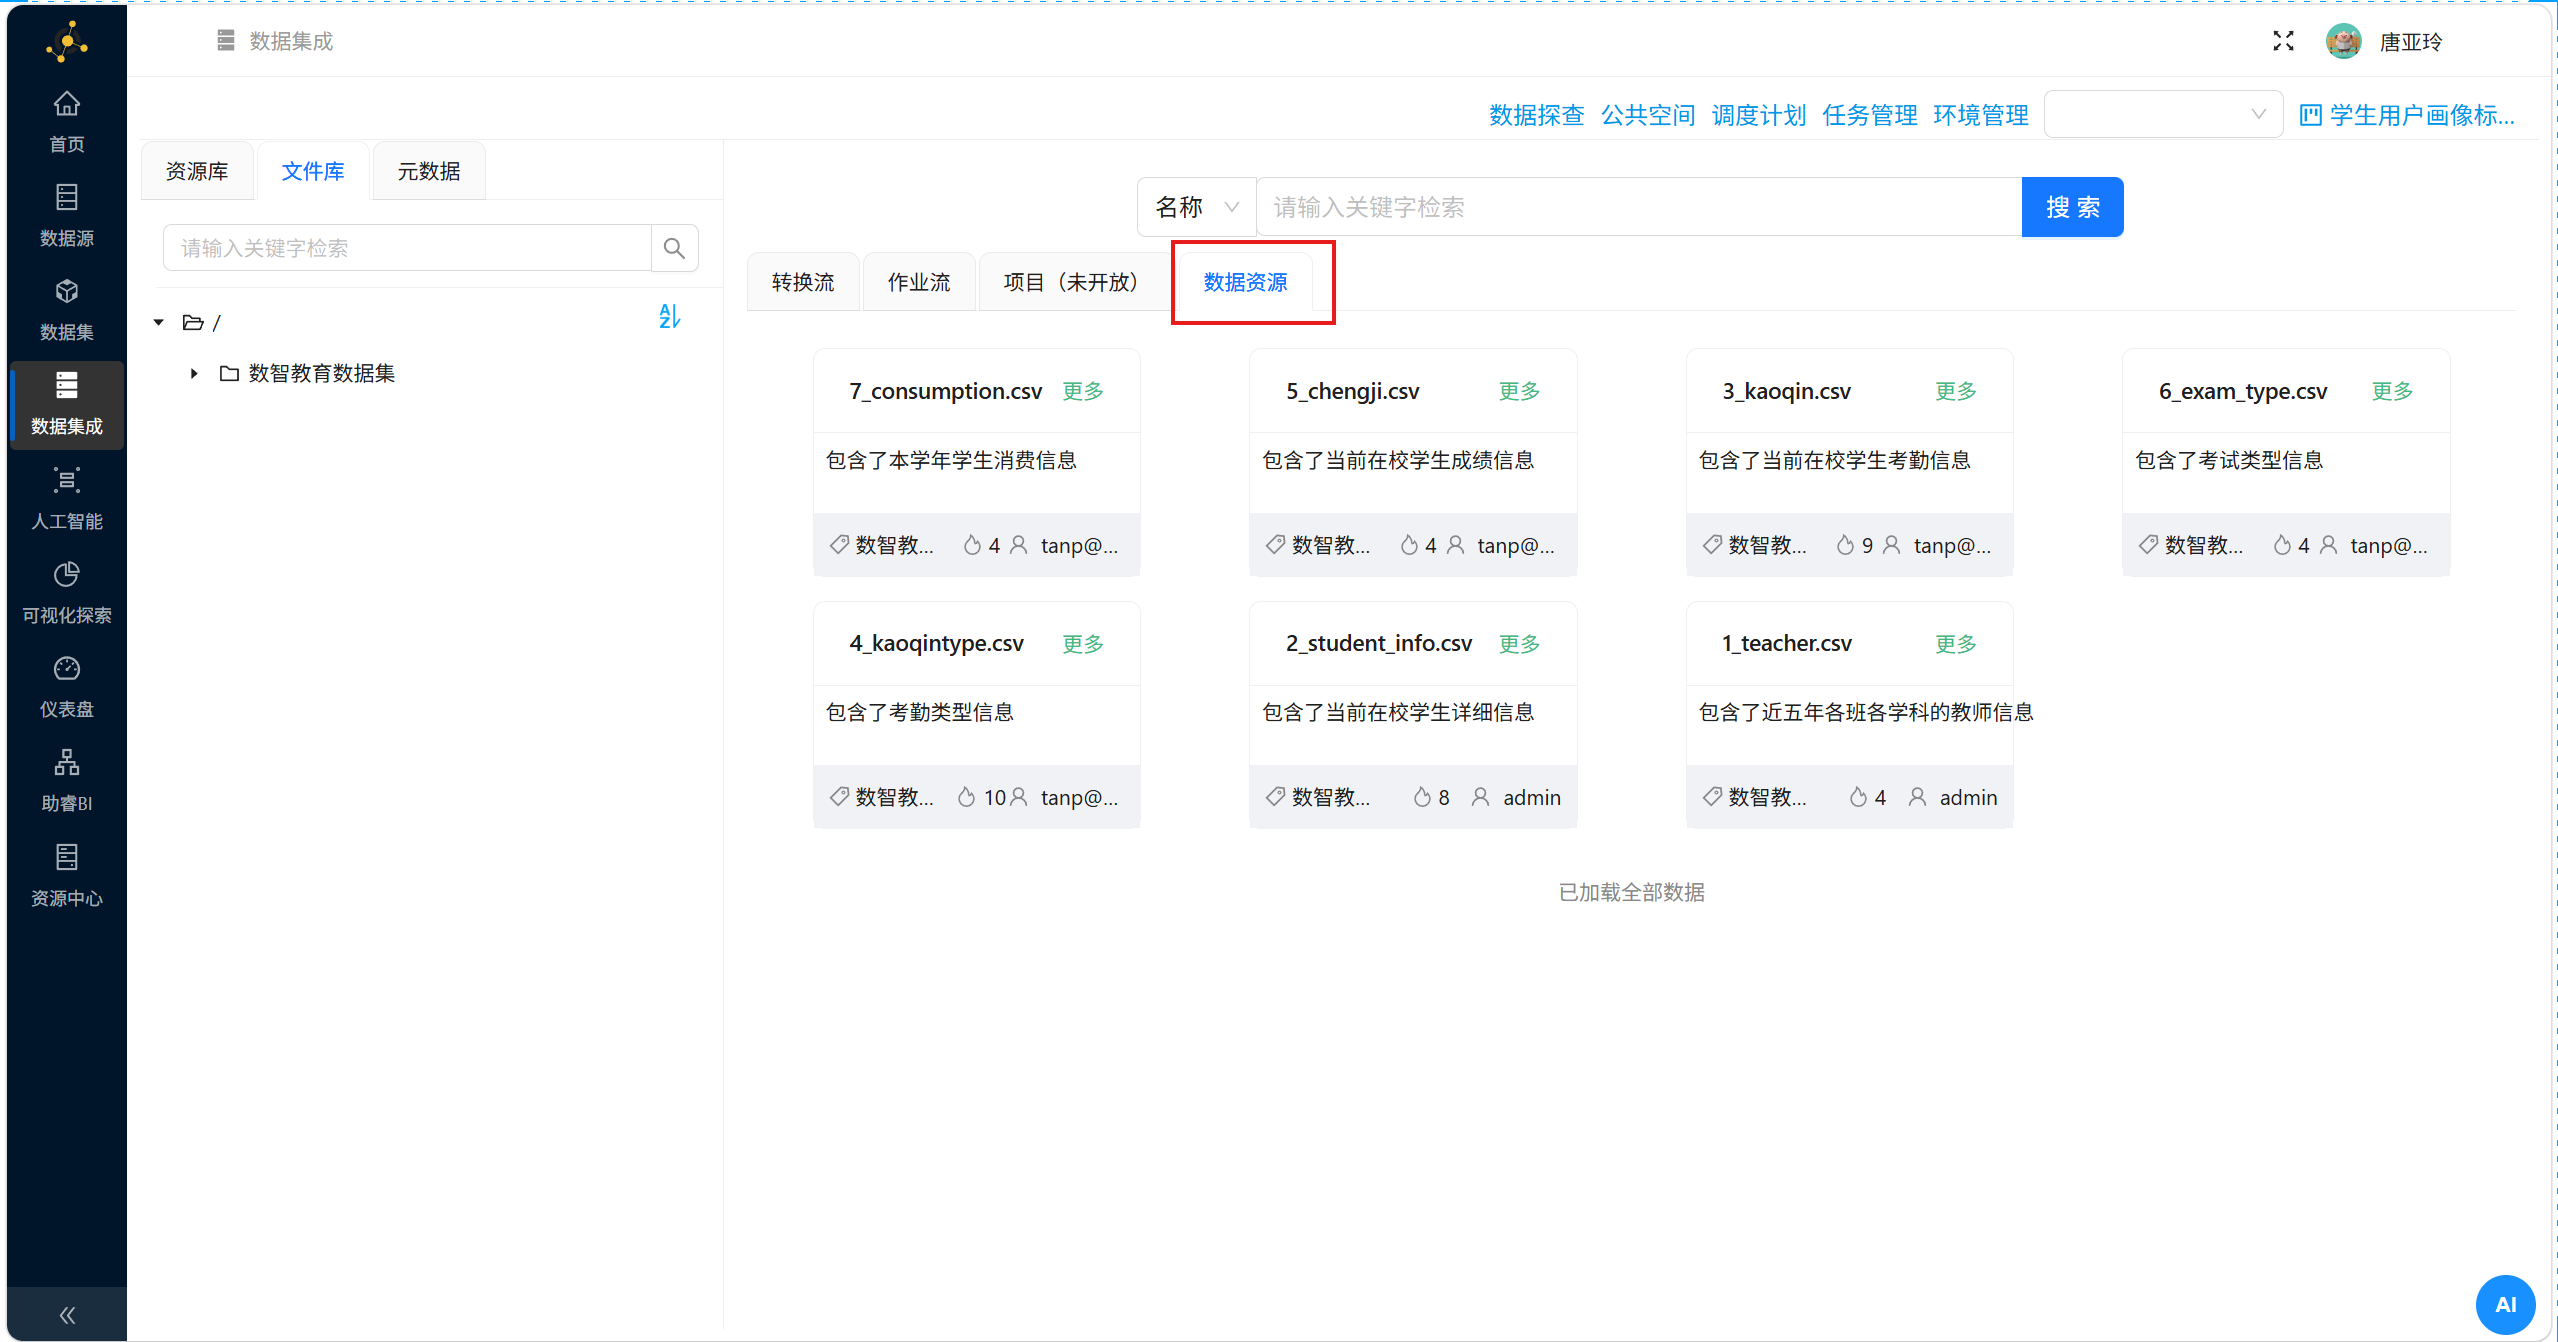
点击“3_kaoqin.csv”卡片右上角的“更多”,并点击“导出”
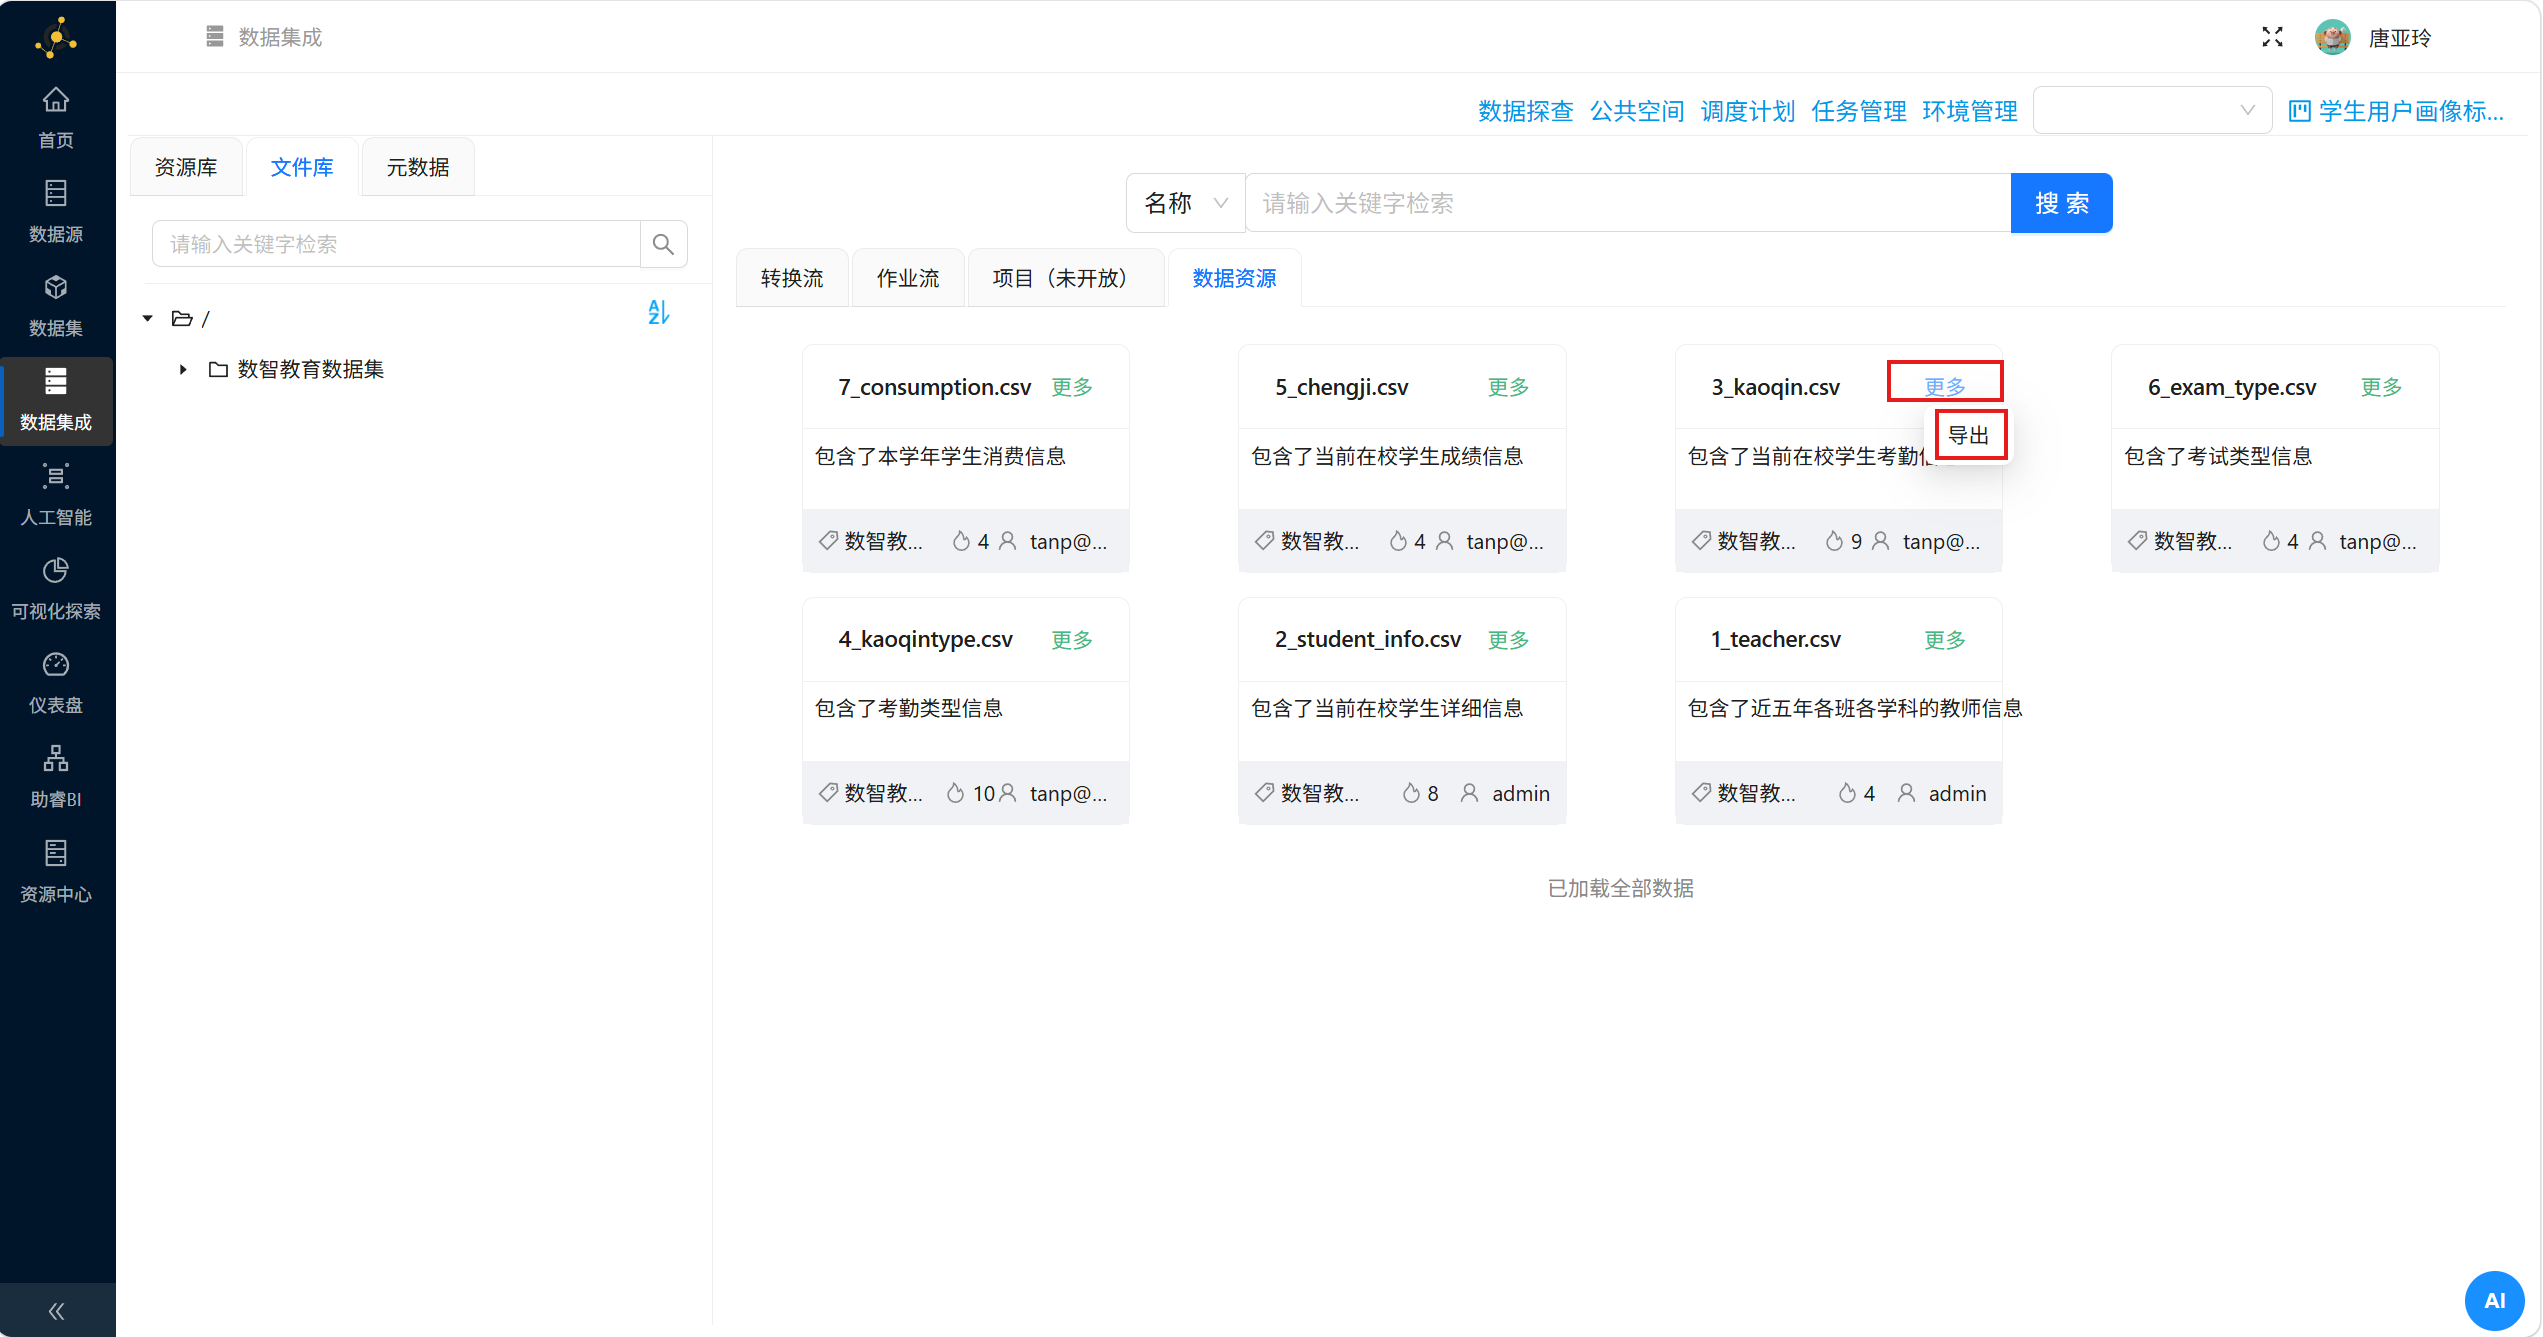
在弹出的窗口中选择导出到刚刚创建的目录 “数智教育数据集” 下
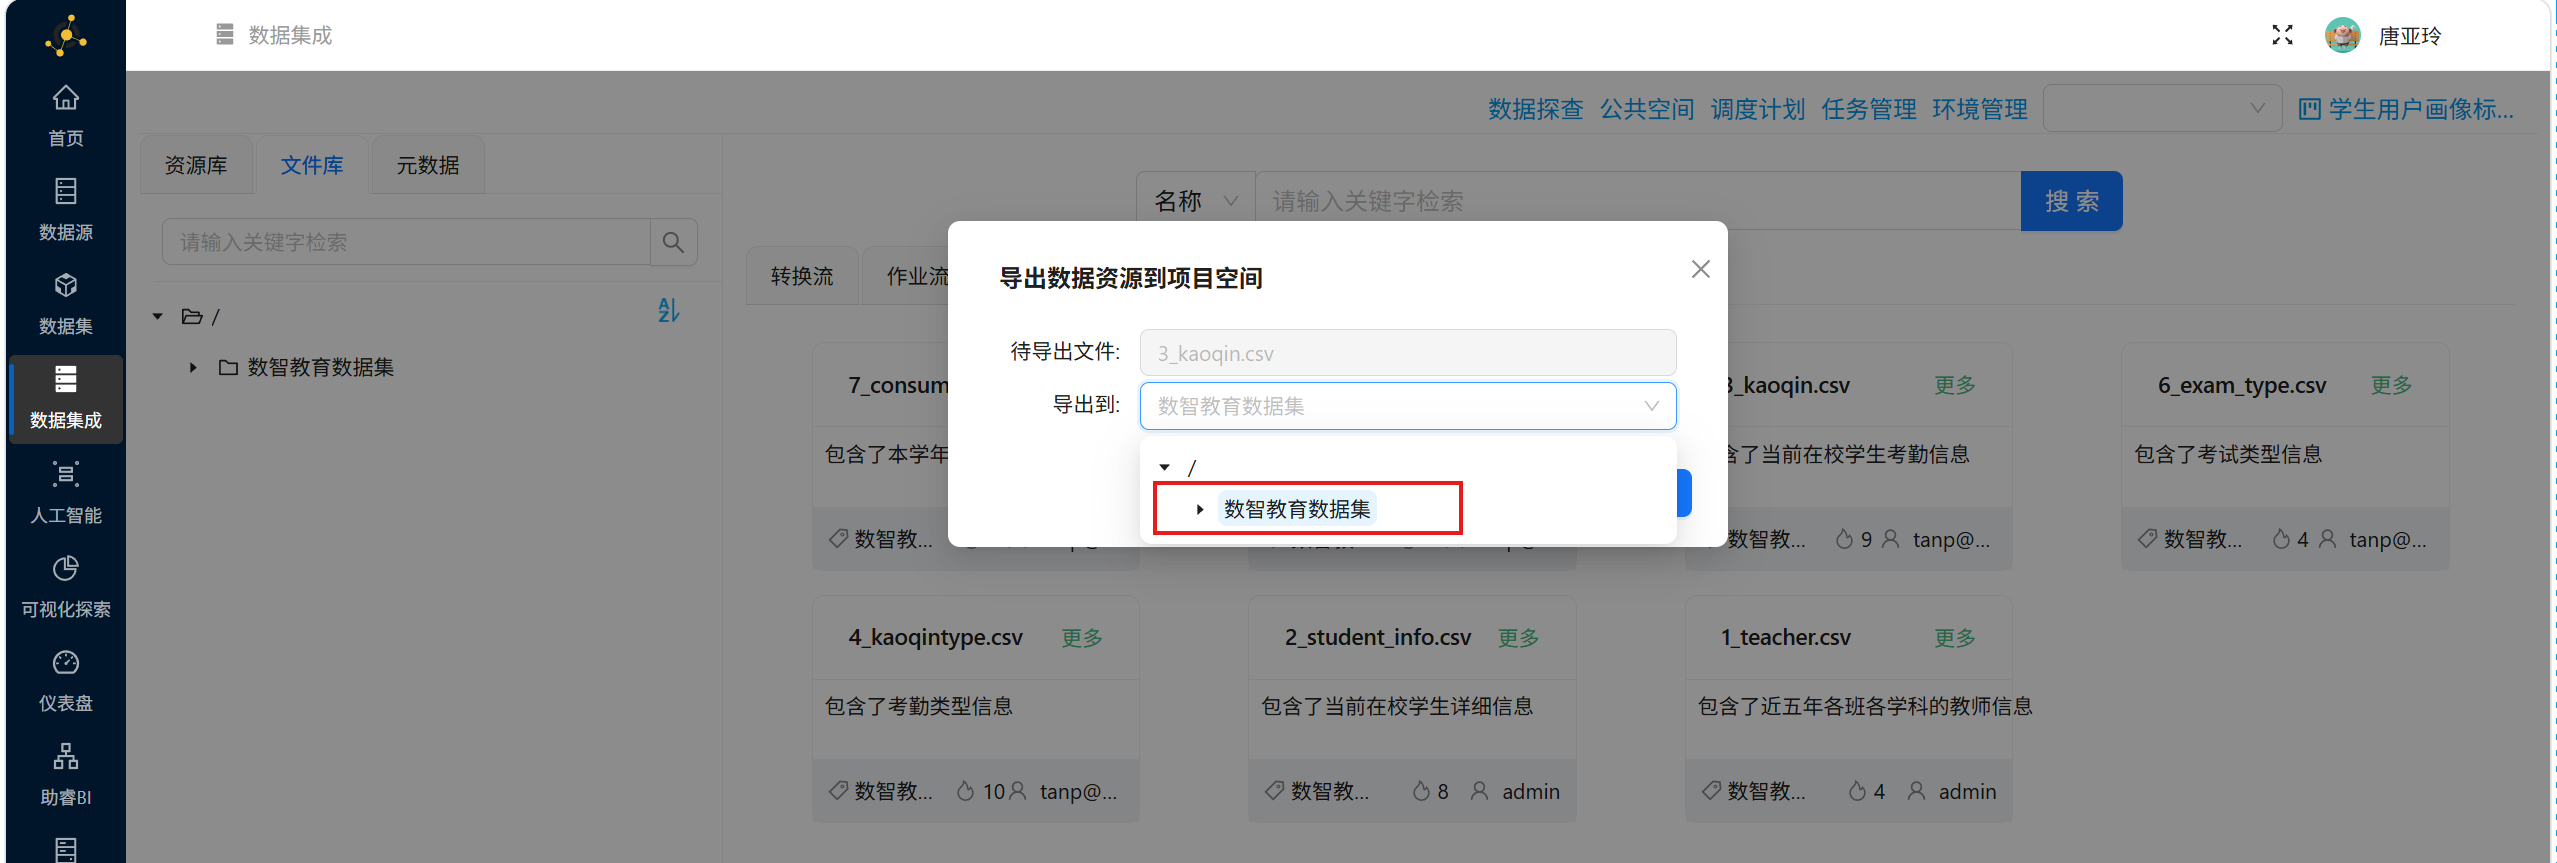
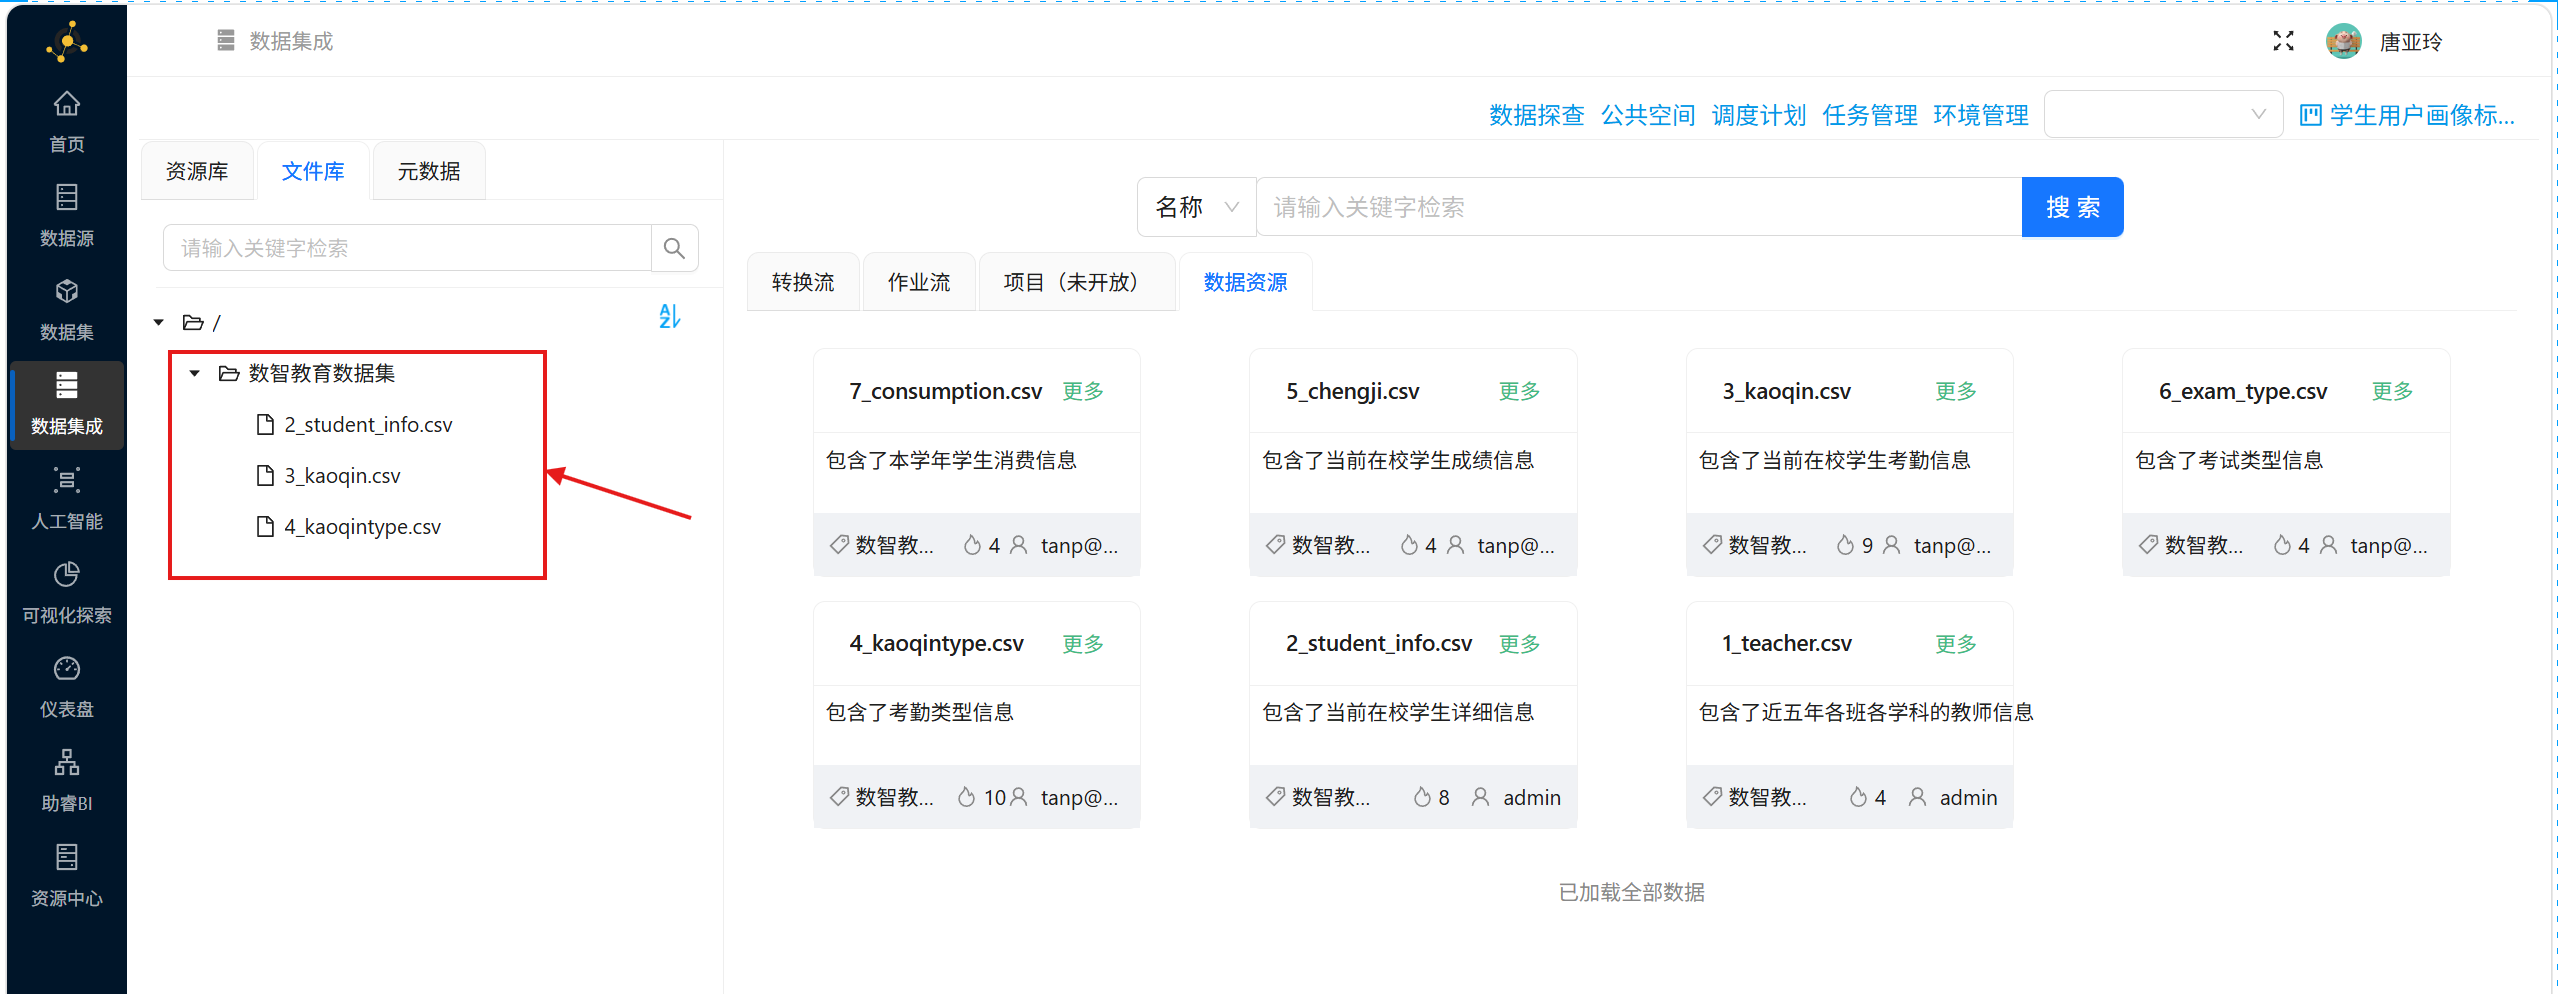
刷新后,可以看到在数智教育数据集的目录下,新增了3_kaoqin.csv
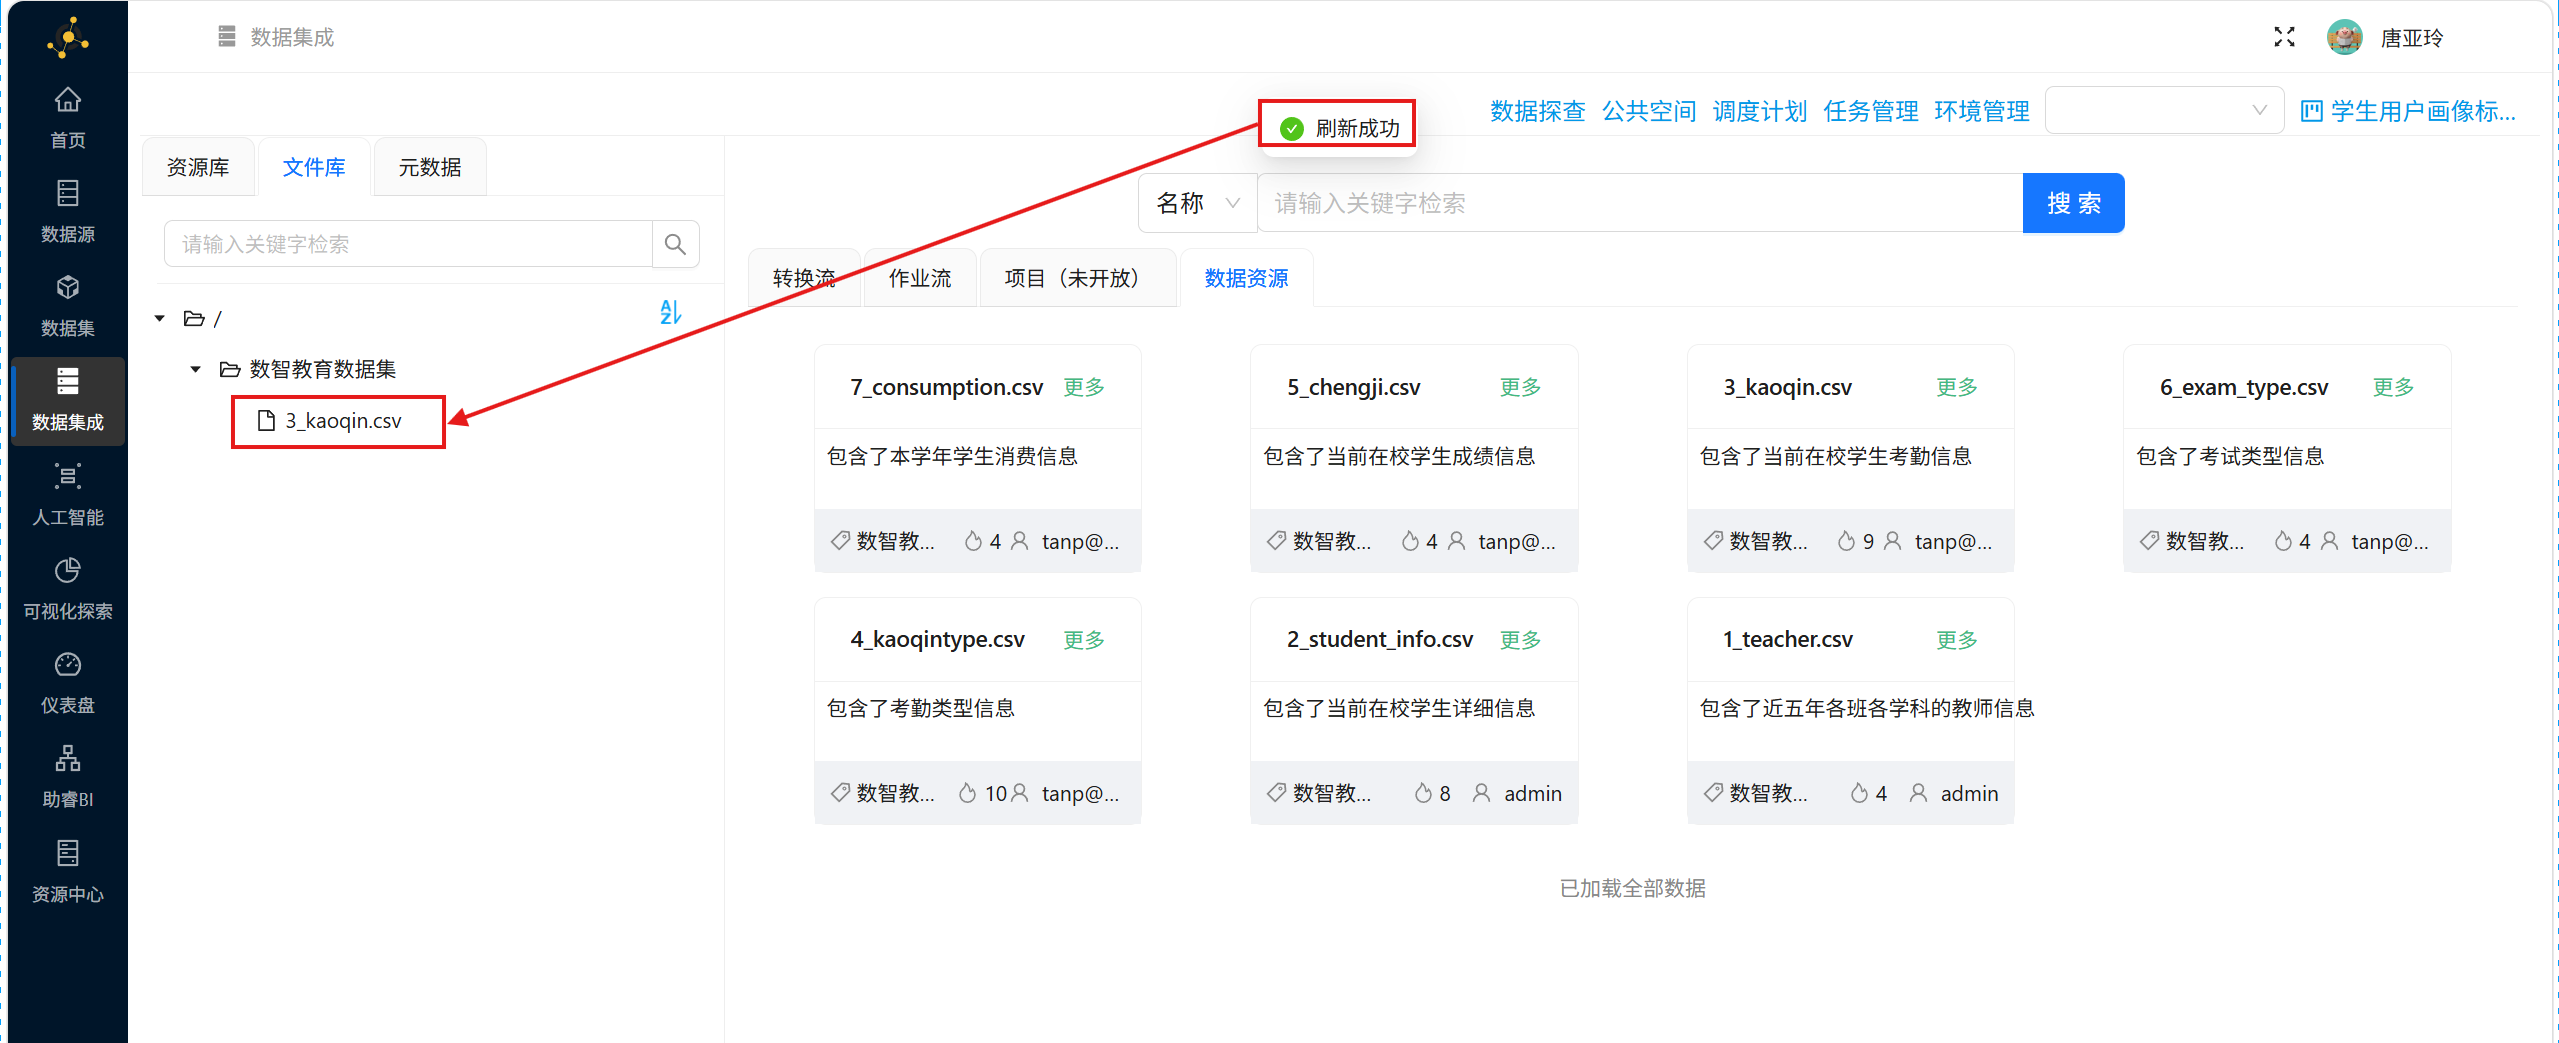
重复以上导出操作,将本次实验需要用到的数据表 4_kaoqintype.csv 和 2_student_info.csv 都导出到“数智教育数据集”
3.3 建立数据源连接
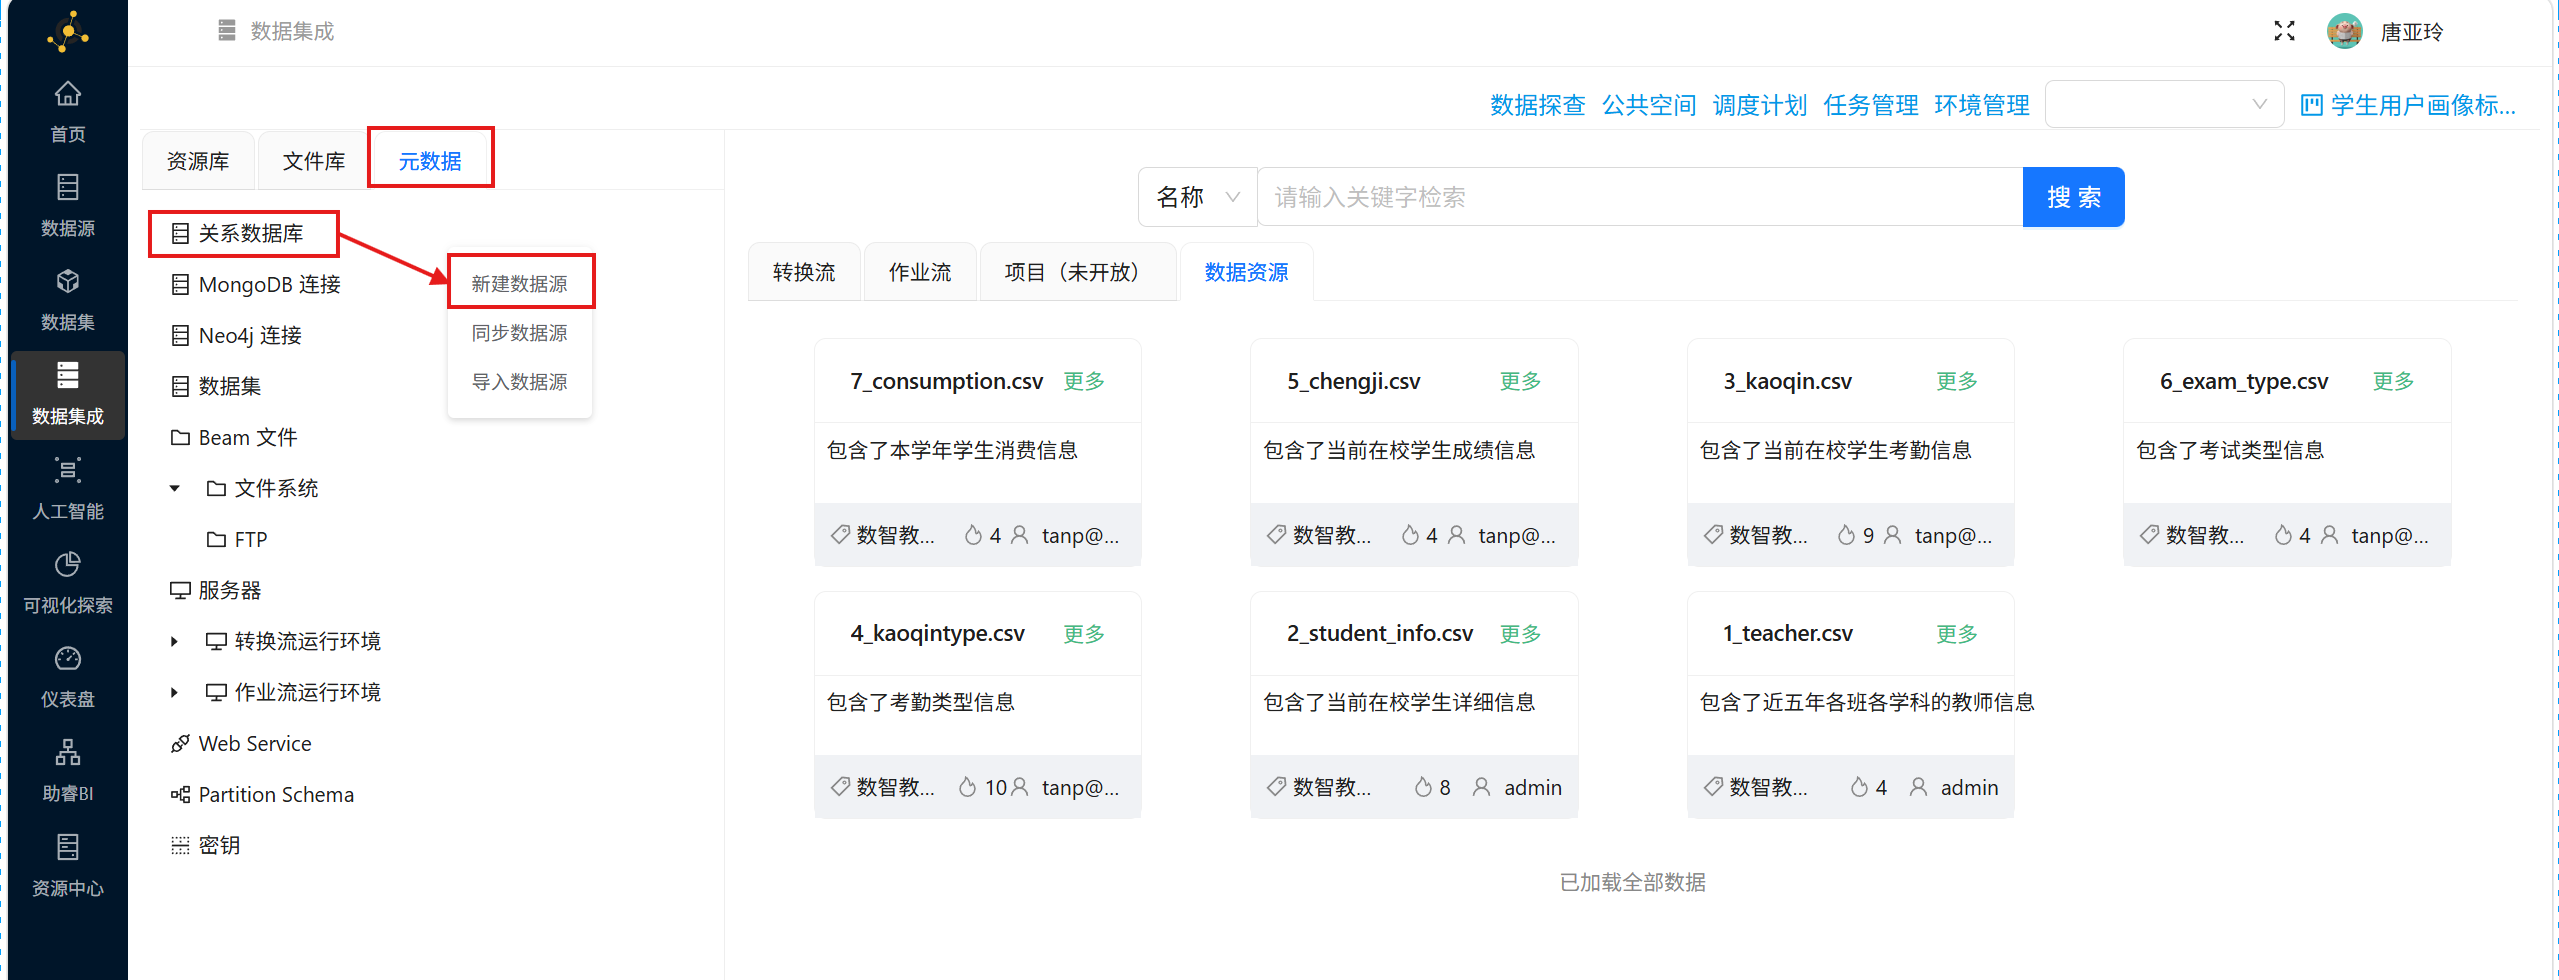
在 “元数据” 菜单页,关系数据库右键打开菜单,选择“新建数据源”
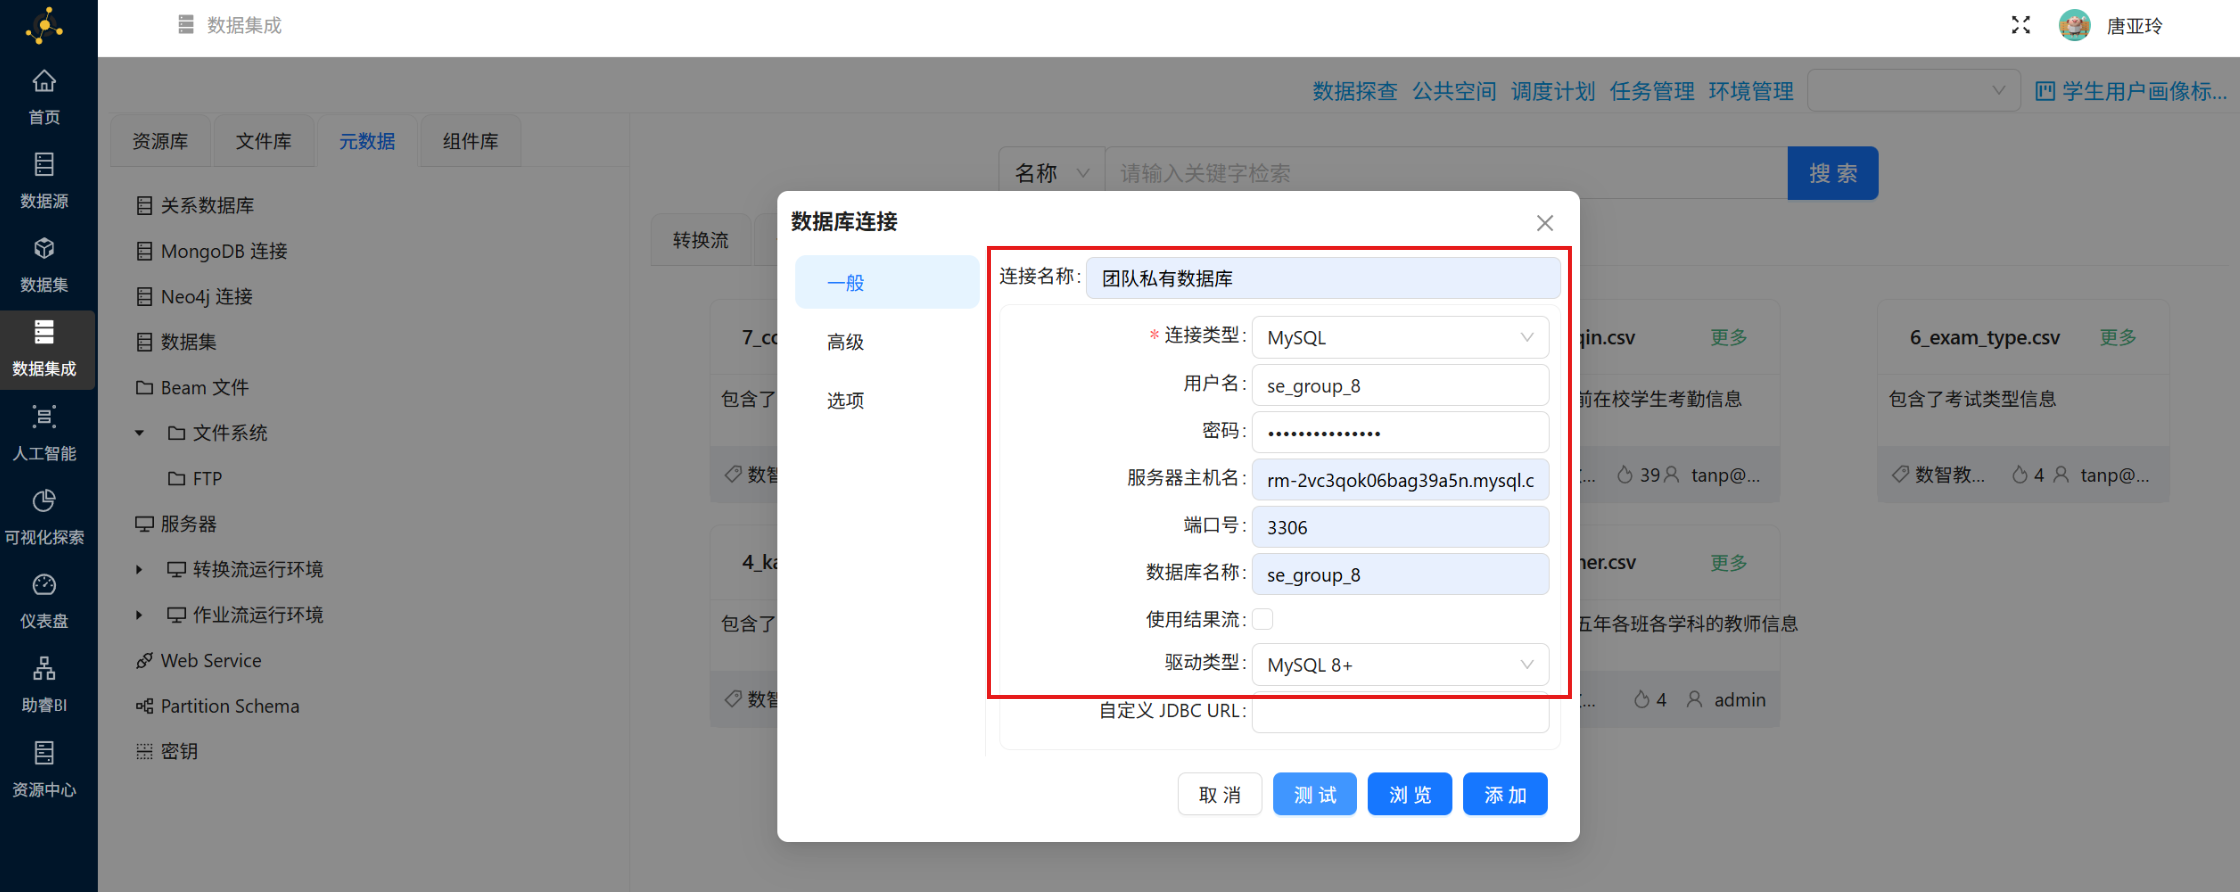
在弹出的新建数据库连接窗口配置信息:
- 连接名称为 “团队私有数据库”
- 连接类型选择 “MySQL”
- 用户名和密码使用助教提供的账号和密码
- 服务器主机名使用助教提供的数据库连接地址:rm-2vc3qok06bag39a5n.mysql.cn-chengdu.rds.aliyuncs.com
- 端口号为 3306
- 数据库名为助教提供的数据库名称,驱动类型选择 “MySQL 8+”
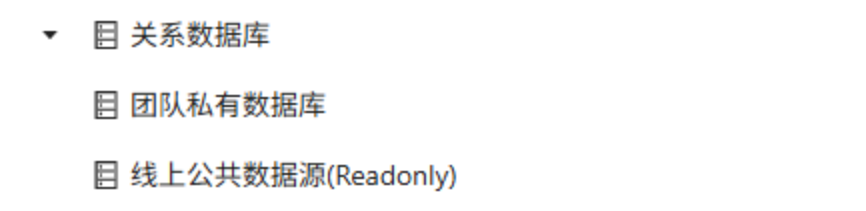
填写完毕后,点击“测试”按钮验证填写信息是否正确,如果填写无误,上方会返回“数据库连接成功”。此时,点击 “添加”,将会增加一个数据库连接;添加成功后,关系数据库节点会增加一个子节点
3.4 数据导入团队私有数据库
3.4.1 原始考勤记录表数据导入
(1)创建原始_学生考勤表
新建转换工作流,并命名为“创建原始_学生考勤表”
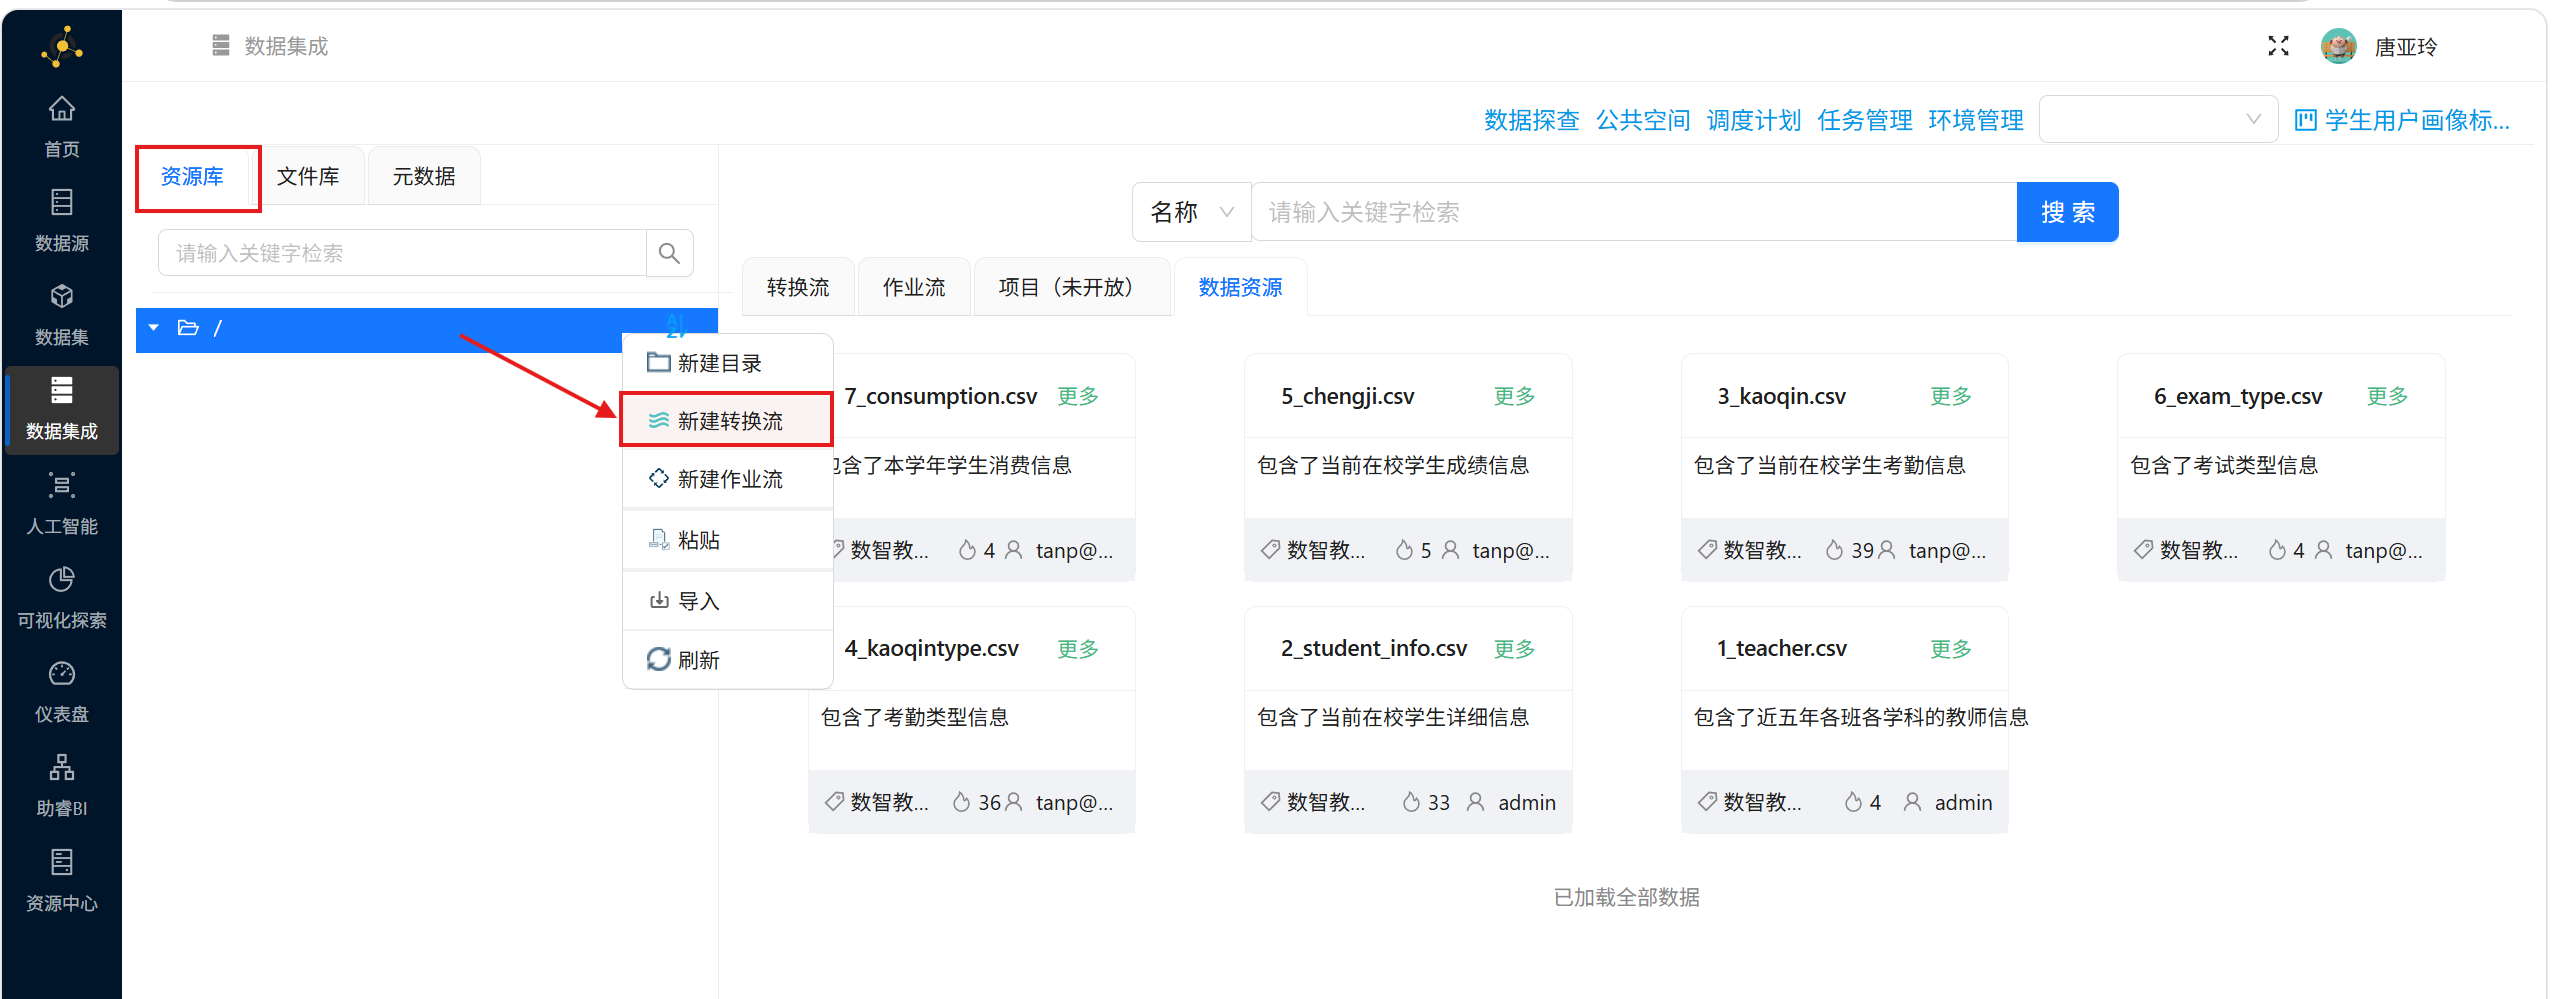
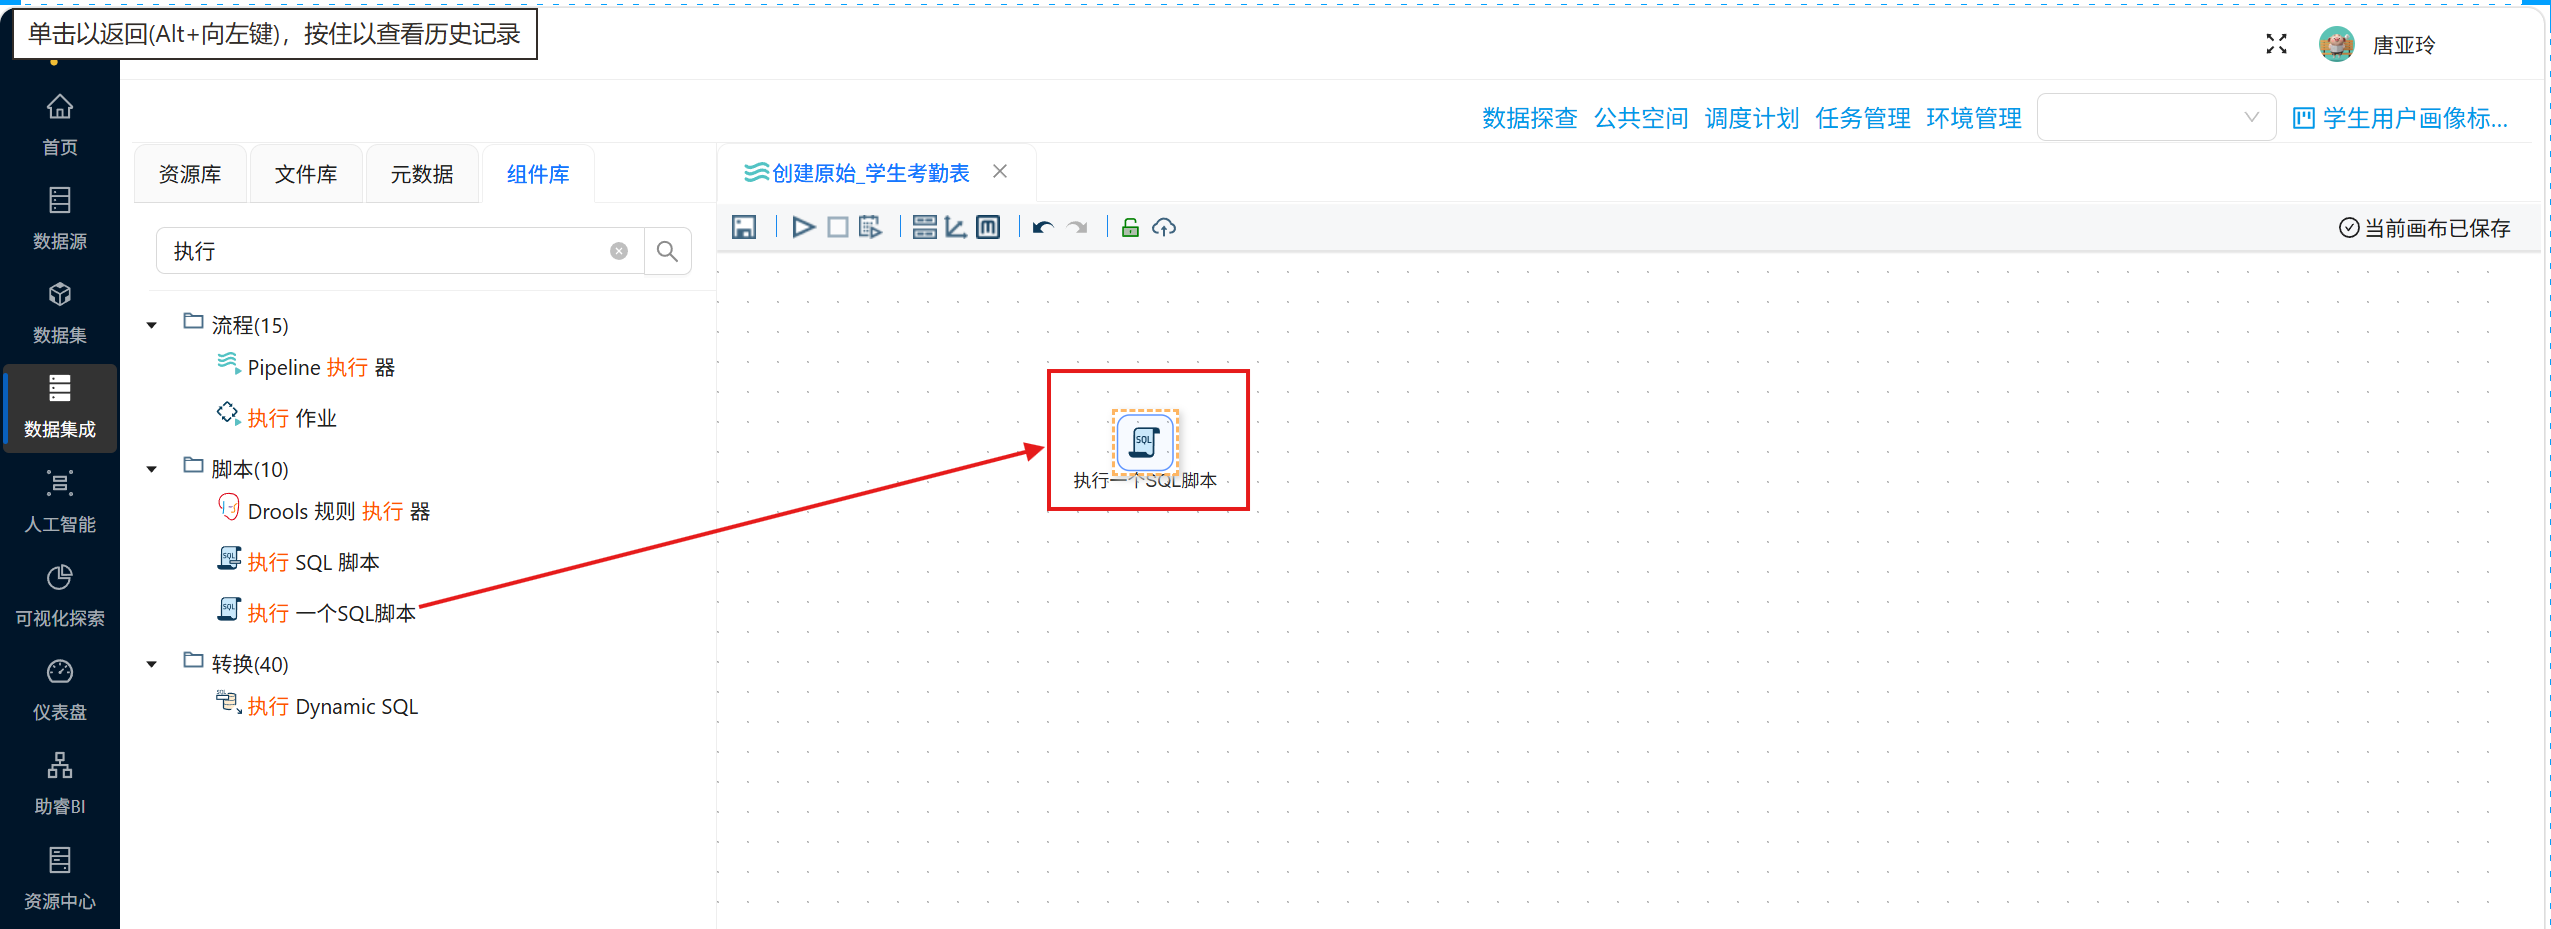
拖拽“执行一个SQL脚本”组件到画布,通过执行SQL脚本创建一个标签表。整个转换流如下所示:
配置说明:在组件中填写SQL脚本,选择目标数据库连接“团队私有数据库”,确保脚本执行权限。
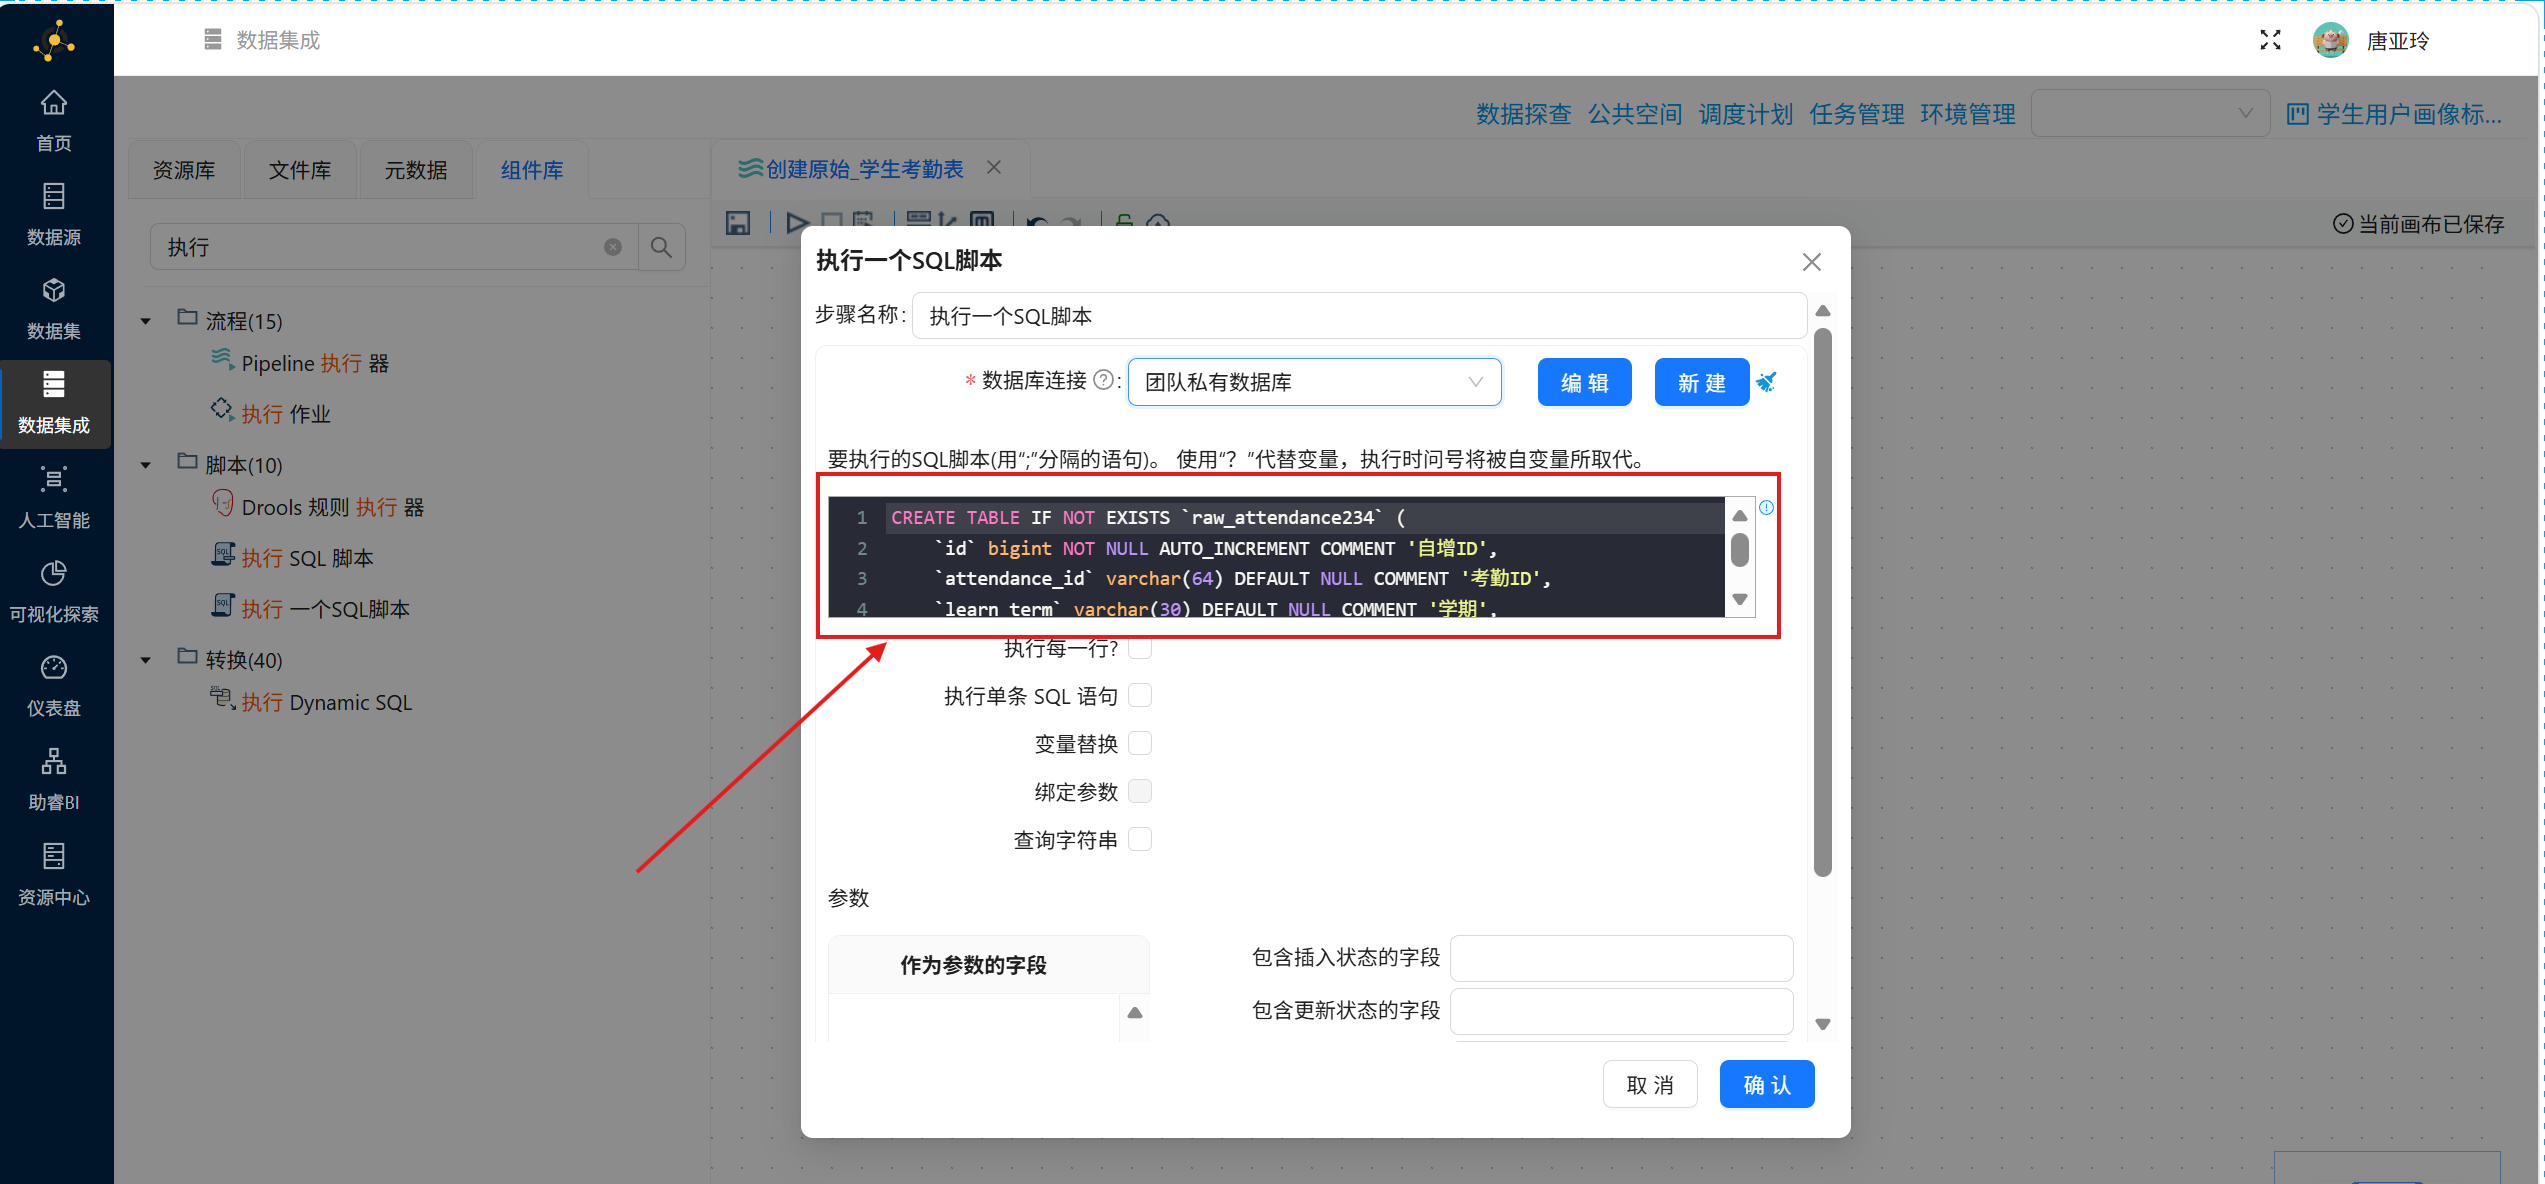
SQL脚本如下:
CREATE TABLE IF NOT EXISTS  `raw_attendance` (
  `id` bigint NOT NULL AUTO_INCREMENT COMMENT '自增ID',
  `attendance_id` varchar(64) DEFAULT NULL COMMENT '考勤ID',
  `learn_term` varchar(30) DEFAULT NULL COMMENT '学期',
  `data_datetime` varchar(50) DEFAULT NULL COMMENT '时间和日期',
  `attendance_type_id` varchar(64) DEFAULT NULL COMMENT '考勤类型ID',
  `attendance_name` varchar(100) DEFAULT NULL COMMENT '考勤名称',
  `attendance_task_order_id` varchar(64) DEFAULT NULL COMMENT '考勤事件ID',
  `stu_id` varchar(64) DEFAULT NULL COMMENT '学生ID',
  `stu_name` varchar(100) DEFAULT NULL COMMENT '学生姓名',
  `cla_name` varchar(100) DEFAULT NULL COMMENT '班级名',
  `cla_id` varchar(64) DEFAULT NULL COMMENT '班级ID',
  `create_time` datetime DEFAULT CURRENT_TIMESTAMP COMMENT '入库时间',
  PRIMARY KEY (`id`),
  KEY `idx_student_id` (`stu_id`),
  KEY `idx_term` (`learn_term`)
) COMMENT='原始_学生考勤表';
完成后运行转换流,可以动态查看组件状态和执行日志
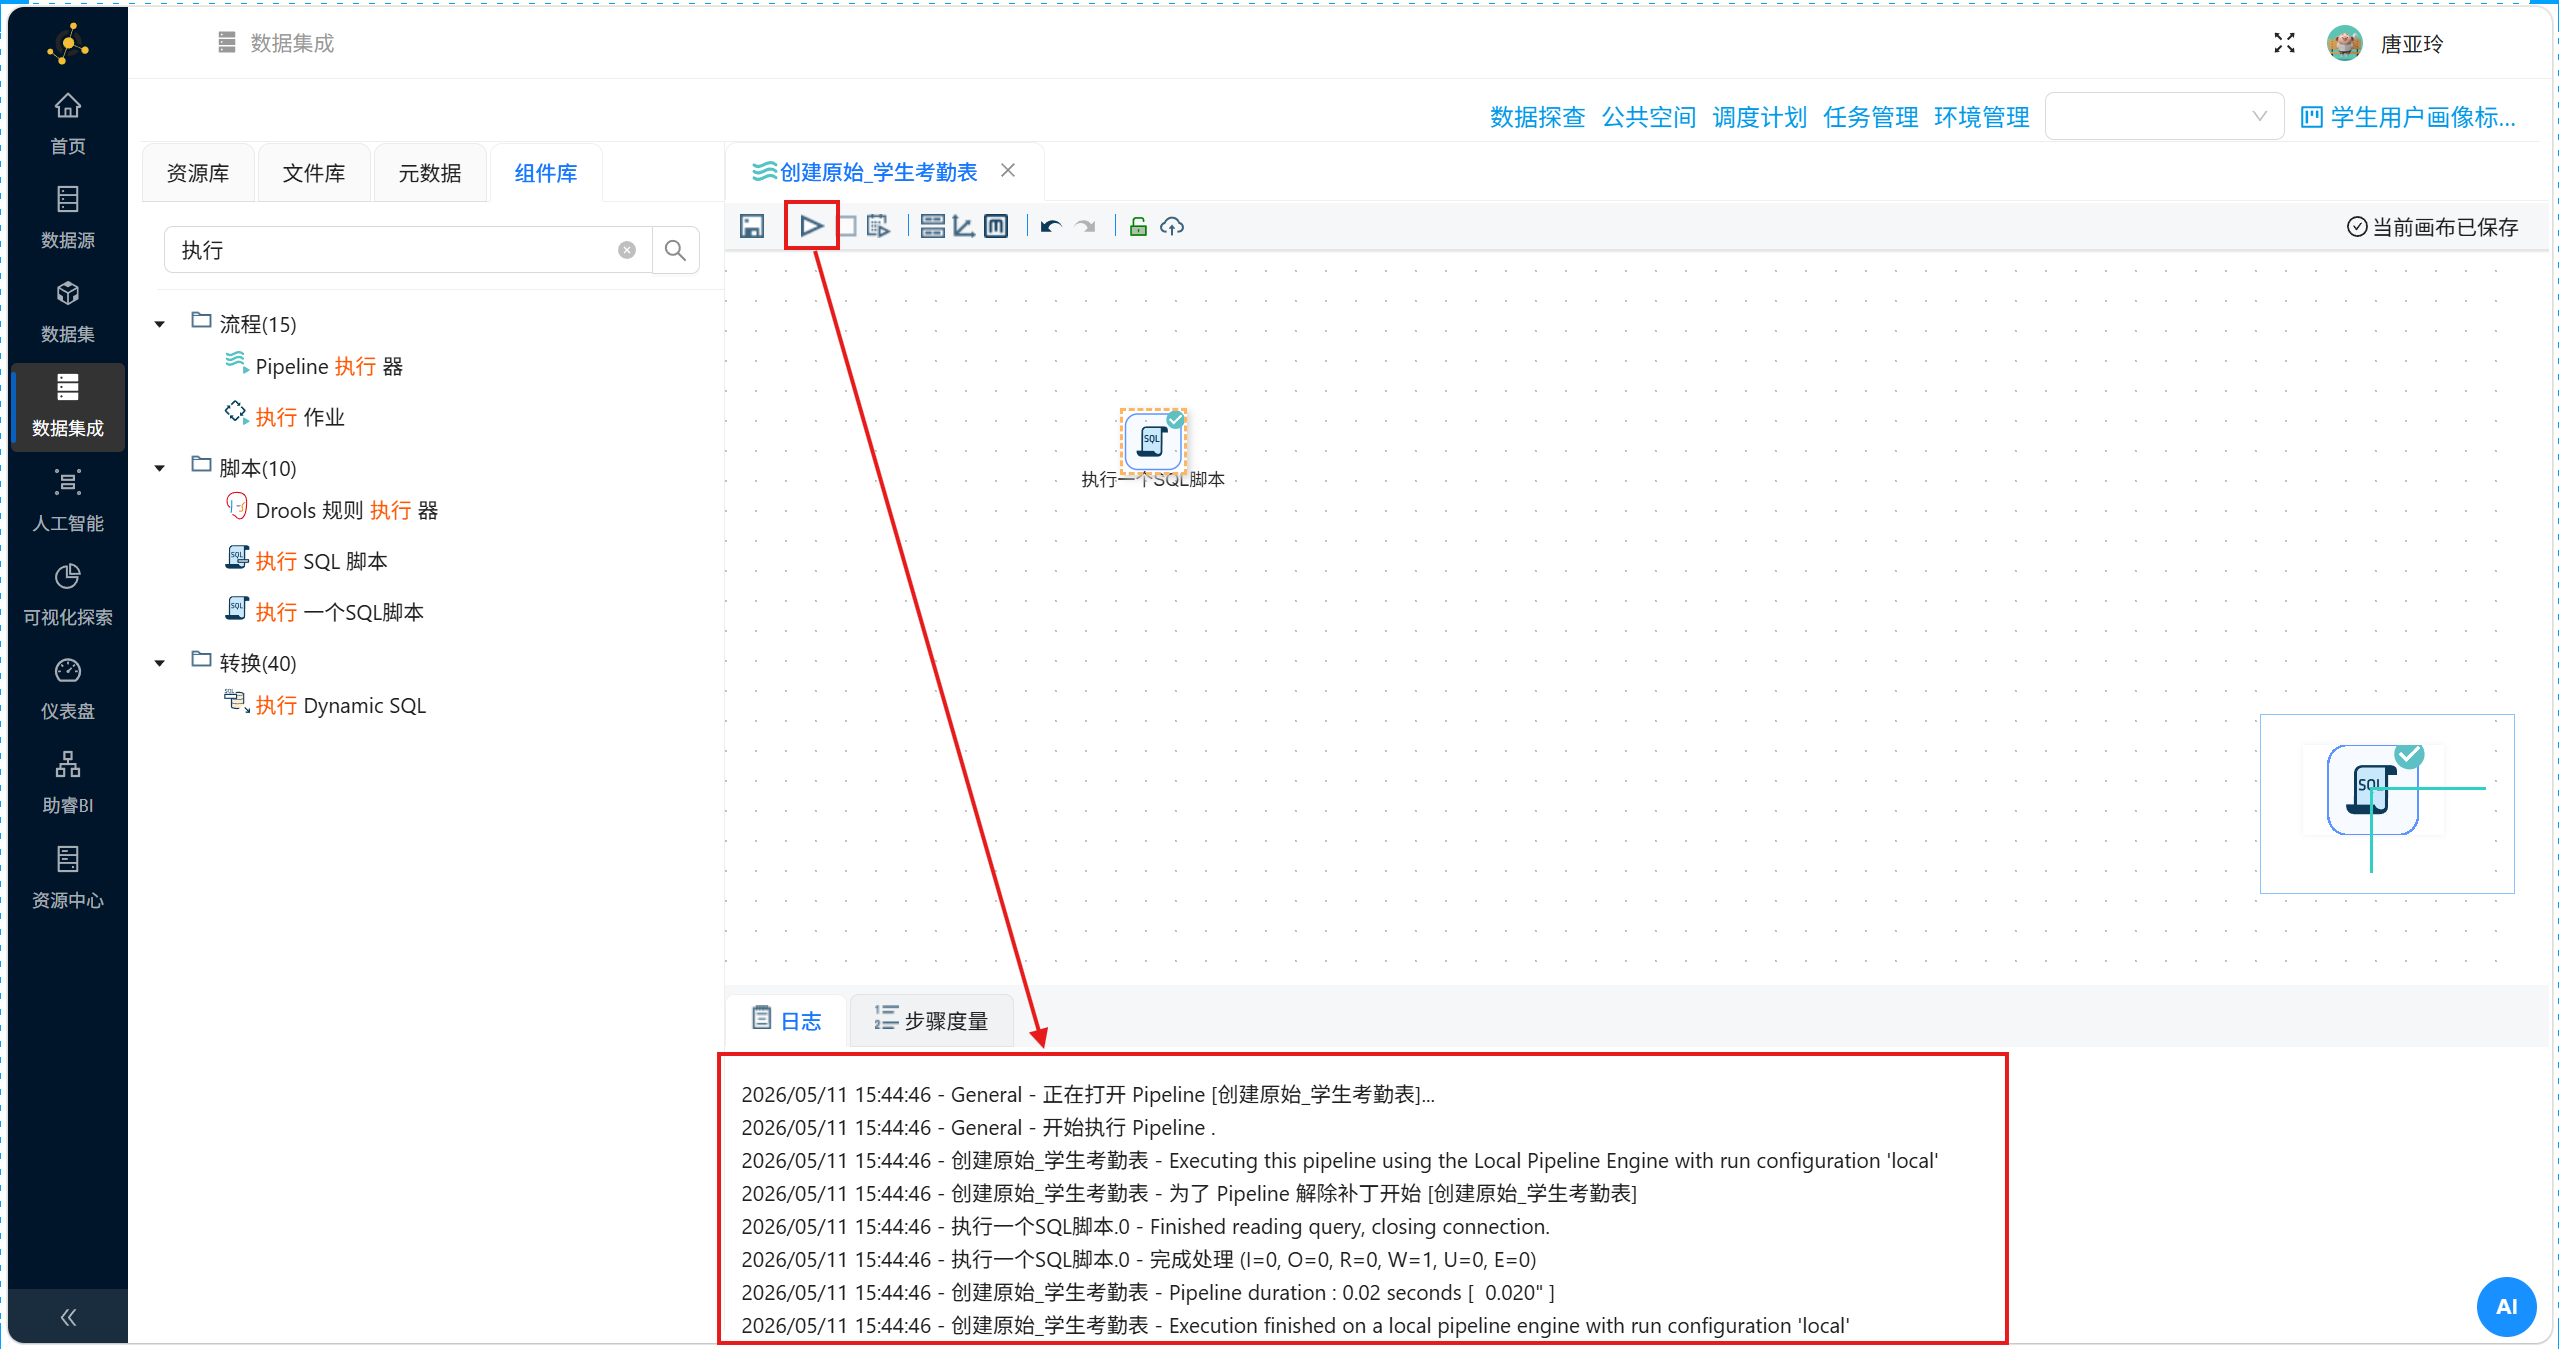
(2)导入原始考勤数据
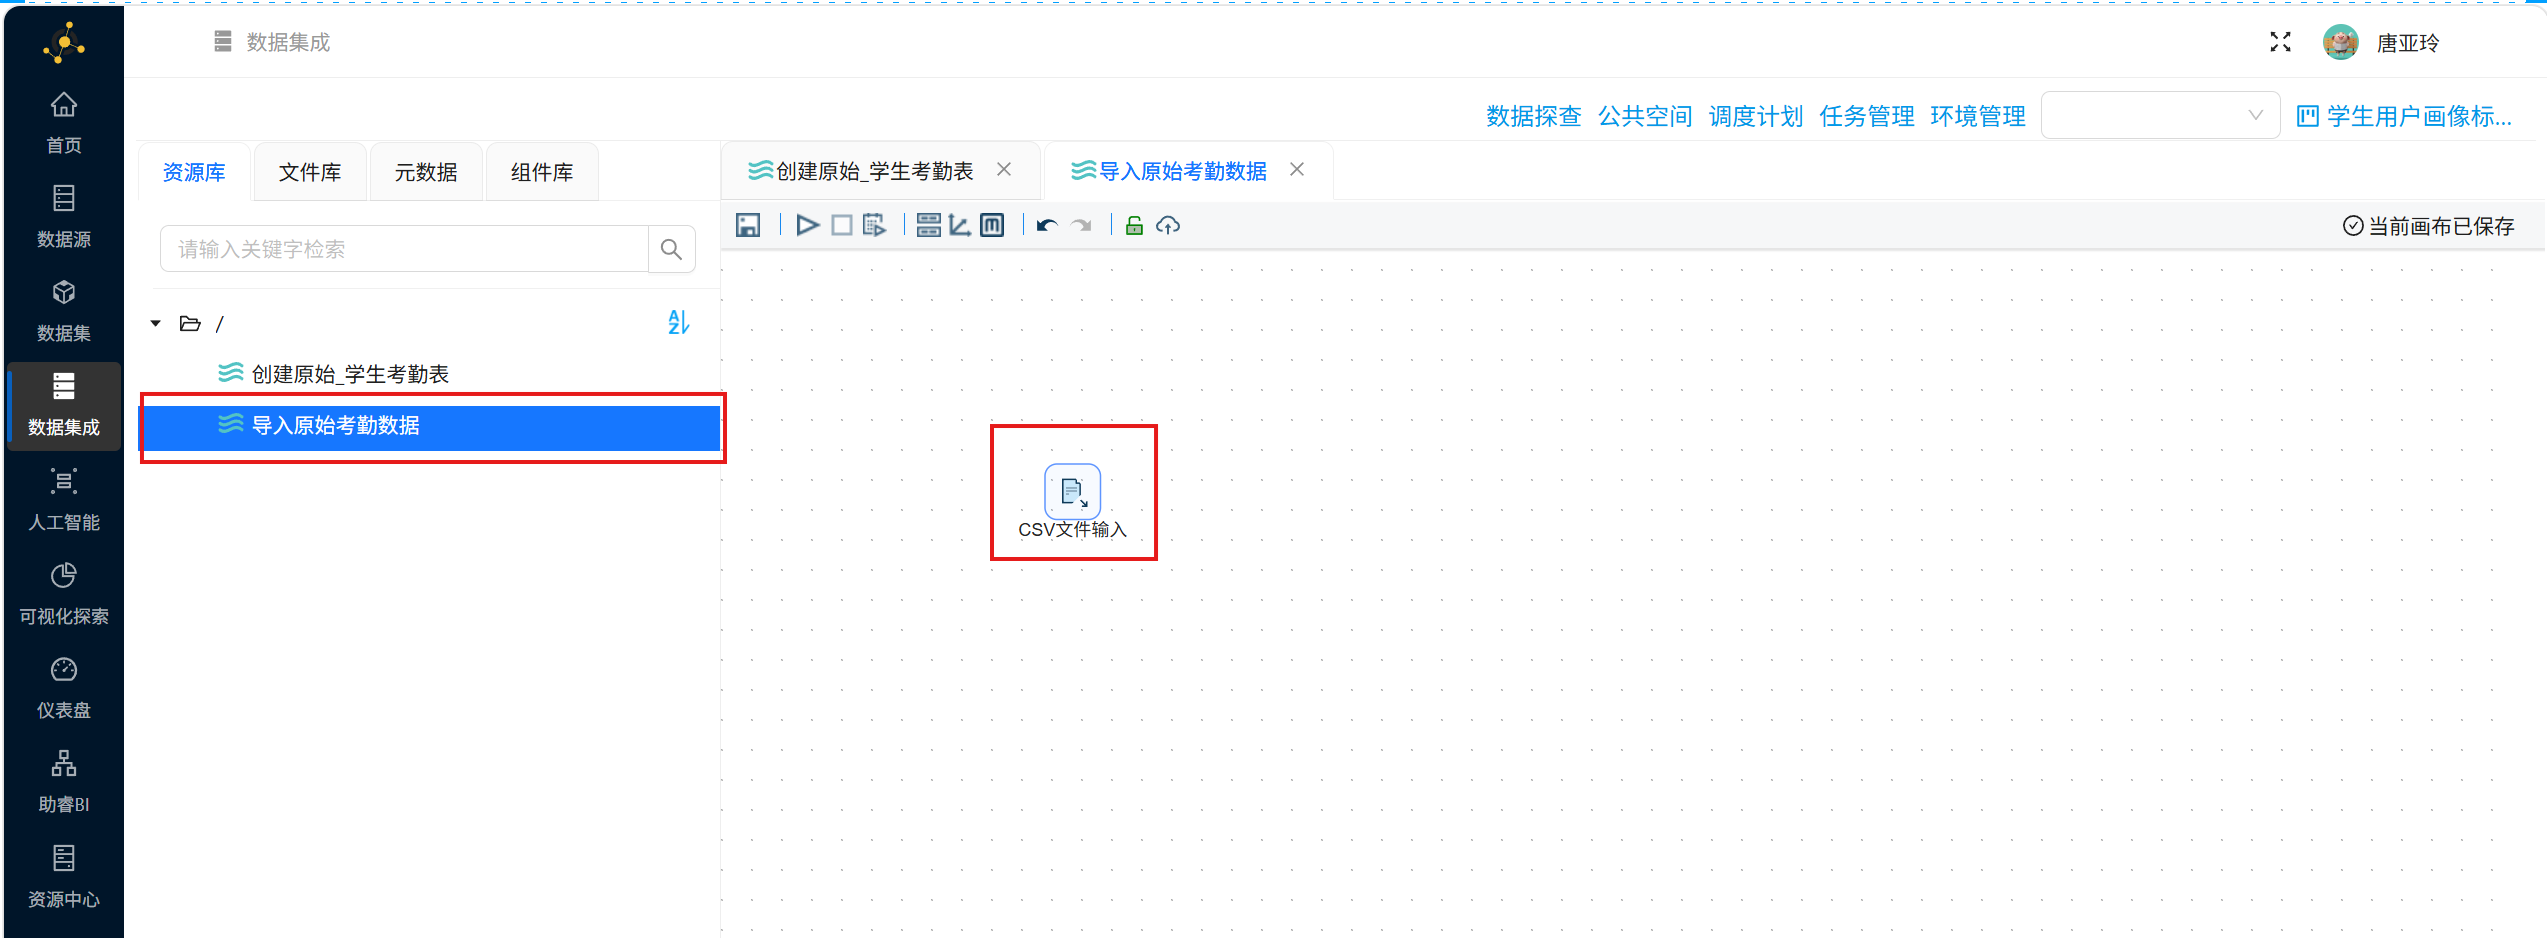
新建转换工作流,命名为 “导入原始考勤数据”,拖拽一个“CSV文件输入”组件到画布
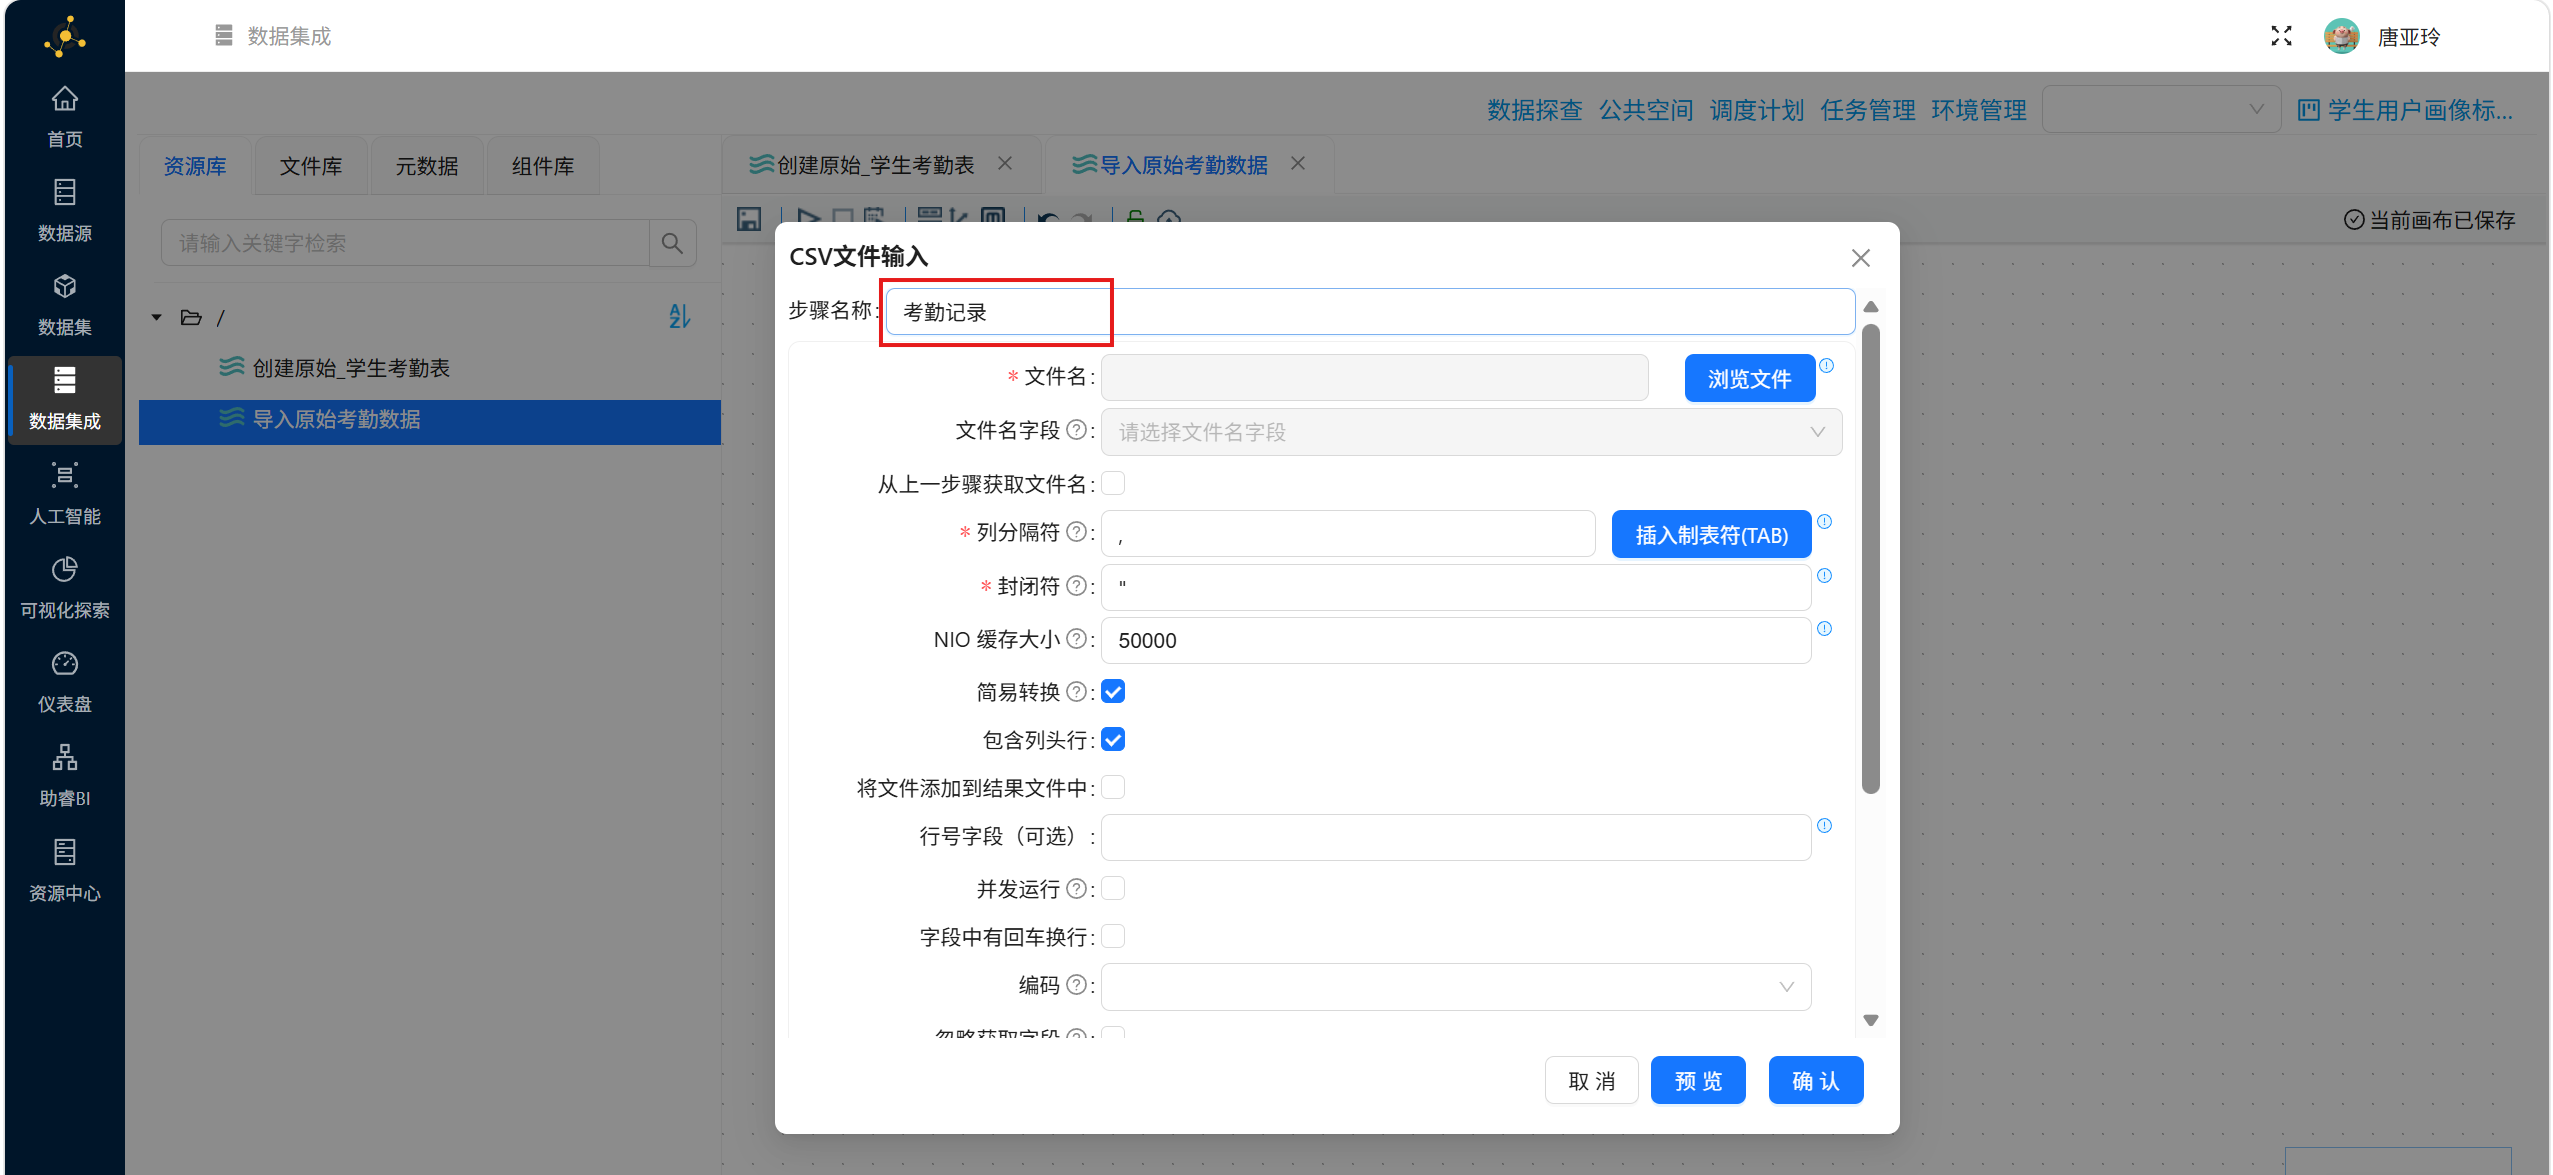
双击编辑CSV文件输入组件,在步骤名称中输入 “考勤记录”
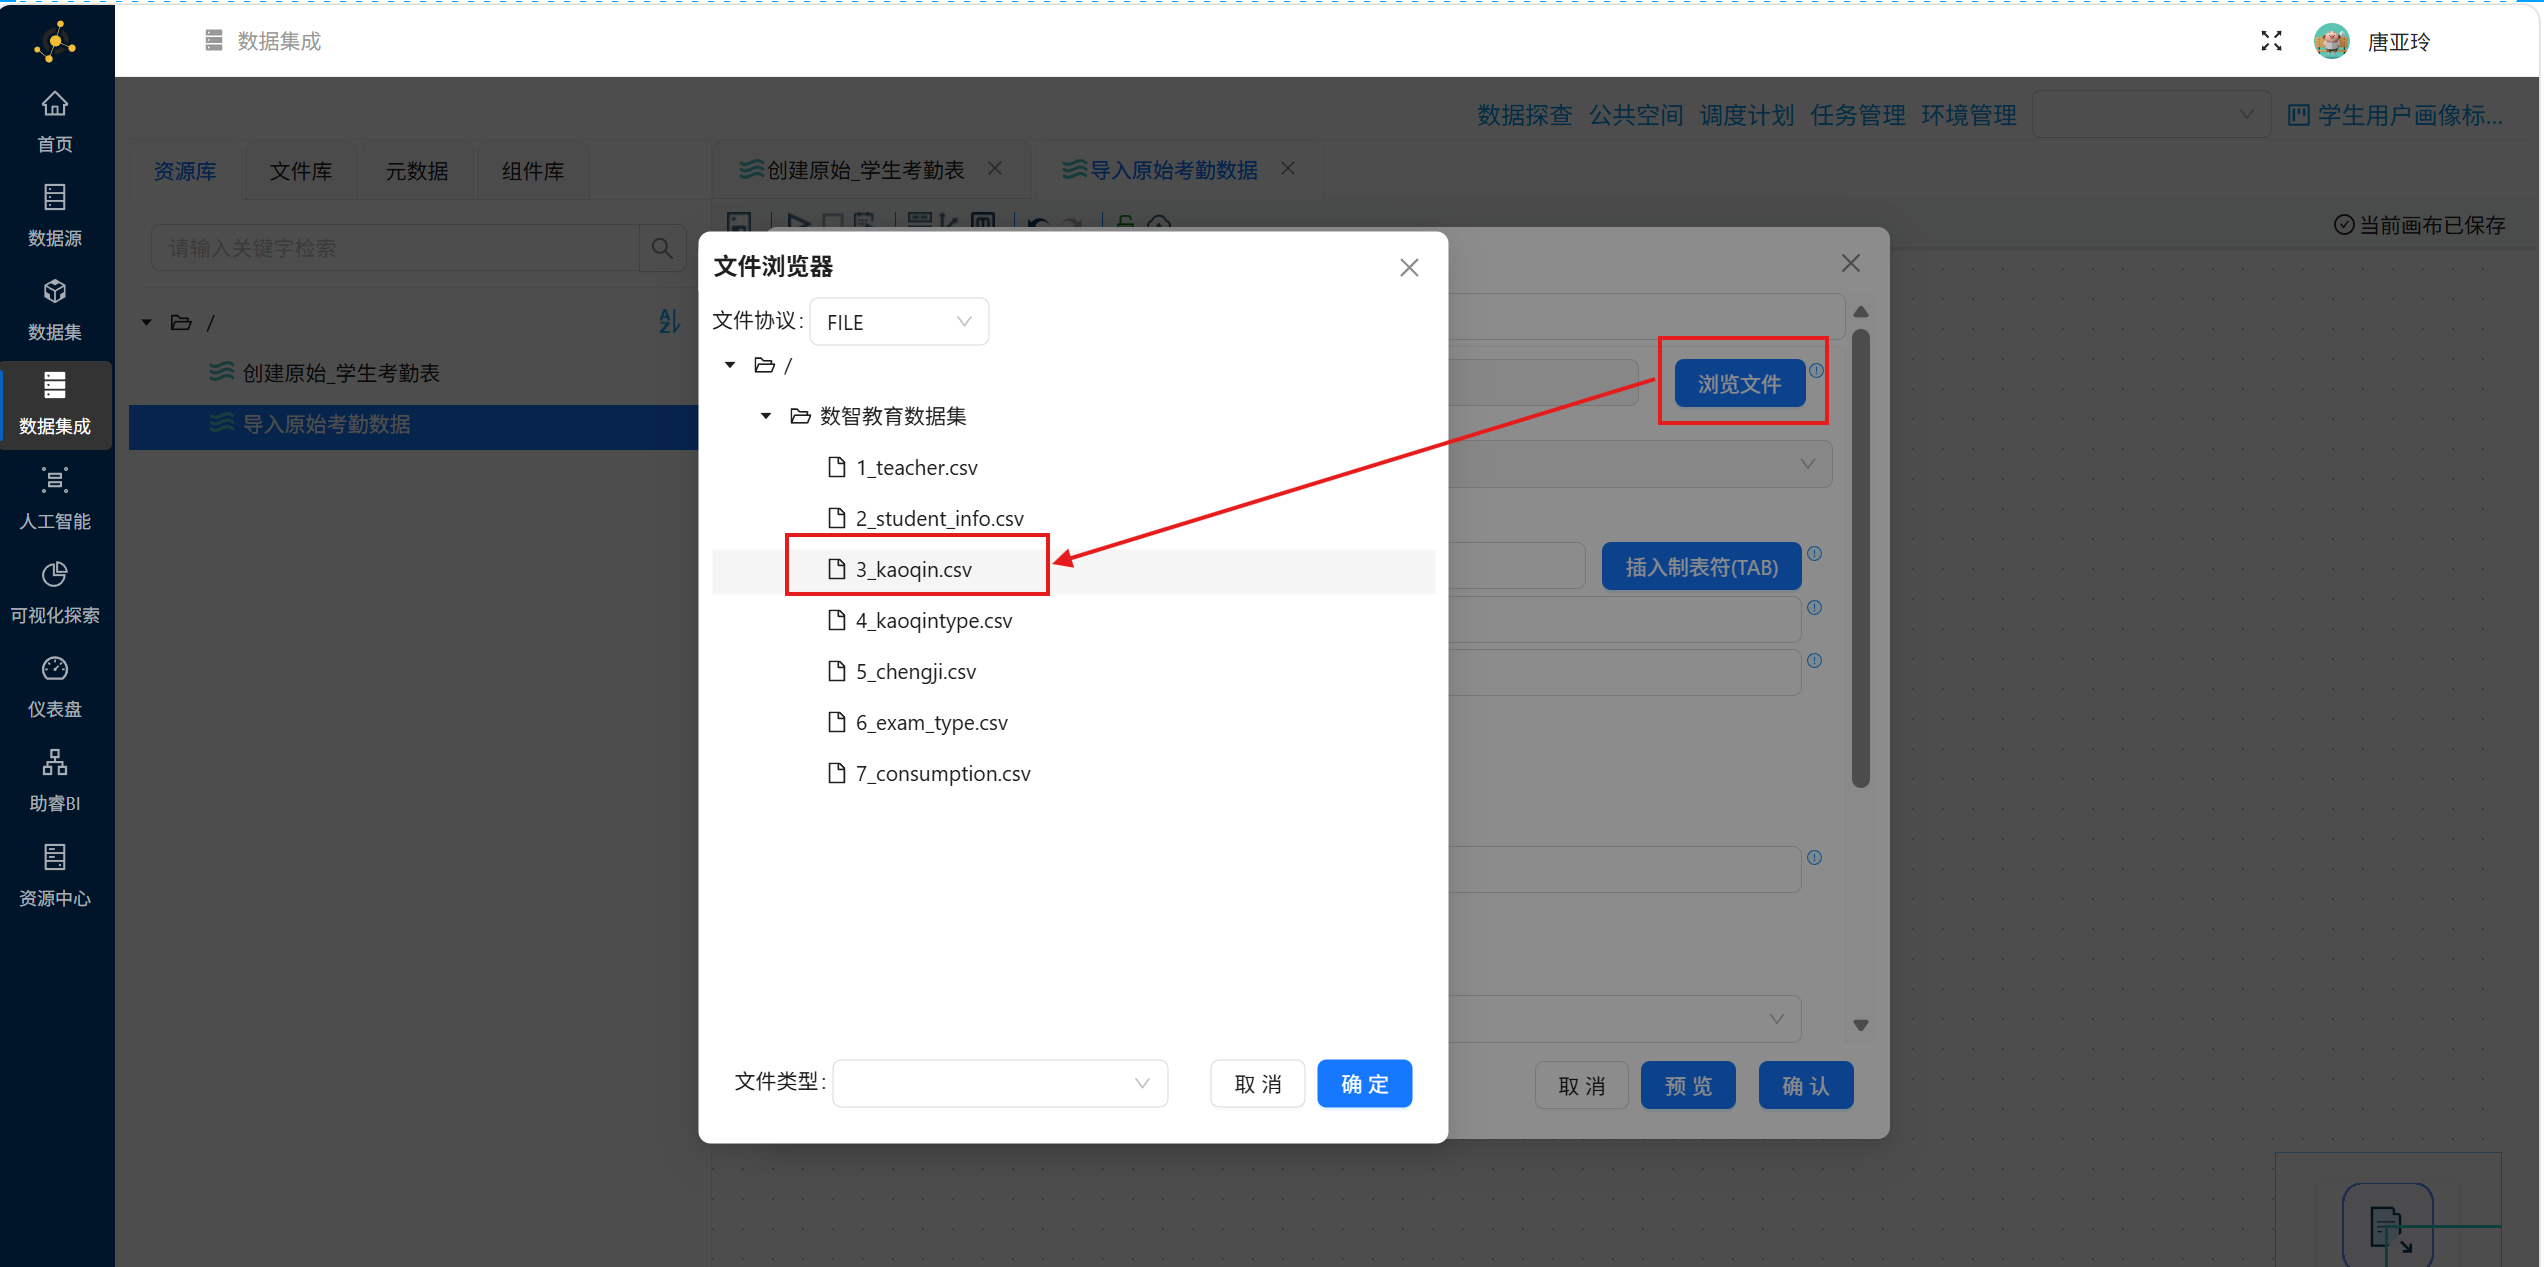
点击文件名后的 “浏览文件” 按钮,在弹窗中选择 “3_kaoqin.csv”,点击 “确定”
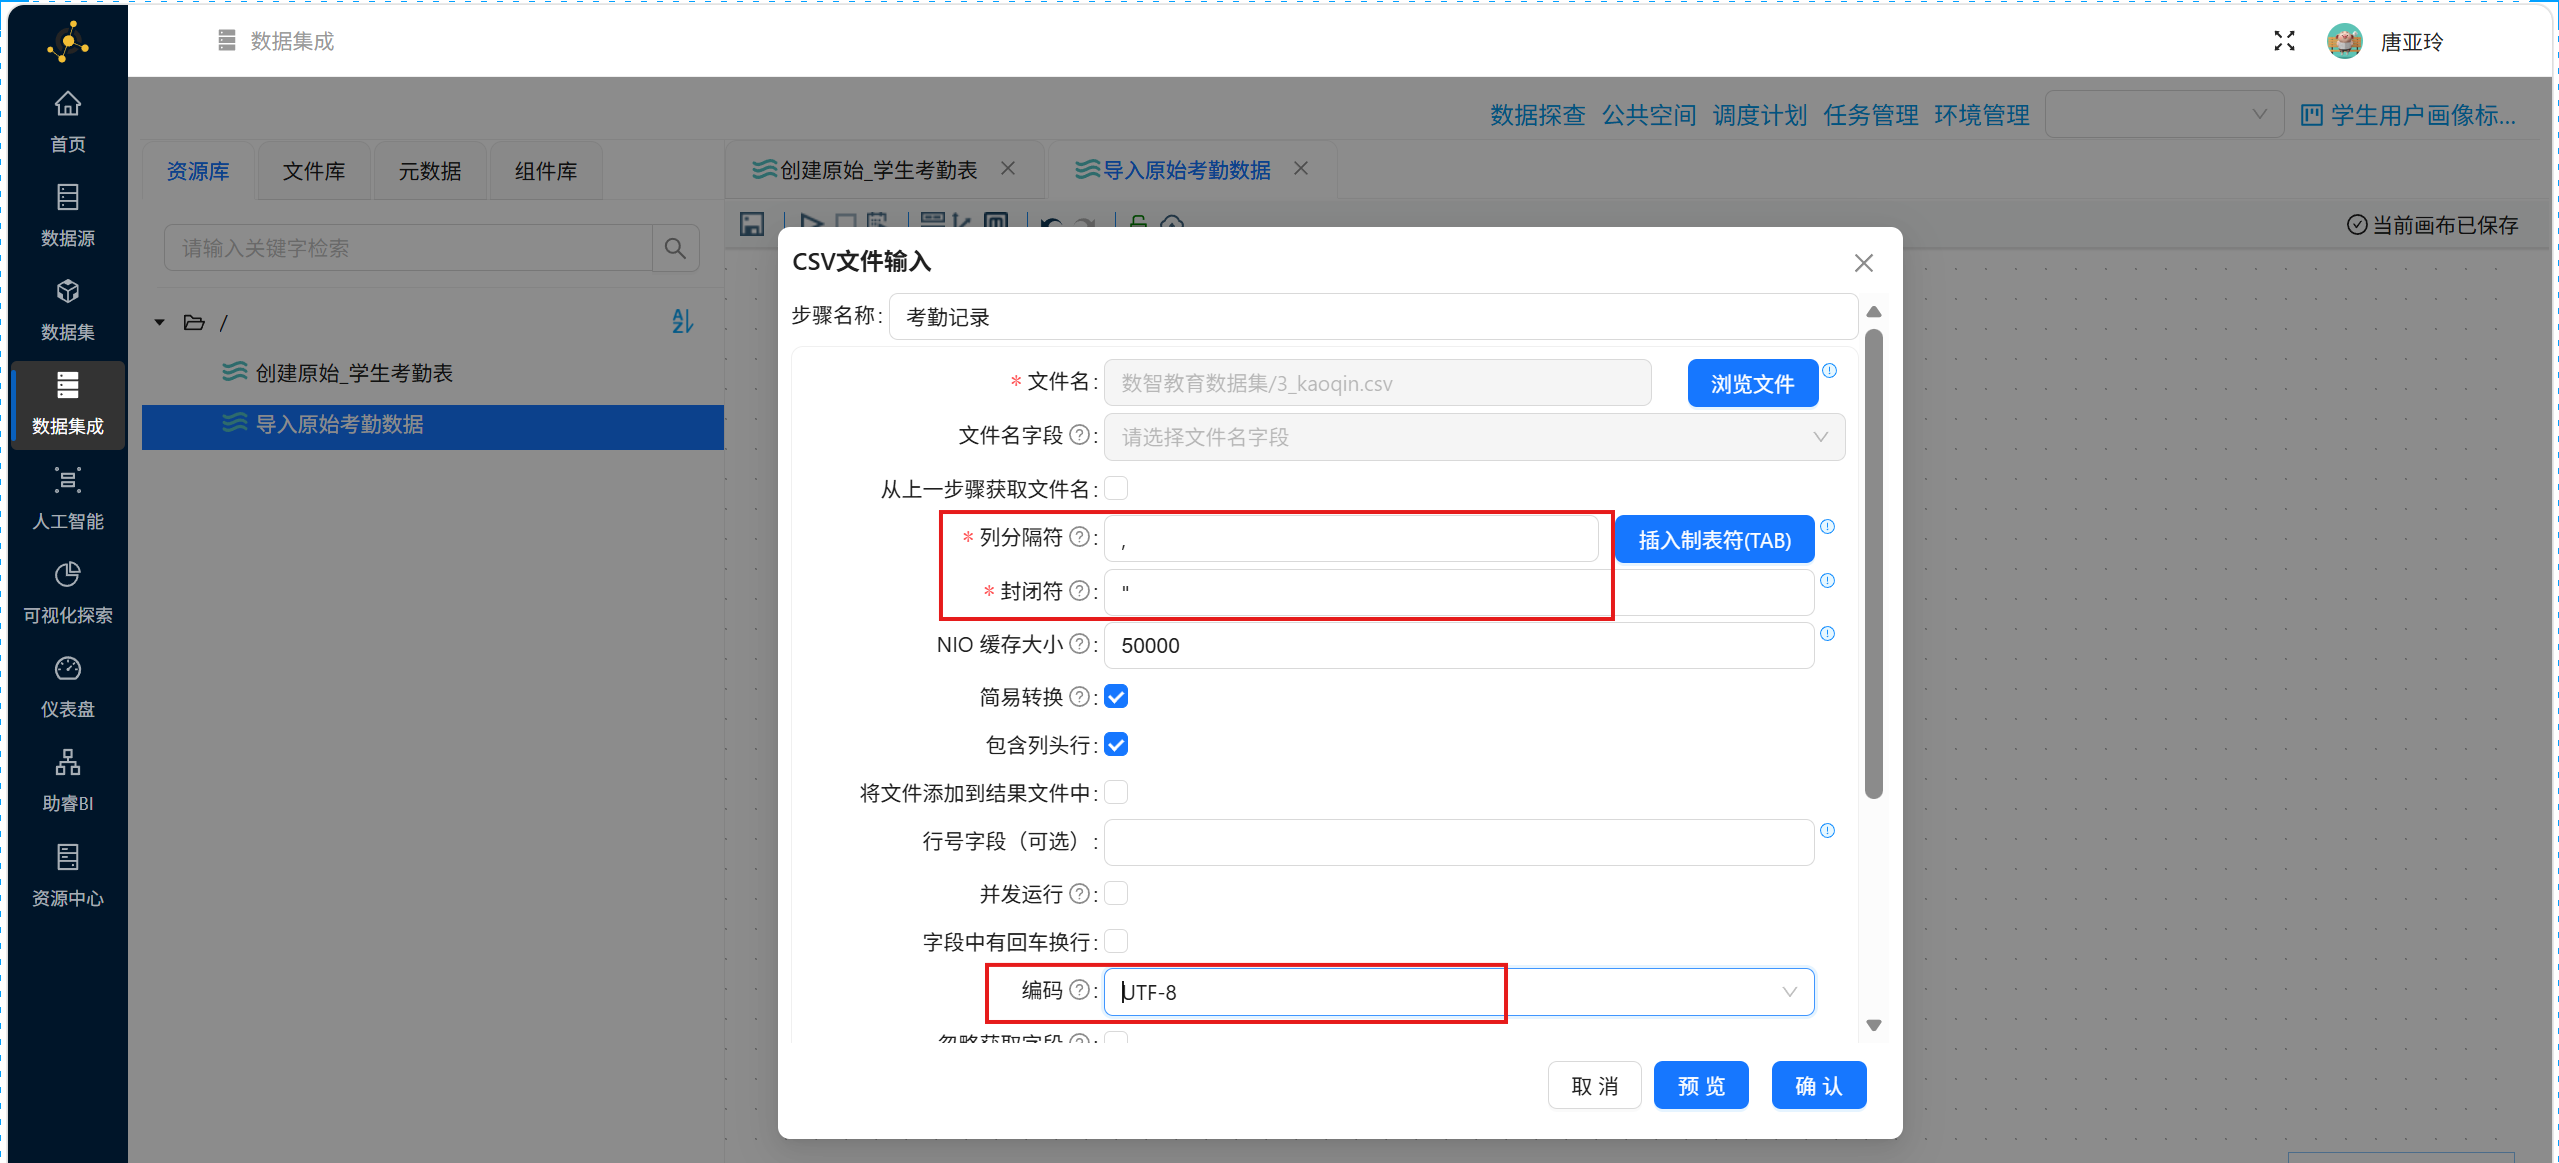
配置信息中 列分隔符 和 封闭符 保持默认参数,编码选择 “UTF-8”
下滑在字段表格的空白处右键点击 “获取字段”,字段获取成功后点击 “确认”
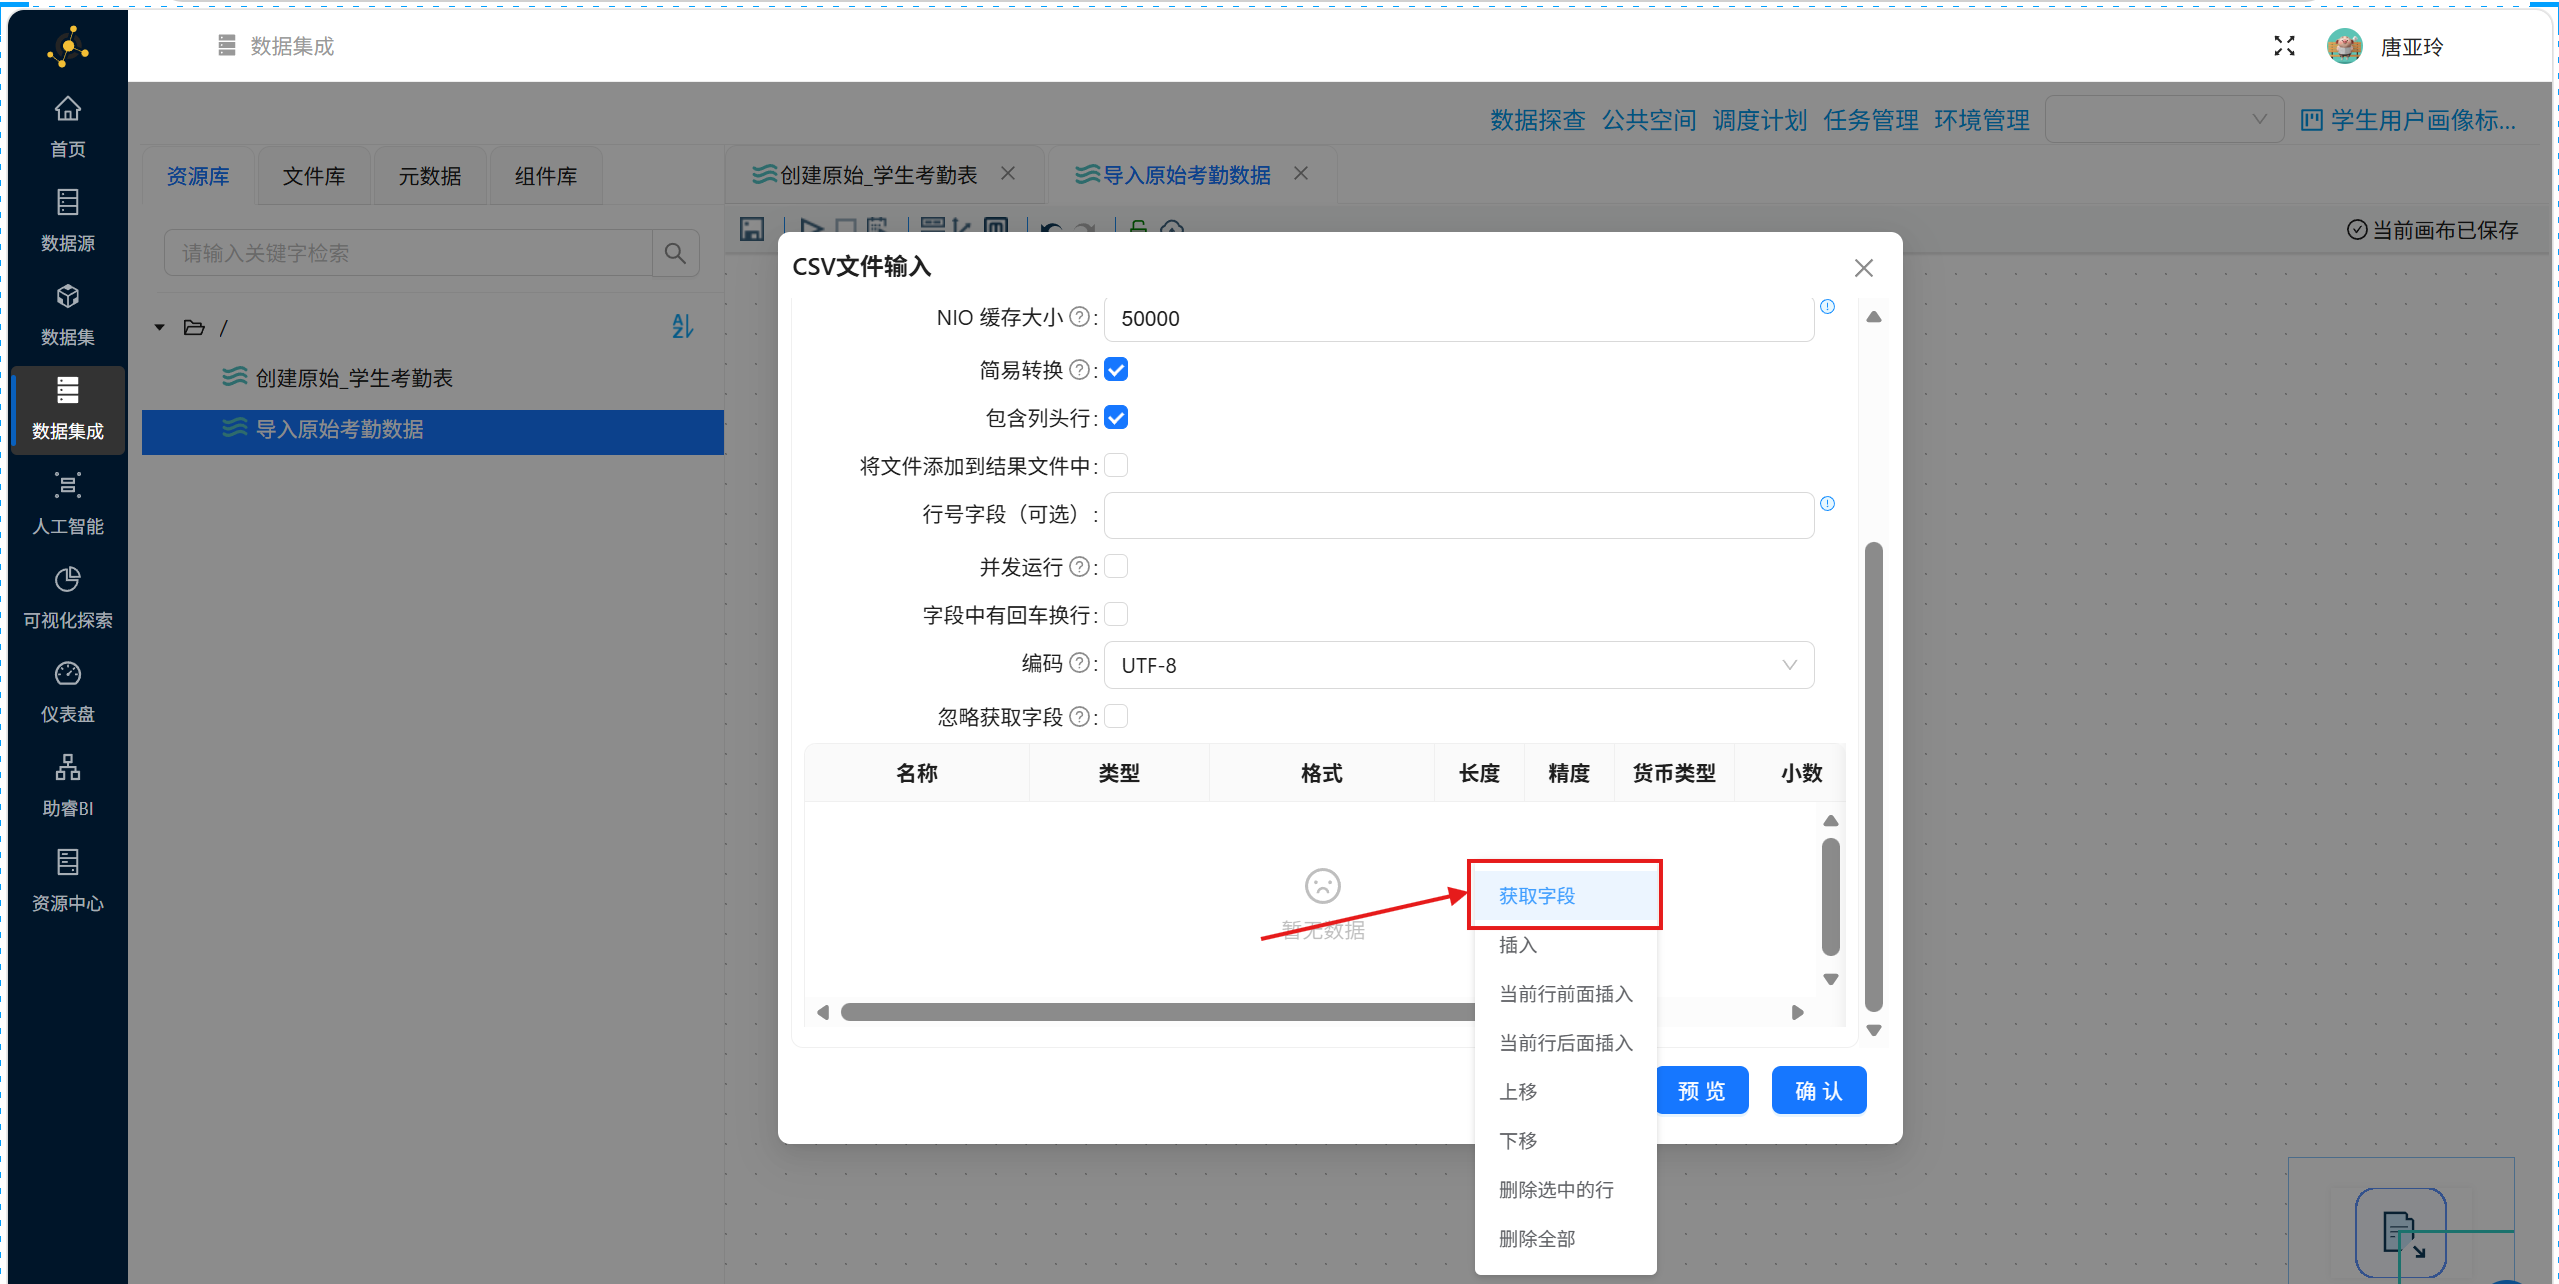
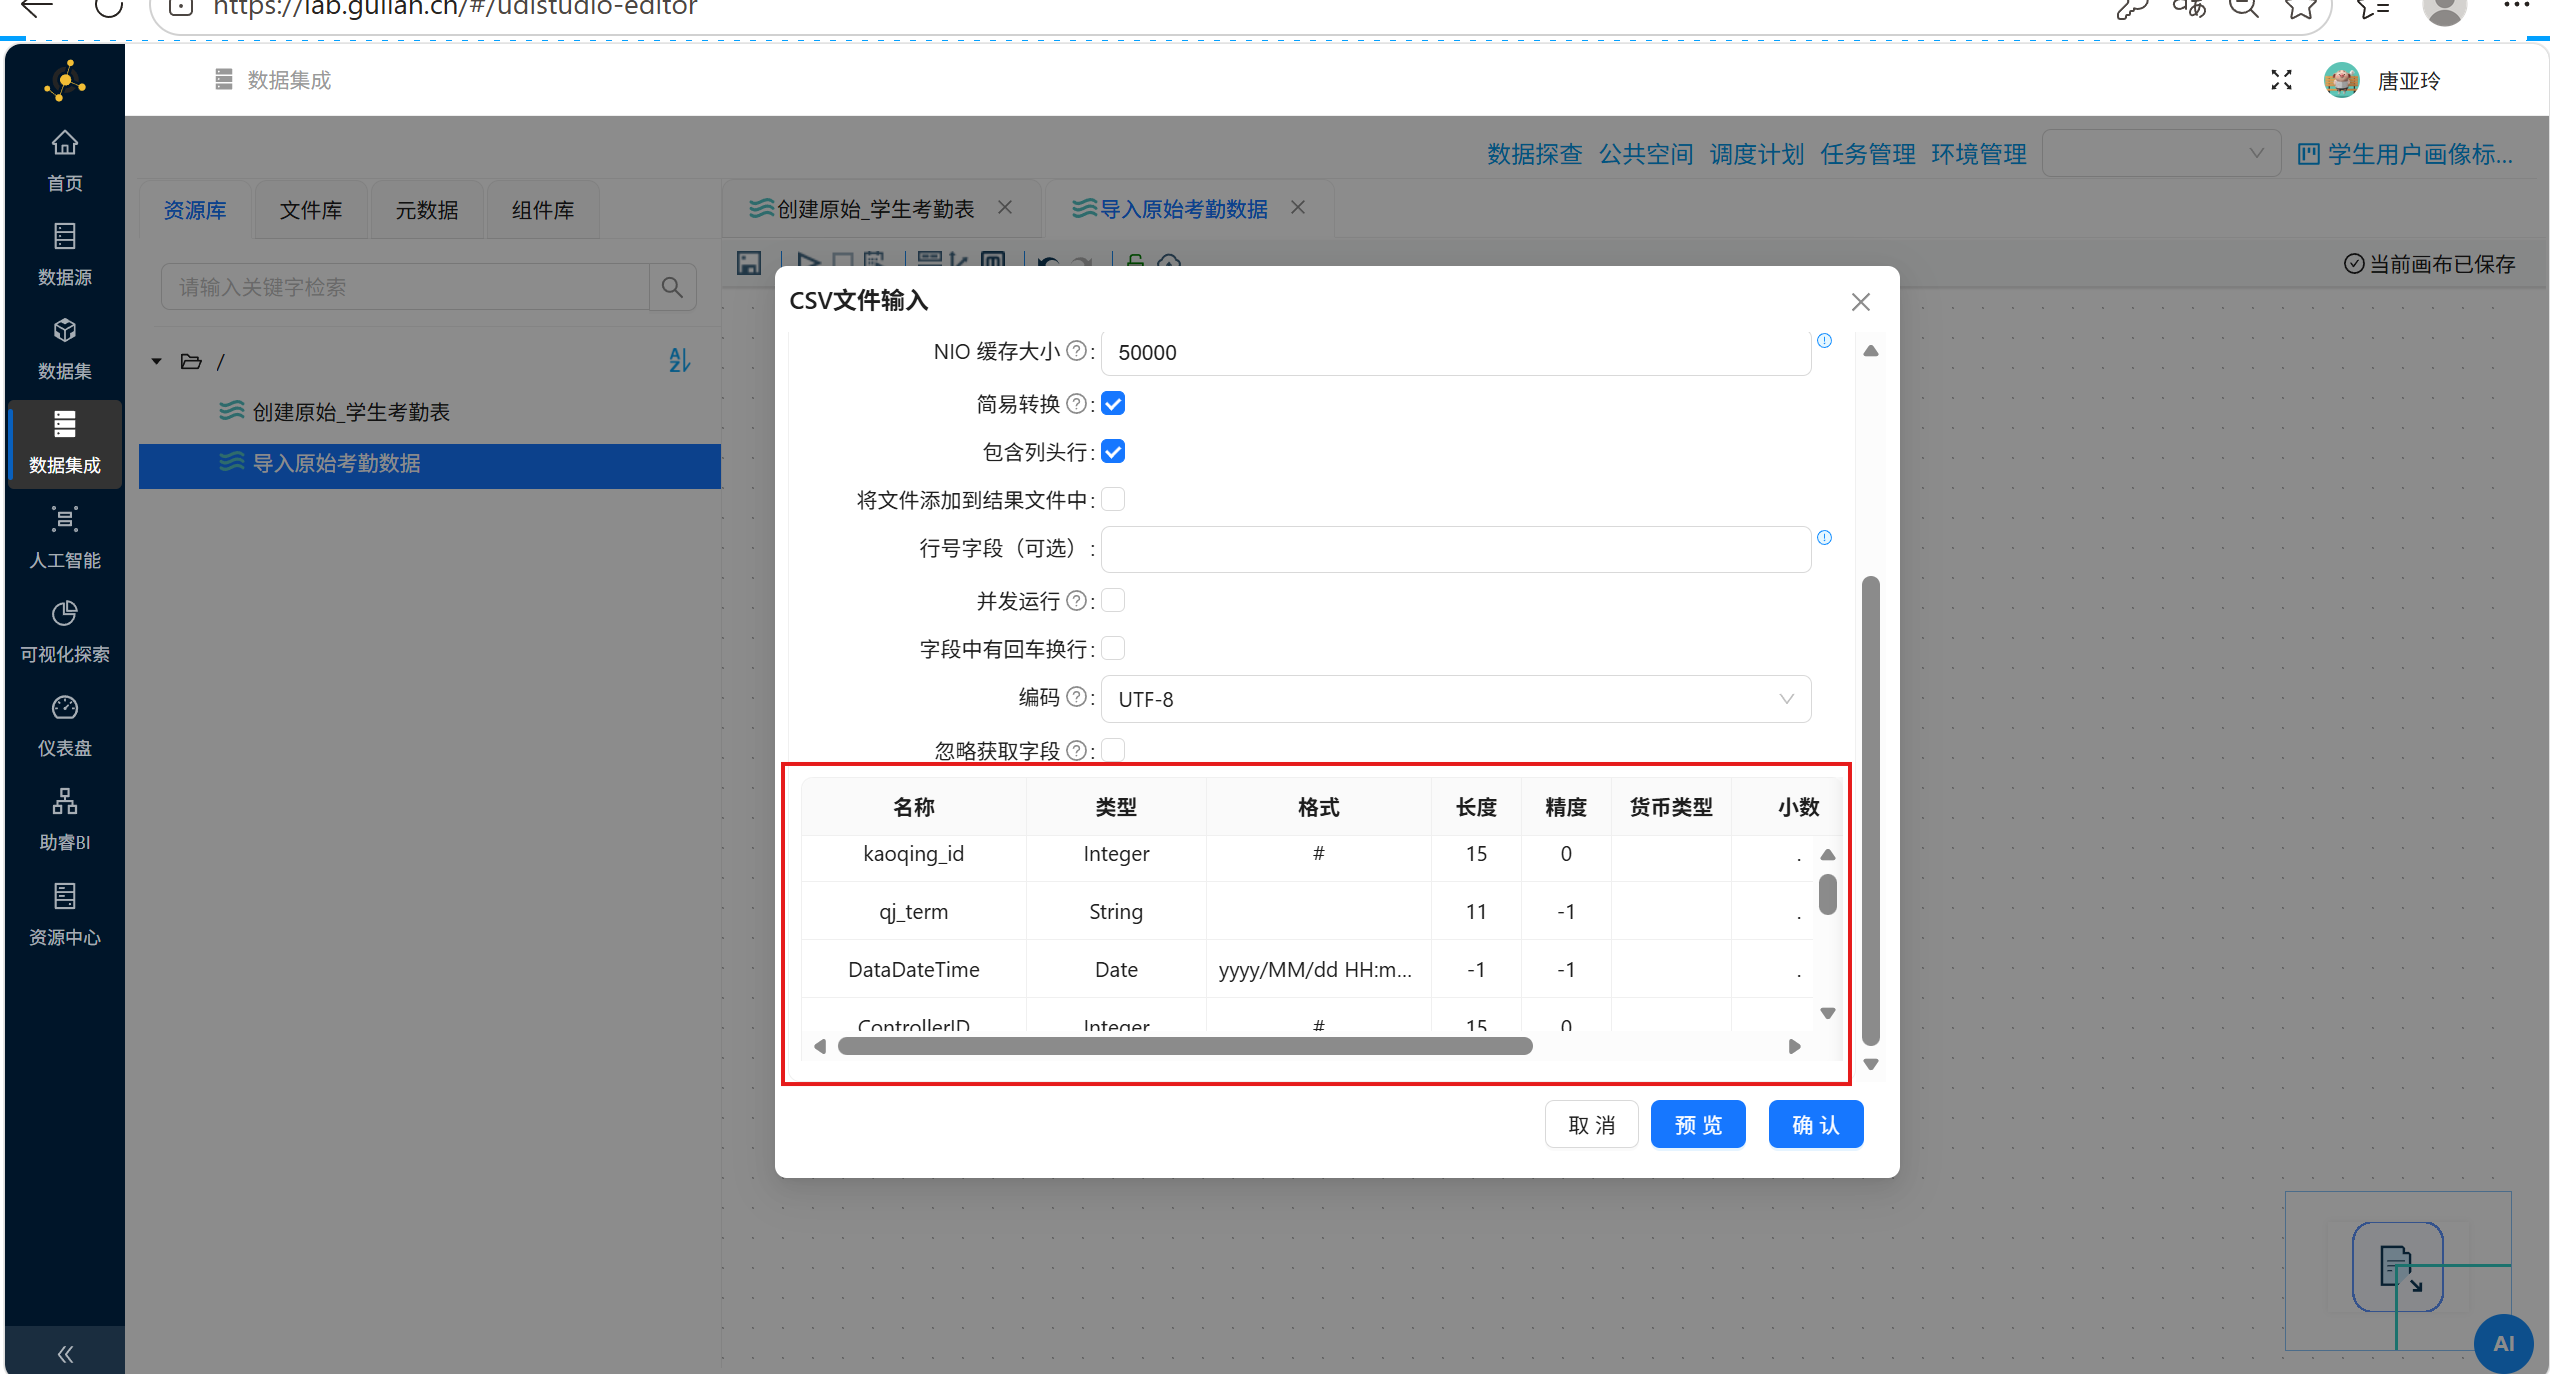
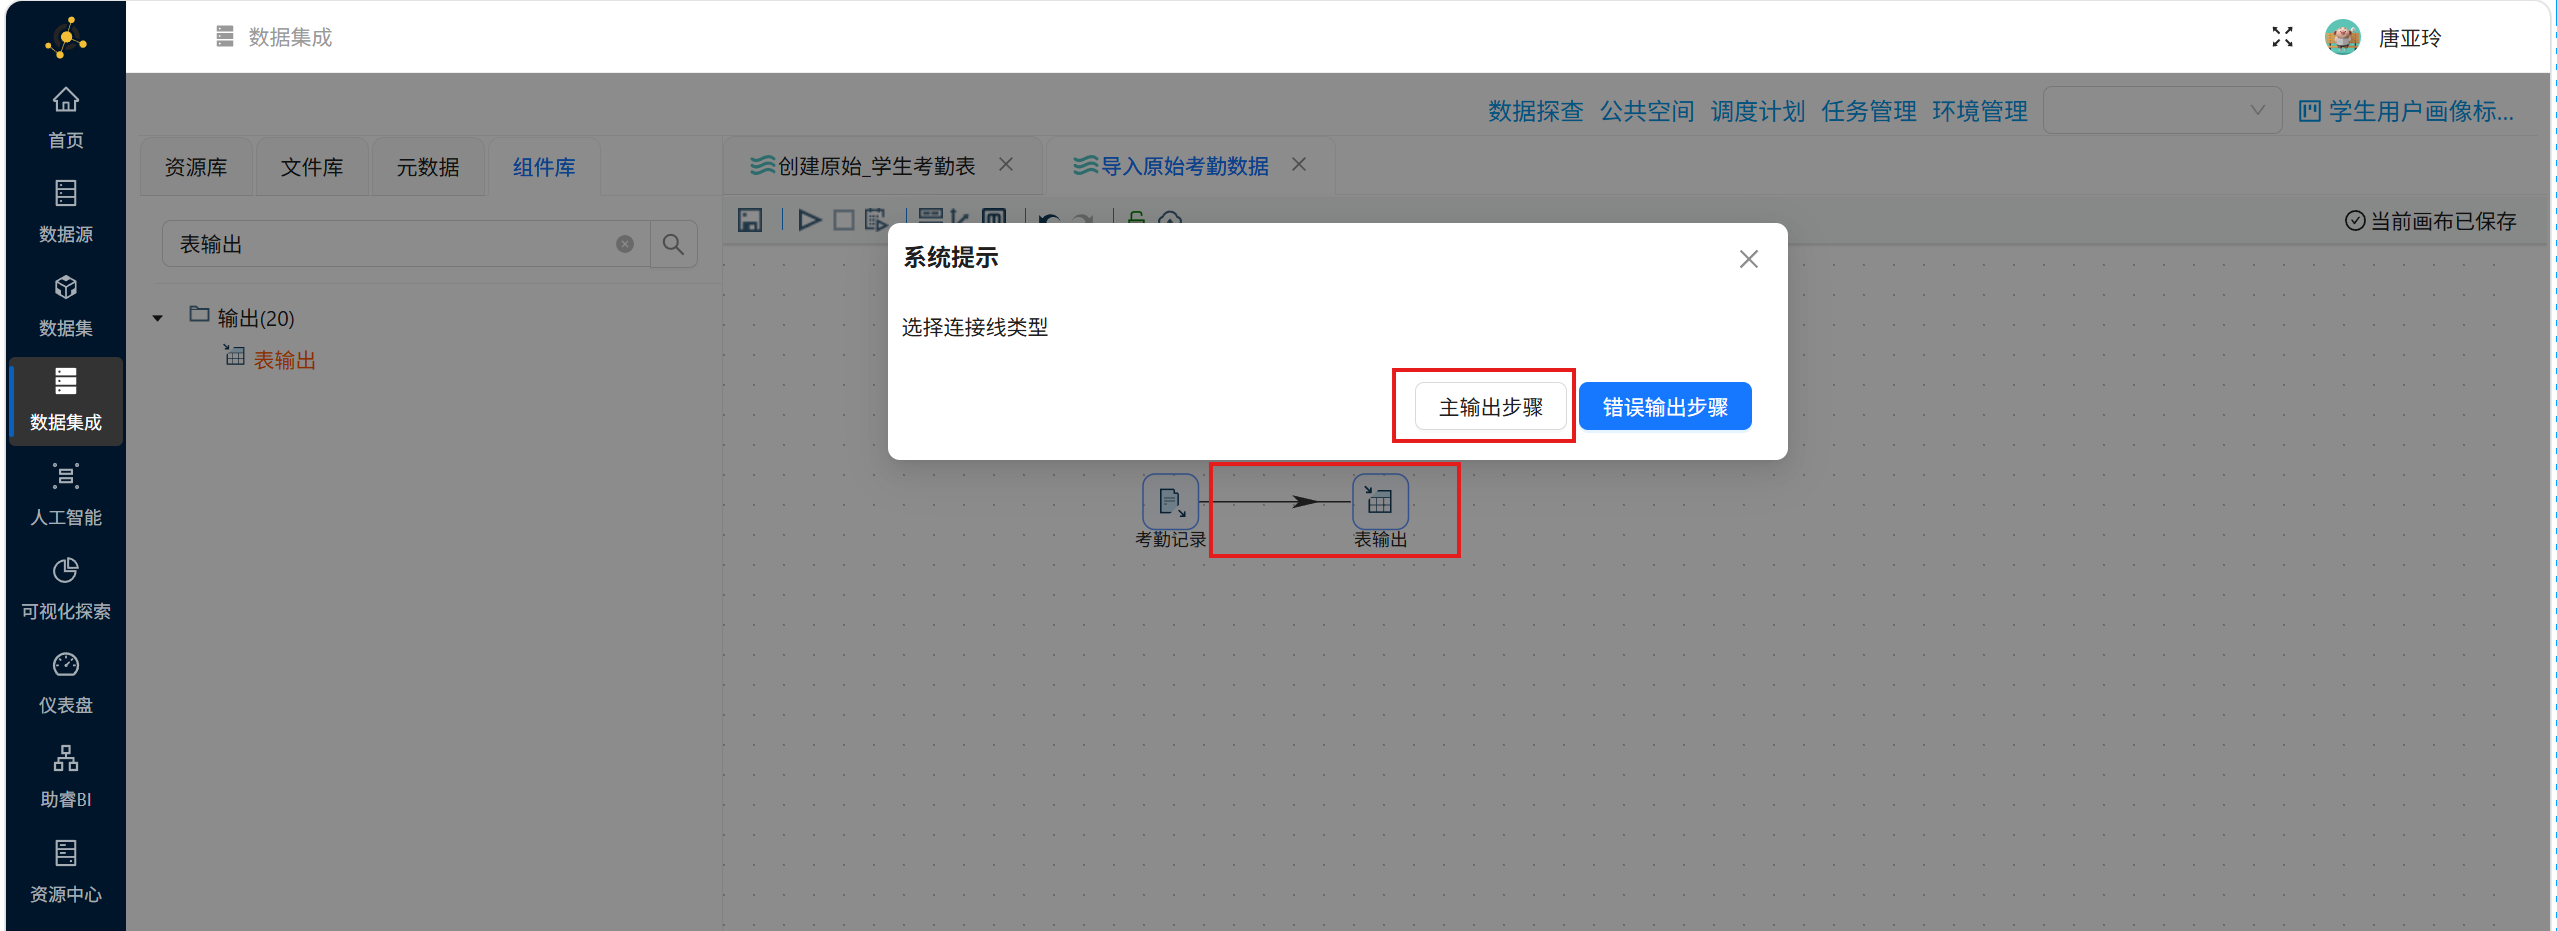
接着,拖拽一个 “表输出” 组件到画布,并创建“考勤记录”CSV文件输入组件到“表输出”组件的连线,连线类型选择 “主输出步骤”
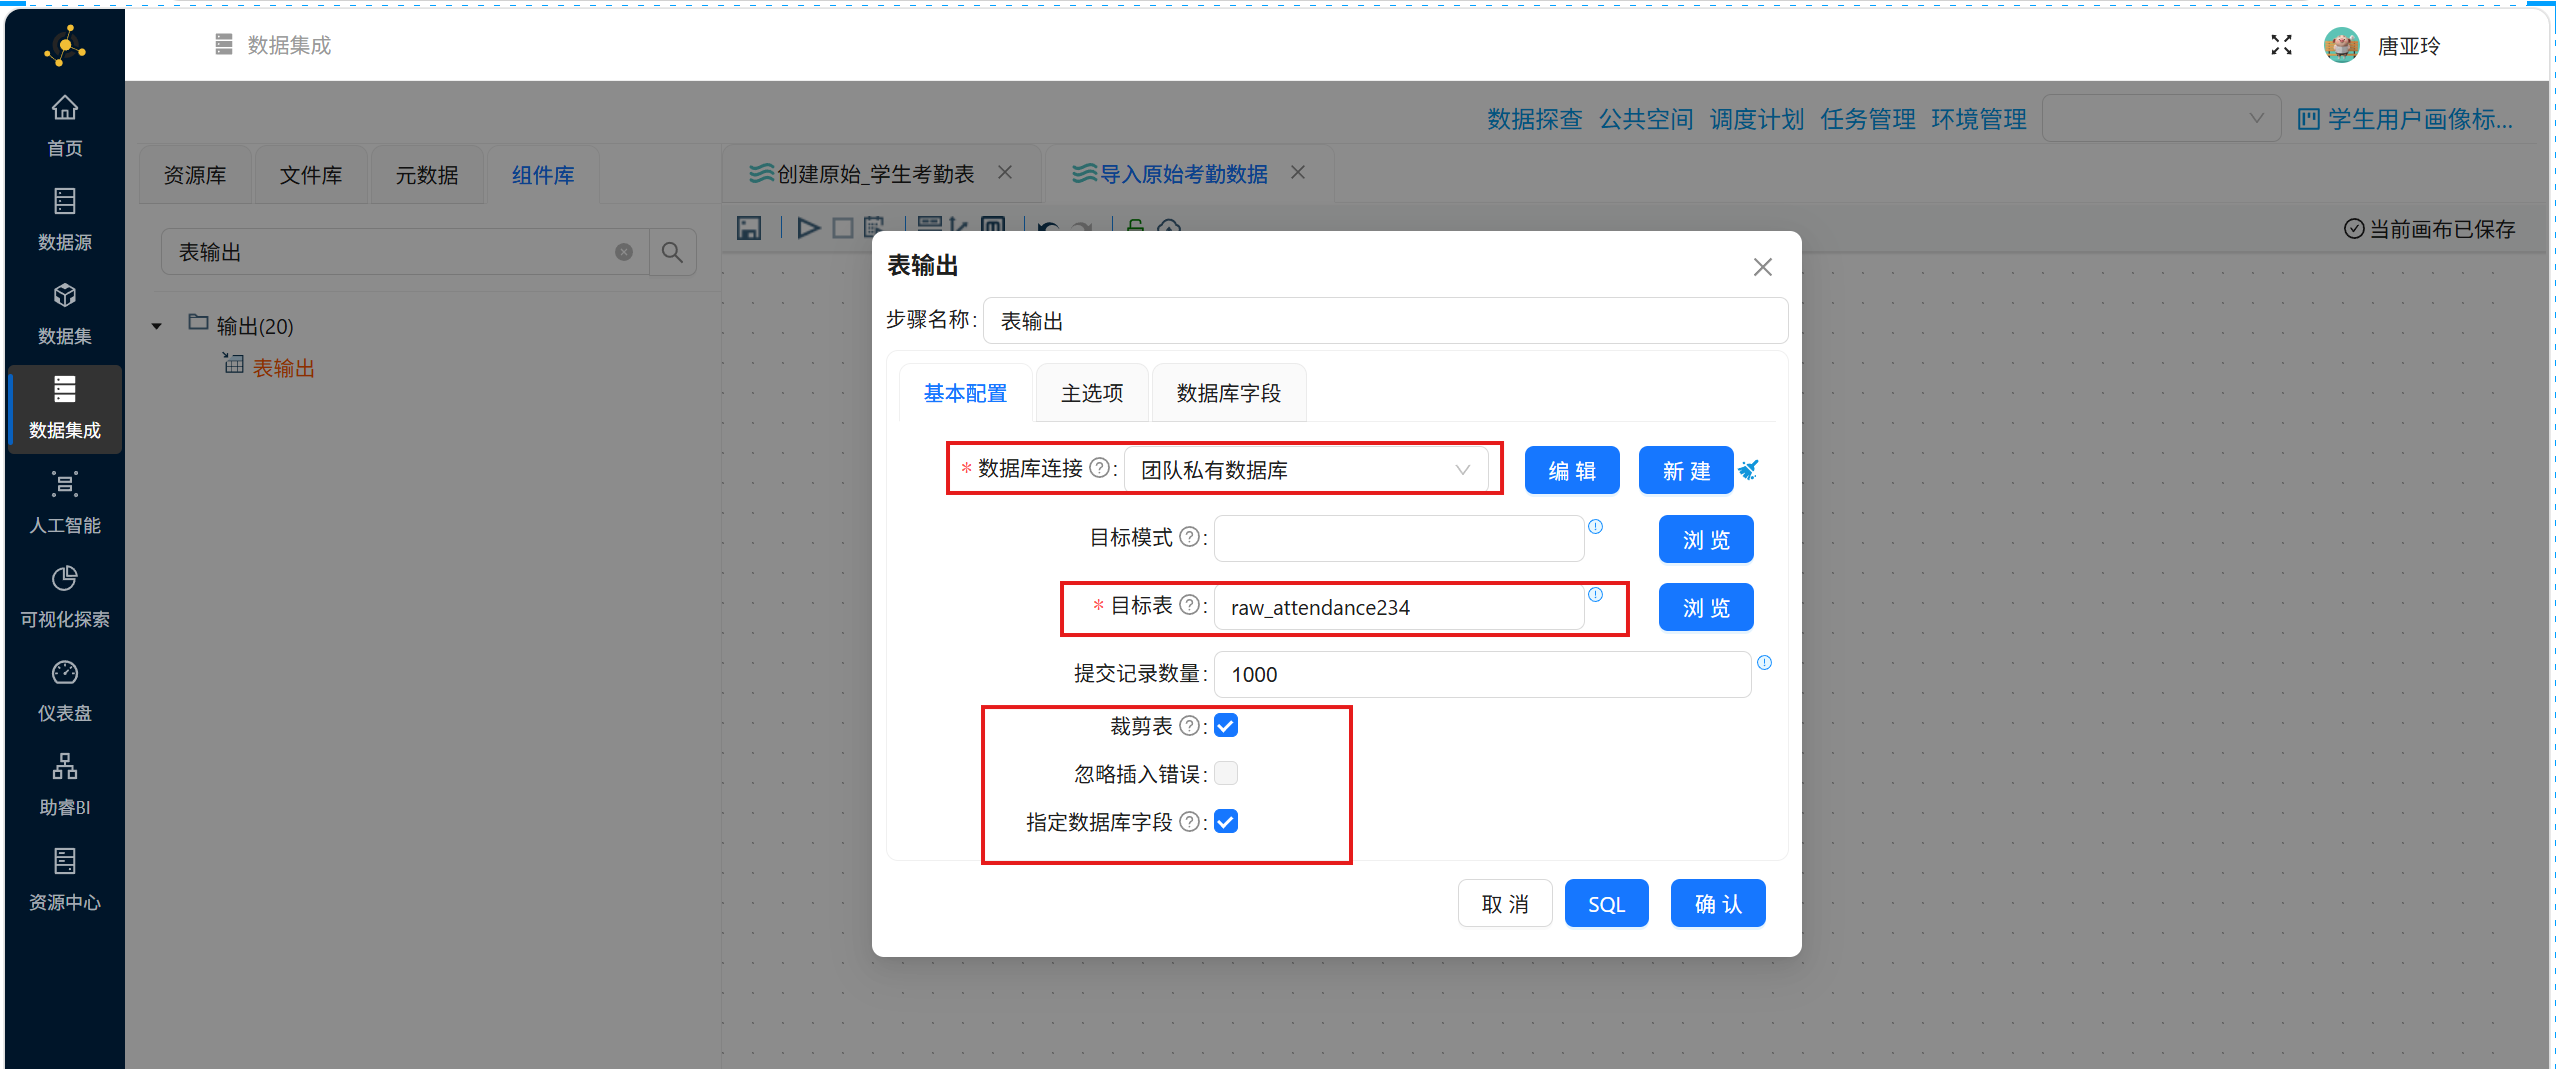
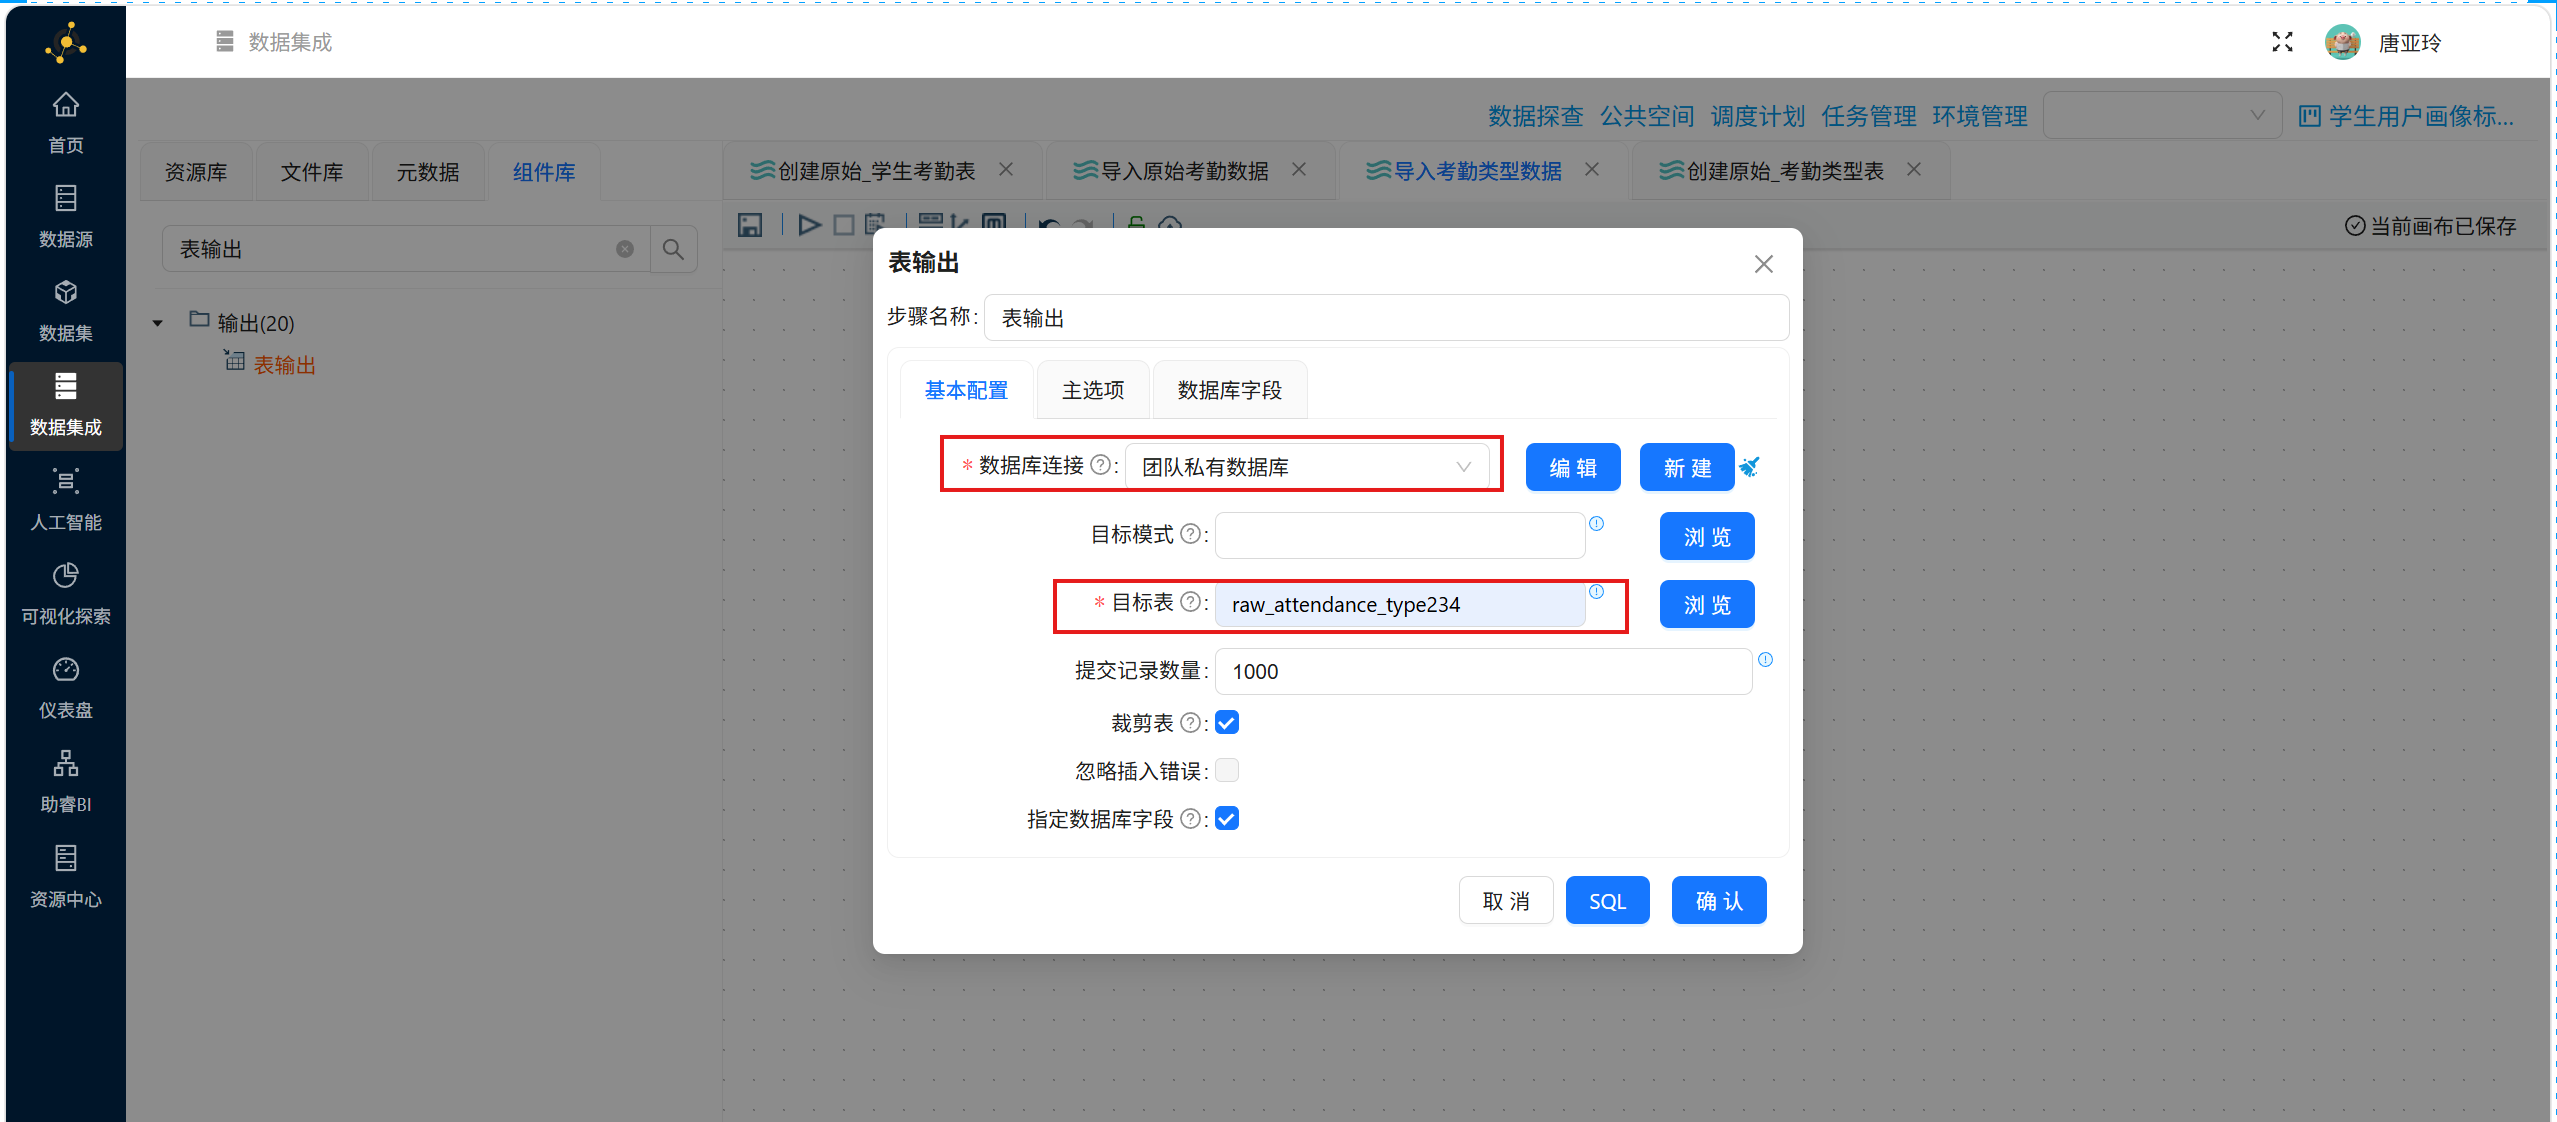
双击配置 “表输出”组件,数据库连接选择 “团队私有数据库”,目标表输入我们使用SQL组件创建的“raw_attendance”,勾选 “裁剪表” 和 “指定数据库字段” ,具体配置如下:
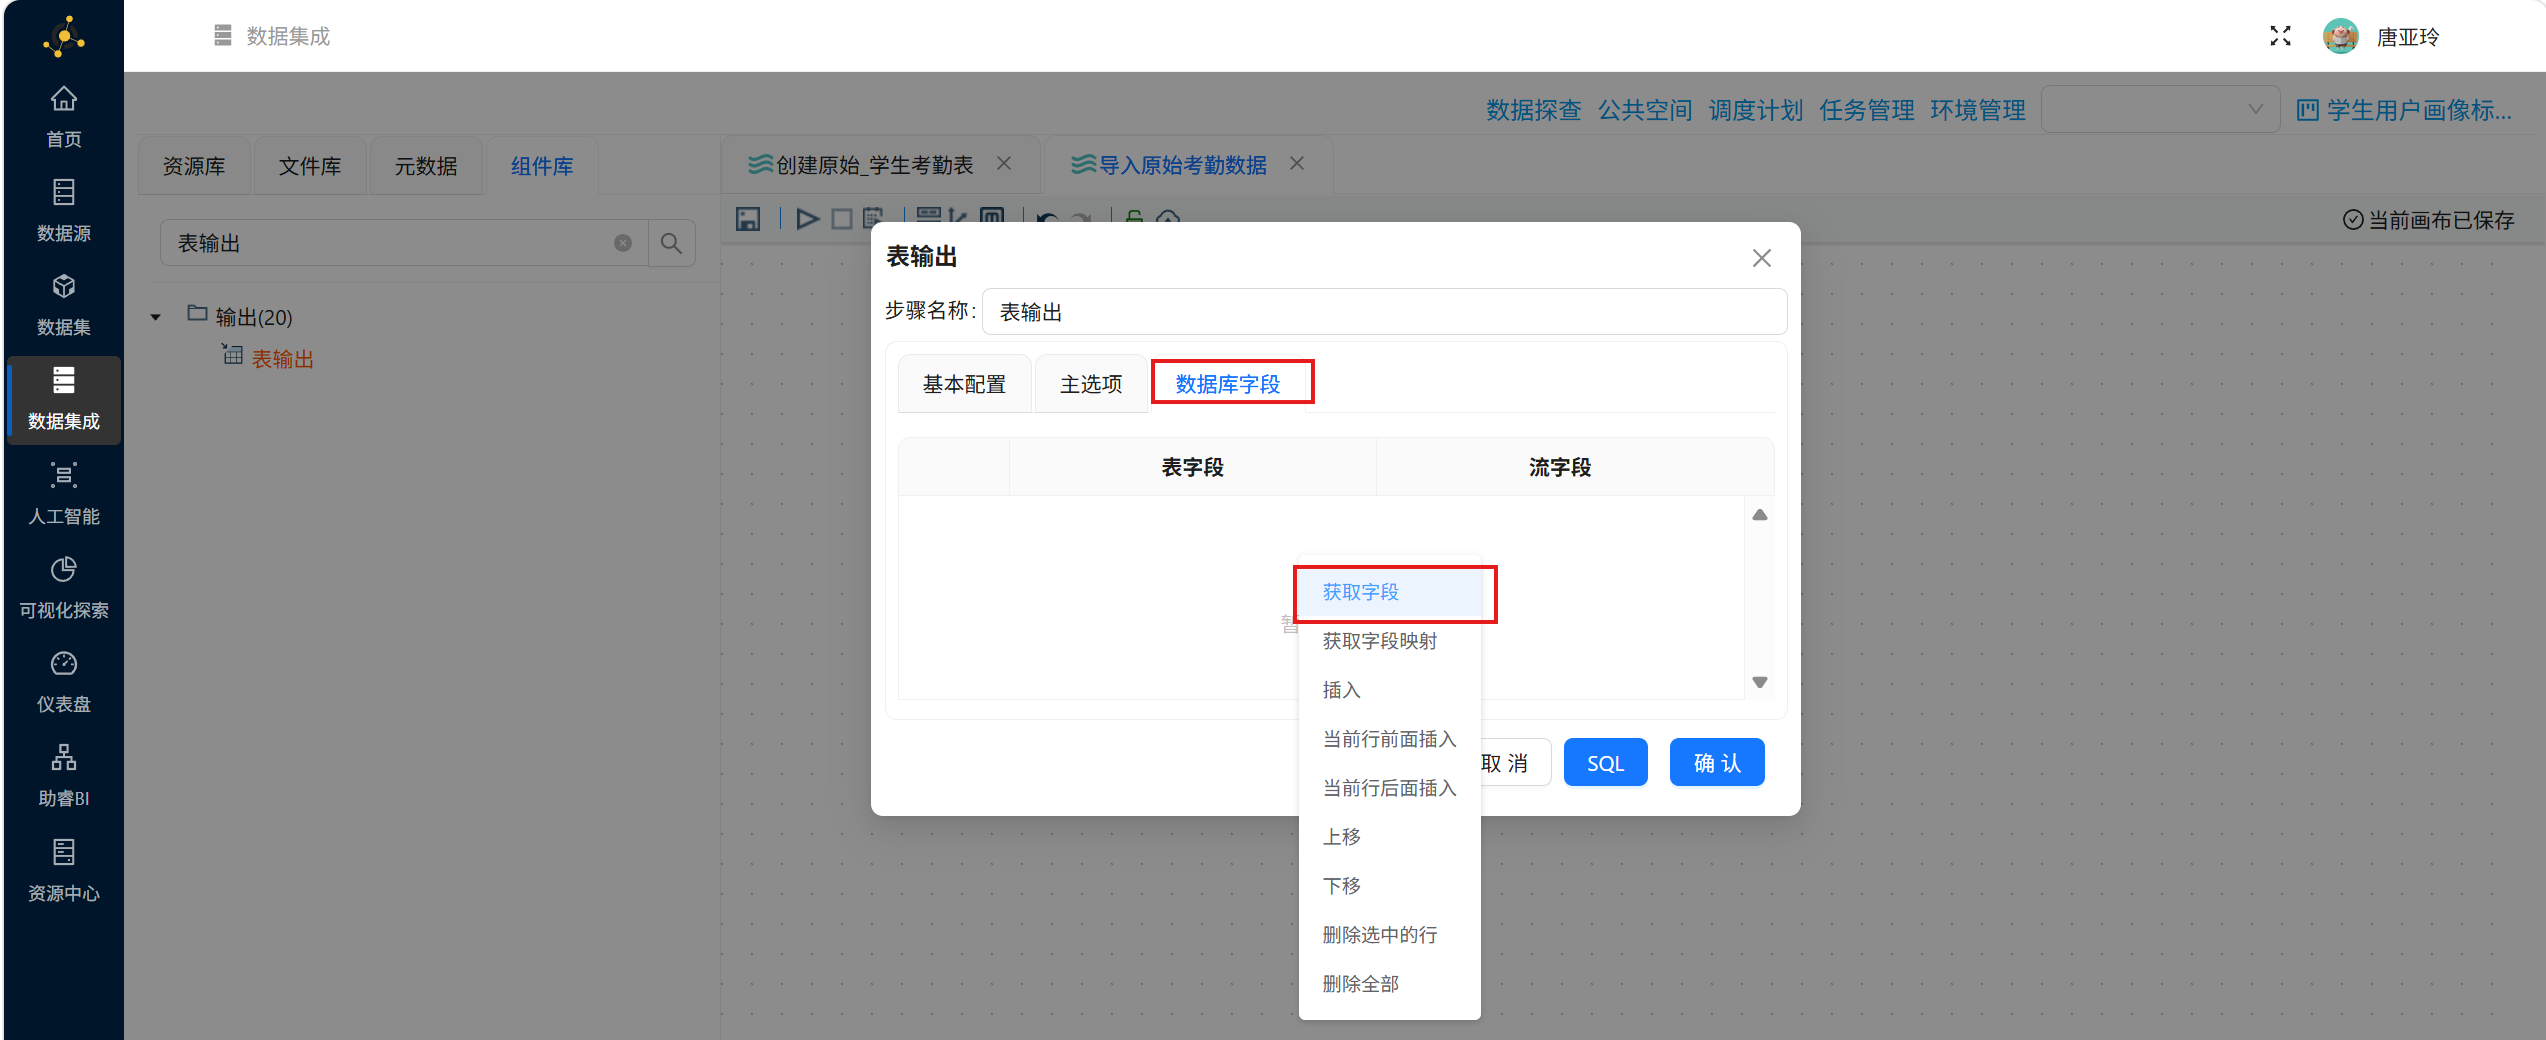
点击 “数据库字段”,在空白处右键 “获取字段”
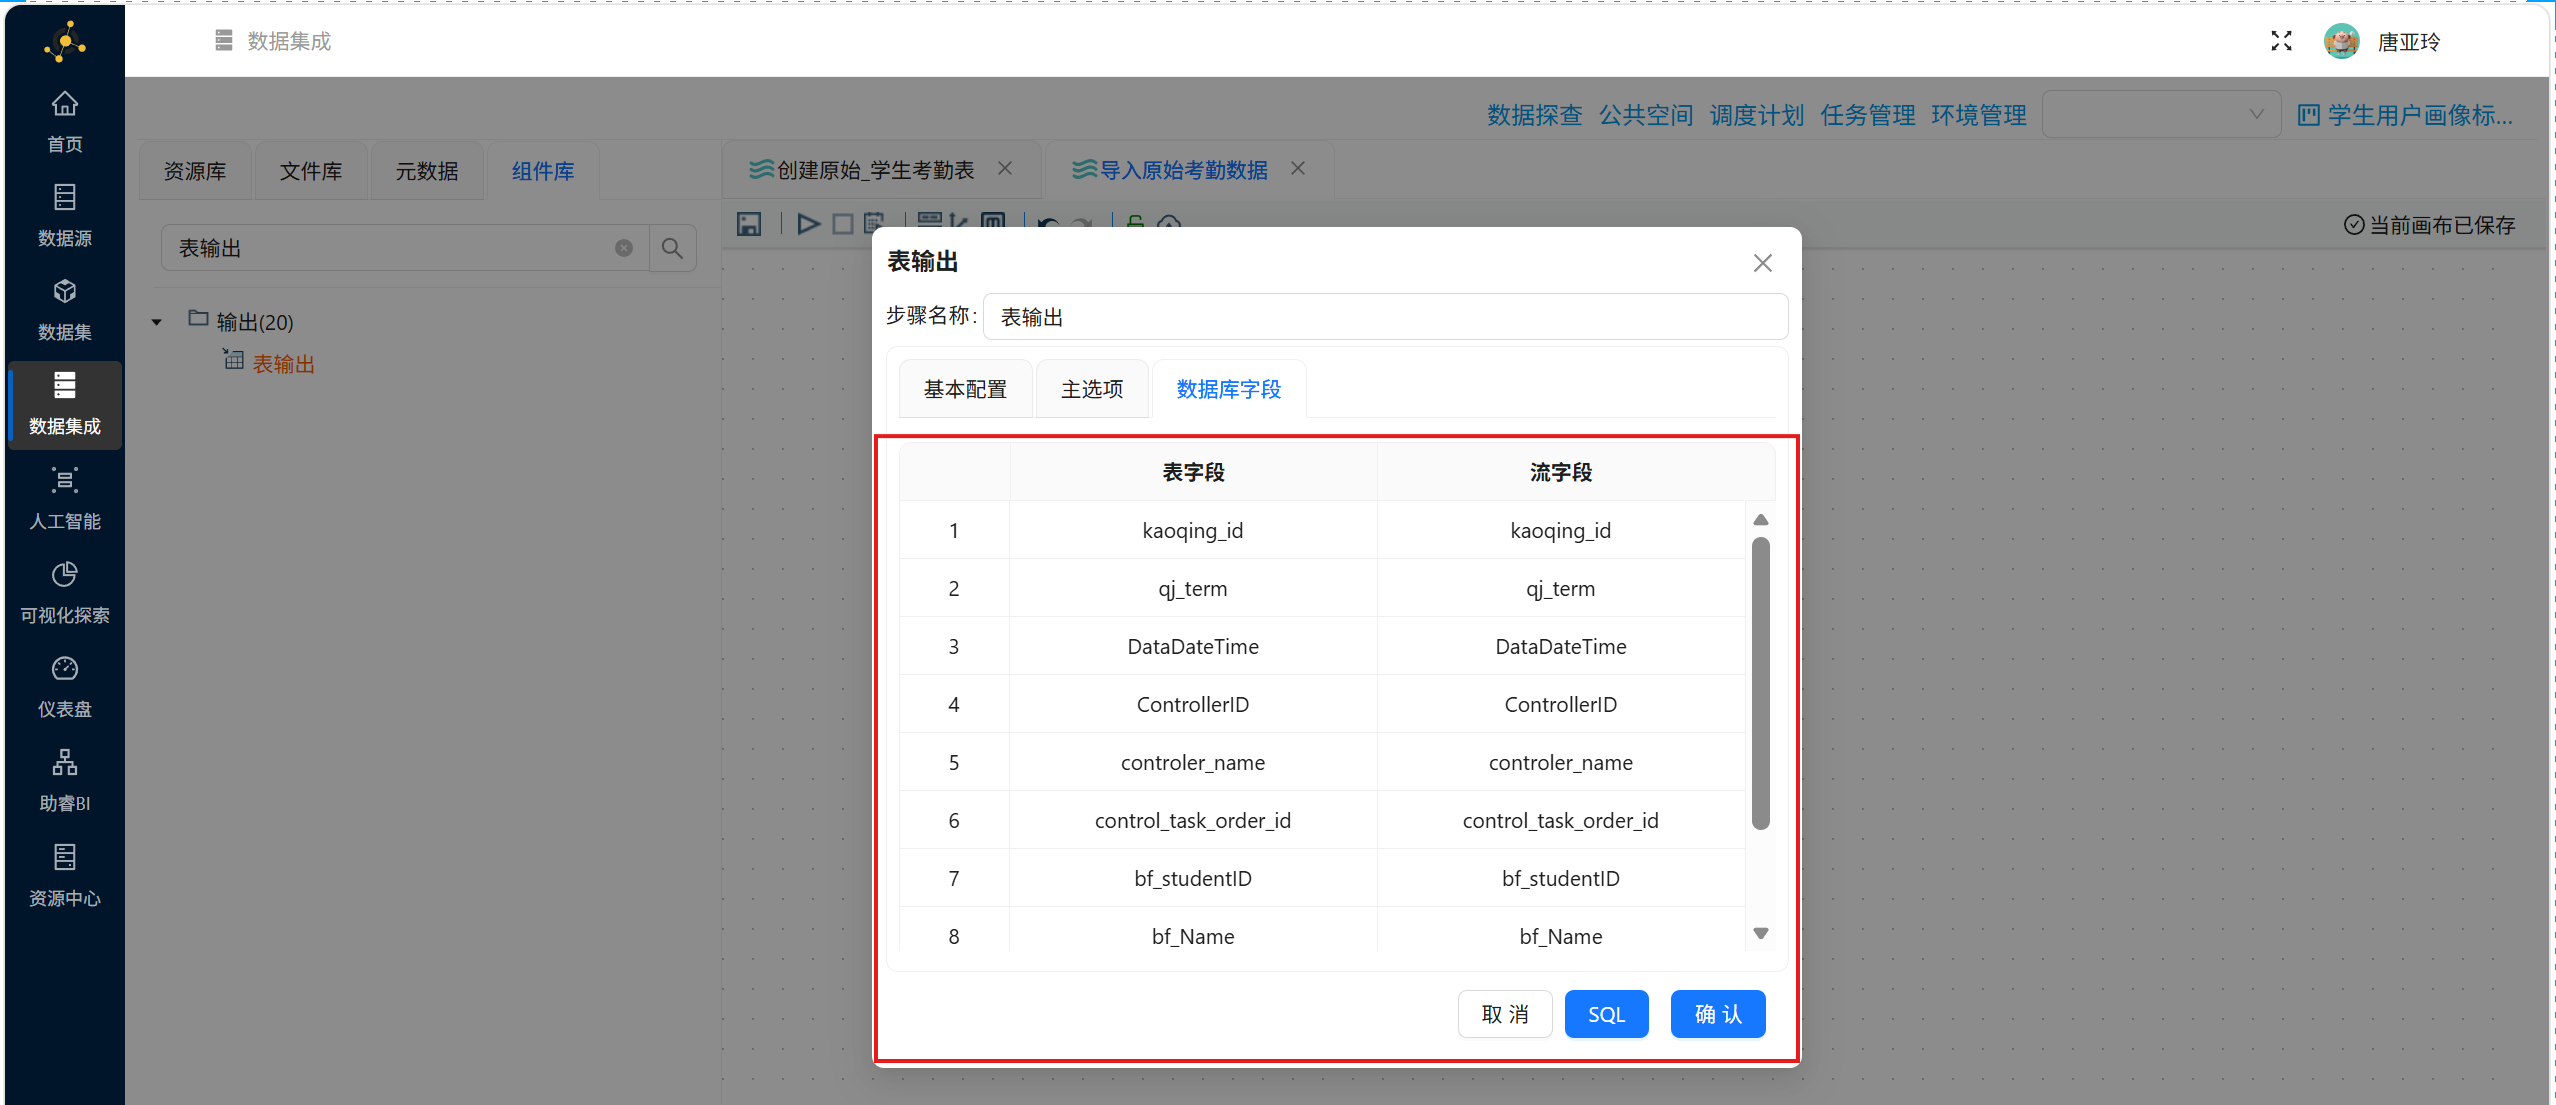
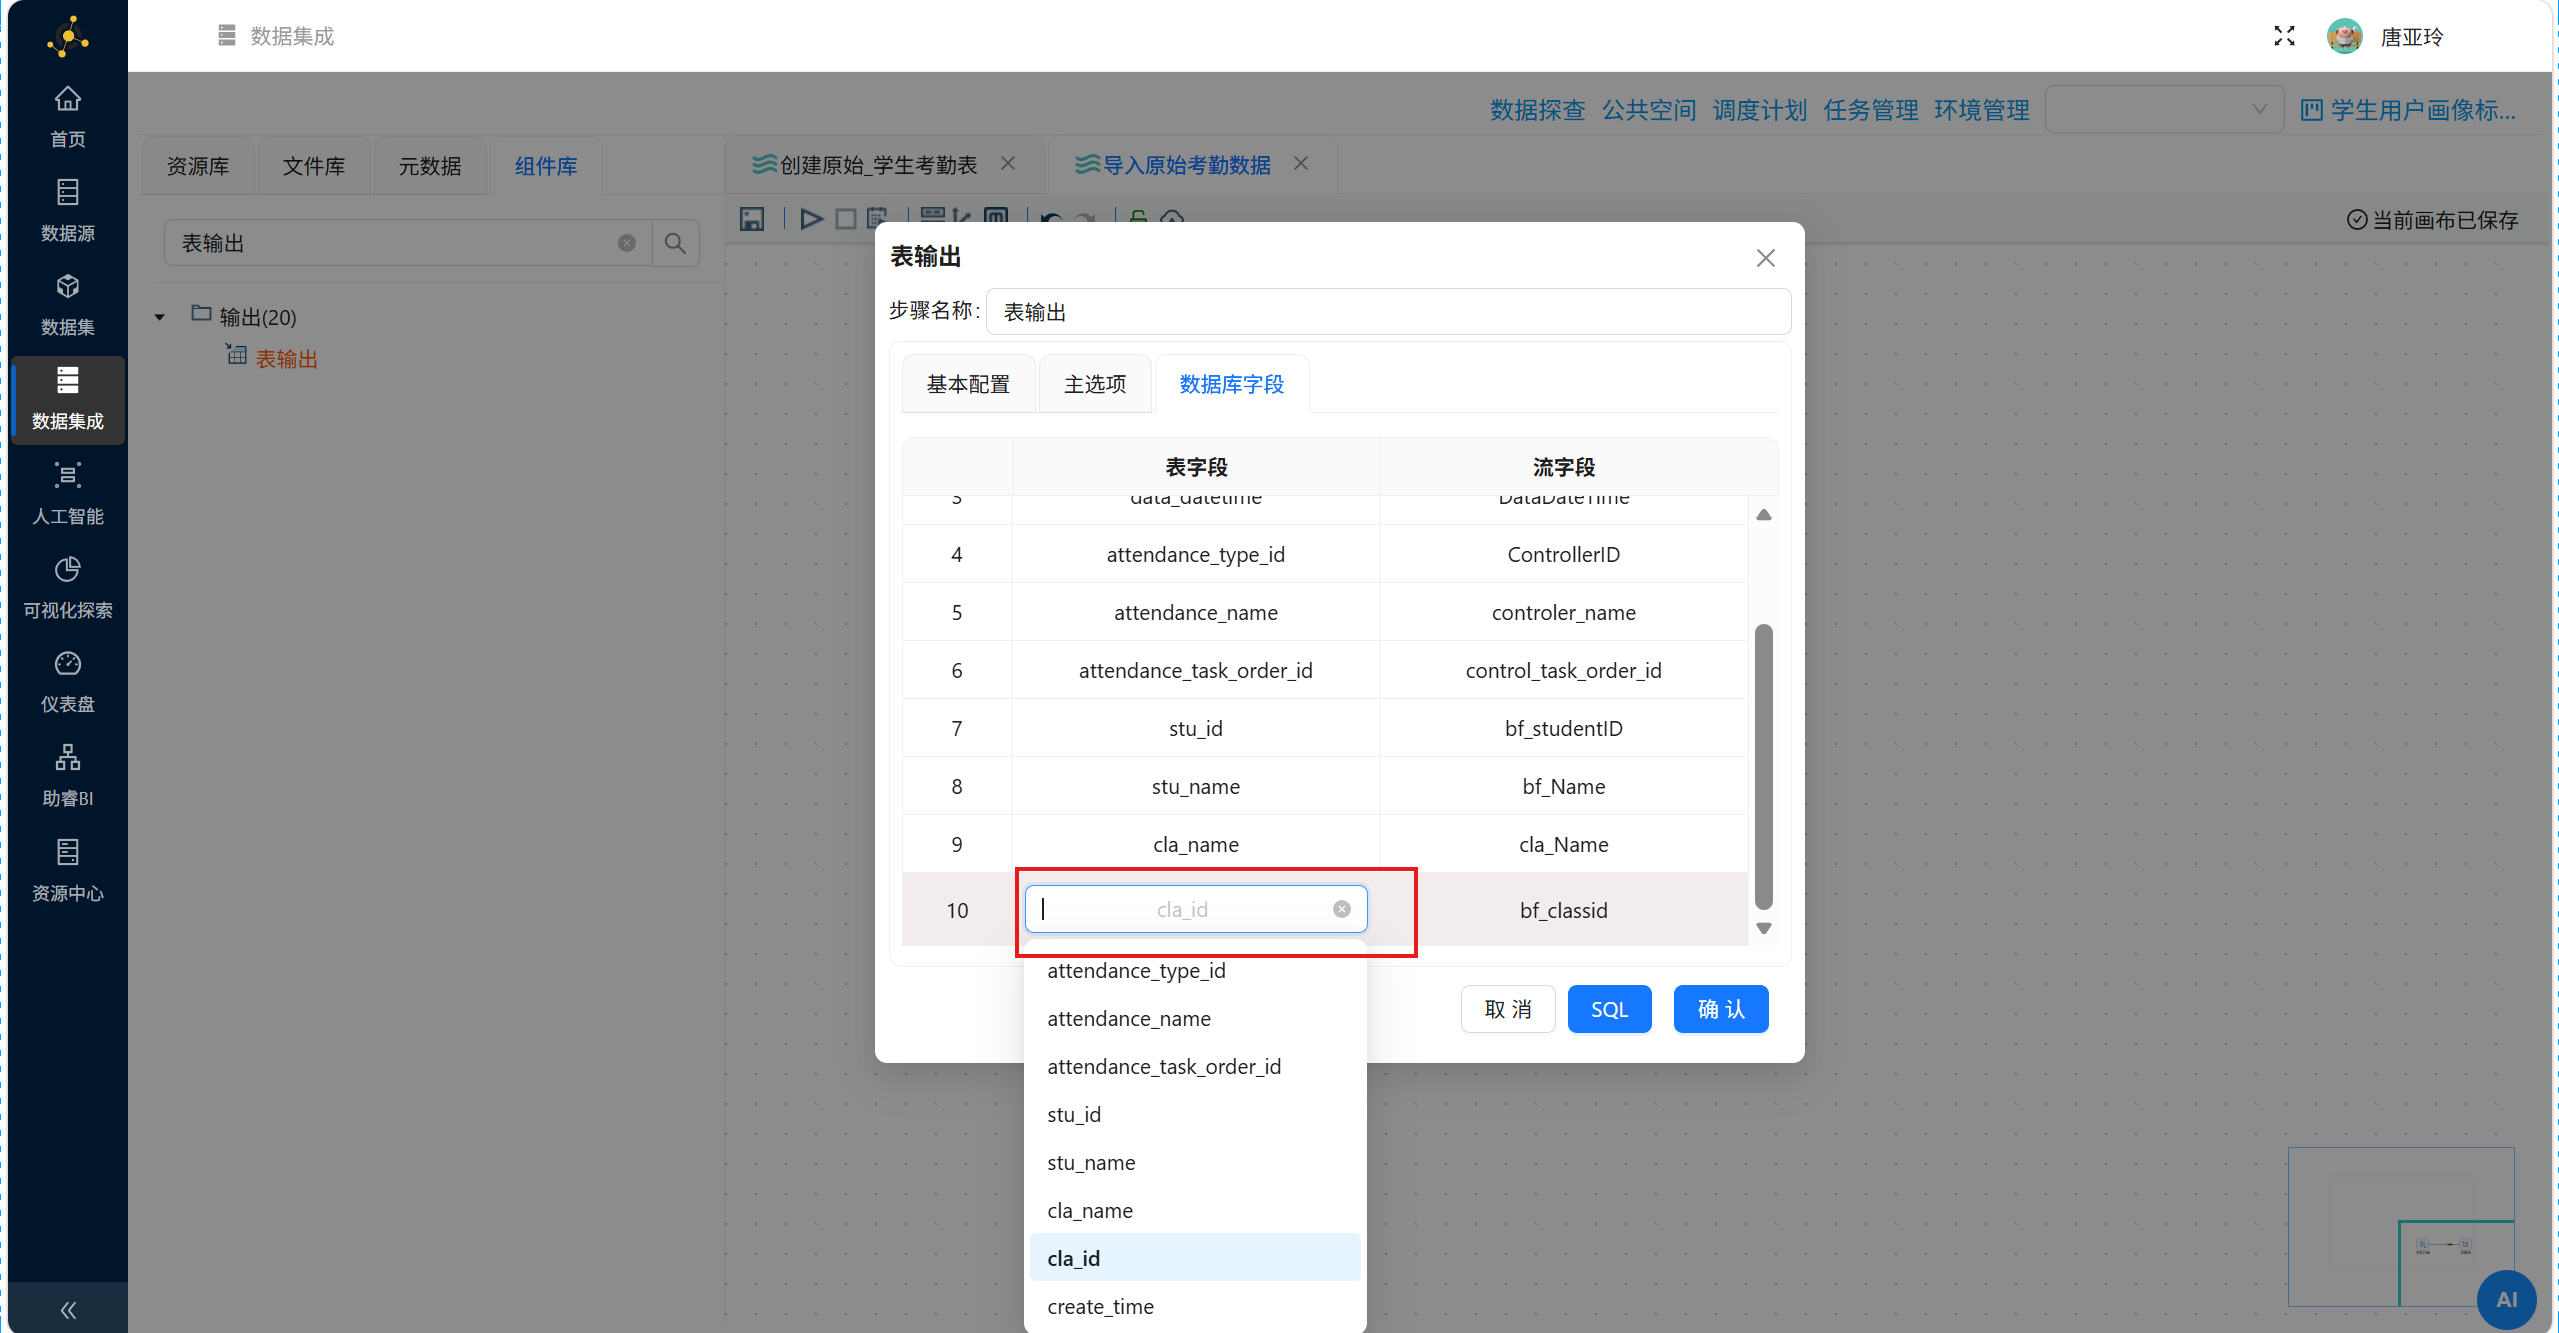
将表字段修改为建表语句中对应的字段,点击“确认”,使数据得到正确处理
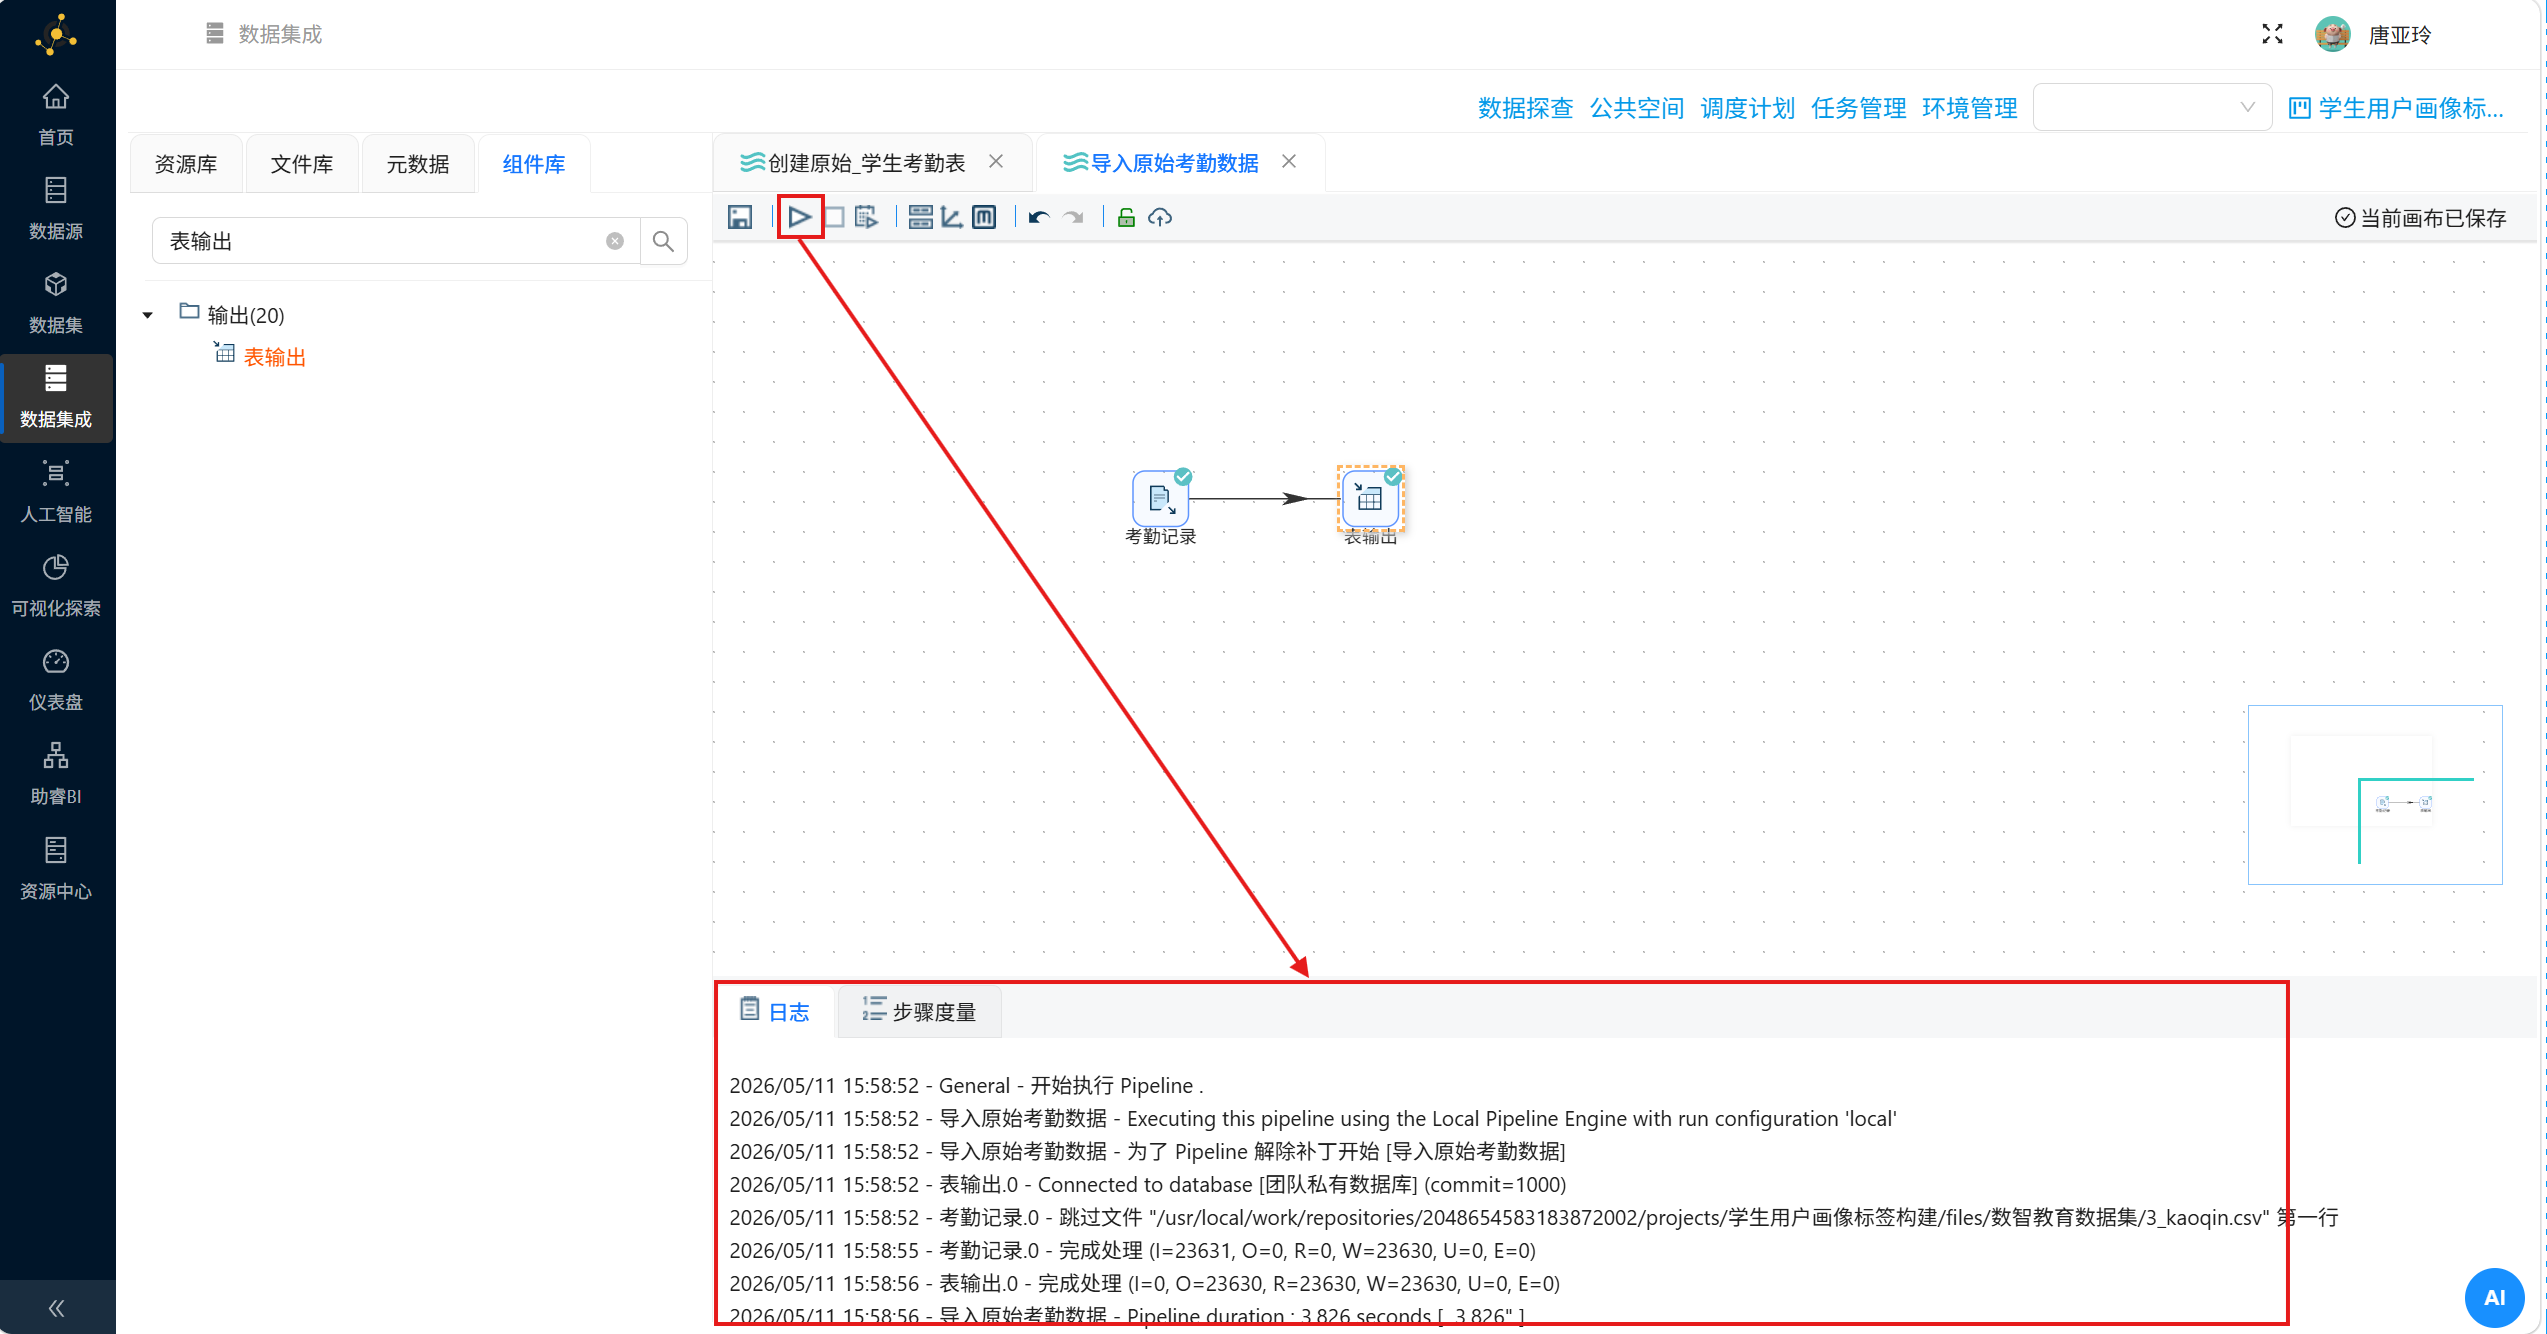
完成后,点击执行转换流,查看组件状态和日志
3.4.2 原始考勤类型表数据导入
这一步,参照 “3.4.1 原始考勤记录表数据导入” 小节实验操作,类似地完成创建 原始_考勤类型表
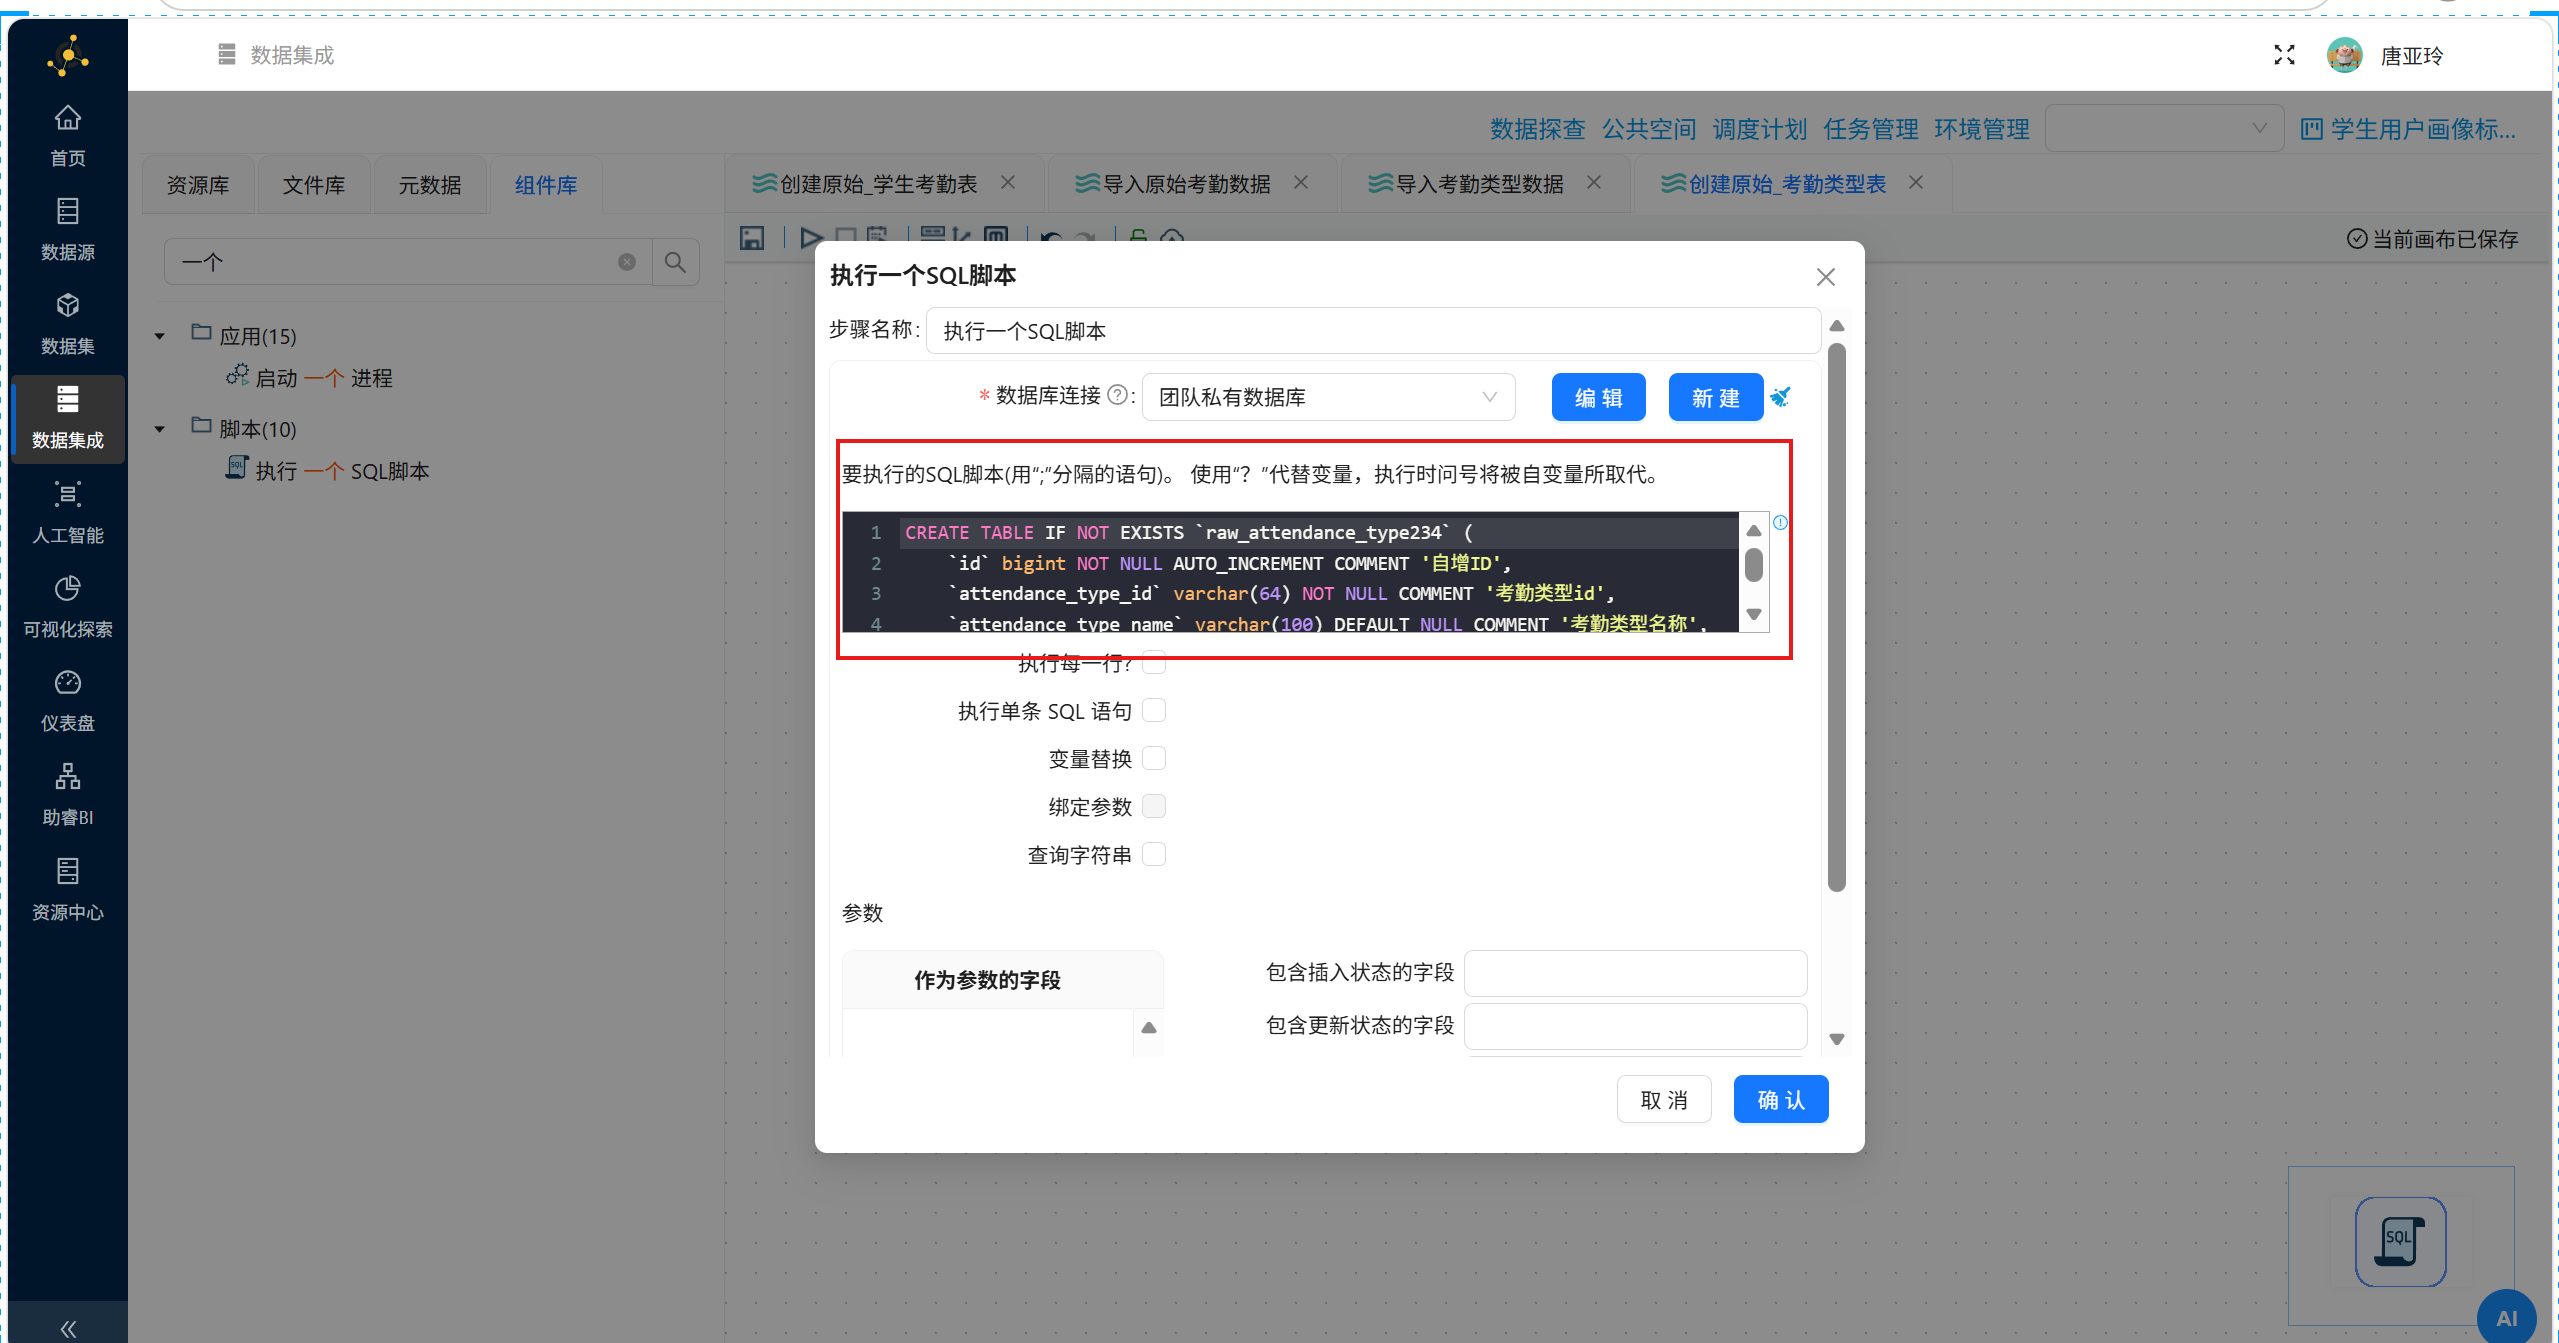
其中的建表SQL为:
CREATE TABLE IF NOT EXISTS `raw_attendance_type` (
  `id` bigint NOT NULL AUTO_INCREMENT COMMENT '自增ID',
  `attendance_type_id` varchar(64) NOT NULL COMMENT '考勤类型id',
  `attendance_type_name` varchar(100) DEFAULT NULL COMMENT '考勤类型名称',
  `attendance_task_order_id` varchar(64) DEFAULT NULL COMMENT '考勤事件id',
  `attendance_task_name` varchar(100) DEFAULT NULL COMMENT '考勤事件名',
  `create_time` datetime DEFAULT CURRENT_TIMESTAMP COMMENT '入库时间',
  PRIMARY KEY (`id`),
  UNIQUE KEY `uk_attendance_type_id` (`attendance_task_order_id`)
)COMMENT='原始_考勤类型表';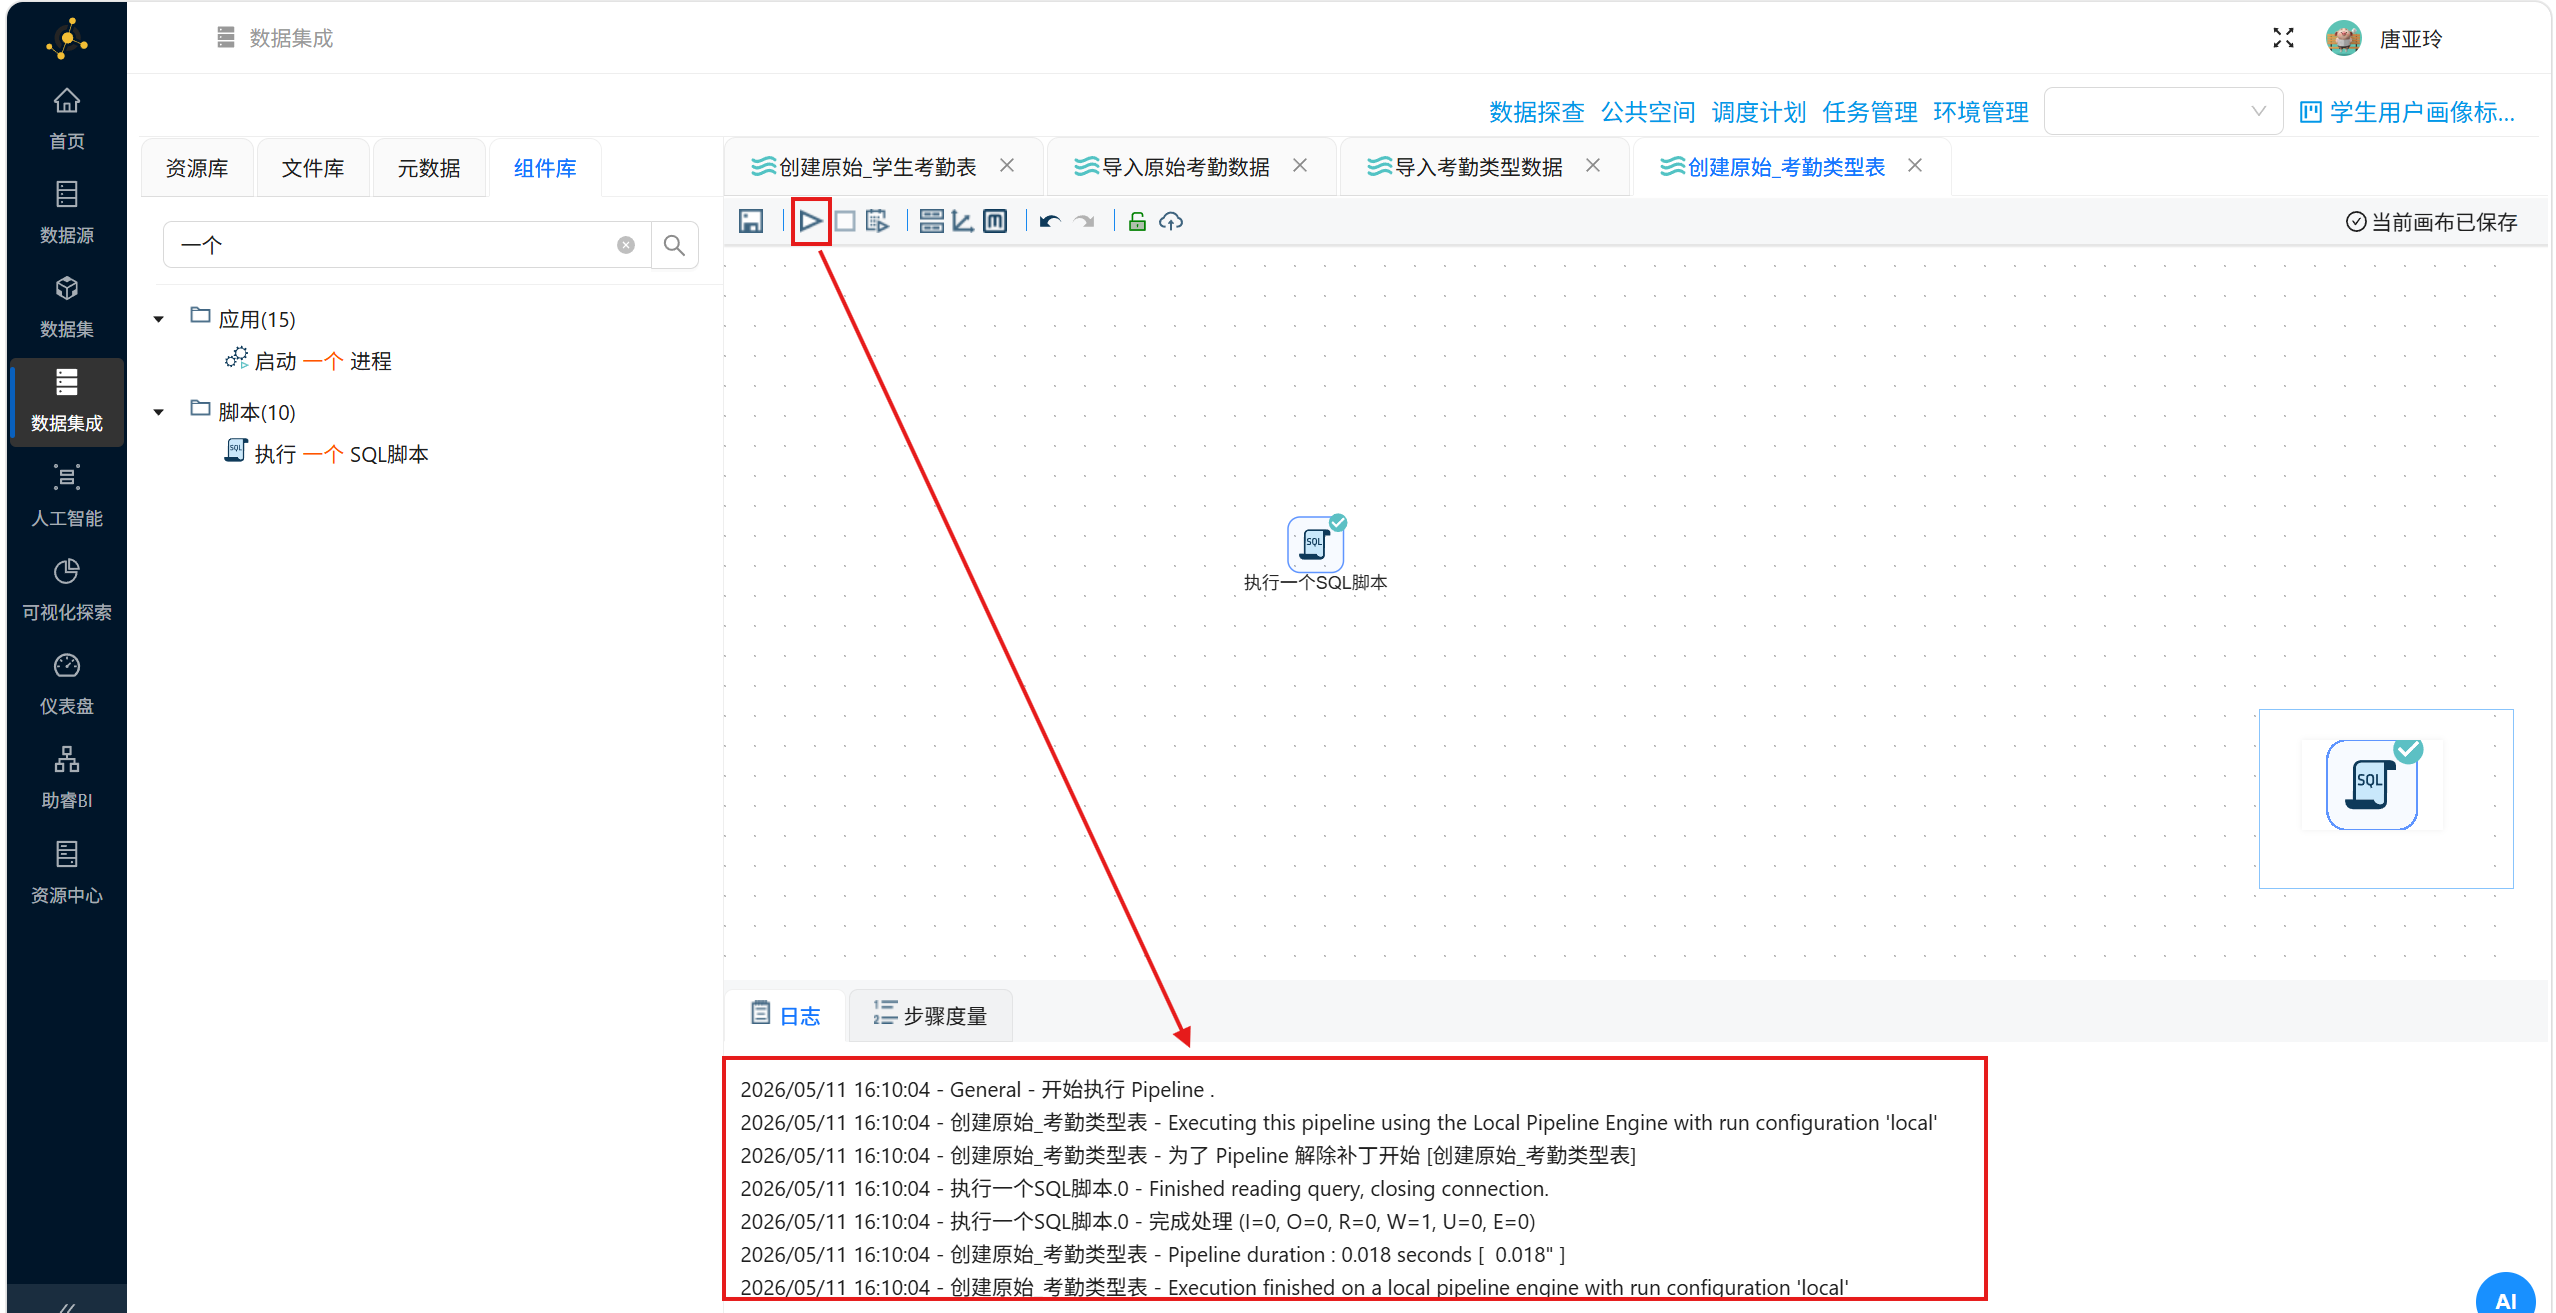
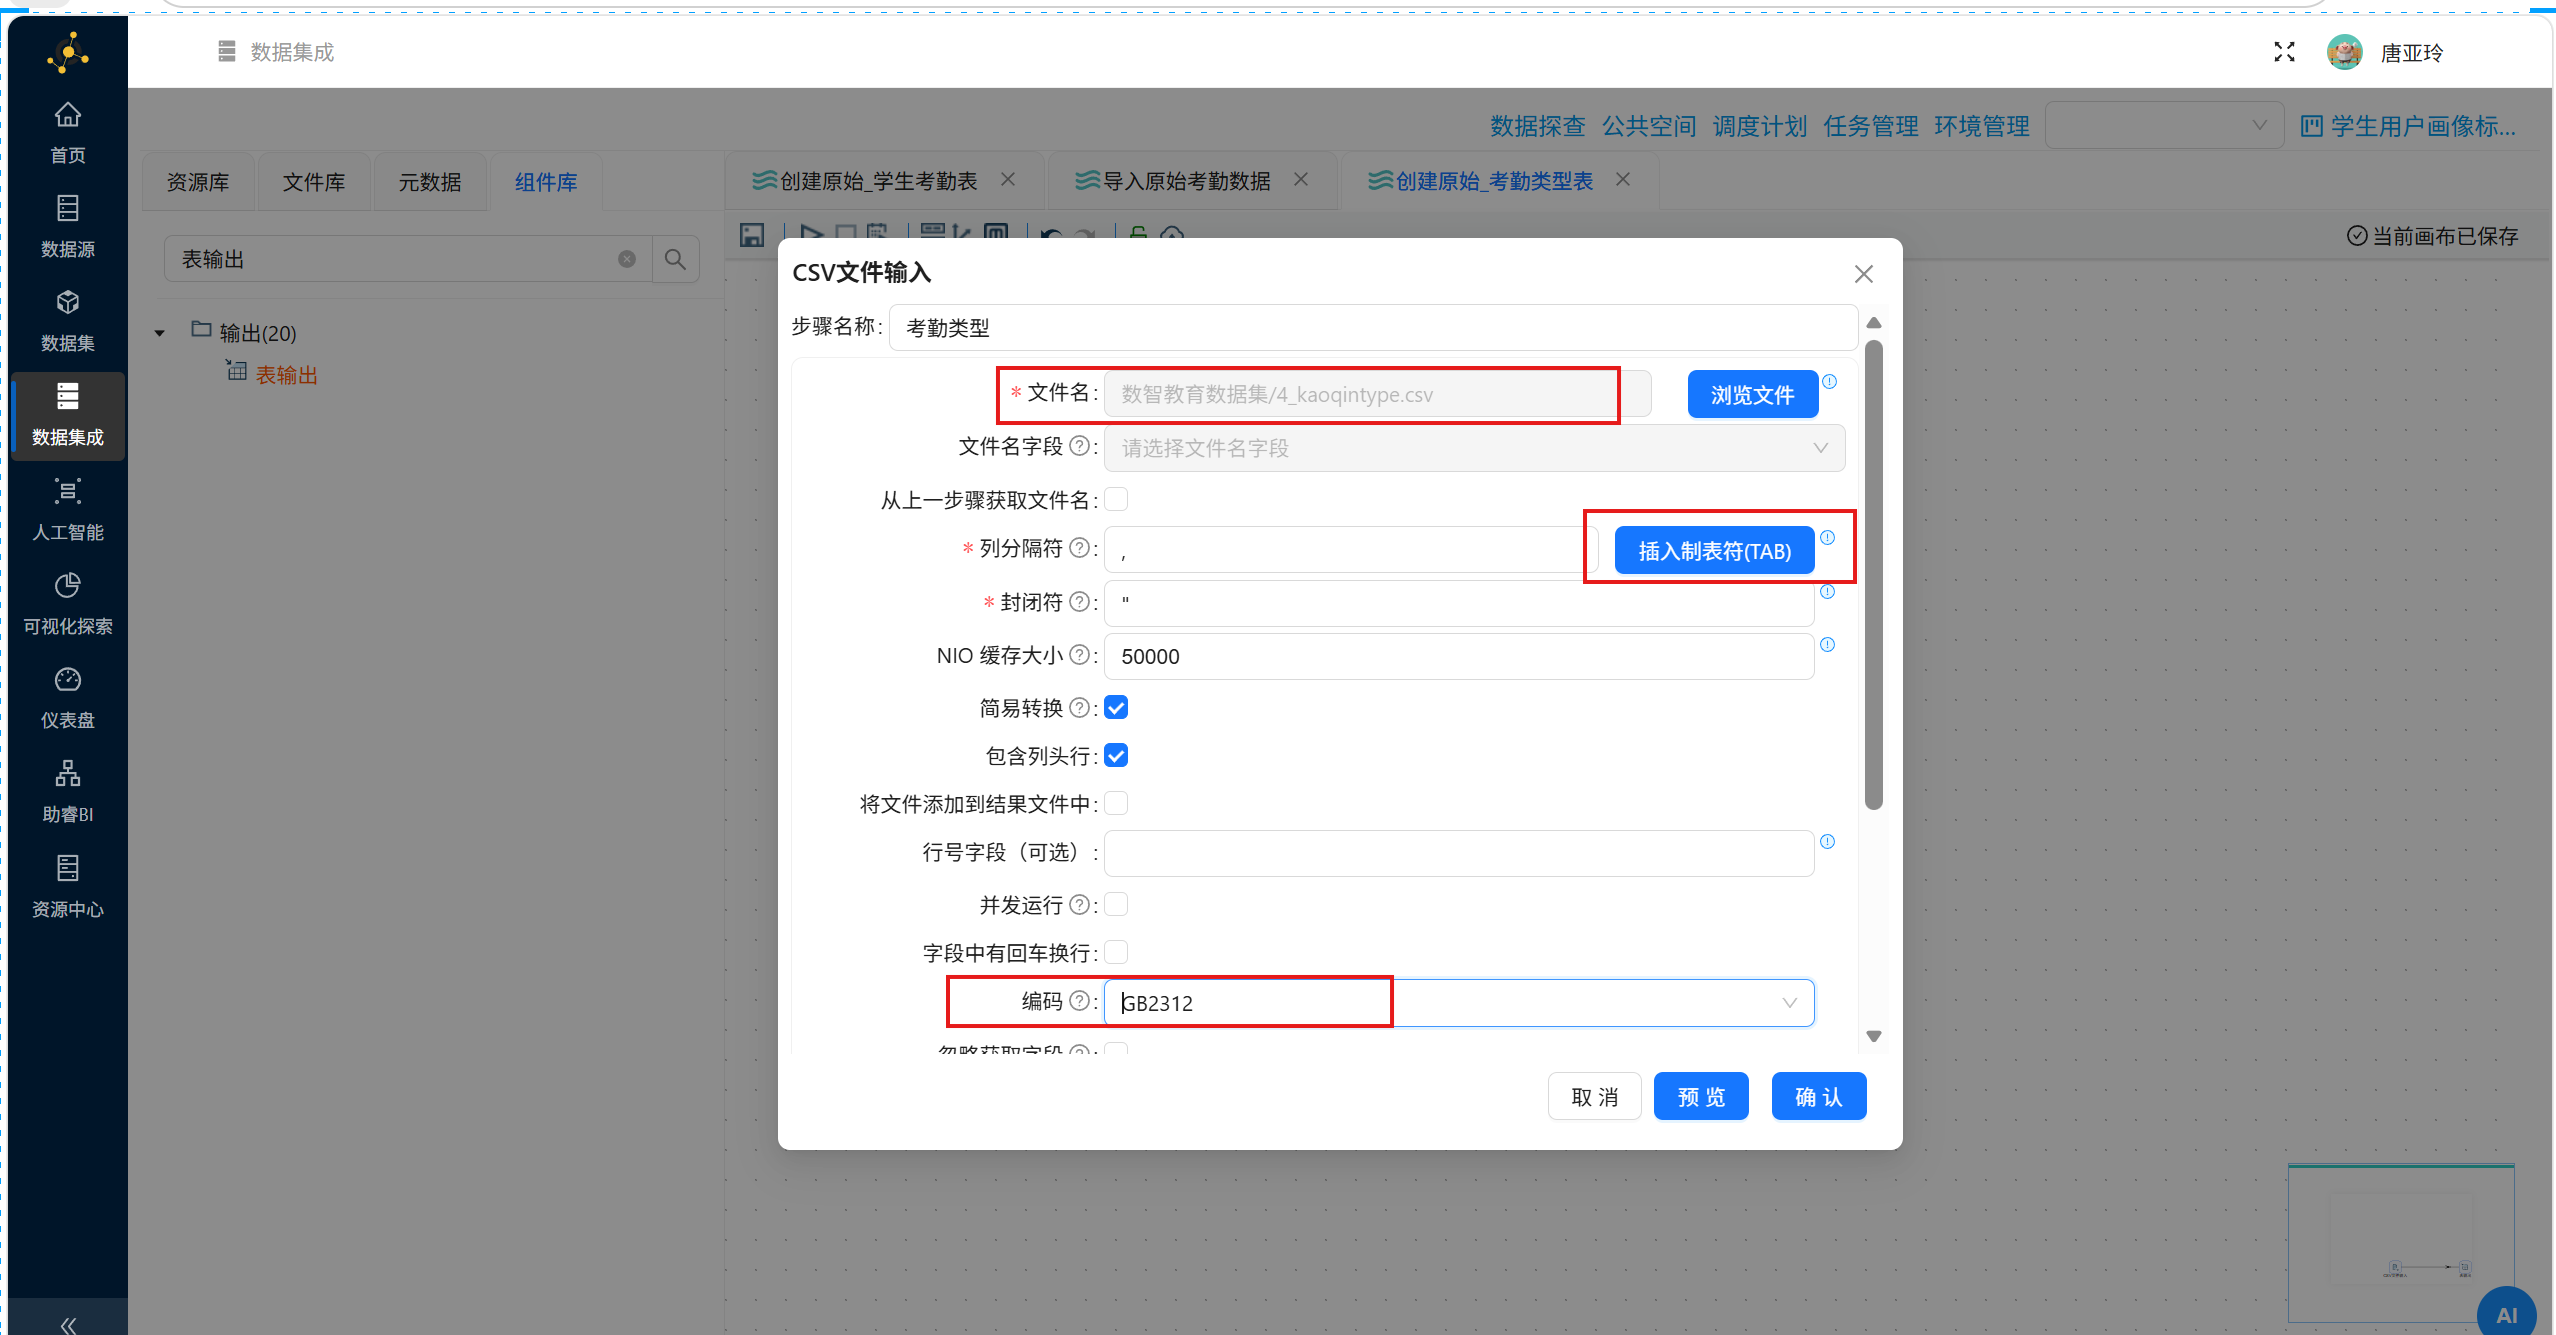
【特别说明】:使用CSV文件输入组件将 “4_kaoqintype.csv” 数据导入到团队私有数据库时,在配置中,列分隔符为 “插入制表符(TAB)”、编码为 “GB2312”
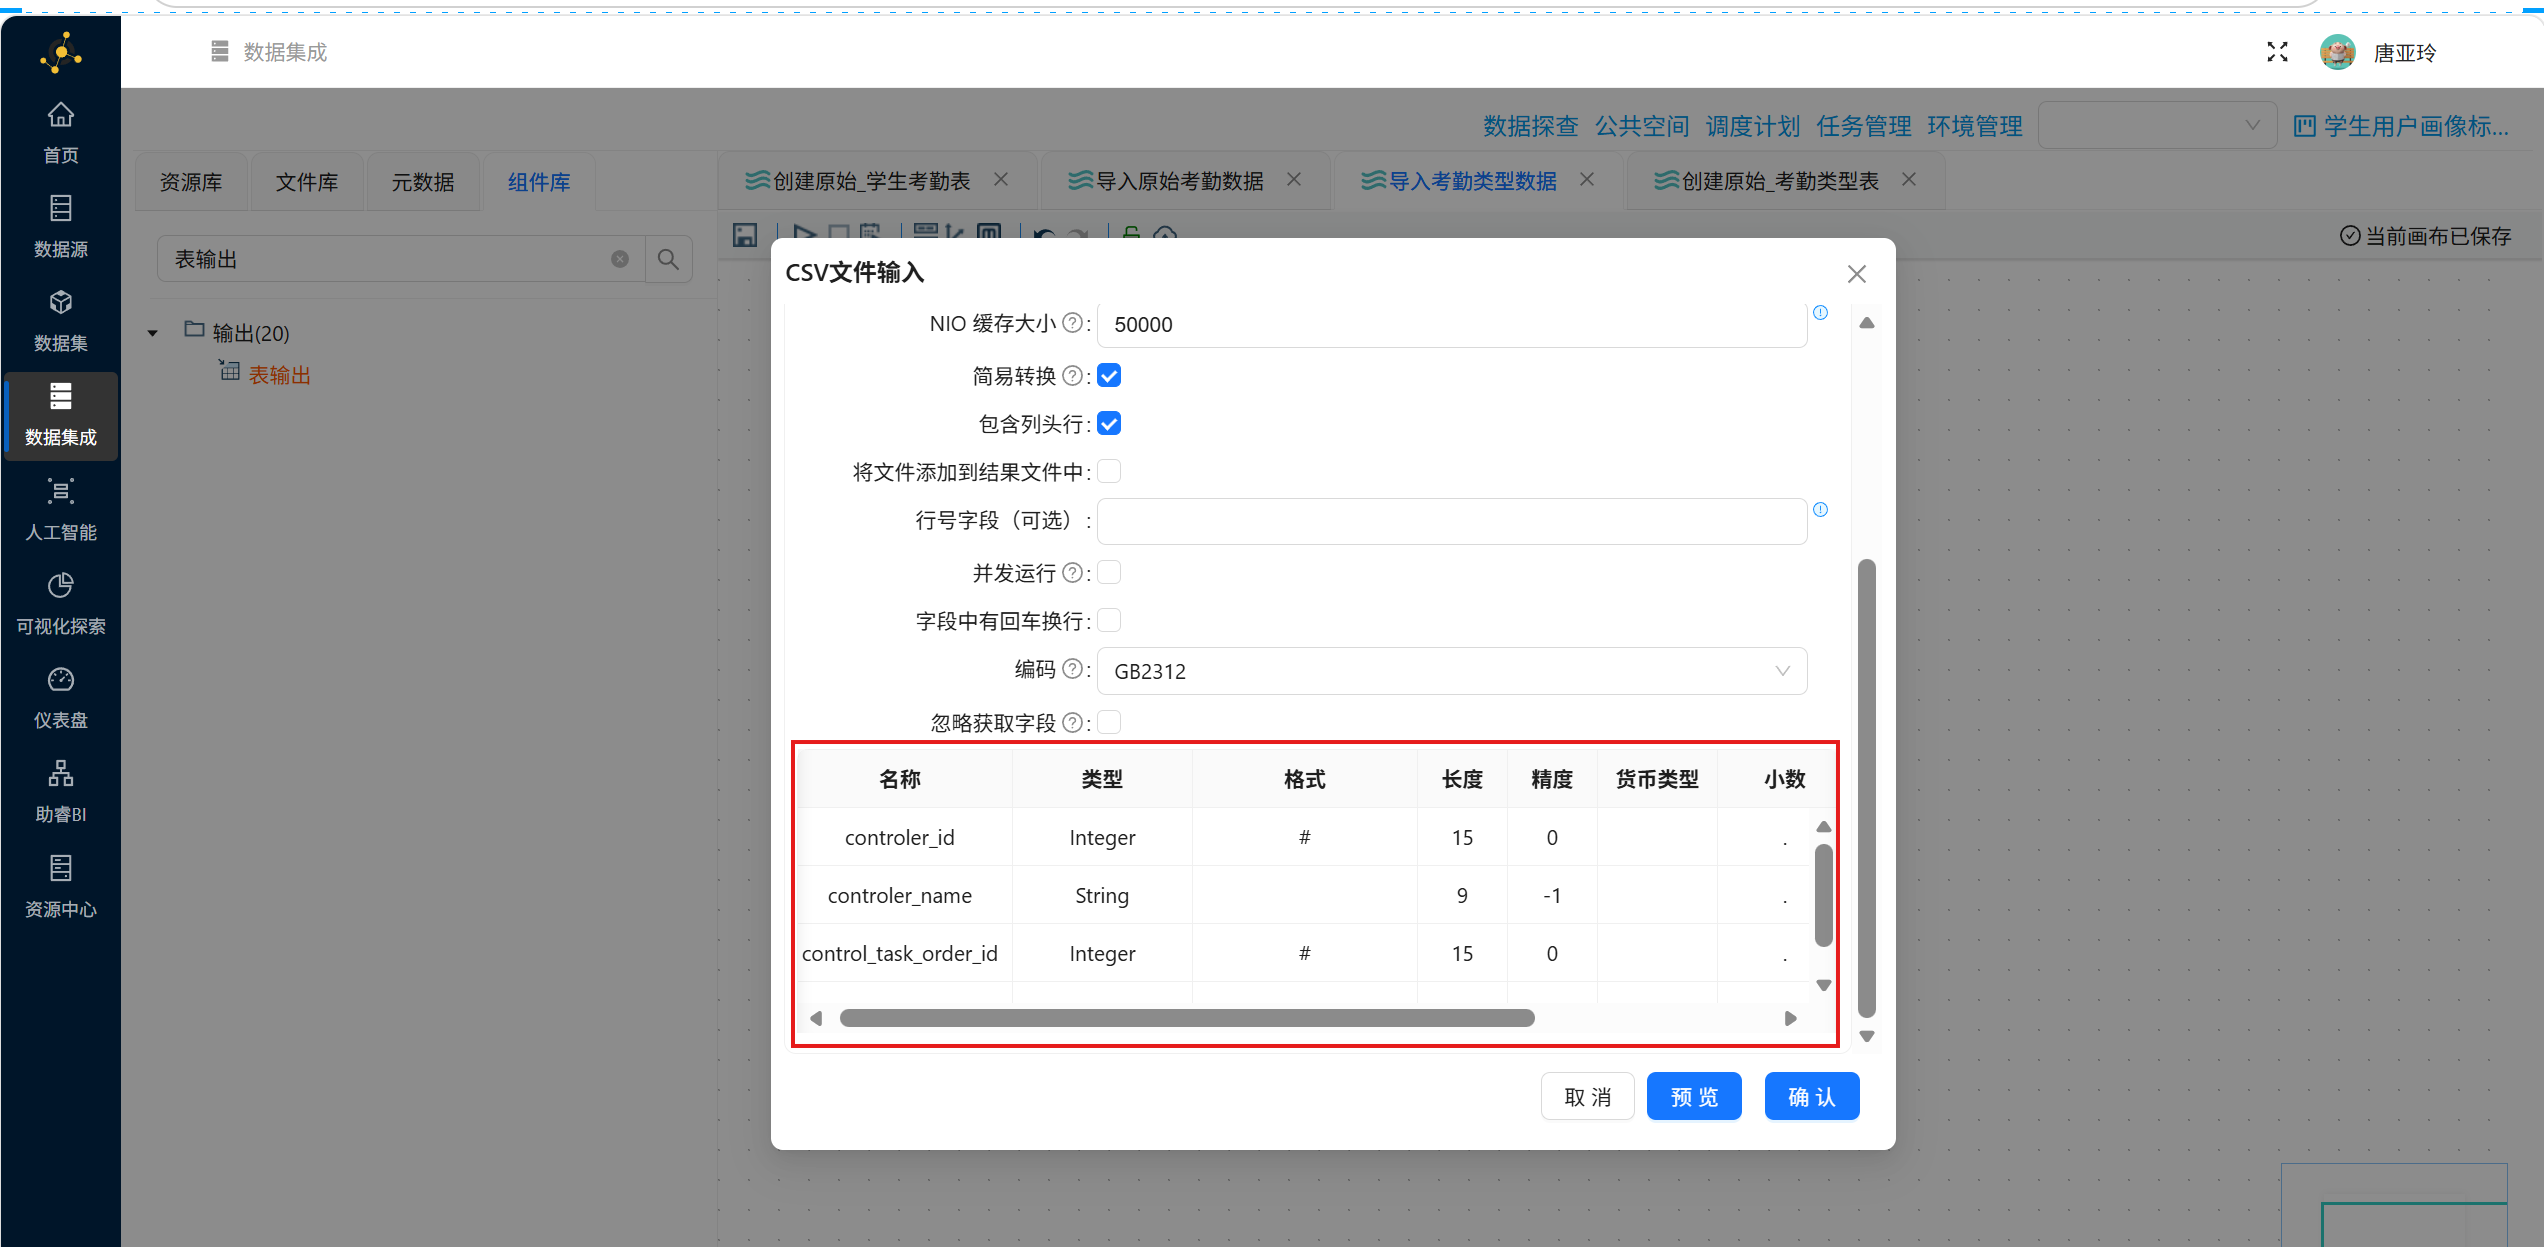
在下方空白处,右键获取字段,查看所获字段是否正确;若不正确,需检查配置。
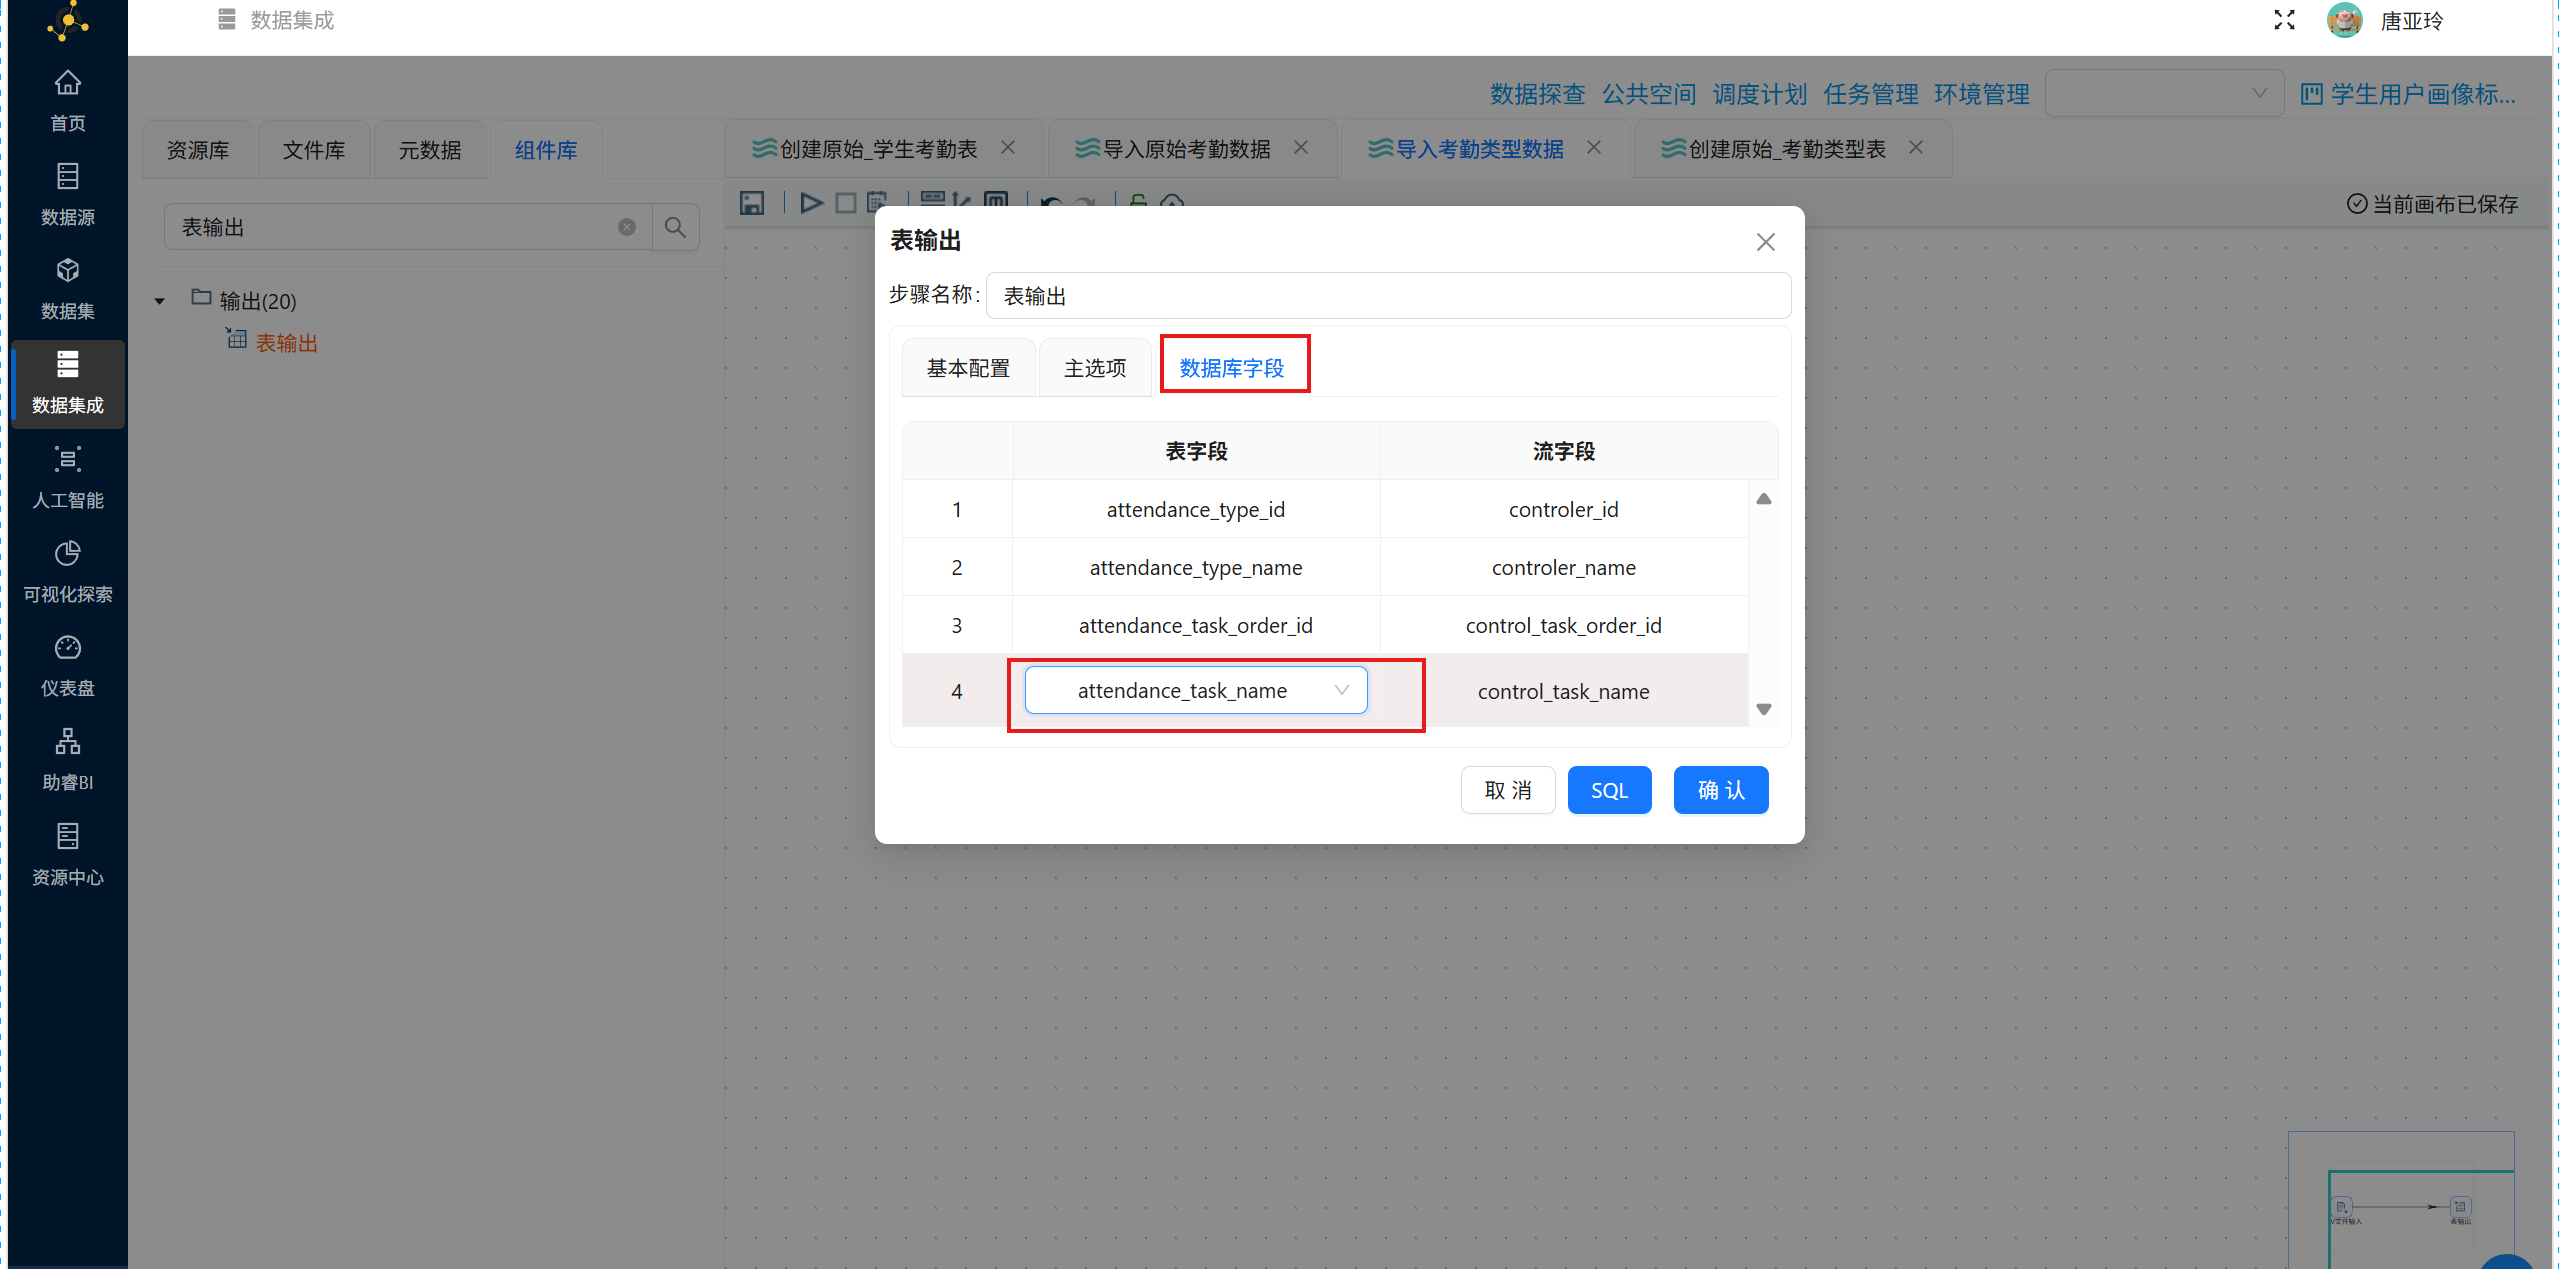
执行转换流,查看组件状态和日志信息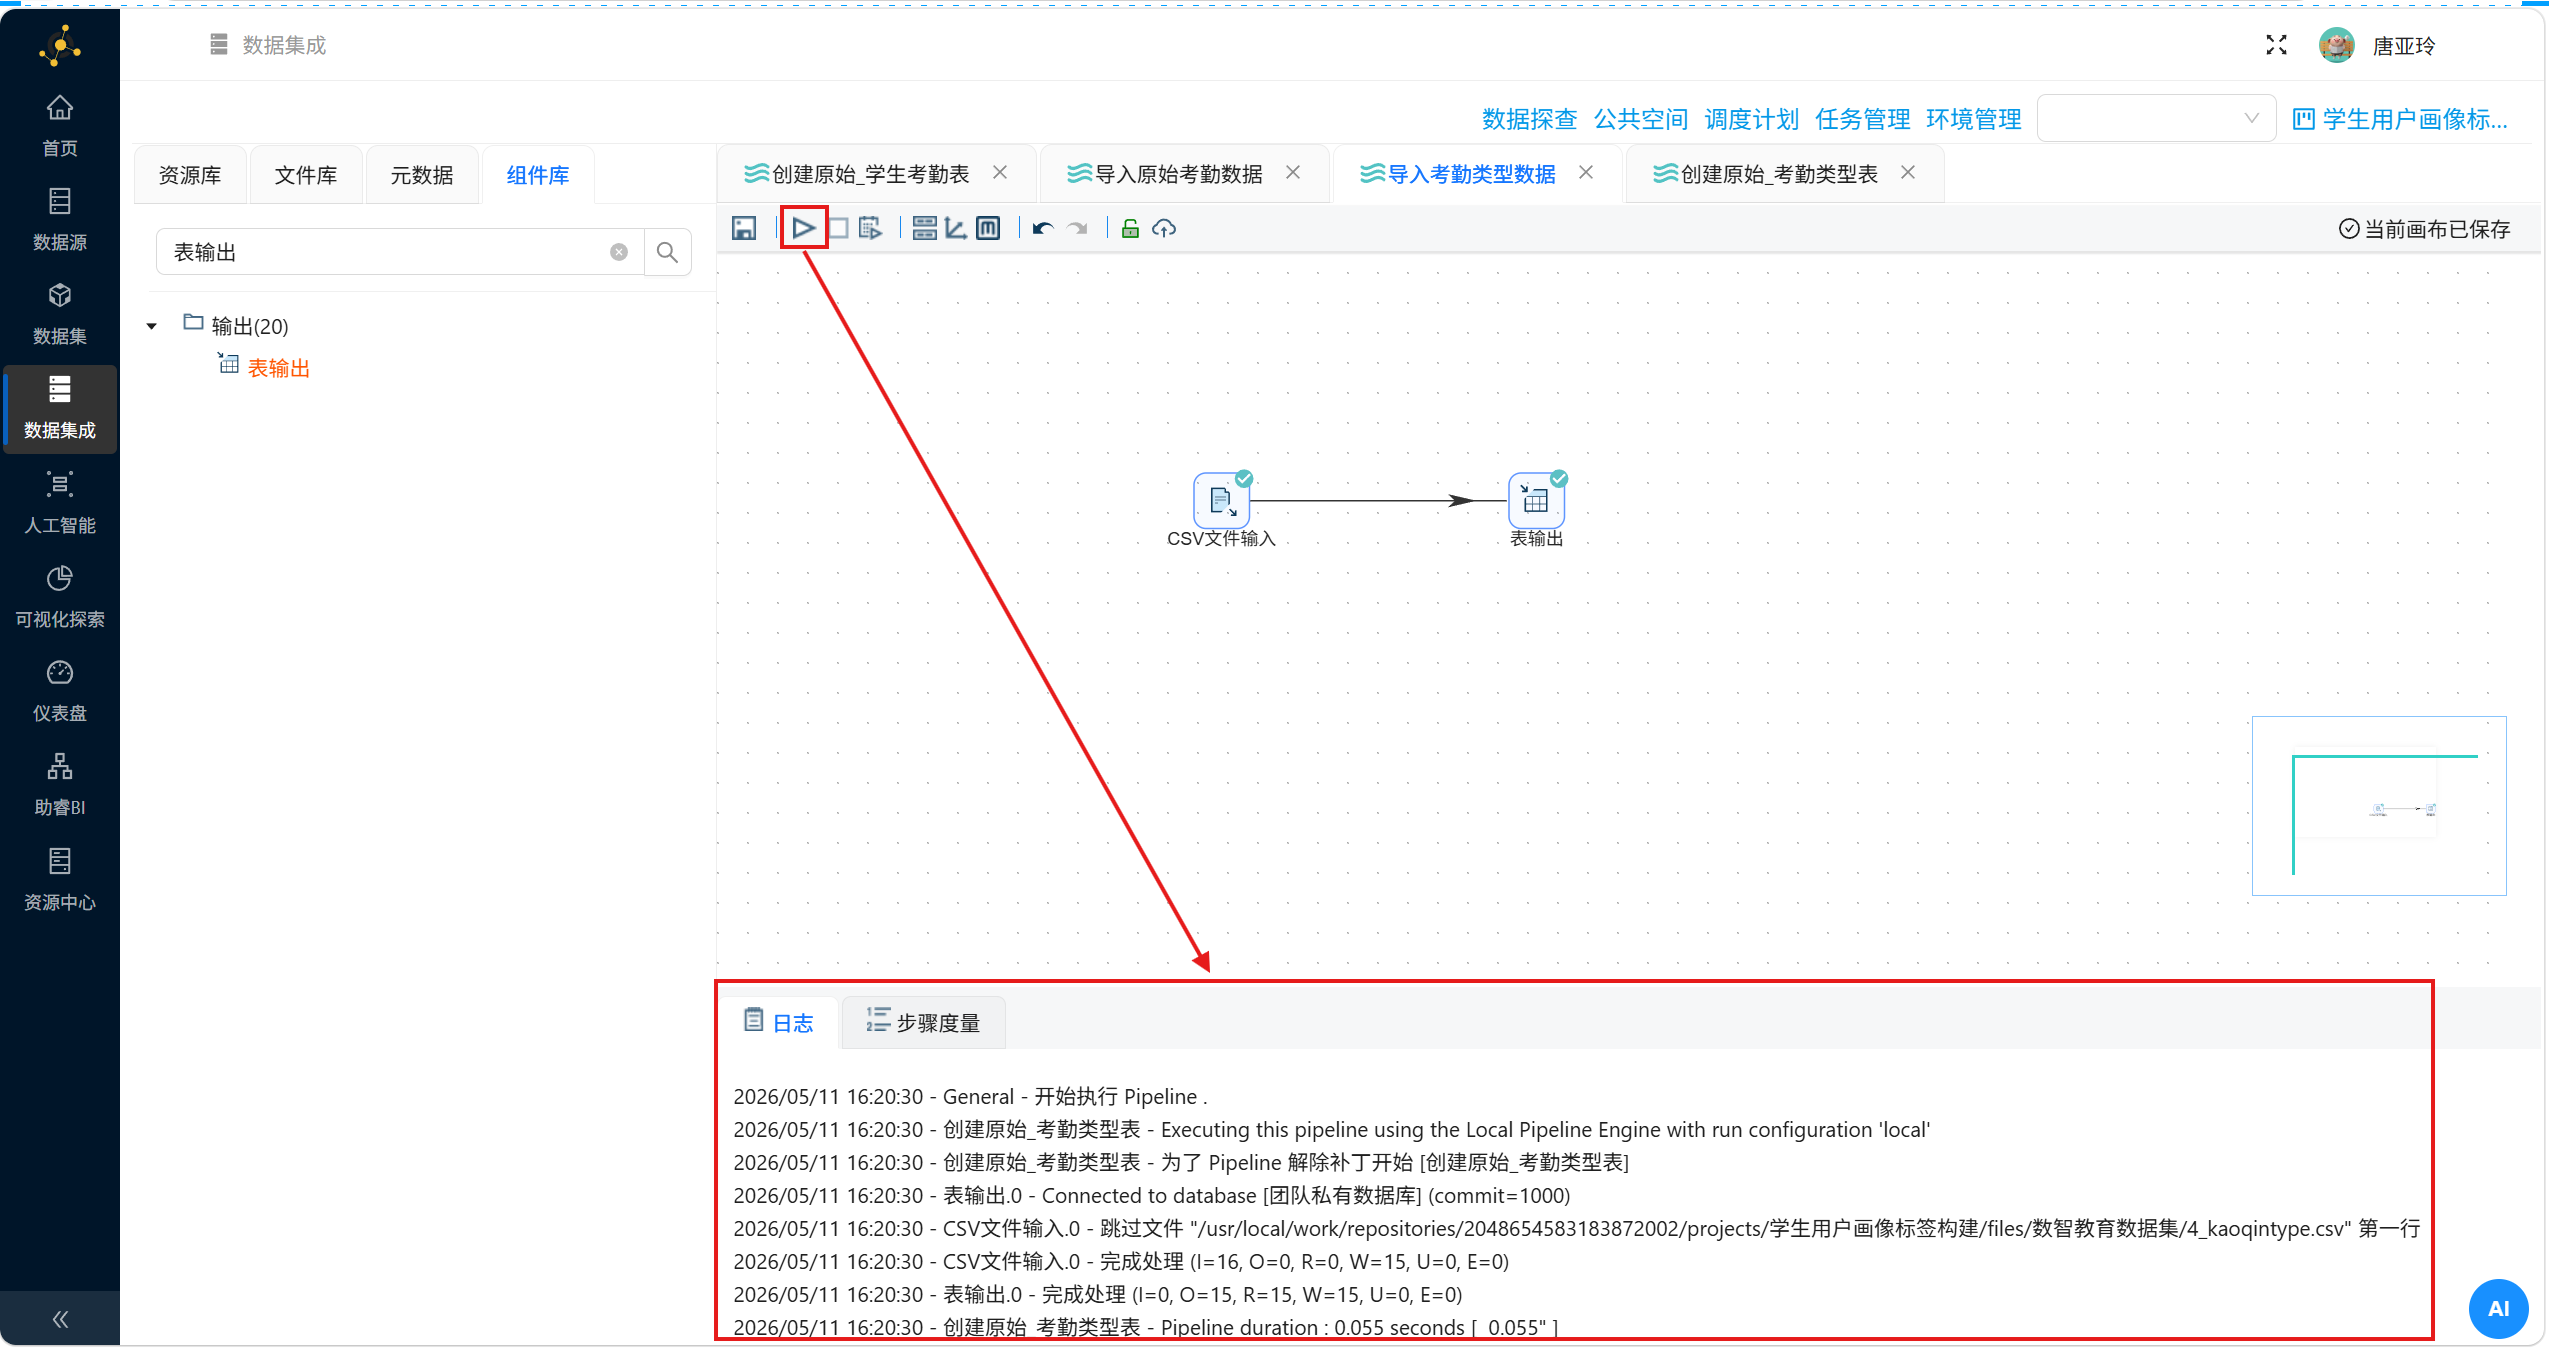
3.4.3 原始学生基本信息表数据导入
同样的,参照 “3.4.1 原始考勤记录表数据导入” 小节实验操作,类似地完成创建 原始_学生信息表
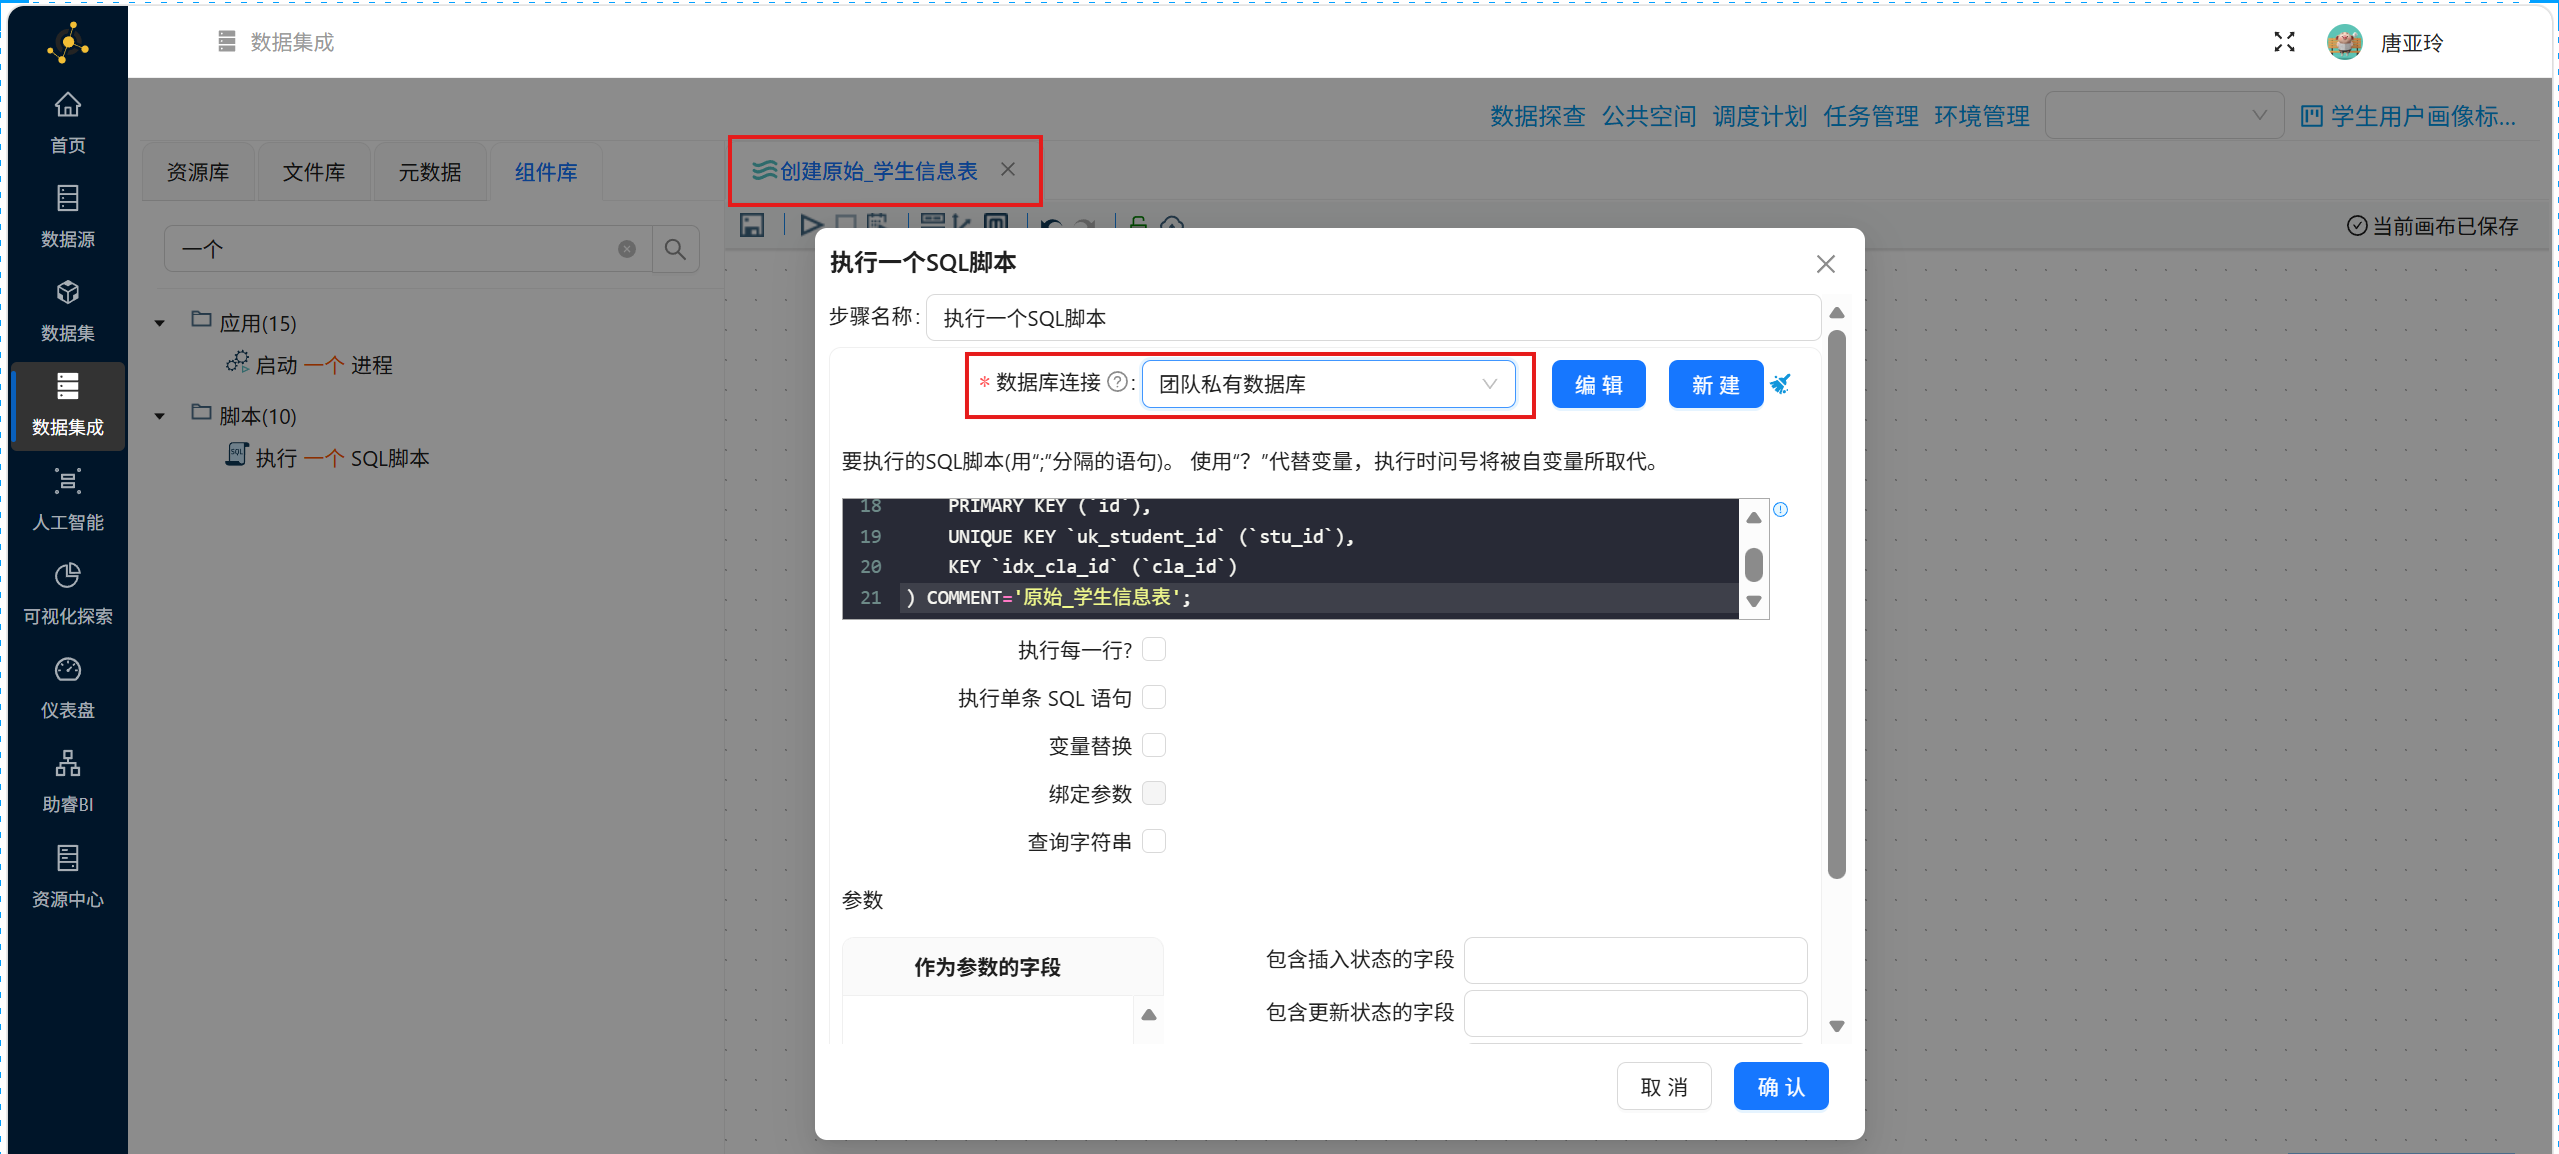
建表SQL为:
CREATE TABLE IF NOT EXISTS `raw_student_info` (
  `id` bigint NOT NULL AUTO_INCREMENT COMMENT '自增ID',
  `stu_id` varchar(64) NOT NULL COMMENT '学生ID',
  `stu_name` varchar(100) DEFAULT NULL COMMENT '学生姓名',
  `stu_sex` varchar(10) DEFAULT NULL COMMENT '性别',
  `stu_nation` varchar(50) DEFAULT NULL COMMENT '民族',
  `born_date` varchar(10) DEFAULT NULL COMMENT '出生日期(年)',
  `cla_name` varchar(100) DEFAULT NULL COMMENT '班级名',
  `native_place` varchar(200) DEFAULT NULL COMMENT '家庭住址',
  `residence_type` varchar(50) DEFAULT NULL COMMENT '家庭类型',
  `policy` varchar(50) DEFAULT NULL COMMENT '政治面貌',
  `cla_id` varchar(64) DEFAULT NULL COMMENT '班级ID',
  `cla_term` varchar(30) DEFAULT NULL COMMENT '班级学期',
  `live_on_campus` varchar(10) DEFAULT NULL COMMENT '是否住校',
  `leave_school` varchar(10) DEFAULT NULL COMMENT '是否退学',
  `dormitory_no` varchar(50) DEFAULT NULL COMMENT '宿舍号',
  `create_time` datetime DEFAULT CURRENT_TIMESTAMP COMMENT '入库时间',
  PRIMARY KEY (`id`),
  UNIQUE KEY `uk_student_id` (`stu_id`),
  KEY `idx_cla_id` (`cla_id`)
) COMMENT='原始_学生信息表';
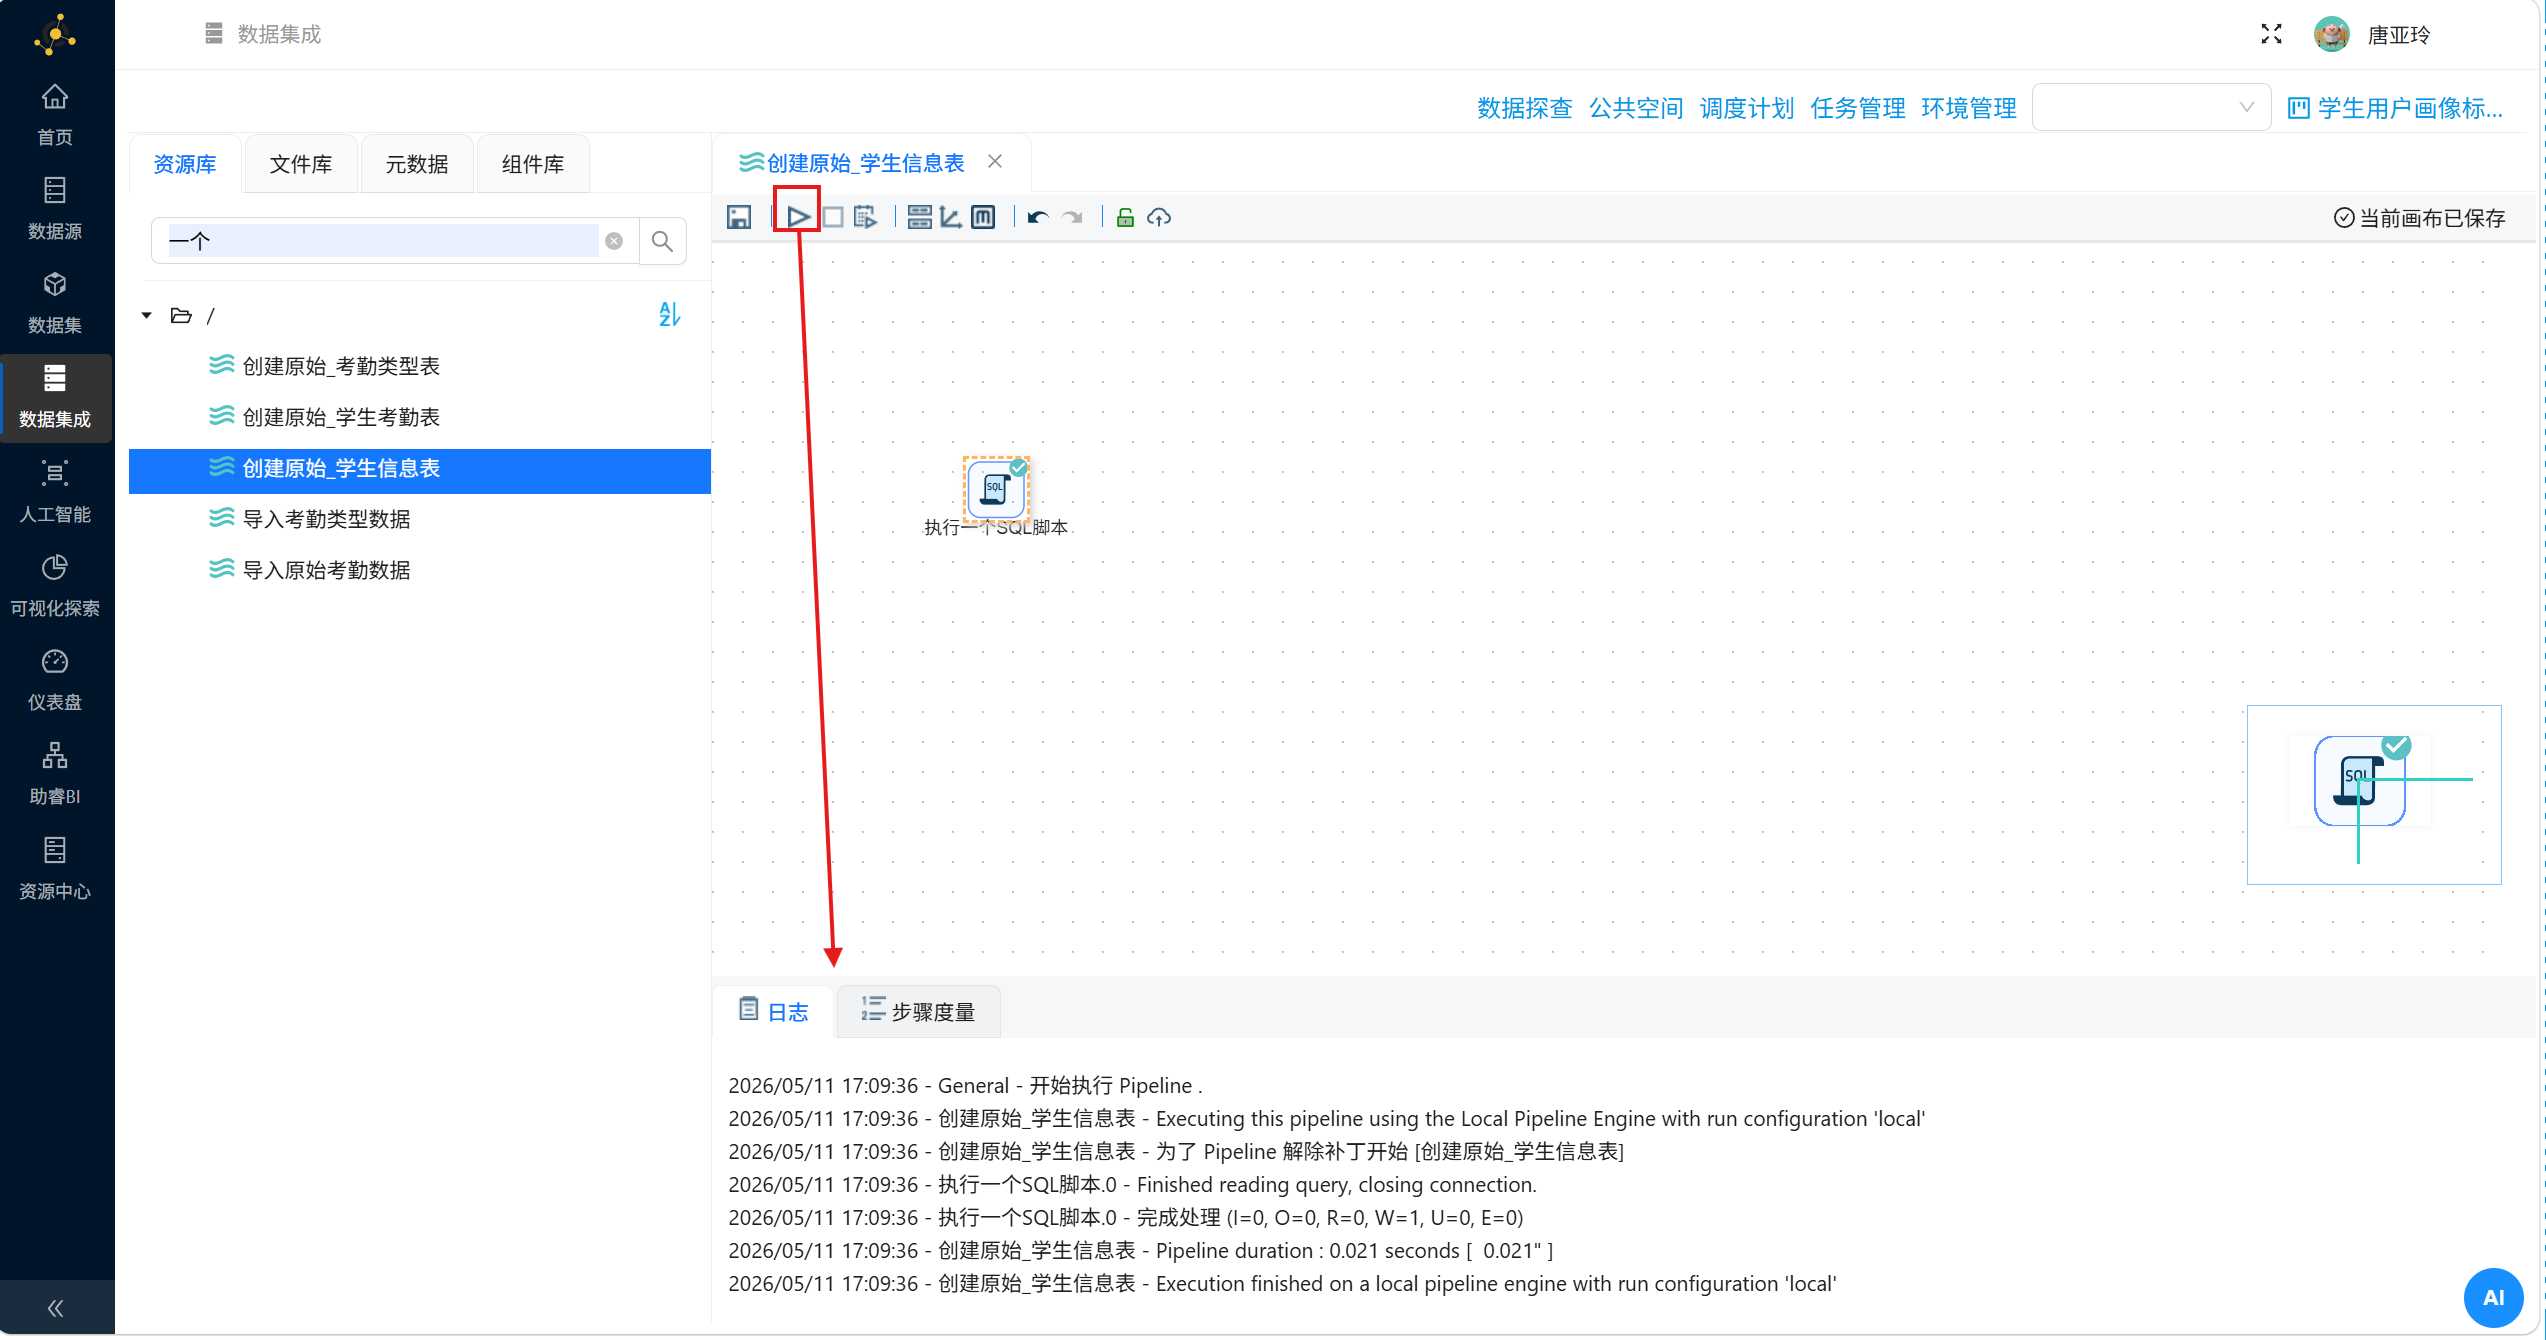
执行建表的转换流,查看组件动态和日志信息
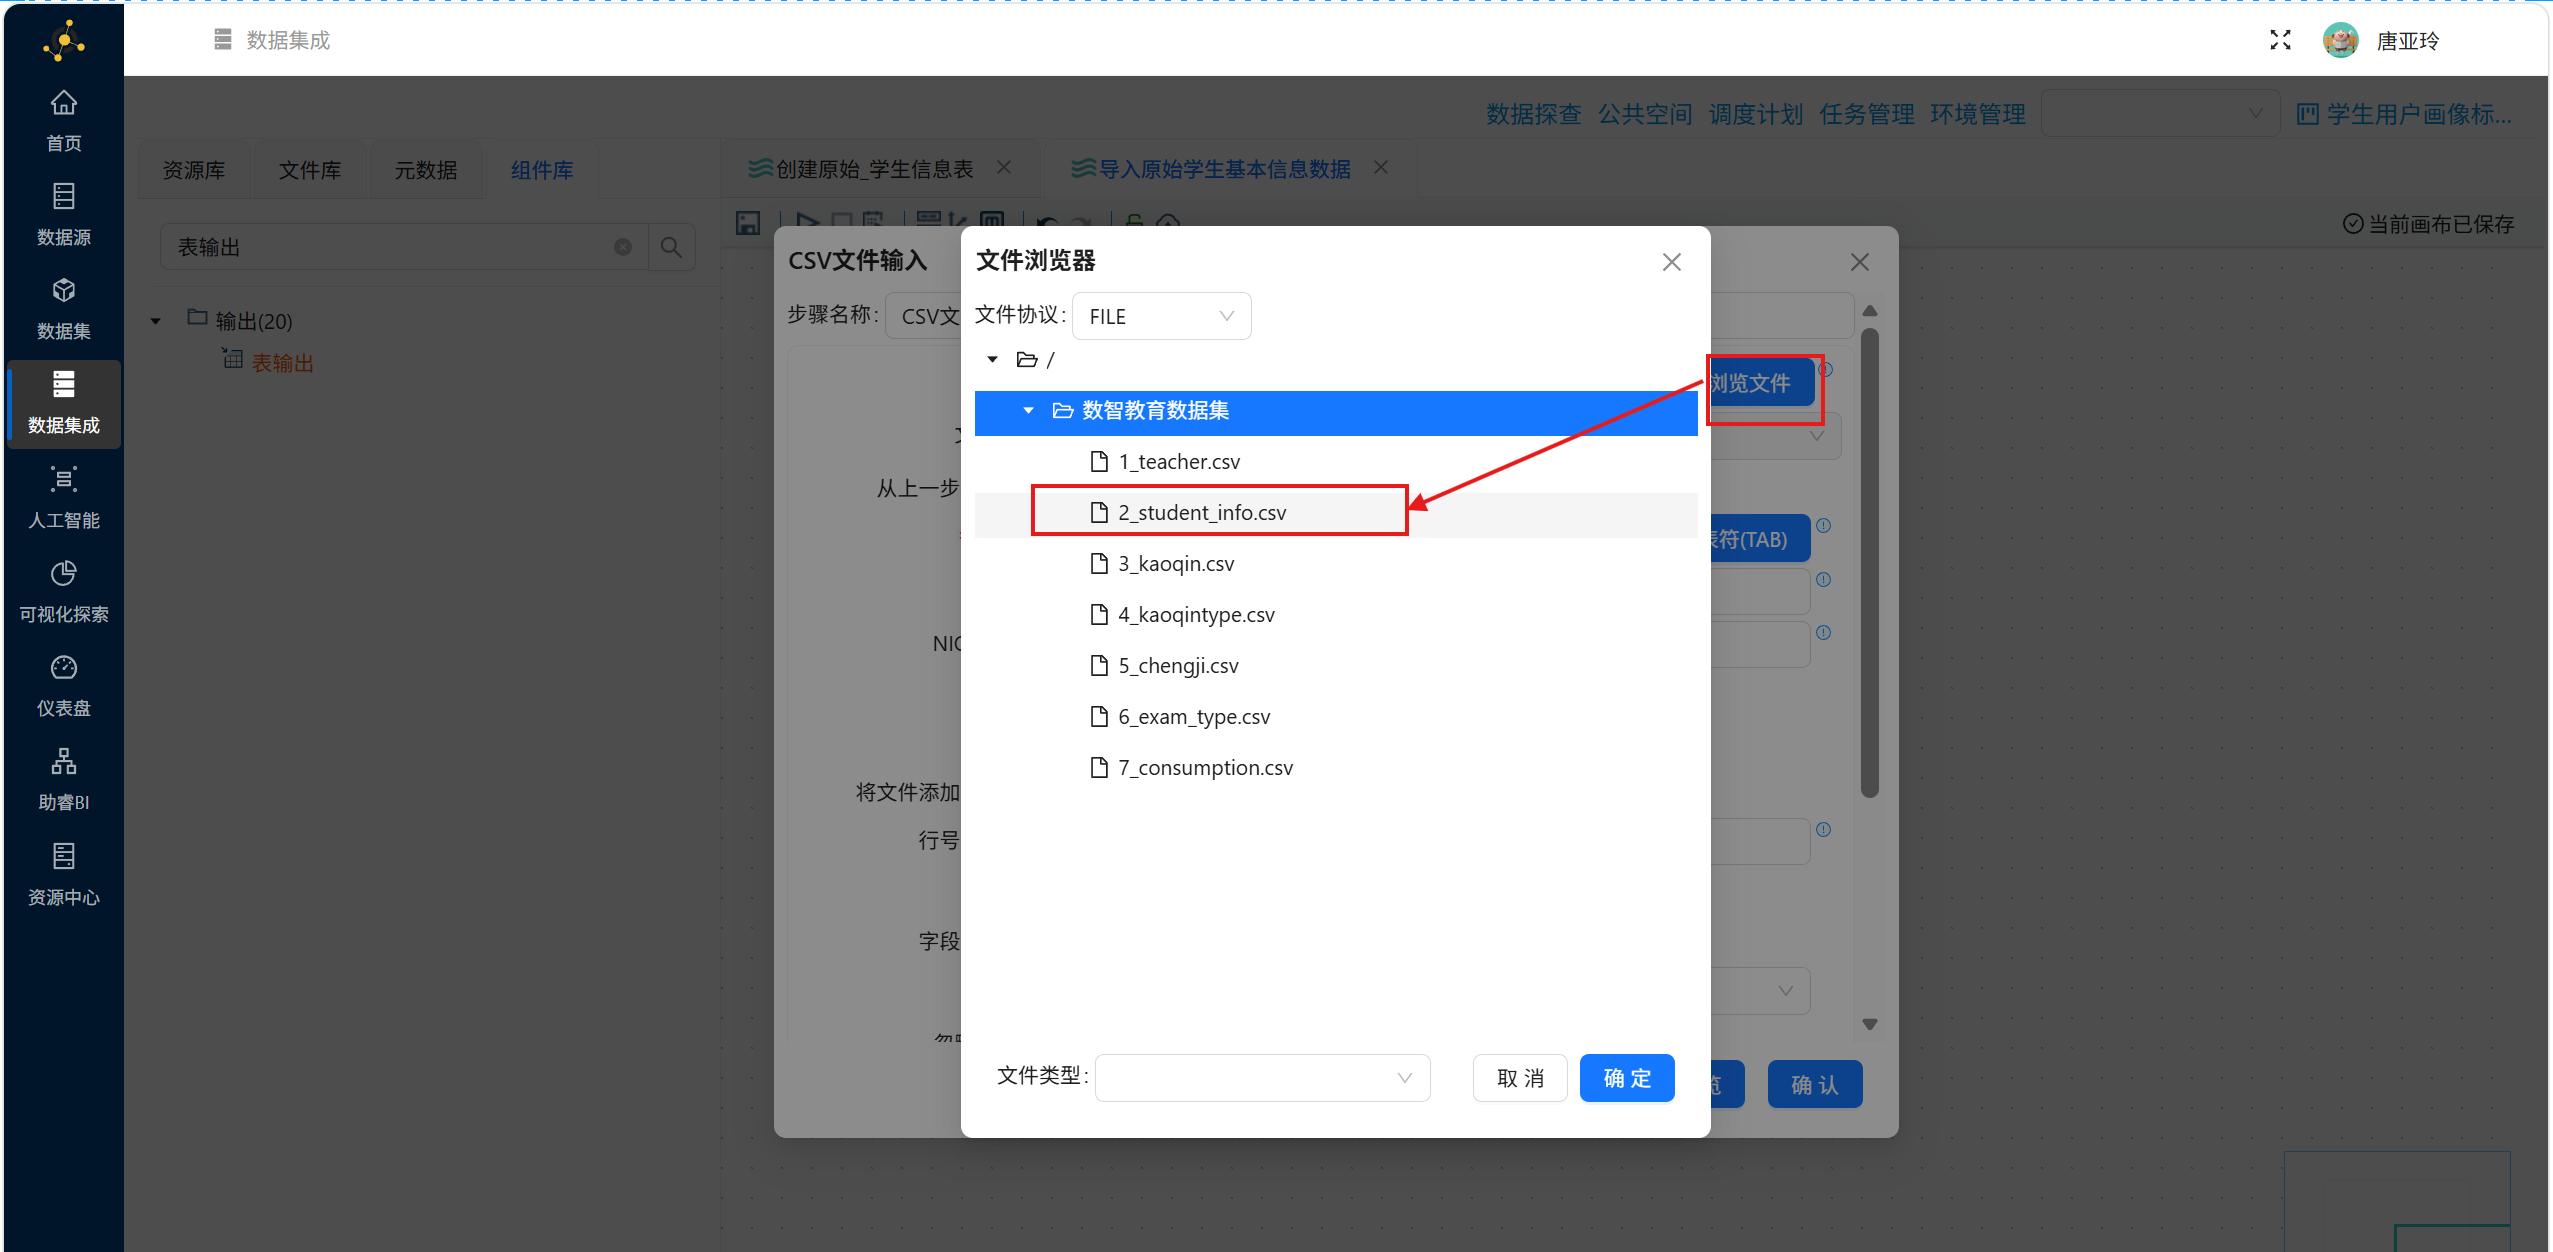
在导入数据的转换流中,使用 “CSV文件输出” 组件输入 “2_student_info.csv” 数据
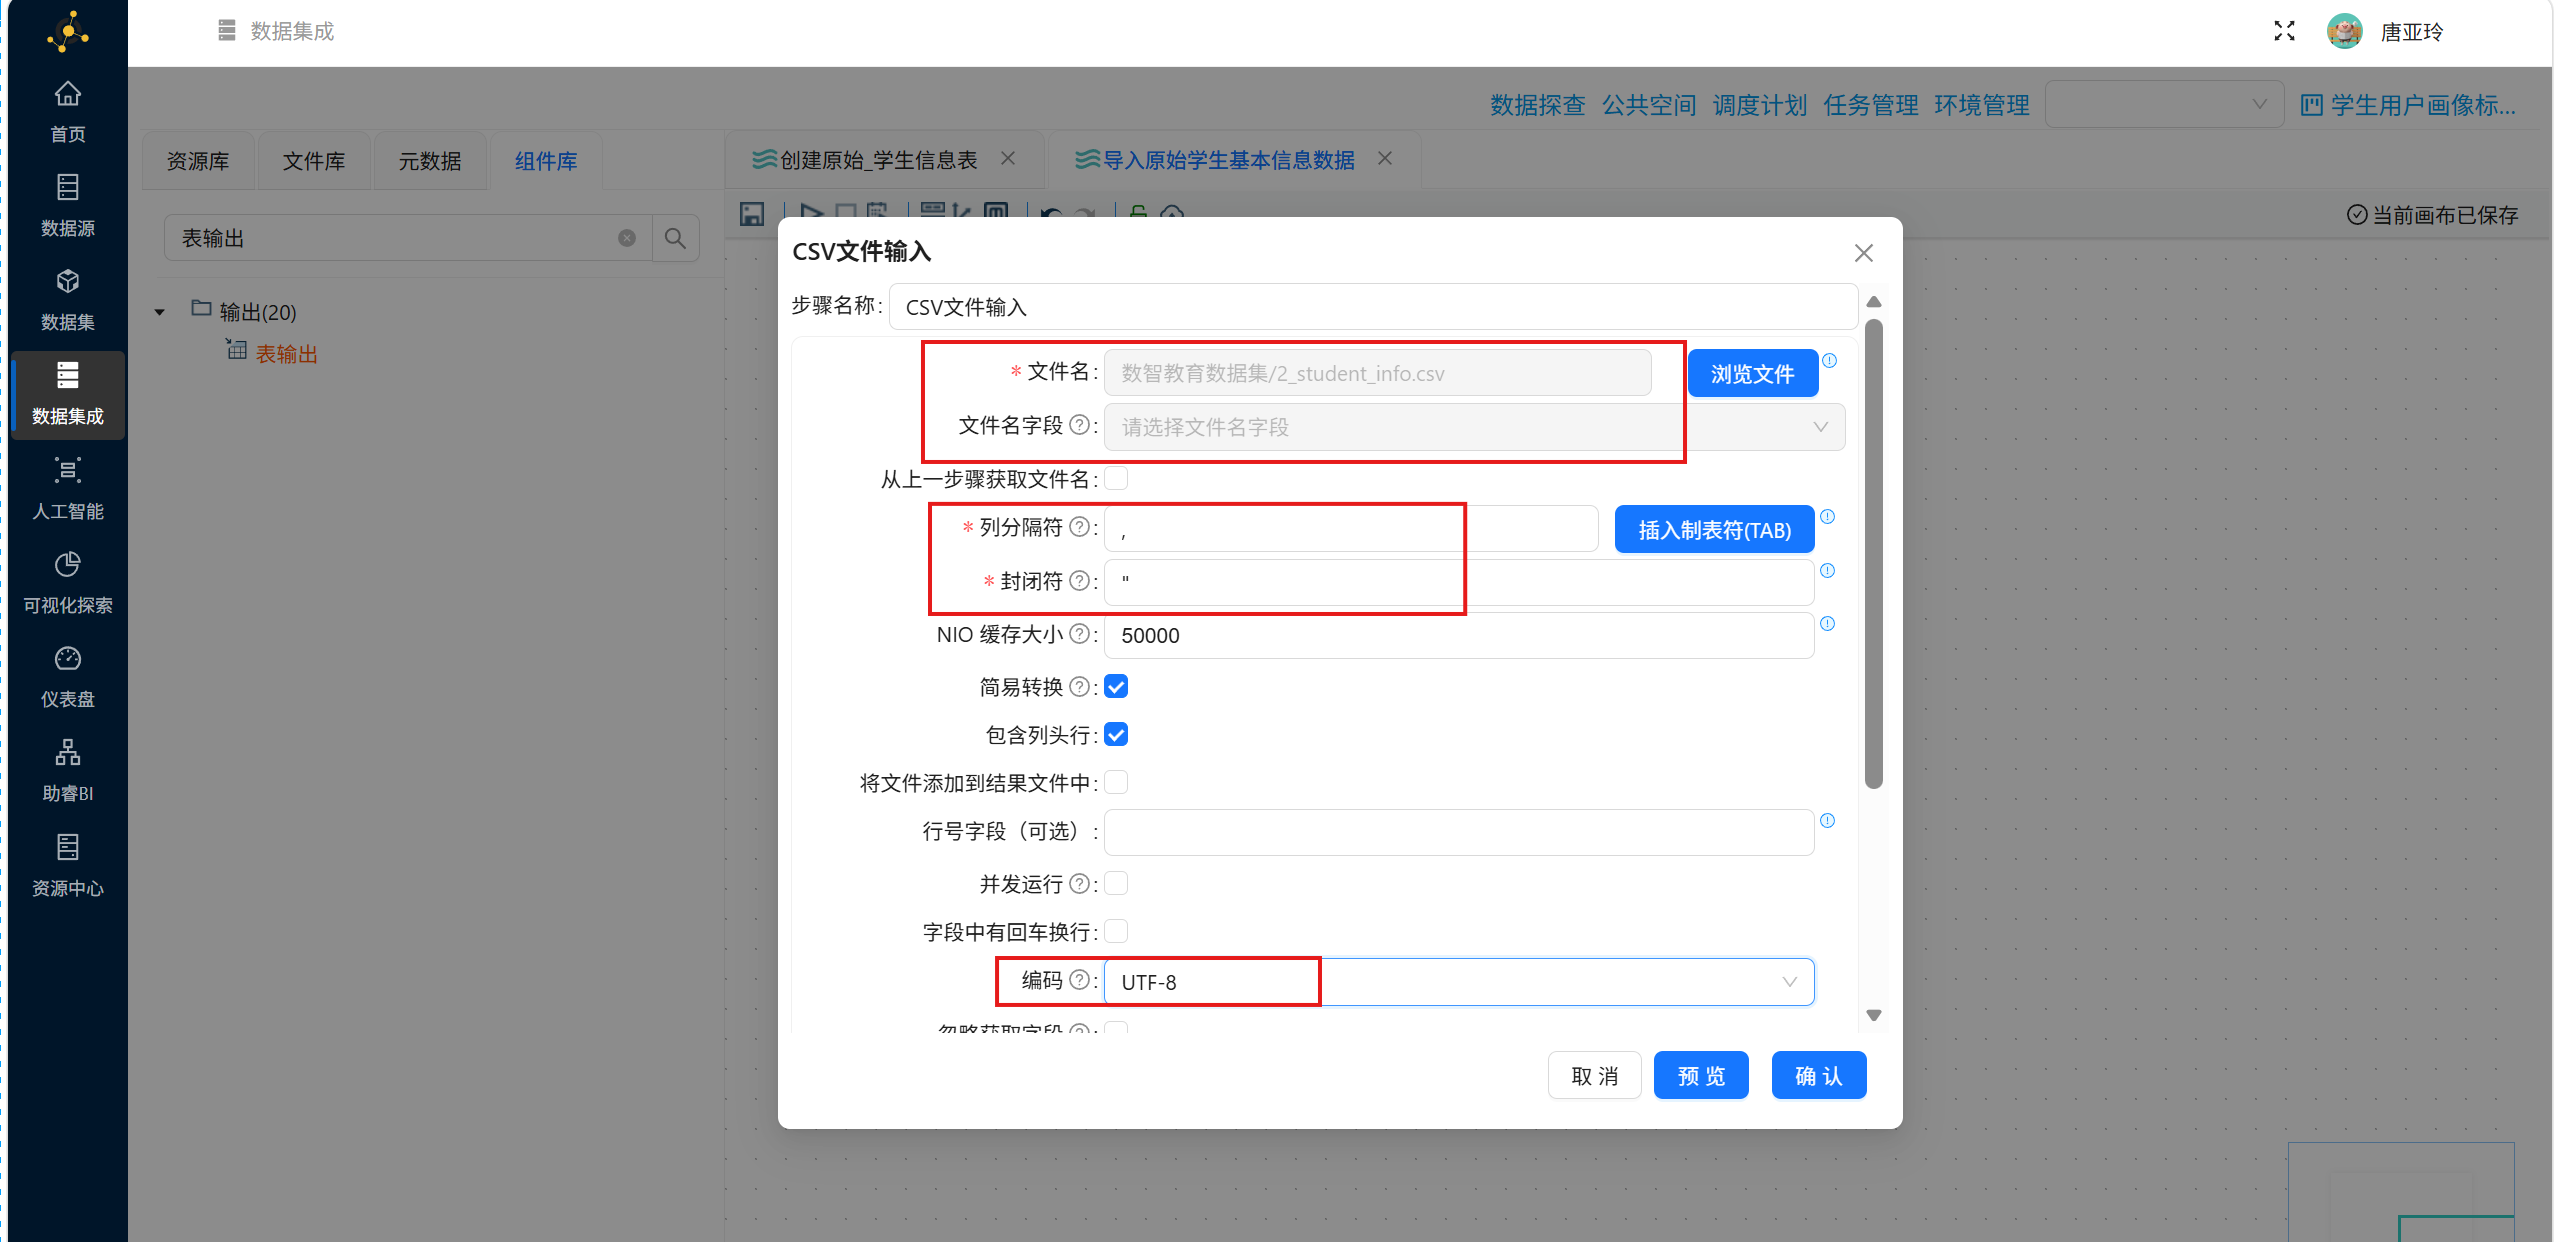
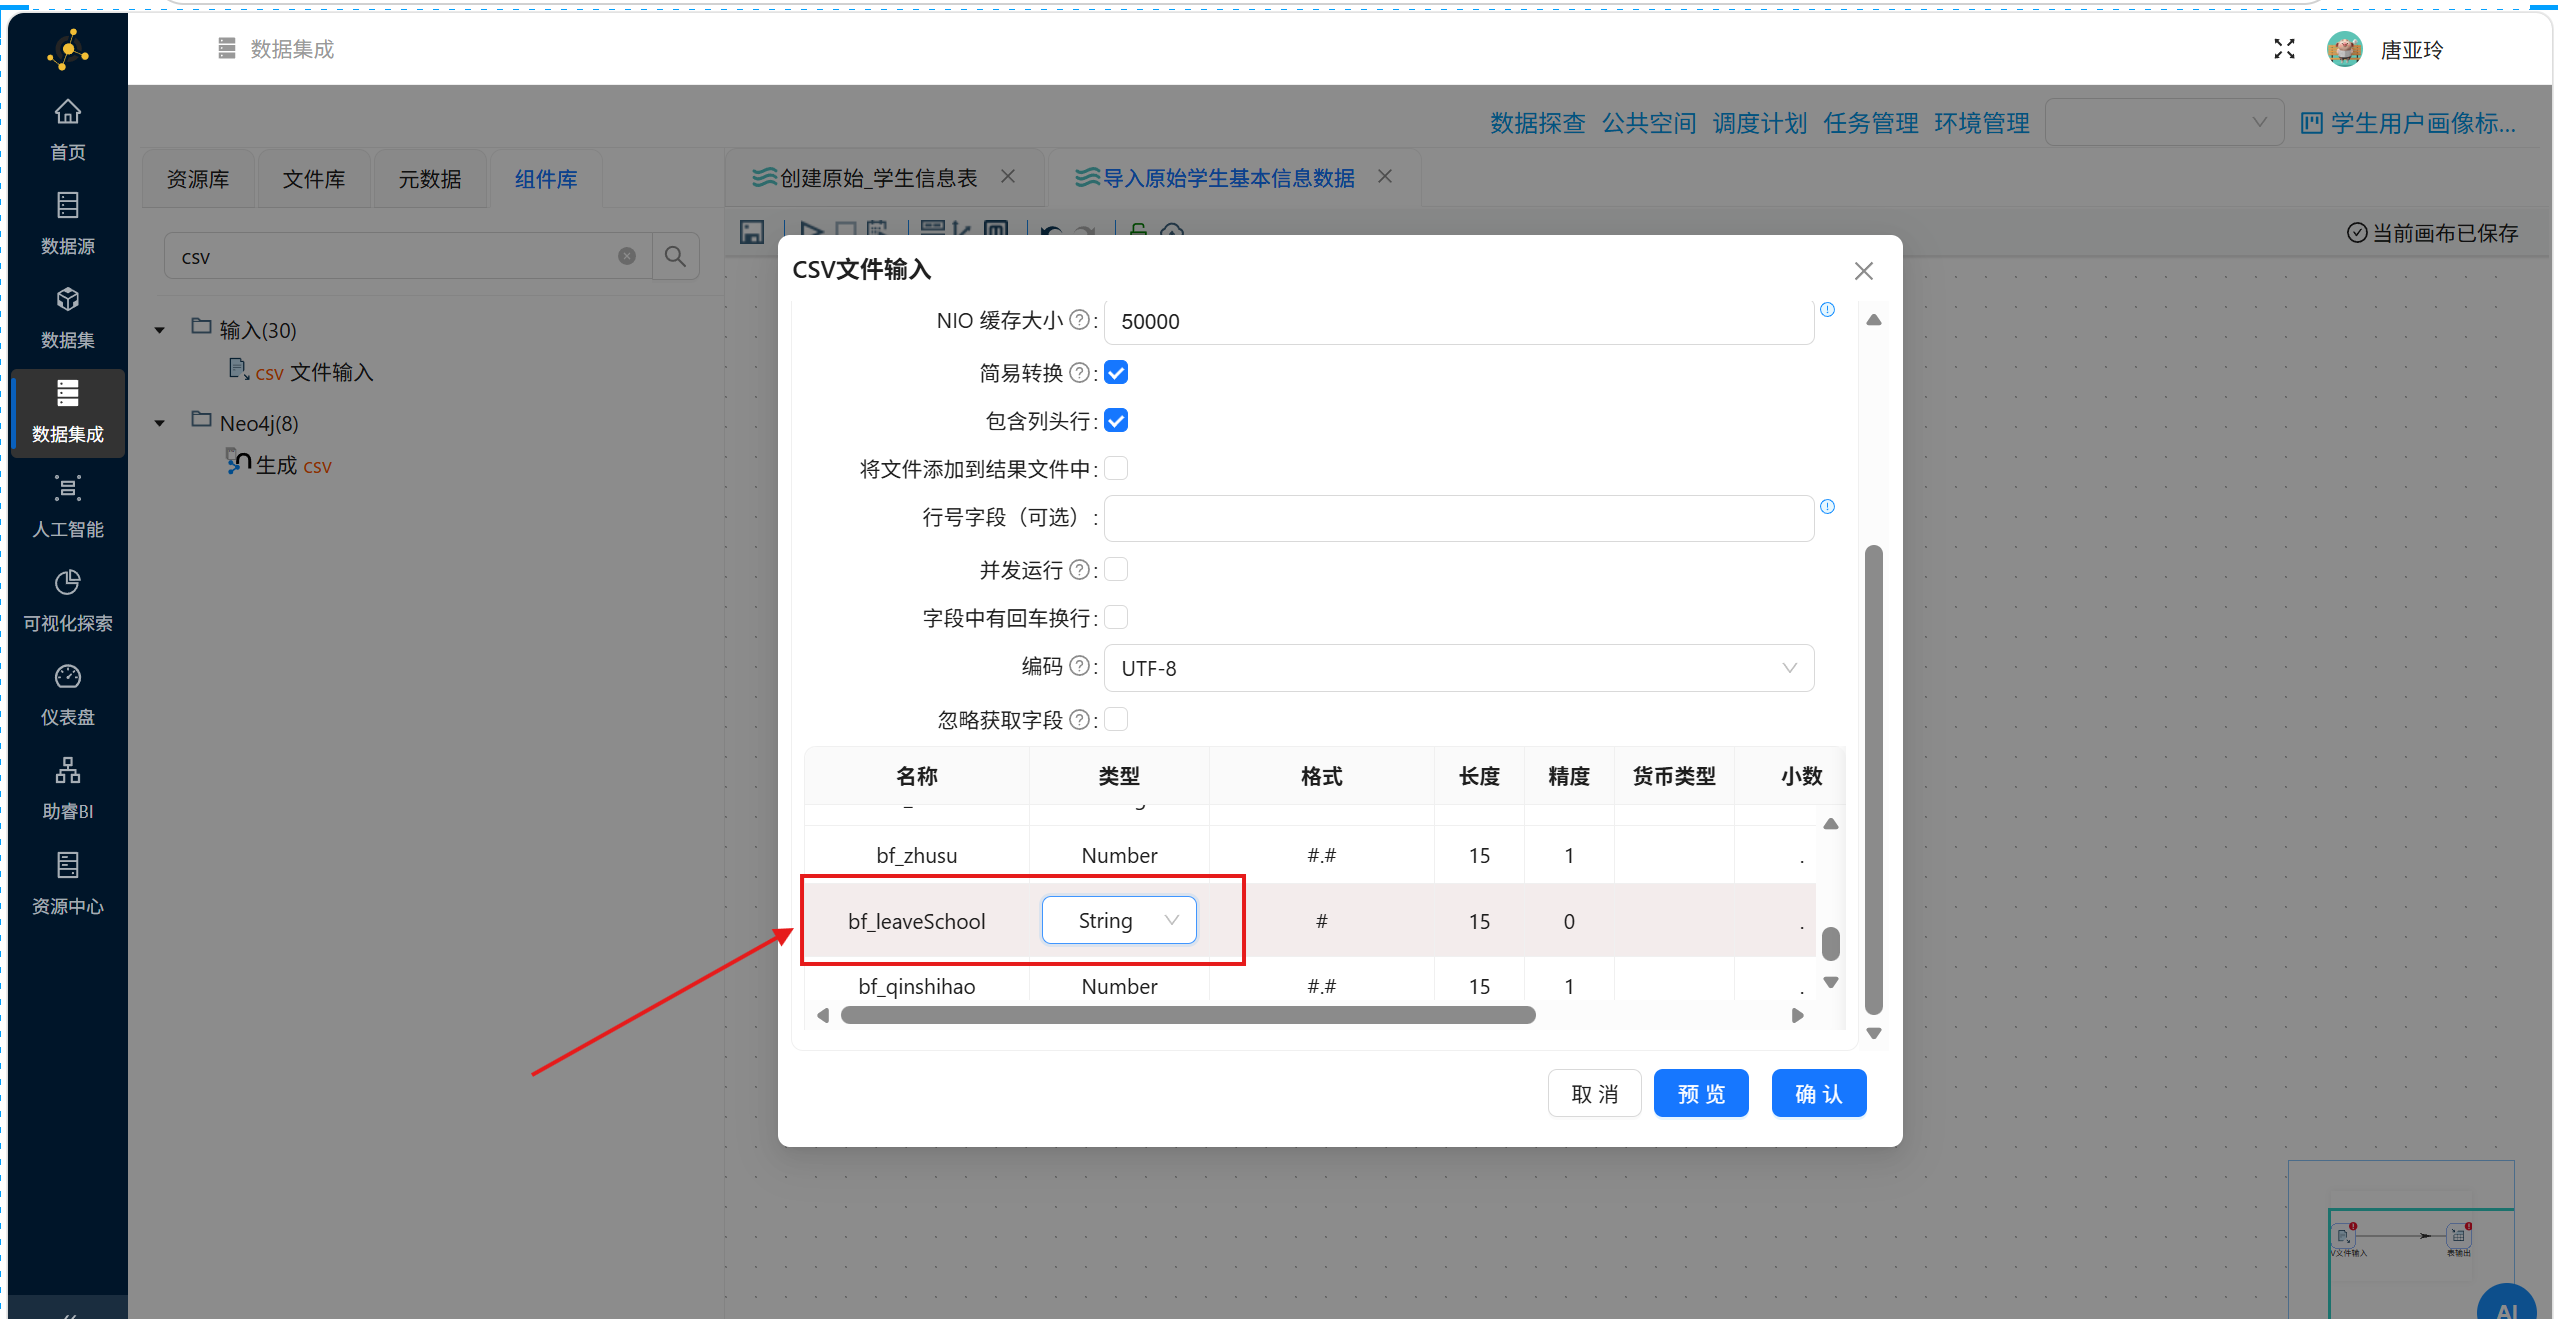
获取字段后,需要将 “bf_leaveSchool” 的字段类型修改为 “String”
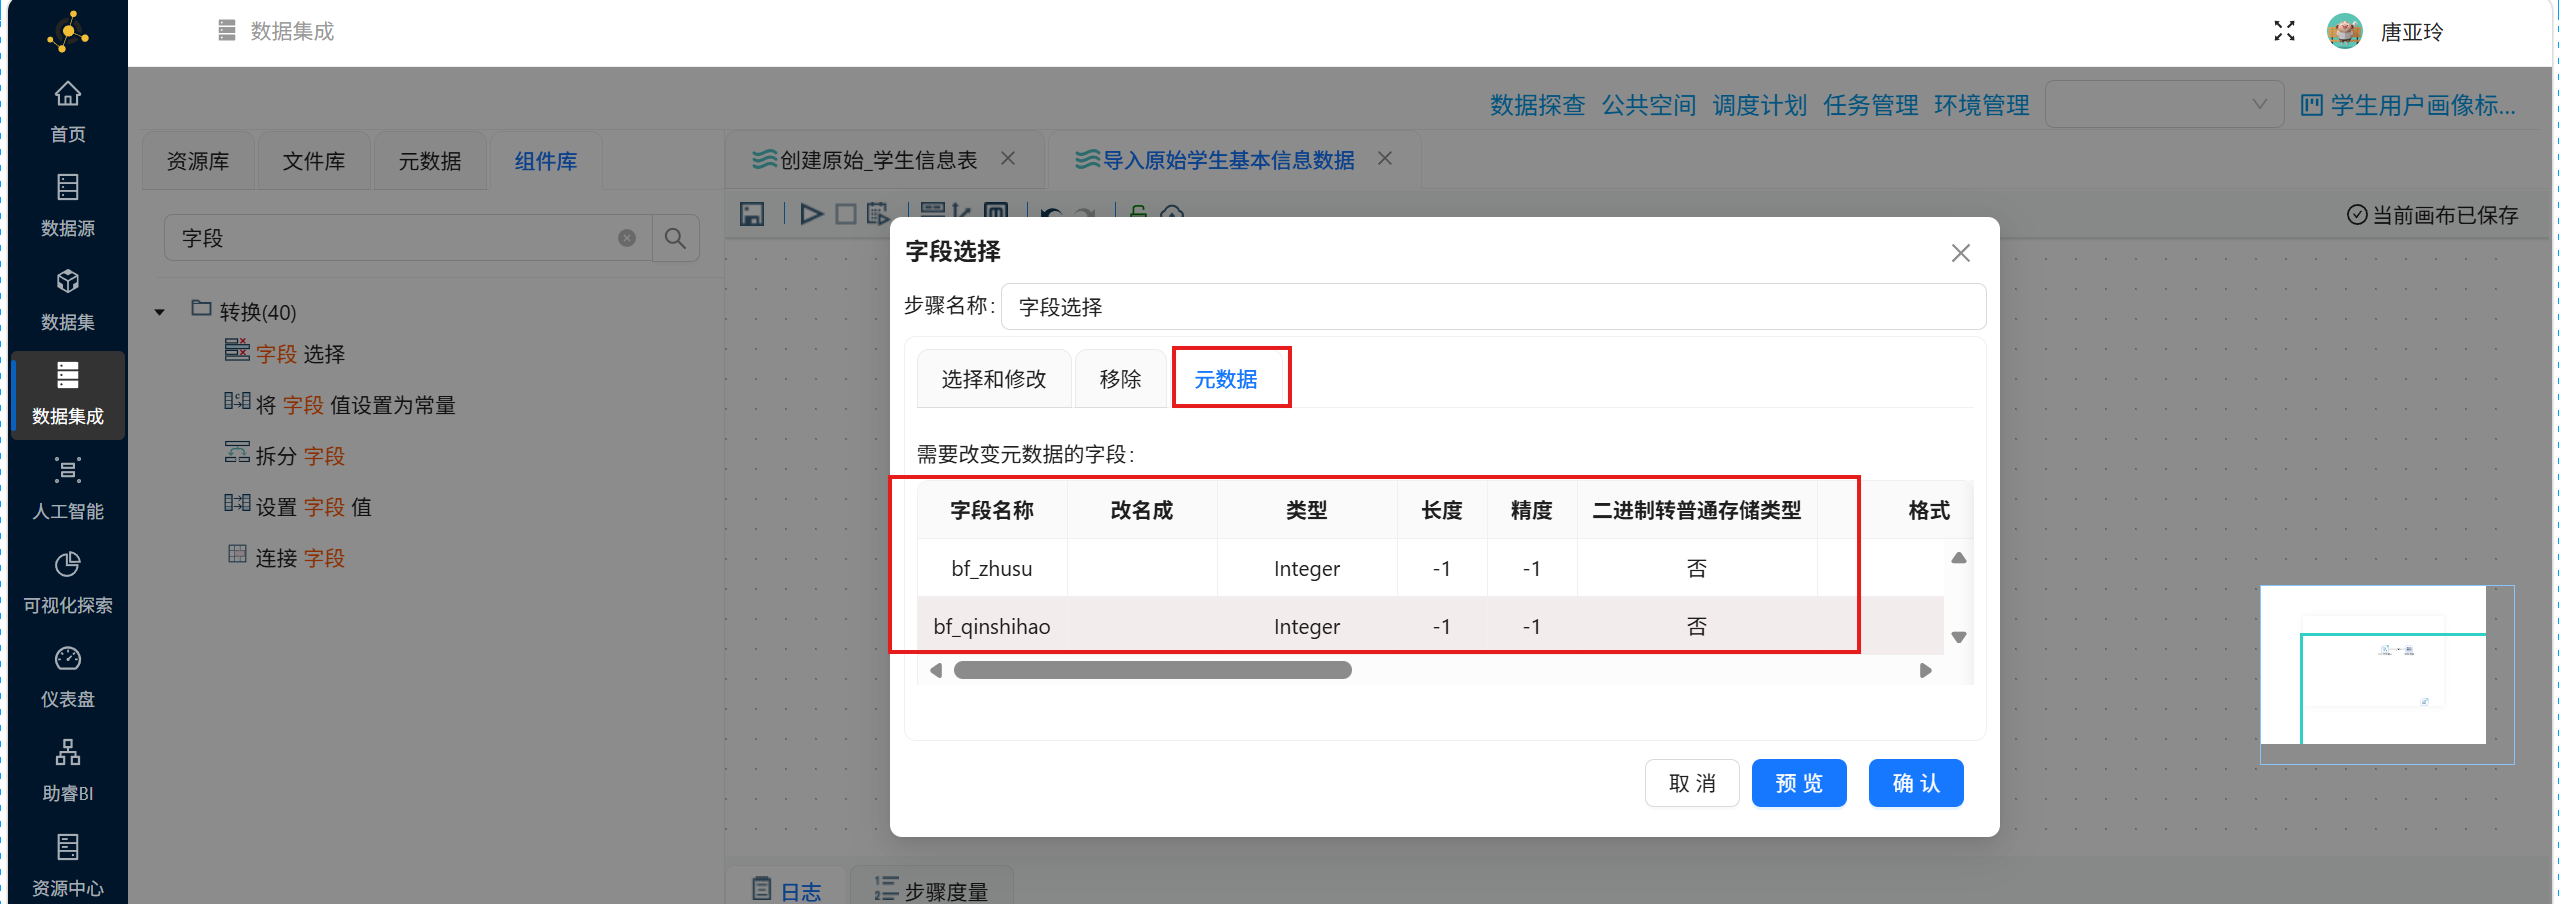
【特别说明】:bf_zhusu、bf_qinshihao 这2个字段是Integer,为避免出现小数,需要使用“字段选择”组件来固化并规范
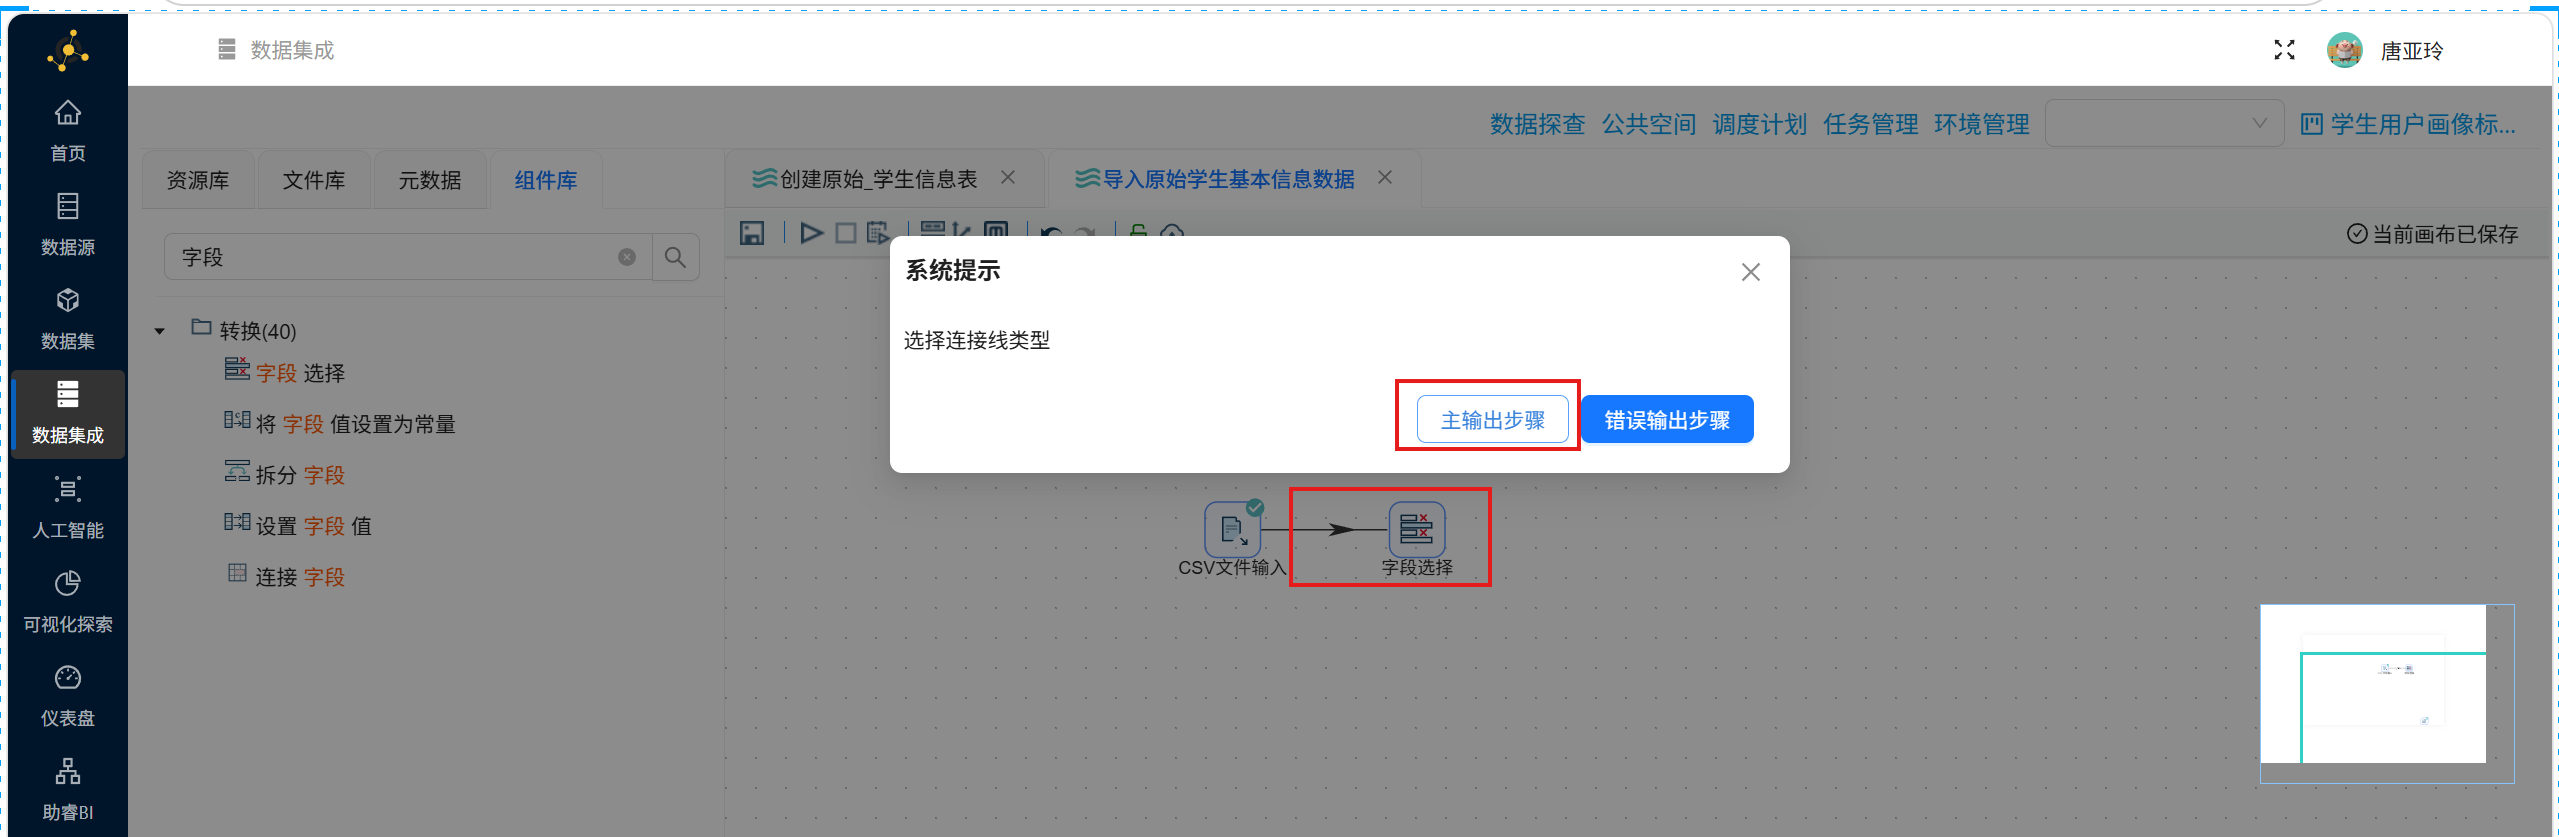
我们需要拖拽一个字段选择组件到画布,并创建连线,连线类型选择 “主输出步骤”
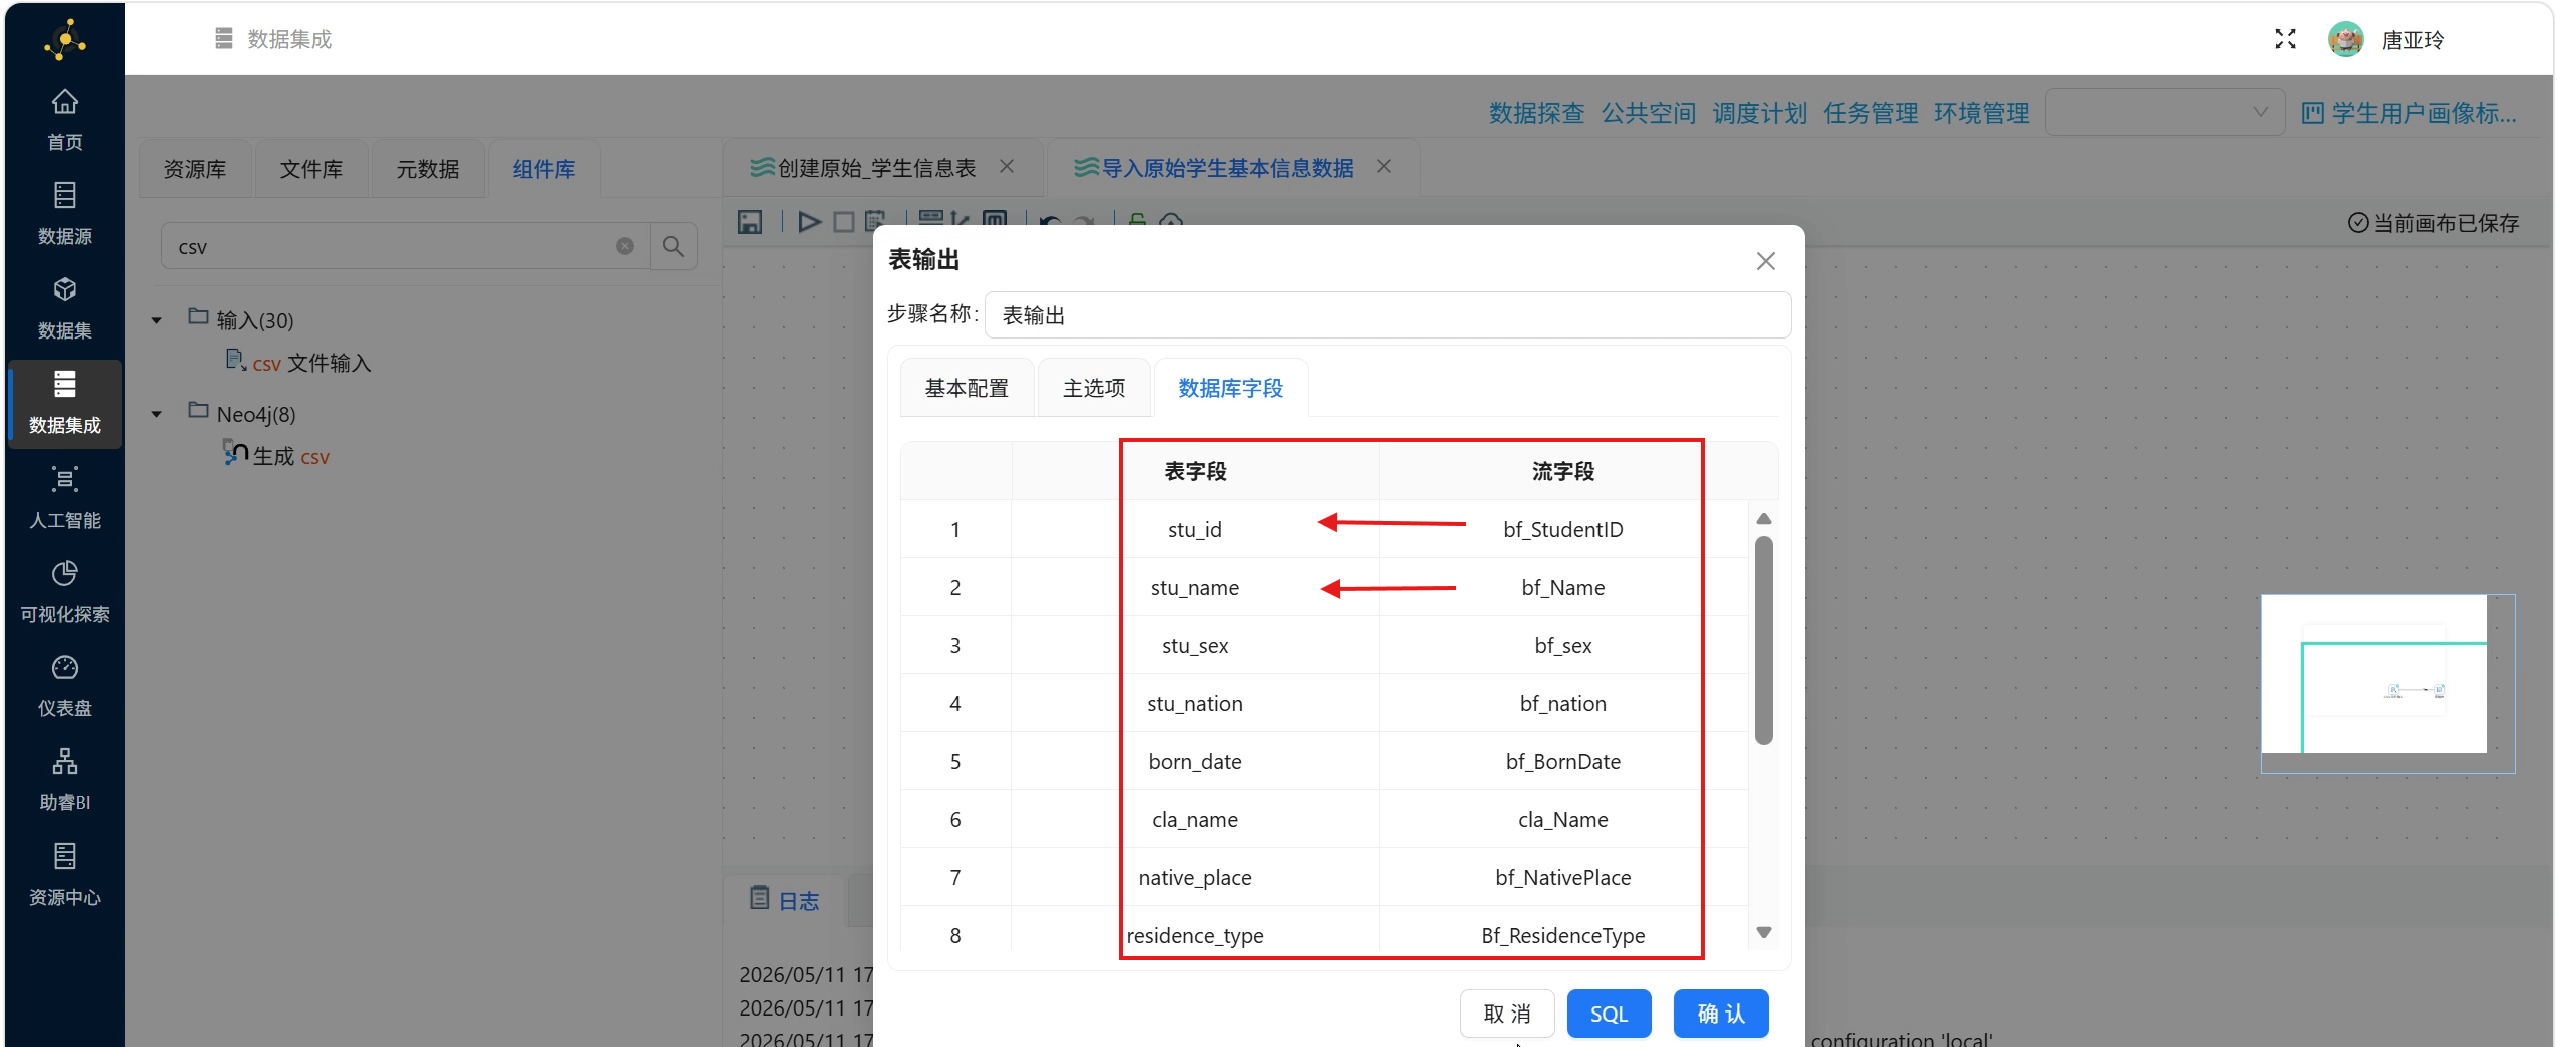
双击“字段选择”组件,在配置窗口中,点击“元数据”,并在空白处插入2行,将“bf_zhusu”、“bf_qinshihao”字段的元数据设置如下:
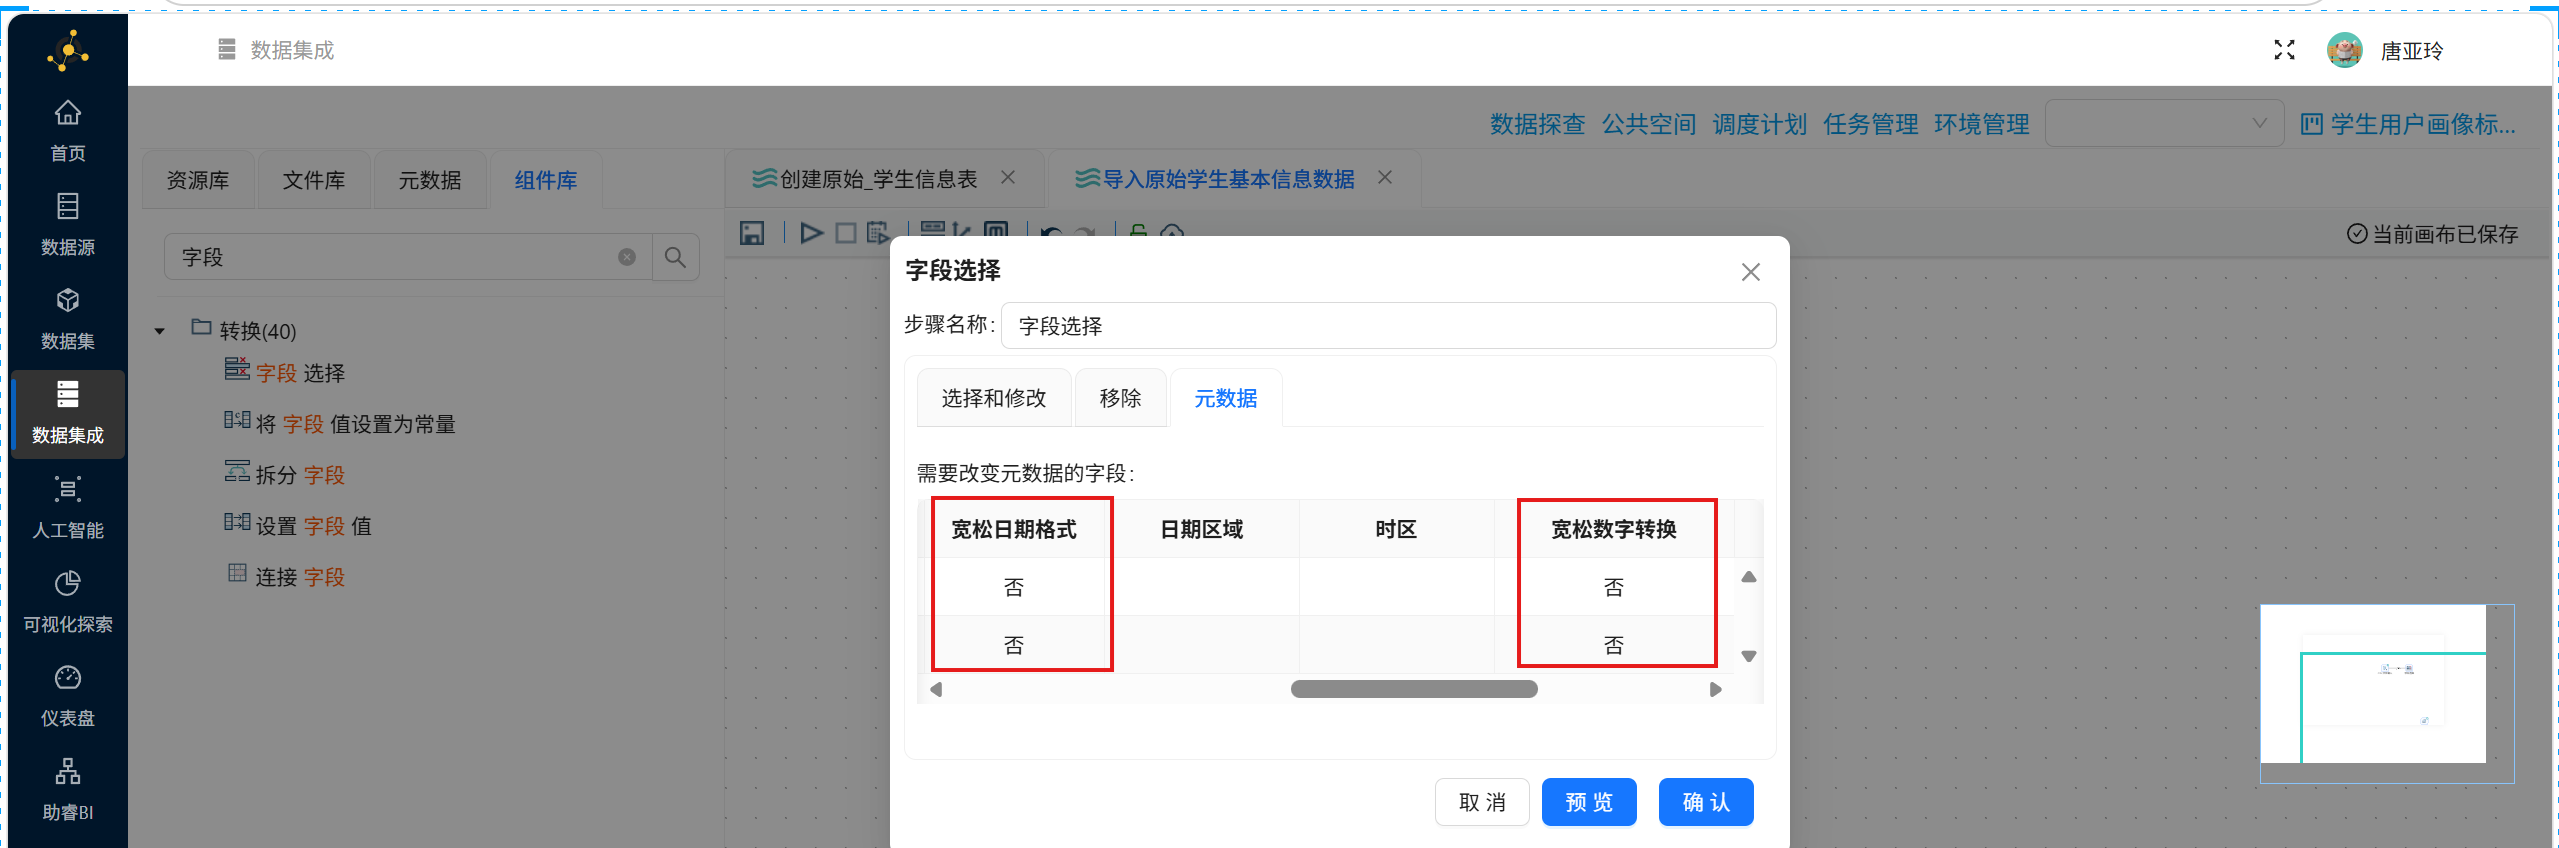
接着,用 “表输出” 组件将 “2_student_info.csv” 数据输出到团队私有数据库的 “raw_student_info中
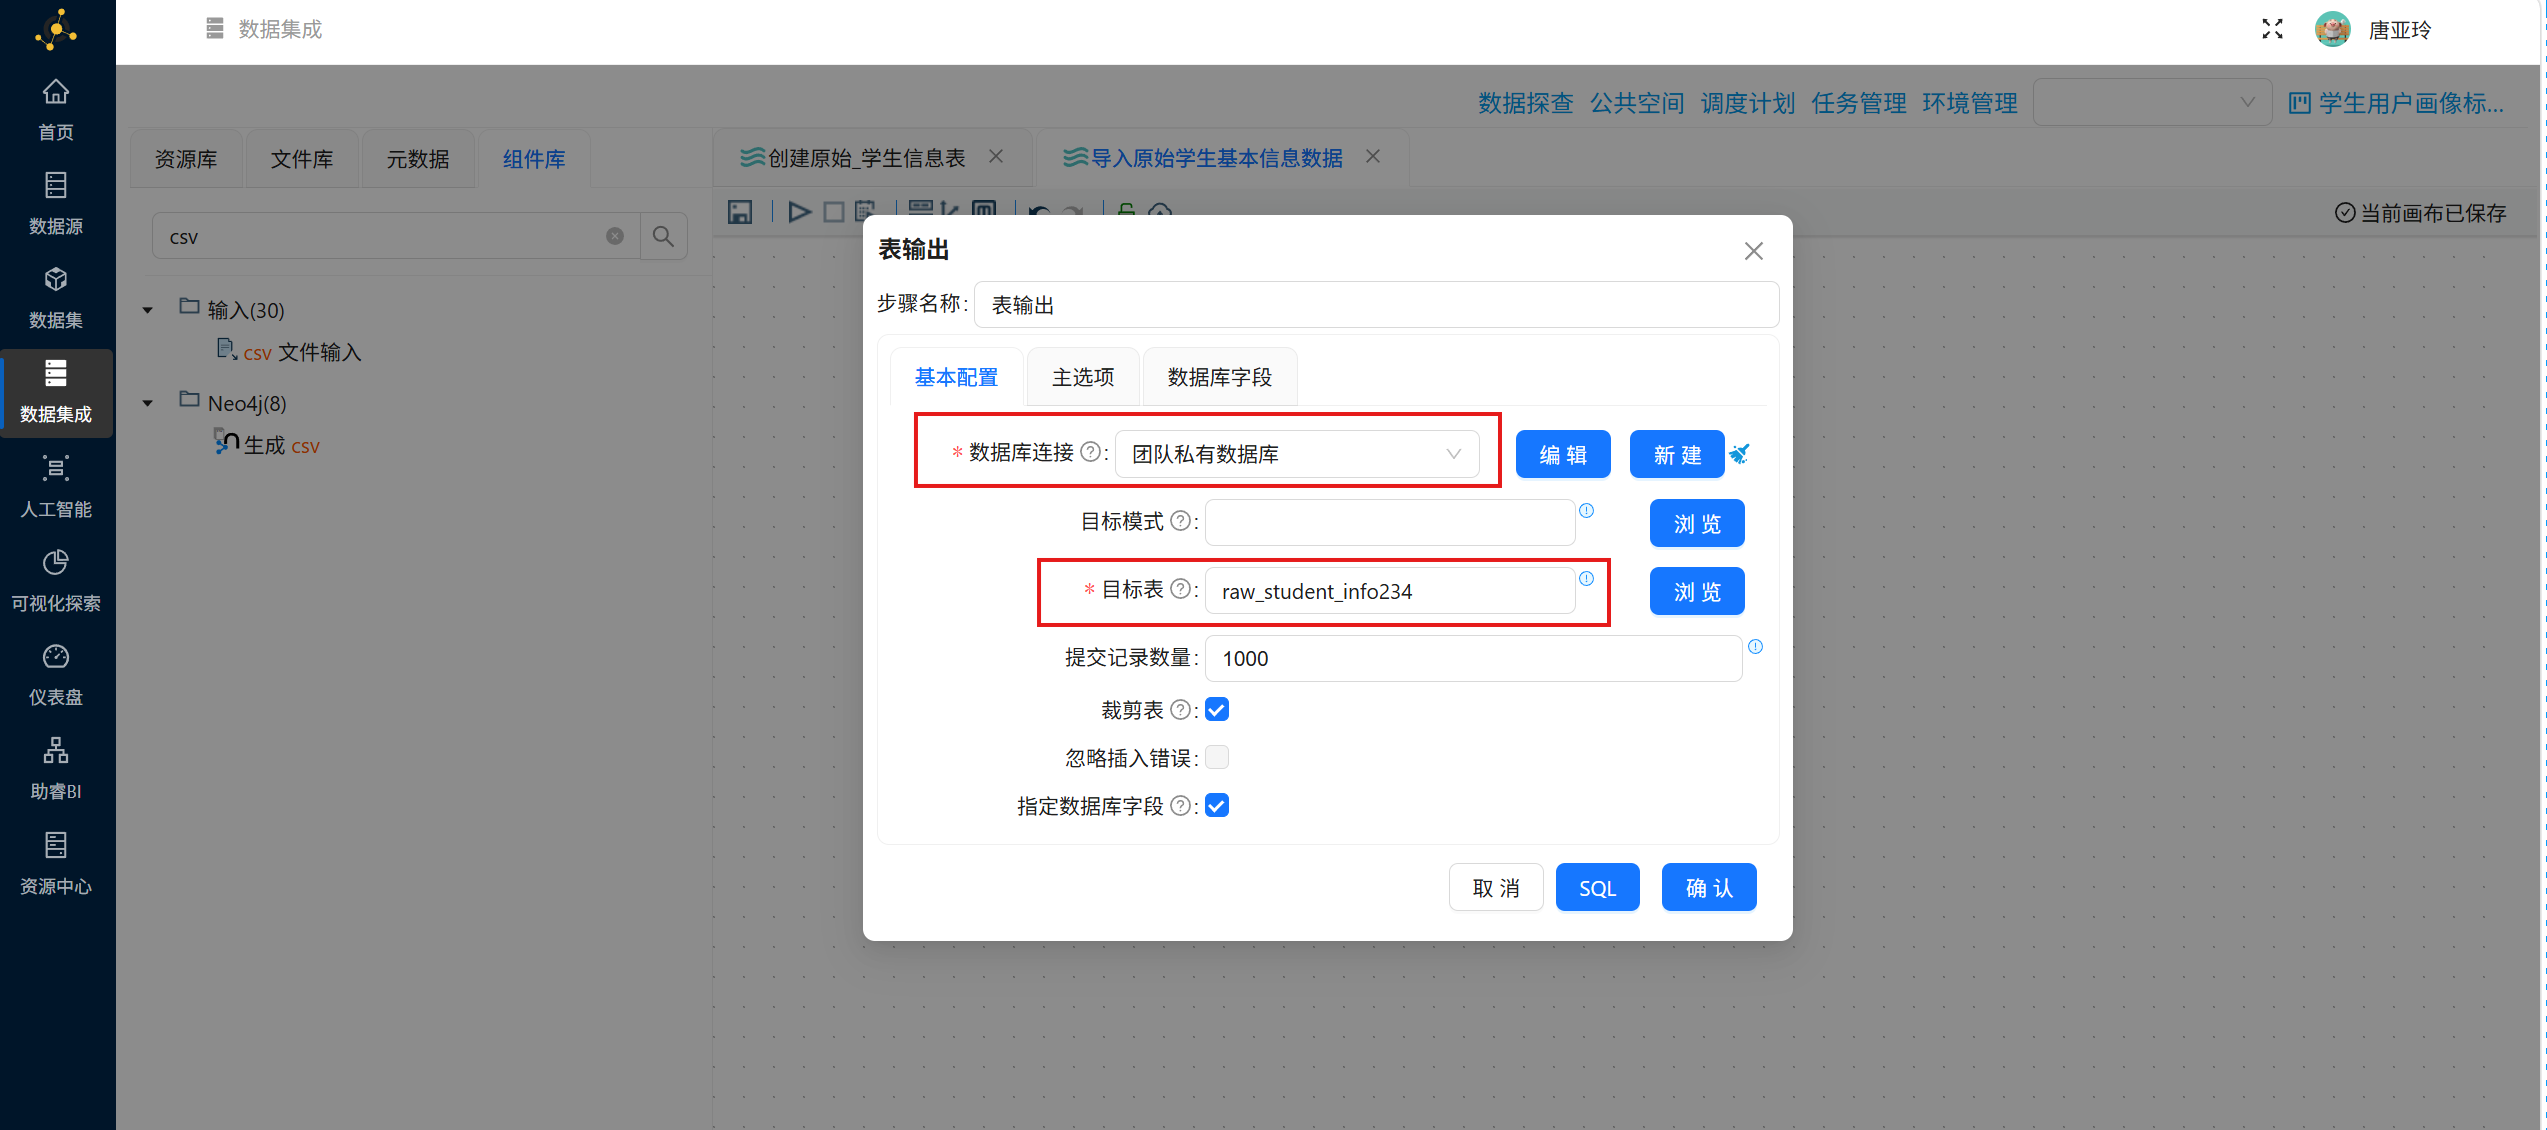
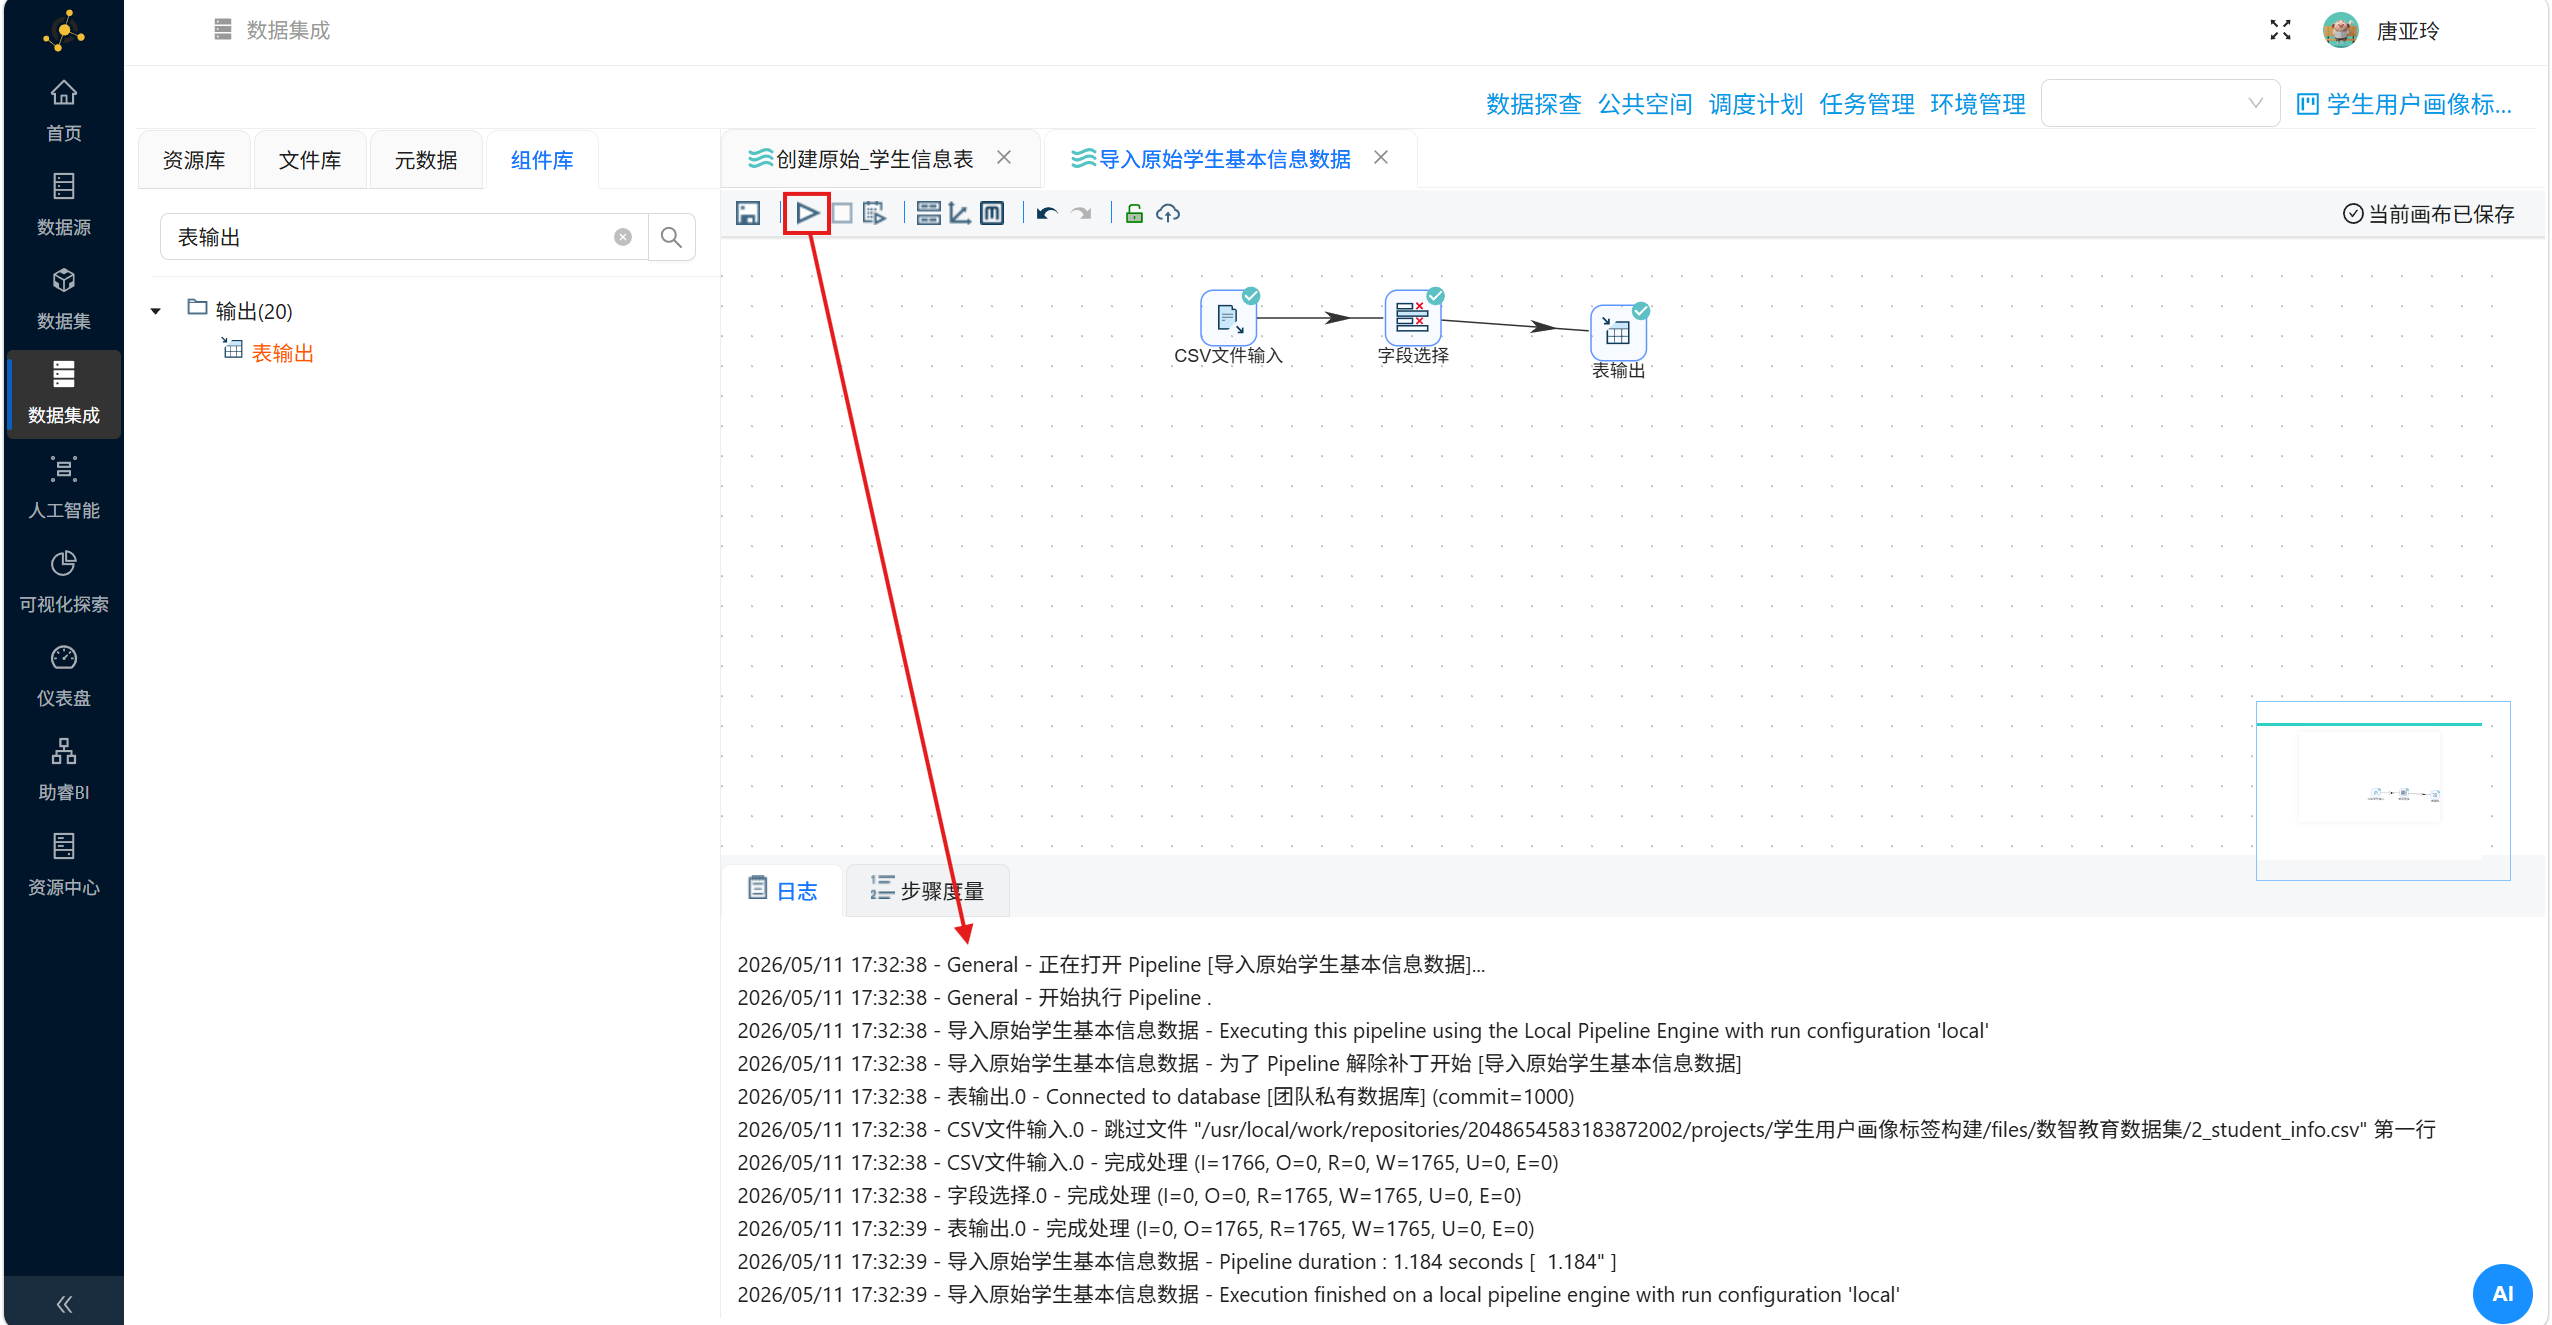
执行转换流
3.5 创建学生考勤主题标签表
新建转换工作流,并命名为“创建学生考勤主题标签表”,在该工作流中拖拽“执行一个SQL脚本”组件,通过执行SQL脚本来创建一个标签表
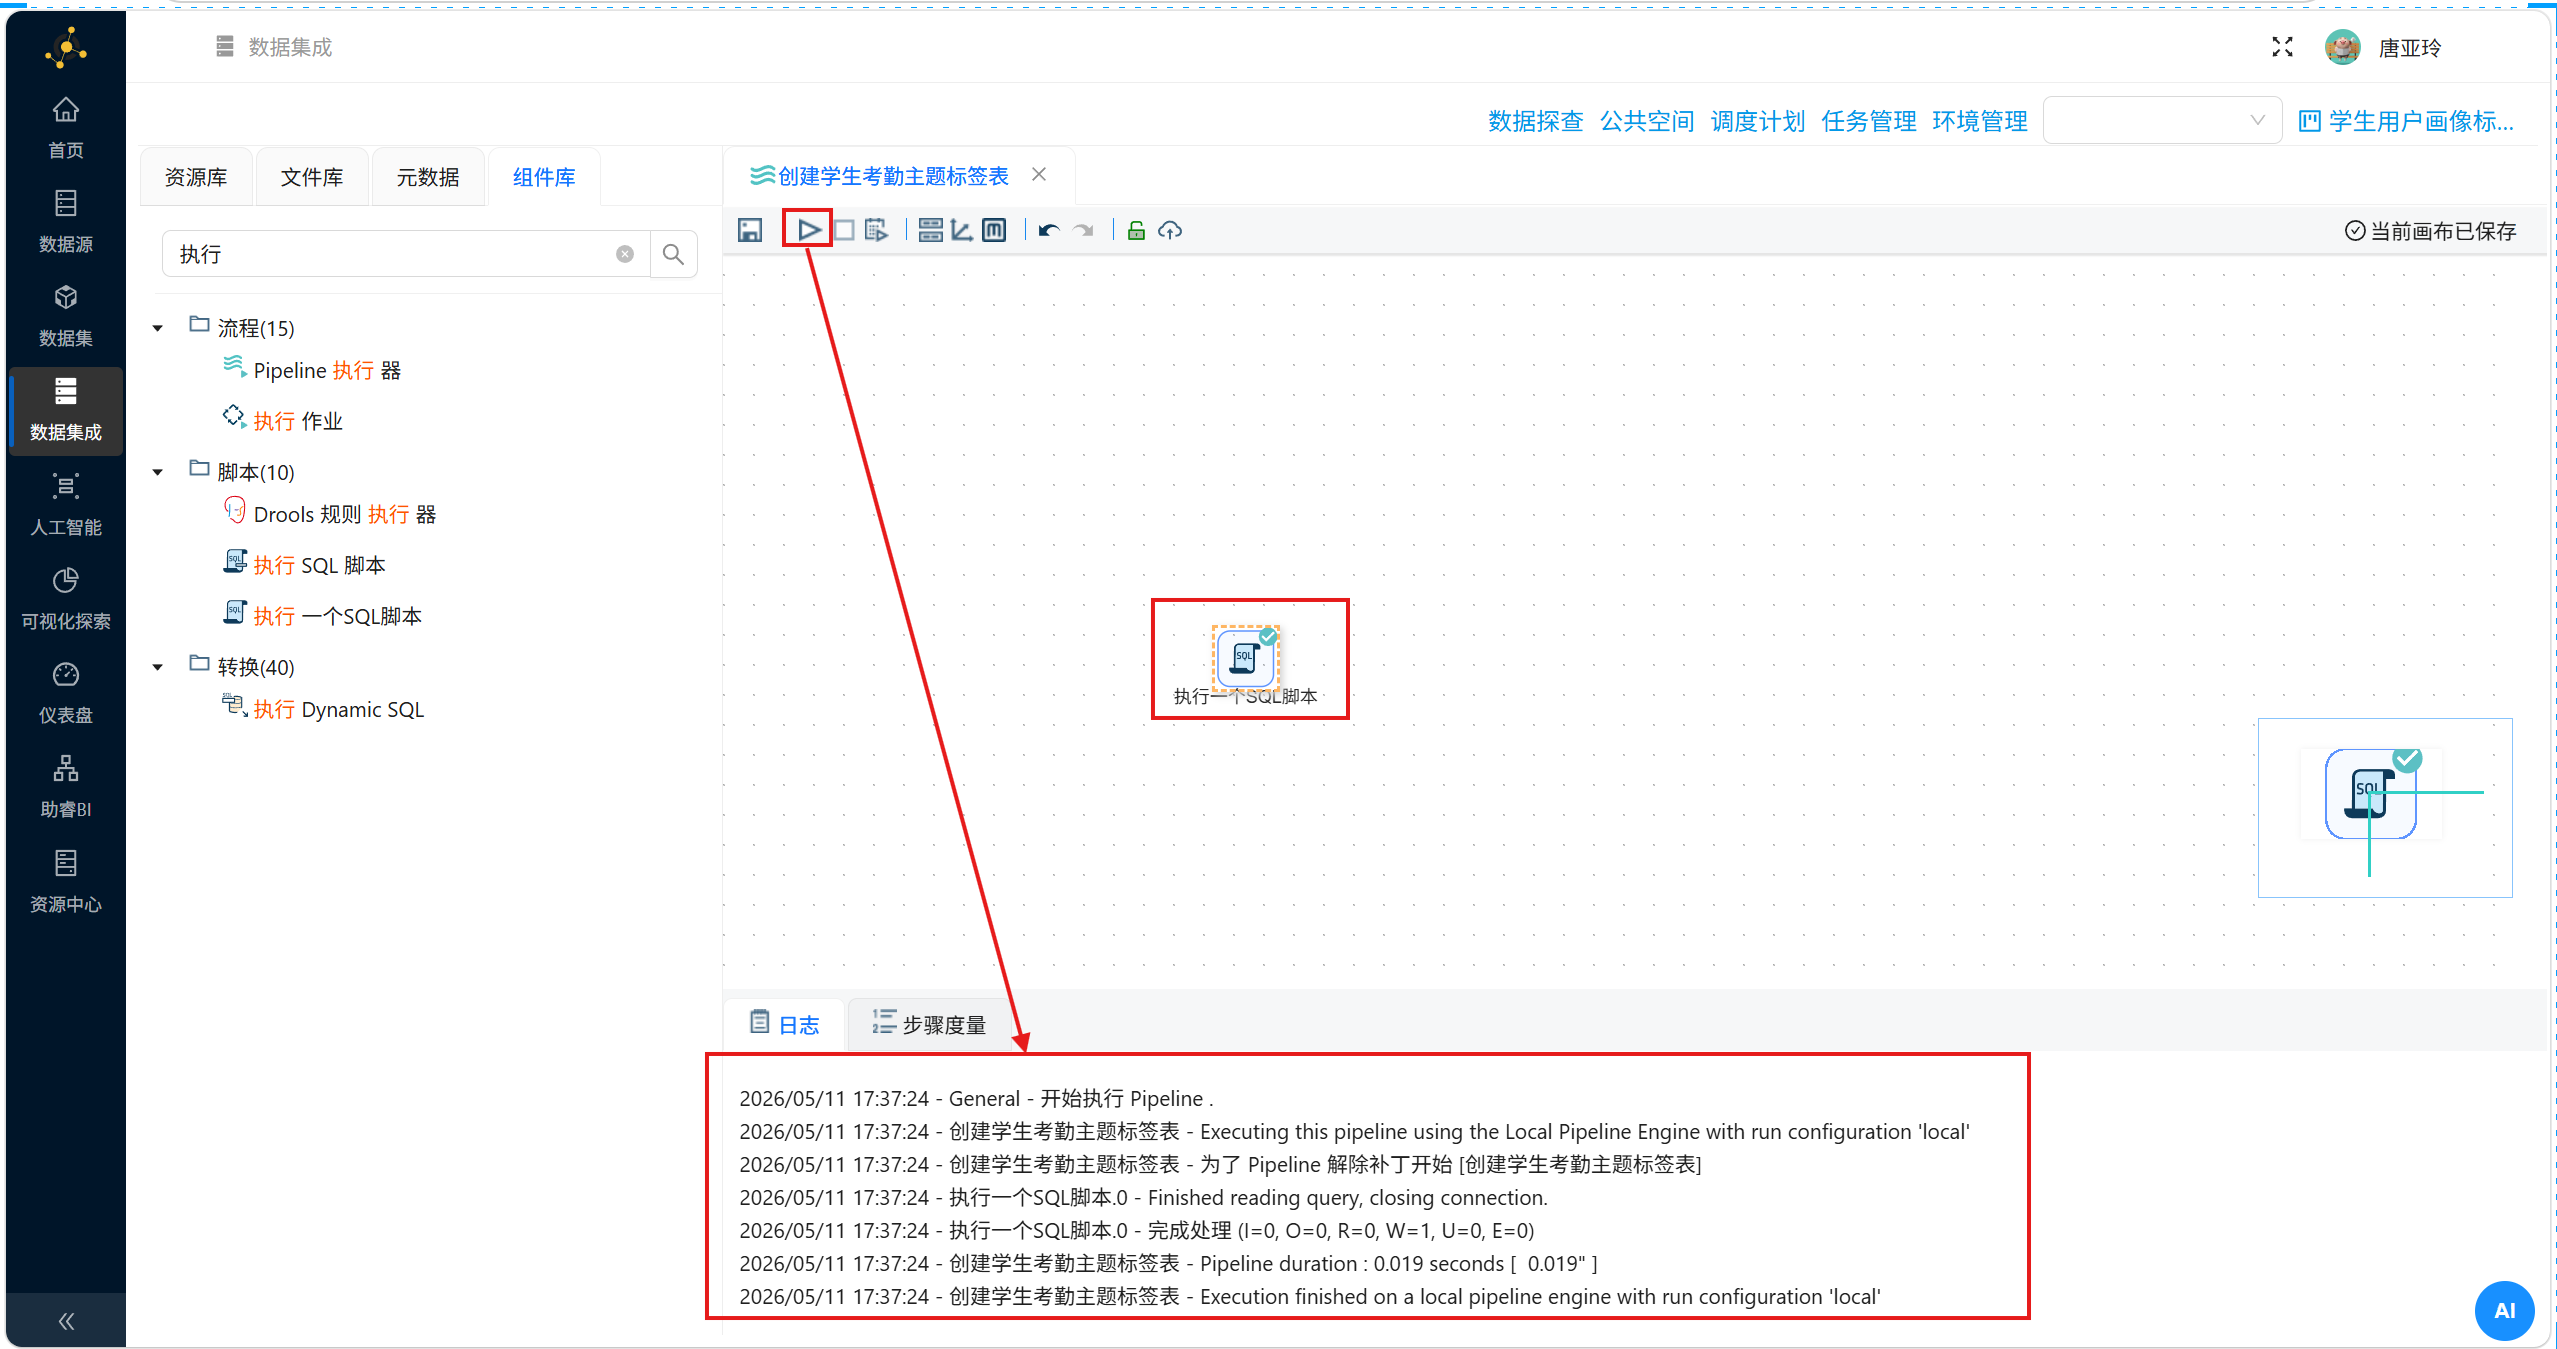
SQL脚本如下:
CREATE TABLE IF NOT EXISTS student_attendance_stats (
    id INT PRIMARY KEY AUTO_INCREMENT COMMENT '自增主键',
    student_id INT NOT NULL COMMENT '学生ID',
    student_name VARCHAR(50) NOT NULL COMMENT '学生姓名',
    class_id INT NOT NULL COMMENT '班级ID',
    class_name VARCHAR(50) NOT NULL COMMENT '班级名称',
    grade VARCHAR(10) NOT NULL COMMENT '年级',
    gender VARCHAR(10) NOT NULL COMMENT '性别',
    birth_date  VARCHAR(10) NOT NULL COMMENT '出生日期',
    political_status VARCHAR(20) NOT NULL COMMENT '政治面貌',
    is_boarder VARCHAR(10) NOT NULL COMMENT '是否住校',
    campus_type VARCHAR(10) NOT NULL COMMENT '校区类型',
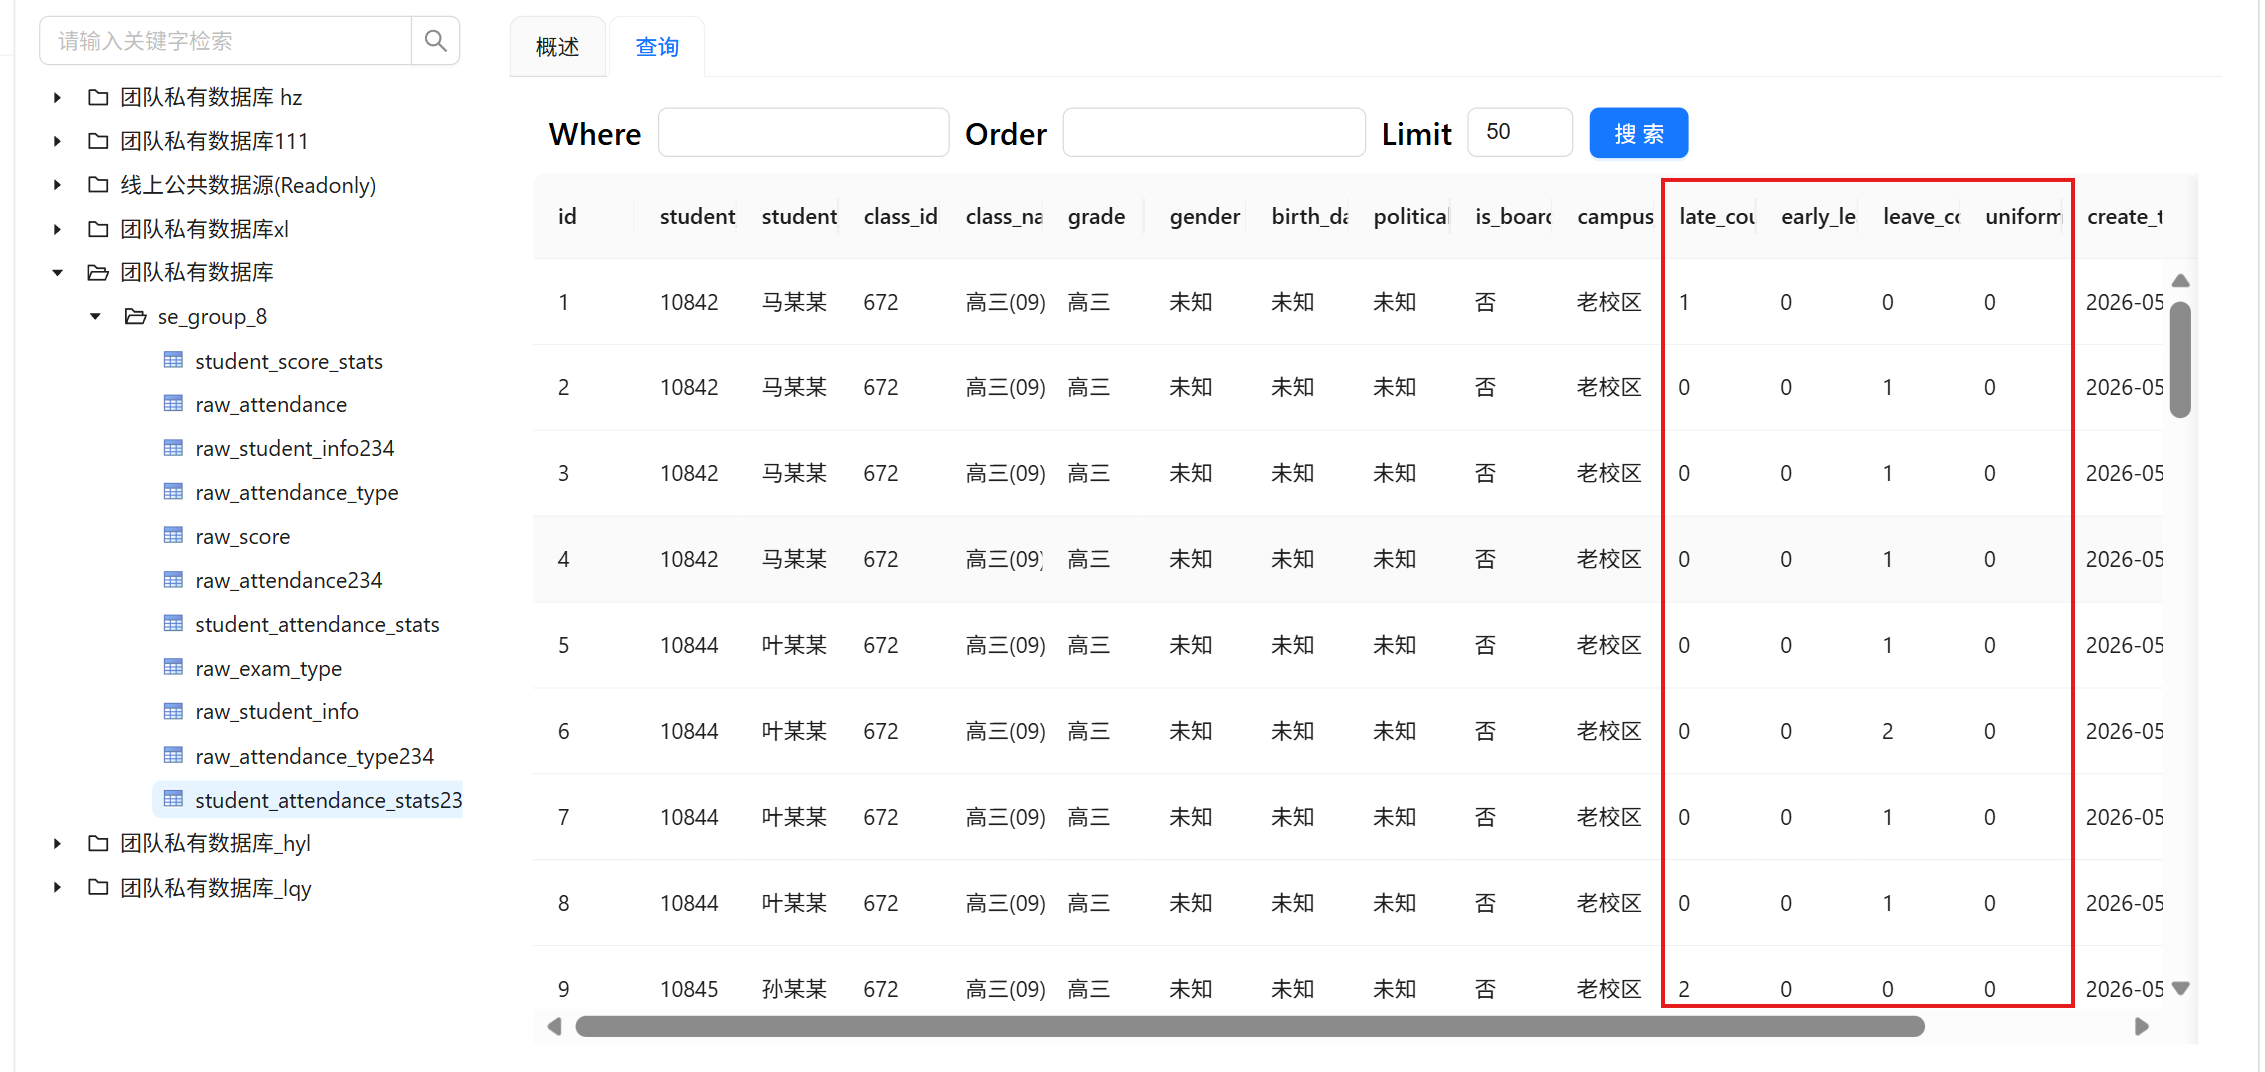
    late_count INT NOT NULL DEFAULT 0 COMMENT '迟到次数',
    early_leave_count INT NOT NULL DEFAULT 0 COMMENT '早退次数',
    leave_count INT NOT NULL DEFAULT 0 COMMENT '请假次数',
    uniform_violate_count INT NOT NULL DEFAULT 0 COMMENT '没穿校服次数',
    create_time DATETIME DEFAULT CURRENT_TIMESTAMP COMMENT '统计入库时间',
    INDEX idx_student (student_id),
    INDEX idx_class (class_id),
    INDEX idx_grade (grade)
)  ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COMMENT='学生考勤主题标签表';
3.6 学生考勤主题标签构建【核心】
3.6.1 数据转换流逻辑说明
转换流遵循“数据接入—清洗整合—维度拆解—标签标记—指标计算—结果落地”的核心逻辑:
-
数据接入:接入考勤原始打卡表、考勤类型码表、学生信息基础表
-
数据整合:多表关联,给原始打卡记录绑定学生班级、住校属性、考勤事件名称
-
标签标记:通过考勤事件名称自动识别迟到、早退、请假、未穿校服等行为
-
指标计算:按日核算在校时长,按多维度聚合统计各类异常次数
-
结果落地:统一写入考勤统计结果表,供报表、查询、分析直接使用
3.6.2 数据接入:获取考勤记录、考勤类型数据、学生信息数据
- 考勤记录表记录了每位学生每天的考勤行为
- 考勤类型表定义了每种考勤行为对应的类型名称(如正常考勤、没穿校服等)
- 学生信息表提供了学生是否住校的核心属性
只有将这三份数据分别接入并后续关联起来,才能完整判断学生的每次考勤是正常还是违纪,同时支撑住校相关维度的统计。所以我们需要先获取这3个数据。
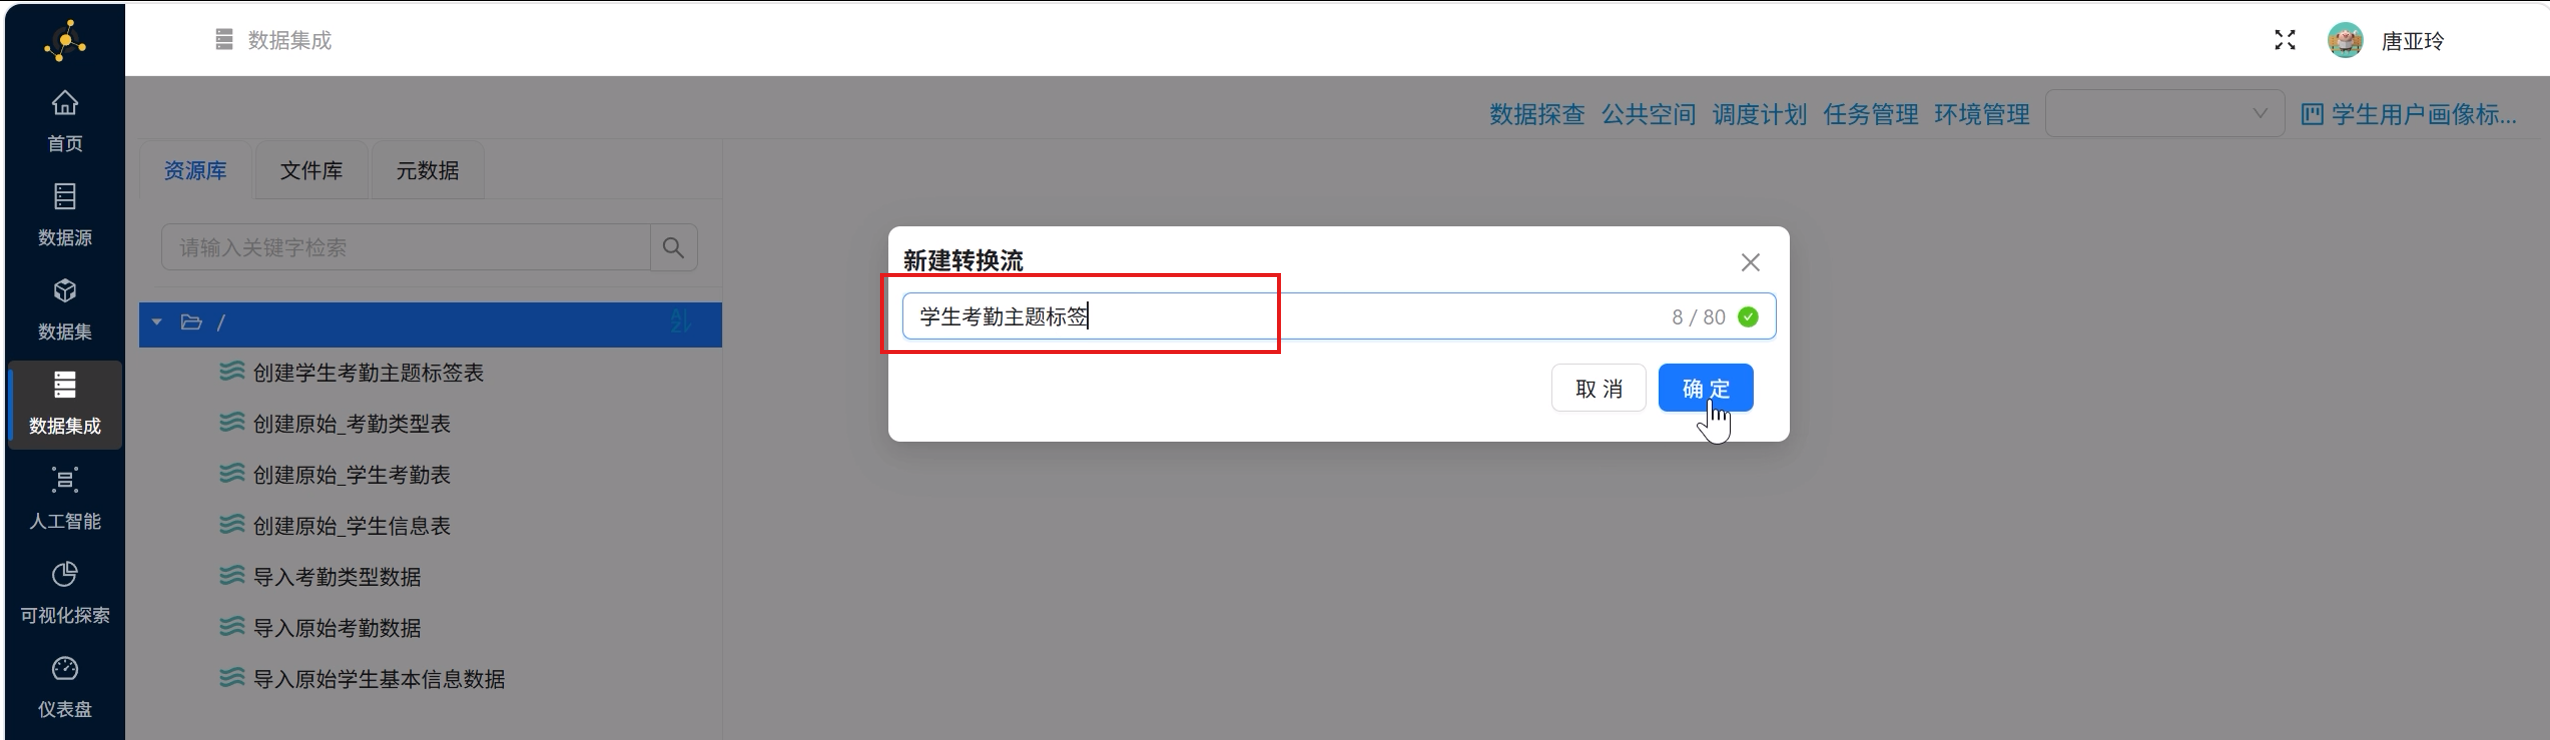
切换到资源库,同样右键根目录,点击 “新建转换流” 并命名为 “学生考勤主题标签”
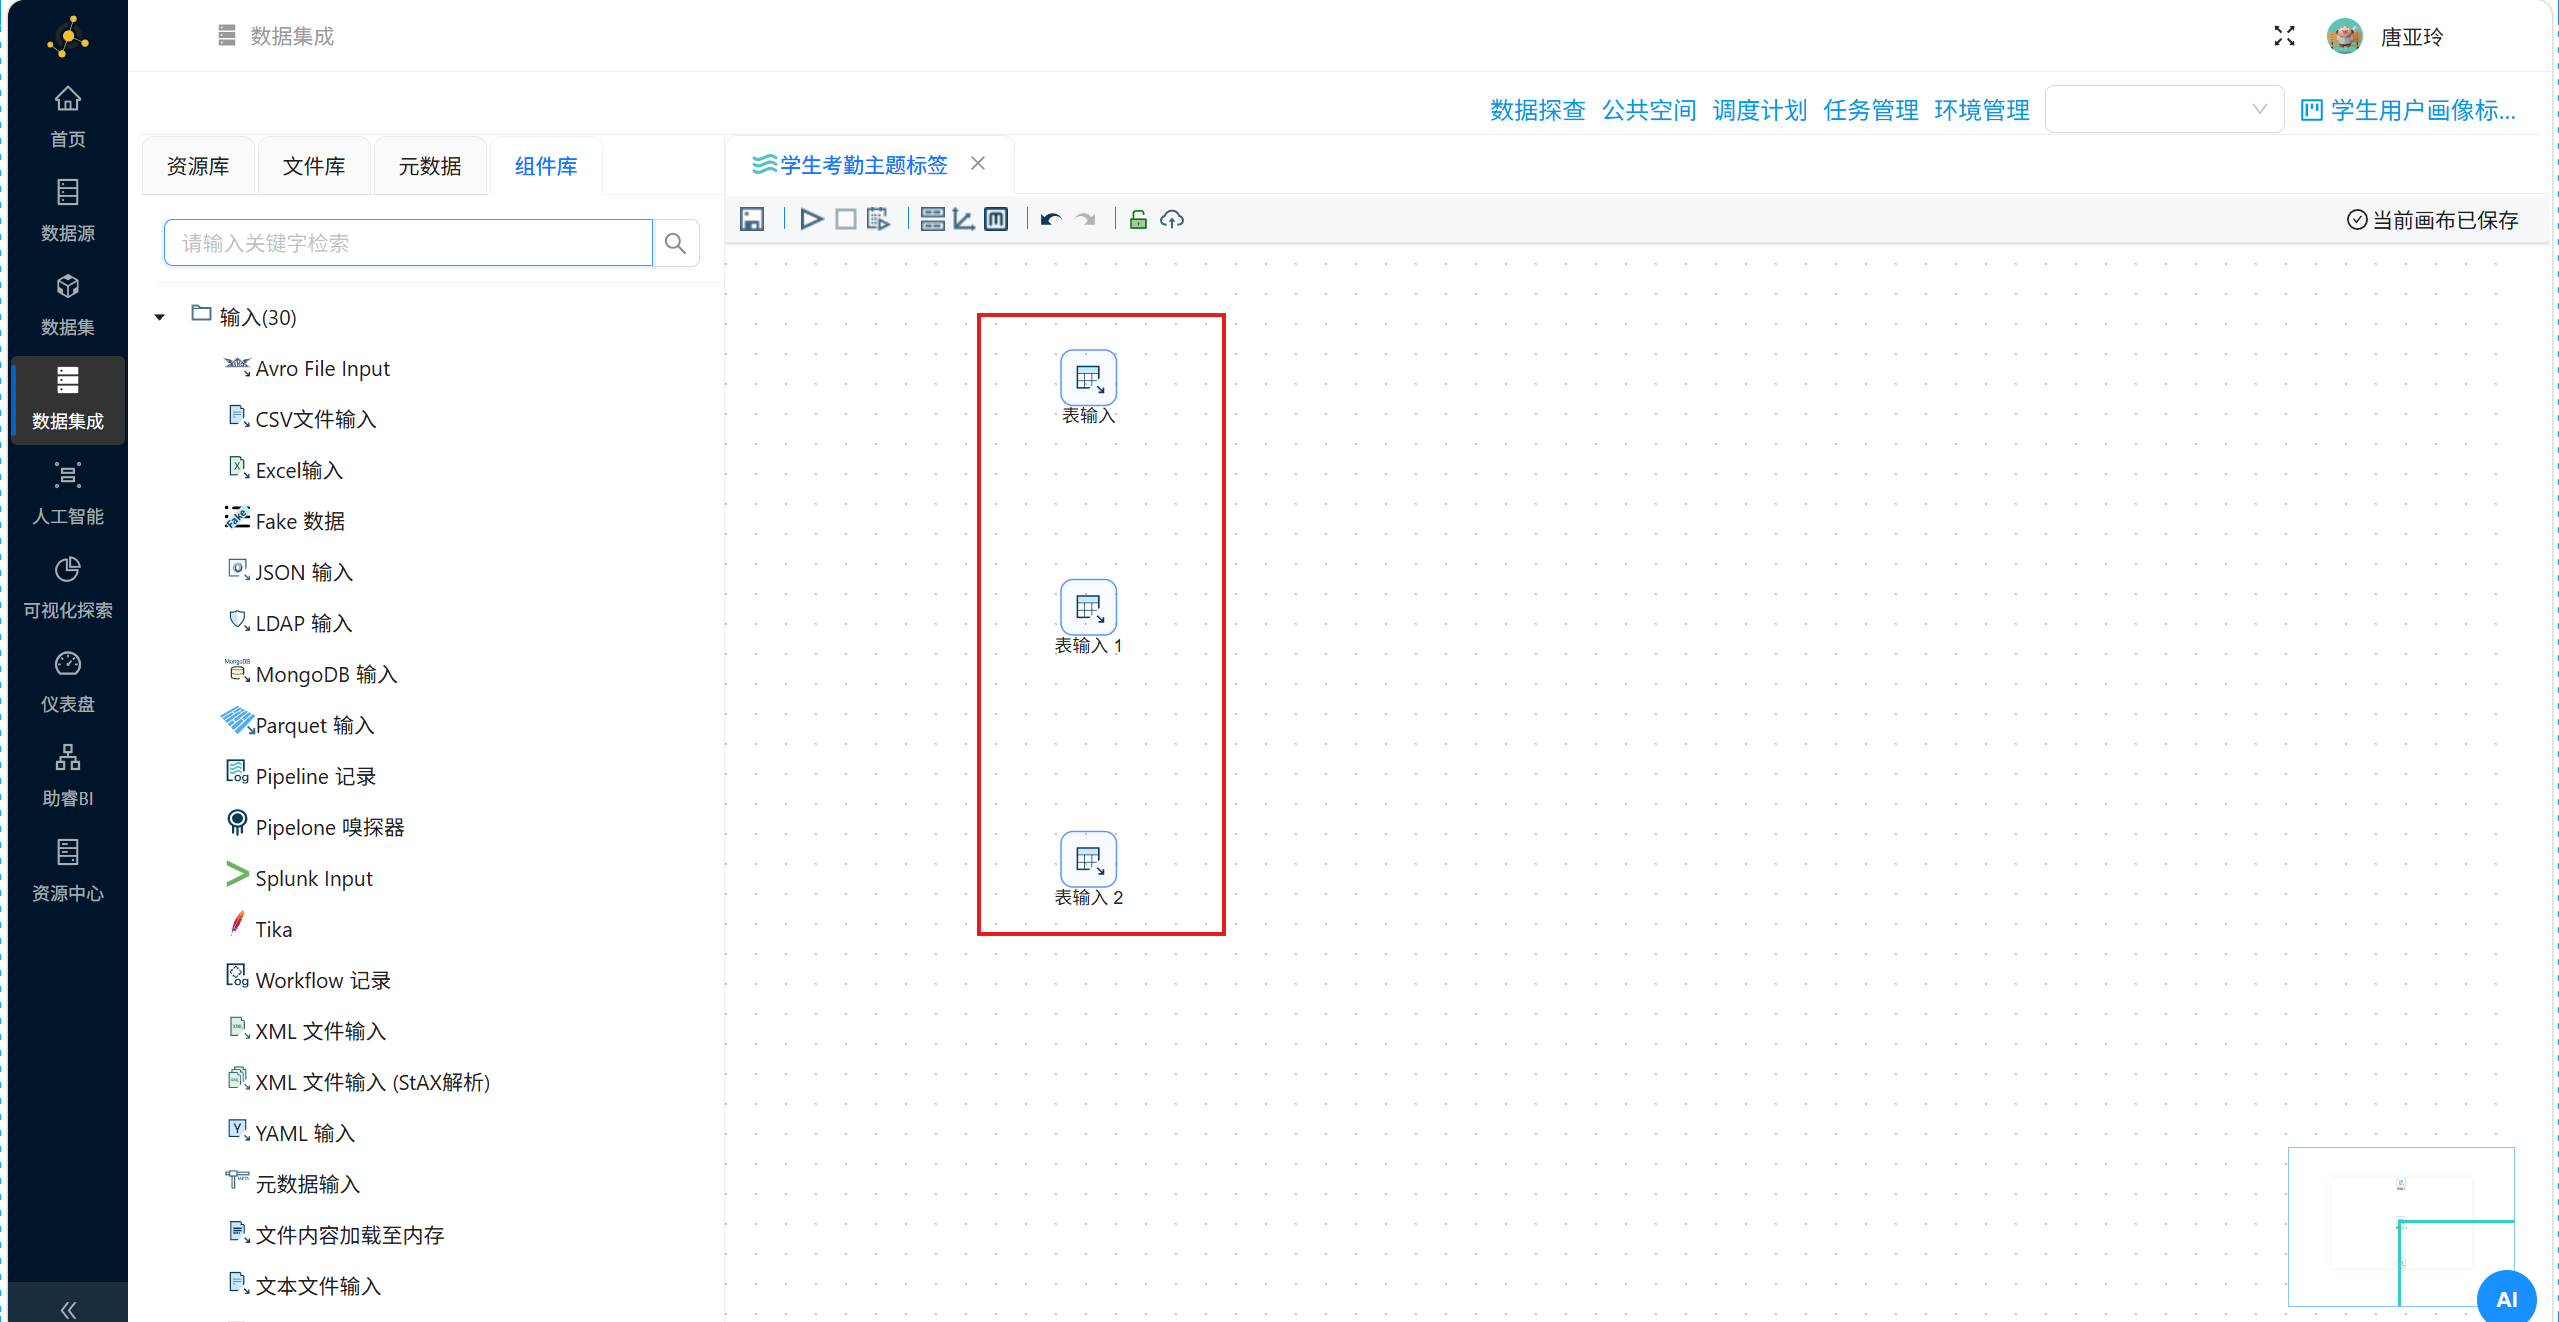
点击 “组件库” ,拖拽3个表输入组件至画布中
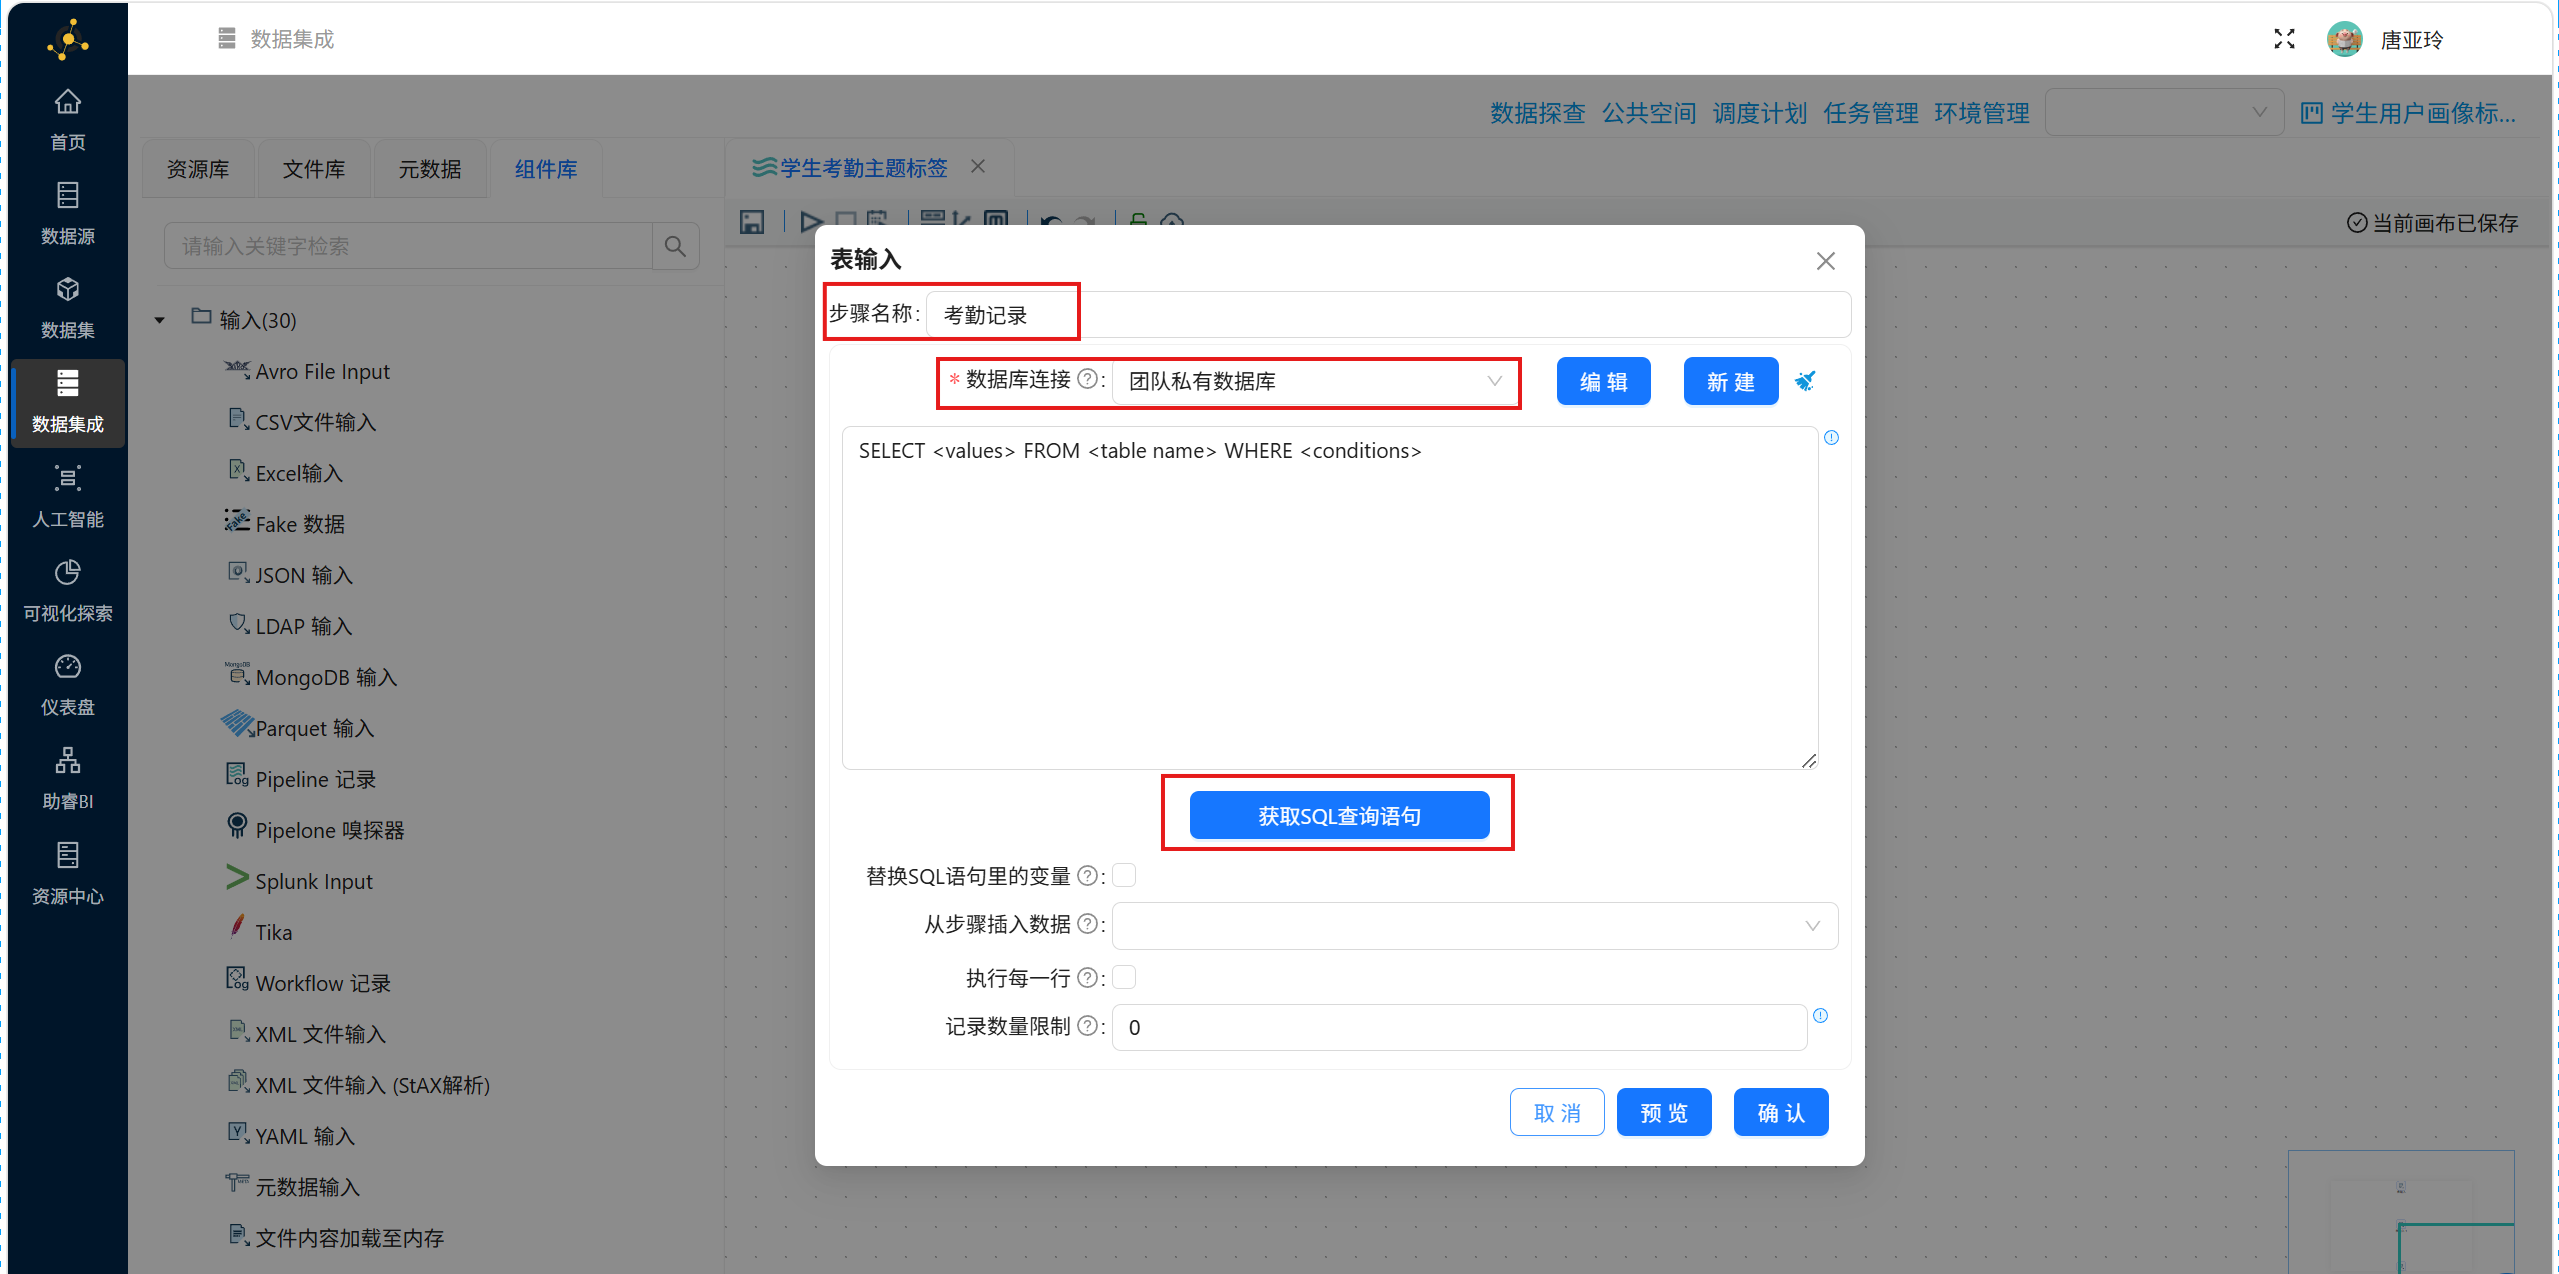
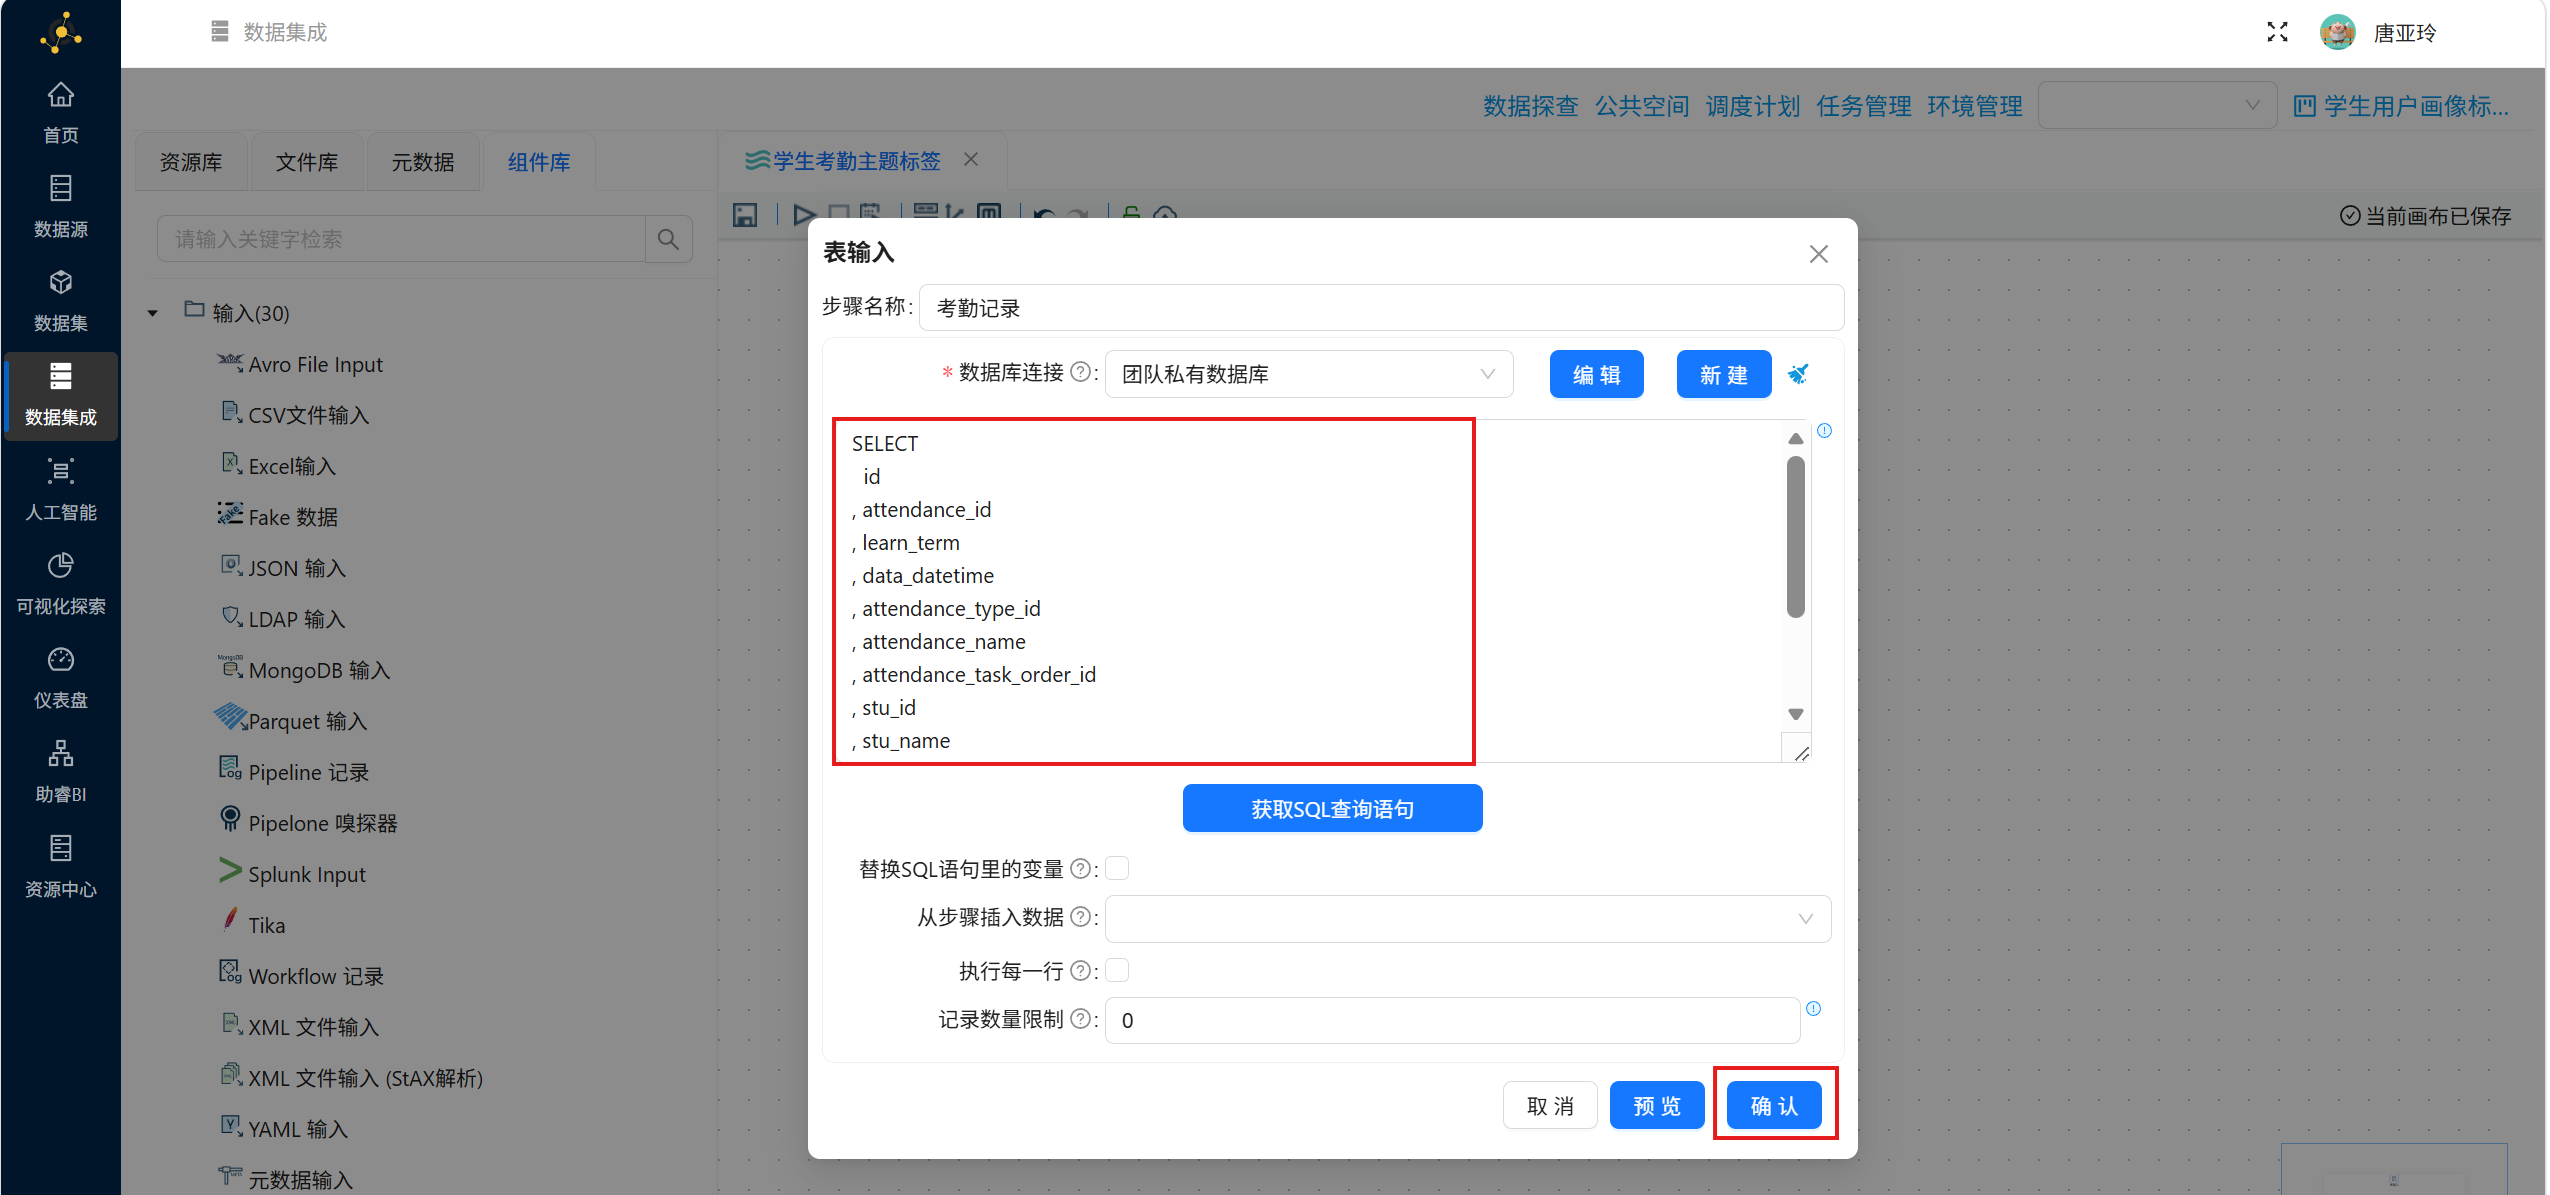
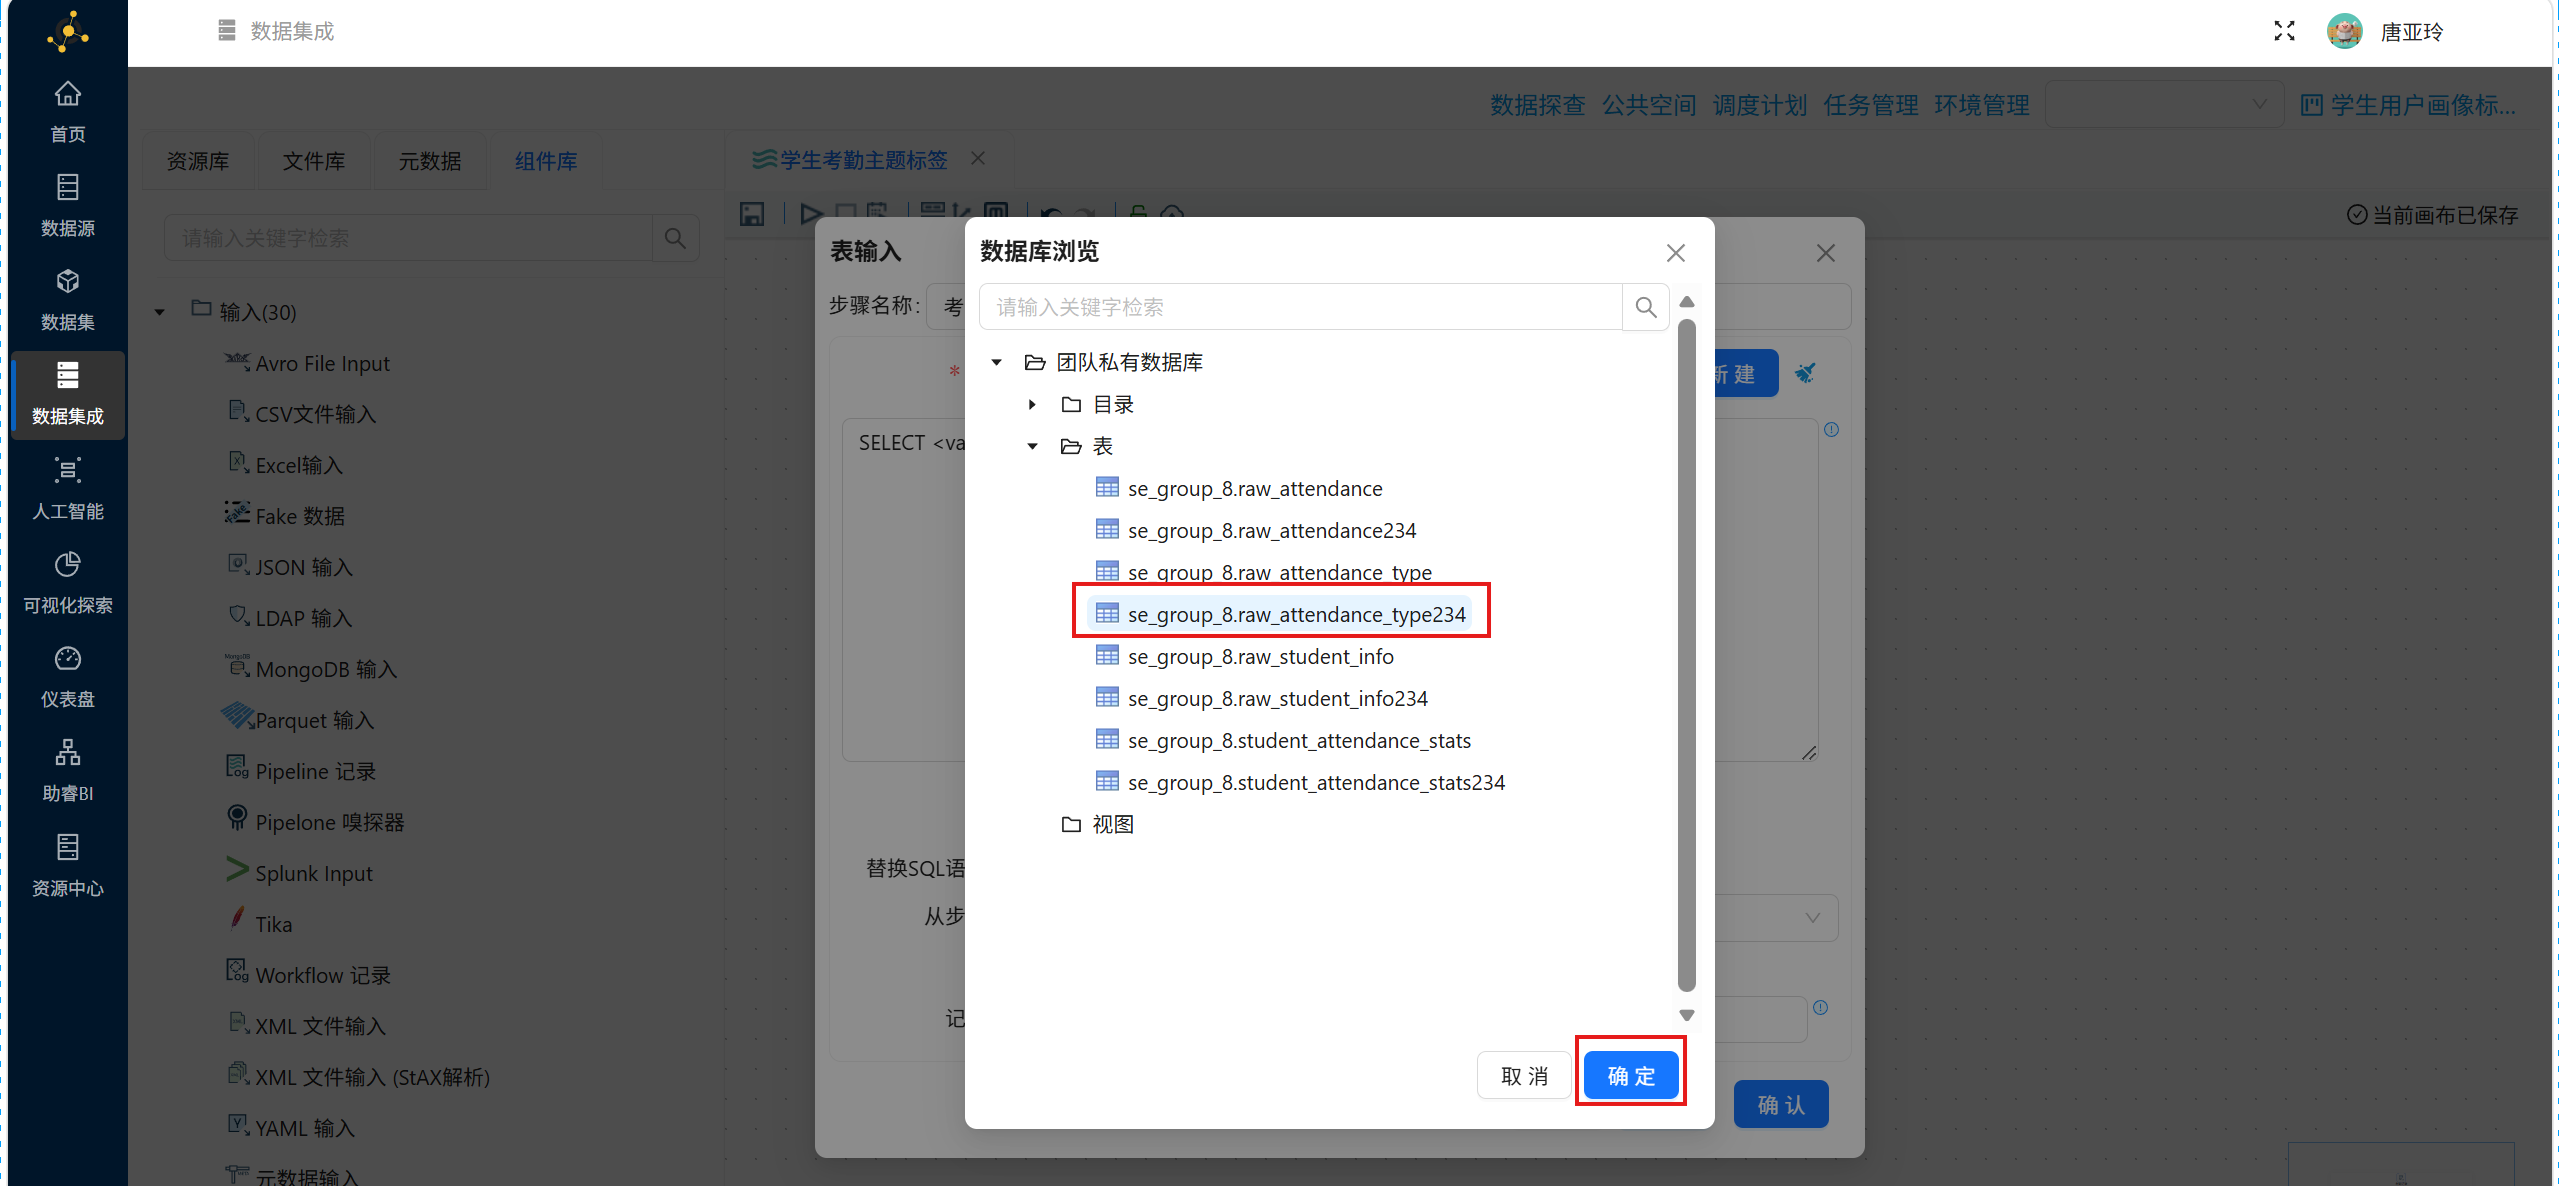
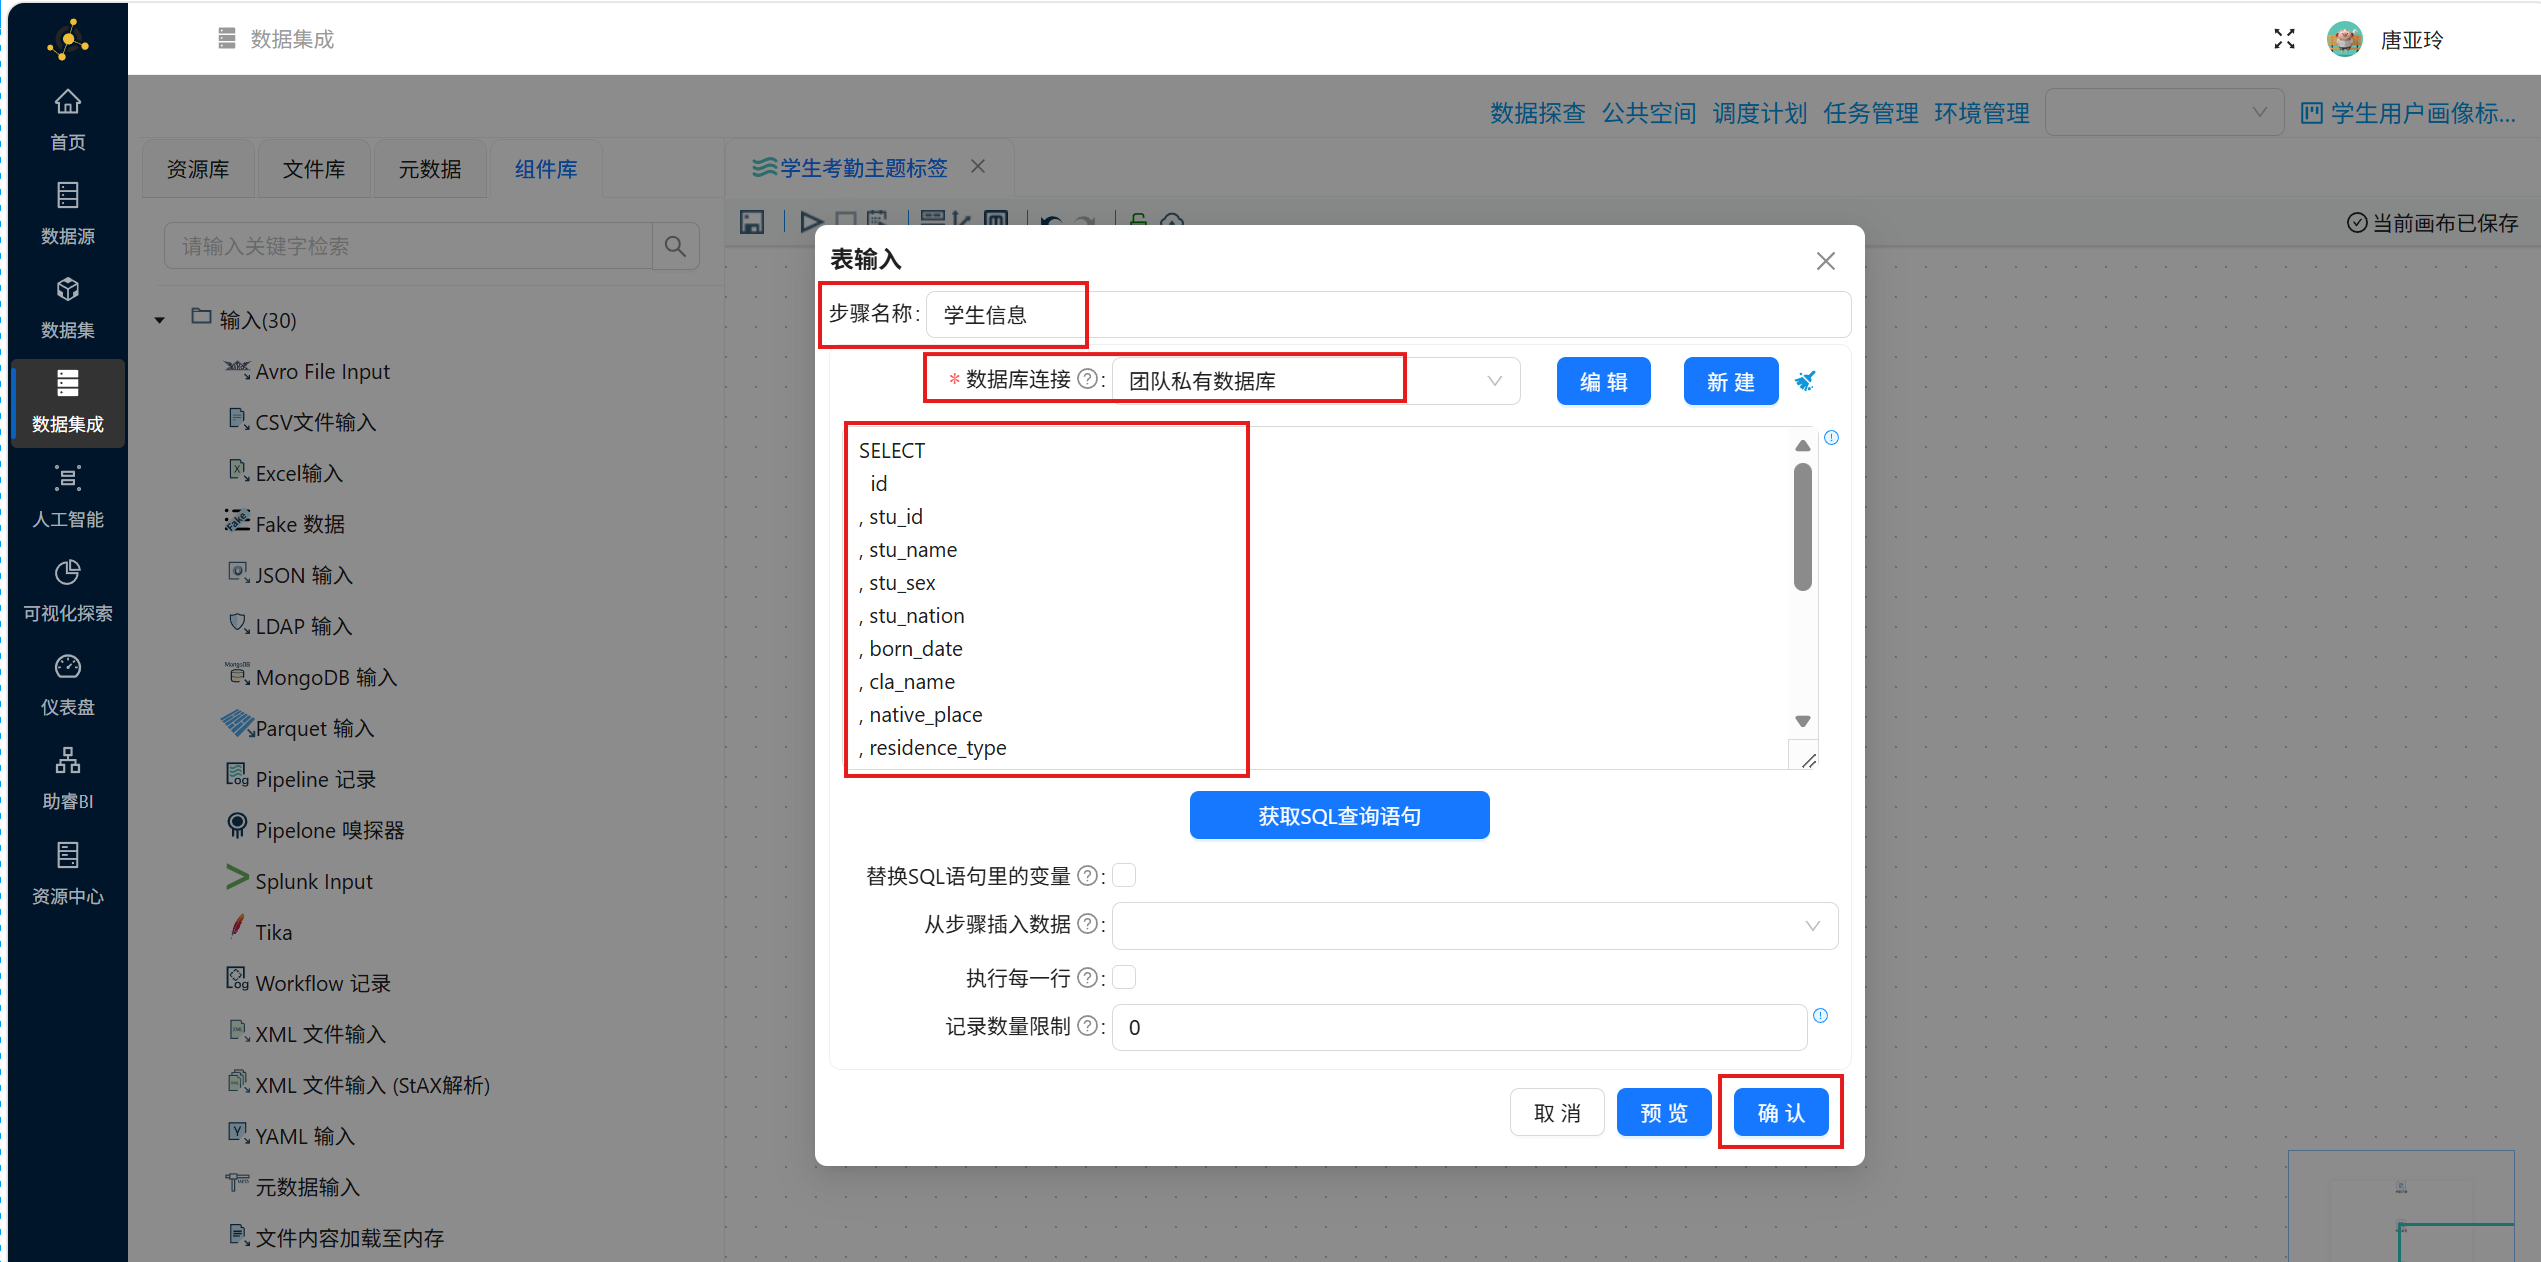
配置第一个表输入组件,在配置窗口中,步骤名称修改为 “考勤记录” ,数据库连接选择 “团队私有数据库” ,并点击 “获取SQL查询语句”,在数据库中选择考勤记录表
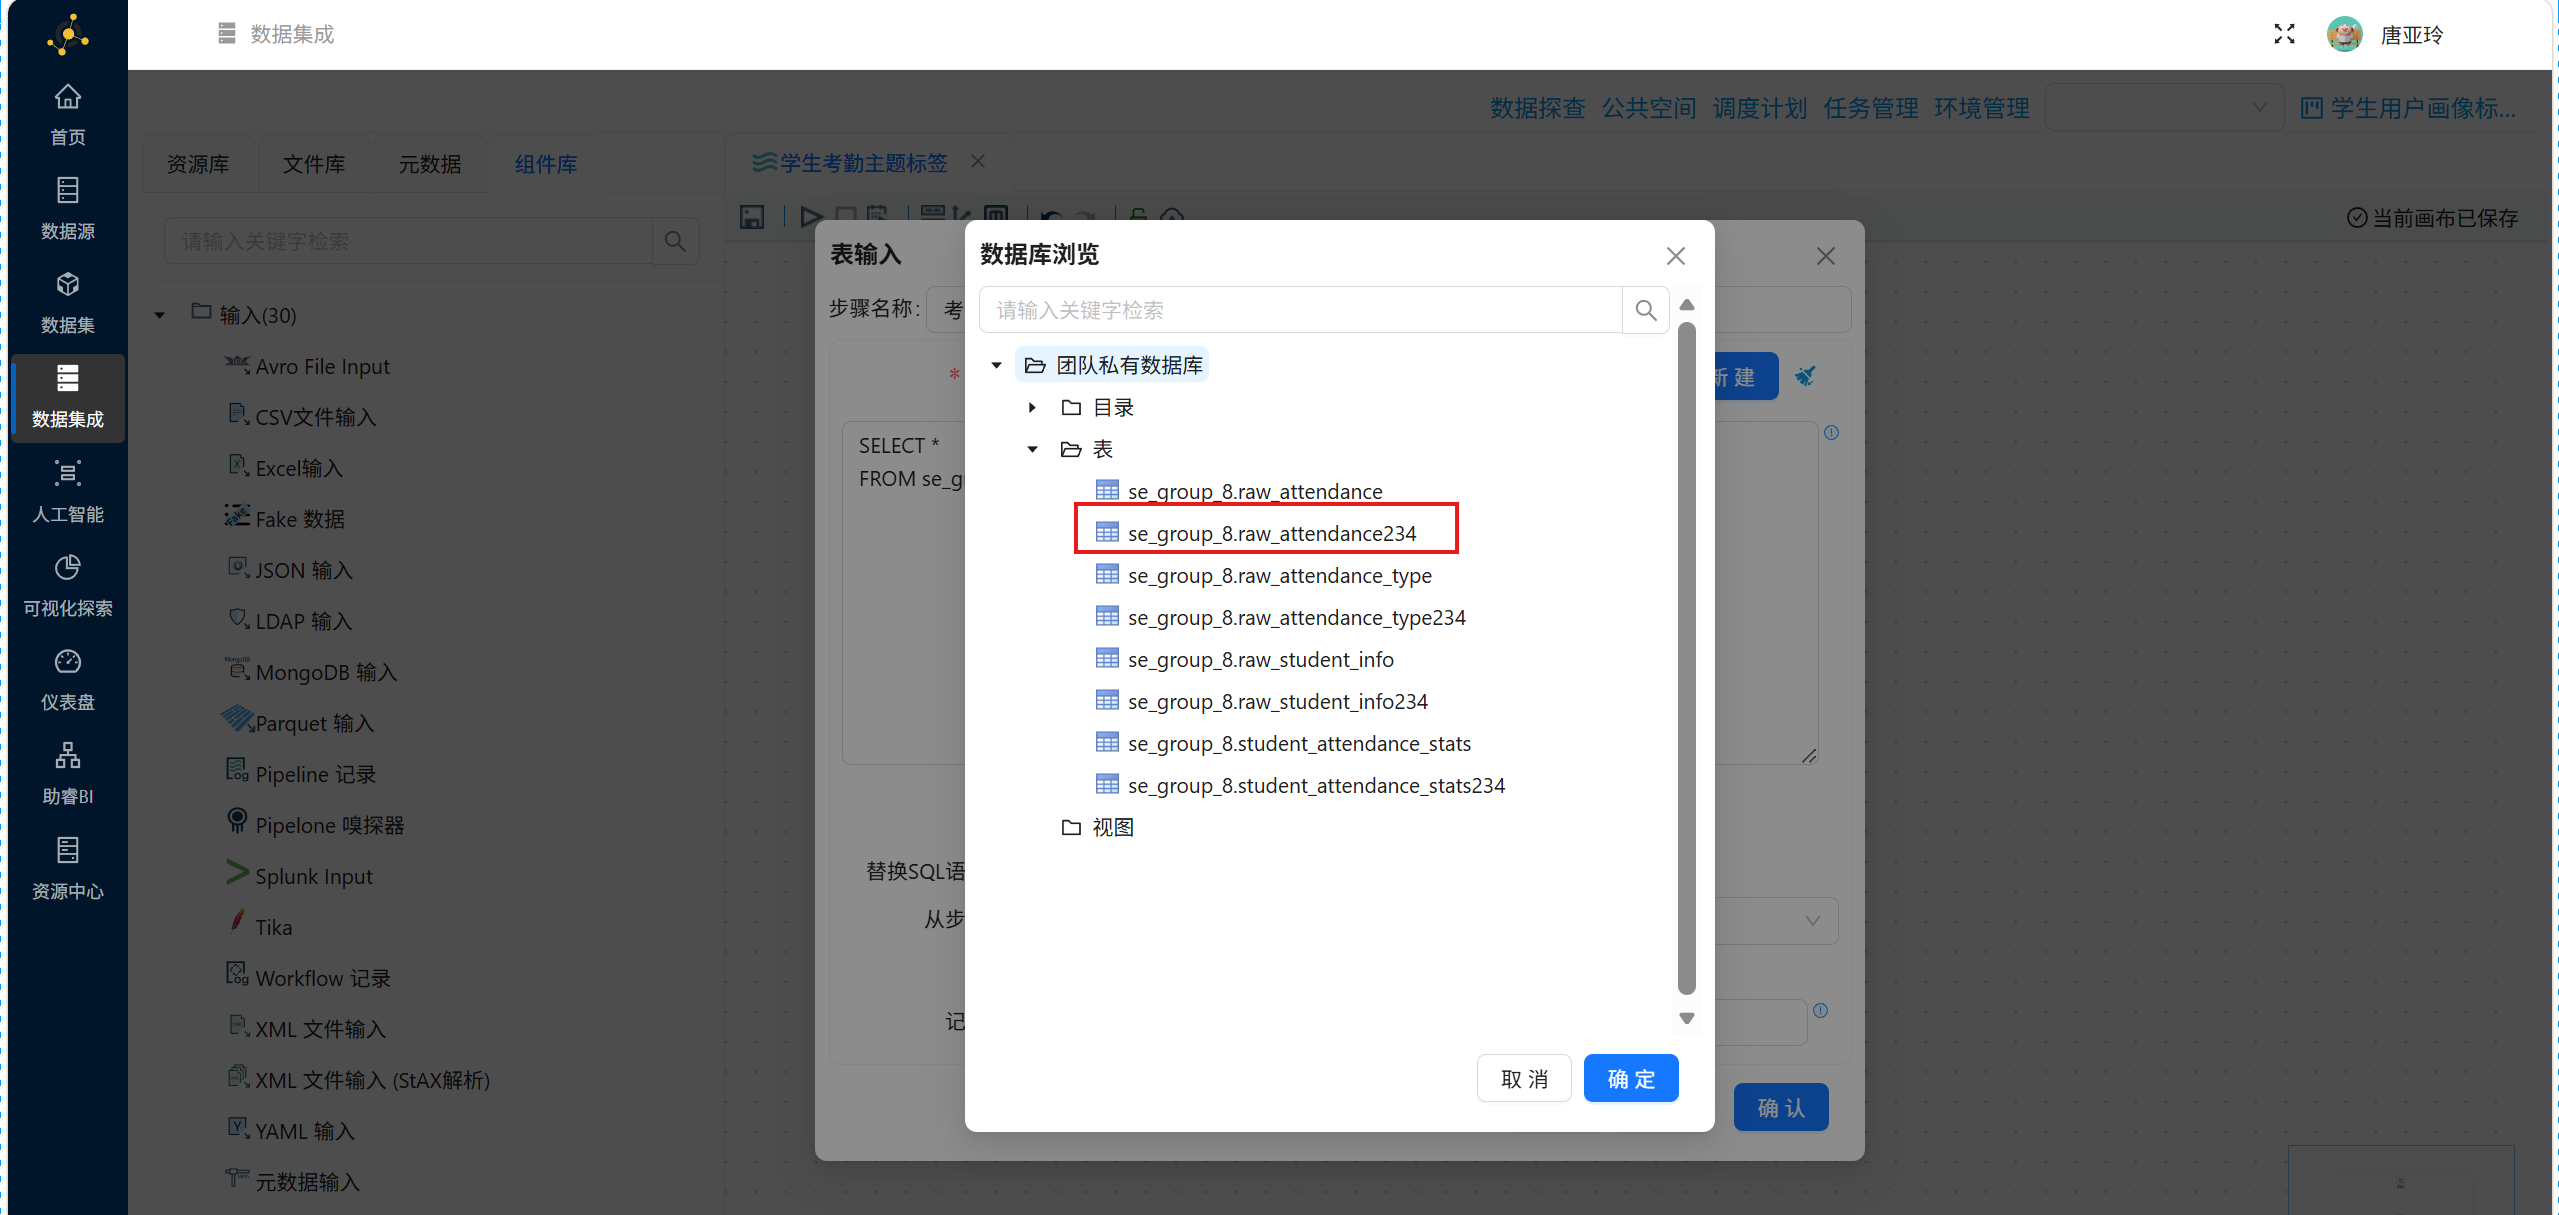
系统提示弹窗中点击“确认”,获取“raw_attendance”考勤记录表的所有字段
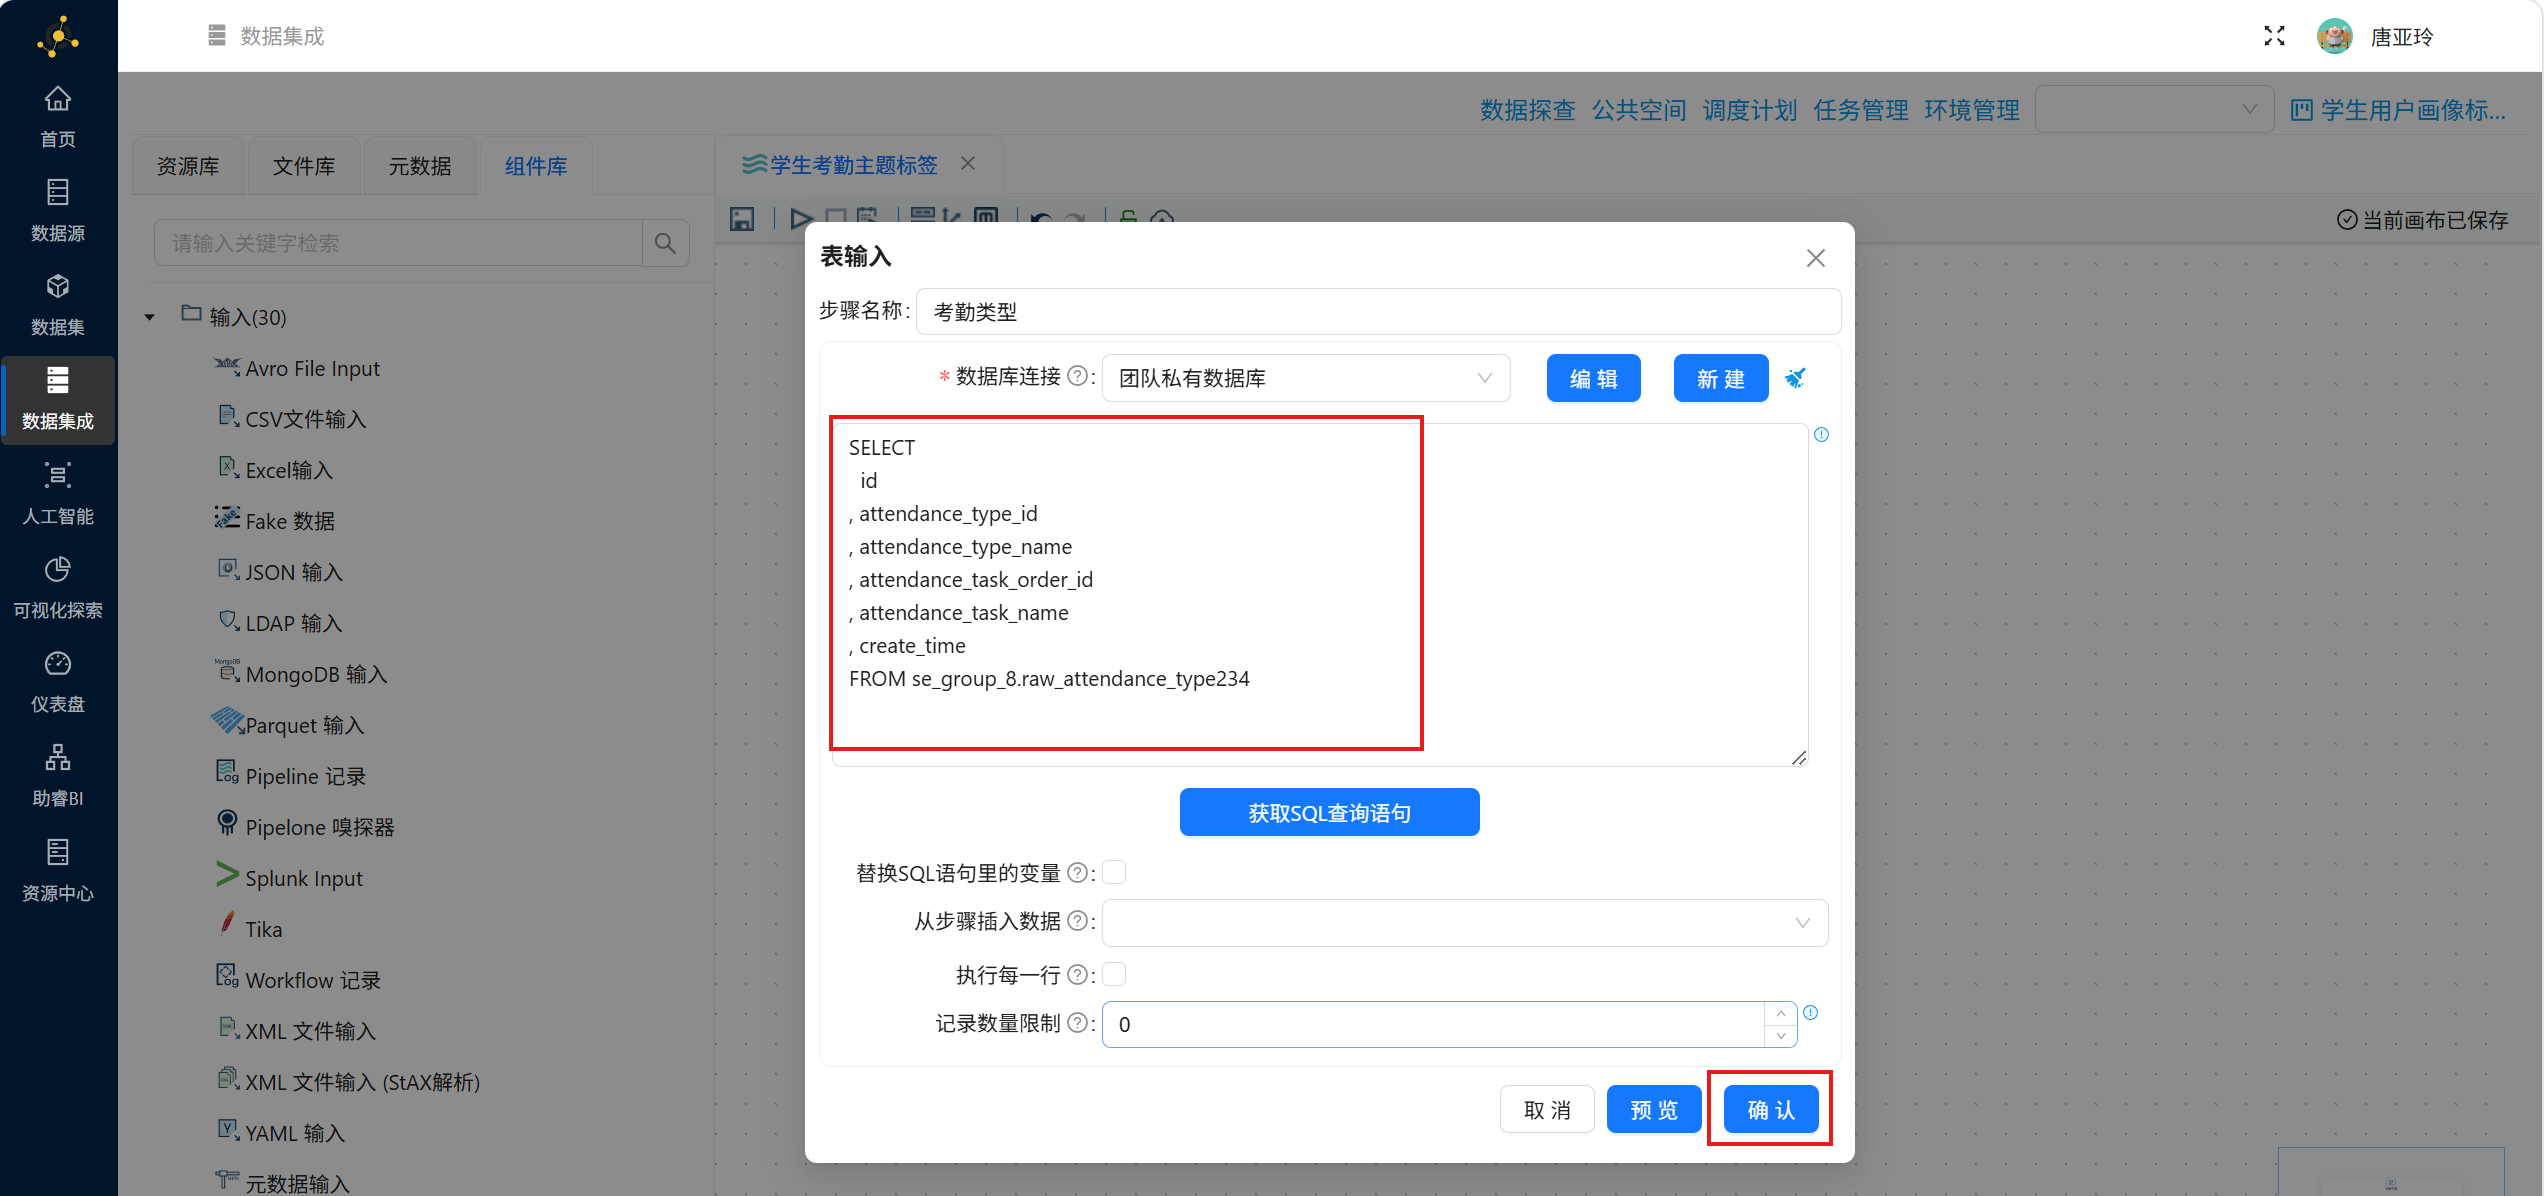
同样的,参考以上步骤,将第2、3个组件分别命名为 “考勤类型” 和 “学生信息” ,分别获取“raw_attendance_type” 原始_考勤类型表和 “raw_student_info” 原始_学生信息表的所有字段数据
3.6.3 数据关联:关联考勤记录+考勤类型
使用表输入组件读取考勤记录、考勤类型数据后,需通过记录集连接组件完成数据关联,补充关键业务信息,为后续指标计算奠定基础。
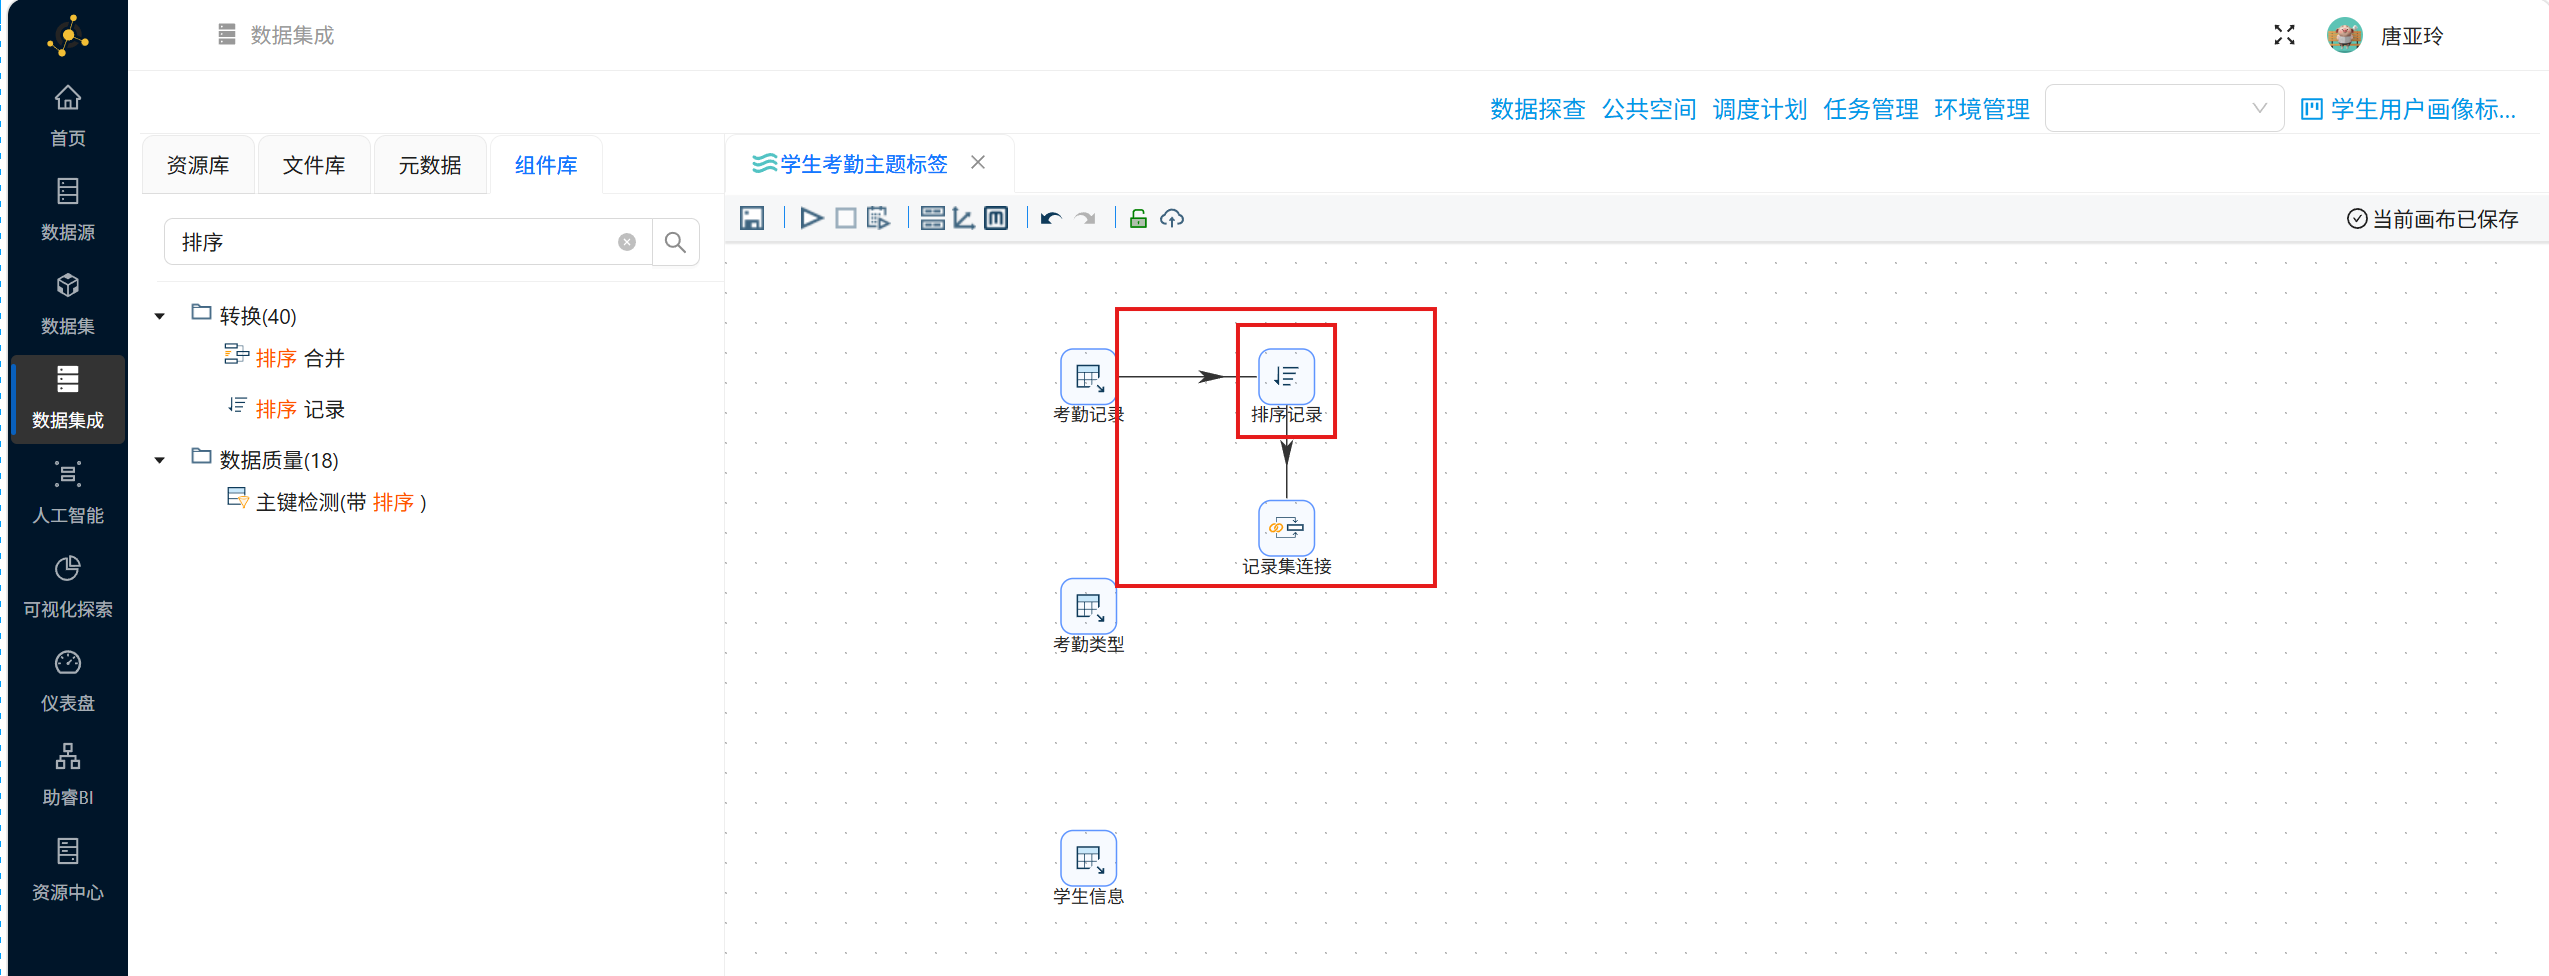
为避免因排序问题造成连接结果出错。添加一个排序记录组件到转换流的 “考勤记录” 与 “记录集连接” 之间。
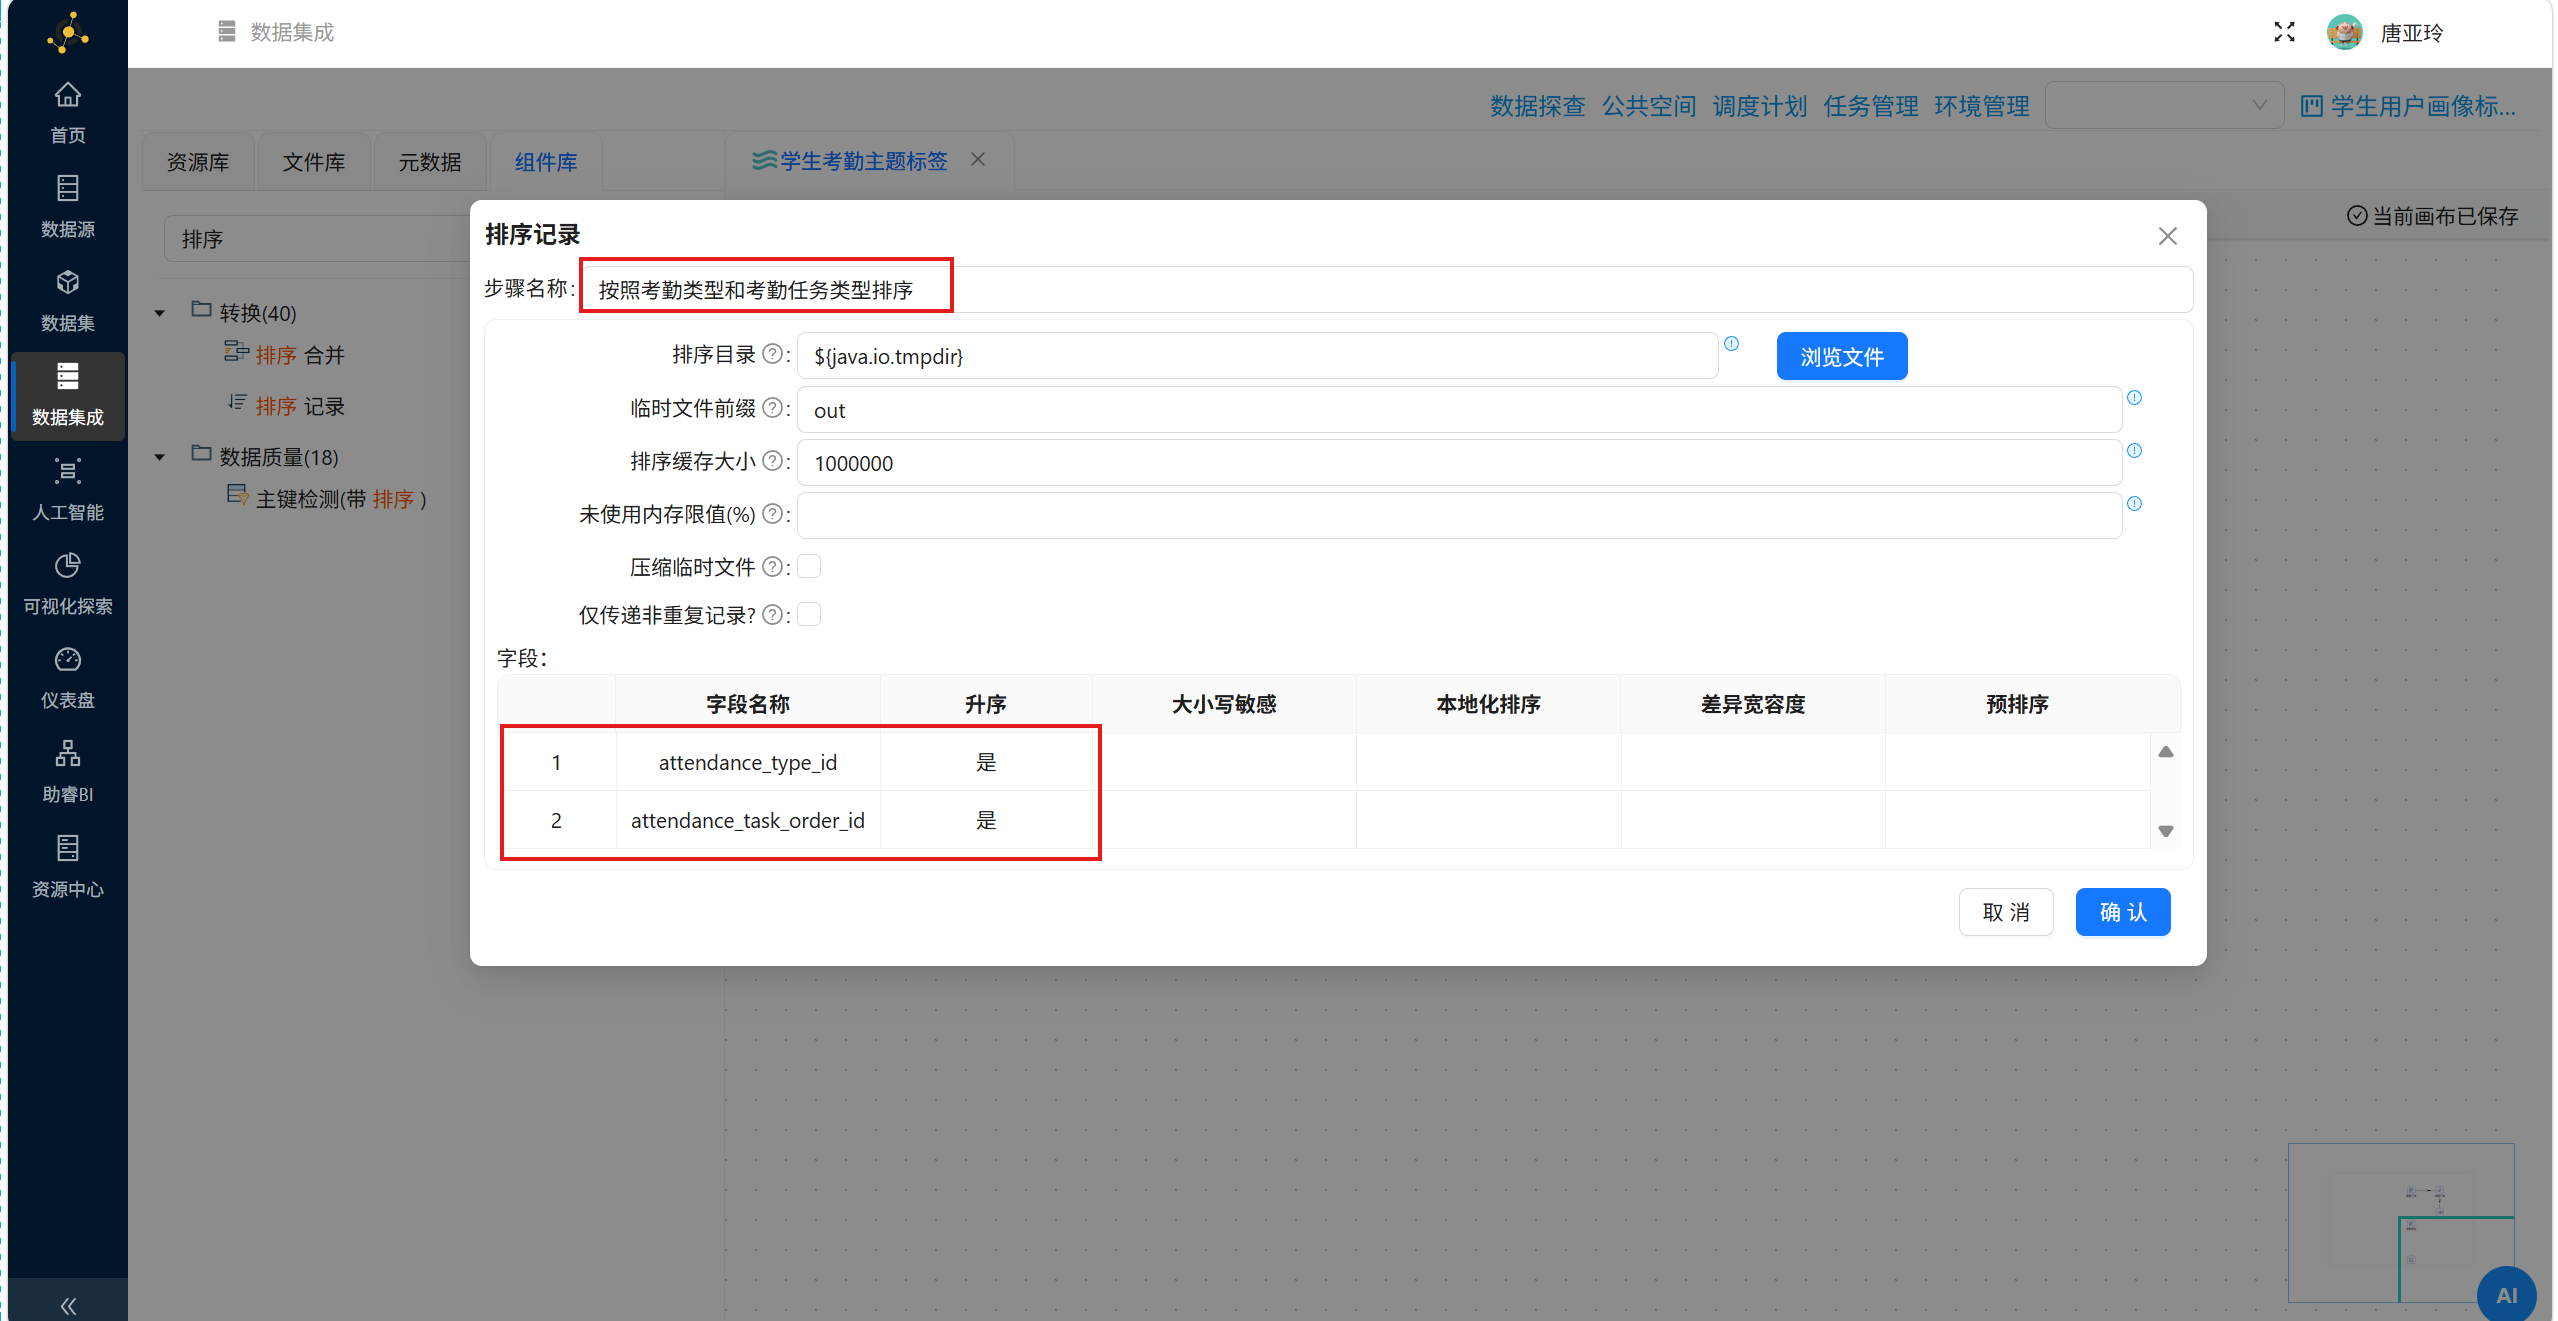
双击“排序记录”组件,设置步骤名称为“按照考勤类型和考勤任务类型排序”,通过 “获取字段” 功能获取字段列表,然后删除多余字段,只保留“attendance_type_id”、“attendance_task_order_id”字段。因为下一步连接是使用这两个字段进行连接,所以对两个字段对记录排序。
创建“考勤类型”表输入组件到记录集连接组件的连接线。由于“考勤类型”组件的记录默认是按“attendance_type_id”、“attendance_task_order_id”这两个字段升序记录的,所以无需再次排序。
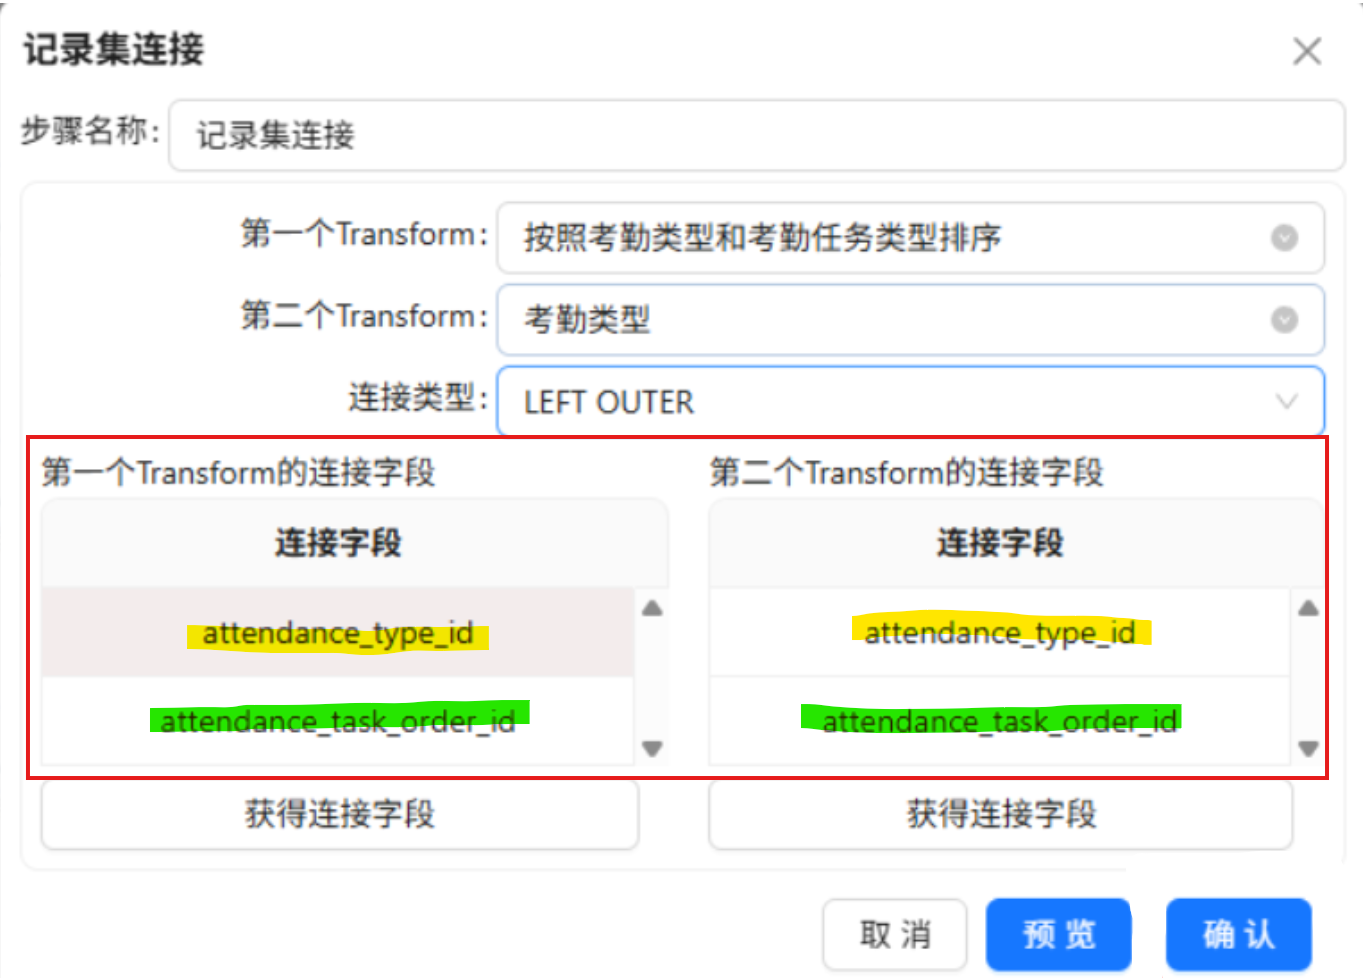
双击“记录集连接”组件,在下拉列表中选择需要连接的数据来源,第一个Transform选择 “按照考勤类型和考勤任务类型排序”,第二个Transform选择 “考勤类型” ,连接类型选择 LEFT OUTER
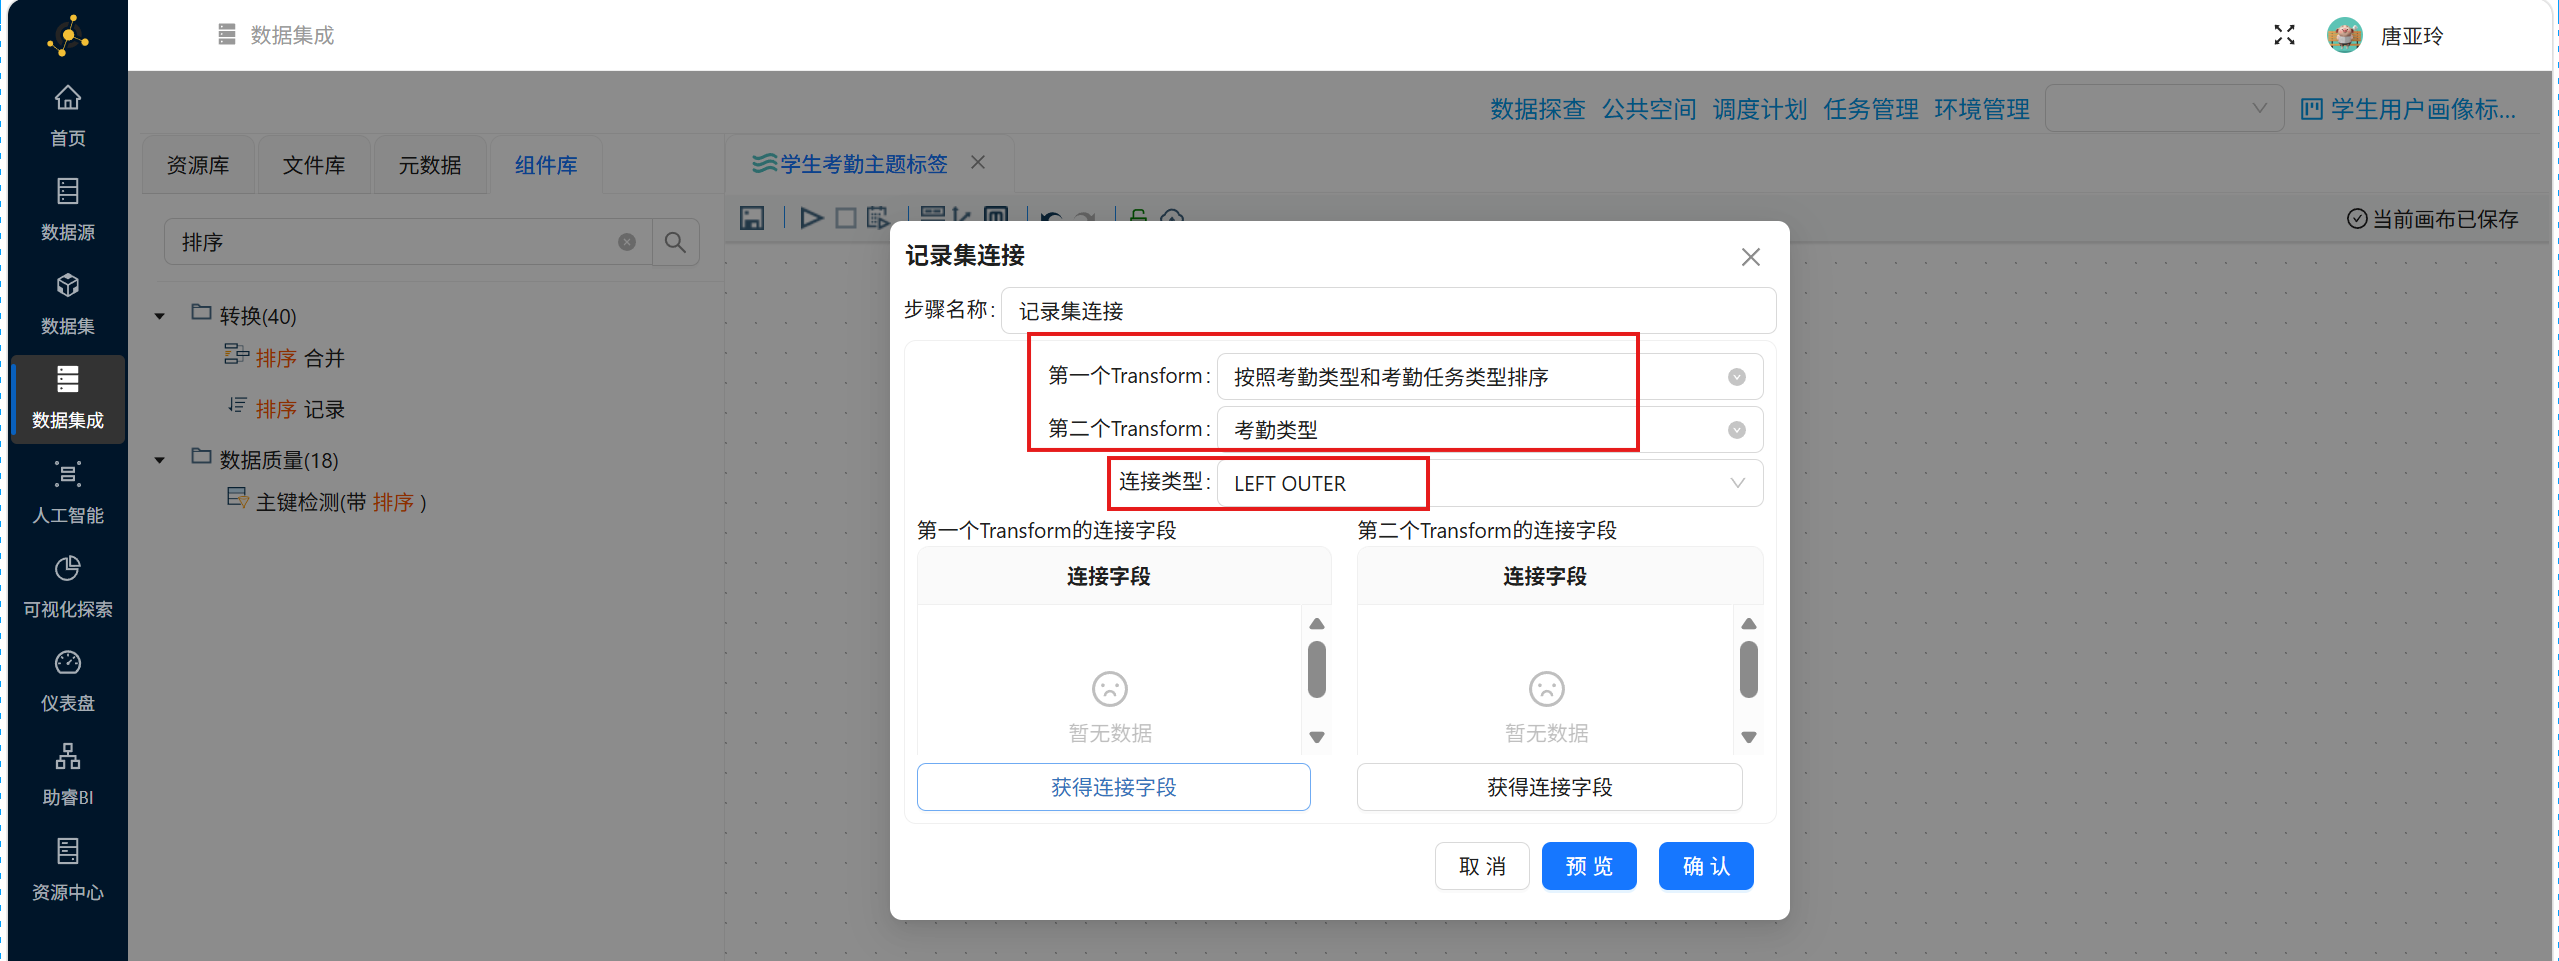
点击 “获取连接字段”,2个Transform字段中仅保留“attendance_type_id”、“attendance_task_order_id”字段,这样做表示使用这2个字段进行记录连接。
【注意】:这里的字段有对应关系,有多个字段时,需要一一对应,避免后续数据出错!!!
3.6.4 行为标签衍生:统计学生异常考勤次数
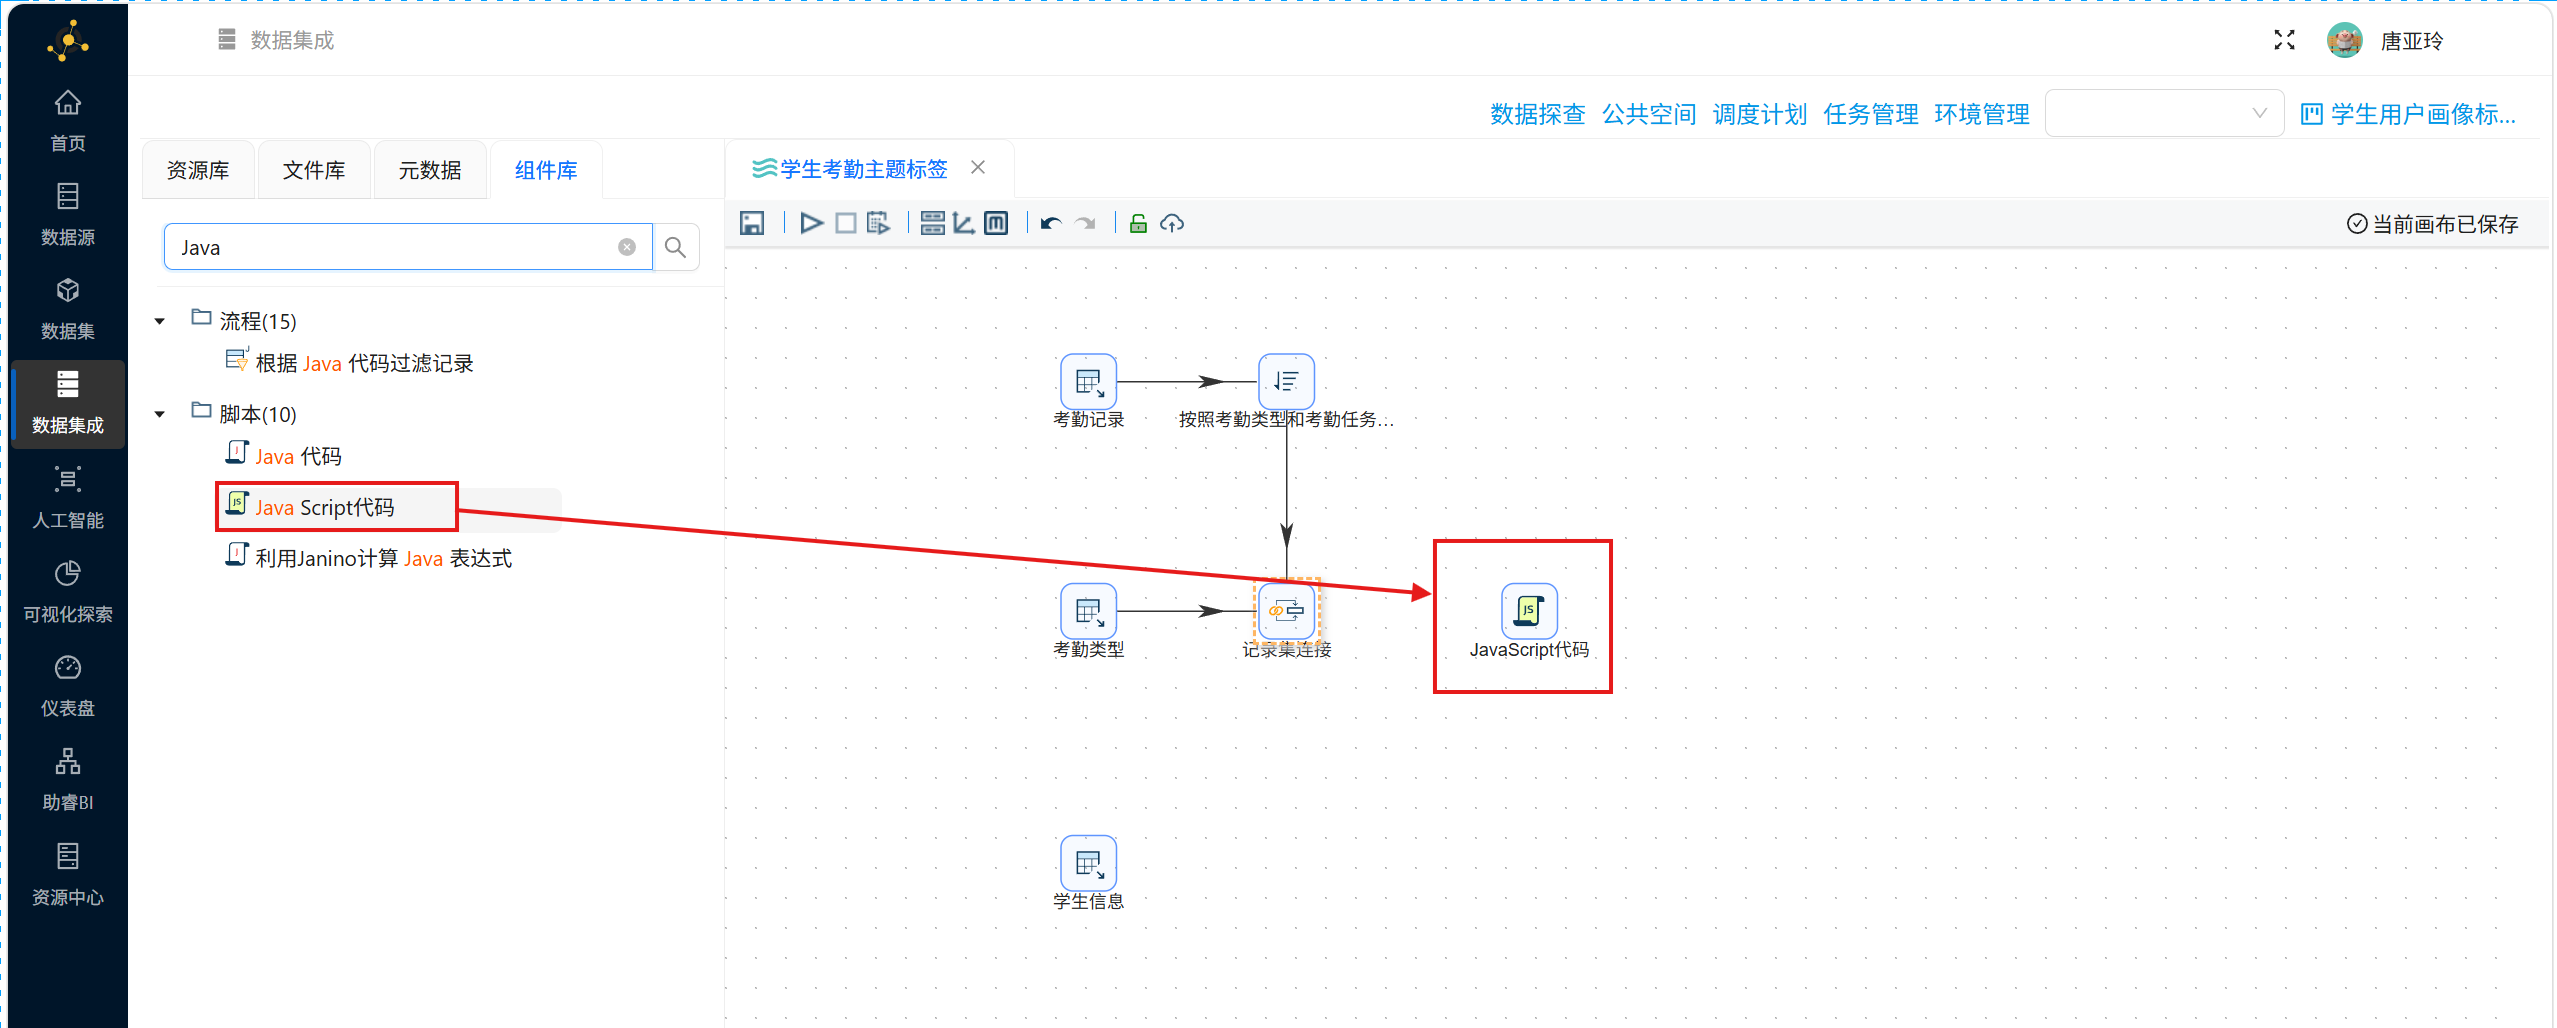
为更好地统计学生异常考勤次数,我们可以通过Javascript脚本生成考勤行为二进制标记,为后续聚合统计提供支撑,确保标签判断精准。
添加“JavaScript 代码”组件,对接 “记录集连接” 组件的输出,通过关键词匹配,生成二进制判断标签(1=是,0=否),用于后续指标聚合:
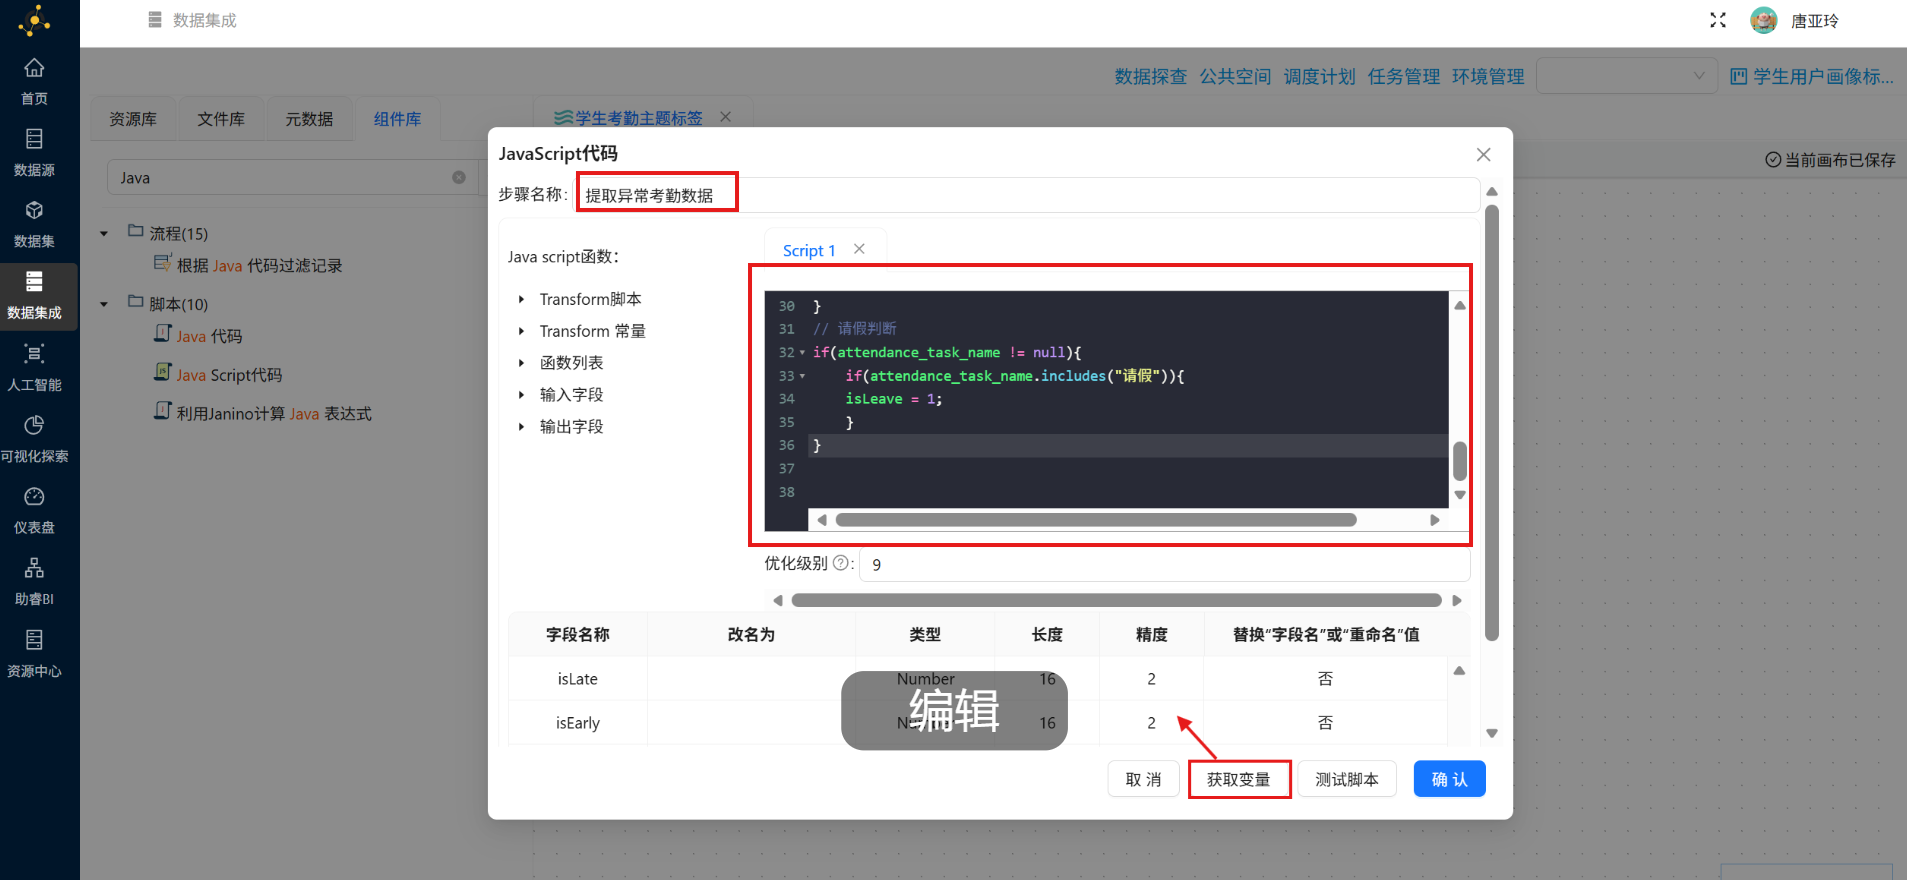
脚本代码如下:
// 初始化变量
var isLate = 0;
var isEarly = 0;
var isLeave = 0;
var isNoUniform = 0;

// 核心判断逻辑
if(attendance_type_name != null && attendance_task_name != null){

    // 迟到判断(排除请假)
    if((attendance_type_name.includes("迟到") ||
        attendance_type_name.includes("晚到") ||
        attendance_task_name.includes("迟到") ||
        attendance_task_name.includes("晚到")) &&
        !attendance_task_name.includes("请假")){
      isLate = 1;
    }

    // 早退判断(排除请假)
    if((attendance_type_name.includes("早退") ||
        attendance_task_name.includes("早退")) &&
        !attendance_task_name.includes("请假")){
      isEarly = 1;
    }

    // 校服违规:只要包含“校服”就标记违规
    if(attendance_type_name.includes("校服") || attendance_task_name.includes("校服")){
      isNoUniform = 1;
    }
}

// 请假判断
if(attendance_task_name != null){
    if(attendance_task_name.includes("请假")){
      isLeave = 1;
    }
}
使用“获取变量”获取输出字段,系统将自动解析脚本中变量定义代码,生成字段数据
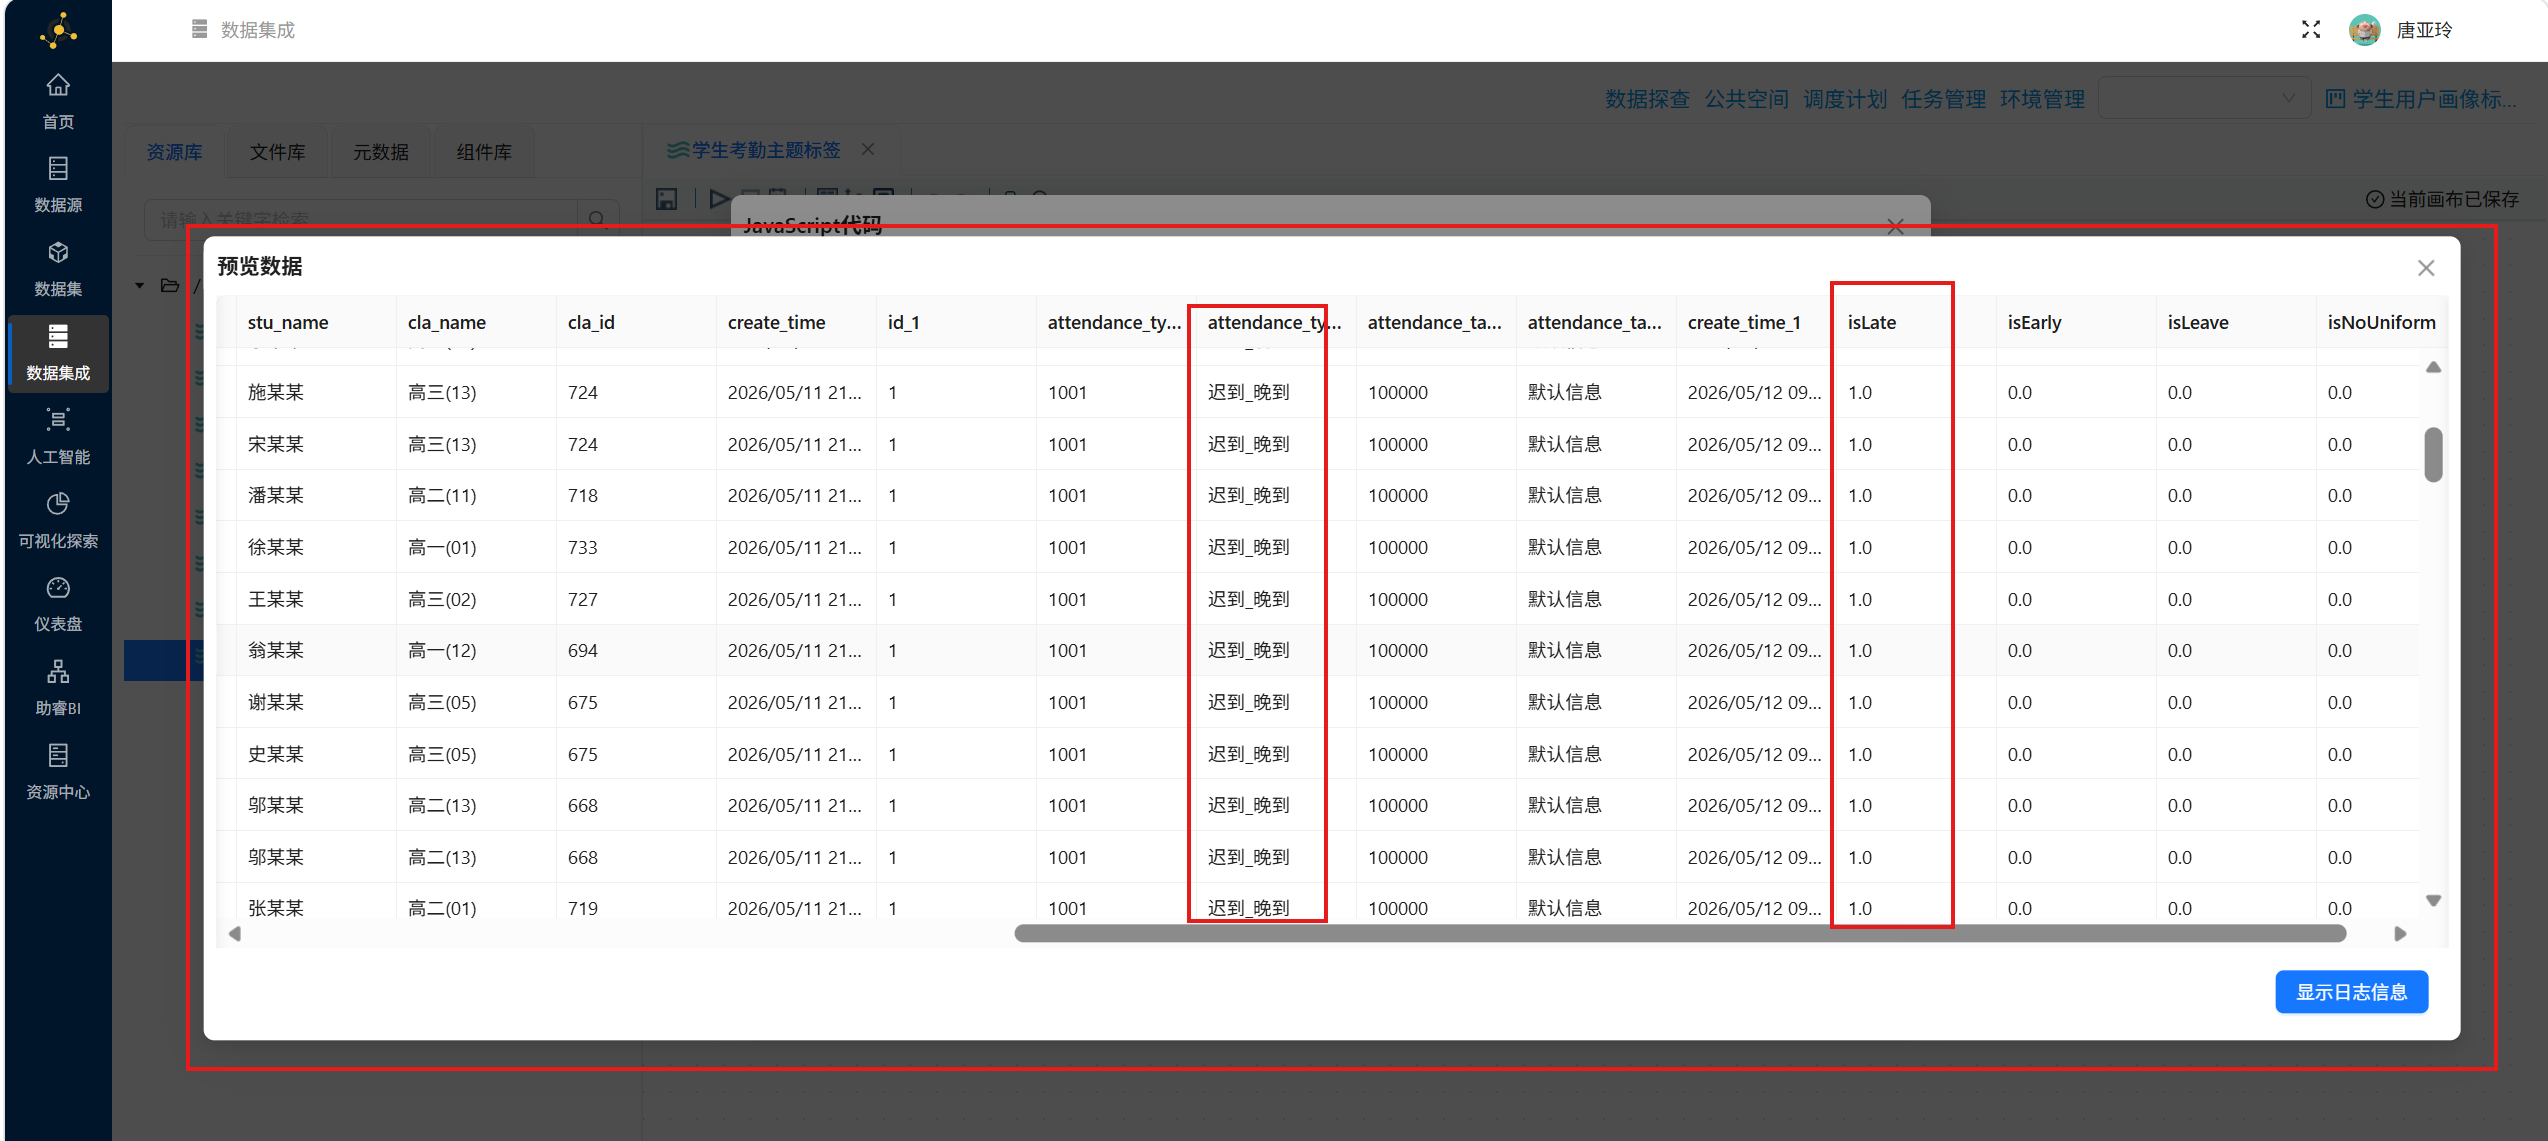
点击 “测试脚本” 按钮,确认标记字段(is_late_early、is_leave等)仅存在1和0两个值,标签判断准确(如迟到记录对应is_late_early=1,正常出勤对应is_compliant=1),无异常
3.6.5 多维度分组聚合统计
实验核心:按两大统计维度聚合数据,将明细数据转化为统计指标,满足多层级考勤管理需求。
具体操作如下:
在助睿ETL平台拖拽2个“分组”组件,分别对接“用户自定义Java表达式”组件的输出,按两大统计维度进行聚合,统一聚合指标,确保数据全覆盖:
聚合规则
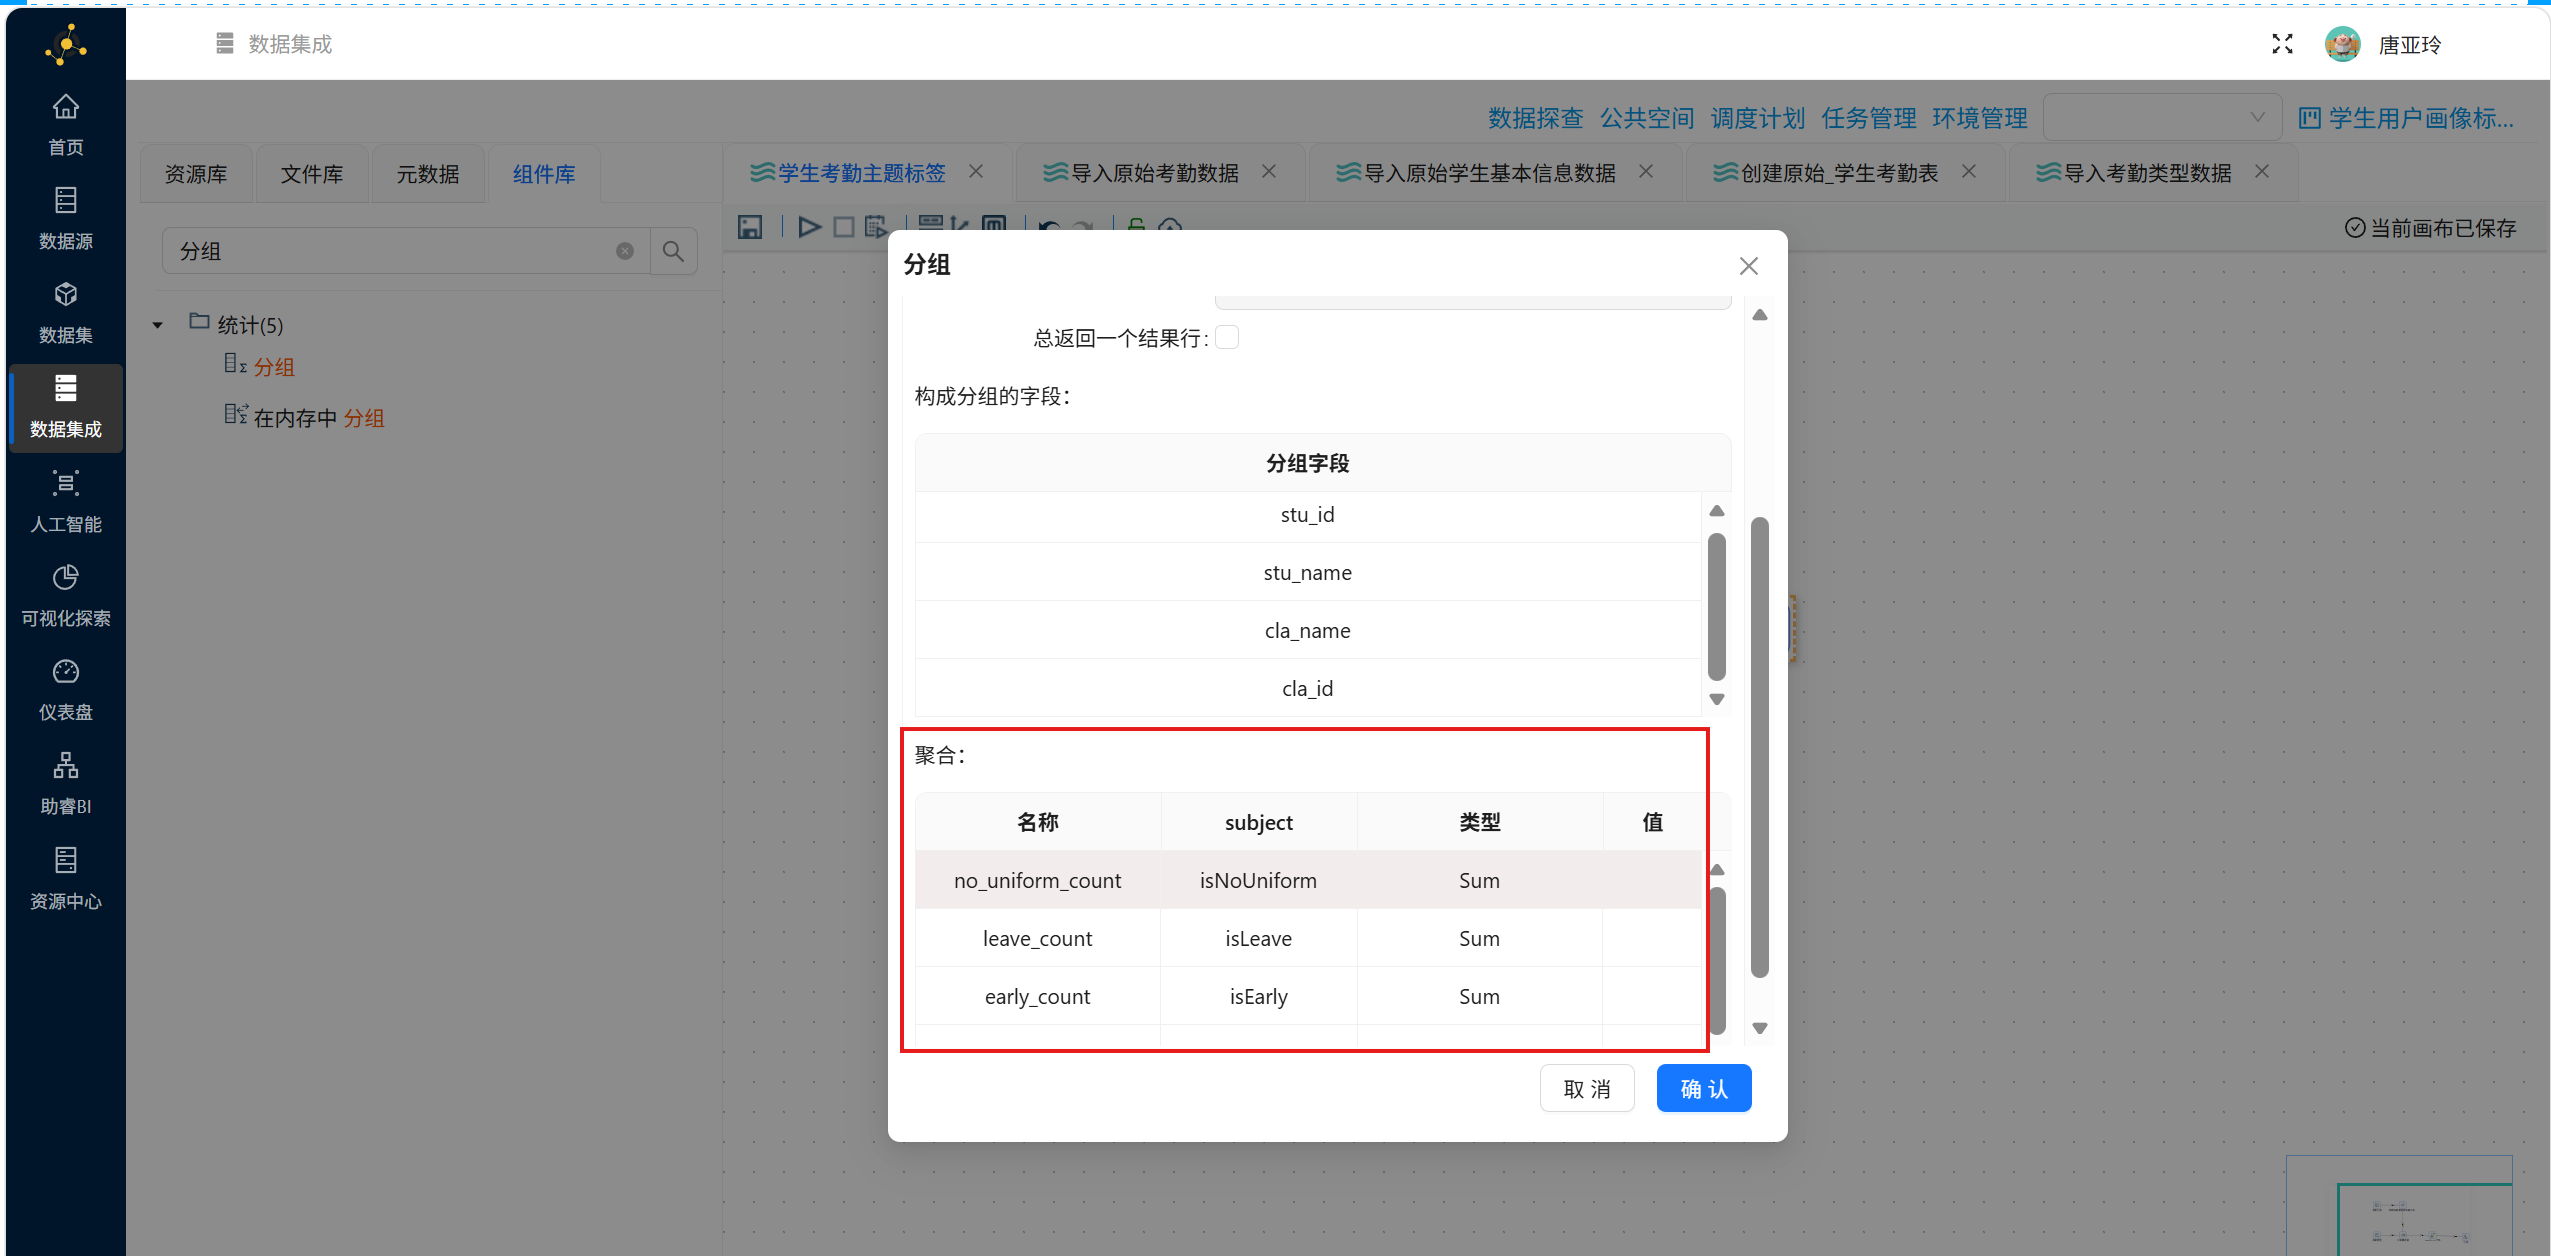
- 聚合函数:SUM(迟到标记)→ 迟到次数(late_count);
- 聚合函数:SUM(早退标记)→ 早退次数(early_count);
- 聚合函数:SUM(请假标记)→ 请假次数(leave_count);
- 聚合函数:SUM(没穿校服标记)→ 没穿校服次数(no_uniform_count)
操作如下:
添加“分组”组件,并建立连接线,连线选择“主输出步骤”
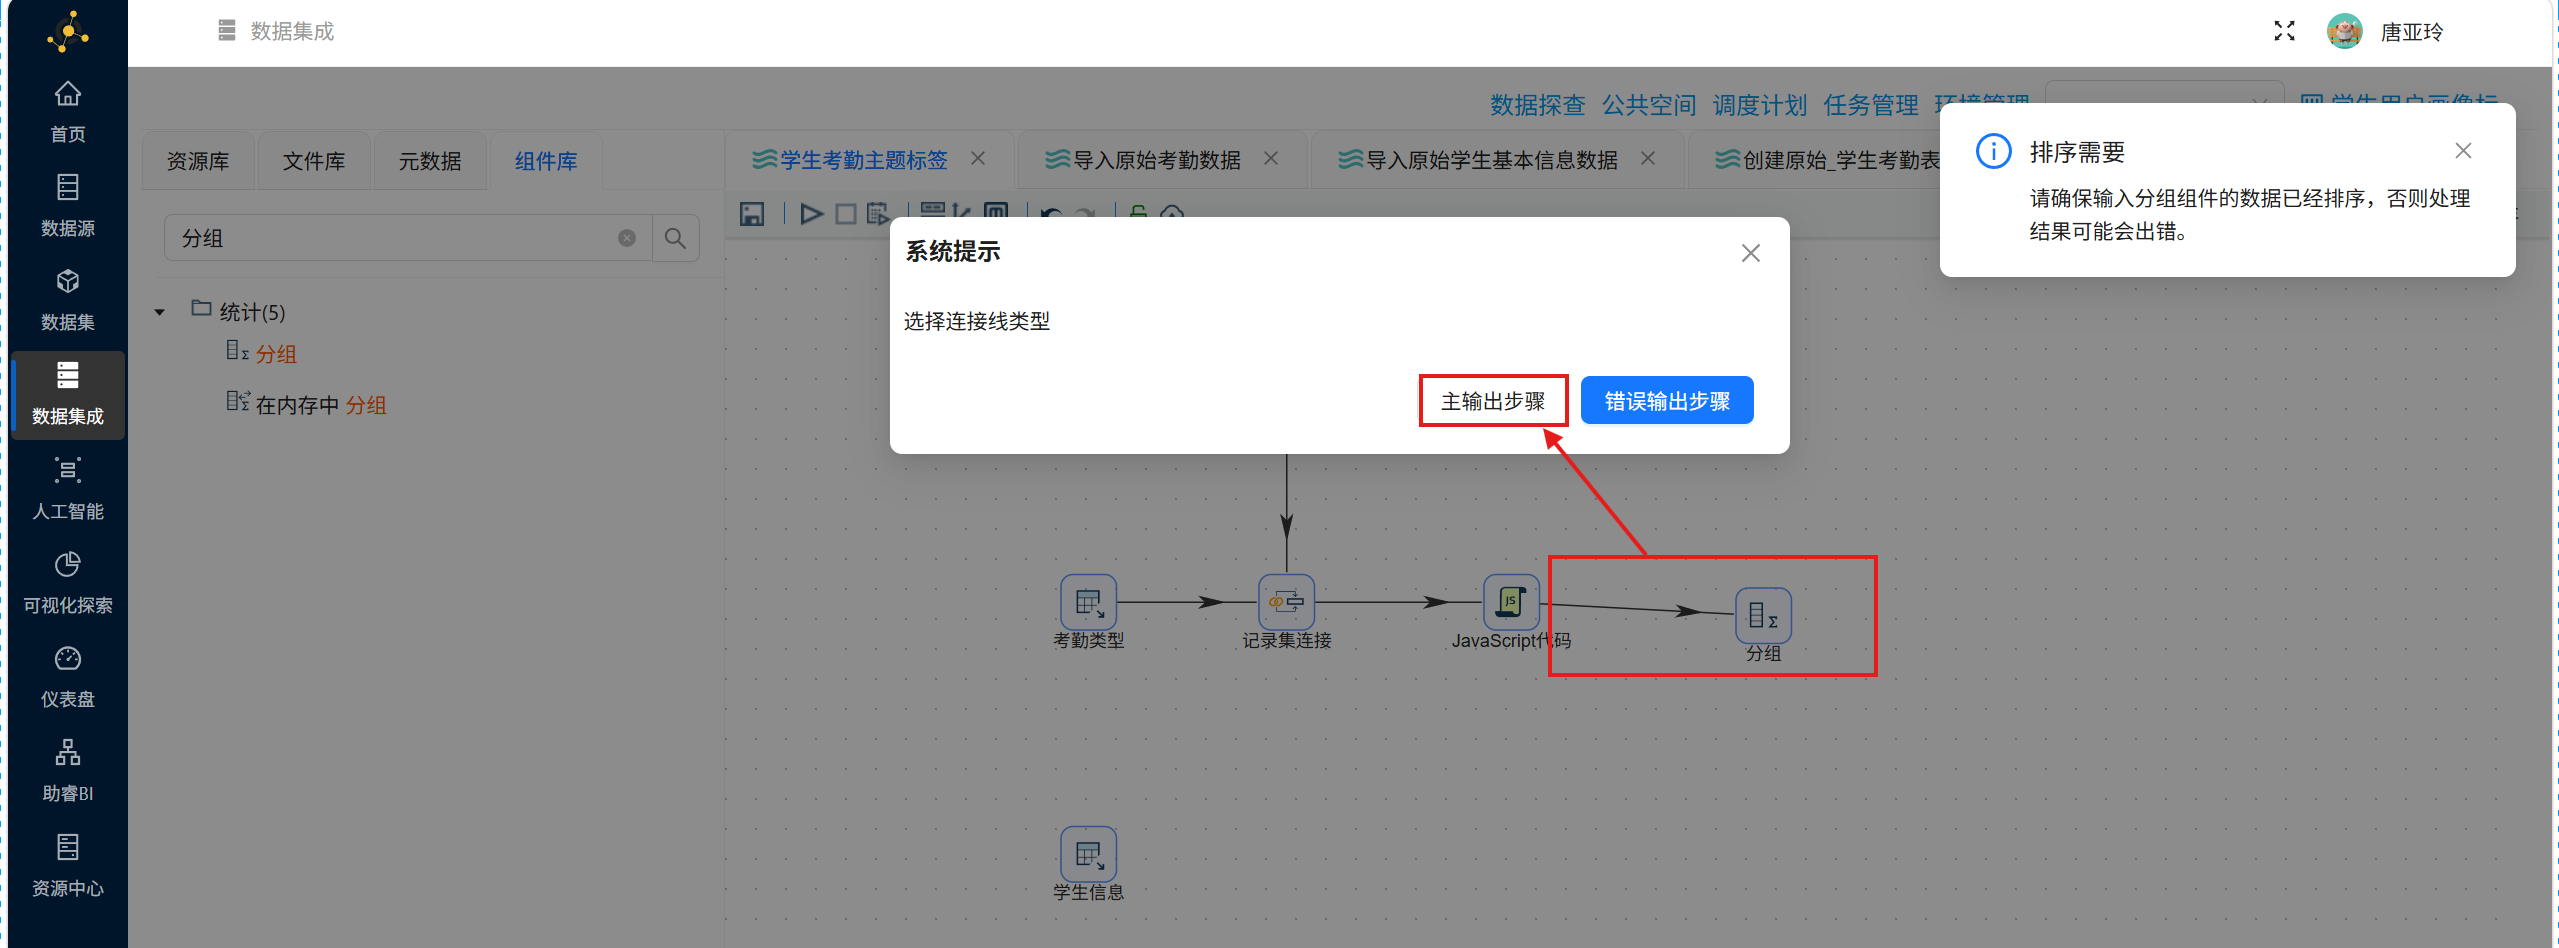
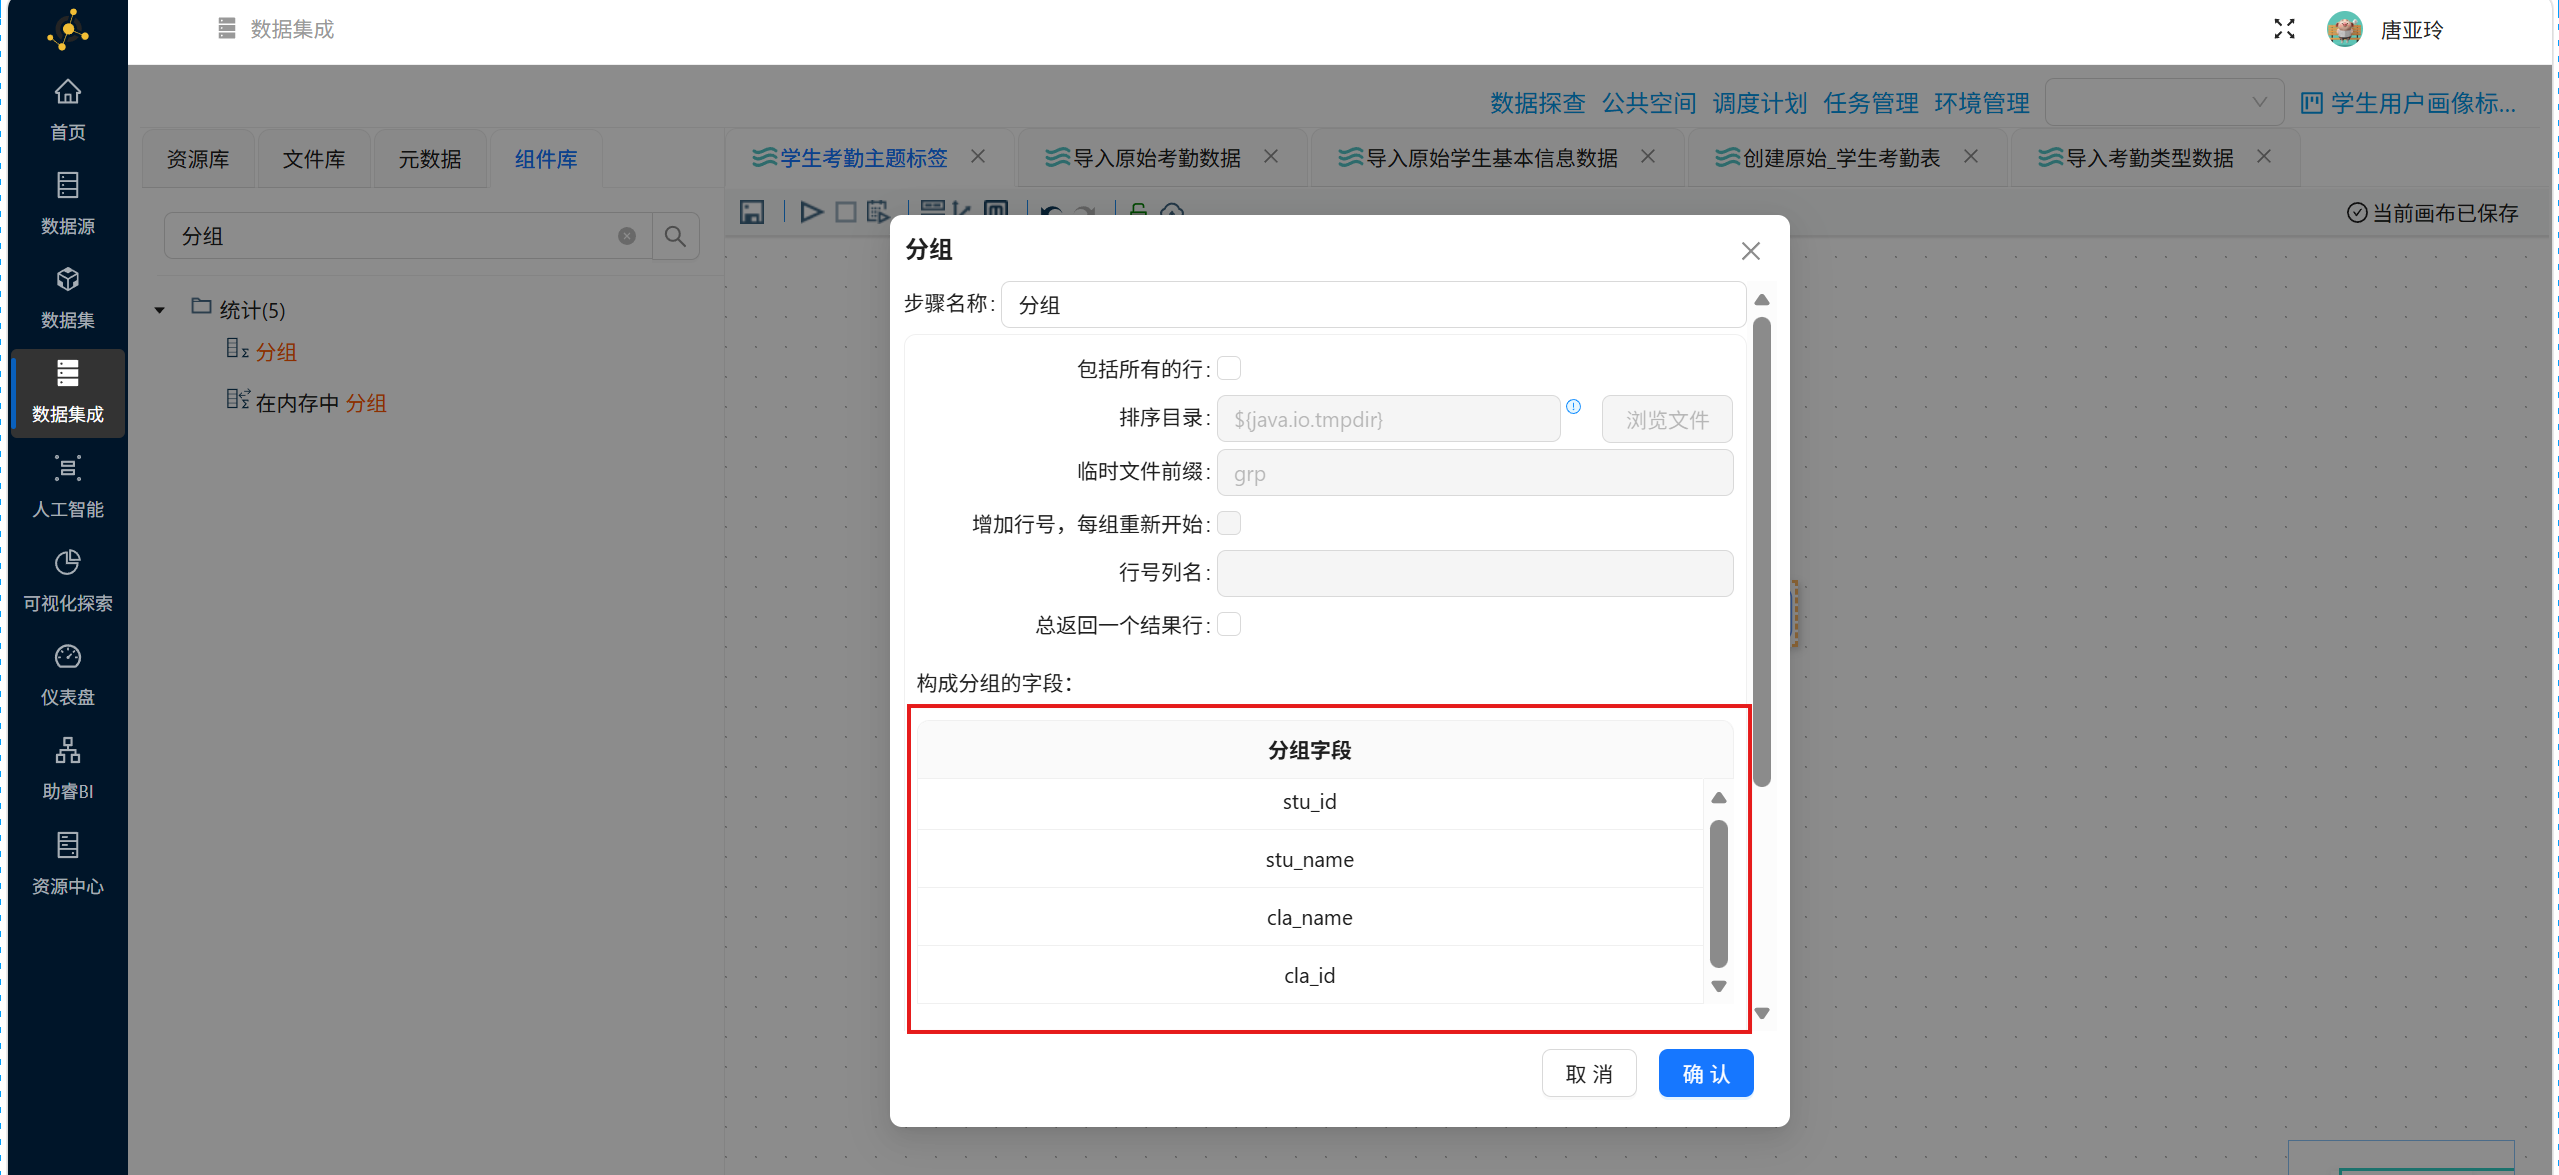
双击“分组”组件,设置分组字段为“stu_id”、“stu_name”、“cla_id”、“cla_name”
设置聚合字段为“late_early_count”、“leave_count”、“no_uniform_count”、“compliant_count”、“total_attendance”
3.6.6 关联学生信息
使用记录集连接组件,关联学生信息表,支撑住校相关维度的统计。
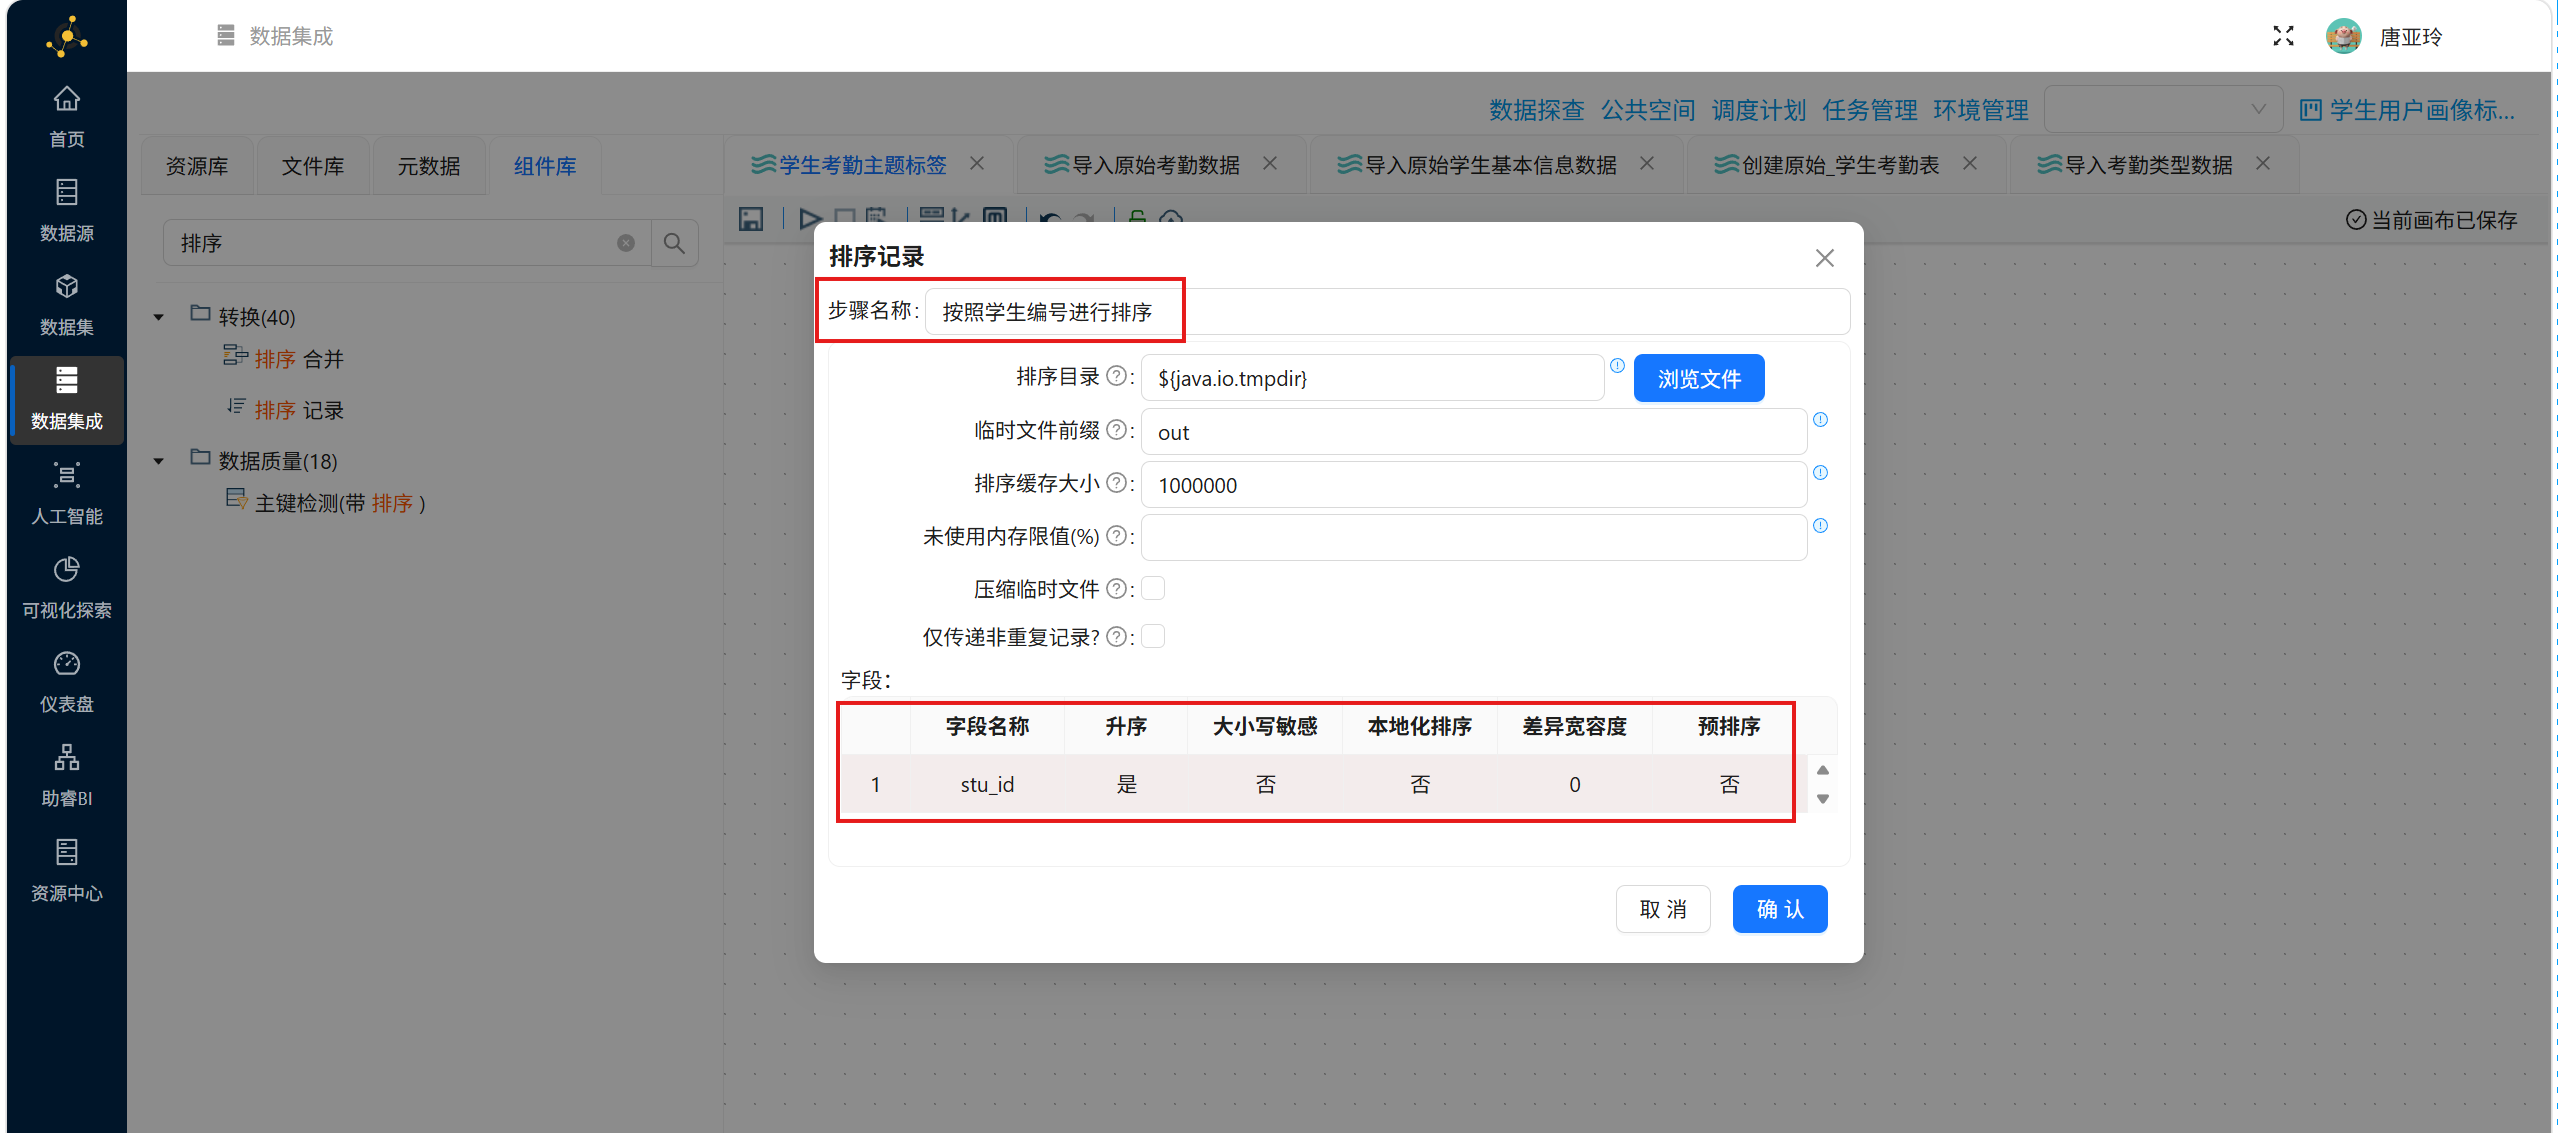
由于“学生信息”数据表中的学号不是升序记录的,所以在进行记录关联前,我们需要添加“排序记录”,并建立“学生信息”表输入组件到“排序记录”组件的连接线
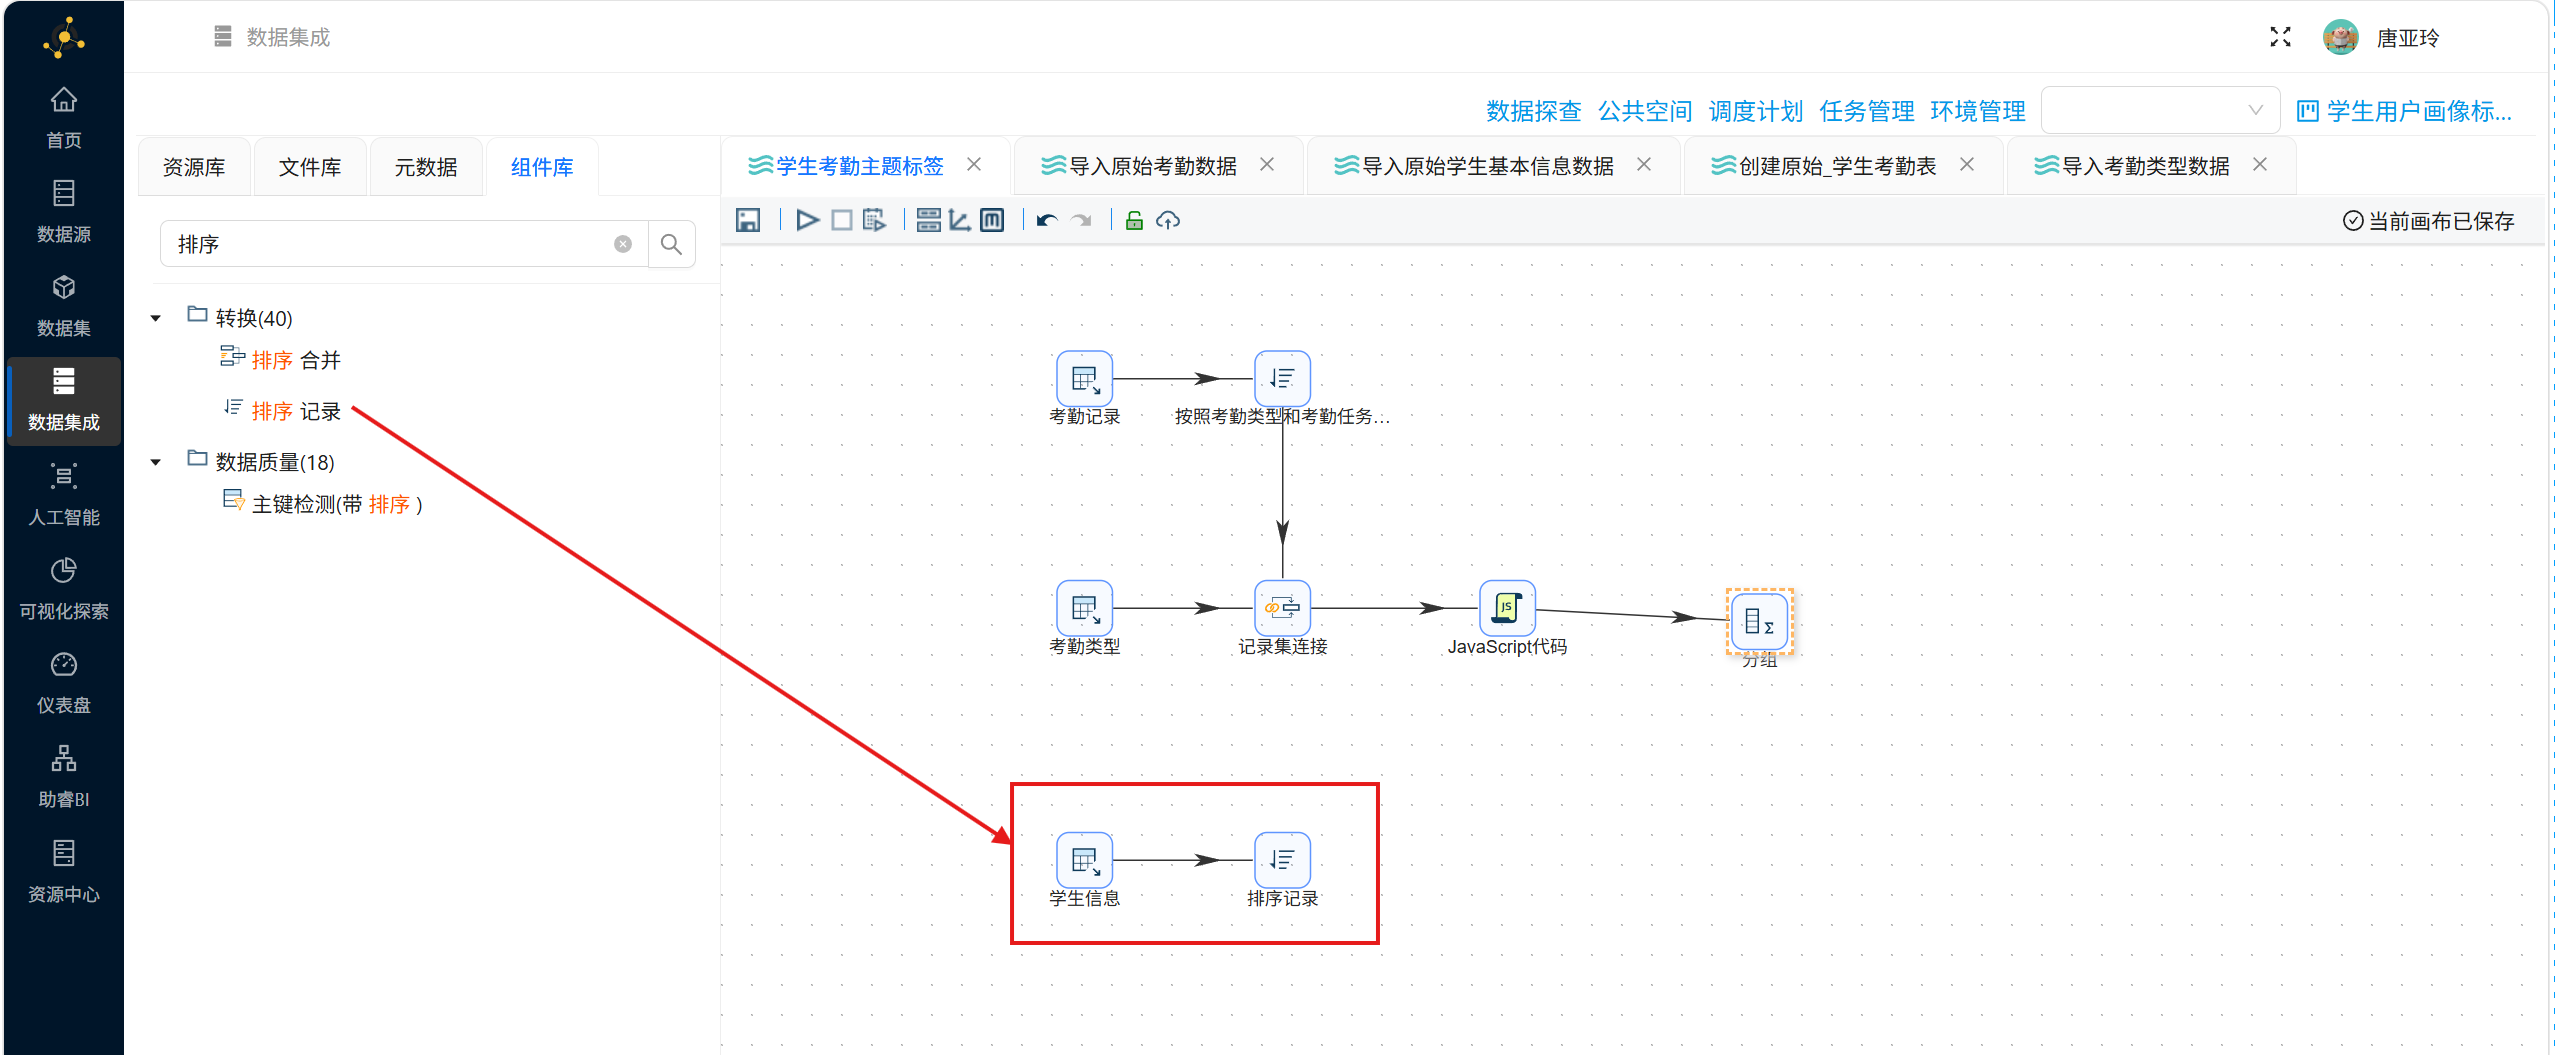
双击“排序记录”组件,设置步骤名称为“按照学生编号进行排序”。获取字段列表,只保留“stu_id”字段。因为下一步连接是使用这个字段进行连接,所以采用这个字段对记录进行排序。
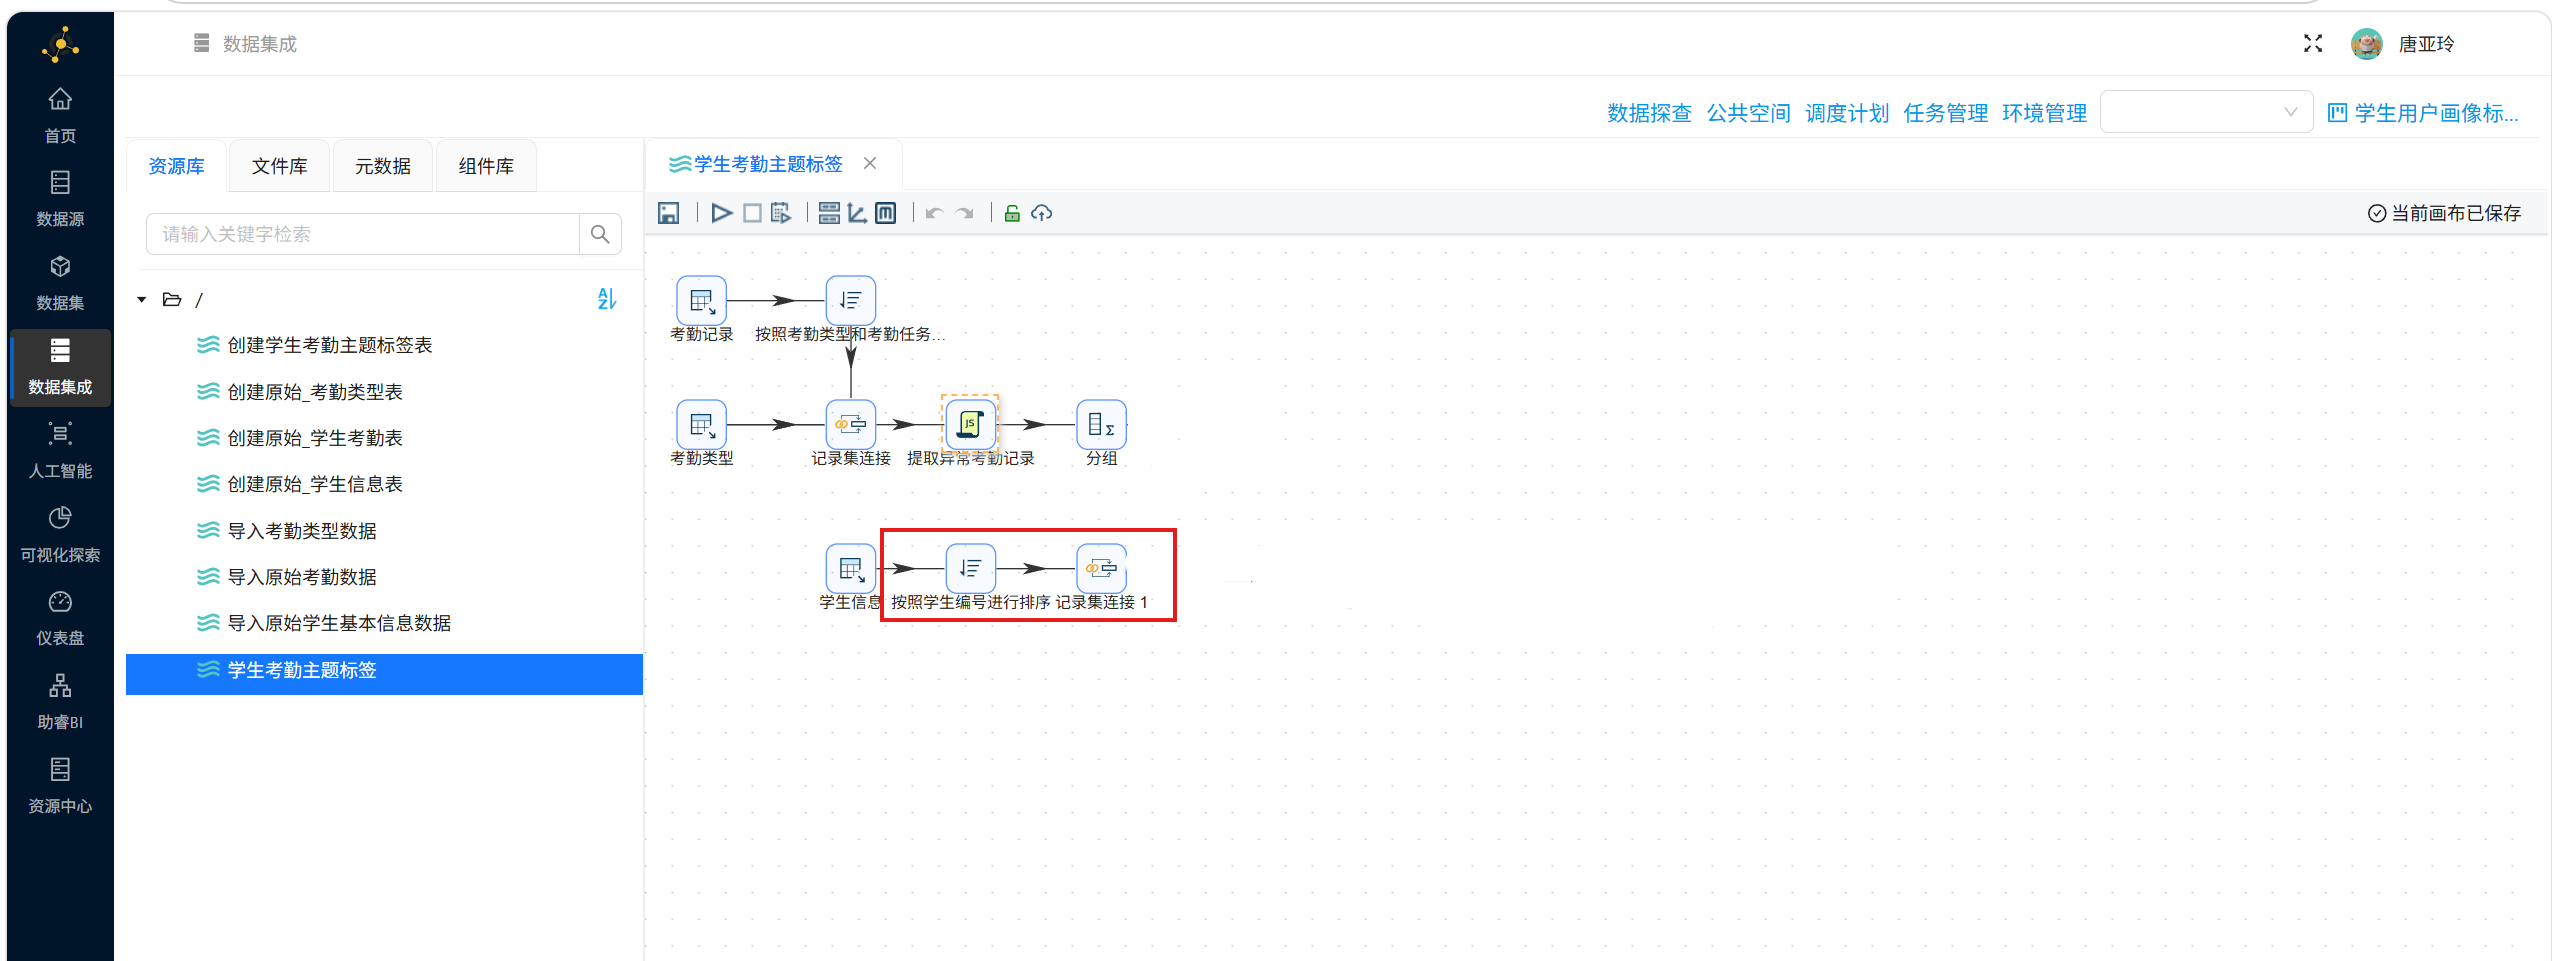
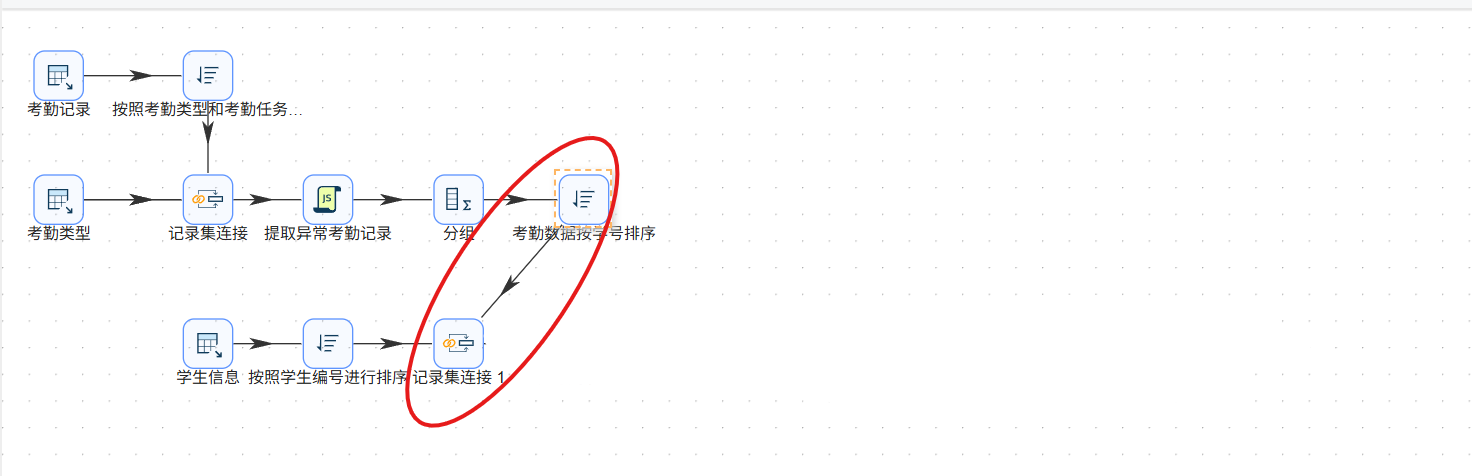
拖拽“记录集连接”组件至画布中,创建“按照学生编号进行排序”排序记录组件到“记录集连接 1”组件的连接线
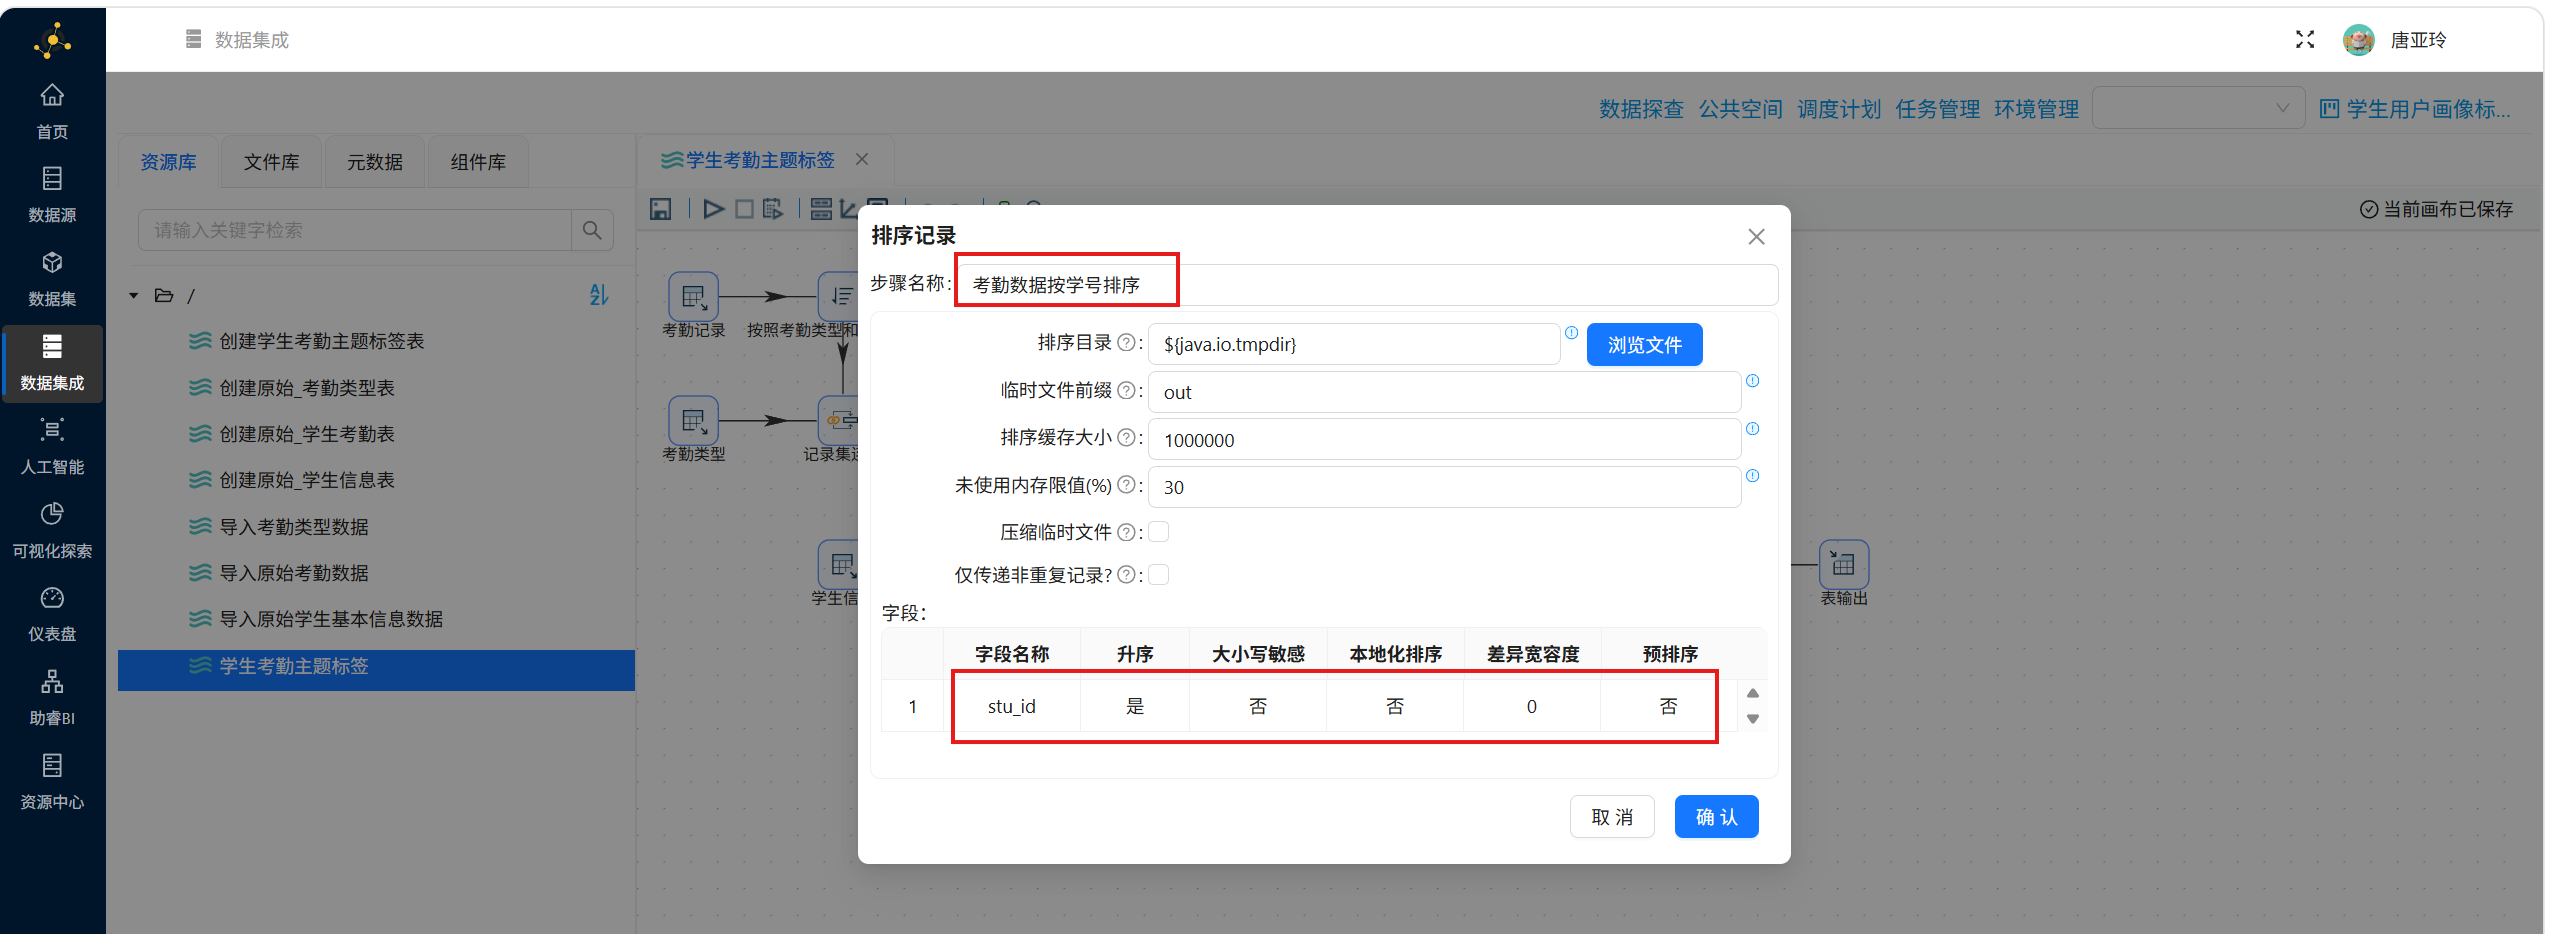
由于考勤记录数据不是按“学号”升序记录的,所以在进行记录关联前,也需要对数据进行排序。再次添加“排序记录”,并建立“记录集连接”组件到“排序记录”组件的连接线
双击“排序记录”组件,步骤名称设置为“考勤数据按学号排序”,排序字段为“stu_id”
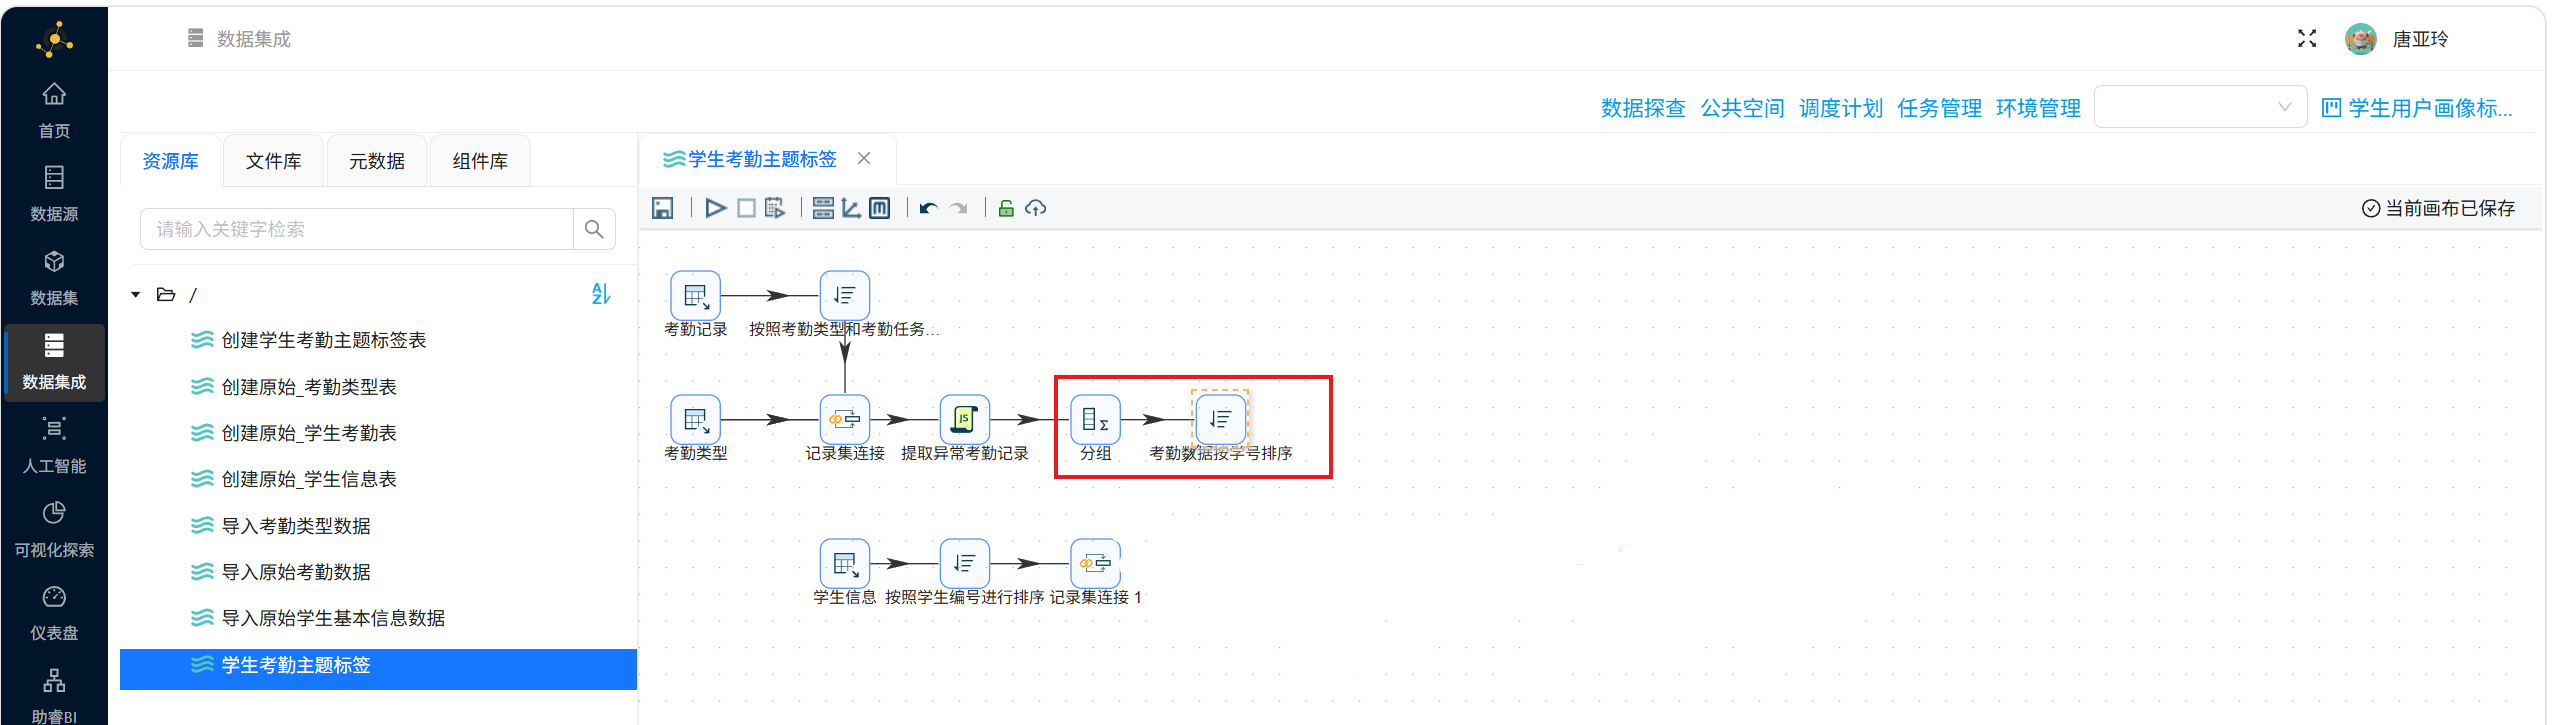
创建“考勤数据按学号排序”记录排序组件到记录集连接 1组件的连线,关联学生信息和考勤记录信息
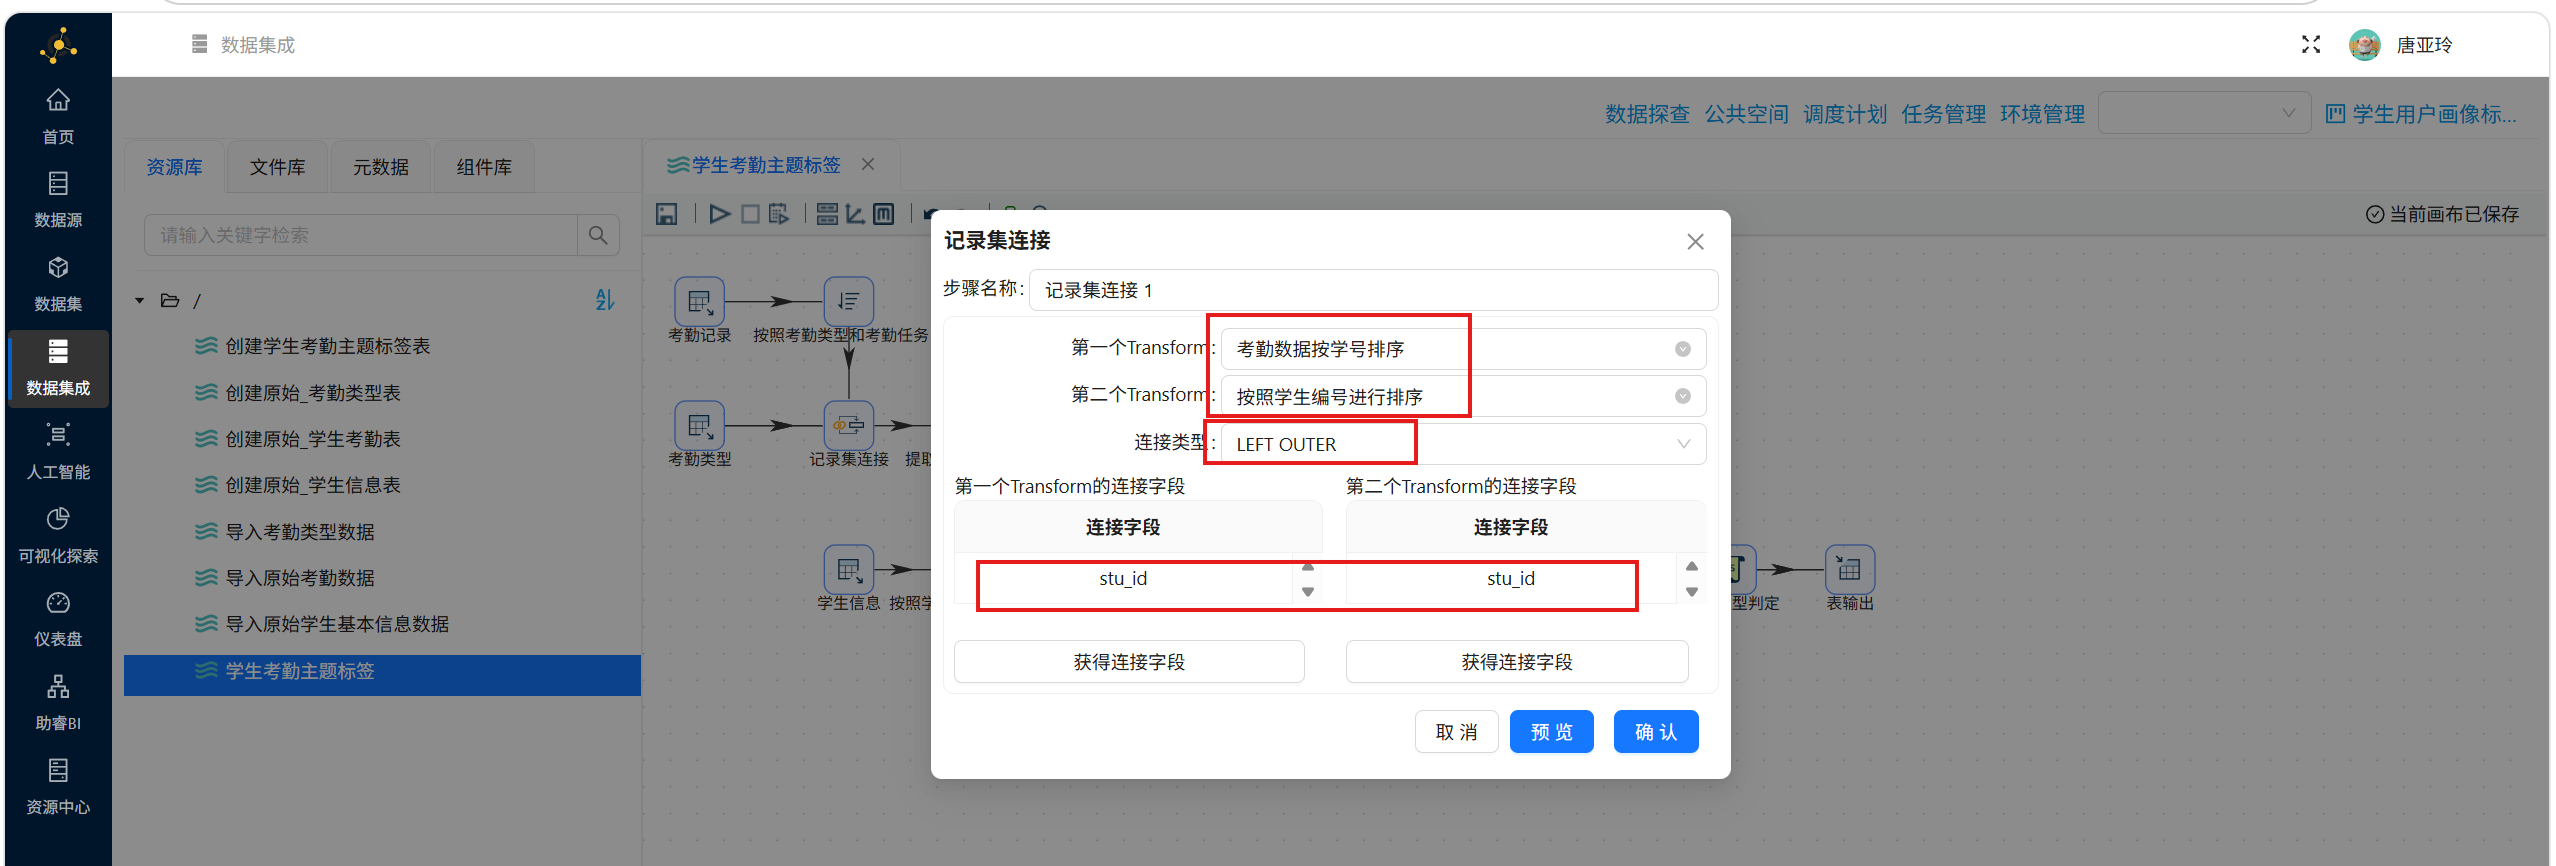
记录集连接 1组件的第一个Transform选择“考勤数据按学号排序”,第二个Transform选择“按照学生编号进行排序”,连接类型选择LEFT OUTER,使用考勤记录的字段 stu_id与学生信息的字段 stu_id进行左外连接
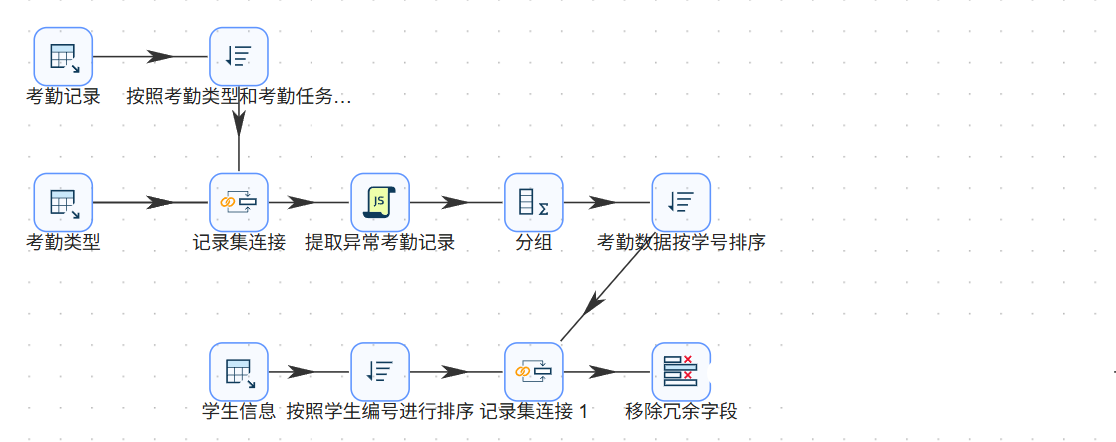
3.6.7 字段选择:移除冗余字段
经过多表关联和前期接入,数据中会包含大量与考勤统计无关的字段(如学生信息表中的非必要属性),需要对关联后的数据进行冗余字段移除。
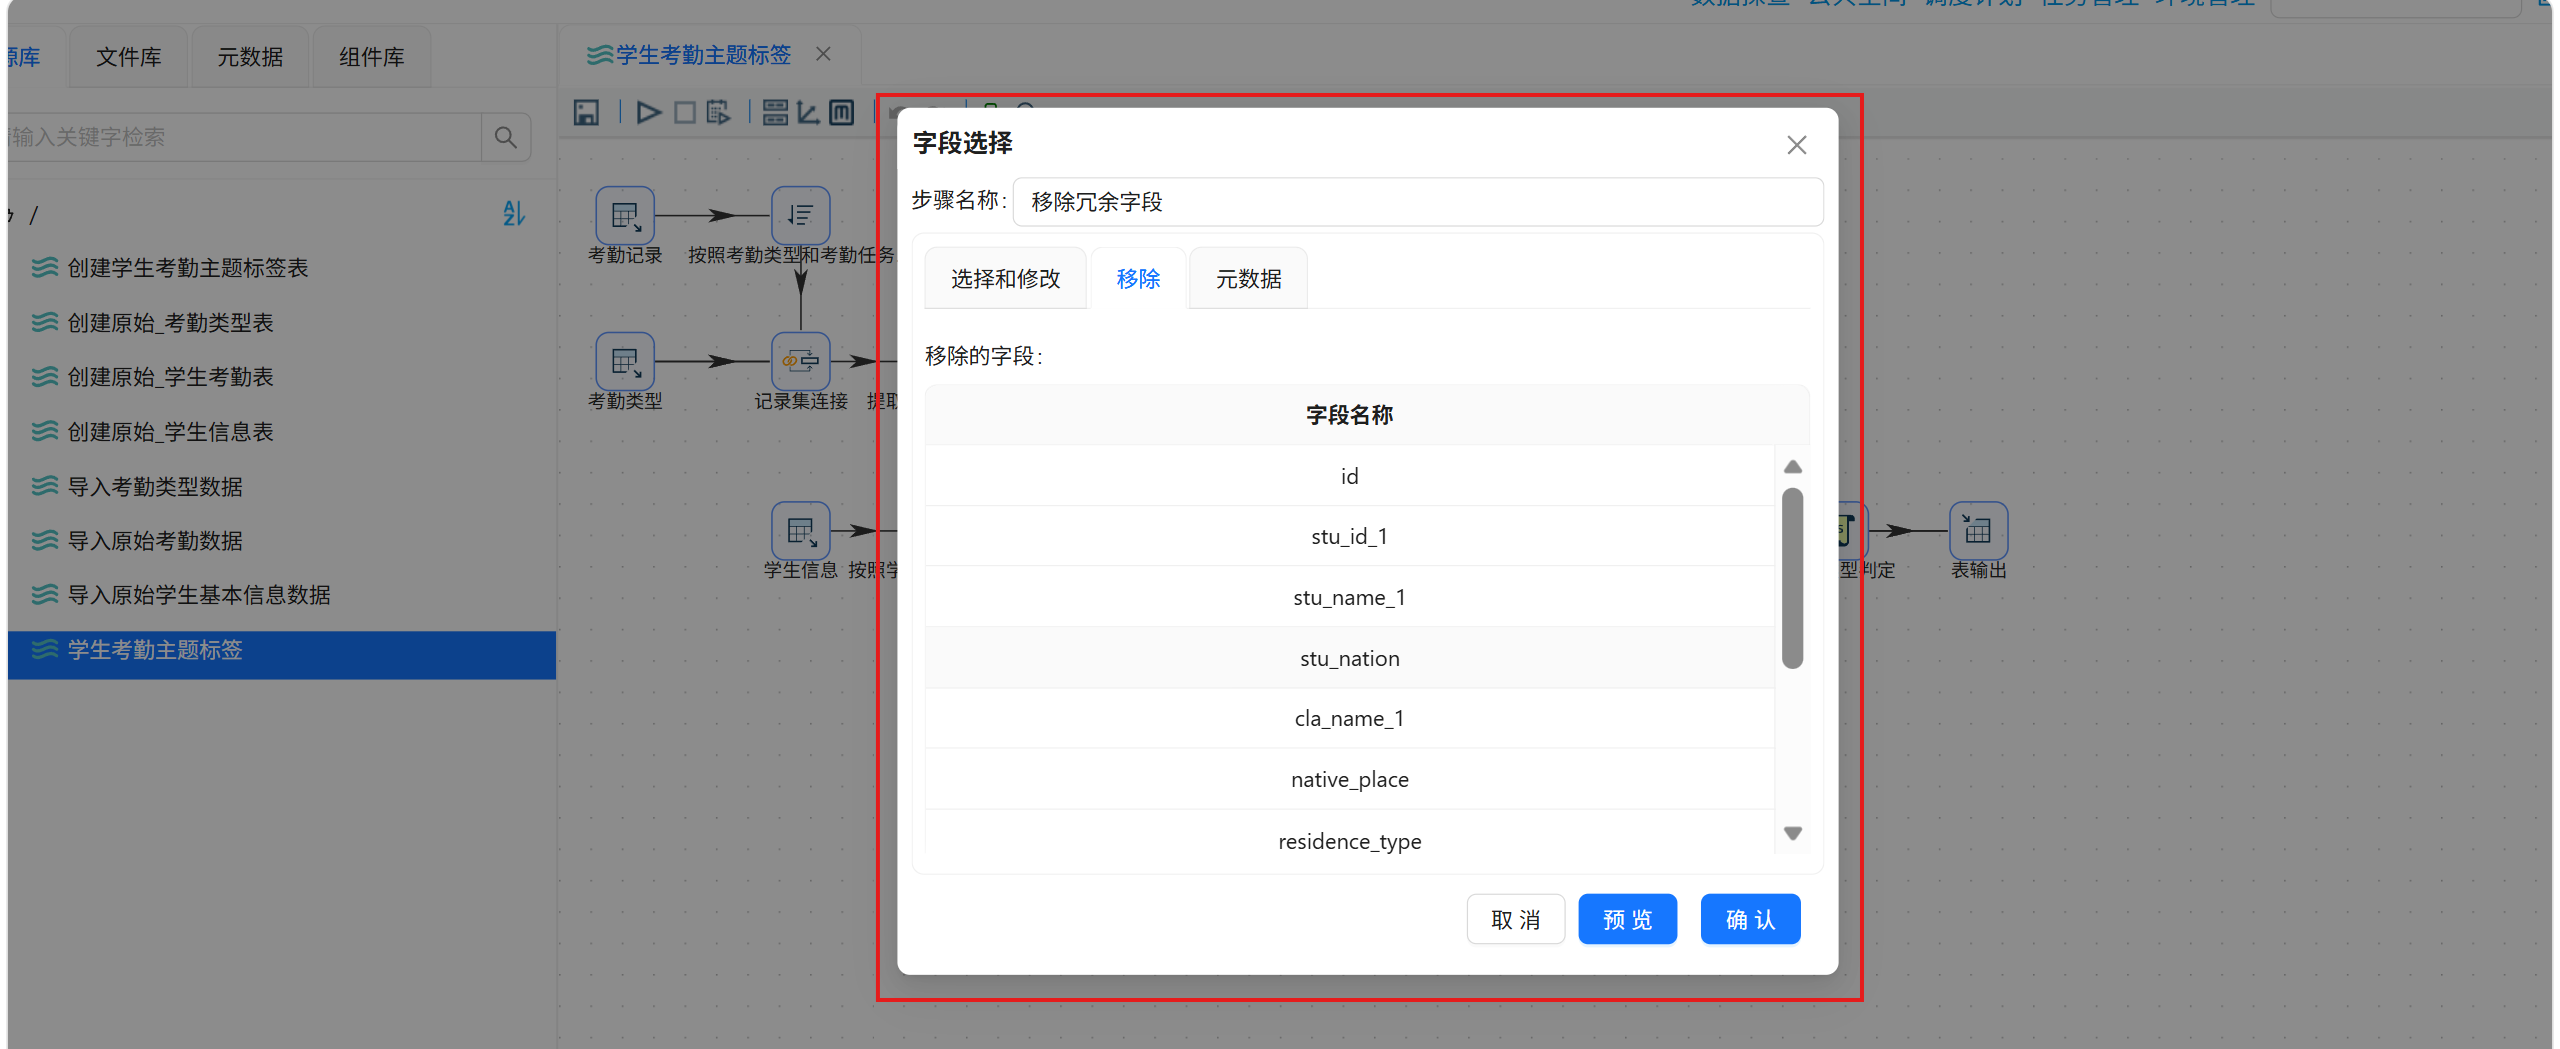
拖拽1个“字段选择”组件至画布中,创建“记录集连接 1”组件到字段选择组件的连接线,步骤名称输入“移除冗余字段”,点击“移除”标签,右键空白处并点击“获取字段”
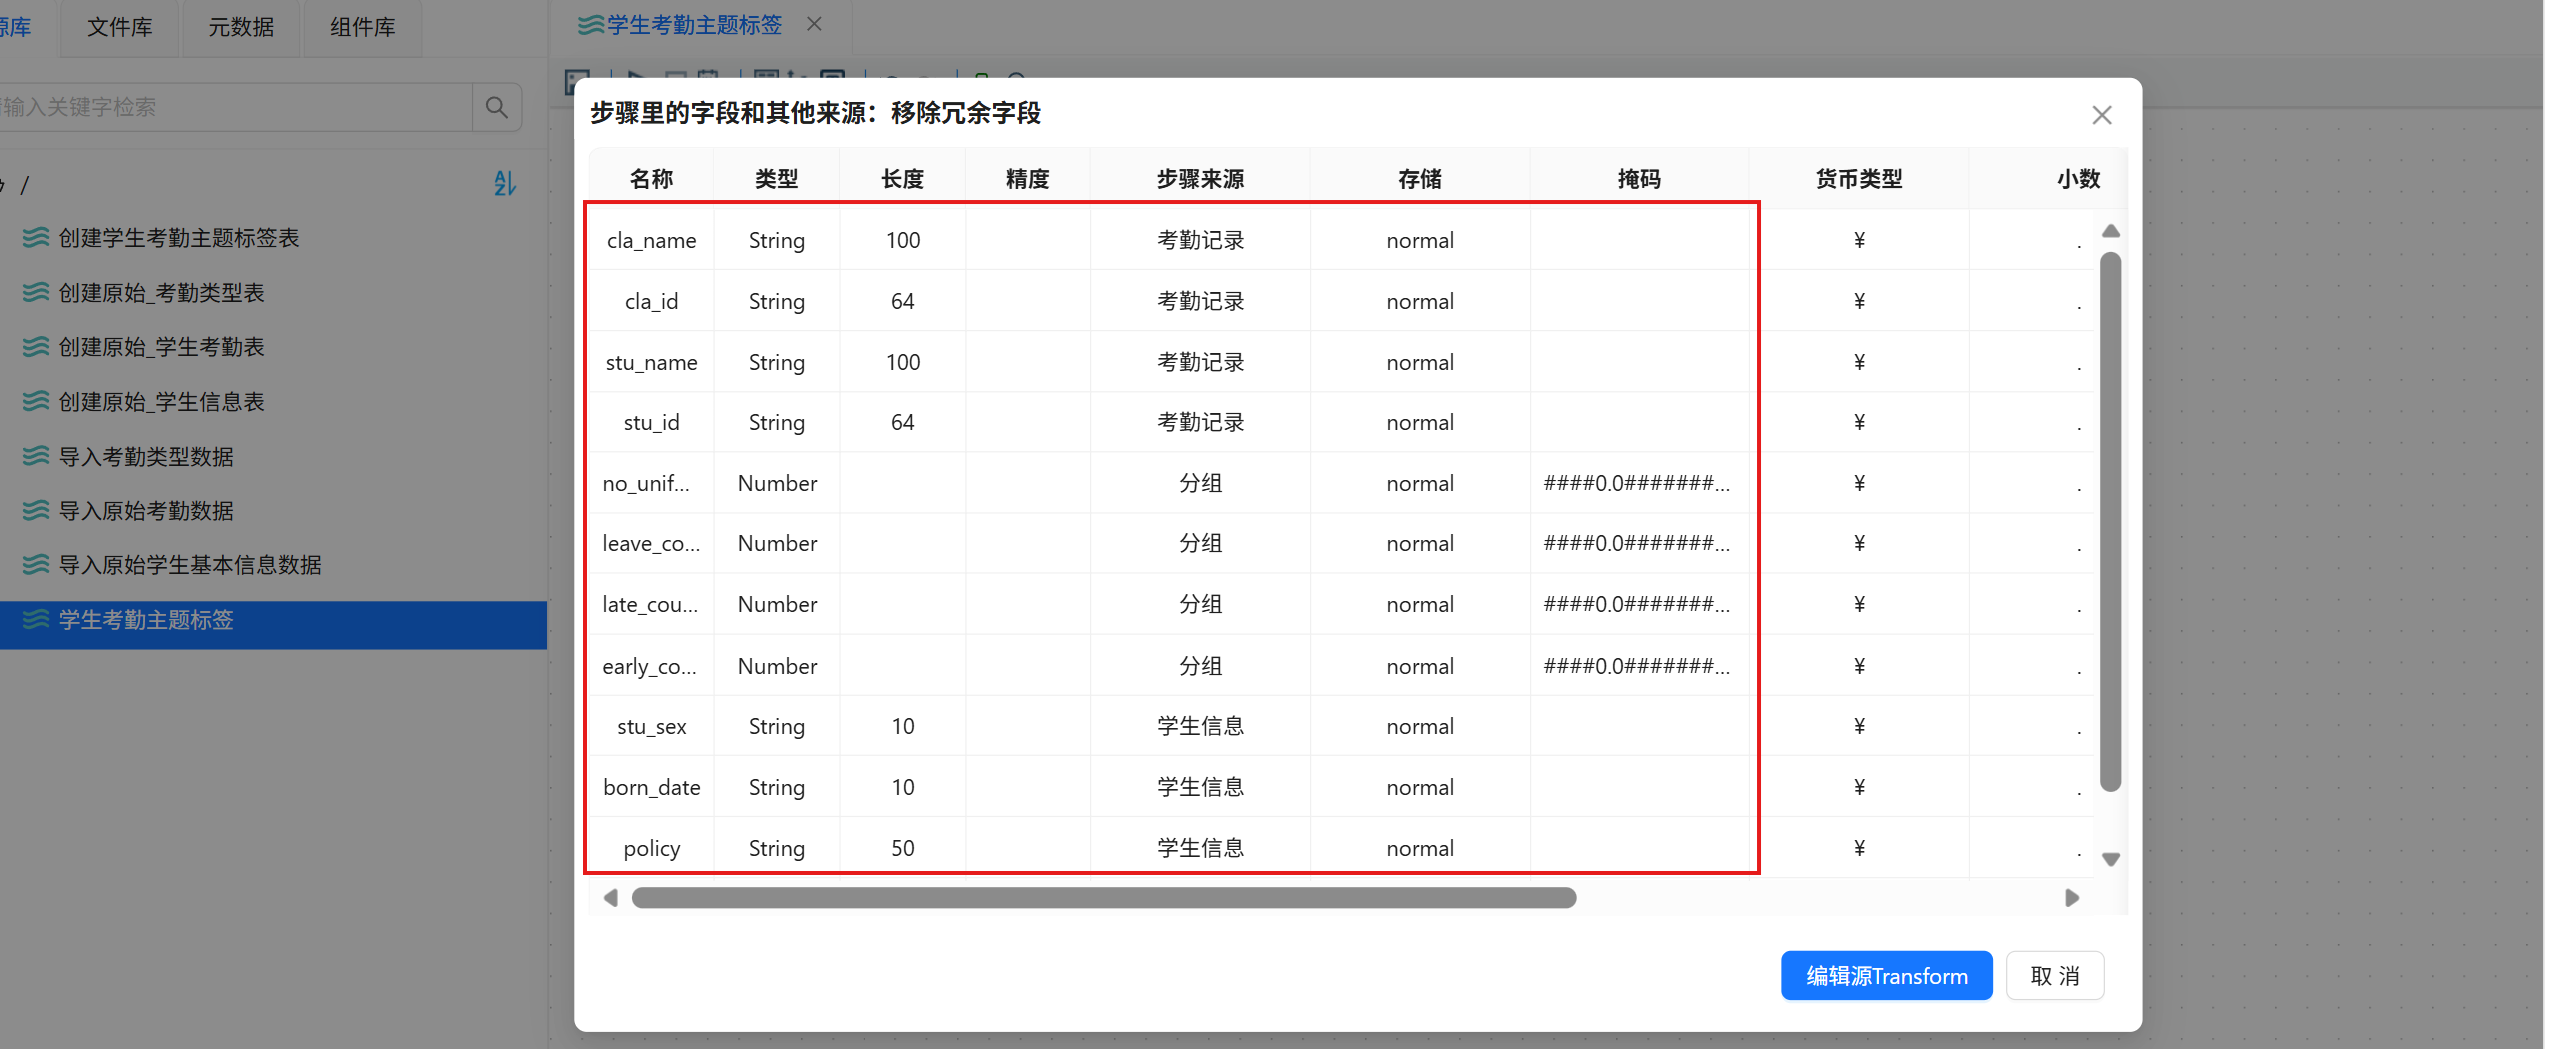
在获取的字段中,删除以下核心字段外,其他字段保留,表示要移除下列字段,为后续时间维度拆解和行为标签衍生奠定基础:
- 学生 ID(stu_id)
- 学生姓名(stu_name)
- 班级 ID(cla_id)
- 班级名称(cla_name)
- 迟到次数(late_count);
- 早退次数(early_count);
- 请假次数(leave_count);
- 没穿校服次数(no_uniform_count)
- 性别(stu_sex)
- 出生日期(born_date)
- 政治面貌(policy)
- 是否住校(live_on_campus
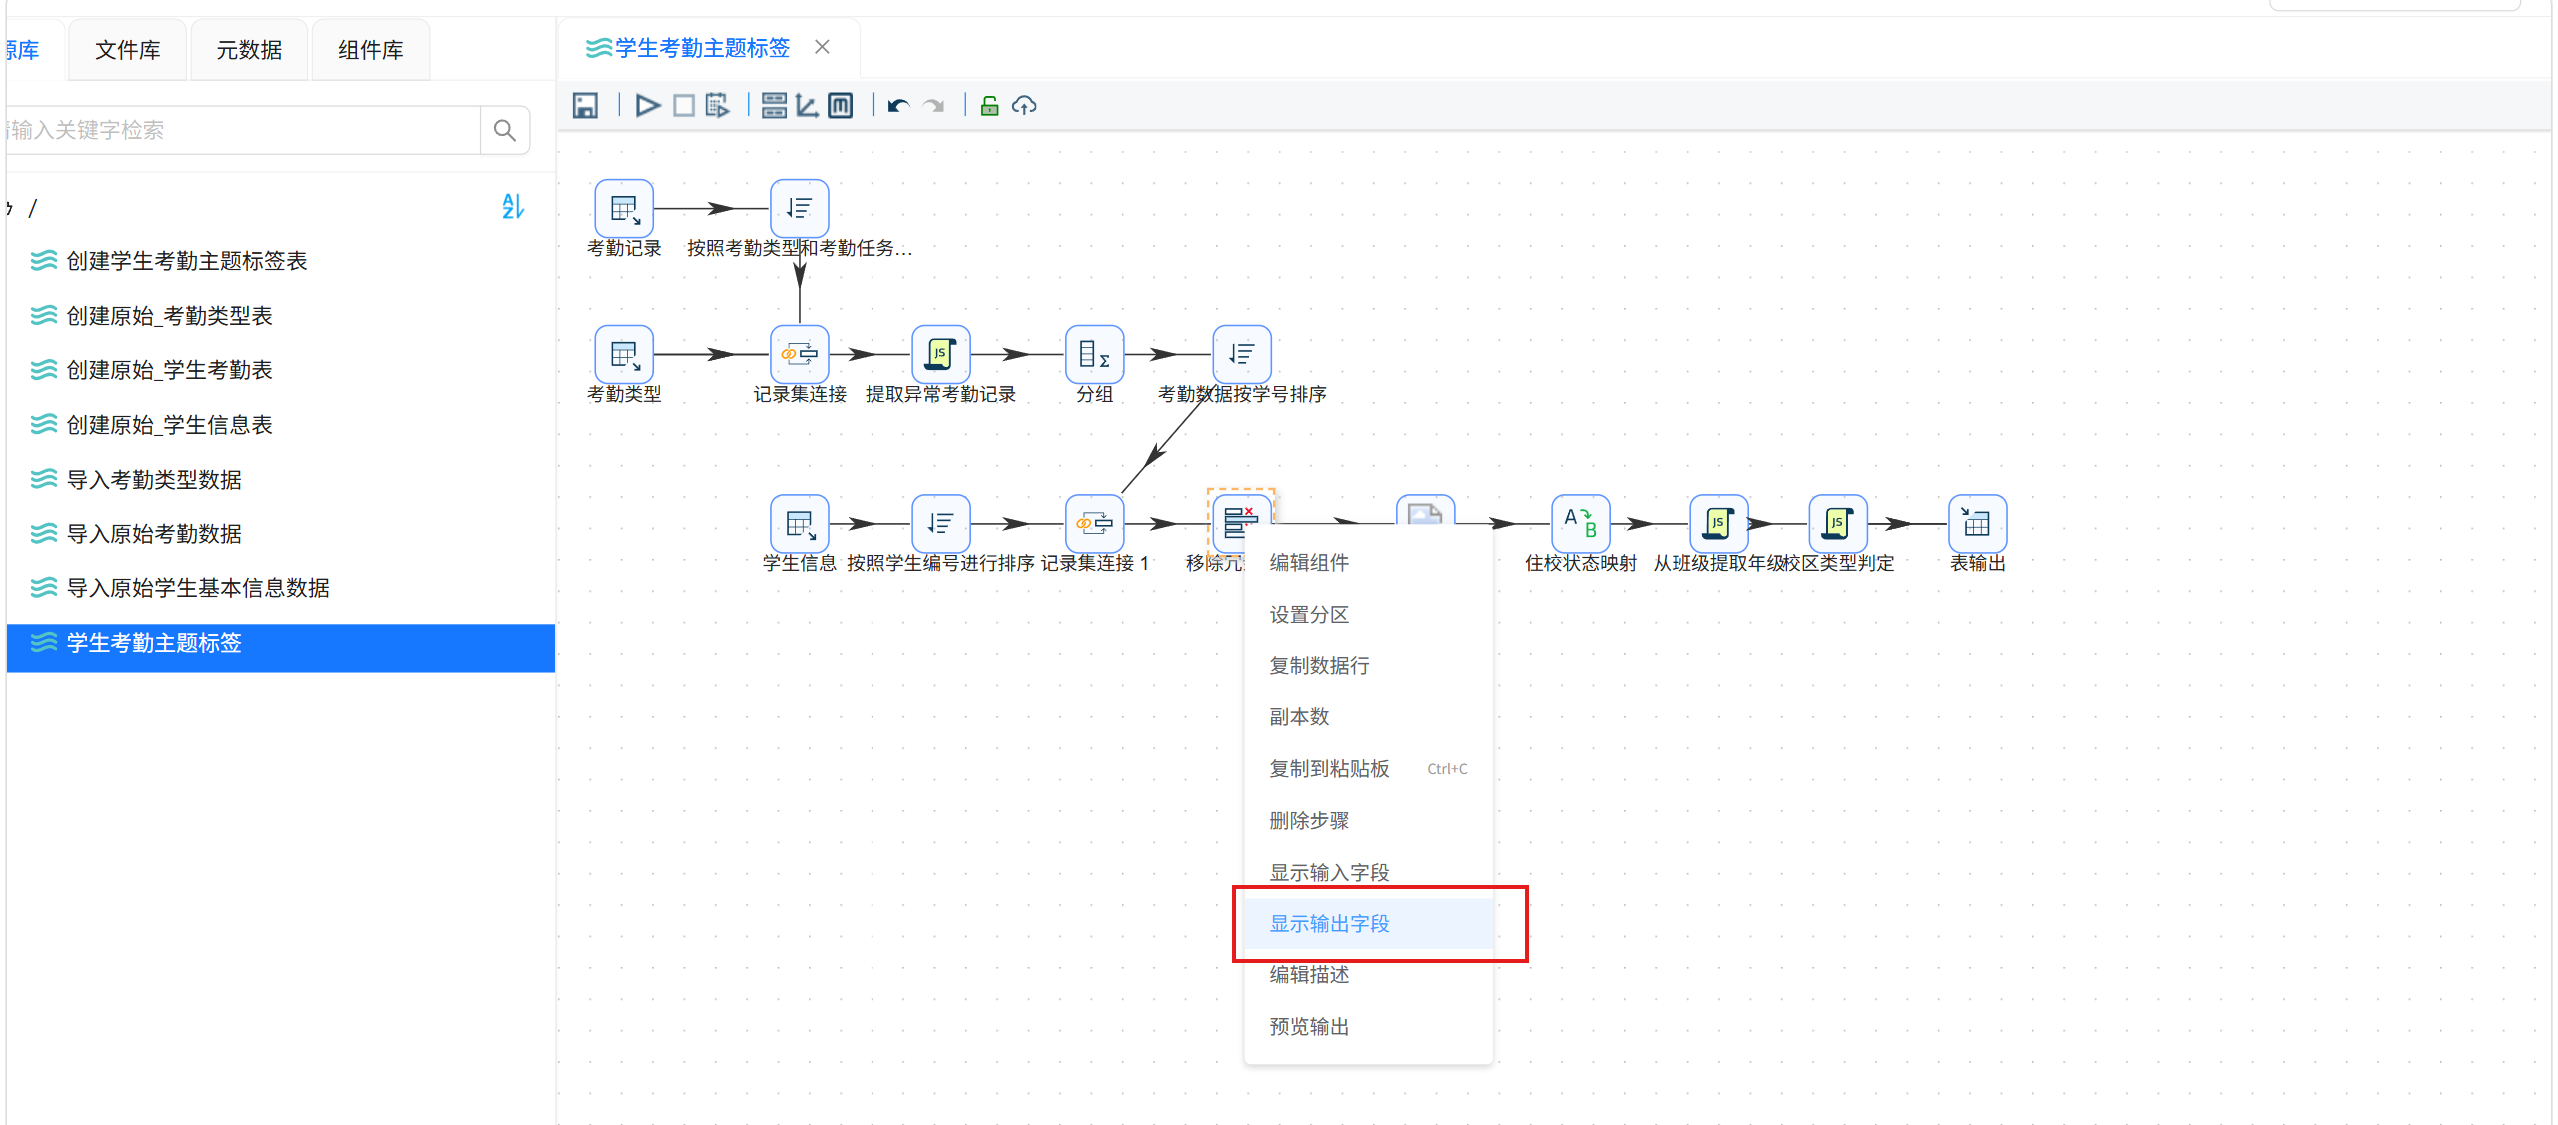
在字段选择组件鼠标右键弹出菜单,点击“显示输出字段”,查看输出字段是否正确
3.6.8 空值处理
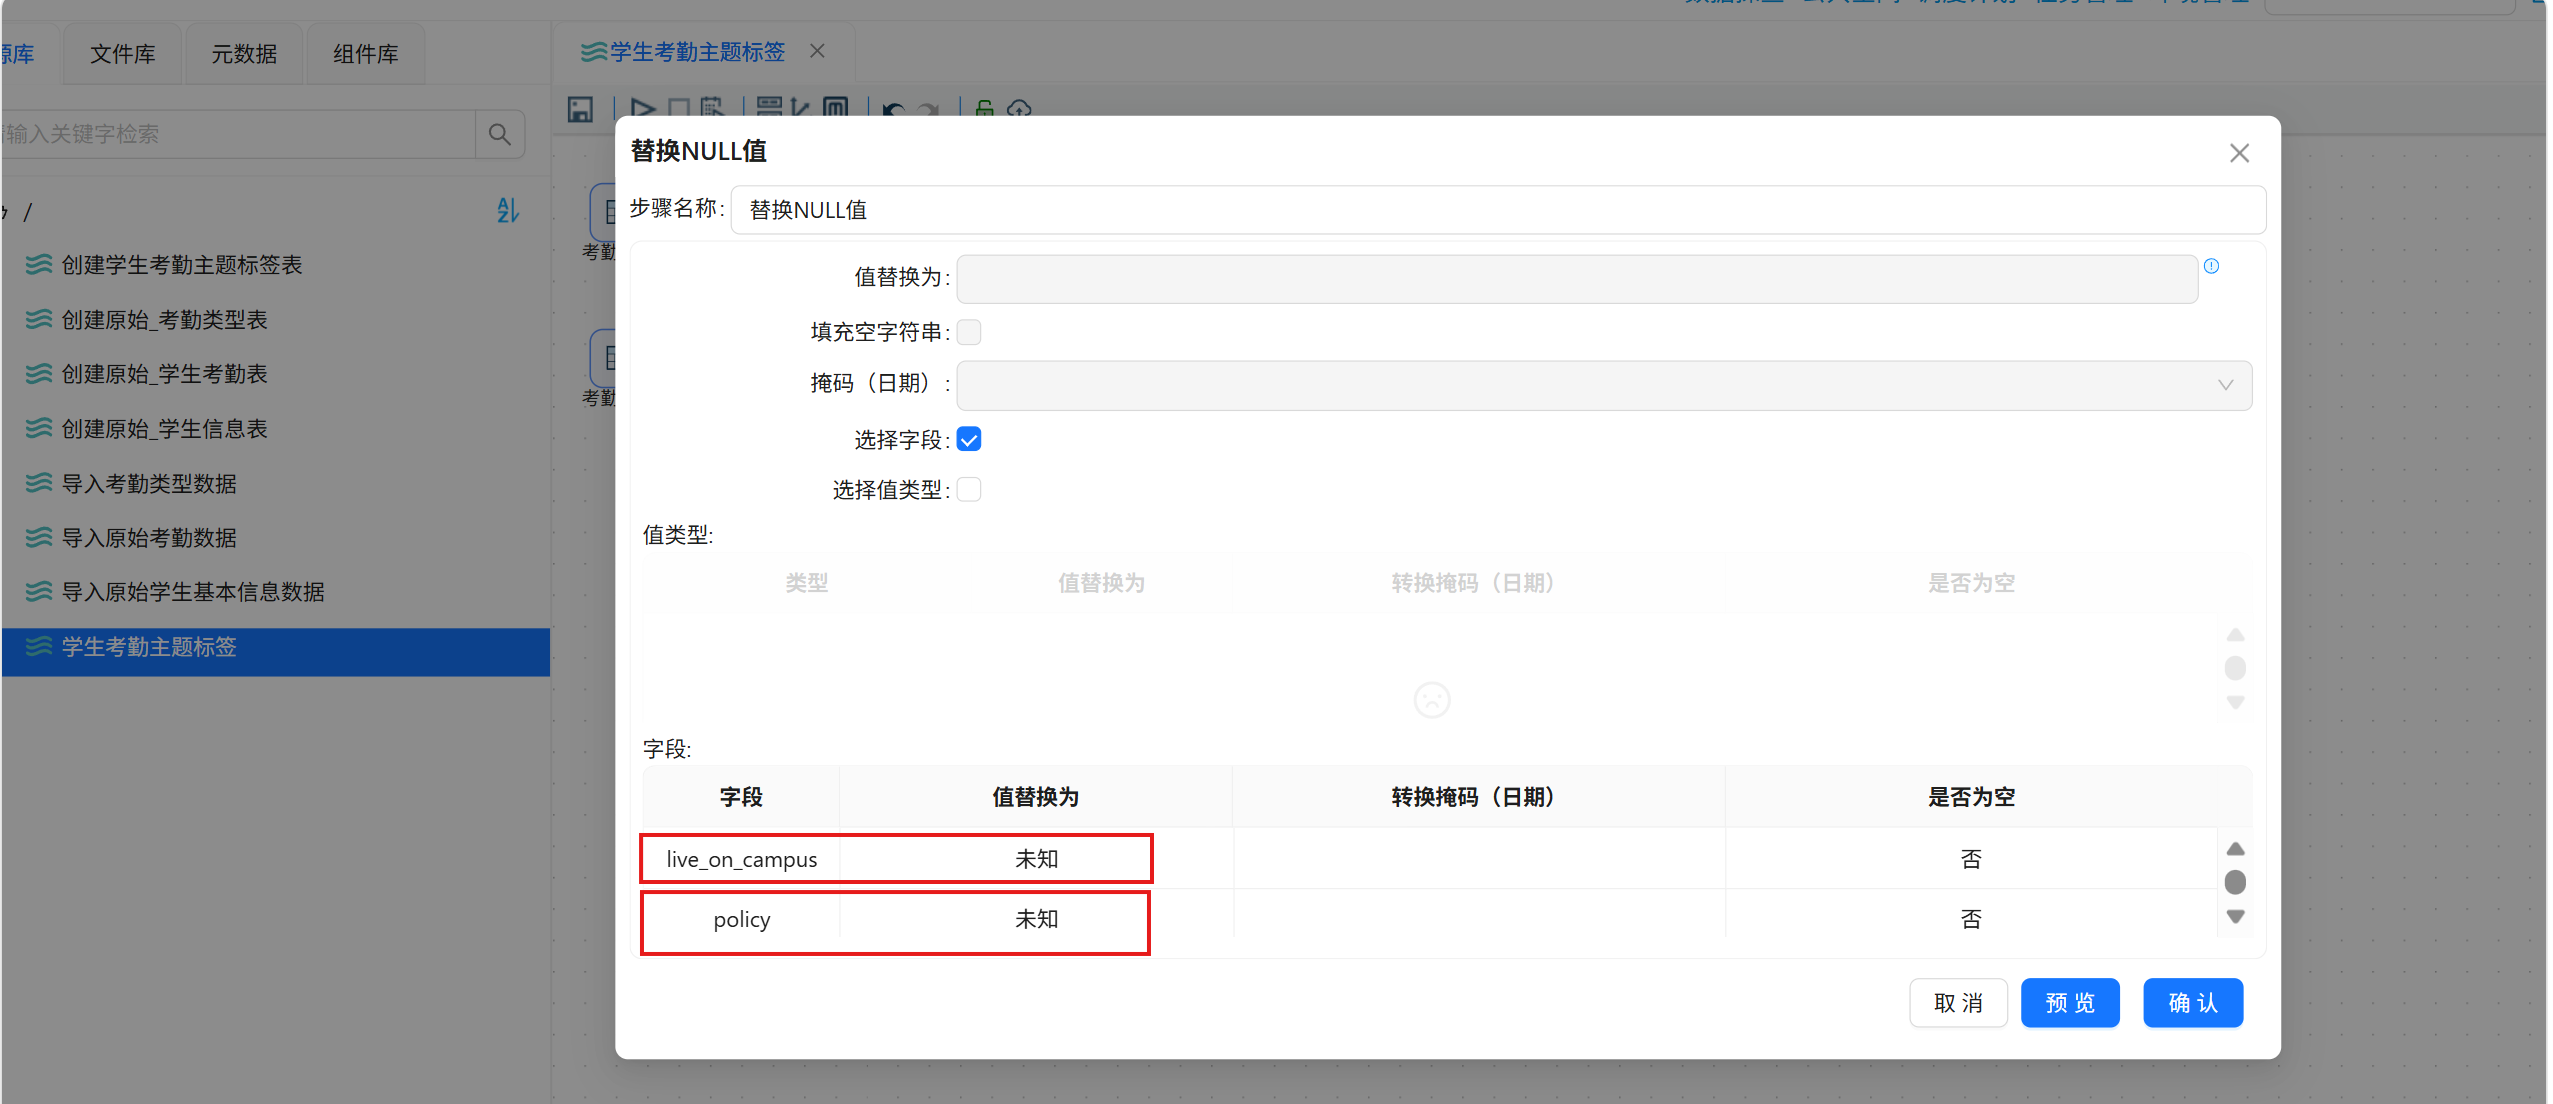
3个数据表关联后,字段“stu_sex”、“born_date”、“policy”、“live_on_campus”存在空值,需要对这些空值进行处理。
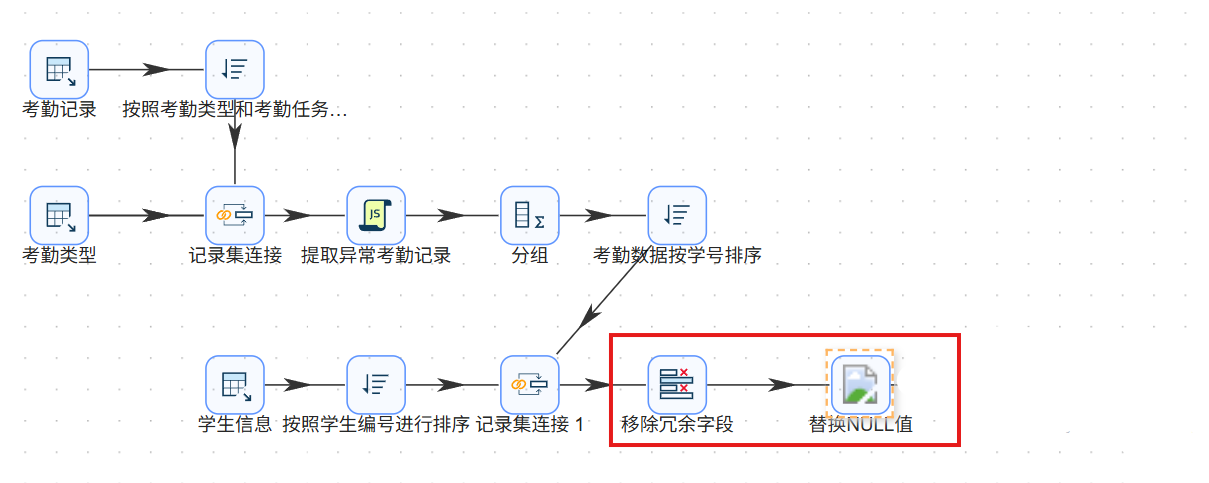
拖拽“替换NULL值”组件至画布,创建“移除冗余字段”字段选择组件到“替换NULL值”组件的连线,连线类型选择“主输出步骤”
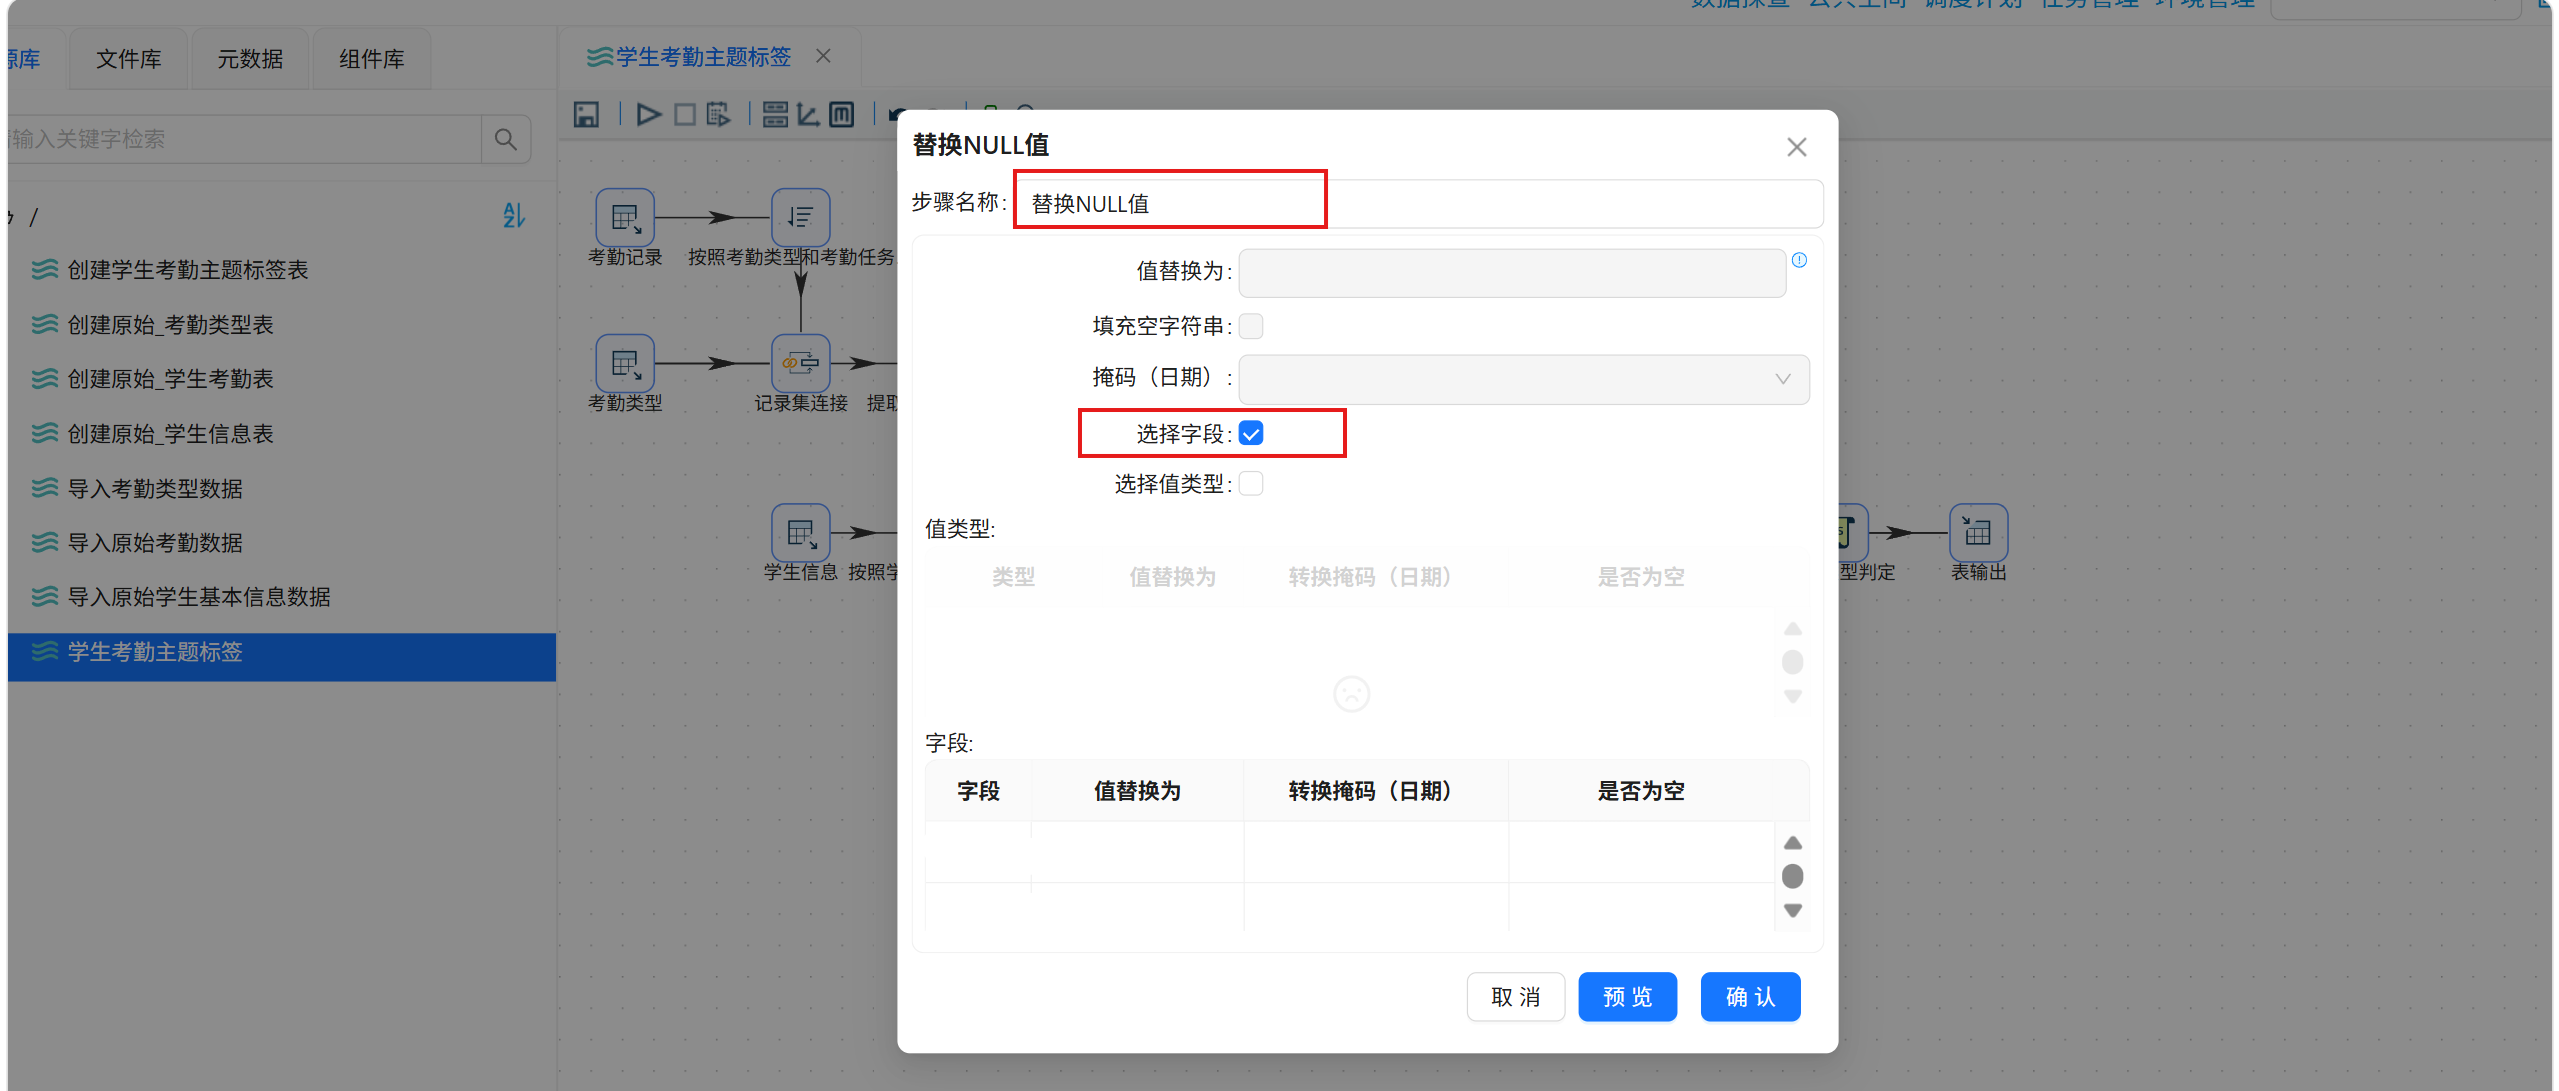
在字段空白表格中右键。点击“插入”,字段名称选择“stu_sex”,继续插入行,将“born_date”、“policy”、“live_on_campus”的空值均替换为“未知”
3.6.9 学生基础属性标准化处理
多表关联与字段筛选后,原始数据中住校状态为编码值,且缺少年级、校区类型等画像分析必需字段,无法直接用于学生考勤标签输出与后续用户画像分析。因此需要对学生基础属性进行标准化映射、缺失字段衍生,统一数据格式、补齐分析维度,保证标签表规范可用。
(1)住校状态映射
添加“值映射”组件到画布中,并创建替换NULL值组件到值映射组件的连线,并选择“主输出步骤”
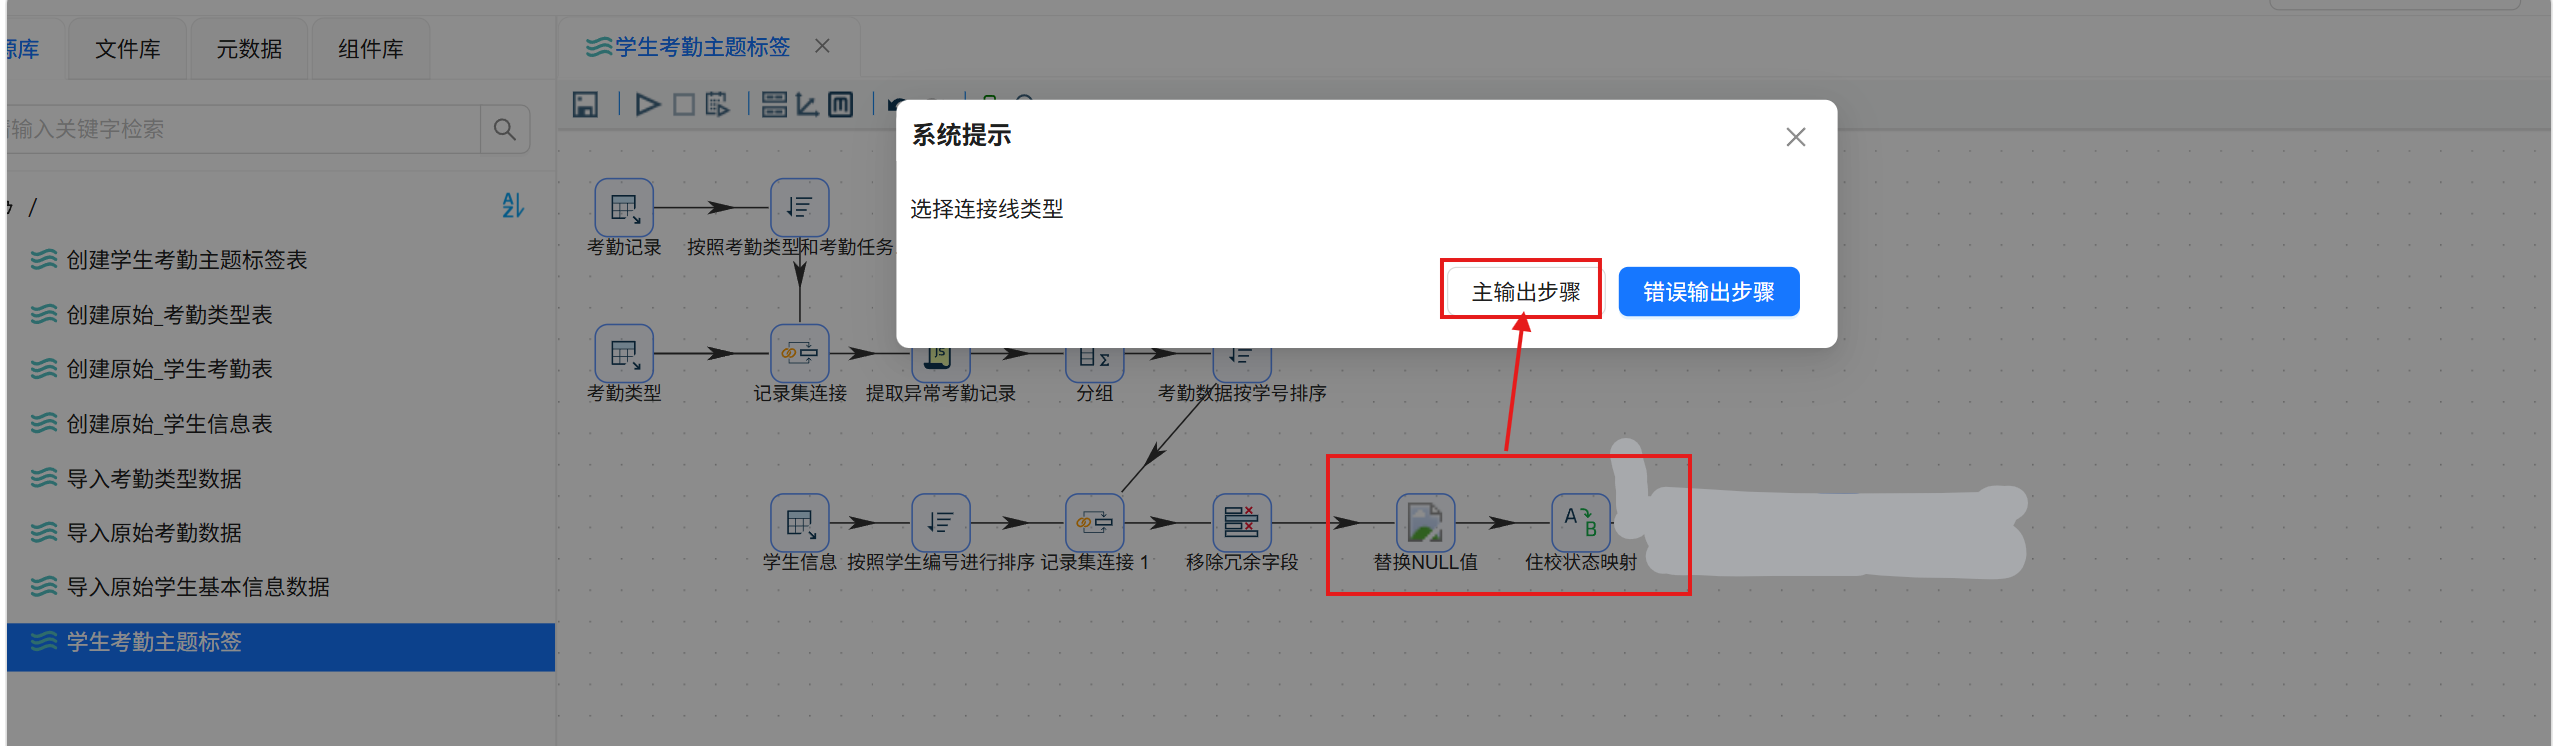
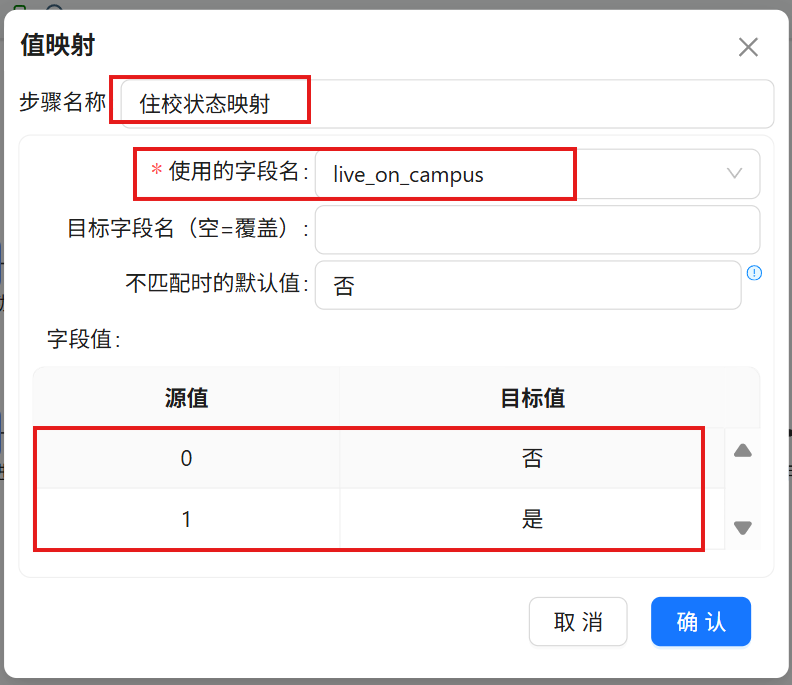
双击“值映射”组件,步骤名称改为“住校状态映射”,使用的字段名为 “live_on_campus”,不匹配时的默认值为 “否”;双击插入的行,在源值中输入“0”,目标值输入“否”,代表将原数据中的“0”统一映射为“否”,“1”的目标值为 “是”
(2) 从班级名提取年级
通过从班级名称中提取年级信息,补齐年级维度,支撑年级层面的考勤分析。
拖拽“JavaScript代码”组件至画布中,创建住校状态映射组件到JavaScript代码组件的连线
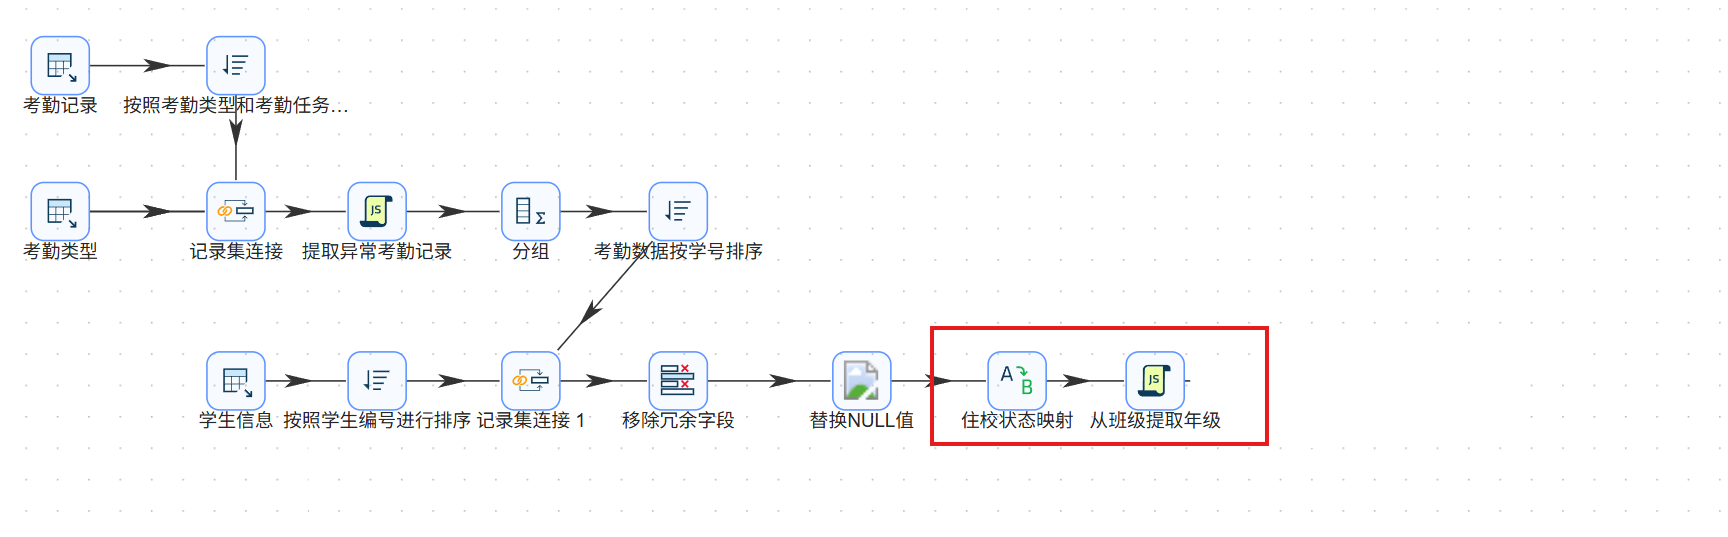
字段名称输入“gra_name”,类型为“String”,替换“字段名”或“重命名”值选择“否”,设置完成后点击“确认”
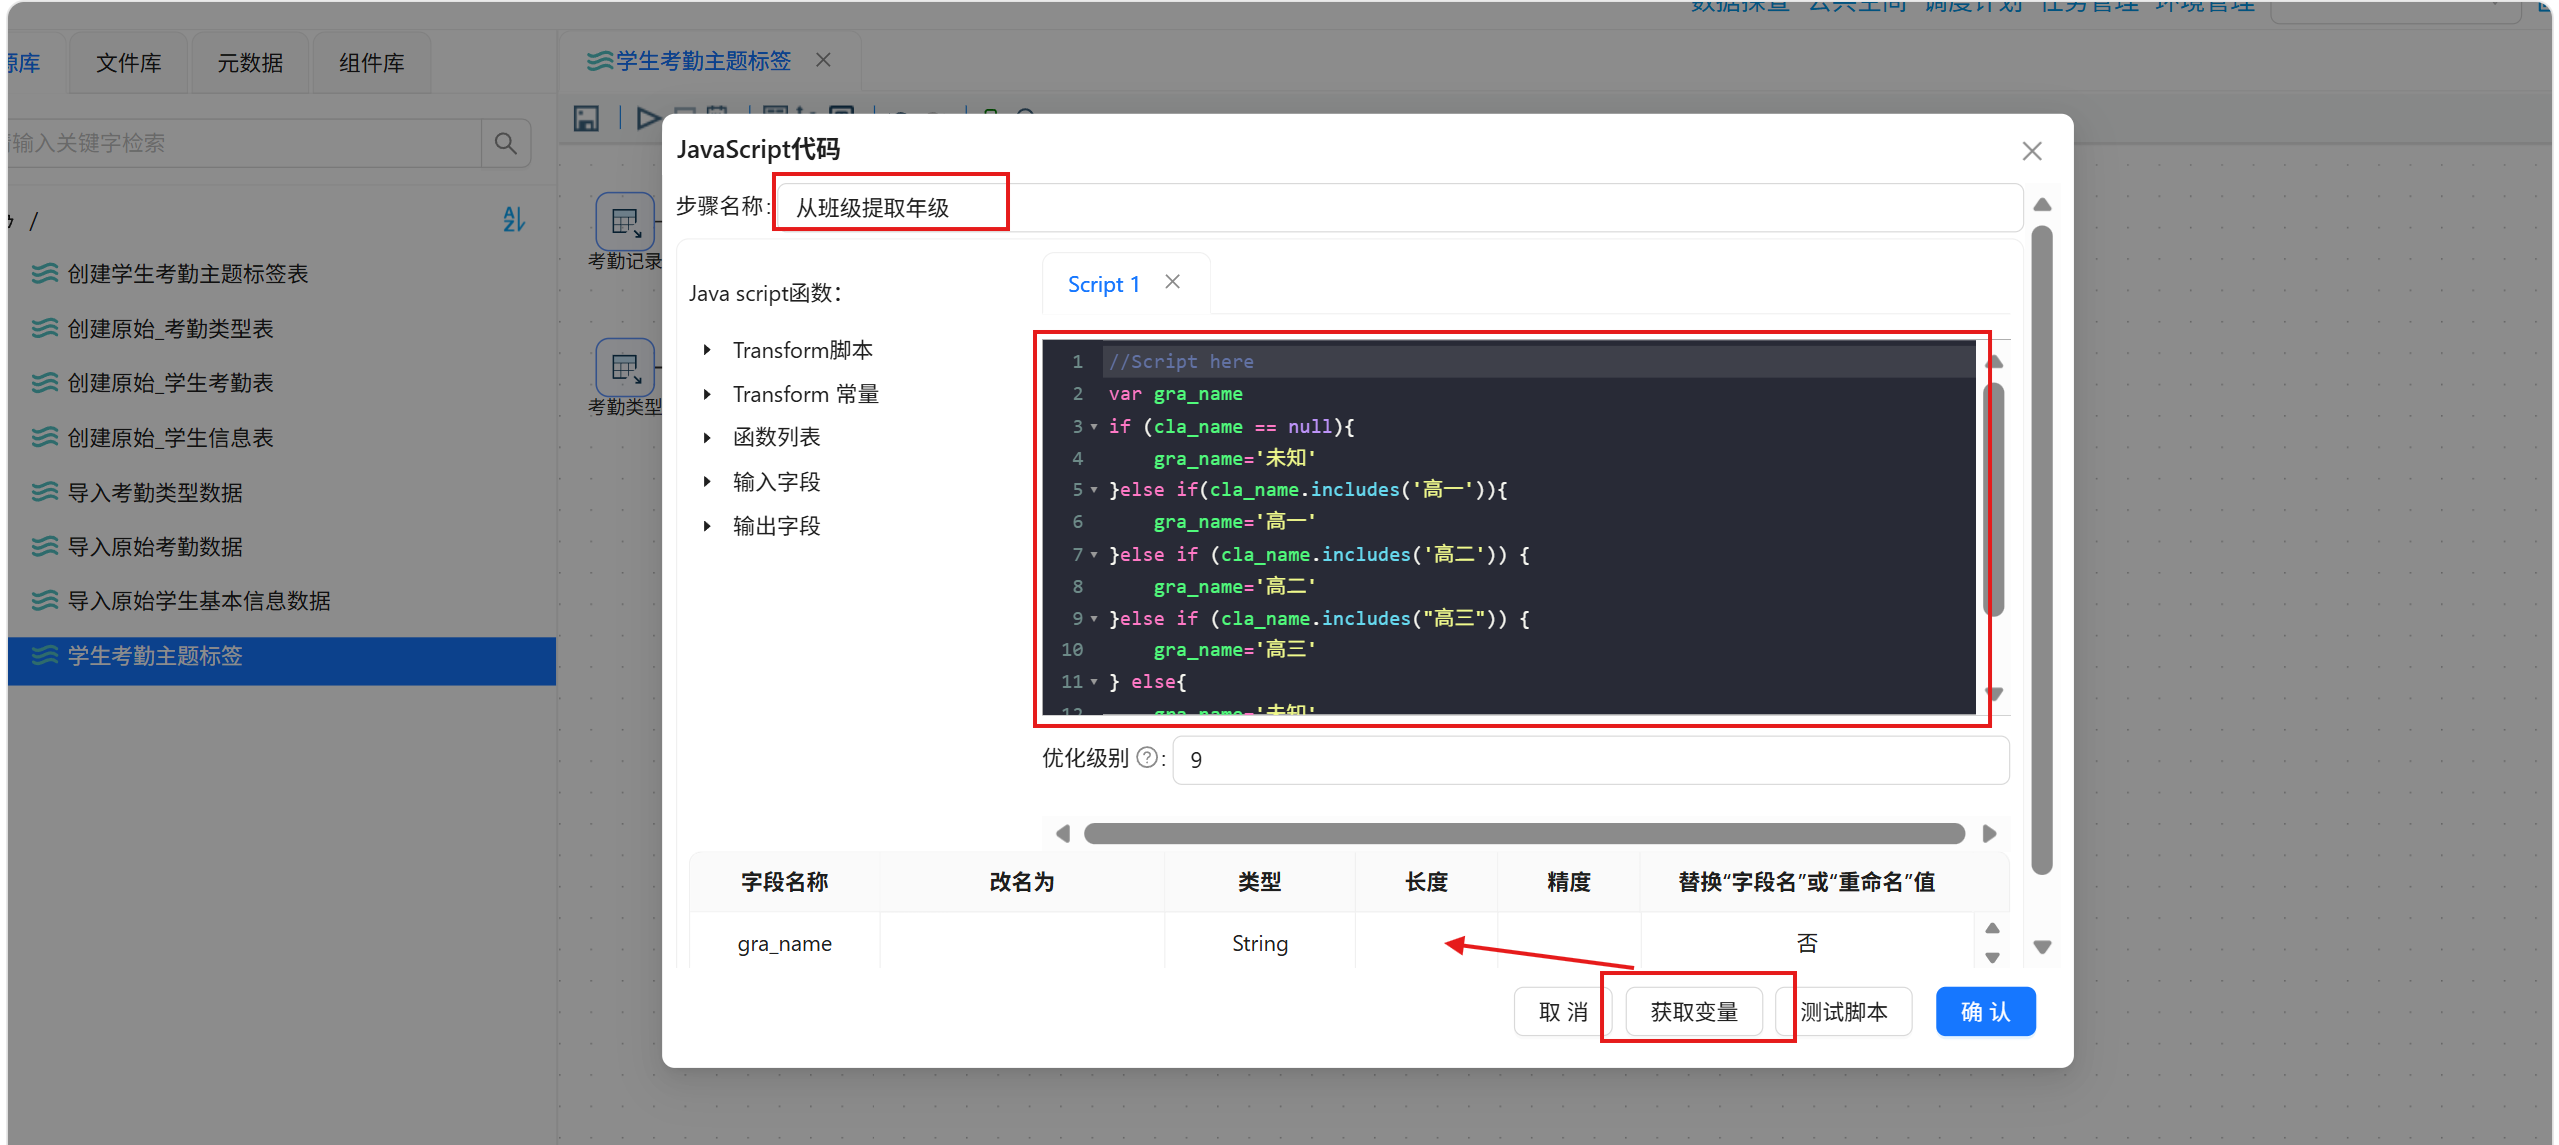
JavaScript代码脚本如下,实现从班级名称中提取出年级字段:
var gra_name
if (cla_name == null){
  gra_name='未知'
}else if(cla_name.includes('高一')){
  gra_name='高一'
}else if (cla_name.includes('高二')){
  gra_name='高二'
}else if (cla_name.includes("高三")){
  gra_name='高三'
} else{
  gra_name='未知'
}
(3)校区类型判定
原始数据无校区类型字段,不同校区管理口径与考勤规则存在差异,通过班级名称规则判定老校区/新校区,增加校区分析维度。
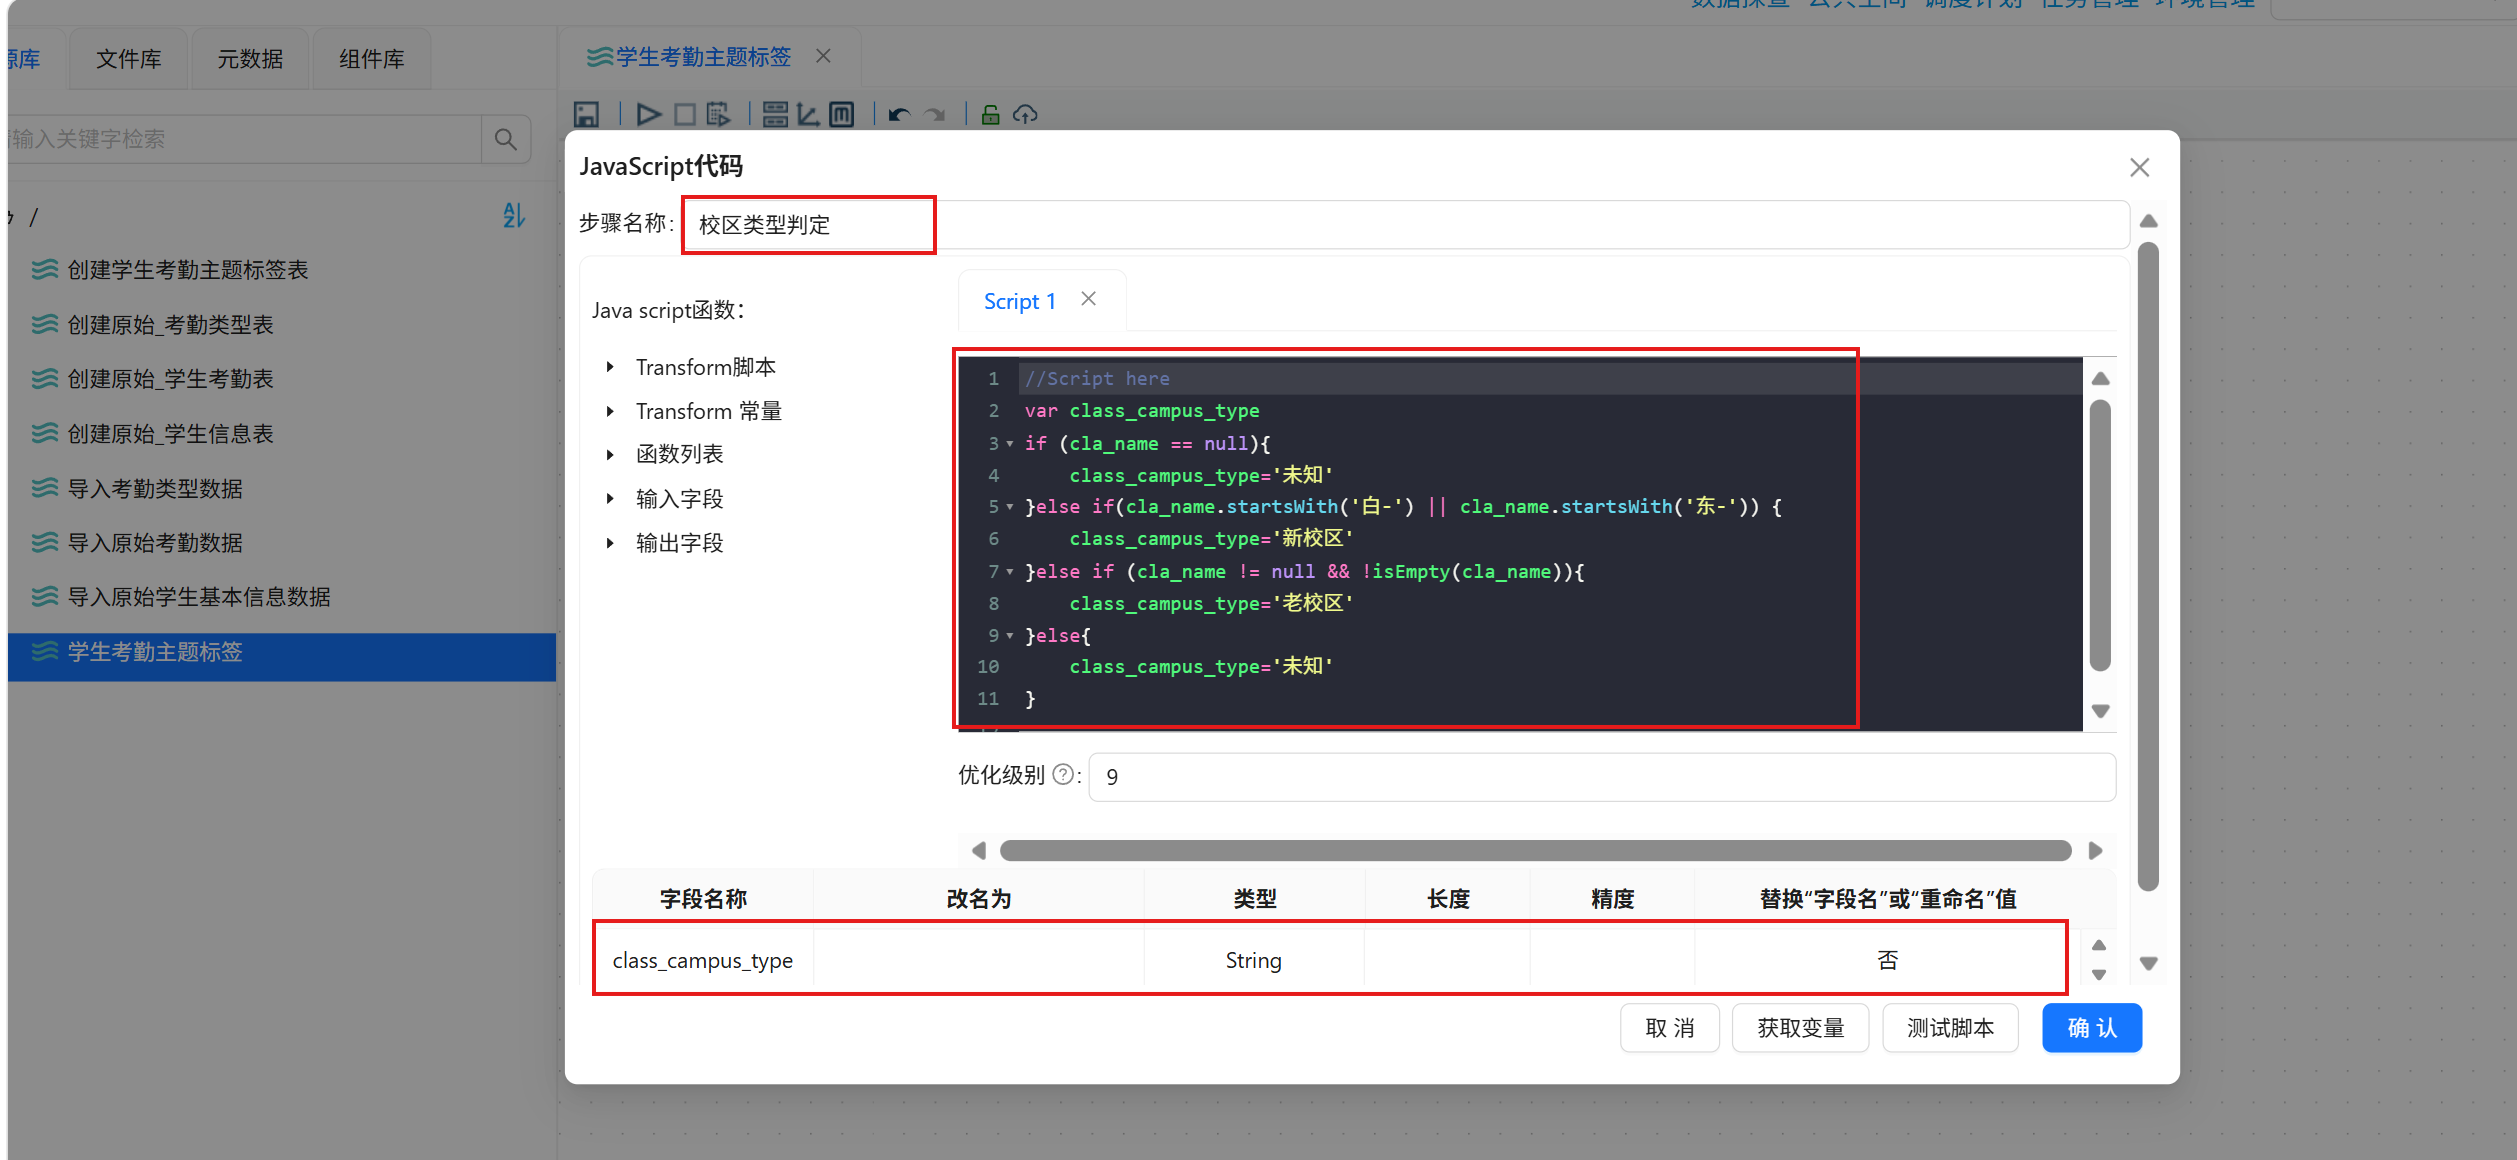
参考 “(2)从班级名提取年级” 步骤,添加“JavaScript代码”组件,“JavaScript代码”组件命名为“校区类型判定”,输入的代码如下:
var class_campus_type
if (cla_name == null){
  class_campus_type='未知'
}else if(cla_name.startsWith('白-') || cla_name.startsWith('东-')){
  class_campus_type='新校区'
}else if (cla_name != null && !isEmpty(cla_name)){
  class_campus_type='老校区'
} else{
  class_campus_type='未知'
}
字段名称“class_campus_type”,类型为“String”,替换“字段名”或“重命名”值选择“否”,设置完后点击 “确认”
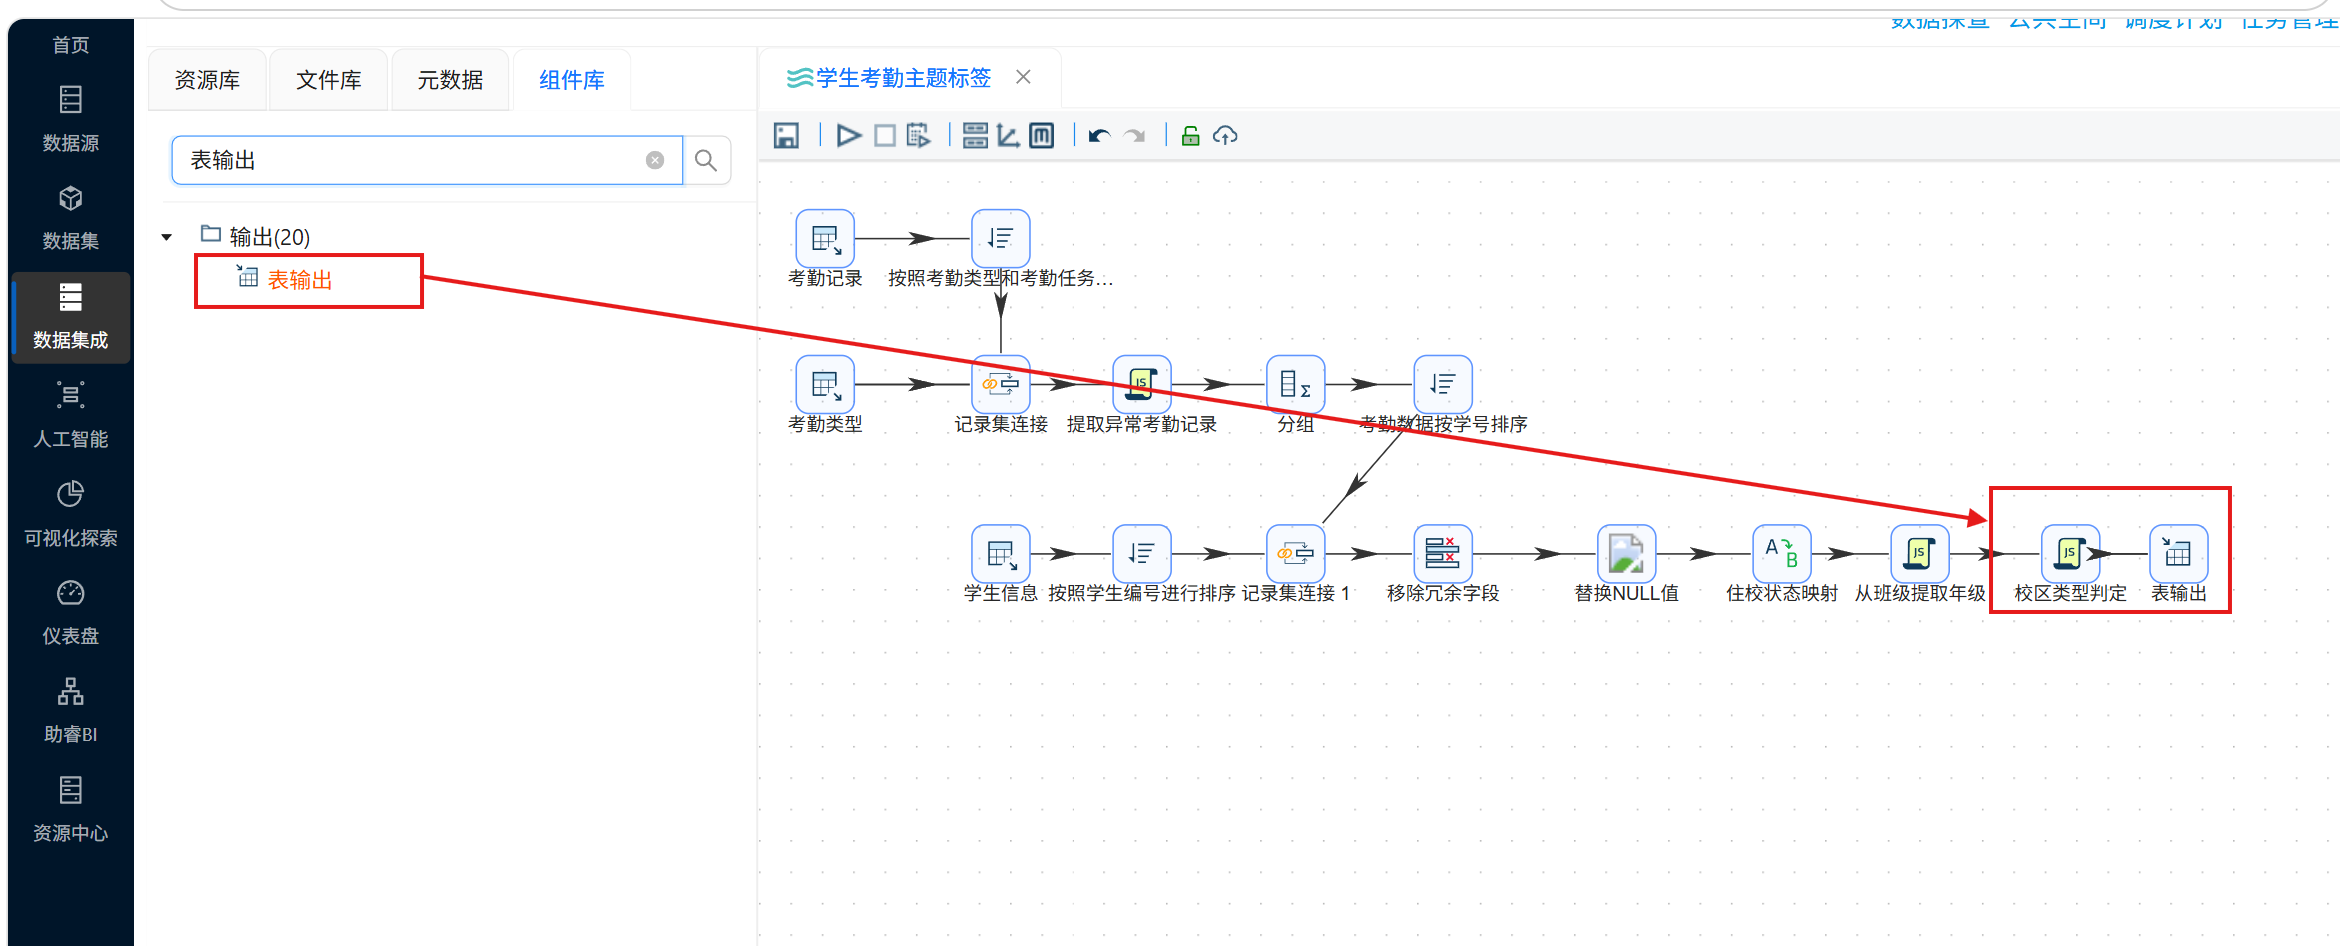
3.7 结果入库
实验核心:将统计结果写入目标表,形成标准化台账,便于后续查询、分析和追溯。
添加表输出组件,并创建 “校区类型判定” 与 “JavaScript代码” 组件到表输出组件的连线
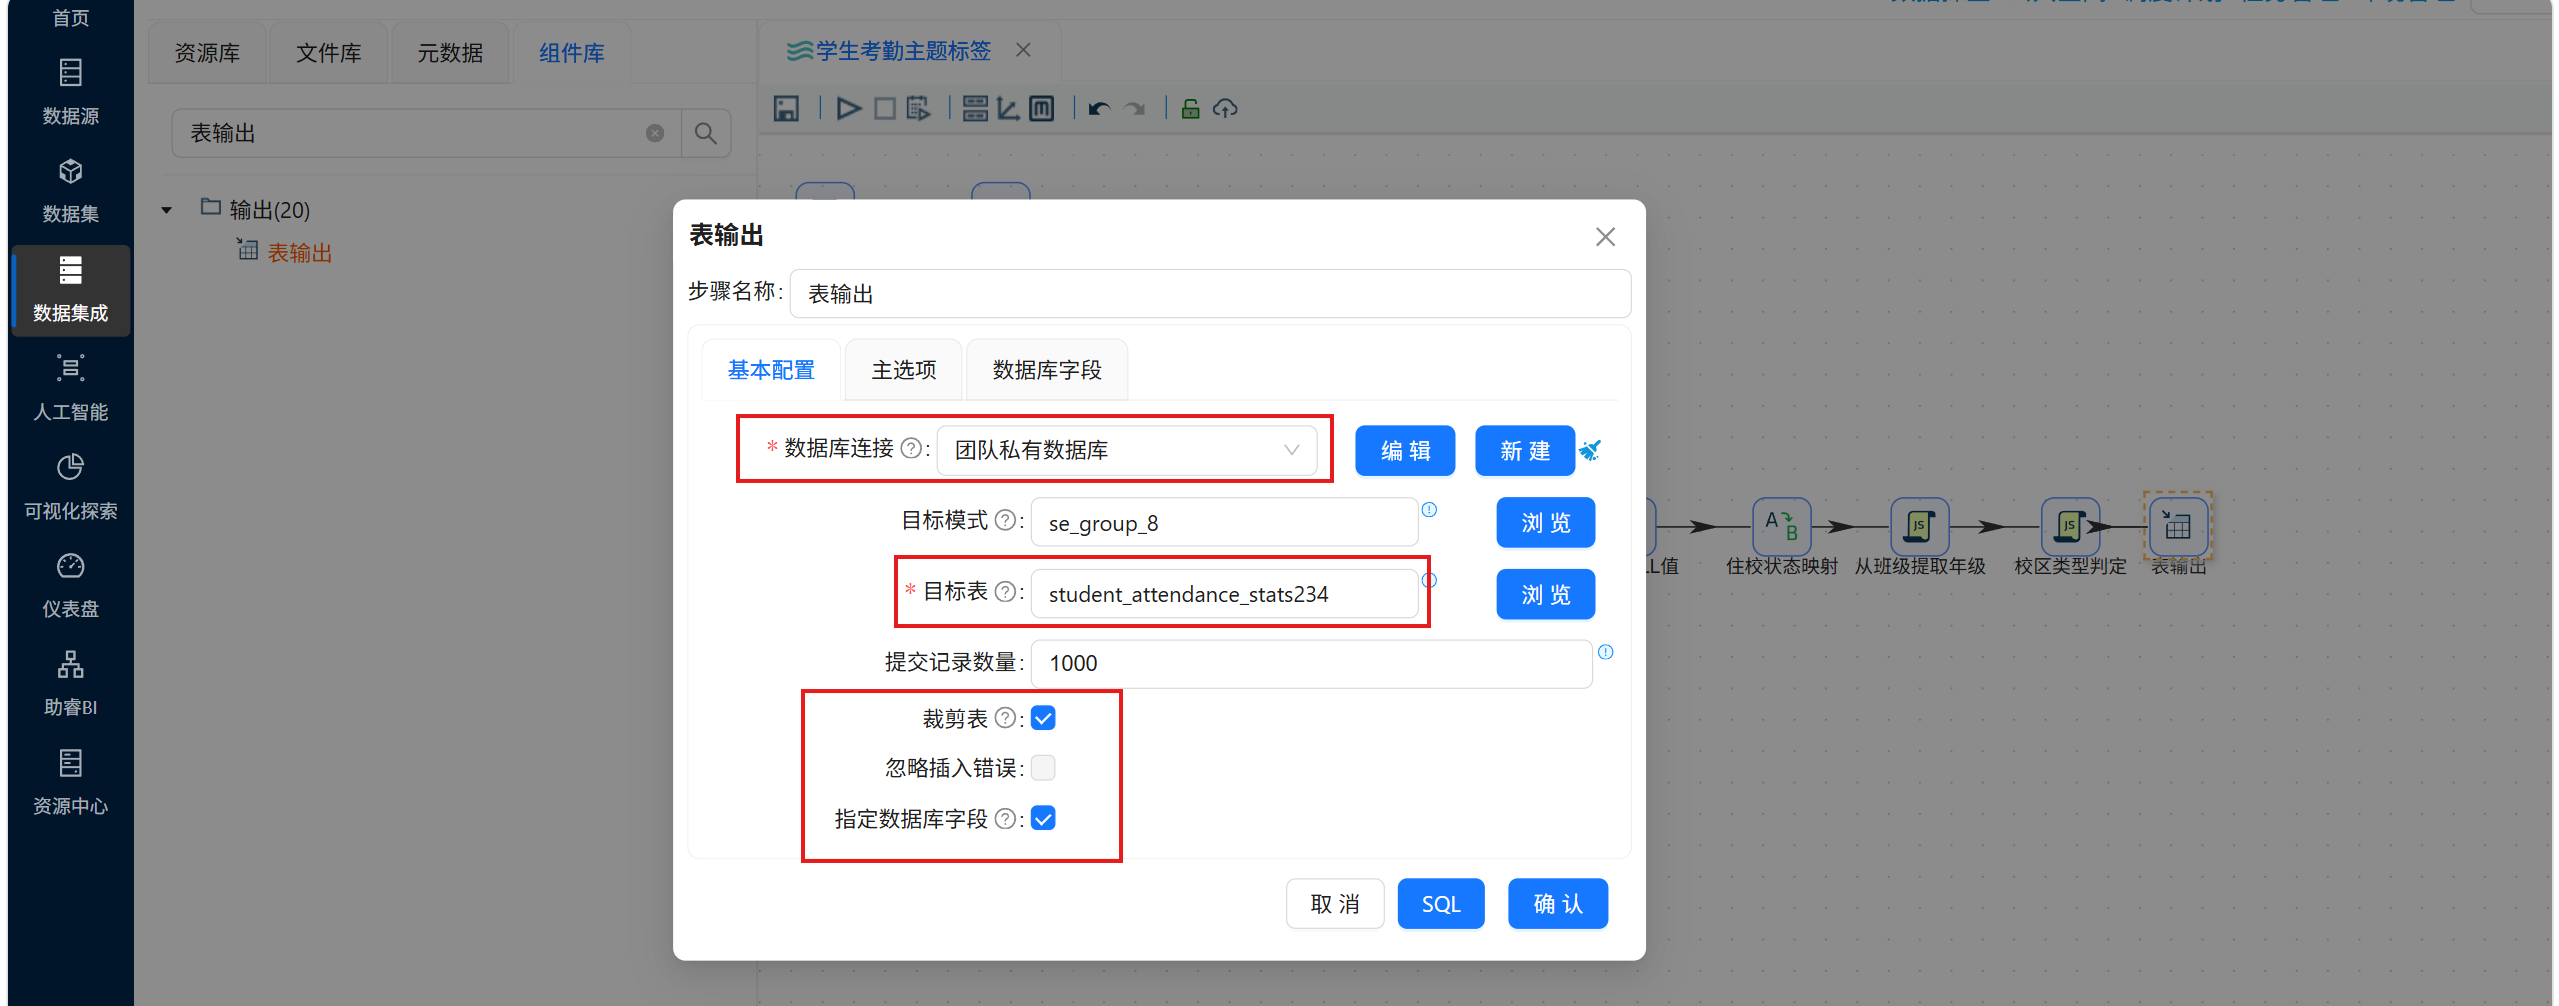
双击表输出组件,选择 “团队私有数据库” 连接;进行下图所示配置,将目标表设置为我们创建的 "student_attendance_stats",表示将数据导出到该表中
建立工作流字段与数据库表字段的映射关系勾,选后会激活 “数据库字段” 页,在数据库字段页,右键选择 “获取字段” ,在下拉框中选择正确的对应字段
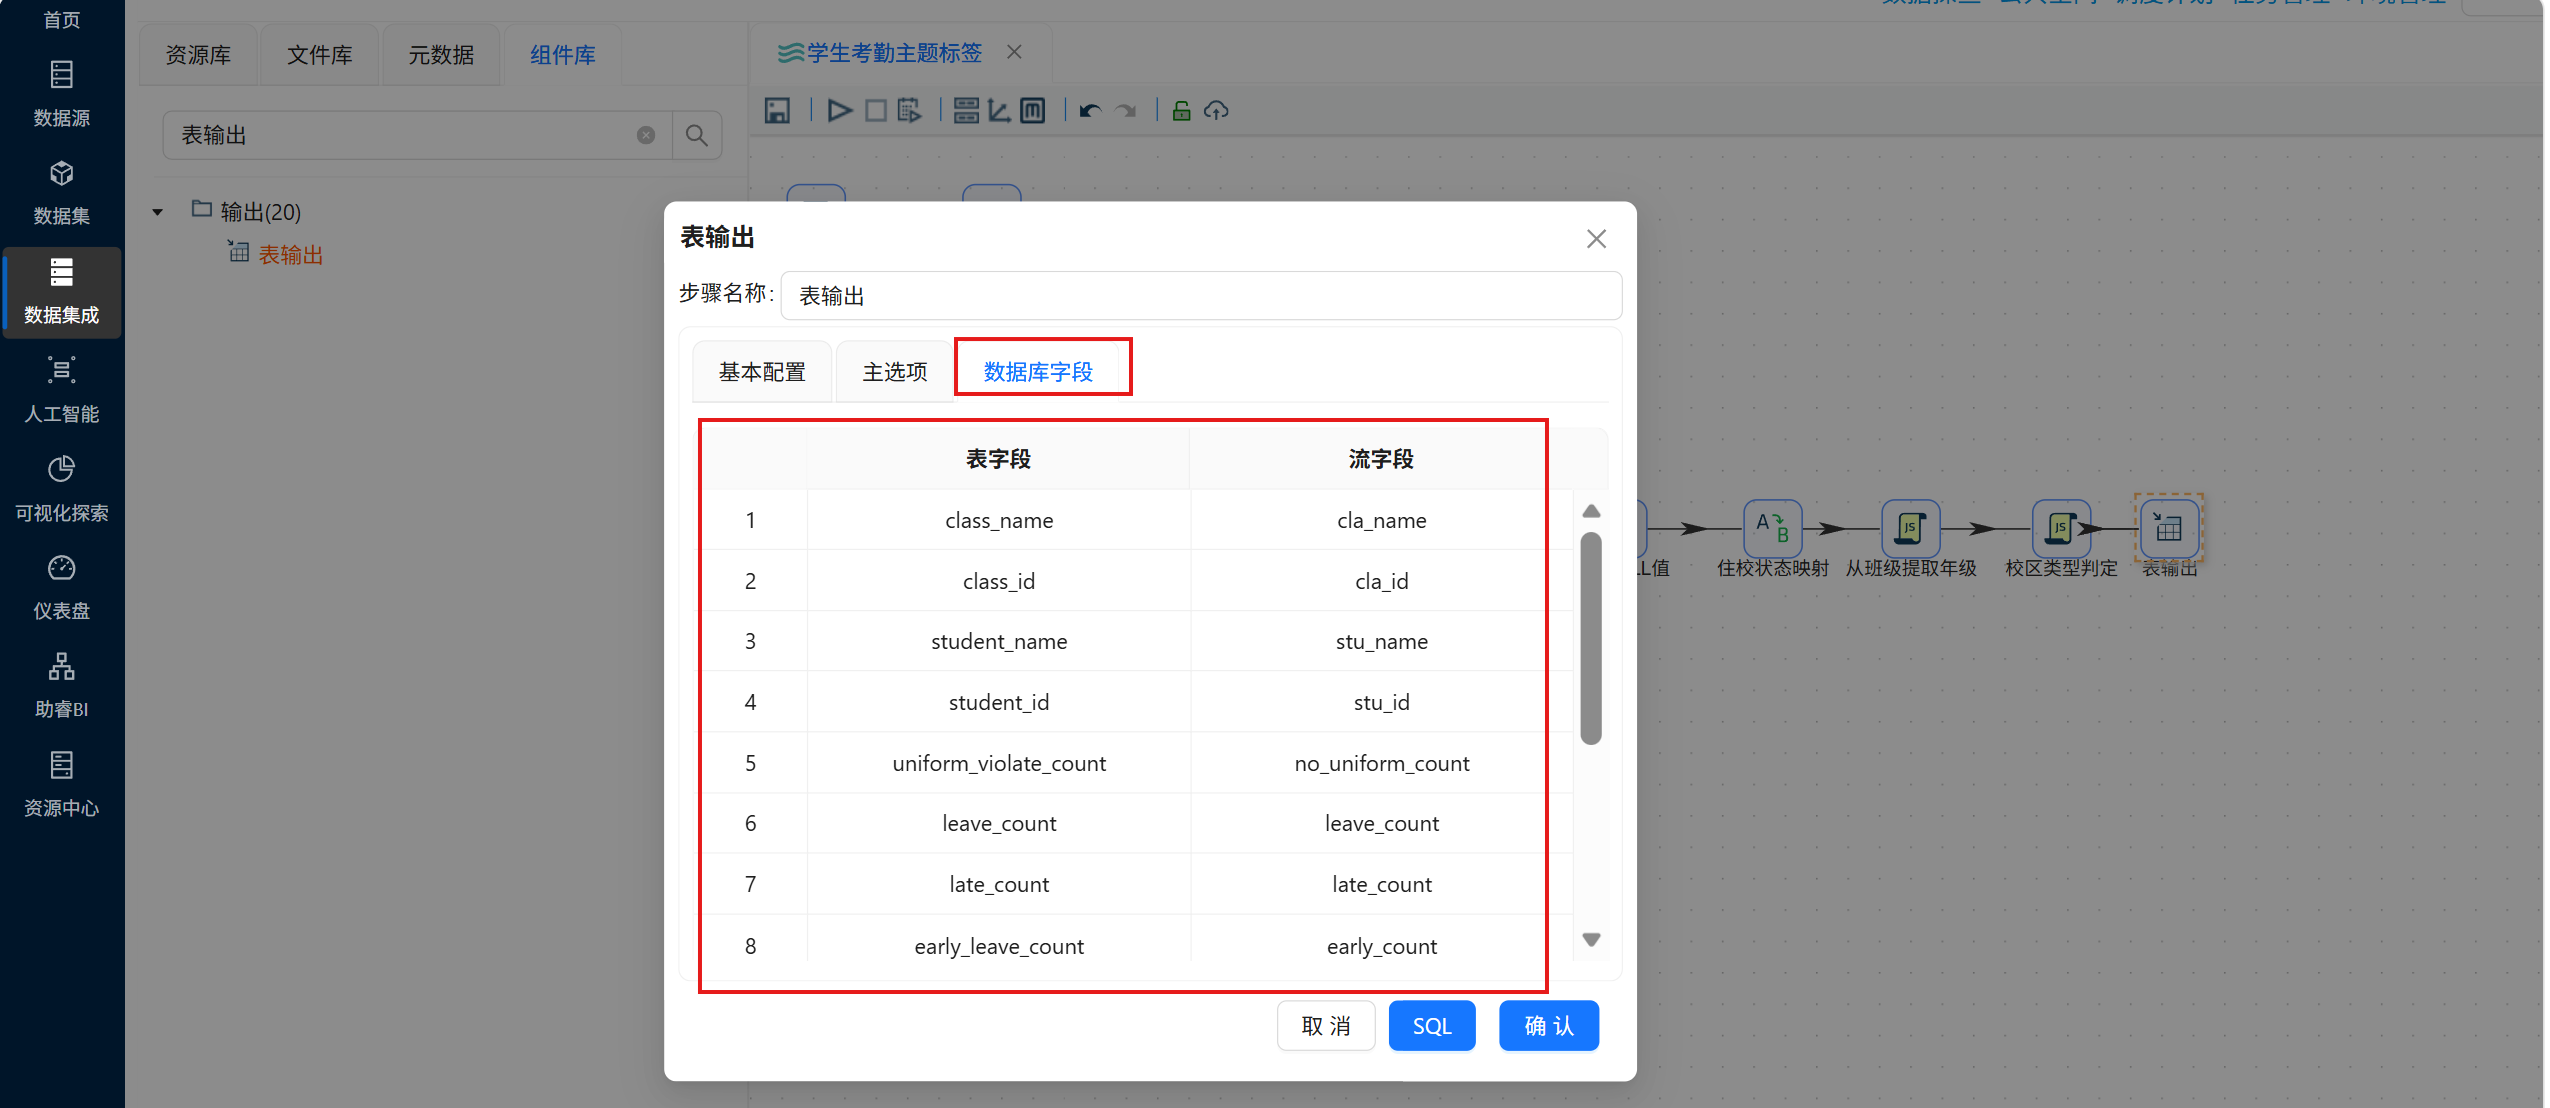
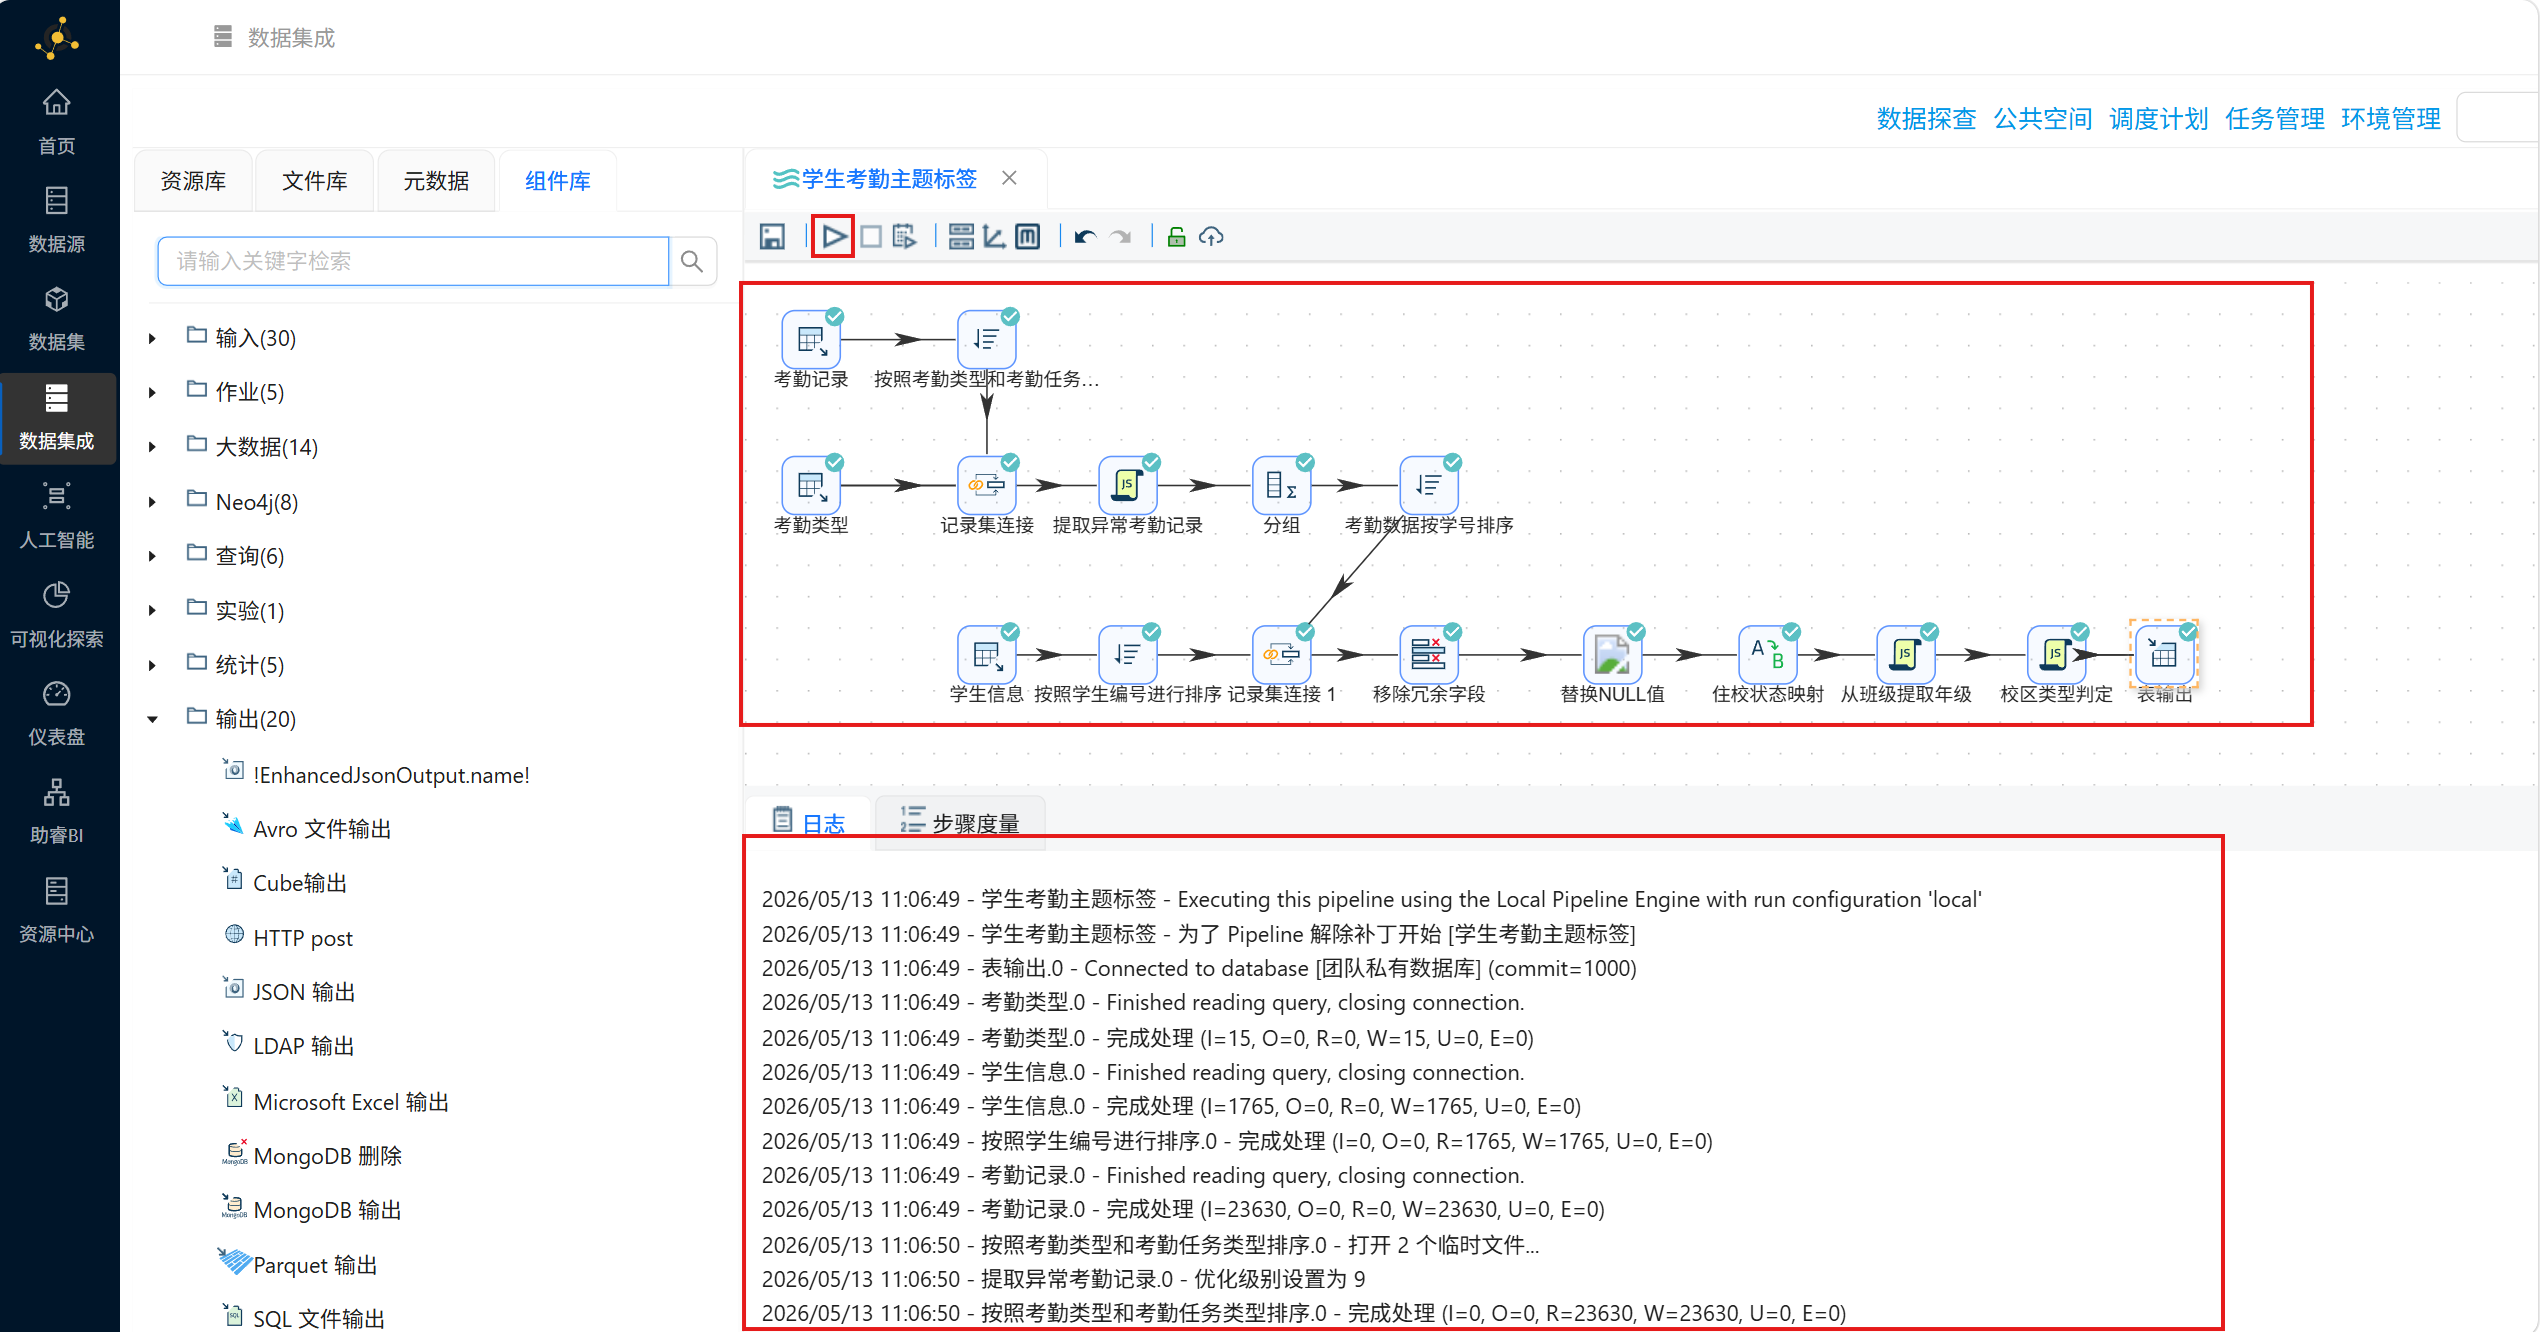
3.8 执行工作流
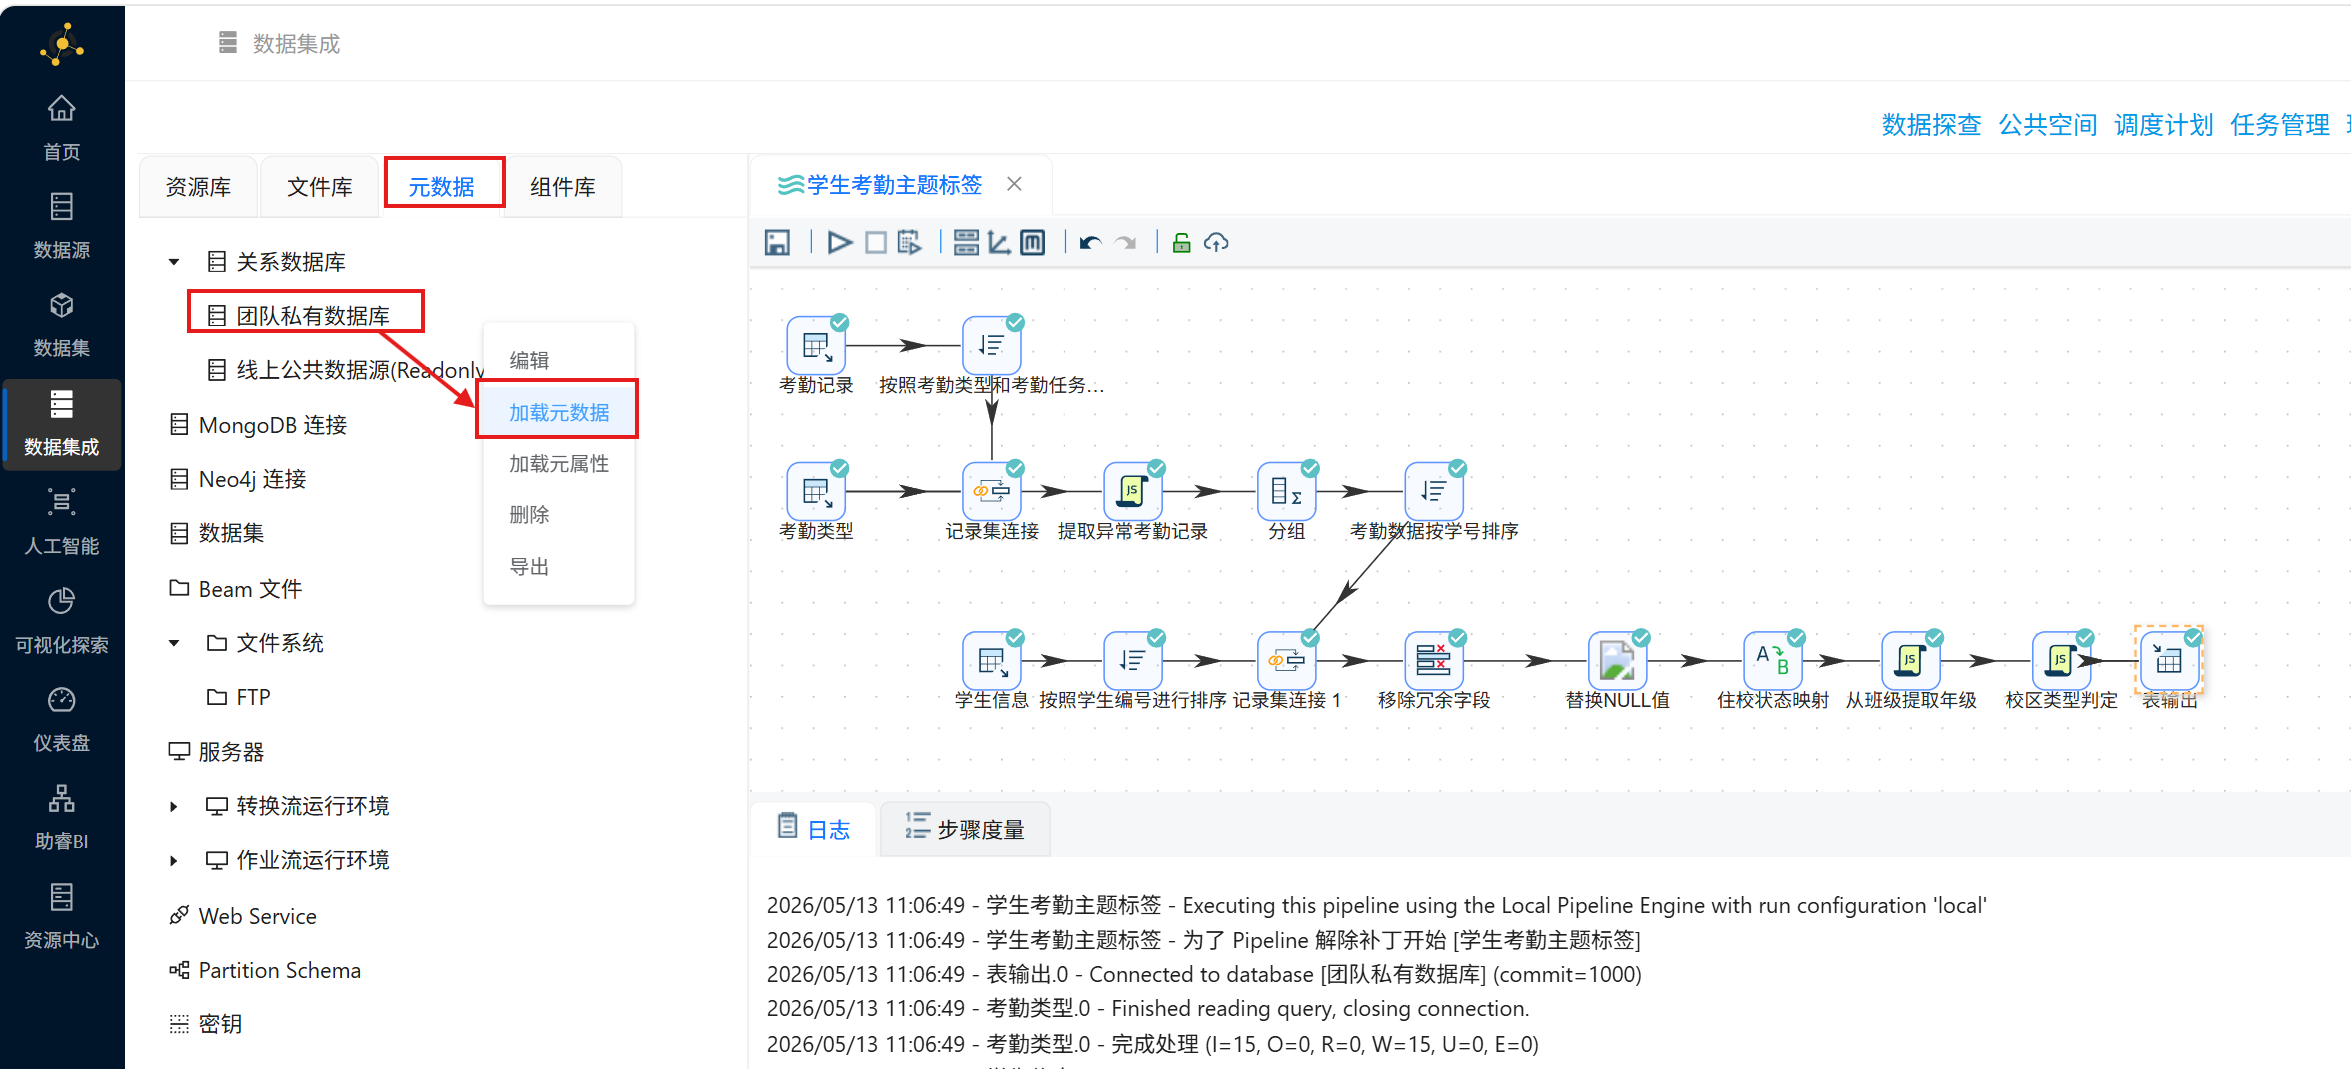
查看数据库结果,点击 “元数据”页,右键 “团队私有数据库”,点击 “加载元数据”
进入数据探查页面,展开“团队私有数据库”,查找到输出的目标表
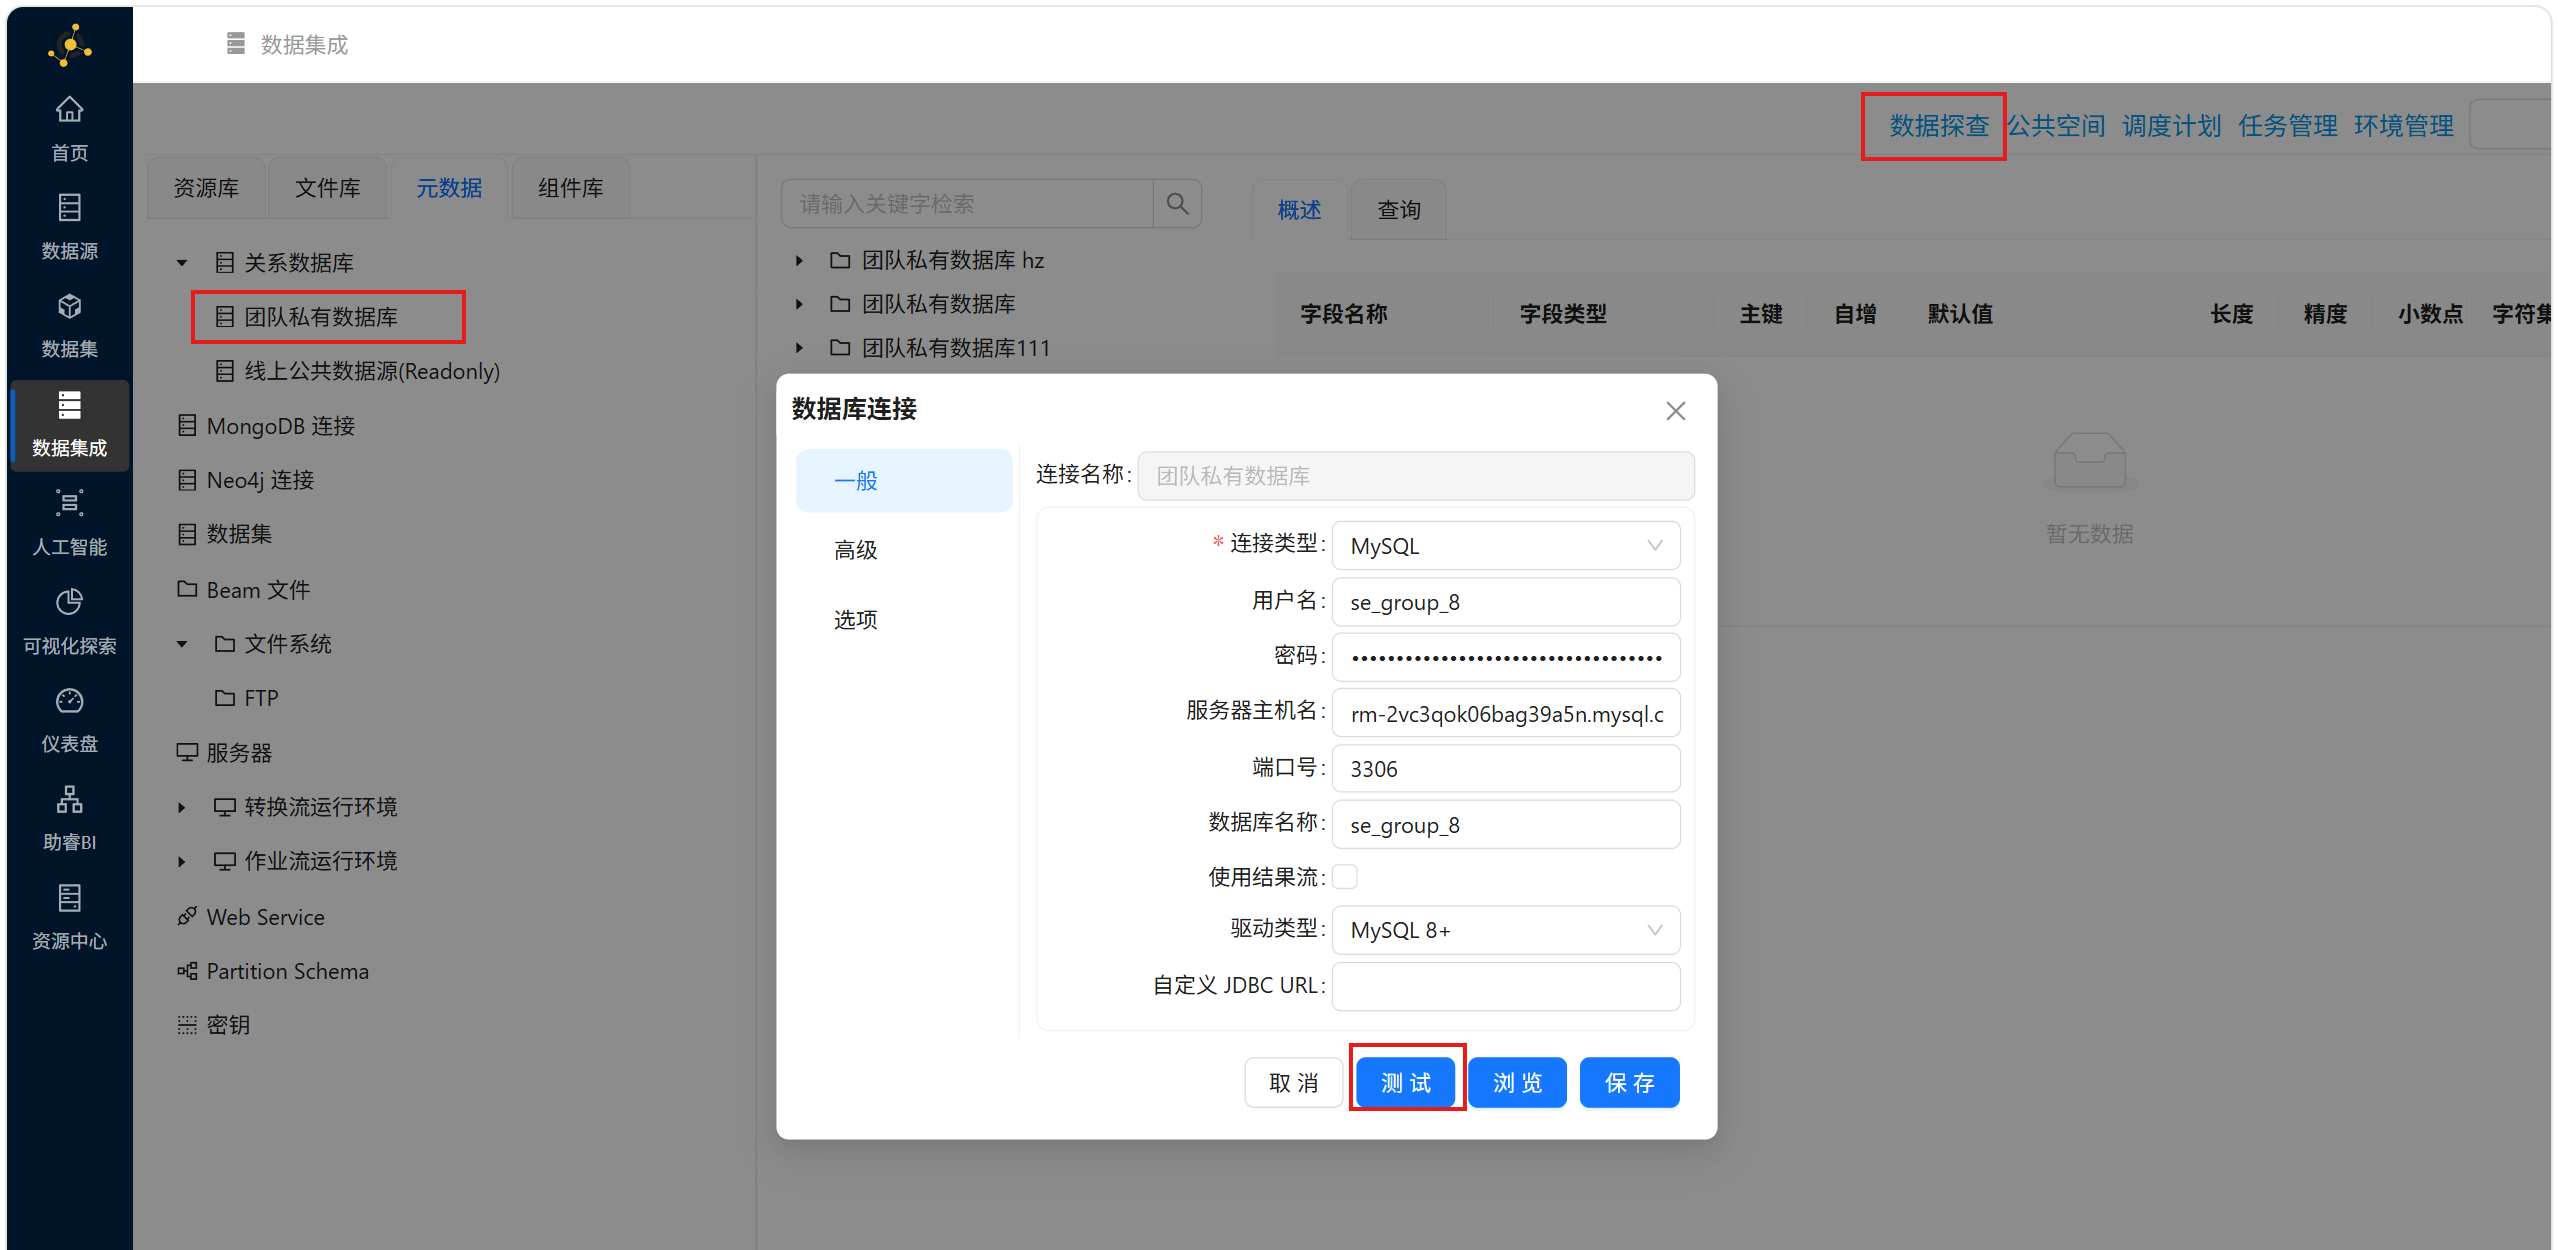
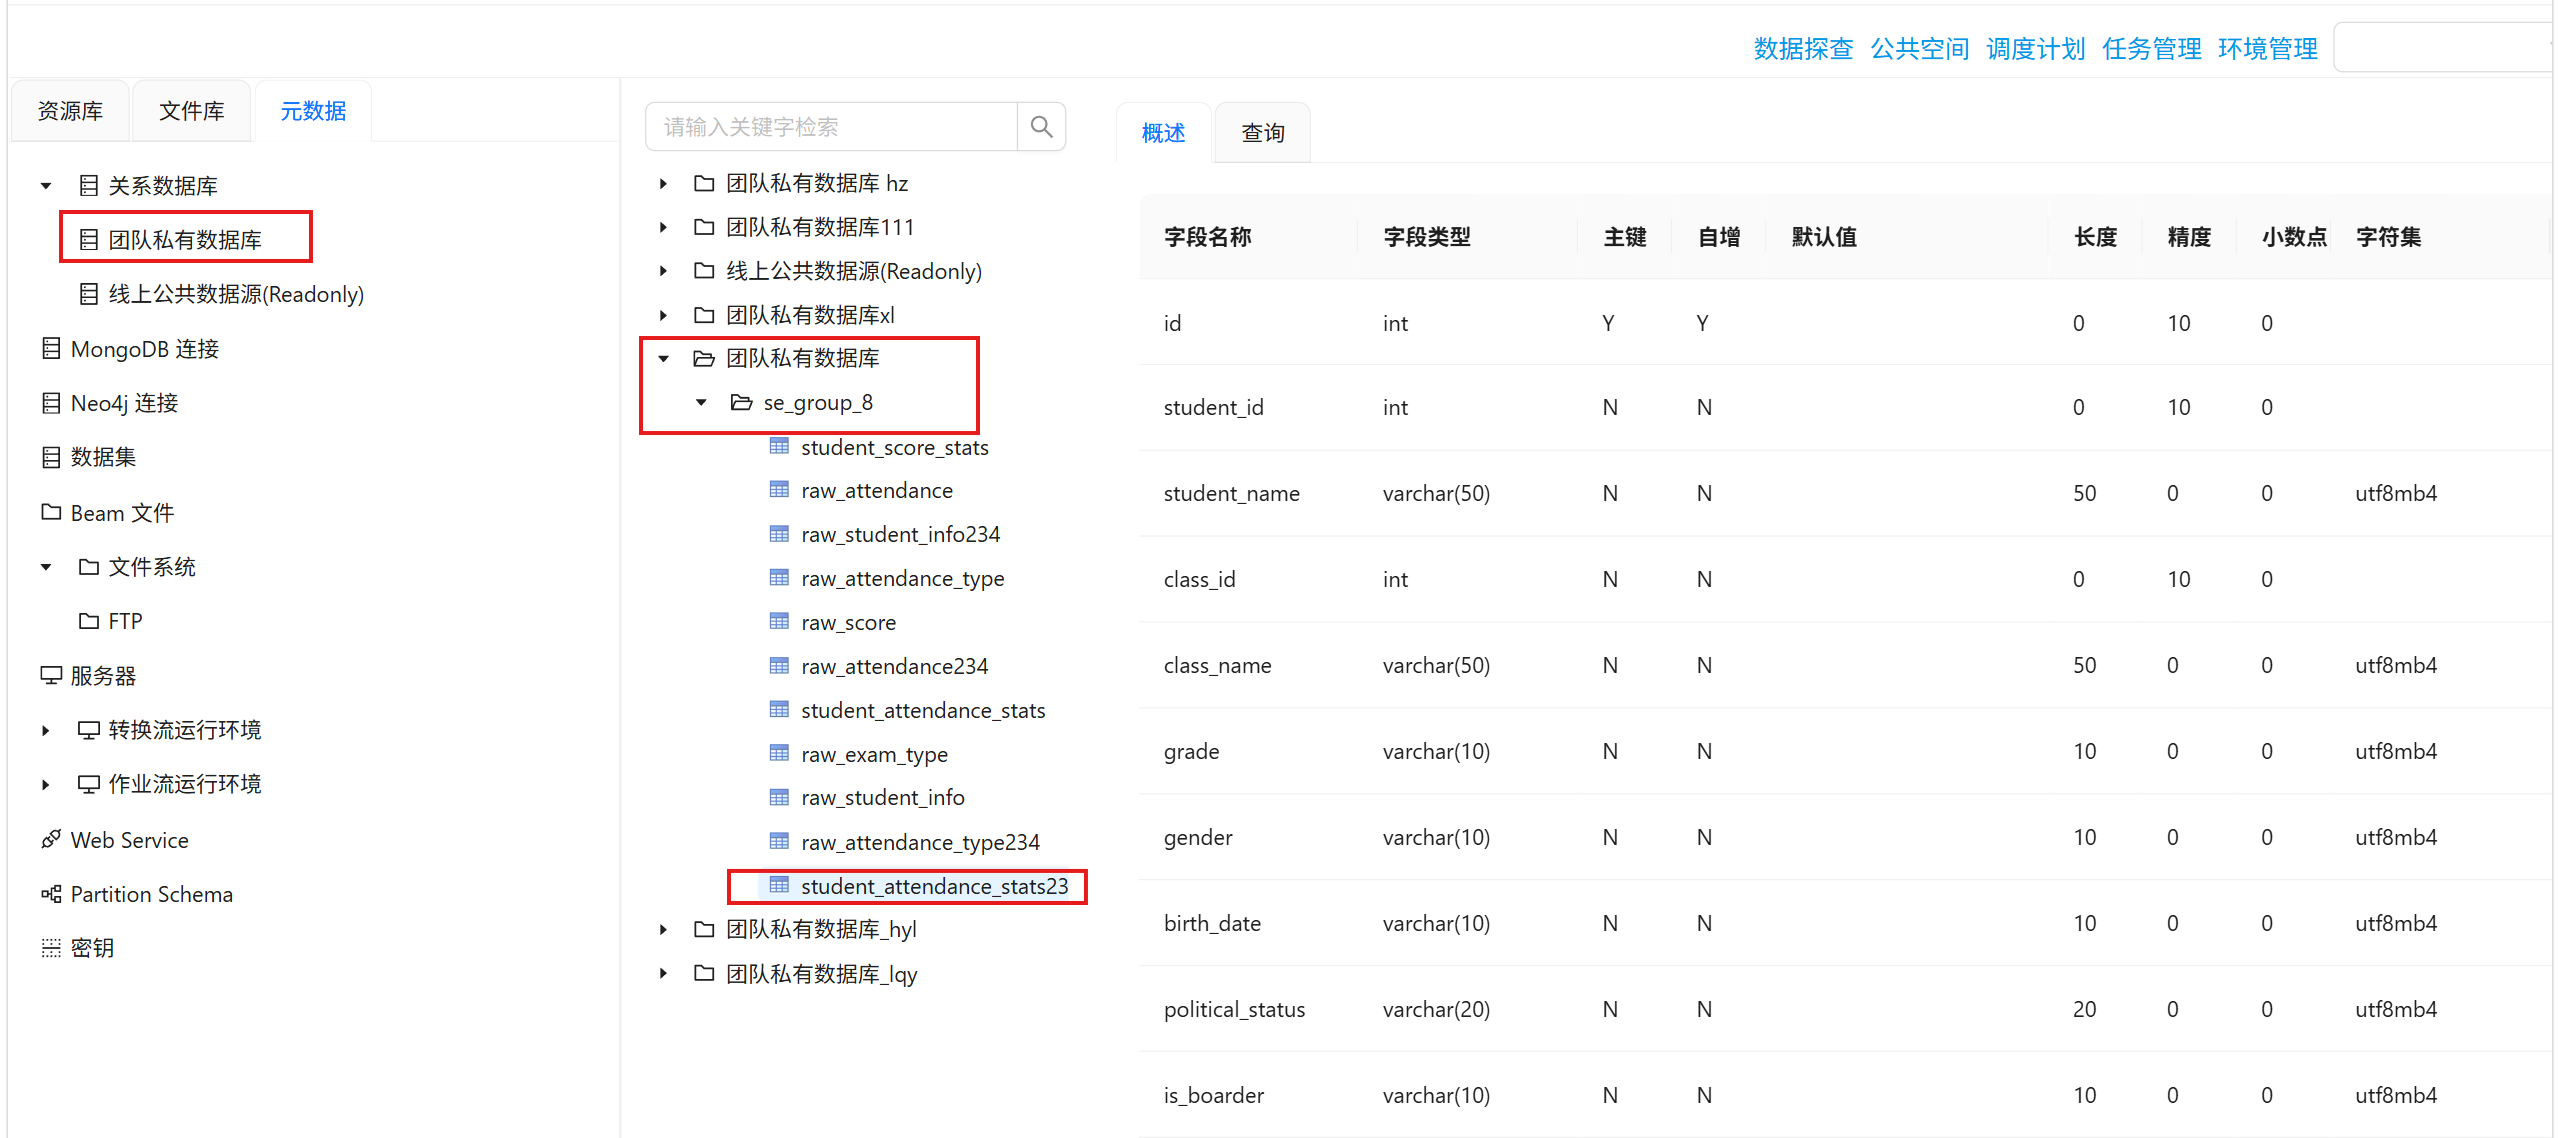
查看输出的数据库表数据是否符合预期
第二部分:学生用户画像——消费情况画像构建
一、数据与流程梳理
-
分析一:学生消费活跃度分层
| 项目 | 内容 |
|---|---|
| 所需数据表 | se_group_8.raw_consumption(消费记录表) |
| 分析目的 | 识别学生的消费活跃程度,发现是否有消费行为异常的学生 |
| 分析意义 | 了解学生整体消费习惯;为后续贫困生识别、消费行为干预提供基础;辅助校园商户经营决策 |
简短流程:
消费记录表(SQL提前聚合) → JavaScript计算月均消费次数 → 输出活跃度标签表
核心指标:
| 指标 | 计算方式 |
|---|---|
| 月均消费次数 | 总消费次数 ÷ 4 |
| 活跃度等级 | 月均≥30次→高活跃;15-29次→中活跃;5-14次→低活跃;<5次→不活跃 |
输出表:student_activity_labels
-
分析二:贫困生识别与津贴建议
| 项目 | 内容 |
|---|---|
| 所需数据表 | se_group_8.student_activity_labels432(消费记录表) |
| 分析目的 | 基于消费数据识别潜在贫困生,为资助政策提供数据参考 |
| 分析意义 | 辅助学生资助工作,使有限的资助资源更精准地分配给真正需要的学生;提供津贴金额的量化参考 |
简短流程:
消费记录表(SQL聚合处理) → JavaScript判断贫困等级+计算津贴 → 输出贫困分析表
判定标准:
| 贫困等级 | 学期总消费 | 建议津贴 |
|---|---|---|
| 特困 | ≤300元 | 800元/学期 |
| 困难 | 301-600元 | 500元/学期 |
| 中等偏低 | 601-1000元 | 300元/学期 |
| 重点关注 | 消费次数≤20次且金额≤500元 | 600元/学期 |
输出表:poverty_analysis432
-
分析三:消费时段偏好分析
| 项目 | 内容 |
|---|---|
| 所需数据表 | se_group_8.raw_consumption(消费记录表) |
| 分析目的 | 了解学生在不同时间段的消费分布和习惯 |
| 分析意义 | 优化食堂各时段备餐量;发现夜宵需求,调整营业时间;为校园商业布局提供数据支持 |
简短流程:
消费记录表(SQL提取小时) → JavaScript划分时段 → 分组聚合(按时段分组) → 输出时段汇总表
时段划分:
| 时段 | 时间范围 |
|---|---|
| 早餐 | 6:00-9:00 |
| 午餐 | 11:00-14:00 |
| 晚餐 | 17:00-20:00 |
| 夜宵 | 20:00-23:00 |
核心指标:
| 指标 | 含义 |
|---|---|
| 各时段消费次数 | 反映消费频率 |
| 各时段消费金额 | 反映消费总额 |
| 各时段平均消费 | 反映消费水平 |
输出表:consumption_time_period432
-
三个分析的关系
| 分析 | 核心问题 |
|---|---|
| 活跃度分层 | 谁消费活跃?谁不活跃? |
| 贫困生识别 | 谁的消费情况看起来需要资助?给多少钱? |
| 时段偏好 | 什么时候消费最多?为什么? |
-
技术实现共性
| 共同点 | 说明 |
|---|---|
| 数据源 | 统一使用 |
| 核心操作 | SQL聚合 + JavaScript计算+(分组聚合) + 表输出 |
| 金额处理 | 统一使用 ABS(mon_deal) 取绝对值 |
二、具体实现步骤
2.1 创建原始_消费记录表
新建一个转换流并命名为:“1_创建原始_消费记录表”,并拖拽一个 “执行一个SQL脚本”组件到画布中
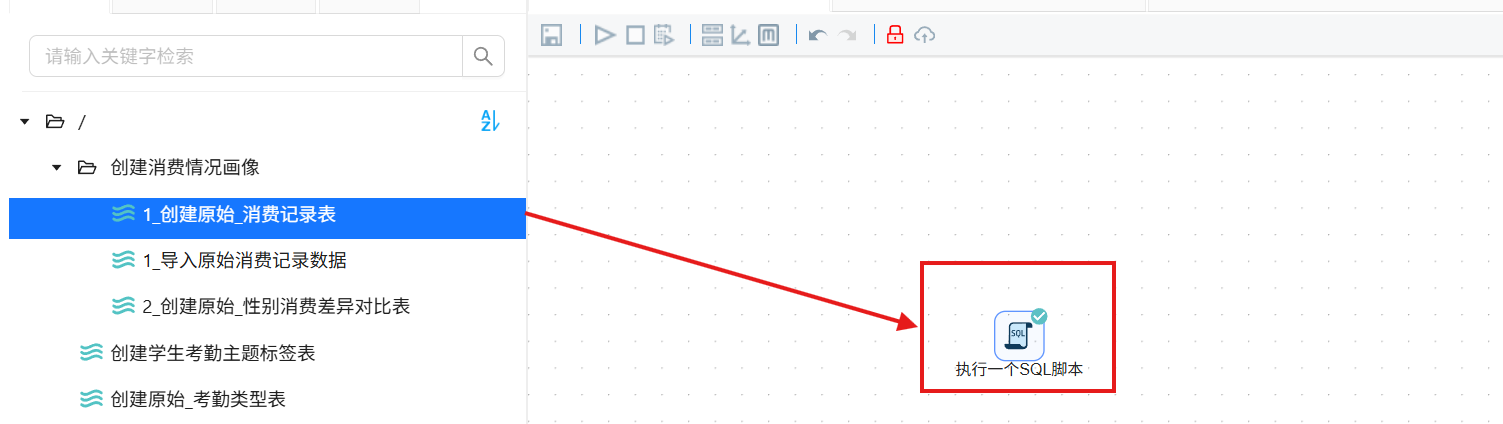
创建消费记录表的具体SQL脚本如下:
CREATE TABLE IF NOT EXISTS `raw_consumption` (
    `id` bigint NOT NULL AUTO_INCREMENT COMMENT '自增ID',
    `deal_time` datetime DEFAULT NULL COMMENT '消费时间',
    `mon_deal` decimal(10,2) DEFAULT NULL COMMENT '消费金额(负数)',
    `bf_student_id` varchar(64) DEFAULT NULL COMMENT '学生ID',
    `acc_name` varchar(100) DEFAULT NULL COMMENT '学生姓名(已脱敏)',
    `per_sex` varchar(10) DEFAULT NULL COMMENT '学生性别',
    `create_time` datetime DEFAULT CURRENT_TIMESTAMP COMMENT '入库时间',
    PRIMARY KEY (`id`),
    KEY `idx_student_id` (`bf_student_id`),
    KEY `idx_deal_time` (`deal_time`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8mb4 COMMENT='原始_学生消费记录表';
确认无误后点击执行,查看组件的动态和日志信息
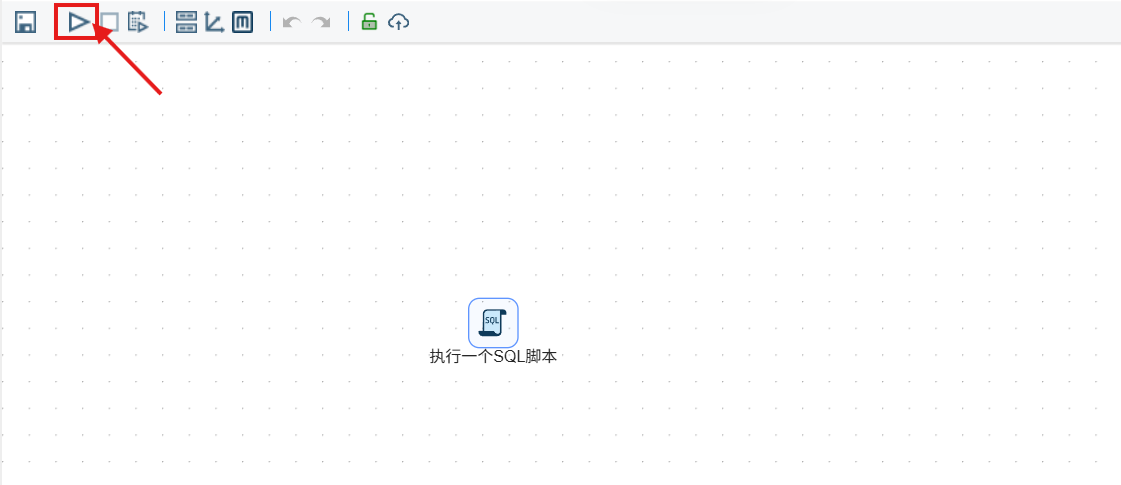
2.2 导入原始消费记录数据
新建一个转换流并命名为:“1_导入原始消费记录数据”,并拖拽一个 “CSV文件输入”组件
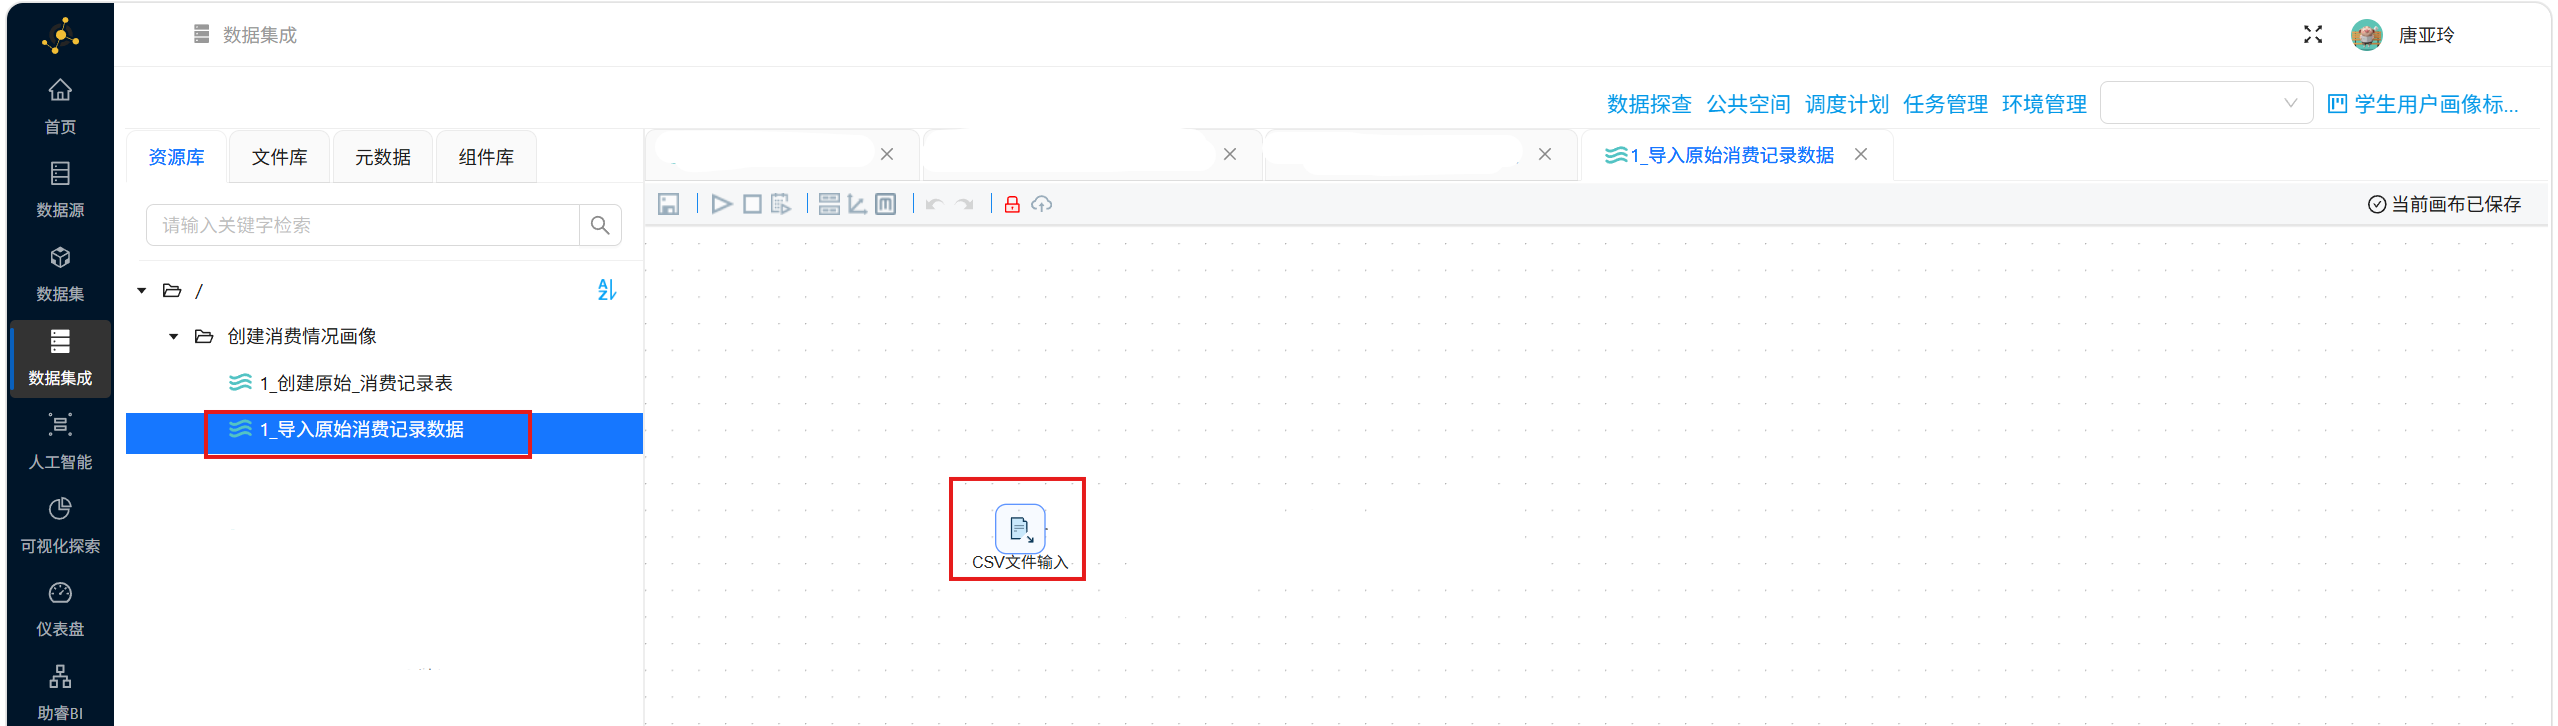
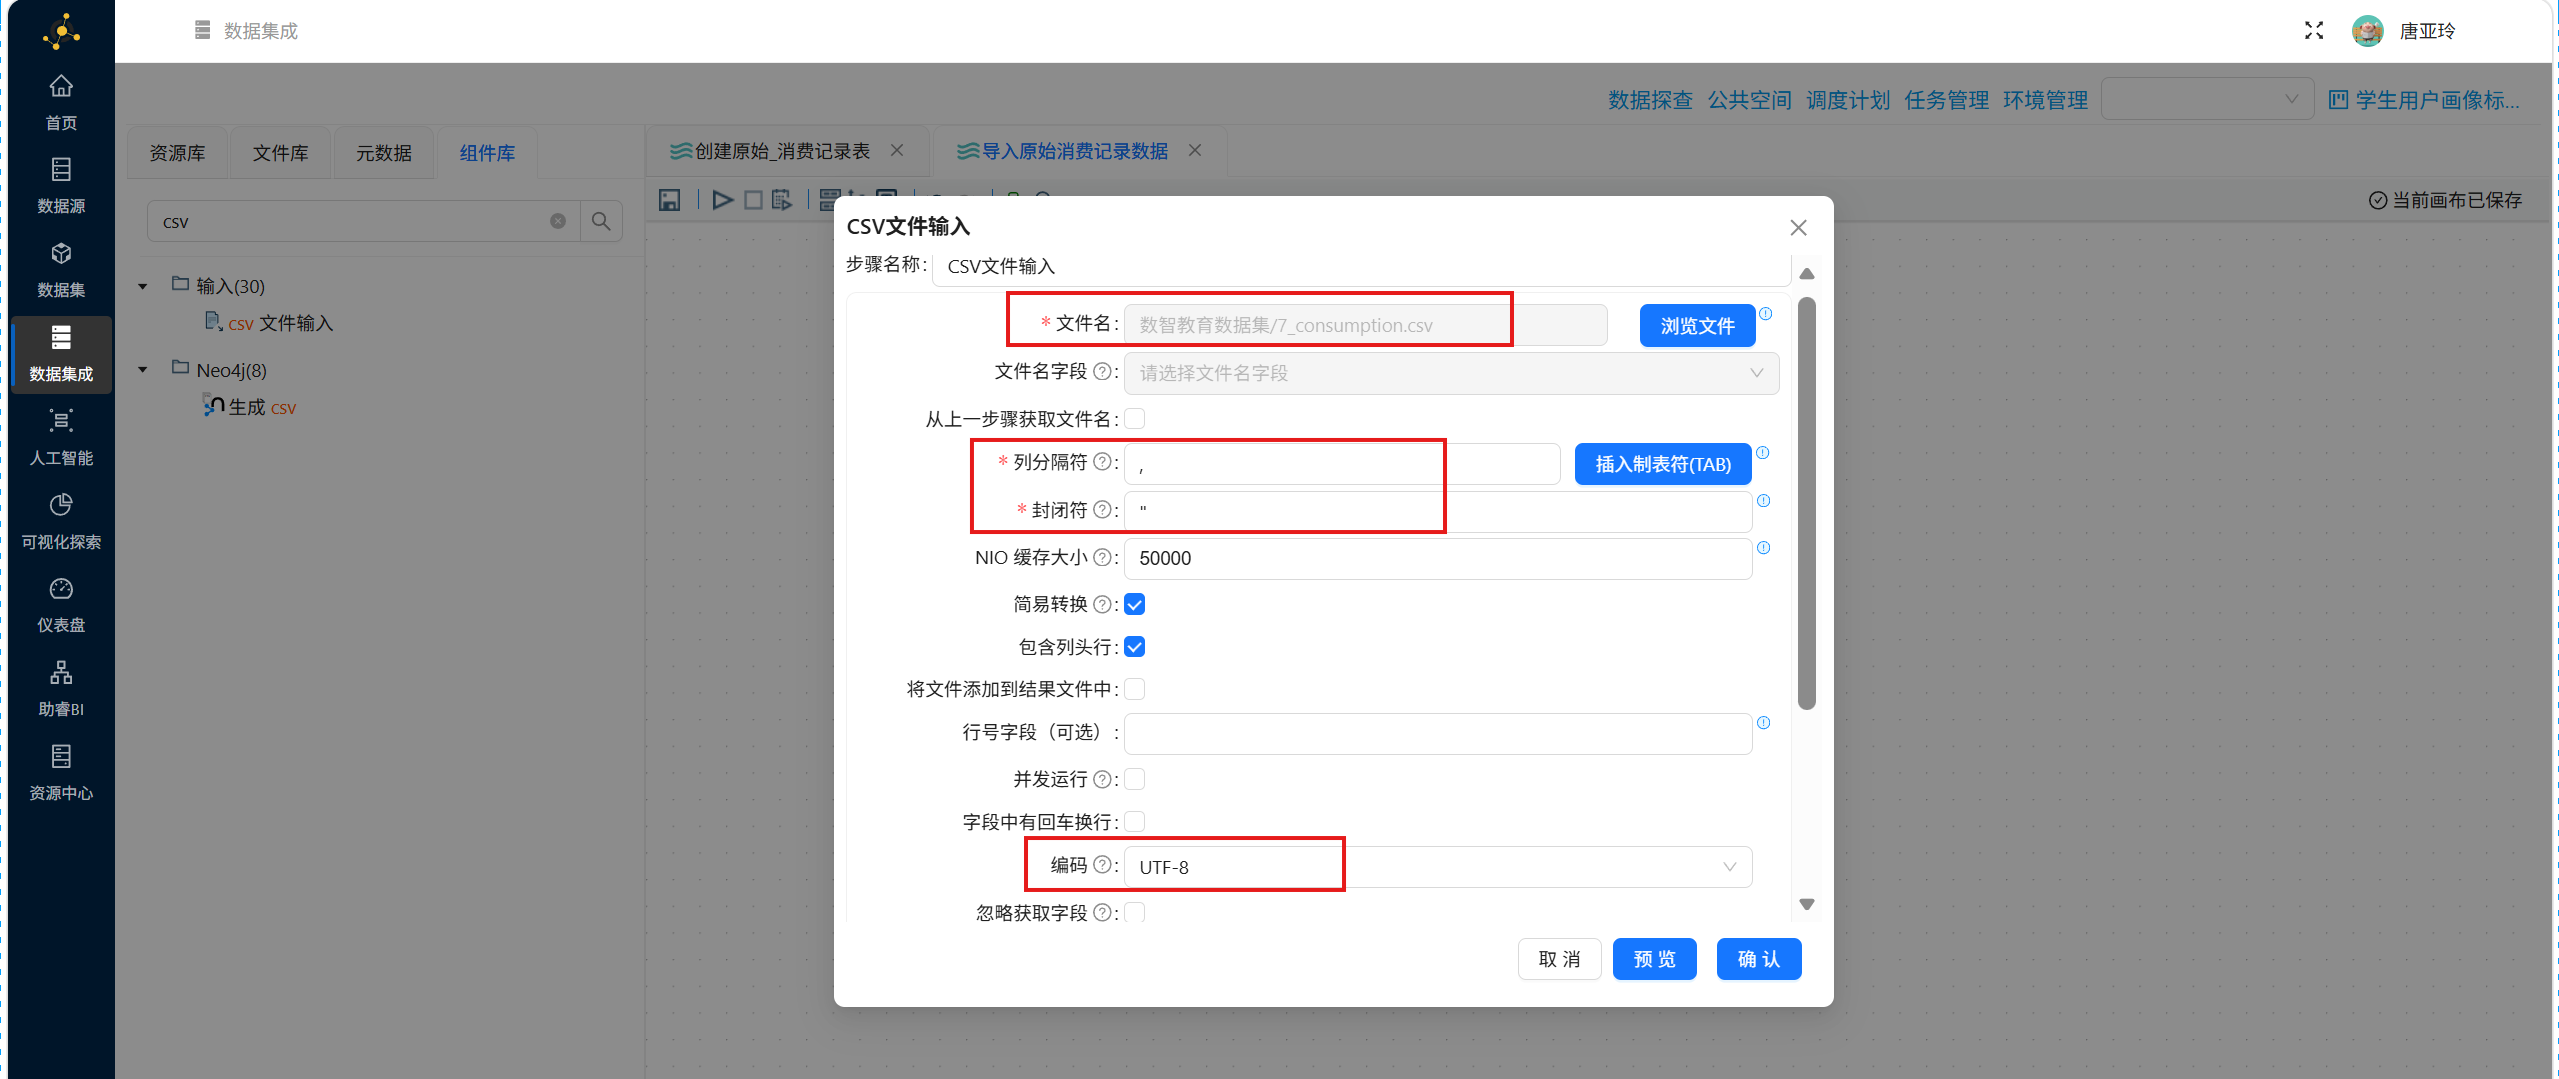
双击该组件,进行如下图所示的配置
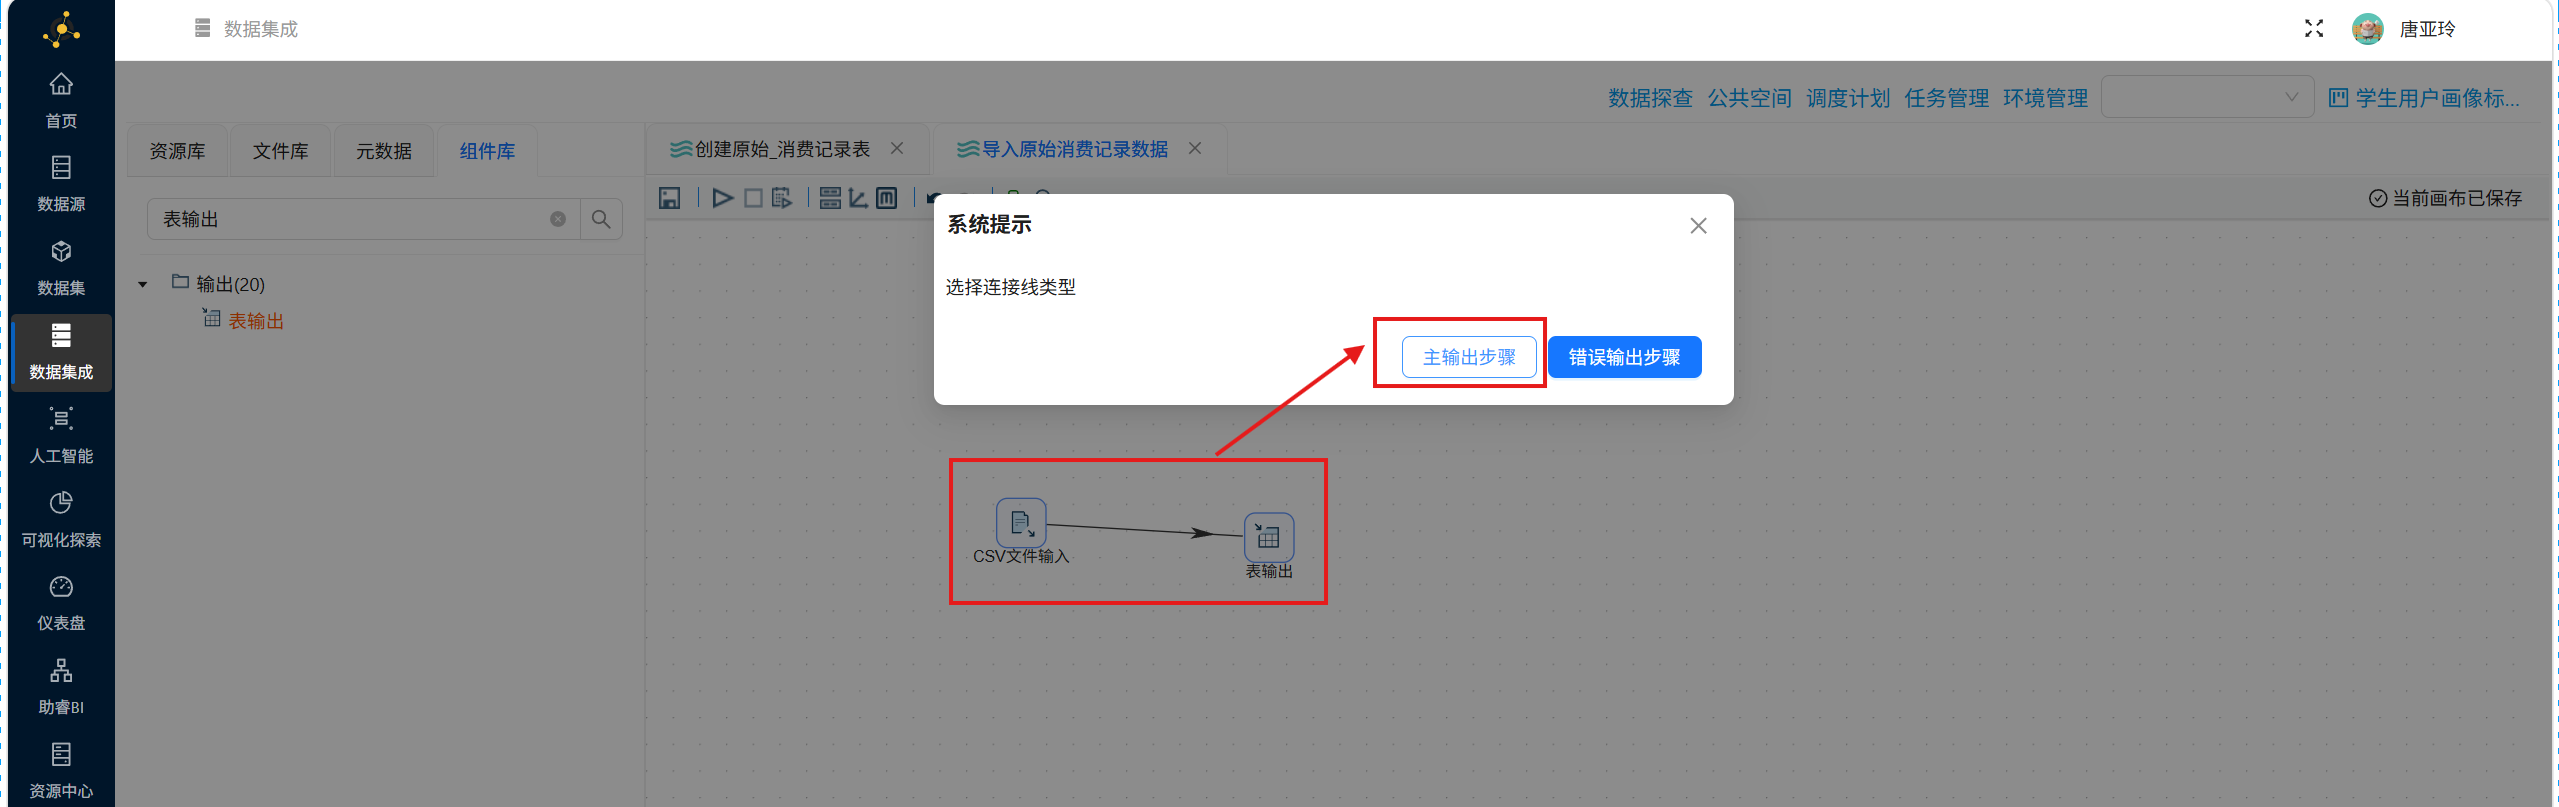
接着,拖拽一个 “表输出”组件,创建其和输入组件的连线,选择连线类型为 “主输出步骤”
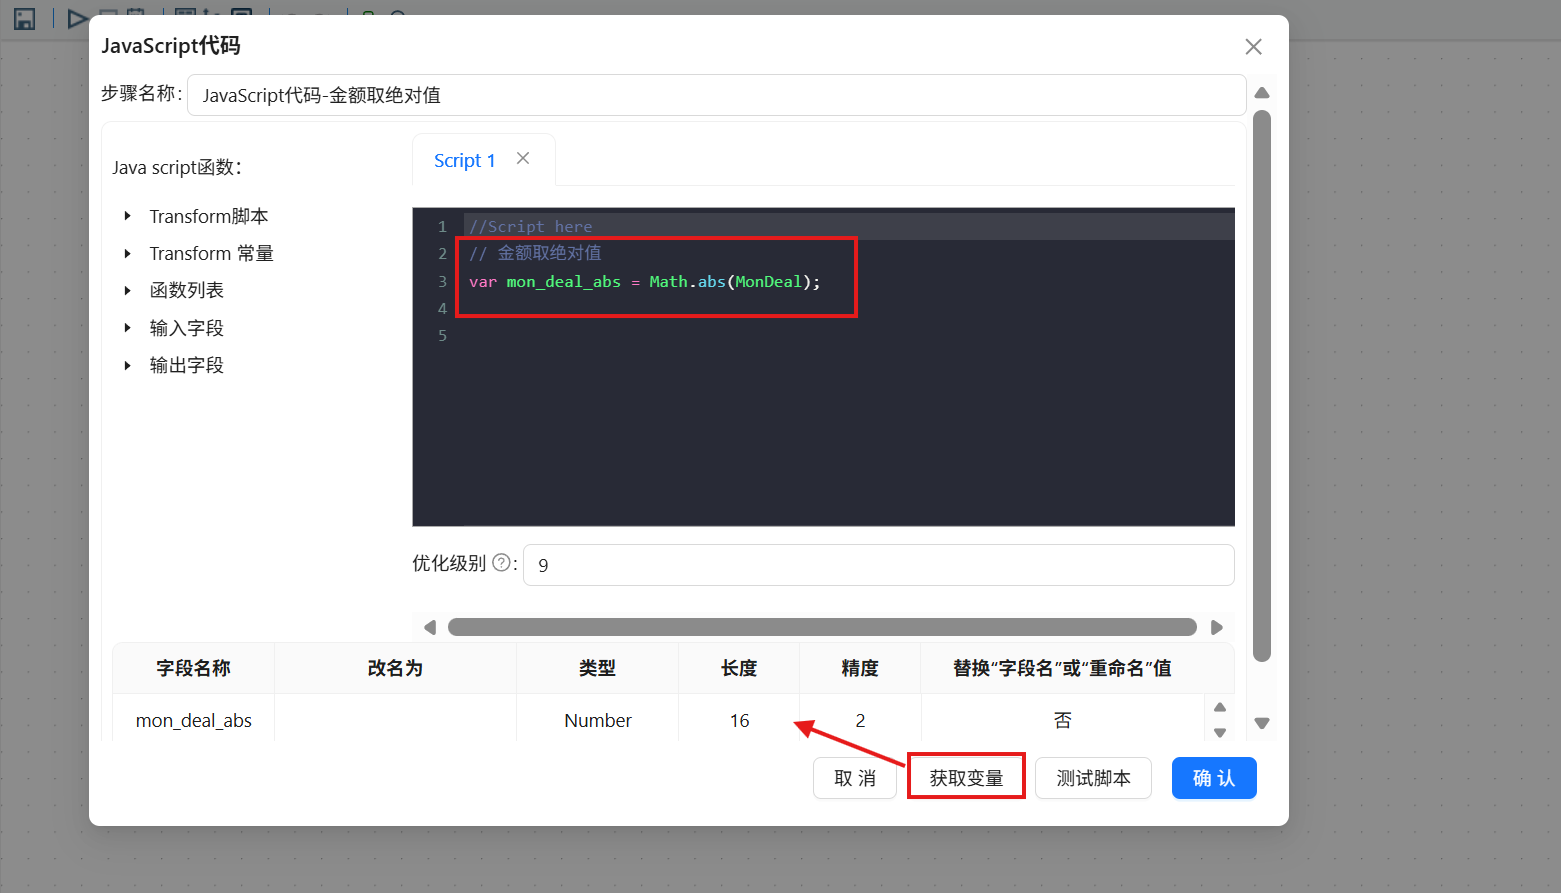
到这一步,我们发现CSV文件中消费金额为负值,我们需要取绝对值处理再输出,所以,我们在两个组件间插入一个 “JavaScript代码”组件
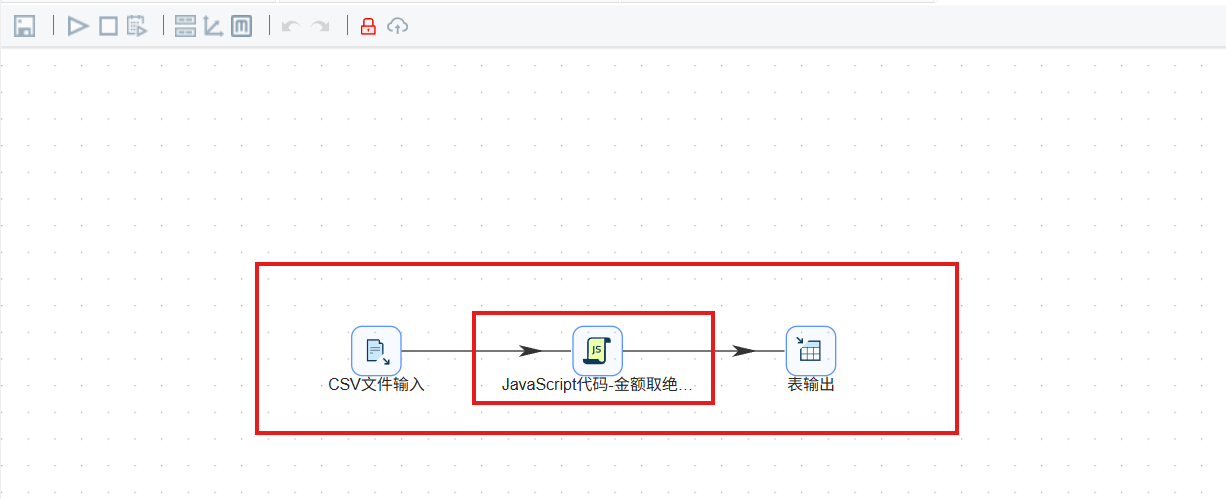
JS脚本如下,将金额取绝对值处理;可以点击 “获取变量”查看字段是否正确
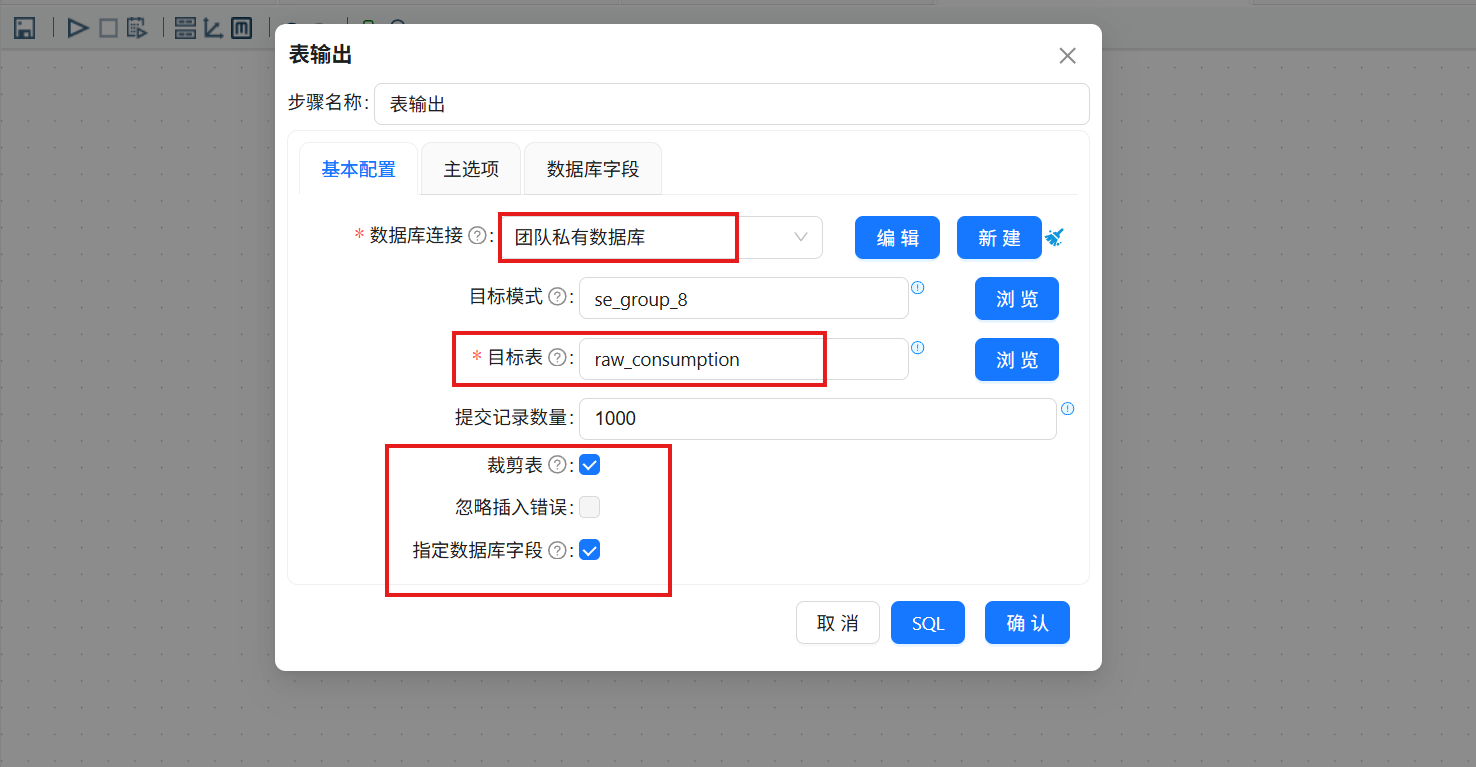
表输出的具体配置如下:
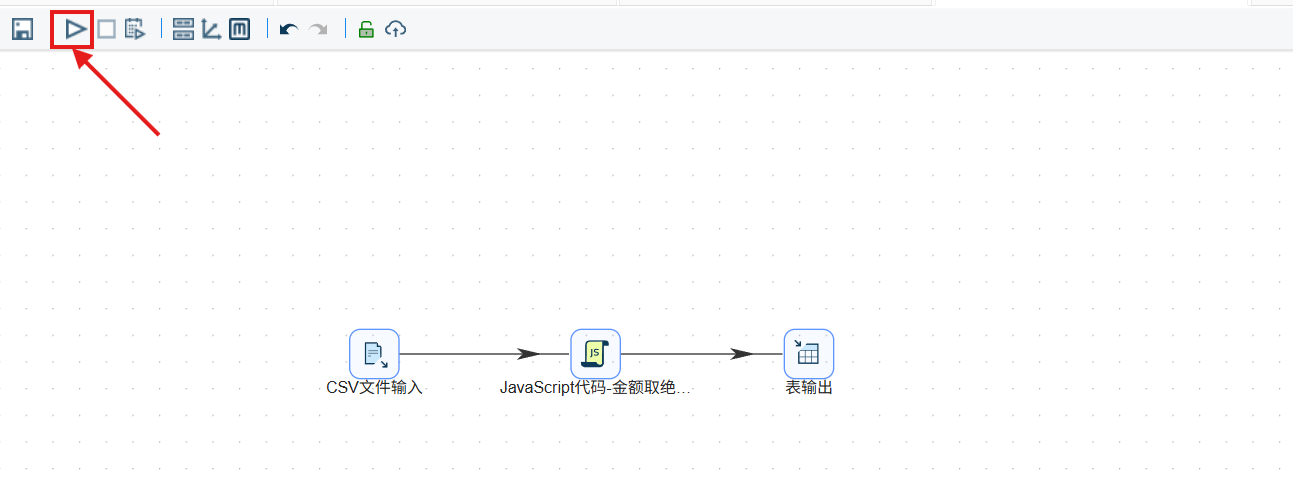
确认无误后,点击执行,查看转换流是否可以正确执行
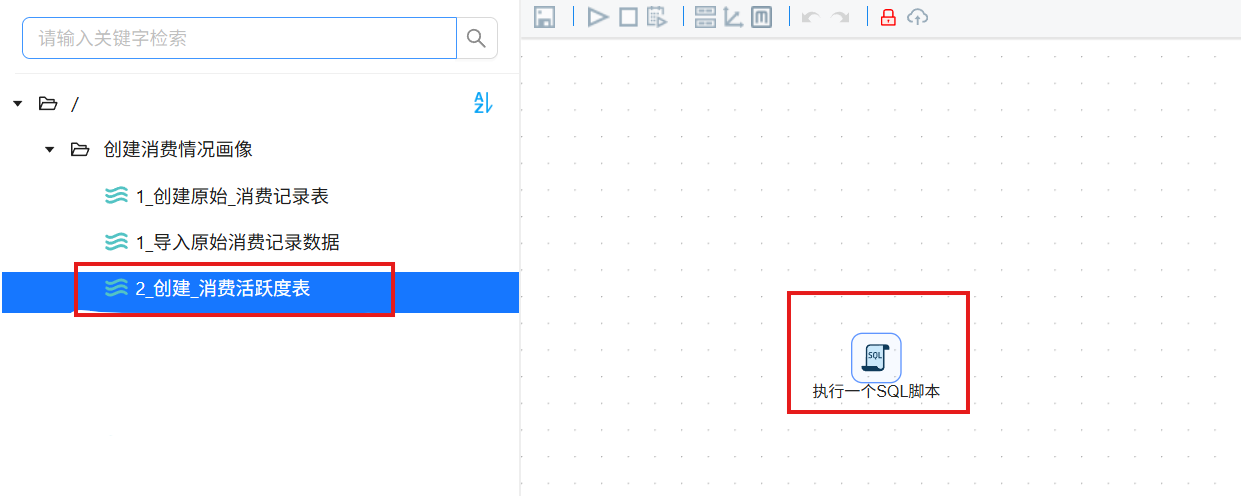
2.3 创建消费活跃度表
参考 【2.1 创建原始_消费表】 实现步骤,通过 “执行一个SQL脚本” 创建消费活跃度表
这一步的建表SQL语句如下:
DROP TABLE student_activity_labels432;
CREATE TABLE IF NOT EXISTS student_activity_labels432 (
    id INT PRIMARY KEY AUTO_INCREMENT COMMENT '自增主键',
    student_id VARCHAR(50) NOT NULL COMMENT '学生ID',
    total_amount DECIMAL(10,2) DEFAULT 0 COMMENT '消费总金额',
    total_count INT DEFAULT 0 COMMENT '消费总次数',
    avg_amount DECIMAL(8,2) DEFAULT 0 COMMENT '平均消费金额',
    max_amount DECIMAL(8,2) DEFAULT 0 COMMENT '单笔最大消费',
    monthly_avg DECIMAL(8,2) DEFAULT 0 COMMENT '月均消费次数',
    activity_level VARCHAR(20) COMMENT '活跃度等级',
    create_time DATETIME DEFAULT CURRENT_TIMESTAMP COMMENT '创建时间',
    INDEX idx_student (student_id),
    INDEX idx_level (activity_level)
) COMMENT='学生消费活跃度标签表';
2.4 创建学生消费活跃度分层标签
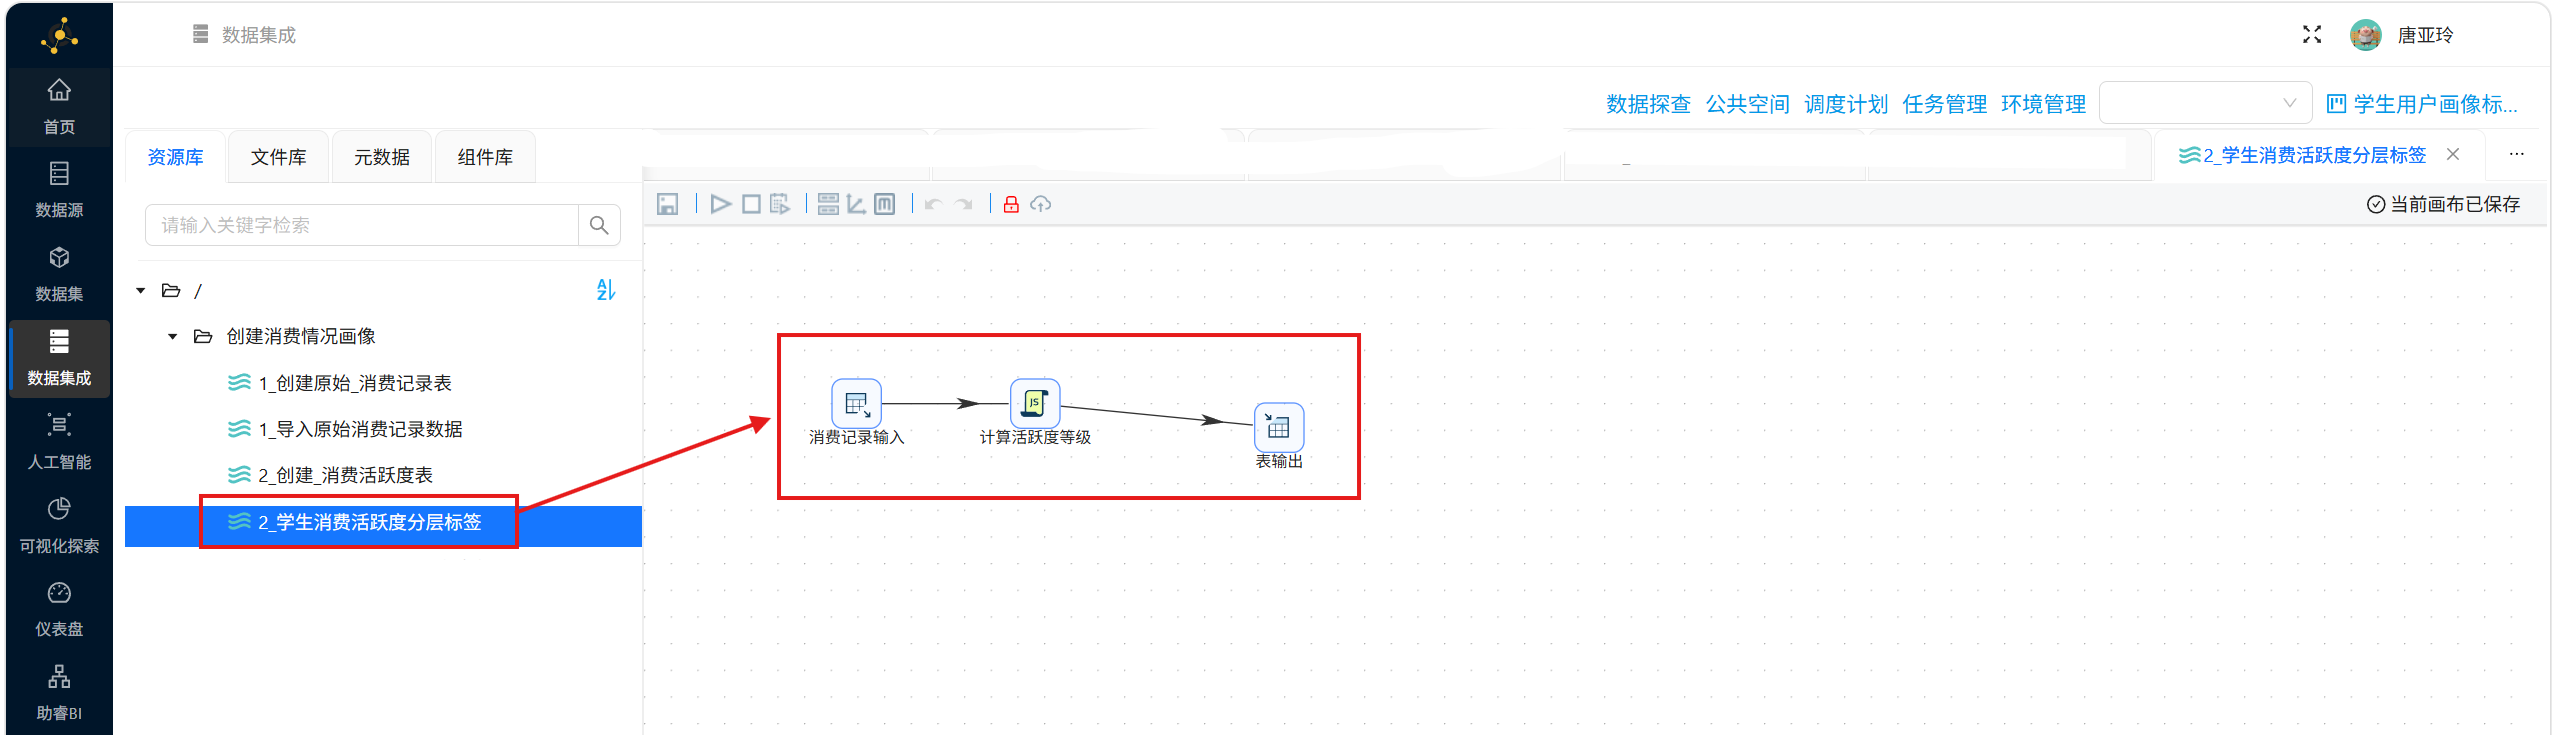
创建消费活跃度标签的完整转换流程图如下:
首先,新建一个转换流并命名为:“2_学生消费活跃度分层标签”,拖拽出下列组件
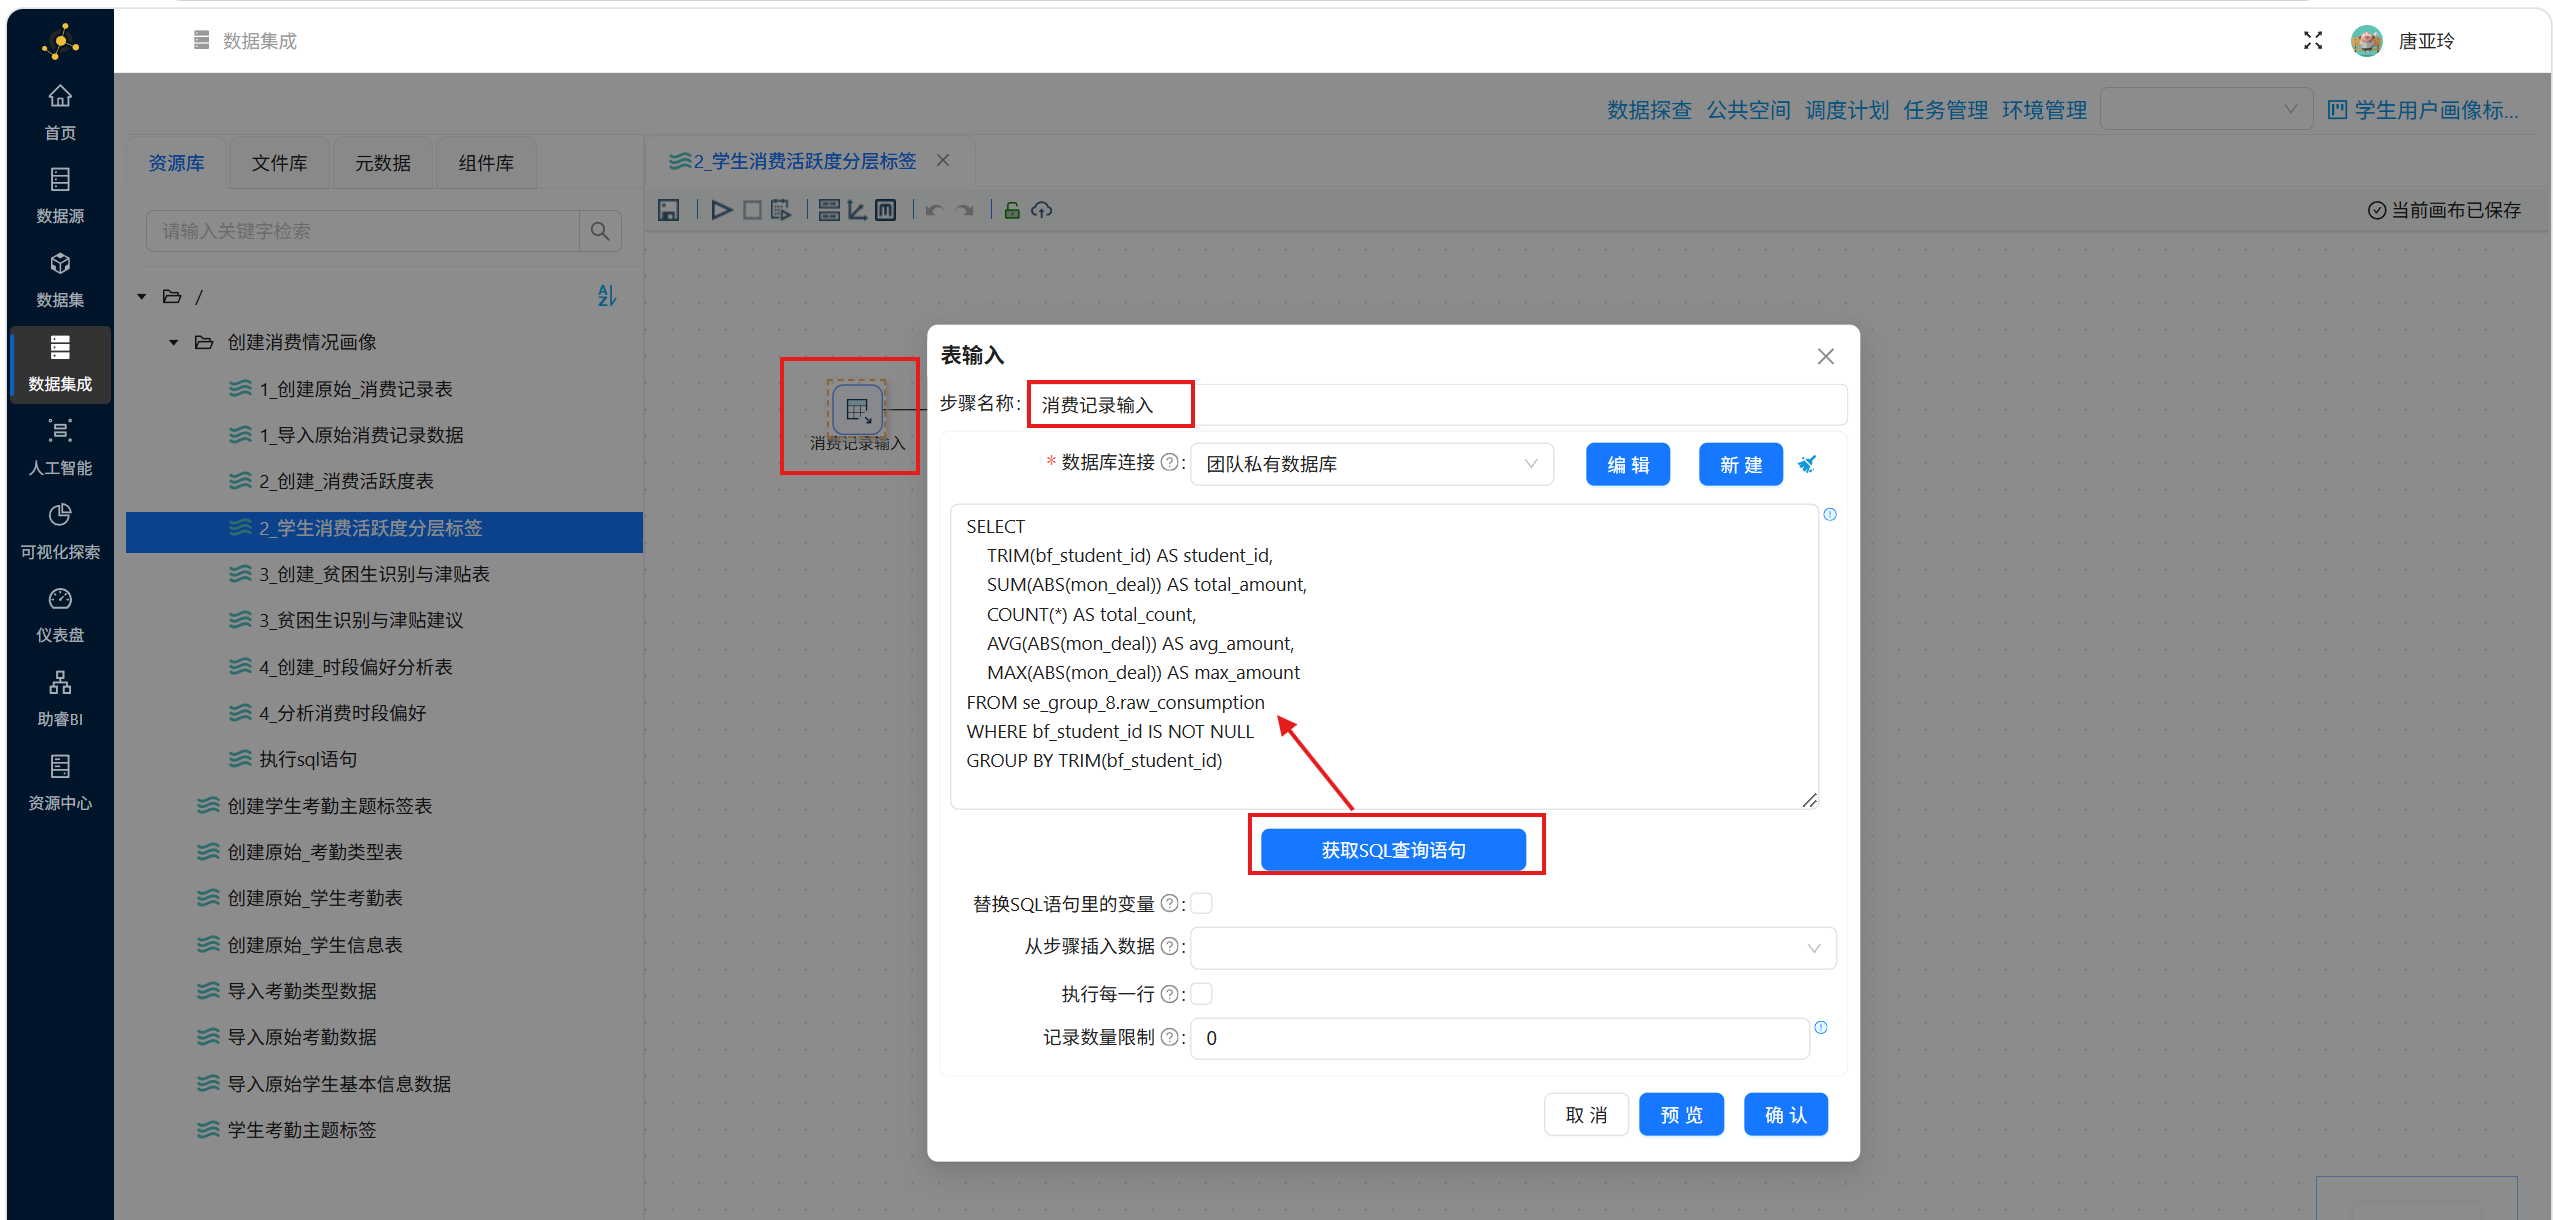
“表输入”组件的配置如下图:
“JavaScript代码” 组件的具体配置如下:
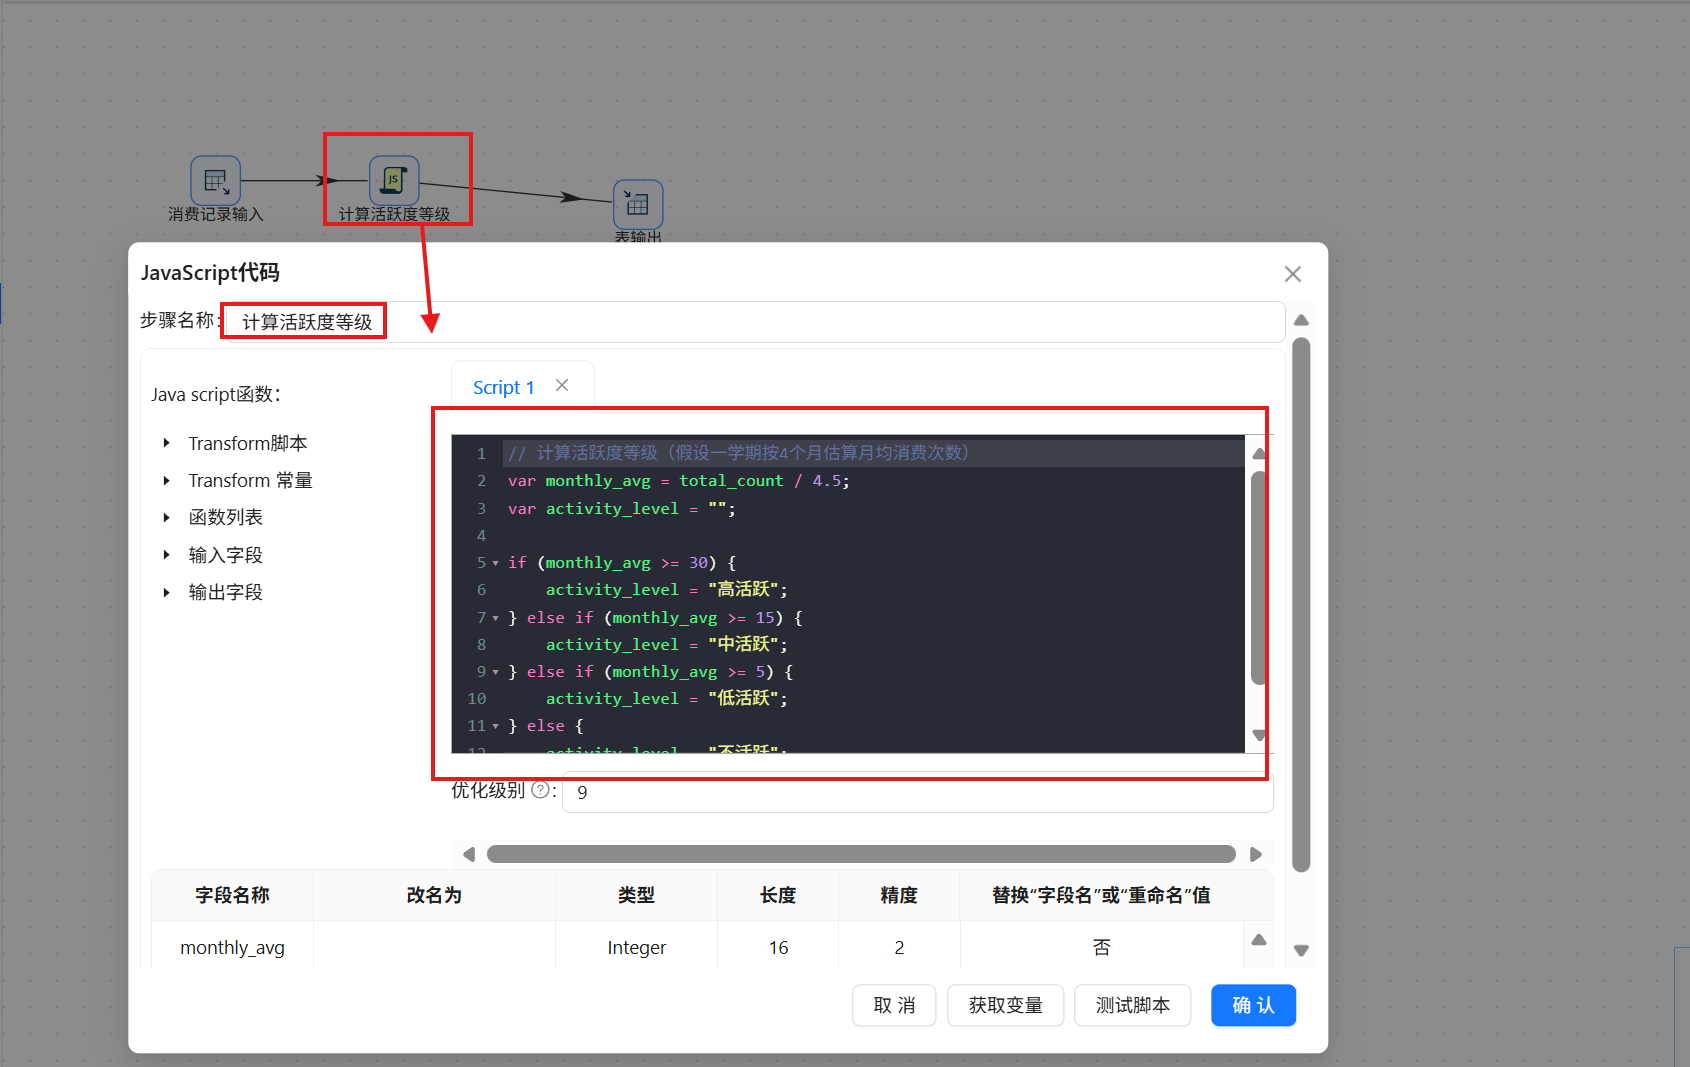
JS脚本如下:计算消费的活跃度等级
// 计算活跃度等级(假设一学期按4个月左右估算月均消费次数)
var monthly_avg = total_count / 4.5;
var activity_level = "";

if (monthly_avg >= 30) {
    activity_level = "高活跃";
} else if (monthly_avg >= 15) {
    activity_level = "中活跃";
} else if (monthly_avg >= 5) {
    activity_level = "低活跃";
} else {
    activity_level = "不活跃";
}
表输出的配置如下图,选择对应的输出表
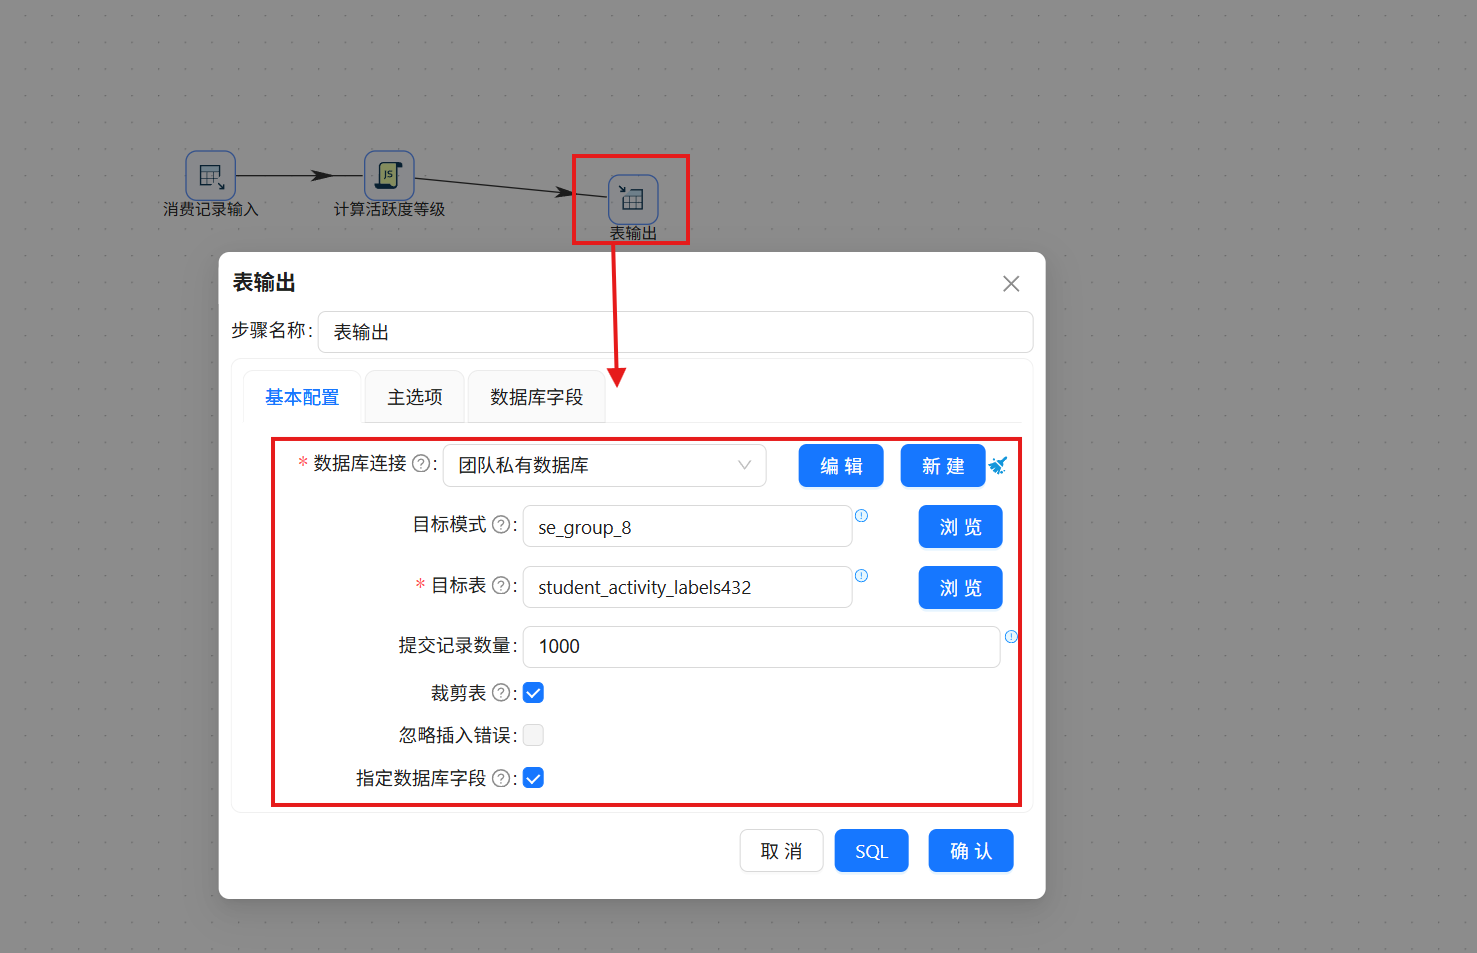
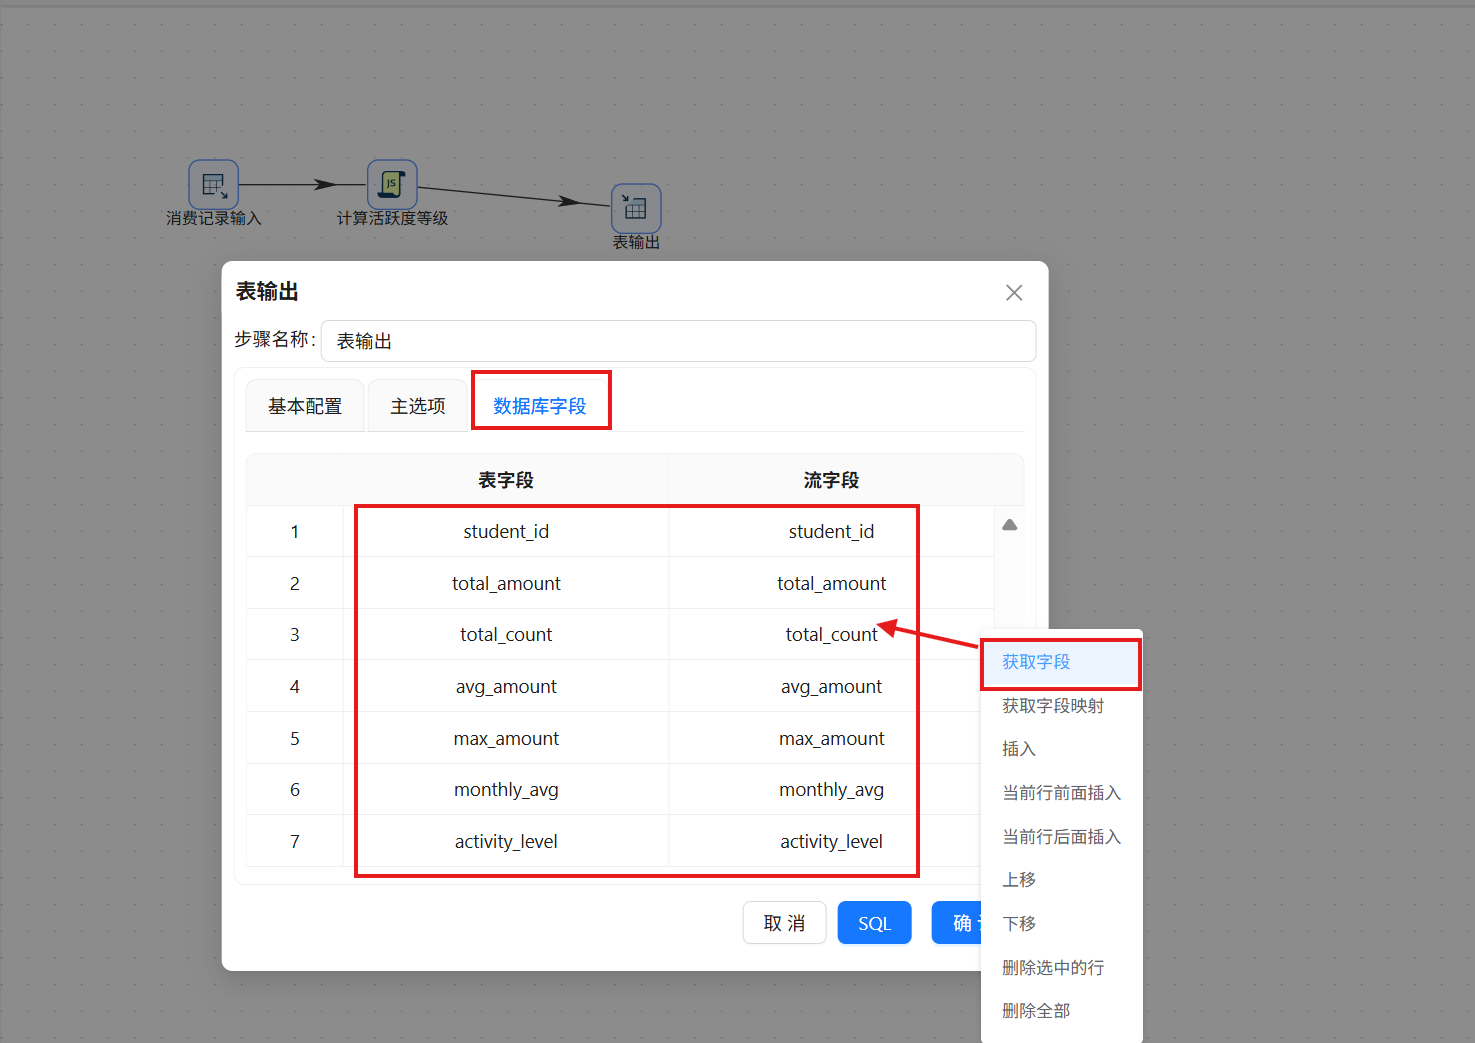
切换到 “数据库字段”页面,在空白处右键点击 “获取字段”,查看字段间的映射关系是否正确
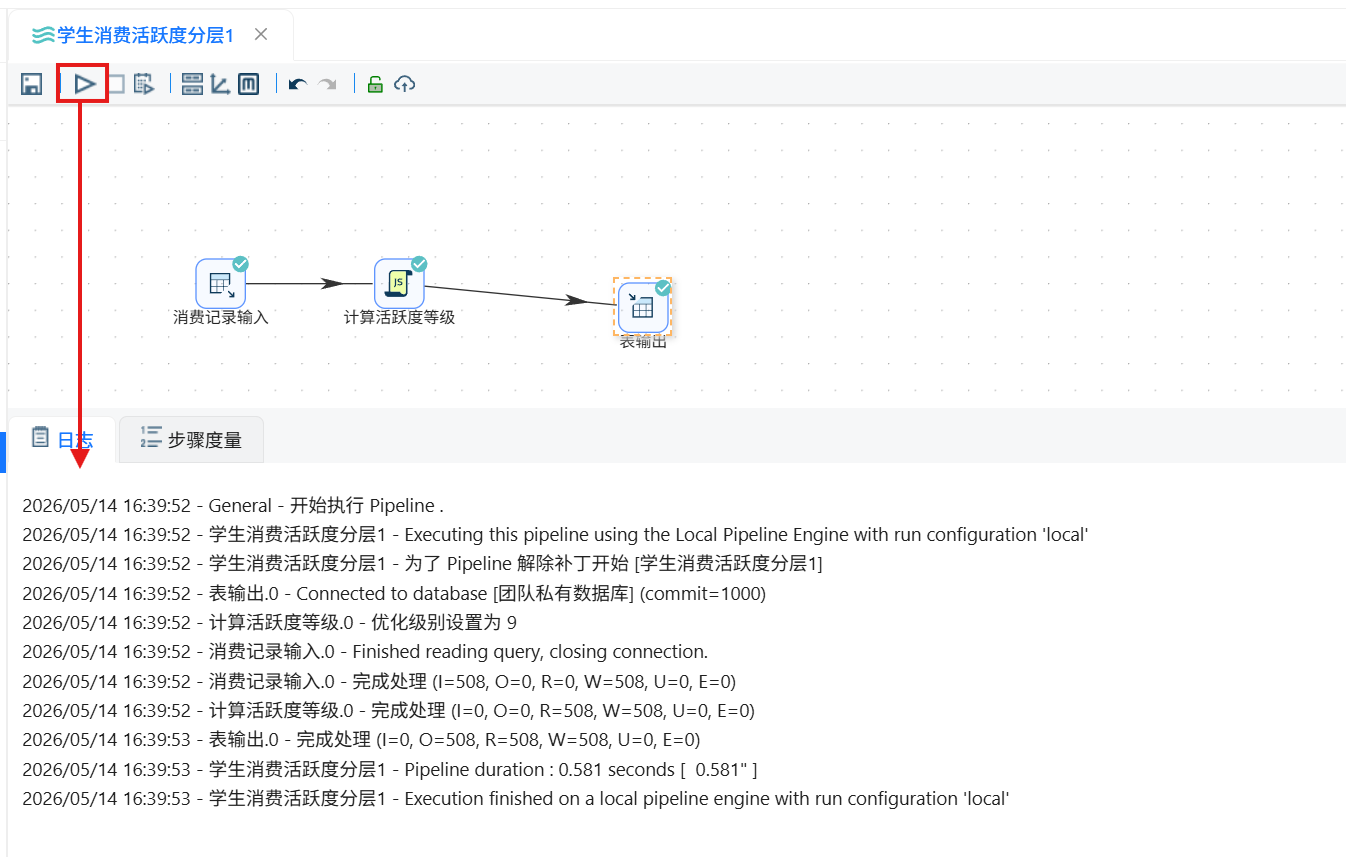
确认无误后,点击执行转换流,查看执行是否正确
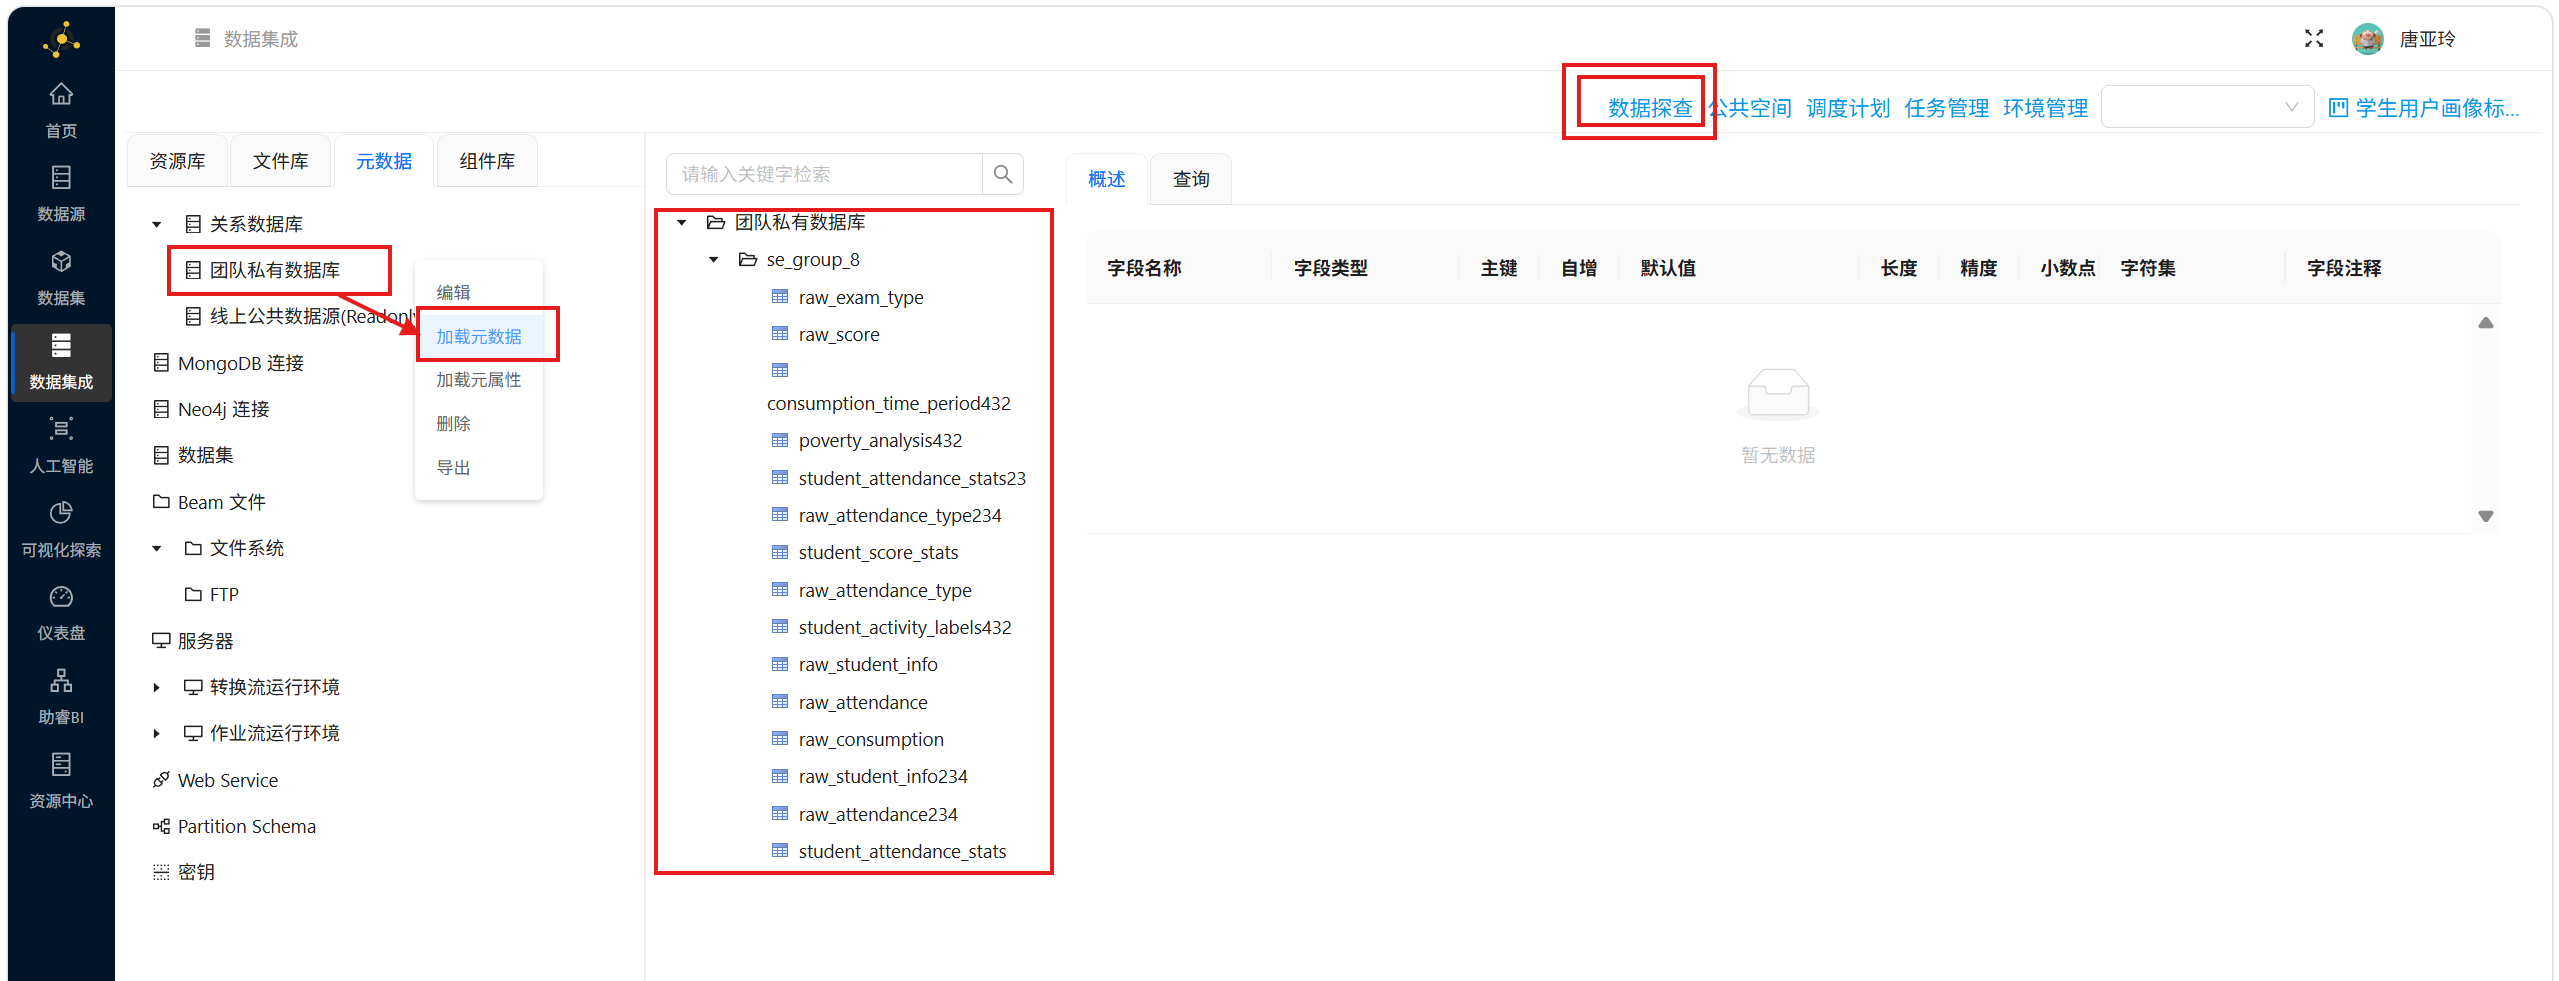
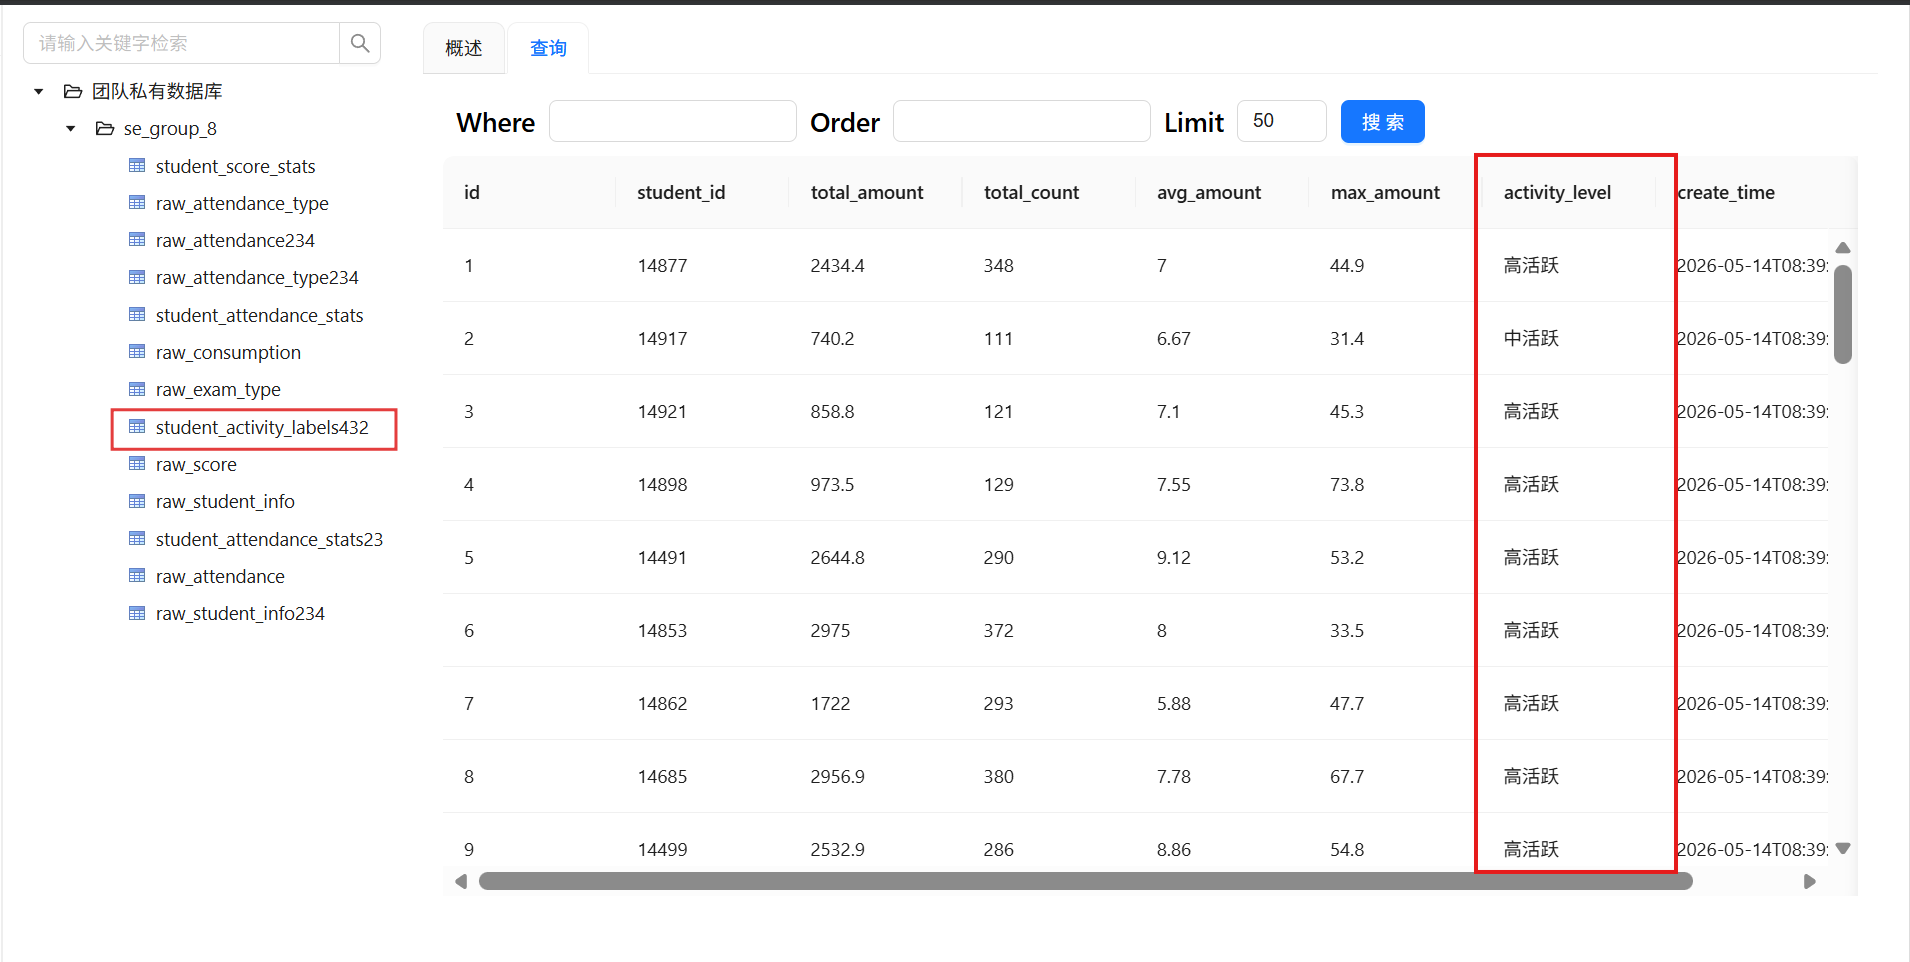
可以在【数据探查】查看表格数据,是否符合目标
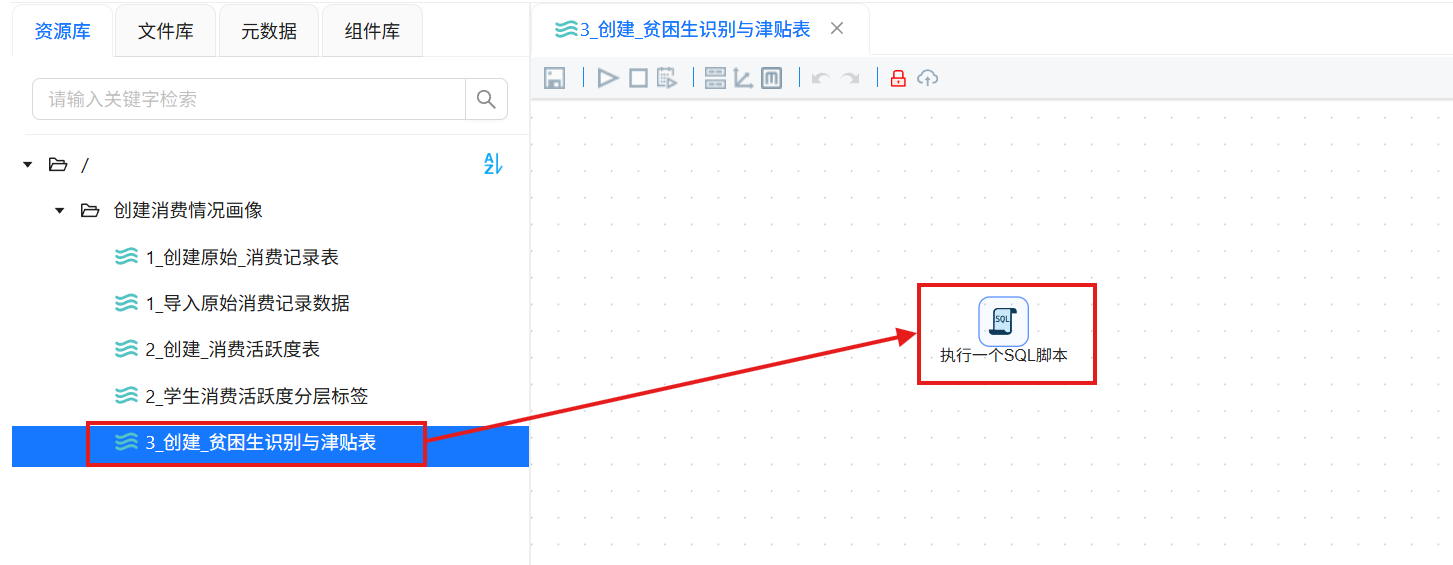
2.5 创建贫困生识别与津贴表
参考 【2.1 创建原始_消费表】 实现步骤,通过 “执行一个SQL脚本” 创建贫困生识别与津贴表
拖拽 “执行一个SQL脚本” 组件,具体配置如下,创建表 poverty_analysis432
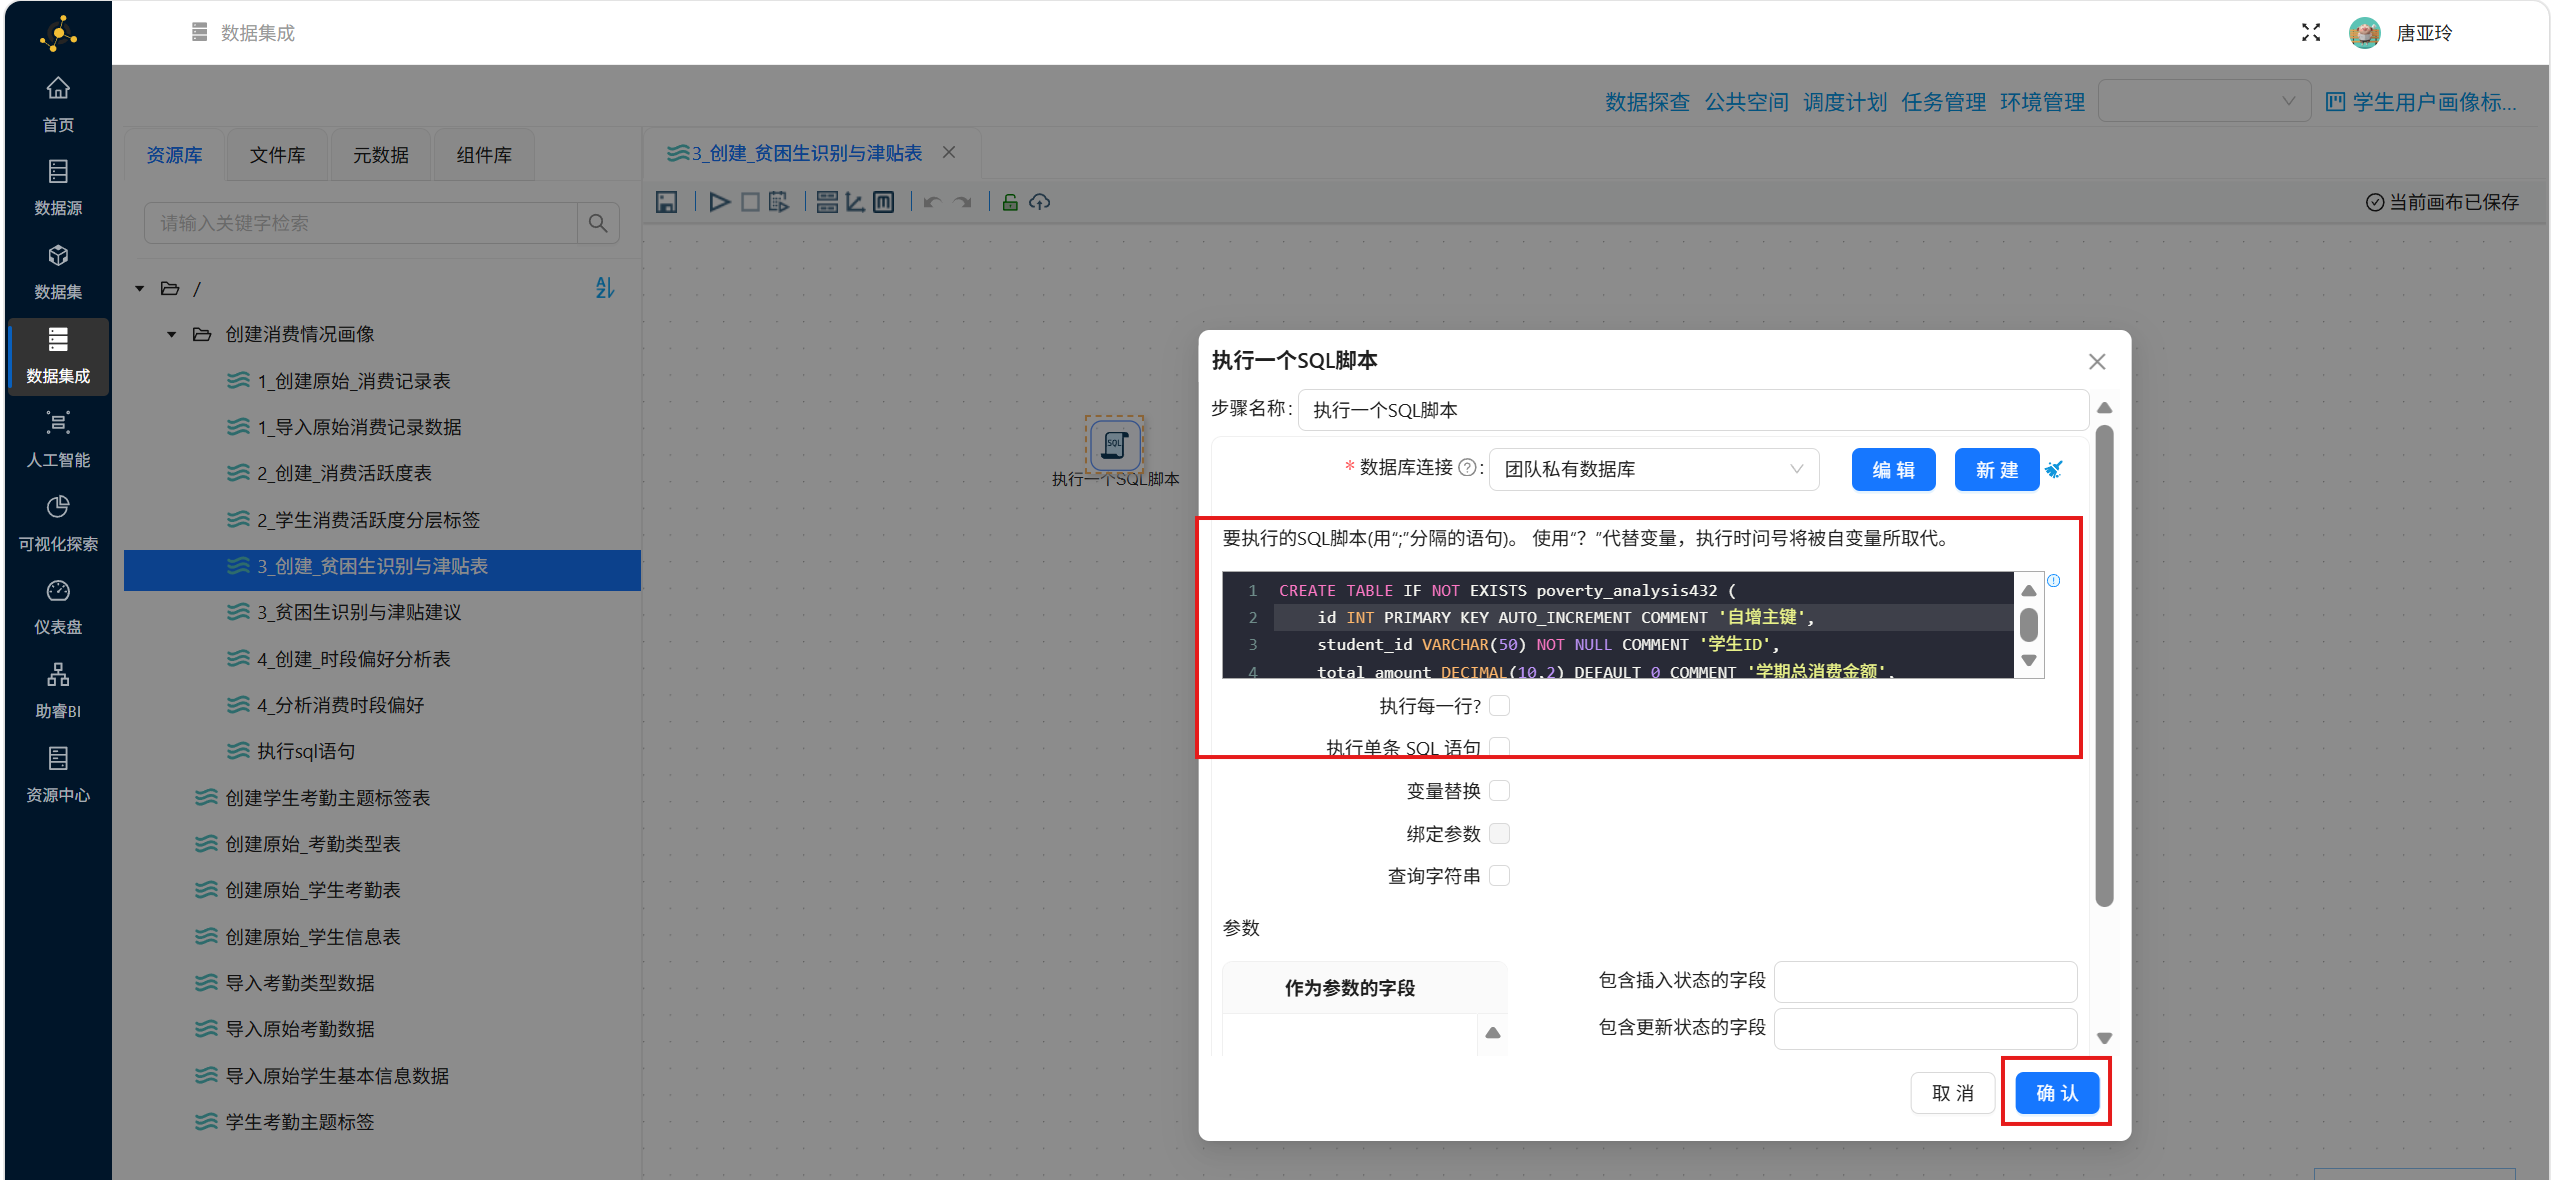
CREATE TABLE IF NOT EXISTS poverty_analysis432 (
    id INT PRIMARY KEY AUTO_INCREMENT COMMENT '自增主键',
    student_id VARCHAR(50) NOT NULL COMMENT '学生ID',
    total_amount DECIMAL(10,2) DEFAULT 0 COMMENT '学期总消费金额',
    total_count INT DEFAULT 0 COMMENT '学期消费次数',
    avg_amount DECIMAL(8,2) DEFAULT 0 COMMENT '平均每笔消费',
    max_amount DECIMAL(8,2) DEFAULT 0 COMMENT '单笔最大消费',
    monthly_avg_count DECIMAL(8,2) DEFAULT 0 COMMENT '月均消费次数',
    poverty_level VARCHAR(20) COMMENT '贫困等级',
    subsidy_amount INT DEFAULT 0 COMMENT '建议津贴金额(元/学期)',
    create_time DATETIME DEFAULT CURRENT_TIMESTAMP,
    INDEX idx_student (student_id),
    INDEX idx_poverty (poverty_level)
);
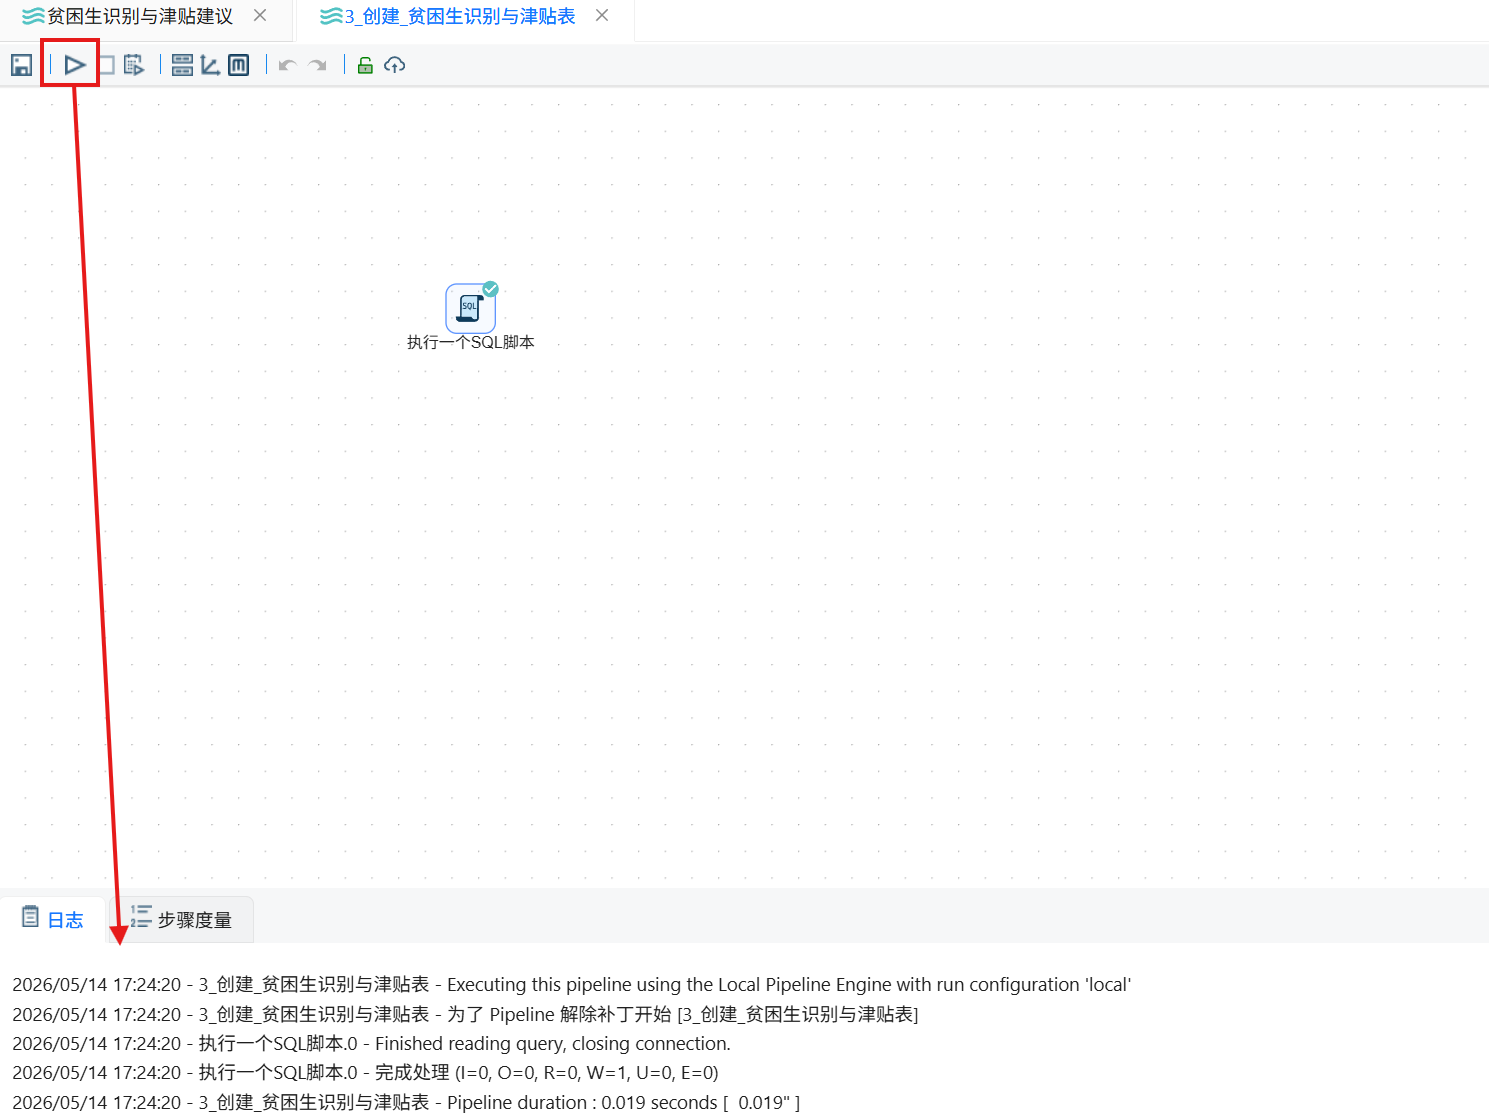
点击执行转换流,查看执行结果,无误则继续下一节
2.6 创建 贫困生识别与津贴建议 分析
新建一个转换流并命名为:“贫困生识别与津贴建议”,拖拽出下列组件,构建流程图
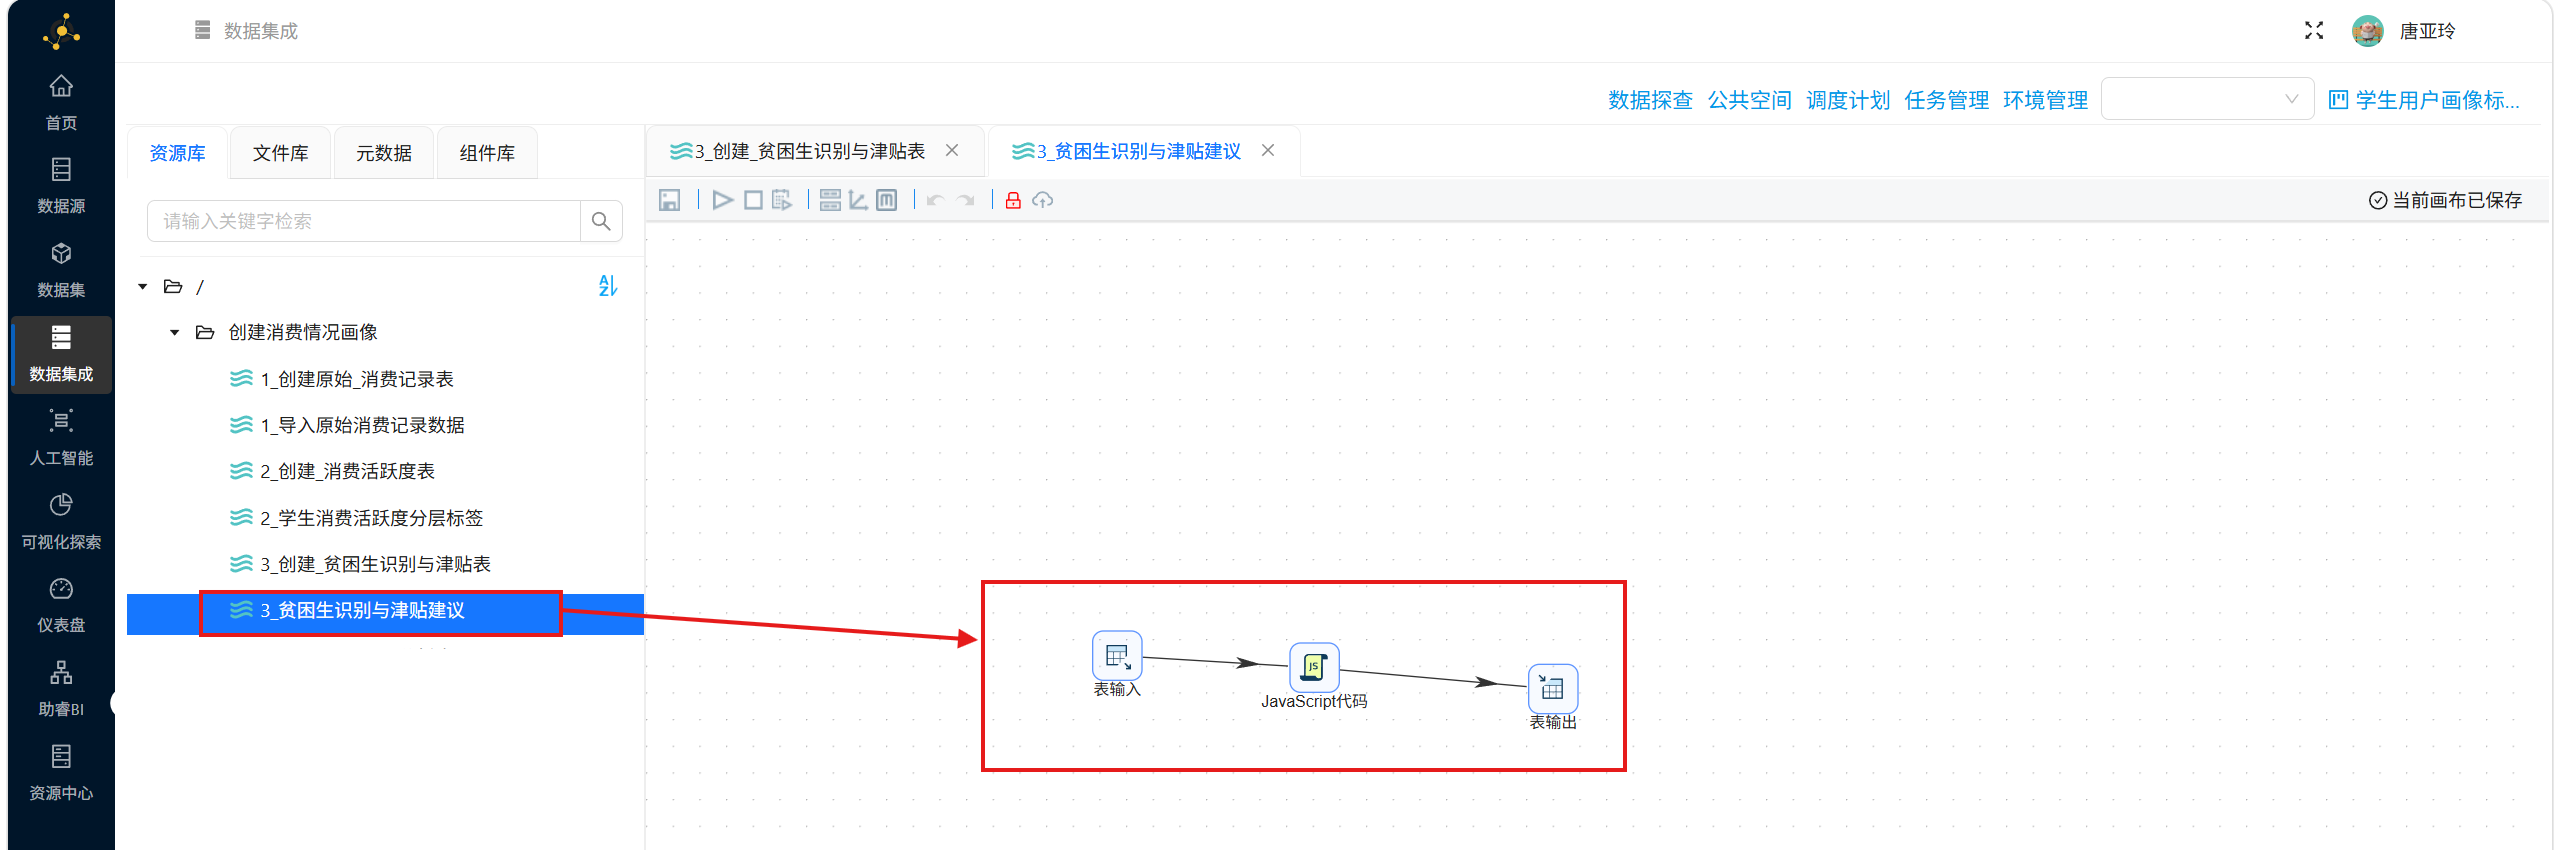
表输入、JavaScript代码、表输出组件的具体配置如下所示:
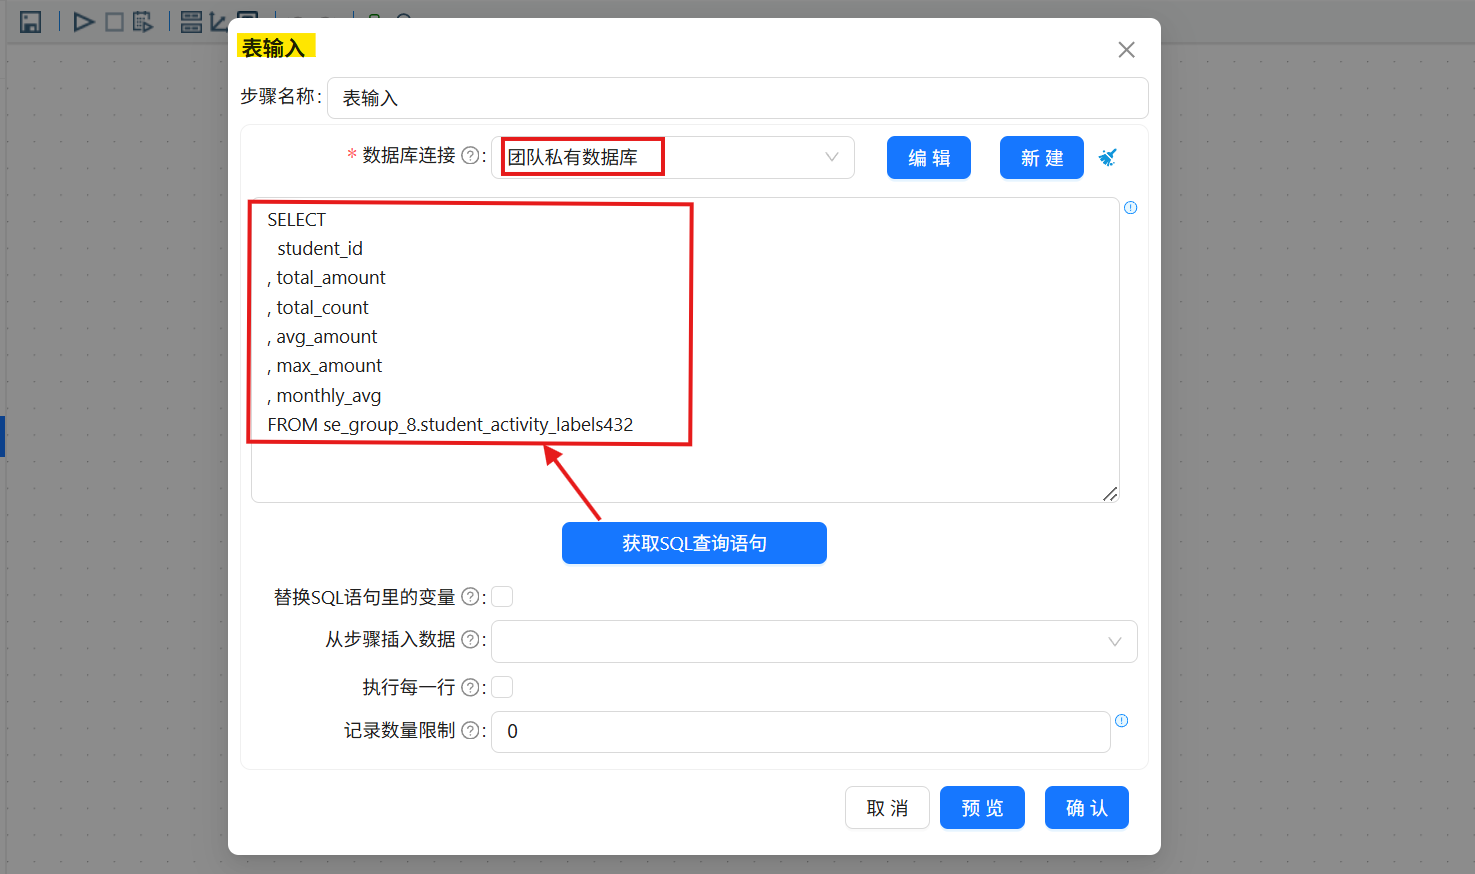
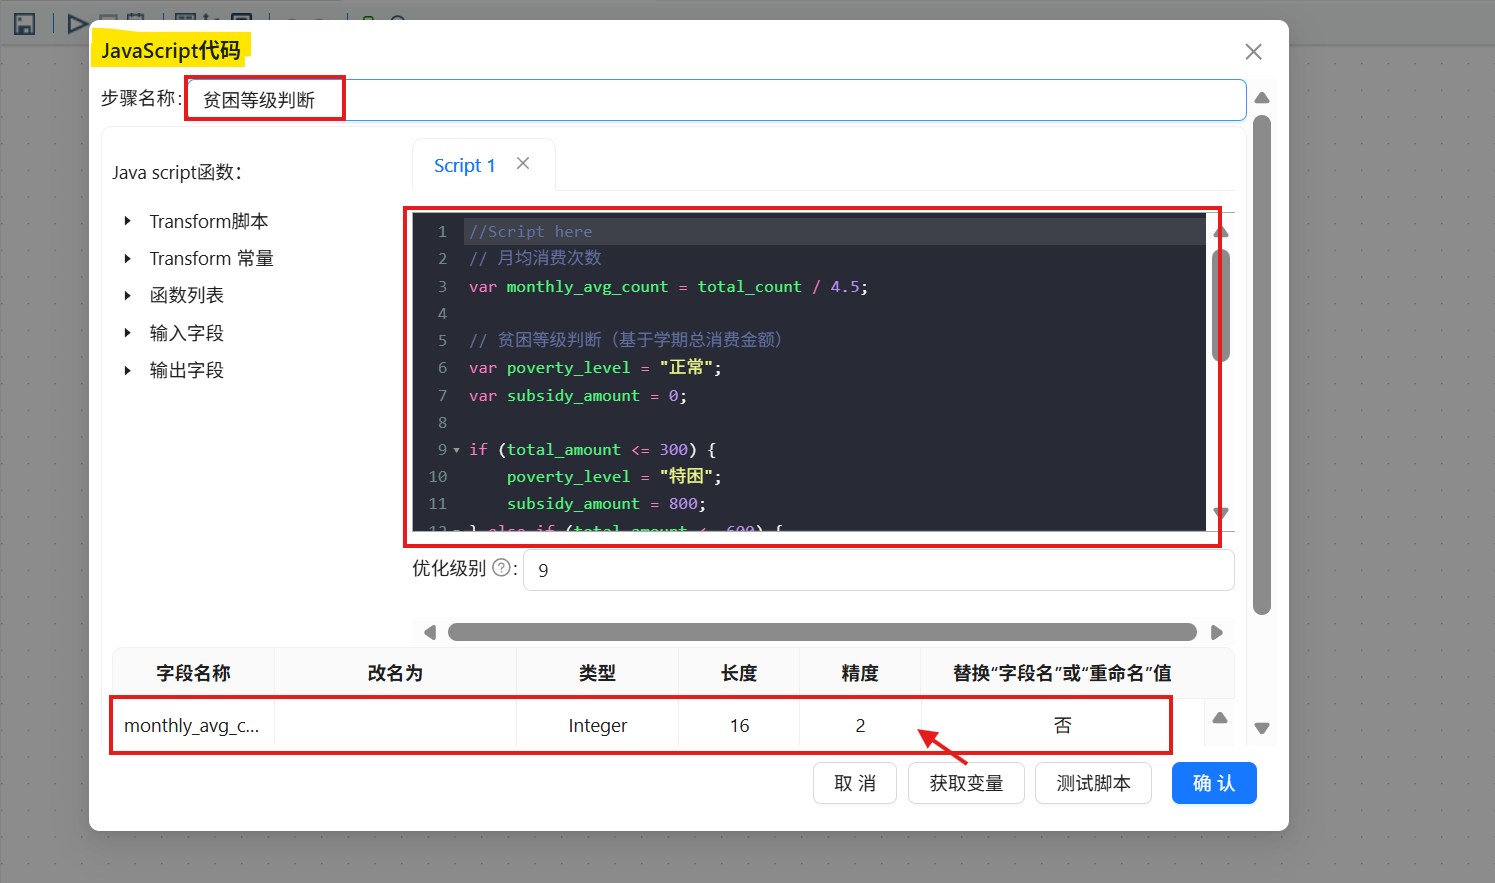
JS逻辑代码如下,可以根据学期总消费判断贫困等级
//Script here
// 月均消费次数
var monthly_avg_count = total_count / 4.5;

// 贫困等级判断(基于学期总消费金额)
var poverty_level = "正常";
var subsidy_amount = 0;

if (total_amount <= 300) {
    poverty_level = "特困";
    subsidy_amount = 800;
} else if (total_amount <= 600) {
    poverty_level = "困难";
    subsidy_amount = 500;
} else if (total_amount <= 1000) {
    poverty_level = "中等偏低";
    subsidy_amount = 300;
}

// 结合消费次数校验
if (total_count <= 20 && total_amount <= 500) {
    poverty_level = "重点关注";
    subsidy_amount = 600;
}
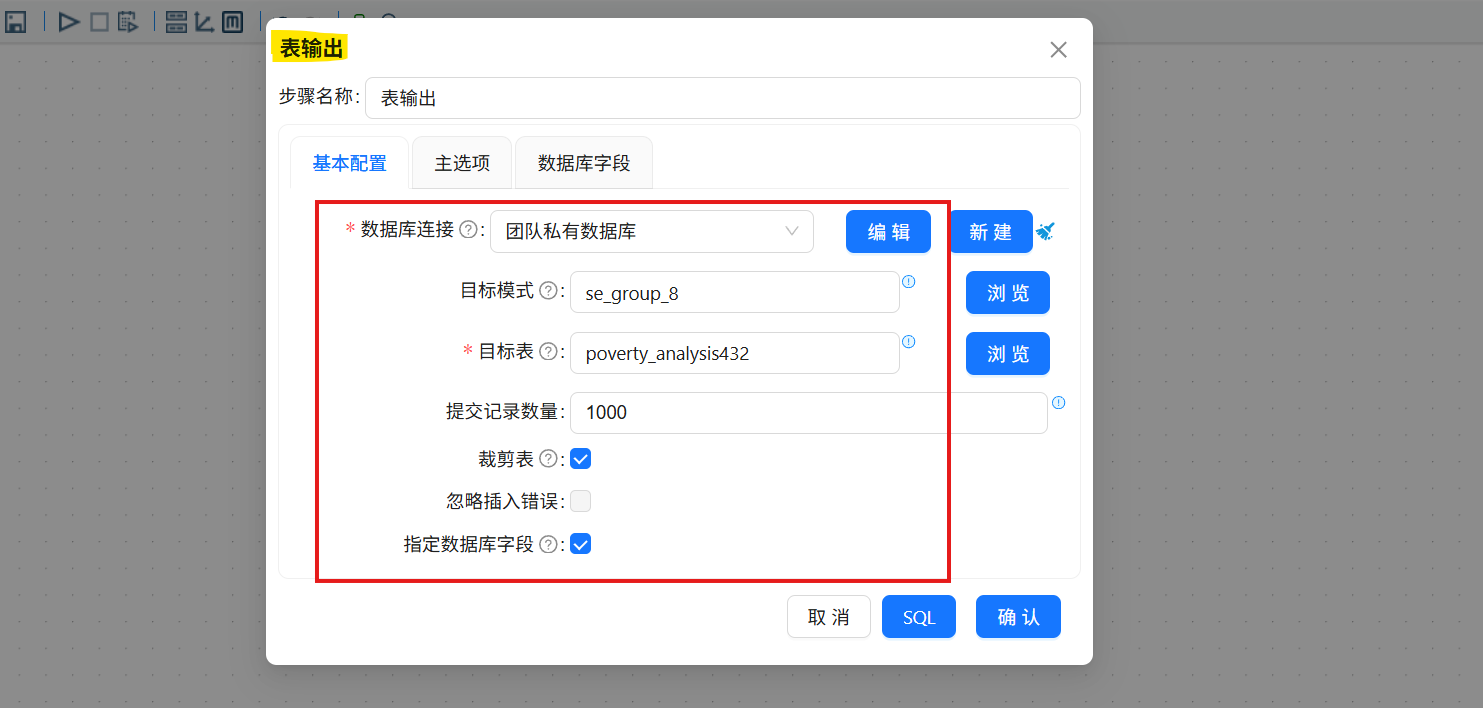
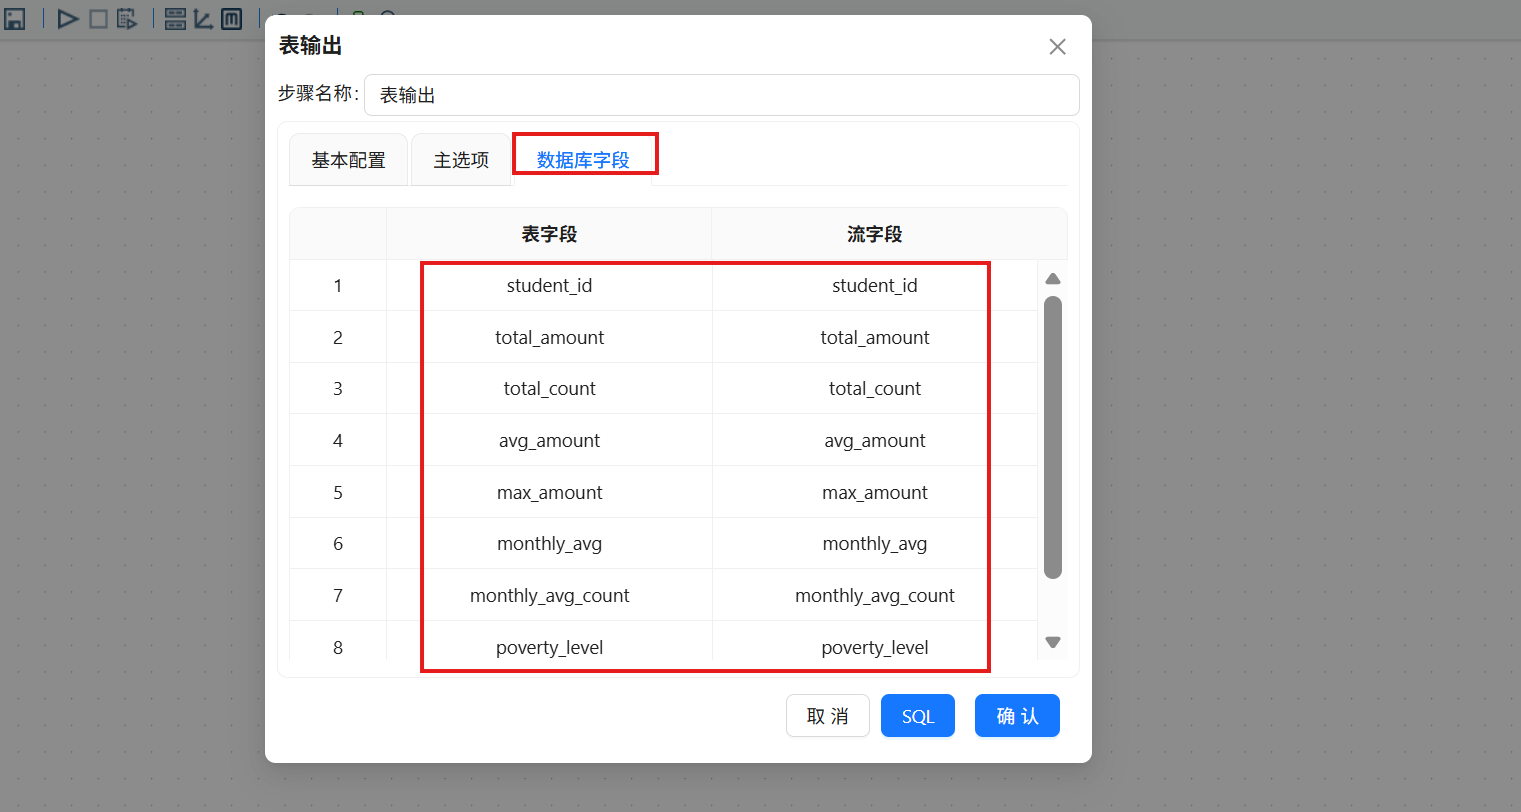
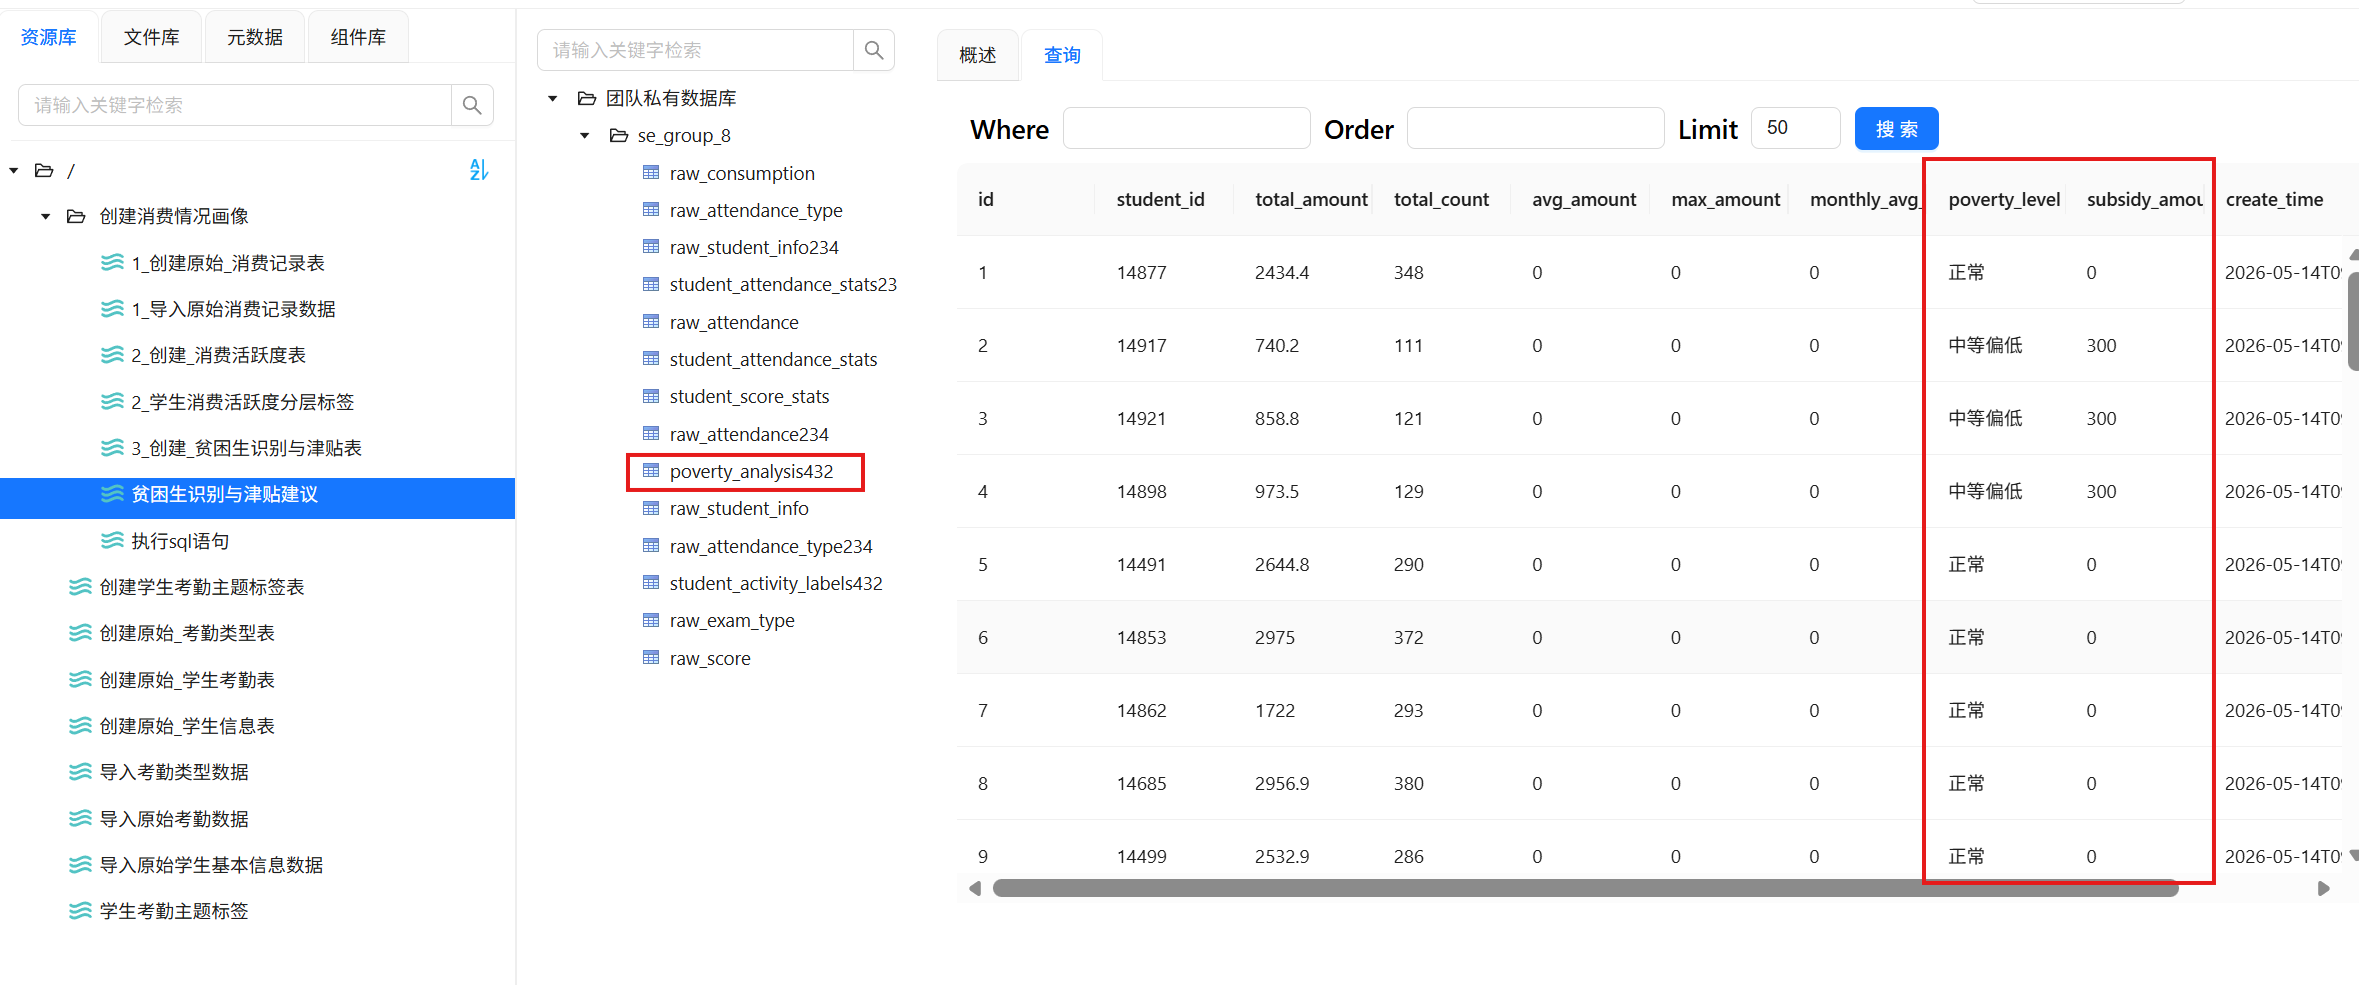
参照完成上述配置后就可以点击执行转换流了,查看【数据探查】中的表格数据
2.7 创建时段偏好分析表
参考 【2.1 创建原始_消费表】 实现步骤,通过 “执行一个SQL脚本” 创建 时段偏好分析表
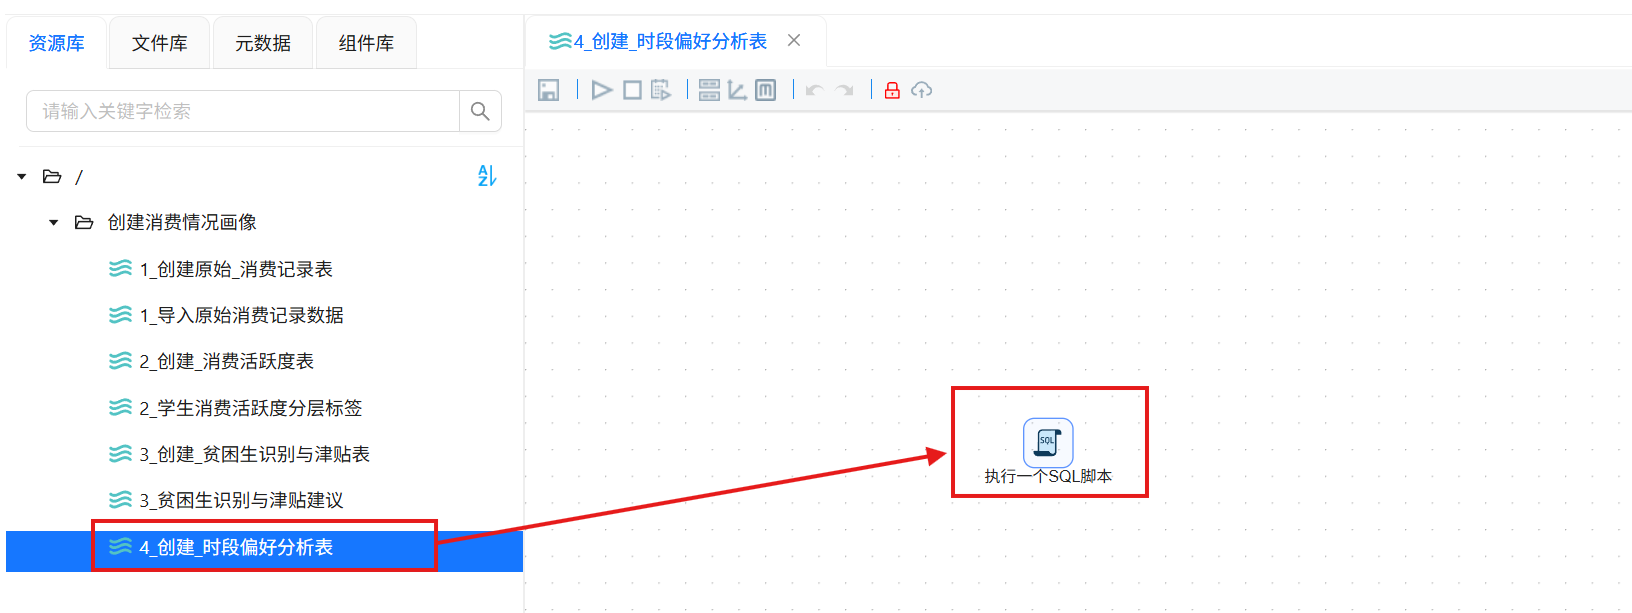
SQL建表如下:
CREATE TABLE IF NOT EXISTS consumption_time_period432(
    time_period VARCHAR(20) NOT NULL COMMENT '时段',
    deal_count INT DEFAULT 0 COMMENT '消费次数',
    total_amount DECIMAL(12,2) DEFAULT 0 COMMENT '消费总额',
    avg_amount DECIMAL(8,2) DEFAULT 0 COMMENT '平均每笔消费',
    max_amount DECIMAL(8,2) DEFAULT 0 COMMENT '单笔最大消费',
    create_time DATETIME DEFAULT CURRENT_TIMESTAMP,
    INDEX idx_period (time_period)
) COMMENT='消费时段偏好表';
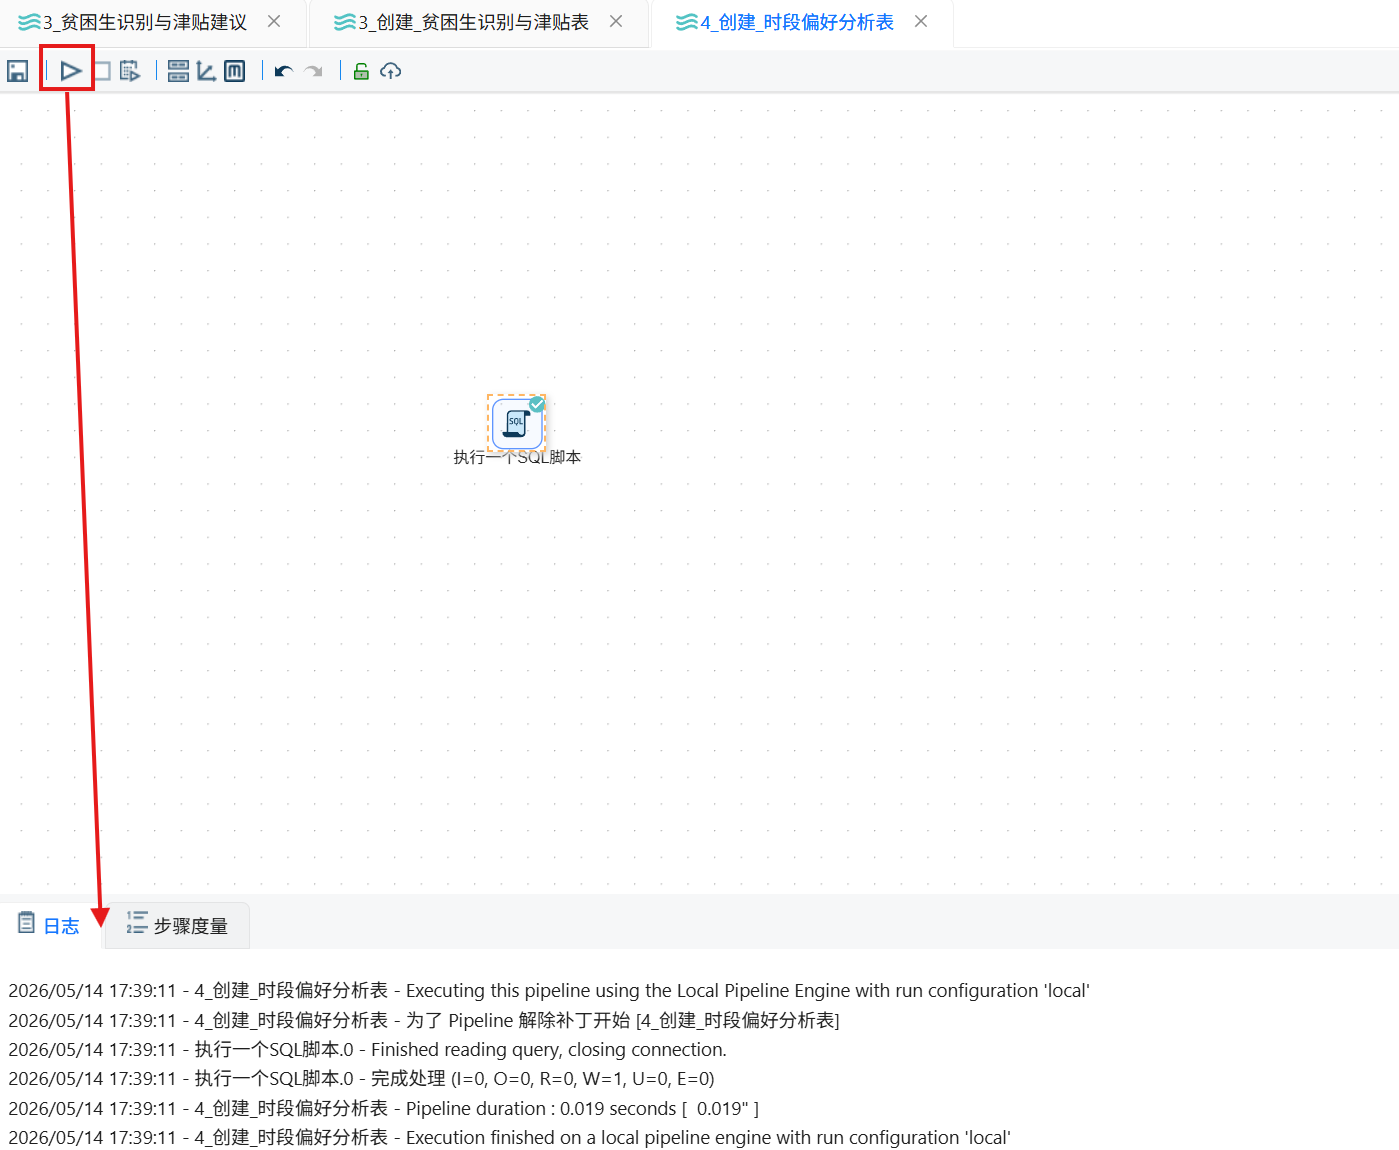
完成上边操作,点击执行转换流完成表格的创建
2.7 分析消费时段偏好
新建转换流并命名为:“分析消费时段偏好”,完整的转换流程图所需组件如下图所示:
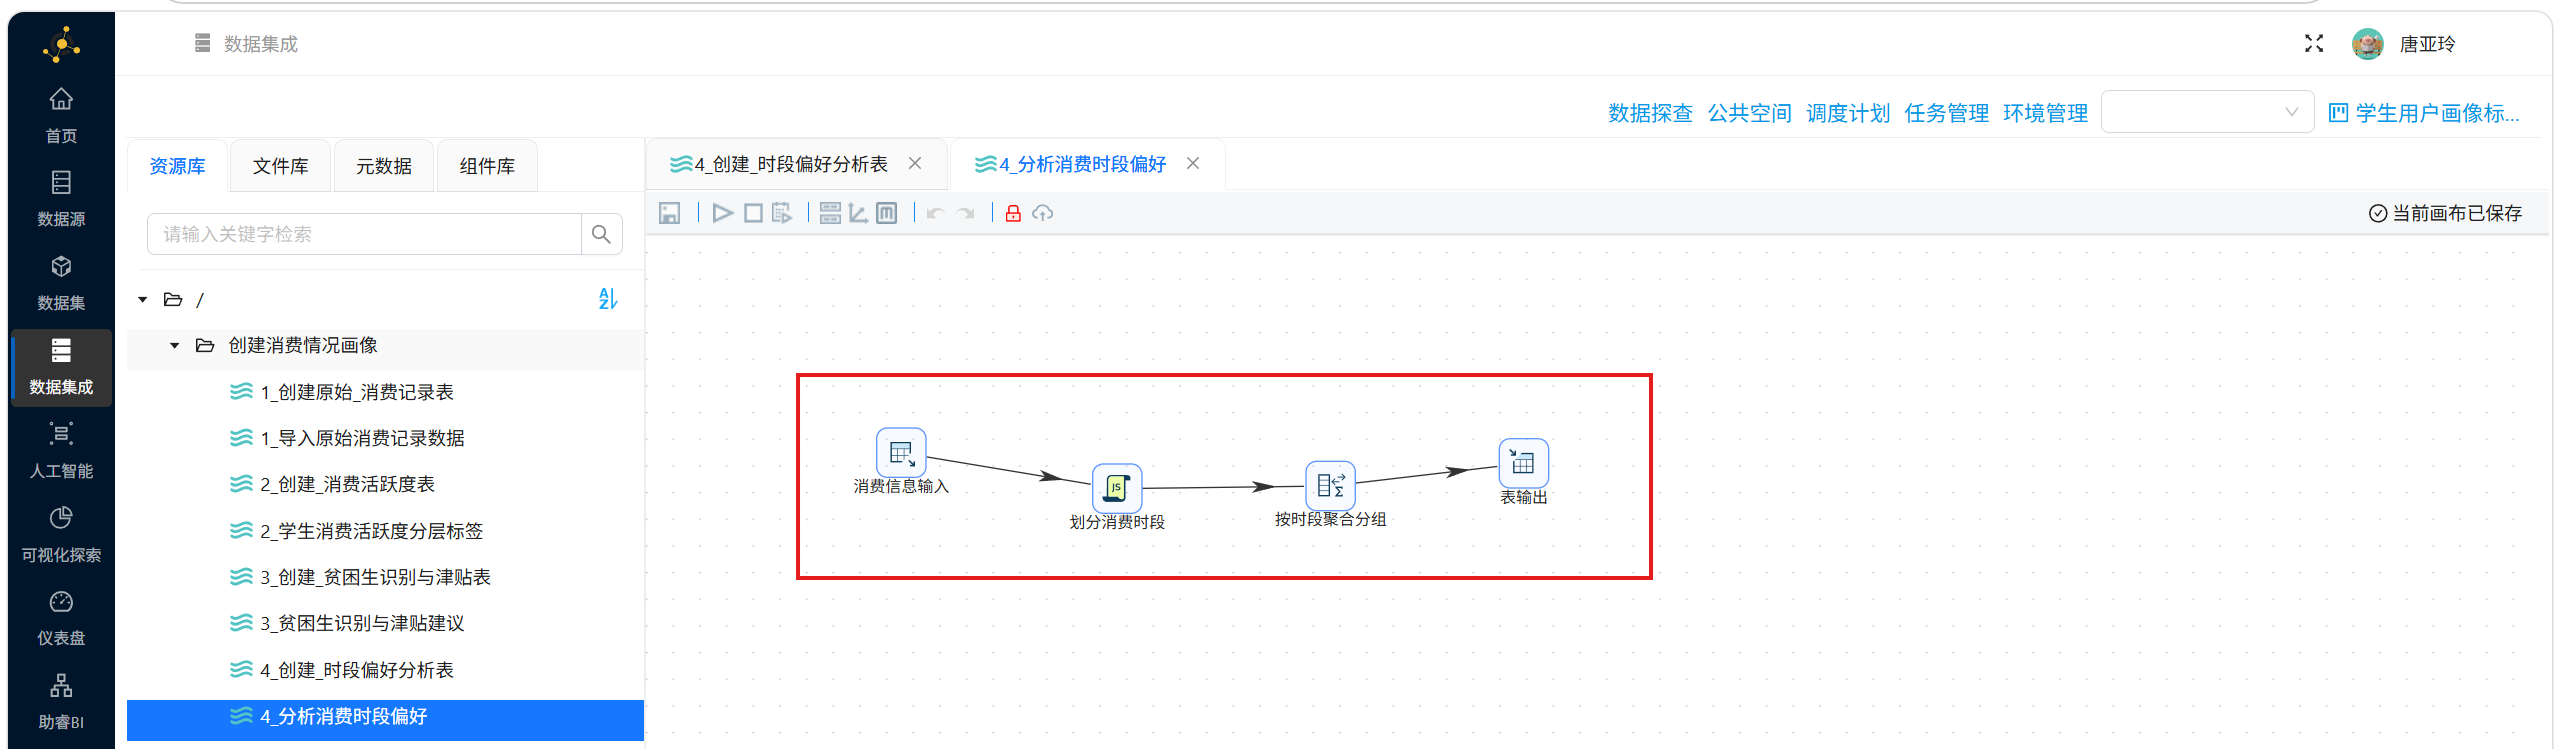
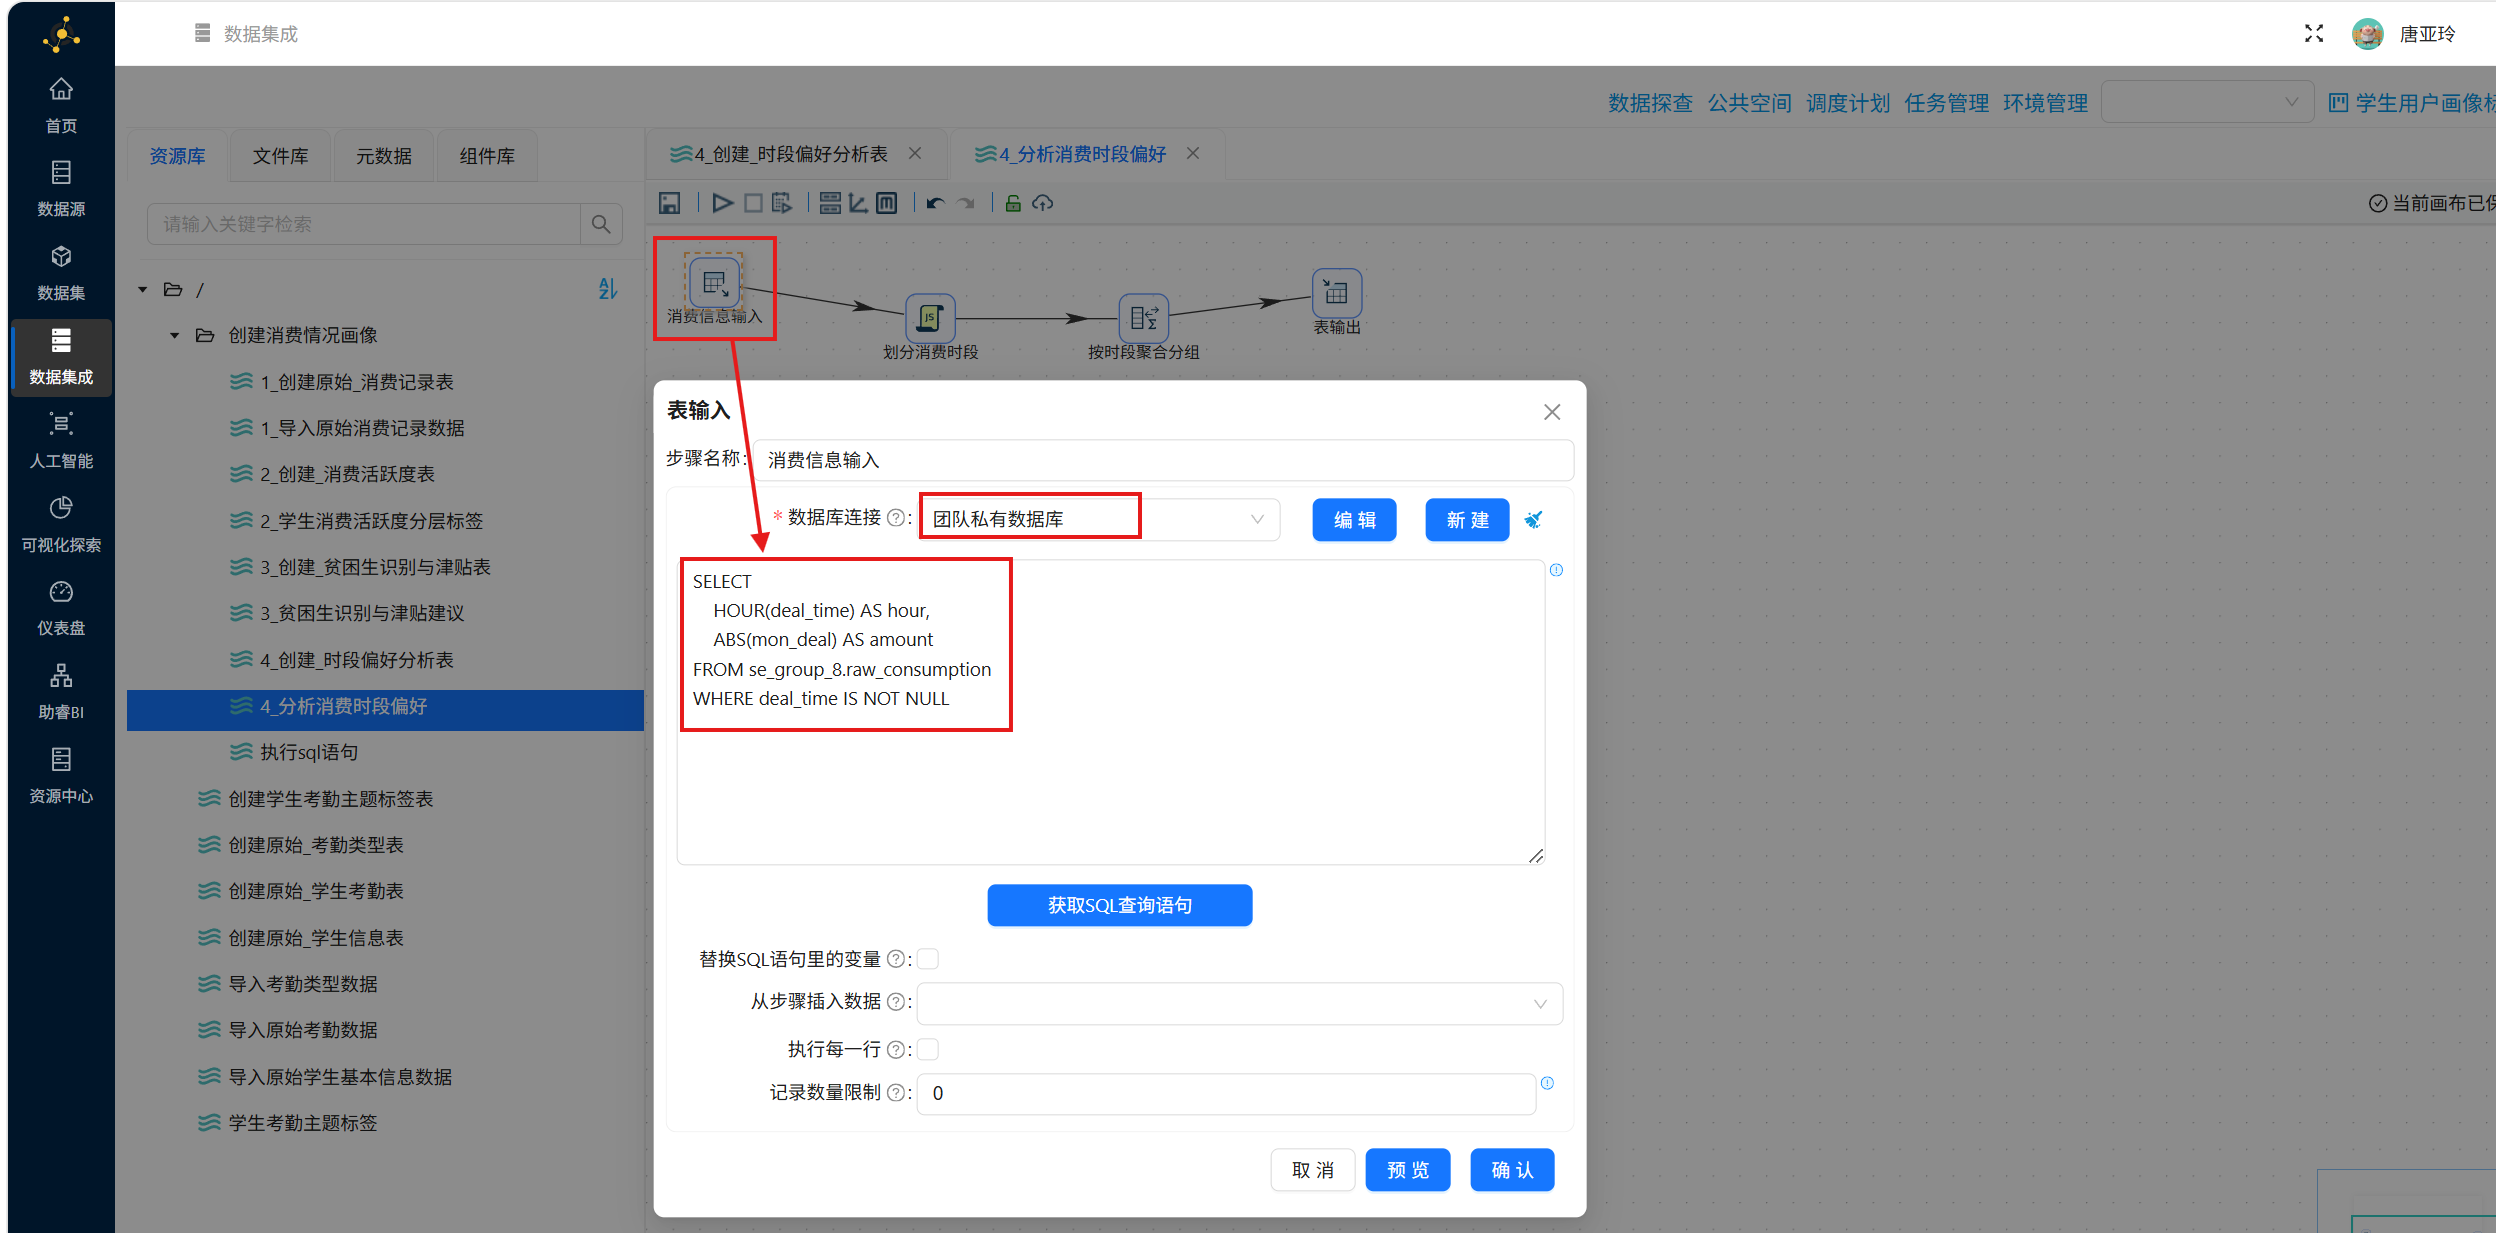
首先,双击 “表输入”组件,配置步骤名称、数据库连接,获取或编写实现自己需求的SQL语句,这一步,我们只需要源表中的两个字段,并根据数据类型调整
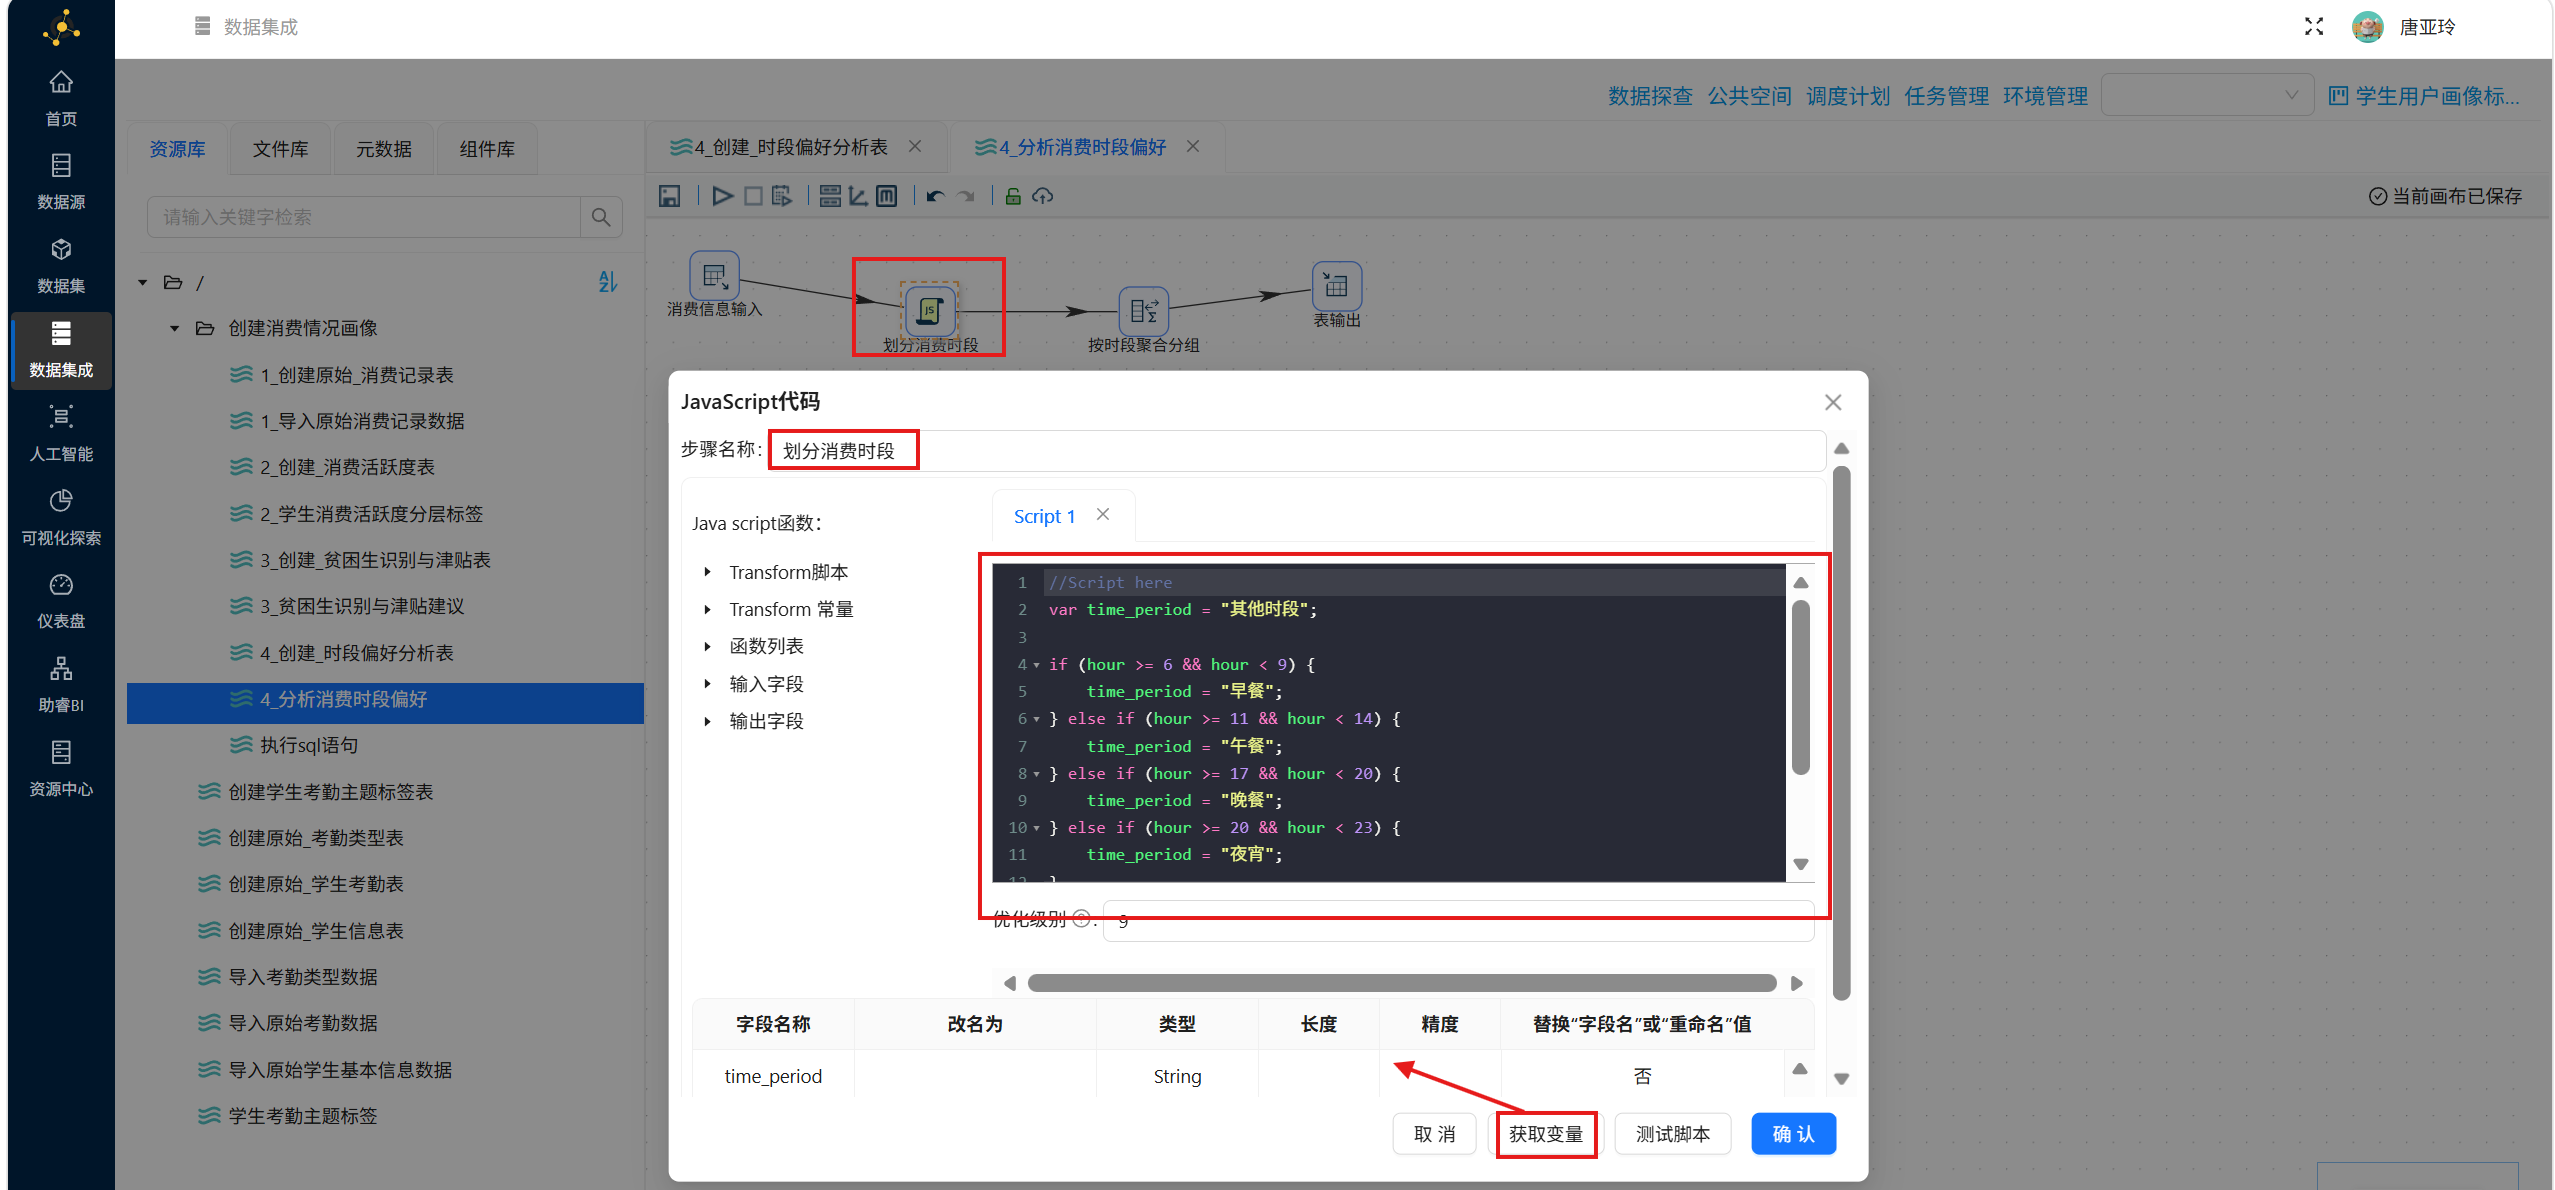
接着配置 “JavaScript代码”组件,配置步骤名称和业务逻辑代码,可以点击 “获取变量”查看字段信息是否正确
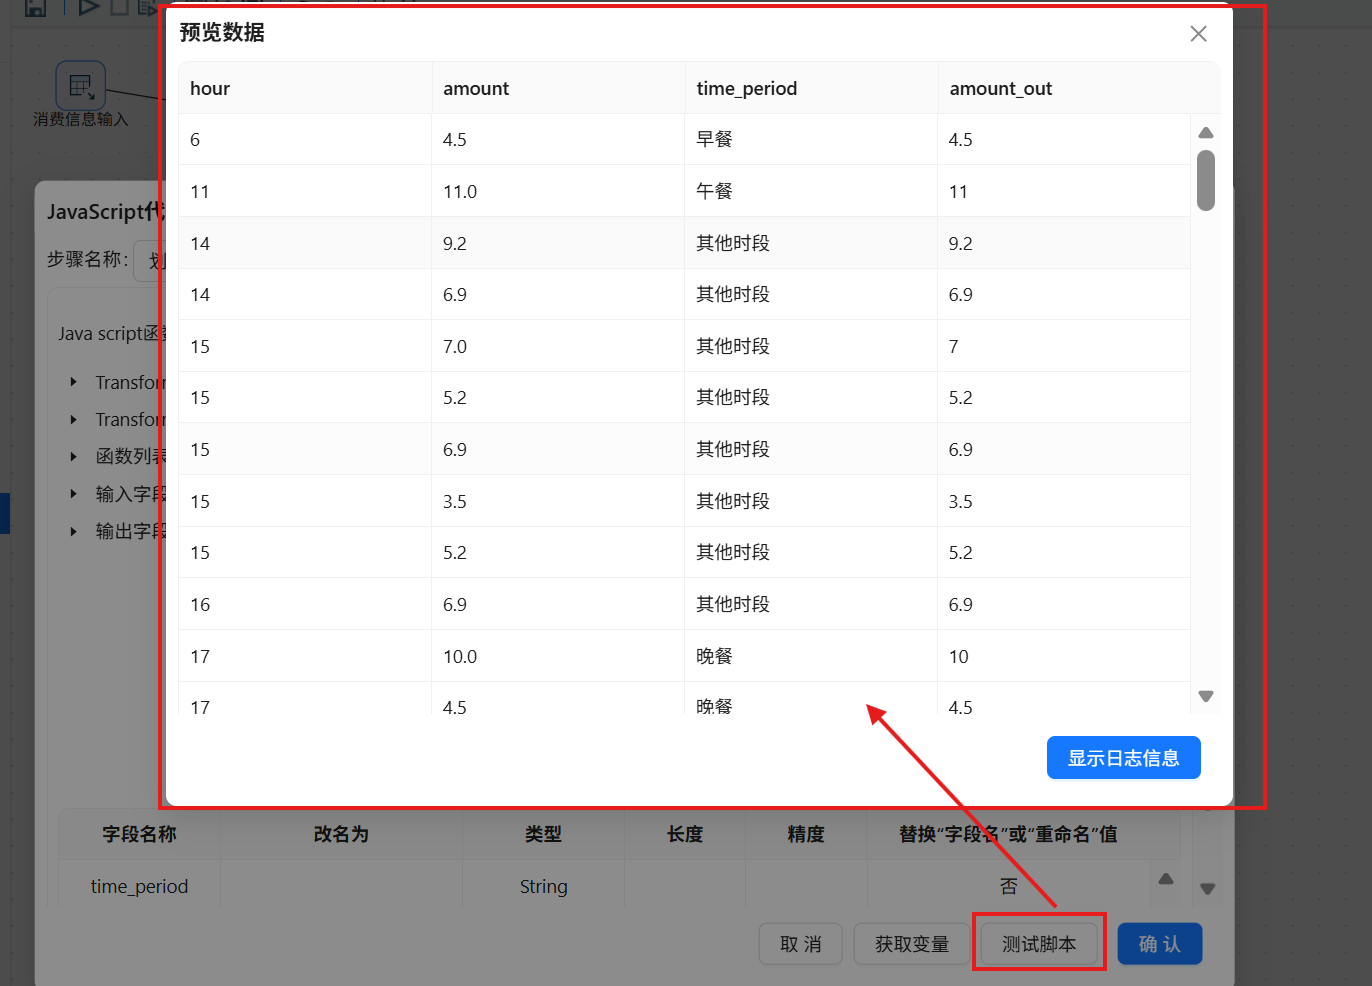
不确定输出数据是否正确时,可以点击 “测试脚本”预览数据和查看日志
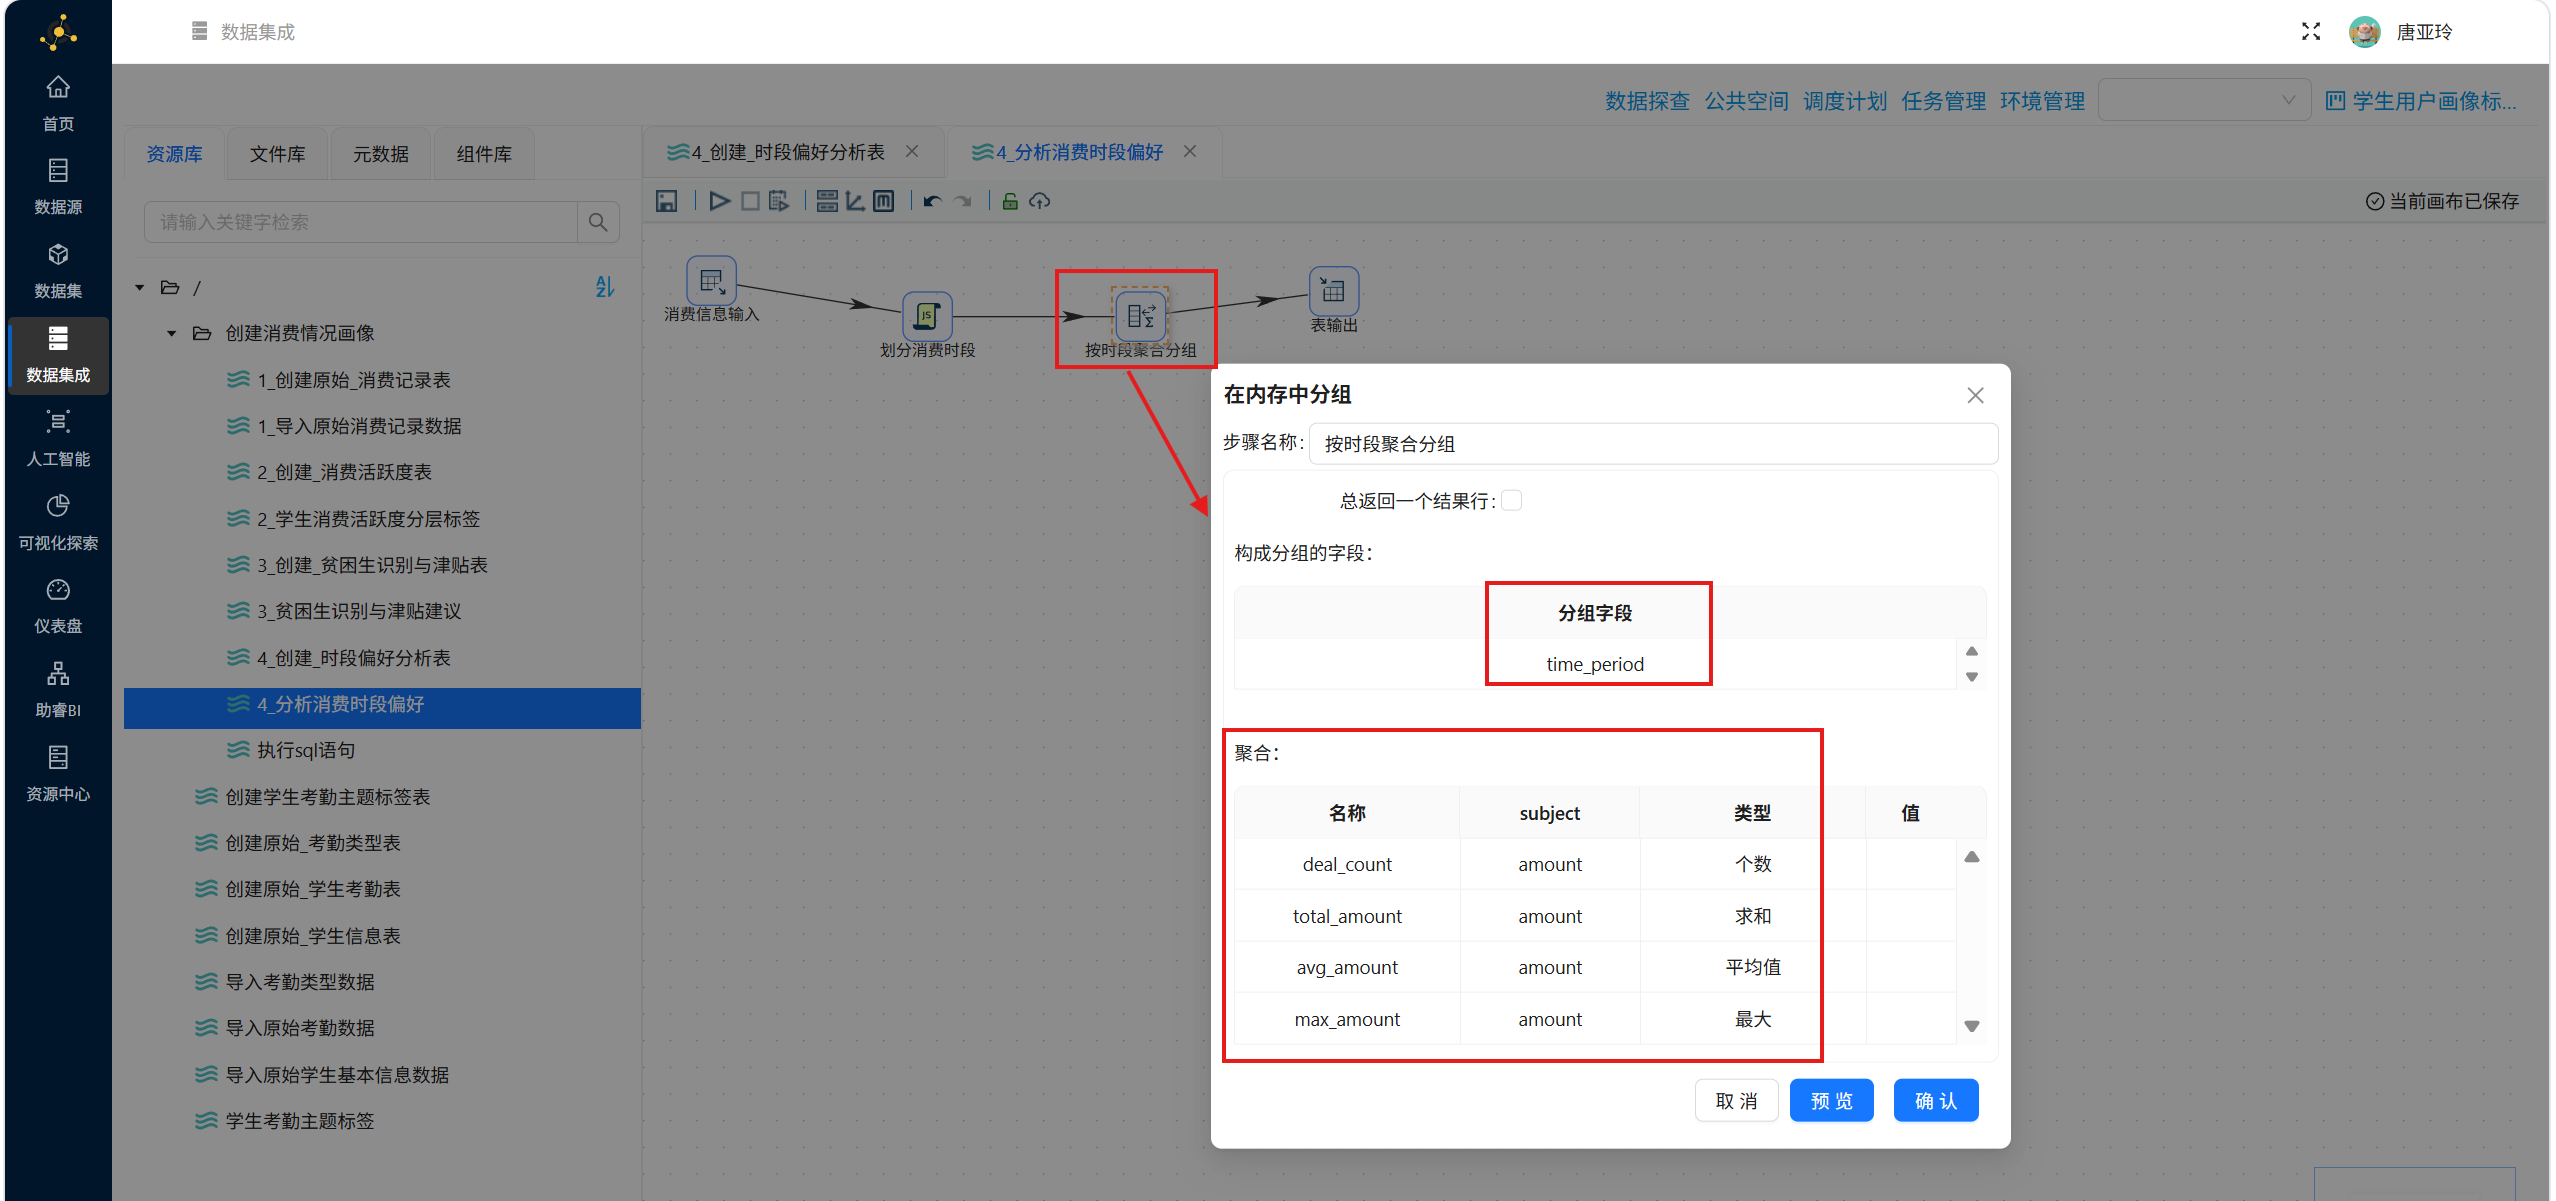
然后配置 “在内存中分组” 组件,选择 “分组字段” 为 time_period,“聚合字段”为所需的聚合类型
注意:在助睿ETL平台中,“分组” 组件只能处理无序数据中一列一列的数据,最多处理连续的2列,要实现全数据的聚合需要先使用 “排序记录”,对数据进行排序后再分组;或改用我们使用的 “在内存中分组”,无需排序,即可实现分组聚合!!!
配置 “表输出” 组件
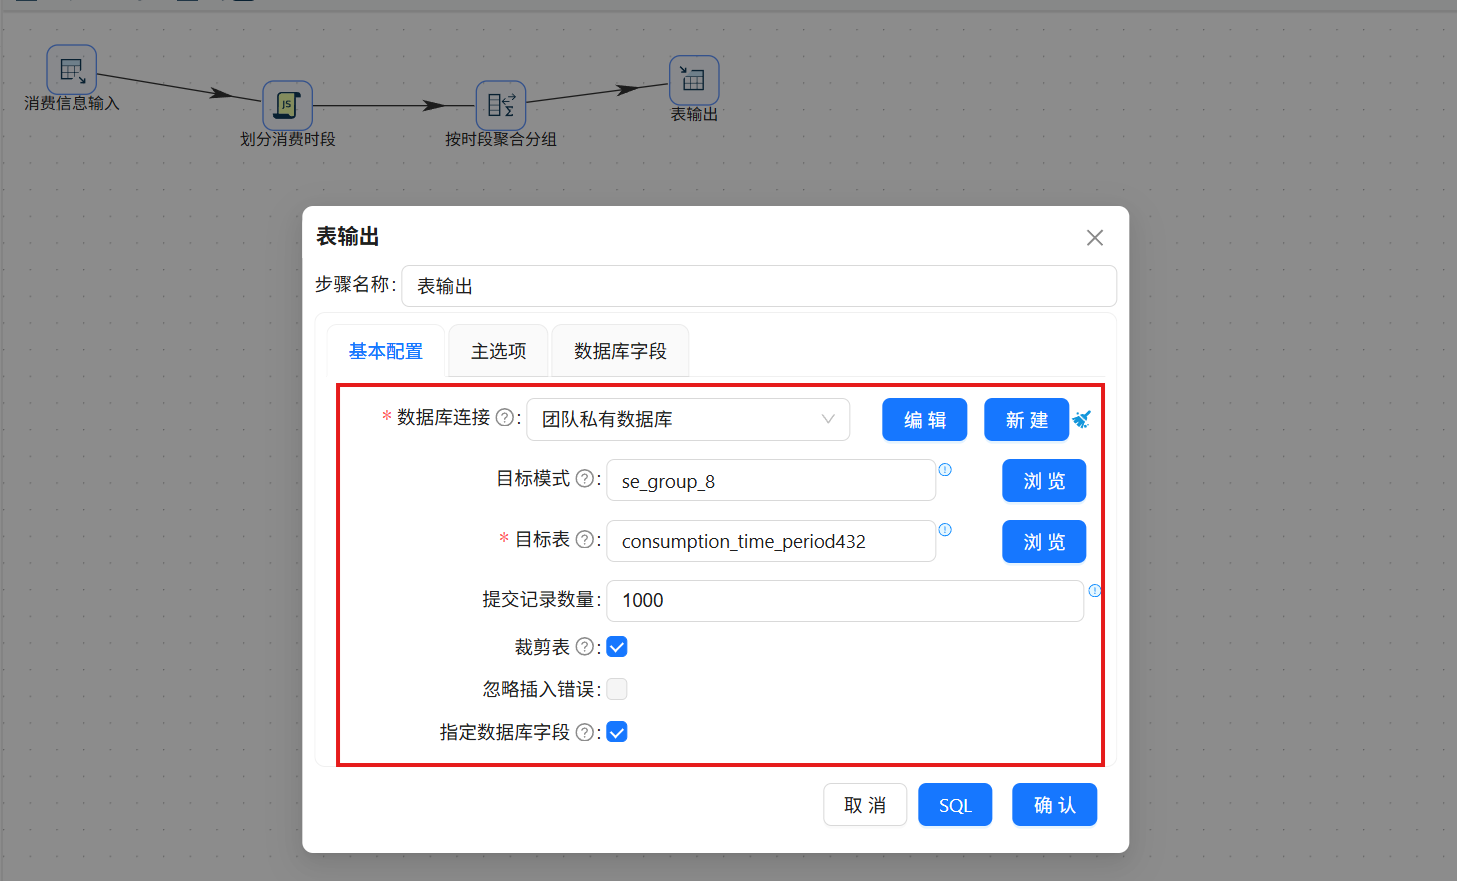
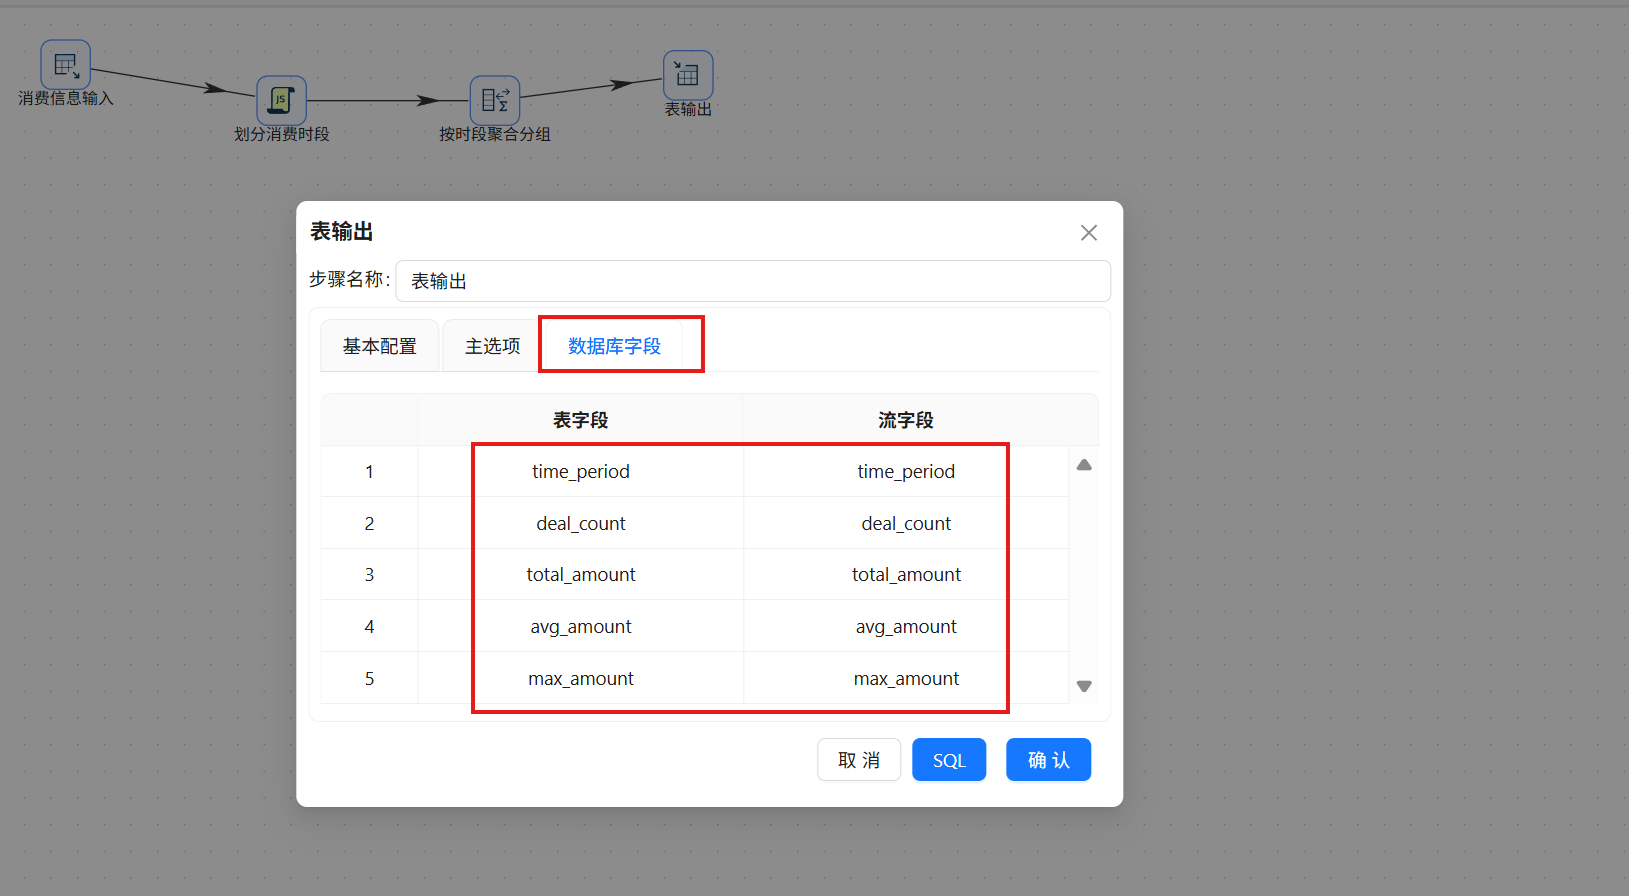
到【数据探查】板块,查看数据
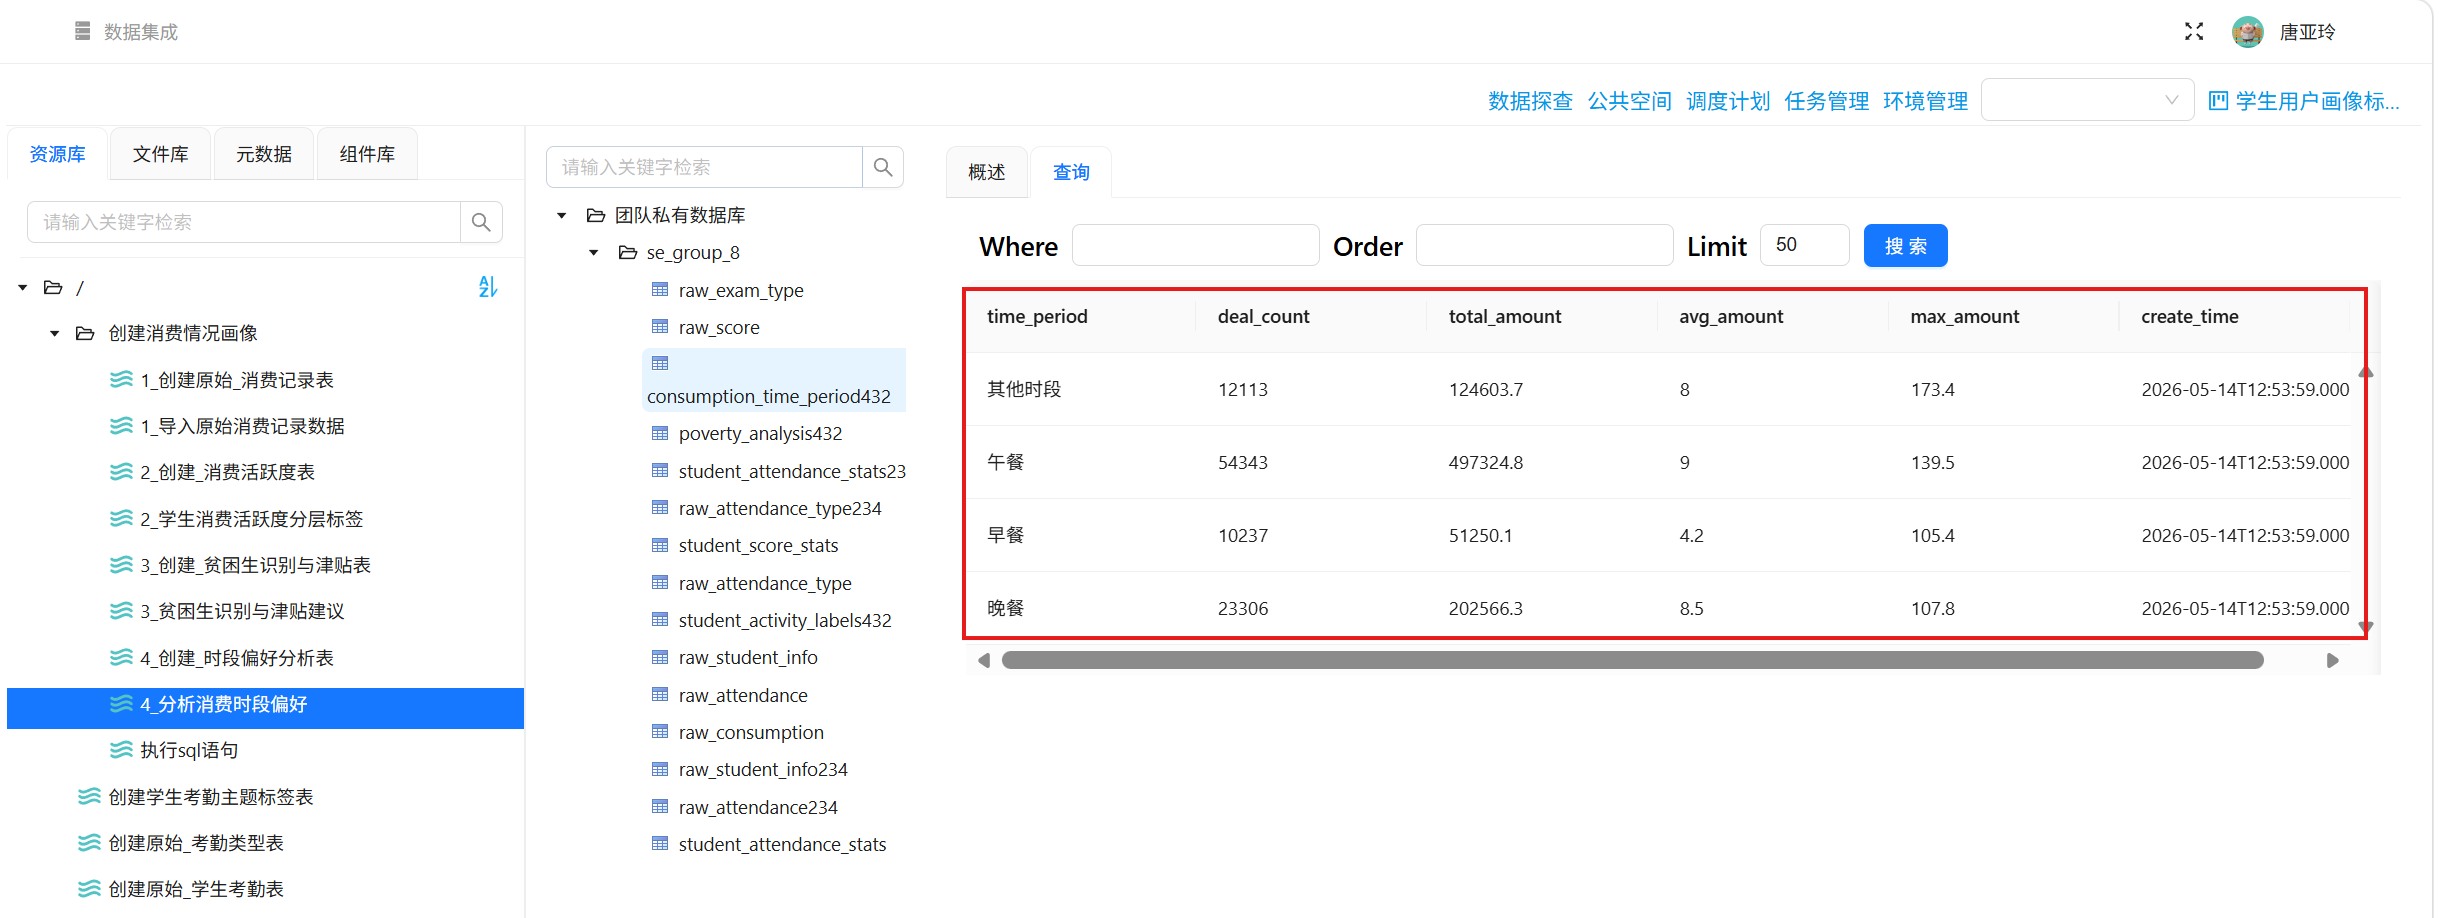
至此,我们就完成了学生画像中的学生消费情况3个板块的标签创建🎇🎇🎇
【拓展分析】
针对我们所获得标签表,可进一步对其进行分析,下边列出的一些可拓展的分析方向给大家作为参考:
一、考勤标签分析
| 分析角度 | 说明 | 所需字段 |
|---|---|---|
| 迟到高发时段 | 早自习/第一节课/下午第一节迟到对比 | 考勤时间、迟到次数 |
| 请假类型分布 | 病假/事假/其他请假类型占比 | 请假类型、请假次数 |
| 异常学生排行 | 迟到/早退次数最多的TOP20学生 | 学生ID、各类异常次数 |
| 班级考勤对比 | 各班级平均迟到率、请假率对比 | 班级ID、班级名称、各类异常次数 |
| 考勤与学期关系 | 开学初/期中/期末考勤变化趋势 | 学期、考勤日期、异常类型 |
| 校服违规高发班级 | 哪些班级校服违规最频繁 | 班级名称、校服违规次数 |
二、消费活跃度分层
| 分析角度 | 说明 | 所需字段 |
|---|---|---|
| 活跃度分布 | 高/中/低/不活跃学生占比 | 活跃度等级、学生ID |
| 各年级活跃度对比 | 高一/高二/高三活跃度差异 | 年级、活跃度等级 |
| 高活跃群体特征 | 高活跃学生的平均消费金额、次数 | 总金额、总次数、活跃度等级 |
| 不活跃群体规模 | 不活跃学生占比及消费特征 | 活跃度等级、总金额、总次数 |
| 活跃度与性别关系 | 男女活跃度差异 | 性别、活跃度等级 |
三、贫困生识别与津贴建议
| 分析角度 | 说明 | 所需字段 |
|---|---|---|
| 贫困等级分布 | 特困/困难/中等偏低/正常占比 | 贫困等级、学生ID |
| 各年级贫困比例 | 高一/高二/高三贫困生分布 | 年级、贫困等级 |
| 津贴总额估算 | 按等级计算所需总津贴金额 | 贫困等级、建议津贴 |
| 重点关注学生 | 消费次数极少+金额极低的学生 | 总消费金额、总次数 |
| 贫困生消费特征 | 月均消费、单笔平均消费等 | 月均消费次数、平均消费金额 |
四、消费时段偏好
| 分析角度 | 说明 | 所需字段 |
|---|---|---|
| 各时段消费占比 | 早/午/晚/夜宵消费次数与金额占比 | 时段、消费次数、消费金额 |
| 高峰期识别 | 哪个时段消费最集中 | 时段、消费次数 |
| 夜宵需求评估 | 夜宵时段消费规模及变化趋势 | 时段、消费金额 |
| 早餐提升空间 | 早餐时段消费占比高/低的原因分析 | 时段、消费次数 |
| 时段与金额关系 | 哪个时段单笔消费最高 | 时段、平均消费金额 |
五、跨板块关联分析
| 分析角度 | 说明 | 涉及板块 |
|---|---|---|
| 消费与考勤关系 | 高消费学生考勤是否更好? | 考勤 + 消费 |
| 贫困生考勤表现 | 贫困生迟到/请假率是否更高? | 考勤 + 贫困生 |
| 活跃度与异常考勤 | 高活跃学生迟到是否更少? | 考勤 + 活跃度 |
| 时段偏好与考勤 | 吃早餐的学生迟到率更低? | 考勤 + 时段偏好 |
=================================================================
第三部分:问题与解决、实验总结
实验过程中,我所遇到的问题大致如下,大家可以参考参考,避免踩坑。
1. 考勤主题标签构建
| 序号 | 问题阶段 | 问题描述 | 原因分析 | 解决方式 |
|---|---|---|---|---|
| 1 | 数据导入 | CSV导入时字段类型转换错误 | leave_school字段为字符串,目标表定义为整数 | 修改字段类型改为String |
| 2 | 数据导入 | 考勤类型表导入失败,提示Unknown column | 表输出步骤字段映射不正确 | 检查并修正字段映射关系 |
| 3 | 数据导入 | CSV文件预览为空或数据错位 | 列分隔符配置错误(误用“\n”充当制表符) | 列分隔符改为点击按钮插入制表符(TAB) |
| 4 | 数据导入 | CSV整行数据被读成一个字段 | 列分隔符未正确设置 | 手动配置字段,不依赖"获取字段"功能 |
| 5 | 数据导入 | 表输出报错"未指定数据库连接" | 表输出步骤数据库连接未选择 | 在表输出配置中选择正确的数据库连接 |
| 6 | Pipeline执行 | 排序步骤大量磁盘溢出日志 | 数据量大,内存不足触发磁盘溢出 | 正常行为,不影响业务逻辑 |
| 7 | 数据关联 | 记录集连接后数据不匹配 | 两张表的连接字段映射错误 | 确保连接字段对应正确(如A→B) |
| 8 | JavaScript脚本 | 标签计算结果全为0 | 记录集连接组件配置错误,导致考勤类型表为空,无法获取考勤名称 | 先成功导入考勤类型数据 |
2. 消费情况画像构建
| 序号 | 组件步骤 | 问题描述 | 原因分析 | 解决方式 |
|---|---|---|---|---|
| 1 | 表输入 | SQL中使用了错误函数名(ABS)mon_deal | 语法错误,函数应写为ABS(mon_deal) | 修改SQL为ABS(mon_deal) AS amount |
| 2 | 表输入 | 时间字段解析结果为NaN | deal_time格式2018/07/01 06:32:5不能被new Date()正确解析 | 改用SQL的HOUR()函数直接提取小时,或手动解析时间字符串 |
| 3 | 分组 | 相同学生ID未能合并聚合 | 助睿ETL中普通“分组”组件只能处理无序数据中一列一列的数据,最多处理连续2列 | 使用“在内存中分组”组件替代普通“分组”组件,无需排序即可实现完整分组聚合 |
| 4 | 分组 | 按时段分组后相同时段有多行(如早餐出现2次) | 使用了普通“分组”组件,无法正确聚合全量数据 | 改用“在内存中分组”组件,确保按time_period正确聚合 |
| 5 | JavaScript | 输出字段在目标表中不存在 | JavaScript输出字段名与建表语句字段名不一致 | 统一字段命名(如monthly_avg或monthly_avg_count) |
| 6 | 表输出 | 写入失败提示Unknown column 'xxx' | 表输出的字段映射不正确,流字段与表字段不匹配 | 删除表输出步骤重新添加,点击“获取字段”重新映射 |
| 7 | 分组 | 分组后数据量异常(96,006条聚合为44,486条而非2条) | 分组字段包含了student_id而非仅gender | 分组字段只保留gender,student_count作为聚合字段 |
| 8 | 表输入 | 预览数据正确但写入后金额仍为负数 | 分组聚合中引用了原始字段而非取绝对值后的字段 | 在SQL中使用ABS(mon_deal),确保聚合使用处理后的字段 |
| 9 | JavaScript | 消费时段判断逻辑不生效 | 时段判断条件中的时间范围有重叠或遗漏 | 检查并修正if条件,确保各时段区间不重叠且覆盖完整 |
| 10 | 表输出 | 连续错误后表输出步骤配置混乱 | 多次修改字段映射导致不一致 | 删除表输出步骤,重新添加并重新配置 |
3.1 实验核心经验总结
3.1.1 数据导入阶段
| 关键点 | 说明 |
|---|---|
| 列分隔符配置 | CSV文件使用制表符分隔时,需点击按钮插入制表符(TAB),不能用\t或\n替代 |
| 字段映射 | 表输出步骤必须检查并修正字段映射关系,确保流字段与表字段对应 |
| 数据库连接 | 每个表输出步骤需单独选择正确的数据库连接 |
| 类型匹配 | 源数据字段类型需与目标表定义一致,否则需修改表结构或转换类型 |
| 手动配置字段 | CSV导入时,不依赖"获取字段"功能,手动配置字段更可靠 |
3.1.2 数据关联与处理阶段
| 关键点 | 说明 |
|---|---|
| 连接字段映射 | 记录集连接时,确保两张表的连接字段对应正确(如A表字段→B表字段) |
| 数据清洗前置 | 在SQL中使用TRIM()去除空格、ABS()取绝对值、HOUR()提取时间,确保数据规范 |
| 金额处理 | 消费金额原始值为负数,需用ABS()取绝对值后再进行聚合计算 |
3.1.3 组件使用阶段
| 关键点 | 说明 |
|---|---|
| 分组组件选择 | 普通“分组”组件只能处理连续2列的无序数据;全量分组聚合应使用“在内存中分组”组件,无需排序即可实现完整聚合 |
| 分组字段配置 | 分组字段只保留需要聚合的维度字段(如gender),计数类指标(如student_count)应作为聚合字段而非分组字段 |
| 时间解析 | 时间格式特殊时(如2018/07/01 06:32:5),改用SQL的HOUR()函数直接提取小时,避免JavaScript解析错误 |
| SQL语法 | 函数使用需正确:ABS(mon_deal)而非(ABS)mon_deal |
3.1.4 JavaScript脚本阶段
| 关键点 | 说明 |
|---|---|
| 输出字段声明 | JavaScript输出字段名需与建表语句字段名完全一致(如monthly_avg与monthly_avg_count不能混用) |
| 字段透传 | 不需要修改的字段直接透传,避免数据丢失 |
| 条件逻辑 | 时段判断等条件需确保各区间不重叠且覆盖完整 |
3.1.5 调试与修复阶段
| 关键点 | 说明 |
|---|---|
| 映射重建 | 表输出字段映射出错时,删除步骤重新添加并点击“获取字段”重新映射最可靠 |
| 分段验证 | 在每个关键步骤(表输入、分组、JavaScript)右键预览,确认数据正确后再继续 |
| 日志定位 | 错误日志中的Unknown column、couldn't be found等提示,直接指明字段名不匹配问题 |
3.1.6 通用原则
| 原则 | 说明 |
|---|---|
| 先清洗后聚合 | 在SQL或JavaScript中完成数据清洗(去空格、取绝对值、提取时间),再进行分组聚合 |
| 命名统一 | 同一字段在所有组件中使用相同命名,避免monthly_avg与monthly_avg_count混用 |
| 组件选型 | 根据数据量和处理需求选择合适组件:全量聚合用“在内存中分组”,有序处理可用普通“分组” |
| 配置一致 | 表输出步骤的字段映射需与目标表结构完全一致,不一致时删除重建 |
3.2 实验总结与平台评价
1)通过本次实验,我们加深了助睿ETL平台的基本操作方法,具体包括:
-
基础操作:创建团队、创建项目、同步数据源、新建转换流、添加和配置组件、构建完整的转换流程图、执行转换及查看结果。
-
核心组件掌握:掌握了表输入、CSV文件输入、记录集连接、字段选择、排序记录、分组聚合、JavaScript脚本、表输出等组件的配置方法。
-
数据处理能力:理解了数据处理在实际业务场景下的应用,以及如何通过构建转换流实现数据处理需求。本次实验中,我们用到了以下关键技术:
多表连接:通过左外连接将考勤记录表与考勤类型表关联,获取考勤名称
-
条件判断:使用JavaScript组件提取迟到、早退、请假、校服违规等异常考勤记录分组聚合:按学生ID统计各类异常次数
-
数据清洗:通过字段选择去除冗余字段,通过替换NULL值处理空数据
2)相较于传统的编写SQL脚本实现数据处理,助睿平台的零代码操作界面具有以下优势:
-
清晰直观:整体数据流向以及实现步骤都非常直观,通过拖拽组件和连线即可构建完整的数据处理流程。
-
便于调试:可以快速定位问题步骤,通过查看日志和中间结果进行分段调试。
-
组件丰富:内置了排序、连接、分组、脚本等多种处理组件,满足复杂的数据处理需求。
-
降低门槛:图形化界面降低了数据开发的学习成本,使业务人员也能参与数据处理流程的构建。
当然,平台也存在一些可以改进的地方,例如CSV文件预览功能在特定情况下不太稳定、组件使用差异没有明显提示、转换流保存后仍会出现被清空的现象等。但整体而言,助睿ETL平台是一款高效、易用的数据集成工具,能够有效支撑数据清洗、转换和加载等ETL任务。

AtomGit 是由开放原子开源基金会联合 CSDN 等生态伙伴共同推出的新一代开源与人工智能协作平台。平台坚持“开放、中立、公益”的理念,把代码托管、模型共享、数据集托管、智能体开发体验和算力服务整合在一起,为开发者提供从开发、训练到部署的一站式体验。
更多推荐


 40
 0
- 0


 已为社区贡献3条内容

所有评论(0)