【学习手札】如何使用 ChatOpenai 接口显示输出第三方模型思考过程?reasoning_content不管用了?跳脱于第三方兼容包的解决思路“response-api“ 探索向
前言
最近用 langchain 接入模型的经历真的把我搞得火冒三丈,逼得我放 DeepSeek 老祖出山,结果也是大败而归,只好慢慢查文档,徐徐图之...
前言到此为止,本篇文章重点在于分享我的探索经历、解决方案、以及好好的辱骂一下这该死的东西以泄心中之愤。想知道解决方案的直接跳到文末总结部分即可。
目录
起因
起因很简单
我在更新某个 RAG 项目时,想要做到流式输出思考过程。作为穷人,我最爱使用的是api接口是阿里云百炼平台的(免费额度给的多),那么很自然,我使用的大模型就是通义千问系列了。但实际使用中遇到了诸多问题,如 openai 接口的 “reasoning_content” 字段被官方剔除了、通义社区 langchain 兼容包接入模型有限制等,因此有了这篇文章。
问:为什么我不使用chatTongyi?
答:官方接口未更新
from langchain_community.chat_models.tongyi import ChatTongyi既然社区有提供 ChatTongyi 的库,为什么不用这个呢?其实我原本使用的也是ChatTongyi,并且ChatOpenai官方也明确提到了,他们也推荐使用适配的接口。但是,ChatTongyi 有一个巨大的问题!它的接口做的并不完善,当你使用这个接口去调用一些最新的大模型 (如qwen3.5系列、qwen3.6系列)时会报错警告。
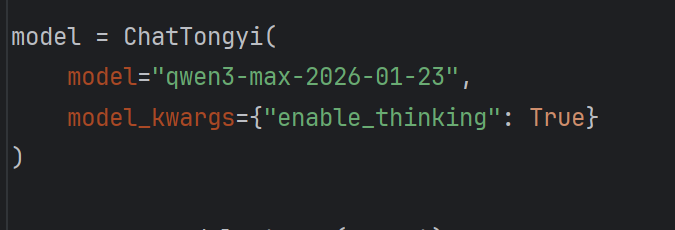
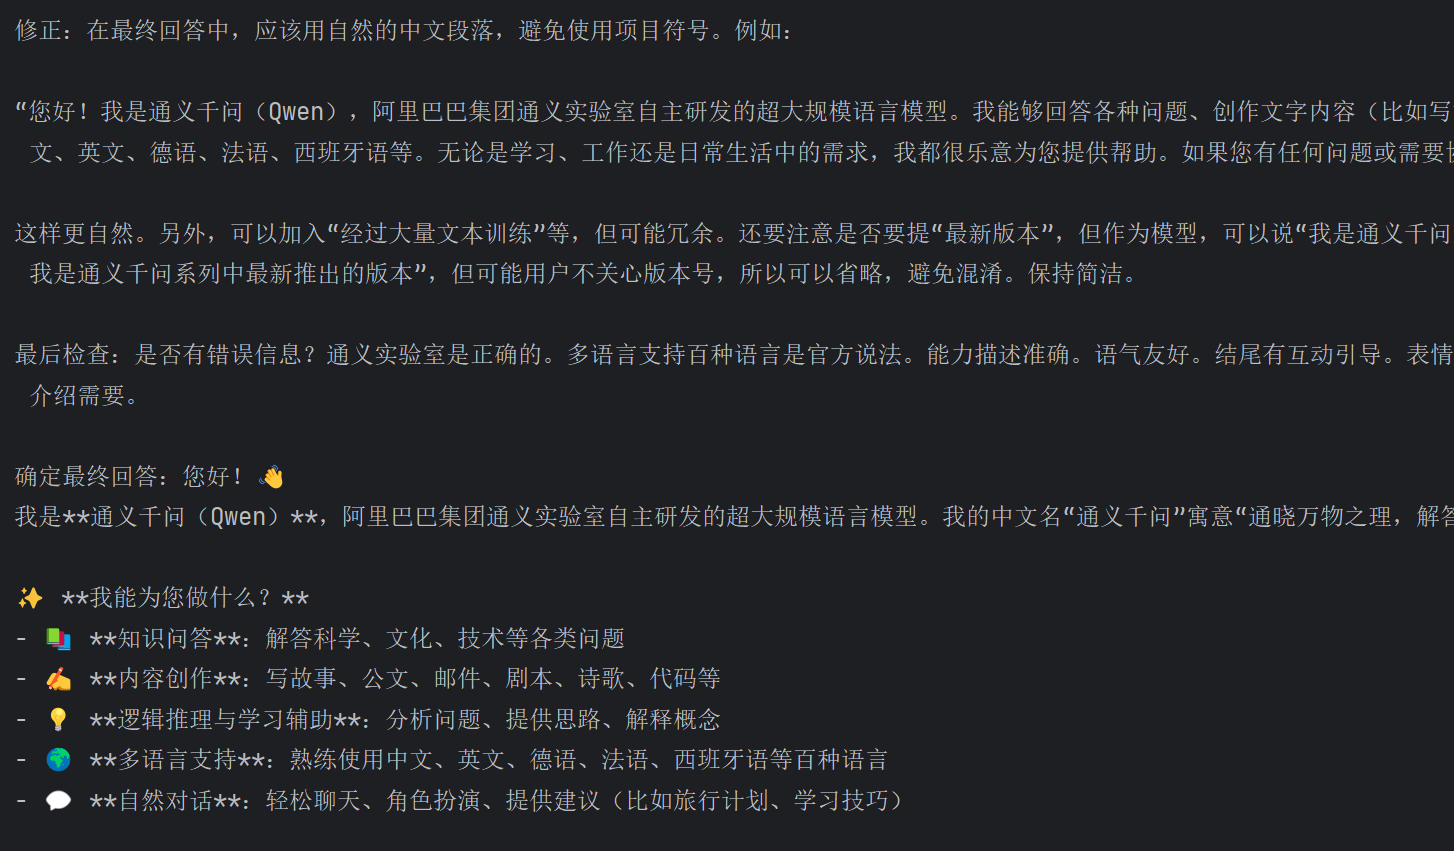
我们可以看到,当我们选择的模型为 "qwen3-max-2026-01-23" 这个纯文本模型时,能够正常输出内容,且可以看到思考过程
但如果我们想使用最新的模型,(如 "qwen3.5系列")就会报错 "400" 显示当前模型接口不匹配 (官方文档:https://help.aliyun.com/zh/model-studio/error-code#error-url)(三个图分别为模型参数、报错信息、官方文档解释)
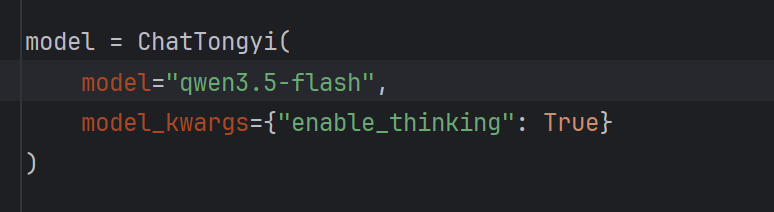
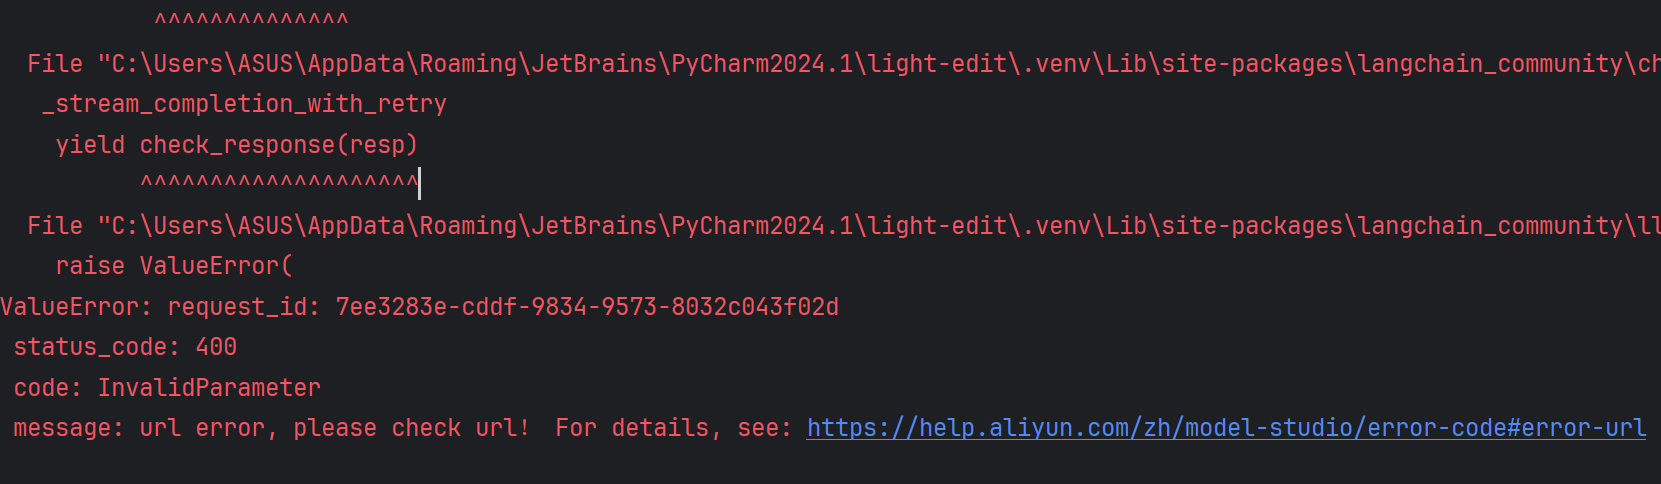
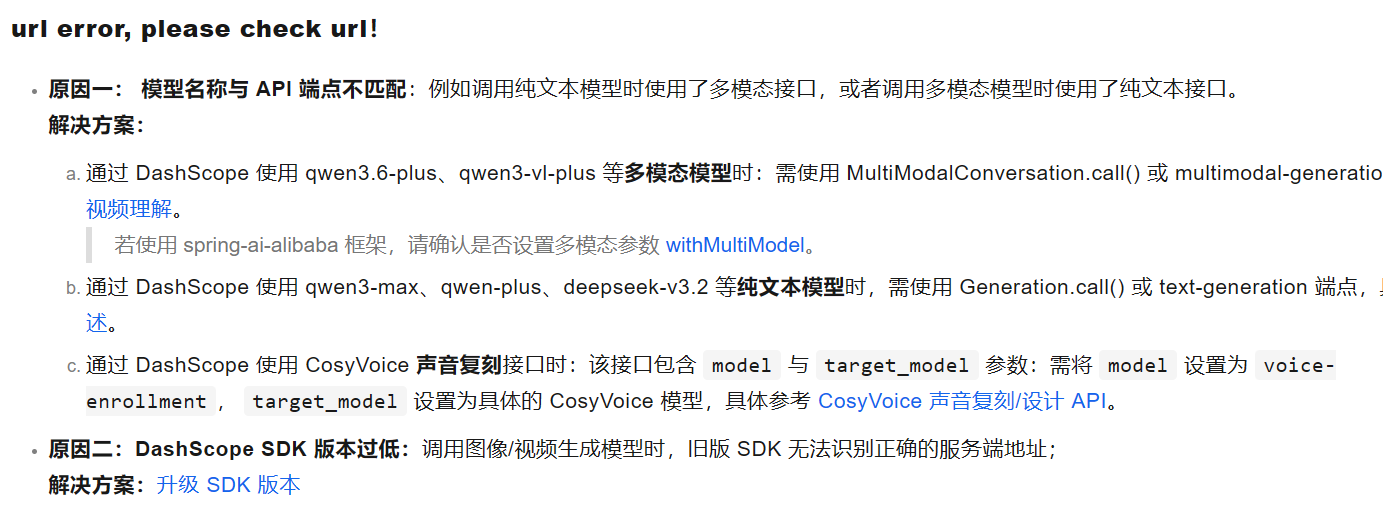
解释 & 解决方案
对比我们发现,纯文本模型时,正常输出;多模态模型时,报错警告;因此判断,ChatTongyi 的接口使用的是大语言模型的,无法使用多模态大模型。因此,如果我们想要使用qwen 模型有三种途径。
1、使用阿里云官方提供的SDK
2、使用 Openai 的兼容接口
3、使用langchain-qwq 第三方的 Chatopenai 扩展包(后续调查才发现的)
但我对第一种方案并不太了解,并且实际使用中,Openai接口我使用的更多一些,第三种方案则是每用一个厂家的模型就得学一个新包,时间成本颇高,因此我使用了第二种,openai 一招鲜吃遍天。
ChatOpenai 的使用
问题出现
from langchain_openai.chat_models import ChatOpenAI

model = ChatOpenAI(
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
    model="qwen3.6-plus-2026-04-02",
    extra_body={
            "enable_thinking": True,
            "return_reasoning": True,
            },
    streaming=True,
)
response = model.stream("你好,自我介绍一下, 请全程使用中文思考")

for chunk in response:
    print(chunk)
相信不少人(包括我自己)之前的写法都是这样的,通过 extra_body 提取思考链,进行思考过程显示输出,但我们可以在 chunk 的打印结果中看到这种情况(如图)。
原本我们是可以在 additional_kwargs 中拿到思考文本的,而 content 属性包含的则是正式输出的文本,但在这里,我们无法在 additional_kwargs 中拿到任何值!
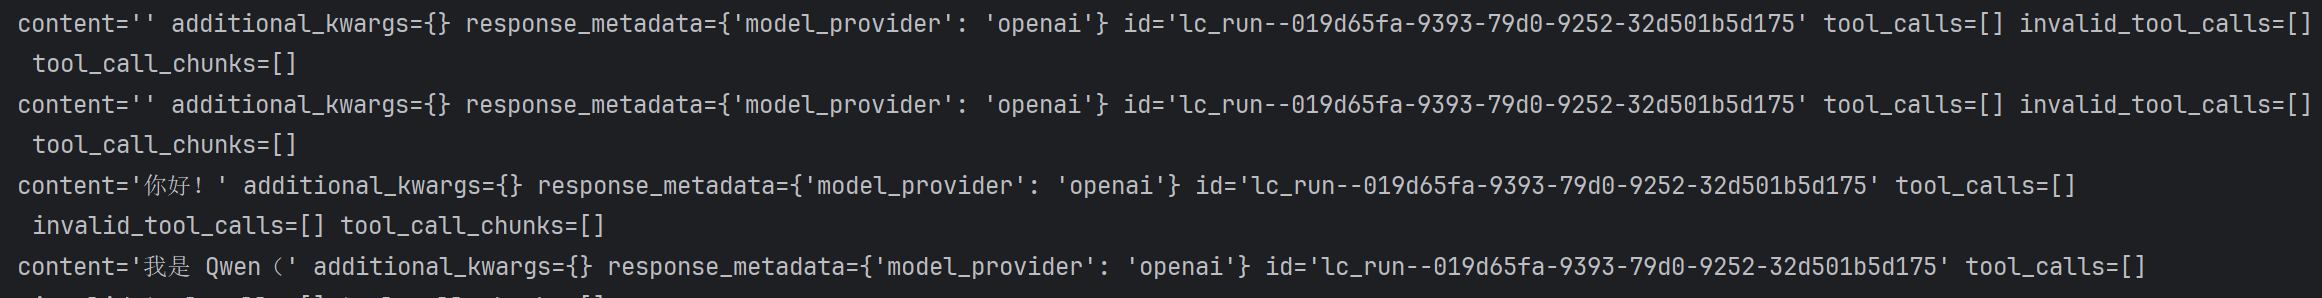
原因解析
这是因为官方在某次后续更新中认为返回 reasoning_content 过于笨重,因为他们不可能兼容所有的第三方包,因此丢掉了这个键。(真正笨蛋的是,我当时完全忽略了他提到的使用langchain-qwq 这个方法....不过也正因如此,我发现了response-api的妙用)
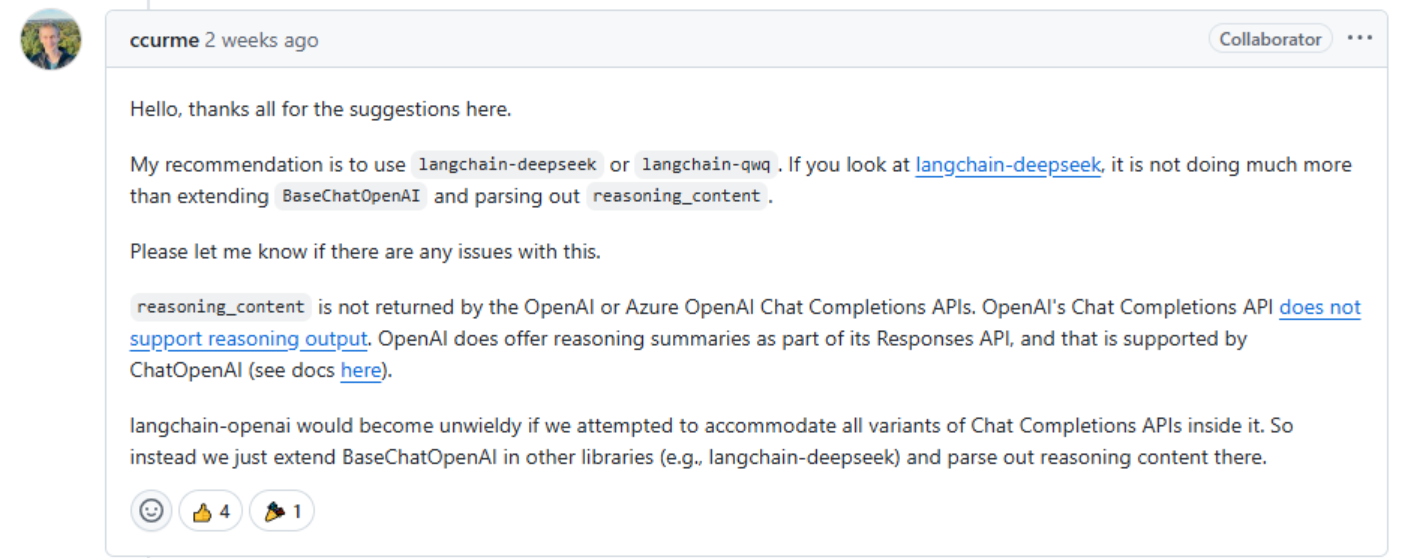
找寻答案
为了找到解决方案,我前往官方文档查询进行分析(下面是url)。ChatOpenAI | langchain_openai | LangChain Reference https://reference.langchain.com/python/langchain-openai/chat_models/base/ChatOpenAI 我注意到官方提供的推理模式输出的是思考总结,而非真正的思考显示输出。
# 摘自官方文档
# Reasoning output
# OpenAI's Responses API supports reasoning models that expose a summary of internal reasoning processes.

from langchain_openai import ChatOpenAI

reasoning = {
    "effort": "medium",  # 'low', 'medium', or 'high'
    "summary": "auto",  # 'detailed', 'auto', or None
}

model = ChatOpenAI(
    model="...", reasoning=reasoning, output_version="responses/v1"
)
response = model.invoke("What is 3^3?")

# Response text
print(f"Output: {response.text}")

# Reasoning summaries
for block in response.content:
    if block["type"] == "reasoning":
        for summary in block["summary"]:
            print(summary["text"])
对代码进行分析,我们可以发现这串代码相较于我们,最关键的不同在于 ChatOpenai 对象创建时新增了两个参数 reasoning 以及 output_version。
对于参数 reasoning 我在尝试去除之后发现,这对于模型输出基本没有影响,因此这个参数应该是当你使用了openai 的官方的大模型(ChatGpt)时,控制其思考程度的参数,因此这里直接忽视即可。
真正有趣的是 output_version ,虽然官方文档对于这个参数并没有太多提及,但他们其实在代码注释中对这个关键参数做了解释
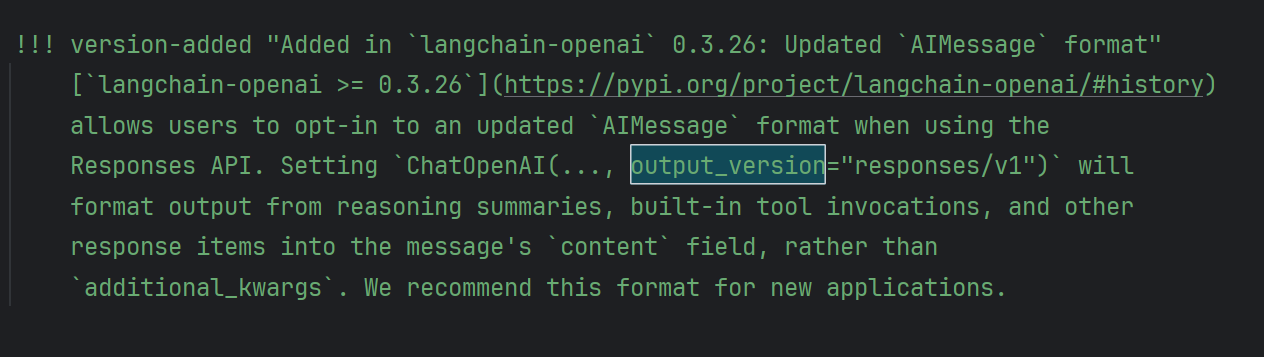
【中文翻译】
!!! 版本新增 "在 langchain-openai 0.3.26 中添加:
更新了 AIMessage 格式"
https://pypi.org/project/langchain-openai/#history
允许用户在使用 Responses API 时,选择采用更新的 AIMessage 格式。
设置 ChatOpenAI(..., output_version="responses/v1") 后,推理摘要、内置工具调用
以及其他响应项的输出将被格式化到消息的 content 字段中,
而不是 additional_kwargs 里。
我们建议新应用采用此格式。
也就是说,官方其实已经不推荐我们使用 reasoning_content 字段进行获取文本了,而是推荐我们使用 output_version 这个新参数来获取显示输出的思考文本
解决方法
因此答案就显而易见了,我们只要使用 output_version 这个参数就能做到获取完整的思考链和文本输出了。
下面附上完整输出代码
from langchain_openai import ChatOpenAI

model = ChatOpenAI(
    model="qwen3.5-plus",
    output_version="responses/v1",
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1"
)

response = model.stream("你好")

for chunk in response:
    # """这里双层循环而不能直接索引是因为流式输出需要等待服务器将结果放进列表之中"""
    for content in chunk.content:
        res_type = content["type"]

        if res_type == "reasoning":
            for i in content["summary"]:
                print(i["text"], end="", flush=True)

        if res_type == "text":
            print(content["text"], end='', flush=True)
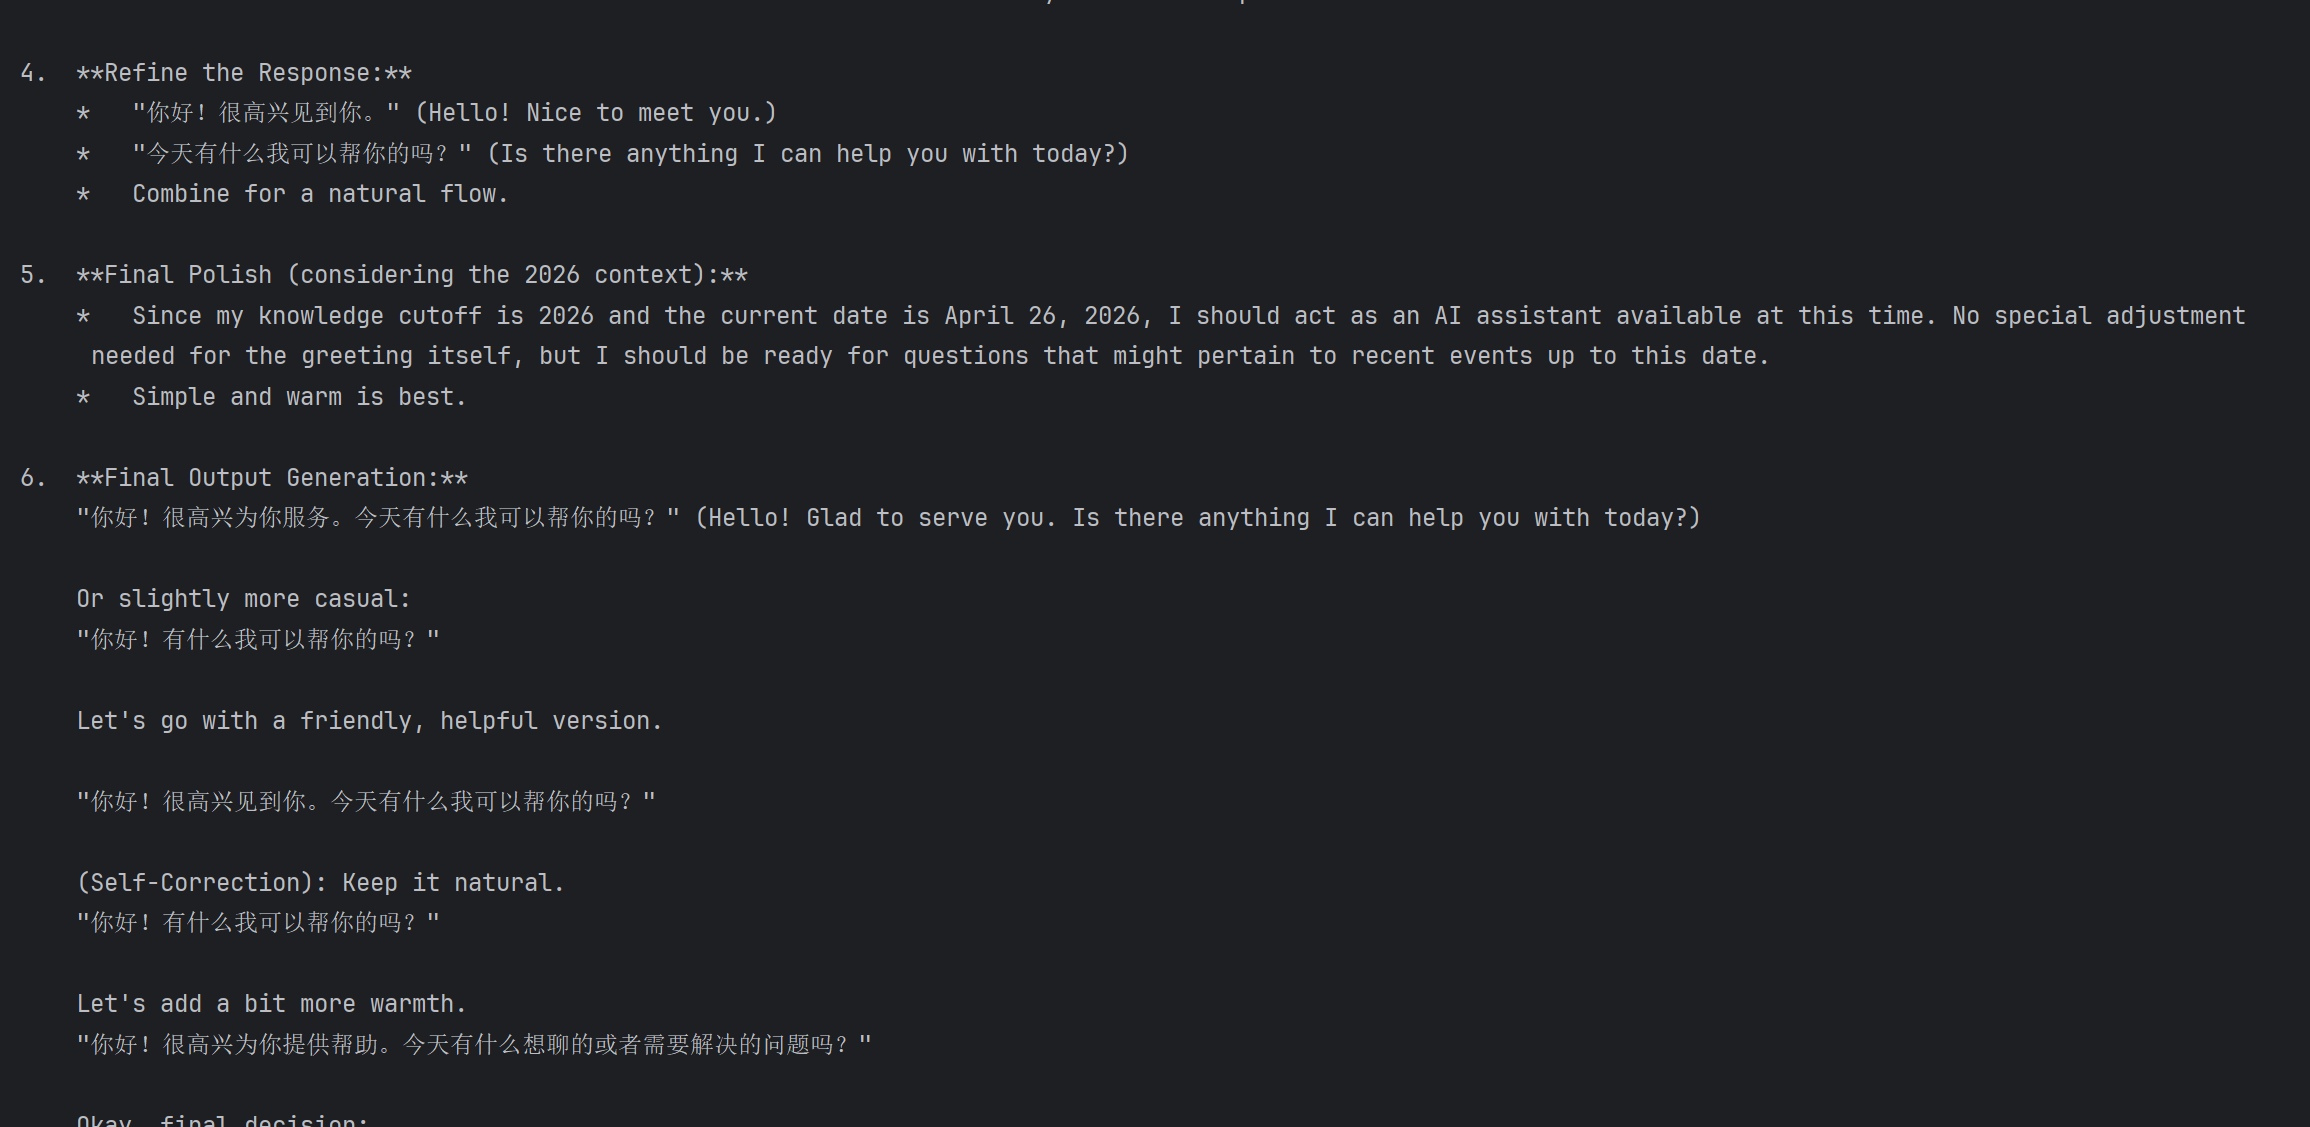
效果展示
总结
三种可以做到显示输出的方法以及存在问题
1. langchain_tongyi 包
存在问题:使用模型限制极大,文本模型与多模态模型接口是分离的,无法混合使用
2. langchain-qwq
存在问题:学习成本高,同时使用多个厂家的大模型时会使代码很混乱
3. Openai
存在问题:reasoning_content 字段无法获取 ---------本文已解决
解决方案
创建模型时显示指定参数 output_version="responses/v1" 并对文本文段进行解析
代码实现
from langchain_openai import ChatOpenAI

model = ChatOpenAI(
    model="qwen3.5-plus",
    output_version="responses/v1",
    base_url="https://dashscope.aliyuncs.com/compatible-mode/v1"
)

response = model.stream("你好")

for chunk in response:
    # """这里双层循环而不能直接索引是因为流式输出需要等待服务器将结果放进列表之中"""
    for content in chunk.content:
        res_type = content["type"]

        if res_type == "reasoning":
            for i in content["summary"]:
                print(i["text"], end="", flush=True)

        if res_type == "text":
            print(content["text"], end='', flush=True)
结语
如果本文能够帮到你,这是我的荣幸,谢谢观看!
如果喜欢,谢谢收藏和点赞。

AtomGit 是由开放原子开源基金会联合 CSDN 等生态伙伴共同推出的新一代开源与人工智能协作平台。平台坚持“开放、中立、公益”的理念,把代码托管、模型共享、数据集托管、智能体开发体验和算力服务整合在一起,为开发者提供从开发、训练到部署的一站式体验。
更多推荐



 16
 0
- 0


 已为社区贡献3条内容

所有评论(0)