【大模型基础|微调实战03】—— ms-swift-3.12-Megatron-SWIFT命令行参数(训练、推理、对齐、量化、部署全参数)
ms-swift 3.12 命令行参数全解:训练、推理、对齐、量化、部署
ms-swift 的参数文档有几百条,全看一遍不现实,随手抄一份别人博客里的命令又容易踩版本坑——同一个参数在 3.12 和 4.x 里可能根本不是一回事。
这篇文章解决一件事:把 3.12 真正会用到的参数按用途分类讲清楚,默认值以官方文档为准。覆盖参数的四层结构、传参格式、六大模块的核心参数、Megatron-SWIFT 专有参数,以及高频报错。
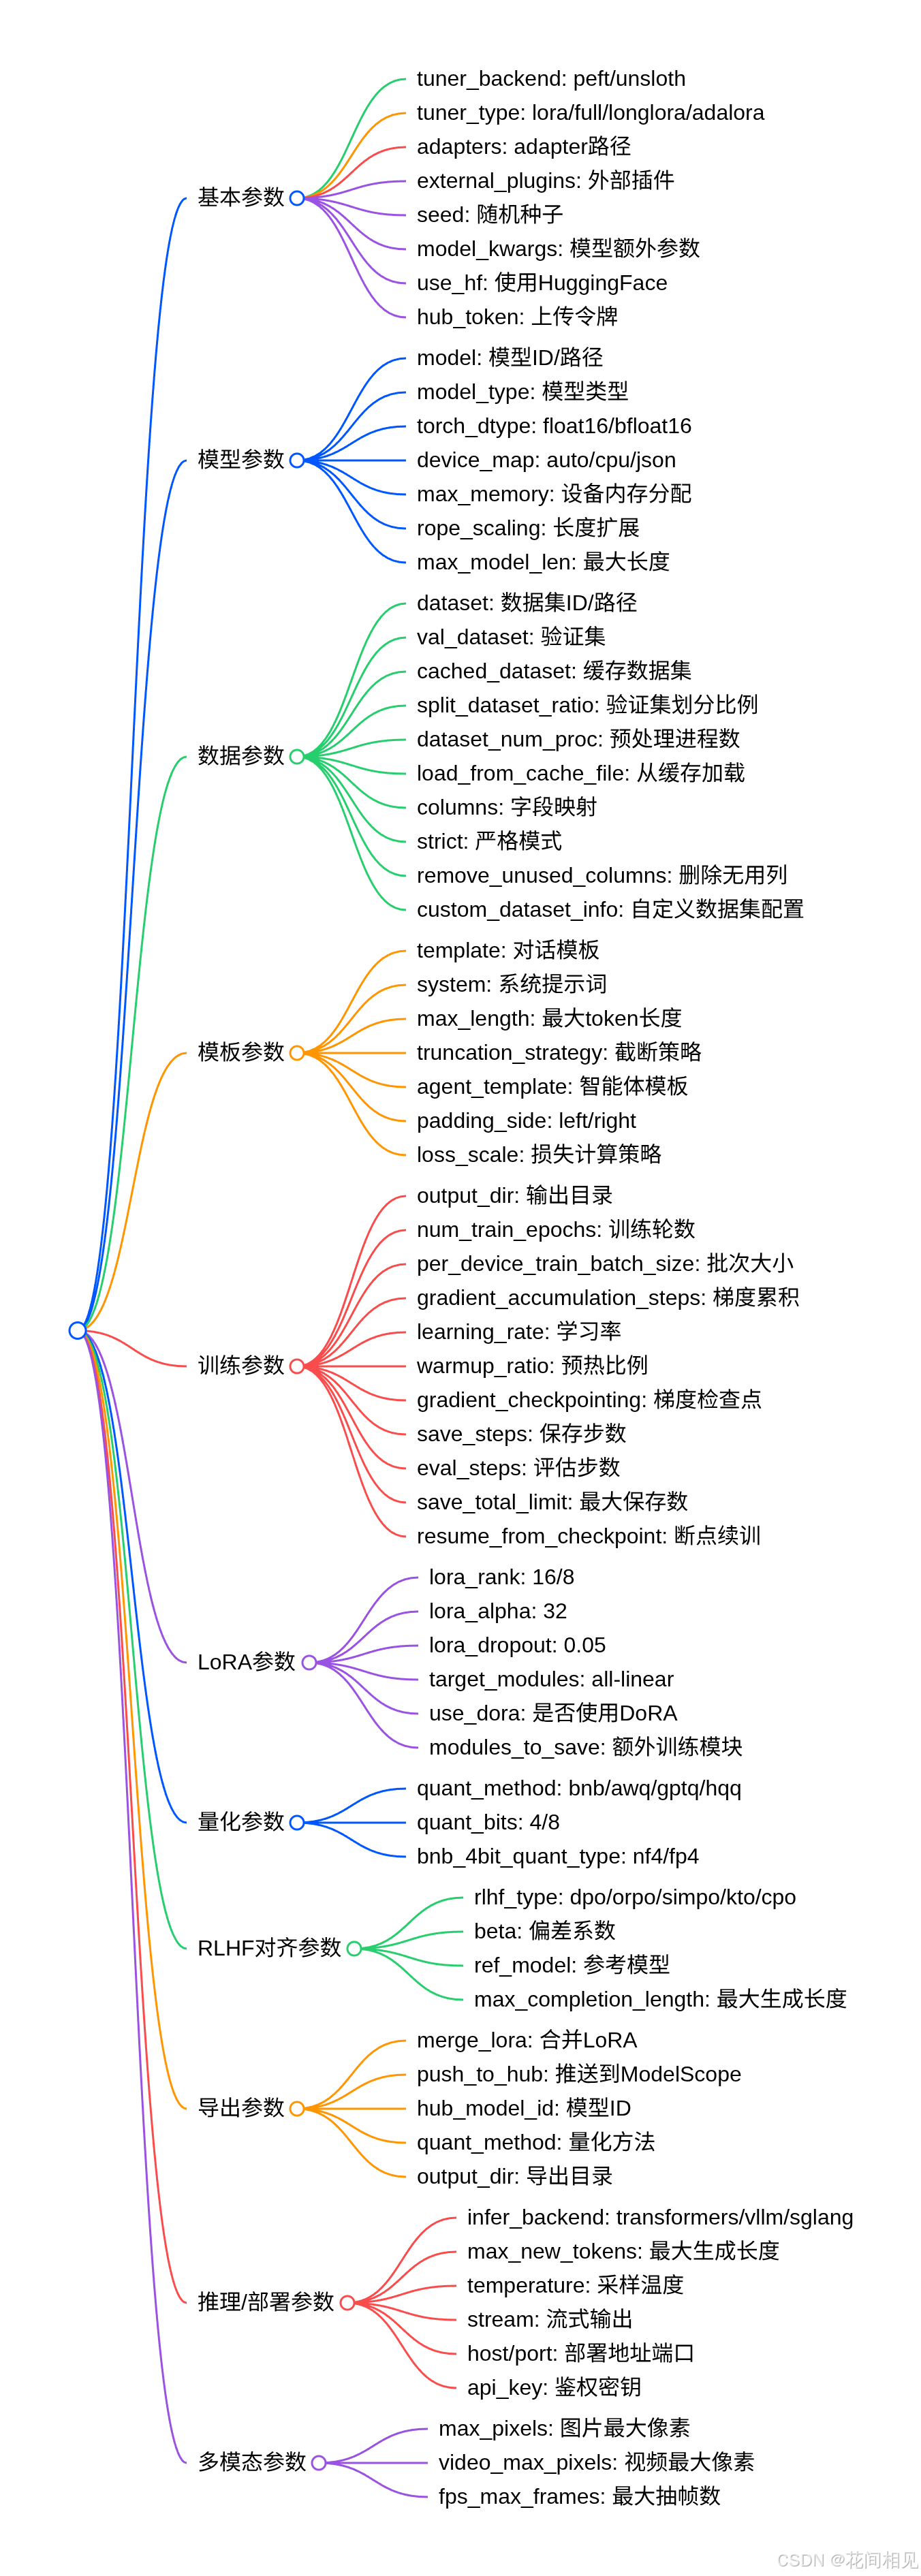
一、先厘清:参数的四层结构
官方把命令行参数分成四类:
| 层级 | 说明 | 你要不要管 |
|---|---|---|
| 基本参数(Base) | 通用能力,如 train_type、seed | ✅ 常用 |
| 原子参数(Atomic) | 训练器底层细项 | ⚠️ 少数场景才动 |
| 集成参数(Integrated) | 继承上面两类,命令行最终生效的就是它 | ✅ 主力 |
| 特定模型参数(Model-specific) | 按模型定制,走 --model_kwargs | ⚠️ 多模态/特殊模型才用 |
🔴 重点:命令行实际生效的是「集成参数」,它是基本参数和原子参数的并集。所以查参数时以集成参数文档为准,看别处的旧文档容易对不上。
另外记住标记规则:带 🔥 的是官方标注的重要参数,新手优先掌握这些。
二、传参格式
三种传参风格,弄混了就会报解析错误。
# list:空格分隔(多数据集、多路径)
--dataset data1 data2 data3

# dict:JSON 字符串(模型额外配置)
--model_kwargs '{"fps_max_frames": 12}'

# bool:小写 true / false
--gradient_checkpointing true
⚠️ 注意:布尔值必须写小写 true / false,写成 True / False 会解析失败。JSON 字符串要用单引号把整个字典包起来,里面用双引号。
三、核心参数速查
下面每张表的「默认值」栏均以 ms-swift 3.12 官方文档为准。默认值这东西最容易以讹传讹,照抄前先核对。
3.1 基本参数
| 参数 | 说明 | 3.12 默认值 |
|---|---|---|
train_type | 微调类型 | lora |
tuner_backend | 微调后端 | peft(可选 peft / unsloth) |
adapters | adapter 权重路径列表 | [] |
model | 模型 ID 或本地路径 | 必填 |
model_type | 模型类型 | None(按 --model 与 config.json 自动推断) |
use_hf | 用 HuggingFace 还是 ModelScope | False(即默认 ModelScope) |
seed | 全局随机种子 | 42 |
external_plugins | 外置插件 .py 列表 | [] |
model_kwargs | 模型特定参数(JSON) | None |
⚠️ 注意:3.12 用的是 train_type,不是 tuner_type。tuner_type 是 4.x 分支的参数名,在 3.12 的参数表里不存在(我核查过官方 3.12 文档,全文检索 tuner_type 零命中)。这两个版本哪个用哪个,很容易记反。
tuner_backend 的可选值只有 peft 和 unsloth 两个。
3.2 模型参数
| 参数 | 说明 | 3.12 默认值 |
|---|---|---|
torch_dtype | 权重数据类型 | None(读 config.json;可选 float16 / bfloat16 / float32) |
device_map | 设备分配 | None(按可用设备与分布式配置自动决定) |
attn_impl | 注意力实现 | None(读 config.json;可选 sdpa / eager / flash_attn / flash_attention_2 / flash_attention_3) |
max_model_len | 模型最大长度 | None |
rope_scaling | 长度外推策略 | None(可传 linear / dynamic / yarn,或直接传 JSON) |
rope_scaling 的用法值得单独说:传字符串(如 'yarn')时,Swift 会结合 max_model_len 自动算出缩放因子;传 JSON(如 '{"factor": 2.0, "type": "yarn"}')时,直接替换 config.json 里的 rope_scaling。
3.3 数据参数
| 参数 | 说明 | 3.12 默认值 |
|---|---|---|
dataset | 训练数据 | [] |
val_dataset | 验证数据 | [] |
custom_dataset_info | 外接数据集注册文件 | [] |
columns | 字段映射 | None |
split_dataset_ratio | 从训练集切验证集的比例 | 0.(不切分) |
dataset_num_proc | 预处理进程数 | 1 |
strict | 遇到坏样本是否报错 | False(静默丢弃) |
packing | 样本打包 | False |
padding_free | 免 padding | False |
⚠️ 注意:参数名是 --custom_dataset_info,不是 --dataset_info。
🔴 重点:split_dataset_ratio 默认是 0.,也就是默认不切分验证集。很多人以为它会自动按 5% 切,结果训练日志里根本没有验证指标。要验证集,要么显式设置这个比例,要么用 --val_dataset 指定。
3.4 模板参数
| 参数 | 说明 | 3.12 默认值 |
|---|---|---|
template | 对话模板 | None(按模型自动选择) |
system | 系统提示词(字符串或 .txt 路径) | None(用模板的 default_system) |
max_length | 单样本最大 token 数 | None(取模型最大支持长度) |
truncation_strategy | 超长处理 | delete(可选 delete / left / right / split) |
loss_scale | 损失计算范围 | default |
loss_scale 的可选值比想象中多:基础策略有 default、last_round、all,另有 ignore_empty_think 和 Agent 相关的 react / hermes / qwen 等,且支持组合,例如 'default+ignore_empty_think'。
⚠️ 注意:数据内的 system 字段优先级高于命令行 --system。命令行传了却没生效,先看看数据里是不是已经写了 system。
3.5 训练参数
| 参数 | 说明 | 3.12 默认值 |
|---|---|---|
output_dir | 输出目录 | —— 建议显式指定 |
num_train_epochs | 训练轮数 | 3 |
per_device_train_batch_size | 单卡 batch | 1 |
gradient_accumulation_steps | 梯度累积 | —— |
learning_rate | 学习率 | 全参 1e-5,LoRA 等 tuner 为 1e-4 |
warmup_ratio | 预热比例 | 0 |
gradient_checkpointing | 梯度检查点 | True(默认已开启) |
save_steps | 保存间隔 | 500 |
eval_steps | 评估间隔 | None(有验证集时跟随 save_steps) |
save_total_limit | 最多保留 checkpoint 数 | None(全部保留) |
这几个默认值值得划重点,它们和很多教程里写的都不一样:
learning_rate按微调方式分档:全参1e-5、LoRA1e-4,不是统一值。warmup_ratio默认是0,不是常见的 0.05。gradient_checkpointing默认True,省显存但会拖慢训练。想换速度可以显式设false。save_total_limit默认不限制,长时间训练会把磁盘塞满,建议显式设成 2~3。
3.6 LoRA 参数
| 参数 | 说明 | 3.12 默认值 |
|---|---|---|
lora_rank | 低秩矩阵的秩 | 8 |
lora_alpha | 缩放系数 | 32 |
lora_dropout | dropout | 0.05 |
target_modules | 目标模块 | ['all-linear'] |
use_dora | 是否启用 DoRA | False |
⚠️ 注意:默认 lora_rank=8、lora_alpha=32,两者比值是 4,不是 2。网上流传的「alpha 必须是 rank 的两倍」是经验说法而非框架约定,真正起作用的是 alpha/rank 这个比值。target_regex 优先级高于 target_modules——传了正则,target_modules 会被忽略。
3.7 量化参数
| 参数 | 说明 | 3.12 默认值 |
|---|---|---|
quant_method | 量化方法 | None(可选 bnb / hqq / eetq / quanto / fp8) |
quant_bits | 量化位数 | None |
bnb_4bit_quant_type | 4bit 量化类型 | nf4(可选 fp4 / nf4) |
bnb_4bit_use_double_quant | 双量化 | True |
⚠️ 注意:3.12 没有 --load_in_4bit / --load_in_8bit 这两个参数。想做 QLoRA,正确写法是:
--quant_method bnb --quant_bits 4
如果用的是已经 AWQ/GPTQ 量化好的模型,官方明确说明不需要再设 quant_method 等量化参数。
3.8 RLHF 对齐参数
| 参数 | 说明 | 3.12 默认值 |
|---|---|---|
rlhf_type | 对齐算法 | dpo(可选 dpo / orpo / simpo / kto / cpo / rm / ppo / grpo / gkd) |
beta | 与参考模型的偏离程度 | 按算法而异(见下) |
ref_model | 参考模型 | None(取 --model) |
ref_adapters | 参考模型的 adapter | [] |
rpo_alpha | DPO 中 SFT 损失的权重 | None(默认不含 SFT 损失) |
desirable_weight | KTO 正样本权重 | 1.0 |
undesirable_weight | KTO 负样本权重 | 1.0 |
beta 的默认值不是统一值,官方文档给的分档是:
| 算法 | beta 默认值 |
|---|---|
| SimPO | 2.0 |
| GRPO | 0.04 |
| GKD | 0.5 |
| 其他(DPO / KTO / ORPO 等) | 0.1 |
🔴 重点:beta 越大表示与参考模型偏离越小(越保守)。照抄别人的 --beta 0.1 到 SimPO 上就完全错了。
ref_adapters 是实用参数:SFT 用的 LoRA,想让它的权重同时当参考模型,可以用 --adapters sft_ckpt --ref_adapters sft_ckpt(需 ms-swift >= 3.8)。
3.9 推理与部署参数
| 参数 | 说明 | 3.12 默认值 |
|---|---|---|
infer_backend | 推理后端 | pt(可选 pt / vllm / sglang / lmdeploy) |
max_new_tokens | 最大生成长度 | None(不限) |
stream | 流式输出 | None(交互式为 True,批量推理为 False) |
merge_lora | 合并 LoRA 权重 | False |
vllm_max_model_len | vLLM 最大序列长度 | None(读 config.json) |
host | 部署监听地址 | 0.0.0.0 |
port | 部署端口 | 8000 |
⚠️ 注意:infer_backend 默认是 pt(PyTorch 原生),不是 vLLM。想加速必须显式指定 --infer_backend vllm。
3.10 导出参数
| 参数 | 说明 | 3.12 默认值 |
|---|---|---|
merge_lora | 合并 LoRA | False |
push_to_hub | 推送模型库 | False |
hub_model_id | 目标模型 ID | None |
hub_token | 访问令牌 | None |
quant_method | 导出量化方法 | None(可选 gptq / awq / bnb / fp8) |
quant_n_samples | GPTQ/AWQ 校准样本数 | 256 |
quant_batch_size | 量化 batch | 1 |
group_size | 分组大小 | 128 |
导出阶段的 quant_method 可选项与训练阶段不同:训练是 bnb/hqq/eetq/quanto/fp8,导出是 gptq/awq/bnb/fp8。同一个参数名在不同子命令下取值不一样,这是很容易踩的坑。
四、Megatron-SWIFT 专有参数
Megatron-SWIFT 是走 Megatron 并行体系的训练入口,参数与上面的通用参数部分不通用。核心差异:
train_type在 Megatron 下默认是full,不是lora。- batch size 拆成两层:
micro_batch_size(单卡)和global_batch_size(全局)。 - 显存控制靠激活重计算而非梯度检查点。
| 参数 | 说明 | 3.12 默认值 |
|---|---|---|
micro_batch_size | 单设备 batch | 1 |
global_batch_size | 全局 batch(= micro × DP × 梯度累积) | 16 |
recompute_granularity | 激活重计算粒度 | selective(可选 full / selective / none) |
recompute_modules | 重计算的模块 | ["core_attn"] |
attention_backend | 注意力后端 | flash(可选 flash / fused / unfused / local / auto) |
train_iters | 总训练迭代数 | None |
max_epochs | 训练轮数 | None |
tensor_model_parallel_size | TP 并行度 | 1 |
pipeline_model_parallel_size | PP 并行度 | 1 |
几个要点:
- 重计算粒度推荐
selective:只重算核心注意力部分,比full(整层重算)省时间,显存收益却接近。none需要 ms-swift >= 3.12.3。 recompute_modules配 MoE 模型很好用:--recompute_granularity selective --recompute_modules core_attn moe能进一步压显存。global_batch_size的算法是micro_batch_size × DP × 梯度累积,其中DP = 总卡数 / (TP × PP × CP)。调参时按下式反推,别瞎试。- 部分模型不支持 flash attention(如 Llama4、GPT-OSS),需改成
--attention_backend unfused --padding_free false。 - 优化器状态吃显存时,可以用
--optimizer_cpu_offload true把优化器状态卸到 CPU。
五、实战命令
5.1 SFT 训练(LoRA + QLoRA)
CUDA_VISIBLE_DEVICES=0 swift sft \
    --model Qwen/Qwen2.5-1.8B-Instruct \
    --train_type lora \
    --custom_dataset_info dataset_info.json \
    --dataset med_disc med_self_cog \
    --torch_dtype bfloat16 \
    --quant_method bnb \
    --quant_bits 4 \
    --num_train_epochs 2 \
    --per_device_train_batch_size 4 \
    --gradient_accumulation_steps 2 \
    --learning_rate 1e-4 \
    --lora_rank 16 \
    --lora_alpha 32 \
    --target_modules all-linear \
    --max_length 2048 \
    --split_dataset_ratio 0.05 \
    --save_total_limit 3 \
    --system "你是专业医疗助手,提供严谨安全的健康咨询,不替代医嘱" \
    --output_dir ./output_sft
注意这里显式设置了 --split_dataset_ratio 0.05,因为它默认是 0.(不切分)。
5.2 偏好对齐(DPO)
CUDA_VISIBLE_DEVICES=0 swift rlhf \
    --rlhf_type dpo \
    --model Qwen/Qwen2.5-1.8B-Instruct \
    --train_type lora \
    --adapters ./output_sft/checkpoint-xxx \
    --ref_adapters ./output_sft/checkpoint-xxx \
    --dataset <偏好数据集> \
    --beta 0.1 \
    --num_train_epochs 1 \
    --per_device_train_batch_size 2 \
    --learning_rate 1e-5 \
    --output_dir ./output_dpo
5.3 合并 + 量化 + 推送
CUDA_VISIBLE_DEVICES=0 swift export \
    --adapters ./output_dpo/checkpoint-xxx \
    --merge_lora true \
    --quant_method awq \
    --push_to_hub true \
    --hub_model_id "<你的用户名>/qwen2.5-med-1.8b" \
    --hub_token "<你的 ModelScope 令牌>" \
    --use_hf false
5.4 部署为 API 服务
CUDA_VISIBLE_DEVICES=0 swift deploy \
    --adapters ./output_sft/checkpoint-xxx \
    --infer_backend vllm \
    --vllm_max_model_len 4096 \
    --host 0.0.0.0 \
    --port 8000
六、高频报错排查
6.1 用了 tuner_type 报未知参数
- 原因:
tuner_type是 4.x 的参数名,3.12 已改名。 - 解决:换成
--train_type。 - 验证:
swift sft --help | grep -E "train_type|tuner_type"。
6.2 用了 --load_in_4bit 报未知参数
- 原因:3.12 没有这个开关。
- 解决:改用
--quant_method bnb --quant_bits 4。
6.3 布尔值解析失败
- 原因:写成了
True/False。 - 解决:改成小写
true/false。
6.4 训练日志没有验证指标
- 原因:
split_dataset_ratio默认是0.,压根没切验证集。 - 解决:显式设
--split_dataset_ratio 0.05,或用--val_dataset。
6.5 beta 设了没效果 / 效果异常
- 原因:
beta默认值随算法而异,照抄别的算法的值。 - 解决:对照第 3.8 节的分档表确认。
6.6 磁盘被 checkpoint 撑爆
- 原因:
save_total_limit默认None,会保留所有 checkpoint。 - 解决:显式设
--save_total_limit 2或3。
七、总结:你真正需要记住的 N 件事
- 3.12 用
train_type,4.x 用tuner_type——反了就报未知参数。 - 命令行最终生效的是「集成参数」,查文档以它为准。
- 默认值别照抄博客:
num_train_epochs=3、per_device_train_batch_size=1、warmup_ratio=0、gradient_checkpointing=True、split_dataset_ratio=0.,这些和很多教程写的不一样。 learning_rate按方式分档:全参1e-5、LoRA1e-4。- LoRA 默认
r=8, alpha=32,比值是 4;起作用的是比值,不是「alpha 必须等于 2r」。 - QLoRA 用
--quant_method bnb --quant_bits 4,3.12 没有load_in_4bit。 beta的默认值按算法区分,SimPO 是 2.0,DPO/KTO 是 0.1。quant_method在训练和导出阶段取值不同,别拿训练的可选值去导出。
验证清单
-
swift sft --help | grep train_type能查到参数 - LoRA 命令里用的是
--train_type,且位数与--quant_bits配对 - 布尔参数一律小写
- 需要验证集时已显式设置
--split_dataset_ratio或--val_dataset - 已设
--save_total_limit防止磁盘写满 - 对齐任务的
beta与该算法的官方默认分档核对过 - 导出任务的
quant_method用的是导出阶段的可选值
参考资源
- ms-swift 命令行参数(通用):https://swift.readthedocs.io/en/v3.12/Instruction/Command-line-parameters.html
- ms-swift Megatron-SWIFT 命令行参数:https://swift.readthedocs.io/en/v3.12/Megatron-SWIFT/Command-line-parameters.html
- ms-swift 自定义数据集:https://swift.readthedocs.io/en/v3.12/Customization/Custom-dataset.html
- vLLM 引擎参数(
vllm_*前缀参数的含义见此):https://docs.vllm.ai/en/latest/serving/engine_args.html
标签
#ms-swift #命令行参数 #大模型微调 #LoRA #Megatron #模型部署 #ModelScope

AtomGit 是由开放原子开源基金会联合 CSDN 等生态伙伴共同推出的新一代开源与人工智能协作平台。平台坚持“开放、中立、公益”的理念,把代码托管、模型共享、数据集托管、智能体开发体验和算力服务整合在一起,为开发者提供从开发、训练到部署的一站式体验。
更多推荐


 10
 0
- 0


 已为社区贡献41条内容

所有评论(0)