五、性能分析工具的使用
文章目录
概述:在数据库调优中,我们的目标就是
响应时间更快,吞吐量更大。利用宏观的监控工具和微观的日志分析可以帮我们快速找到调优的思路和方式。
1、数据库服务器的优化步骤
当我们遇到数据库调优问题的时候,该如何思考呢?这里把思考的流程整理成下面这张图。
整个流程划分成了观察(Show status)和行动(Action)两个部分。字s的部分代表观察(会使用相应的分析工具),字母A 代表的部分是行动(对应分析可以采取的行动)。
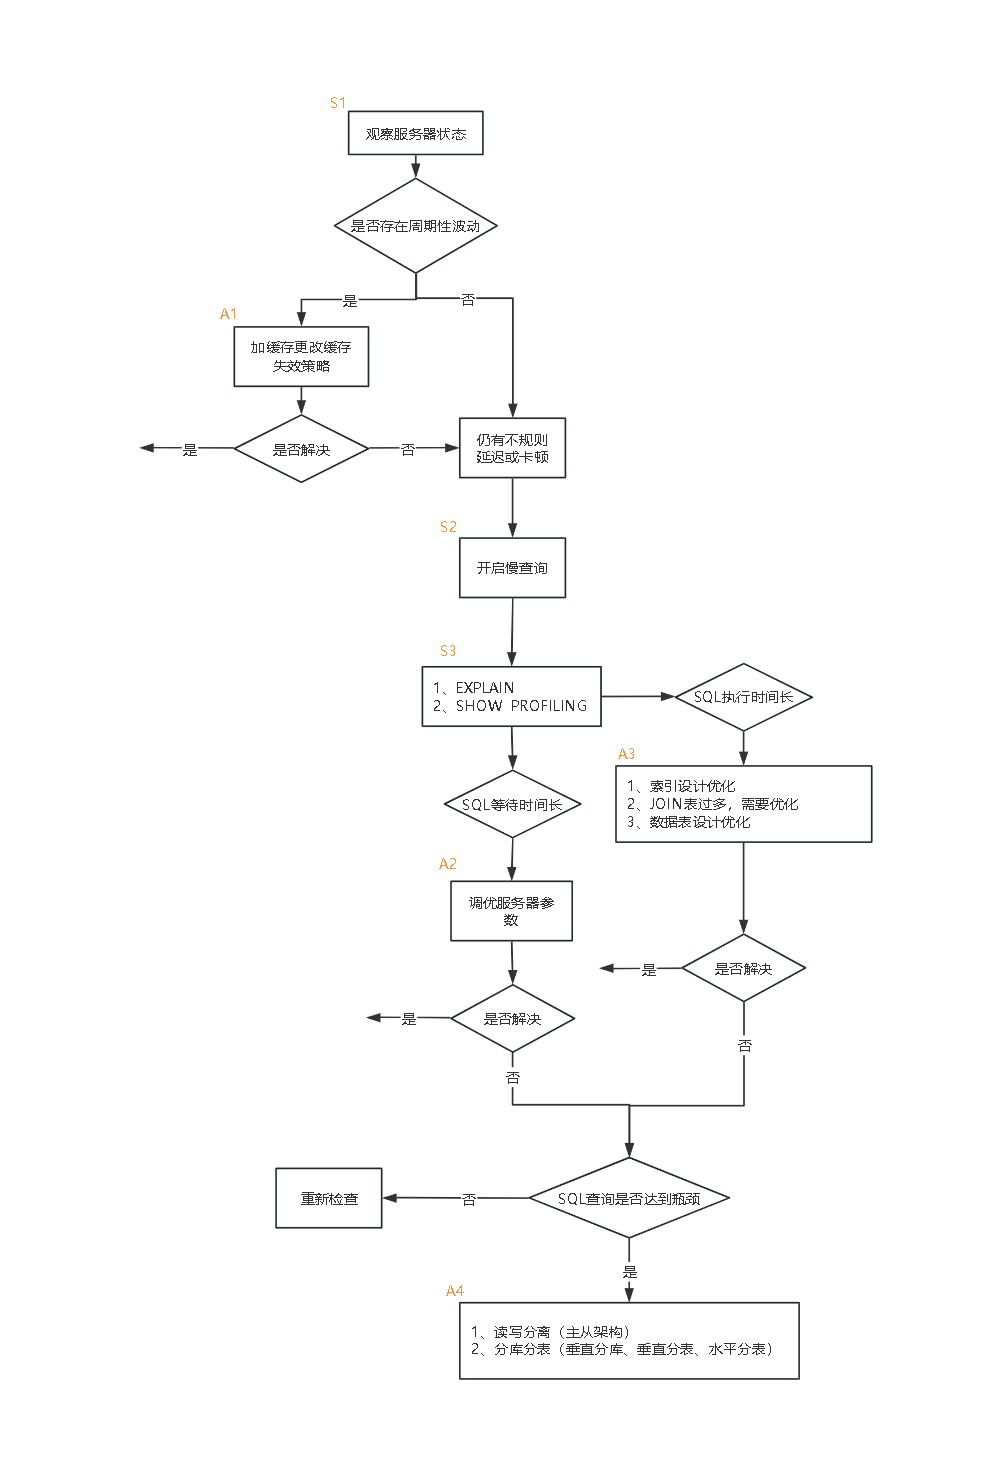
可以通过观察了解数据库整体的运行状态,通过性能分析工具可以让我们了解执行慢的SQL 都有哪些,查看具体的 SQL 执行计划,甚至是SQL执行中的每一步的成本代价,这样才能定位问题所在,找到了问题,再采取相应的行动。
详细解释一下这张图
首先在 S1 部分,我们需要观察服务器的状态是否存在周期性的波动。如果 存在周期性波动,有可能是周期性节点的原因,比如双十一、促销活动等。这样的话,我们可以通过A1这一步骤解决,也就是加缓存,或者更改缓存失效策略。
如果缓存策略没有解决,或者不是周期性波动的原因,我们就需要进一步分析查询延迟和卡顿的原因。接下来进入S2这一步,我们需要开启慢查询。慢查询可以帮我们定位执行慢的SQL语句。我们可以通过设置long-query_time参数定义“慢”的阈值,如果SQL 执行时间超过了long_query_time,则会认为是慢查询。当收集上来这些慢查询之后,我们就可以通过分析工具对慢查询日志进行分析。
在S3这一步骤中,我们就知道了执行慢的SQL,这样就可以针对性地用EXPLAIN查看对应SQL语句的执行计划,或者使用show profile查看SQL中每一个步骤的时间成本。这样我们就可以了解SQL查询慢是因为执行时间长,还是等待时间长。
如果是SQL等待时间长,我们进入A2步骤。在这一步骤中,我们可以调优服务器的参数,比如适当增加数据库缓冲池等。如果是SQL执行时间长,就进入A3步骤,这一步中我们需要考虑是索引设计的问题?还是查询关联的数据表过多?还是因为数据表的字段设计问题导致了这一现象。然后在这些维度上进行对应的调整。
如果A2和A3 都不能解决问题,我们需要考虑数据库自身的 SQL查询性能是否已经达到了瓶颈,如果确认没有达到性能瓶颈,就需要重新检查,重复以上的步骤。如果已经达到了性能瓶颈,进入A4阶段,需要考虑增加服务器,采用读写分离的架构,或者考虑对数据库进行分库分表,比如垂直分库、垂直分表和水平分表等。
以上就是数据库调优的流程思路。如果我们发现执行SQL时存在不规则延迟或卡顿的时候,就可以采用分析工具帮我们定位有问题的SQL,这三种分析工具你可以理解是SQL调优的三个步骤:慢查询、EXPLAIN和SHOW PROFILING。
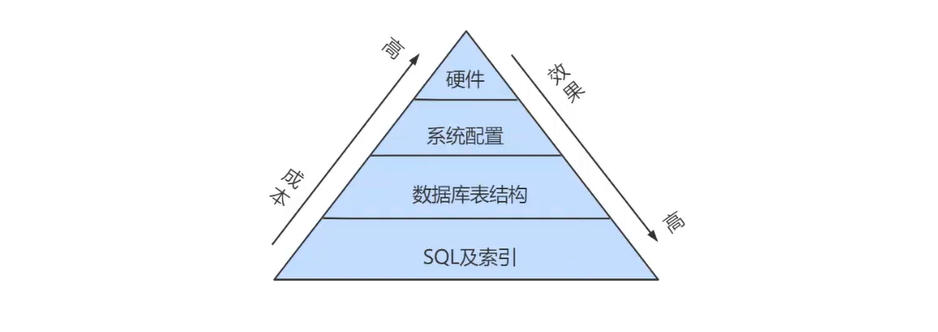
一张图进行小结
- 编写有效率的的SQL和索引成本最低,但是效果却最好
2、查看系统性能参数
在MySQL中,可以使用SHOW STATUS语句查询一些MySQL数据库服务器的性能参数、执行频率。
SHOW STATUS语句语法如下:
SHOW [GLOBAL | SESSION] STATUS LIKE '参数';
-
SESSION STATUS(默认值)
全称:会话级状态变量
作用域:仅当前数据库连接(你打开的这个终端 / 程序连接)
生命周期:连接建立 → 连接断开,断开后数据清零
默认规则:不写 GLOBAL/SESSION 时,MySQL 默认用 SESSION -
GLOBAL STATUS
全称:全局级状态变量
作用域:整个 MySQL 服务,所有客户端连接的统计总和
生命周期:MySQL 启动 → 服务重启 / 关闭,重启后数据清零
统计范围:累加所有会话的操作数据(所有连接的查询、连接数、流量等)
一些常用的性能参数如下:
| 参数 | 描述 |
|---|---|
| Connections | 连接MySQL服务器的次数 |
| Uptime | MySQL服务器的运行时间 |
| Slow_queries | 慢查询的次数 |
| Innodb_rows_read | Select查询返回的行数 |
| Innodb_rows_inserted | 执行INSERT操作插入的行数 |
| Innodb_rows_updated | 执行UPDATE操作更新的行数 |
| Innodb_roWs_deleted | 执行DELETE操作删除的行数 |
| Com_select | 查询操作的次数。 |
| Com_insert | 插入操作的次数。对于批量插入的INSERT操作,只累加一次。 |
| Com_update | 更新操作的次数。 |
| Com_delete | 删除操作的次数。 |
-
若查询MySQL服务器的连接次数,则可以执行如下语句:
SHOW STATUS LIKE 'Connections'; -
若查询服务器工作时间,则可以执行如下语句:
SHOW STATUS LIKE 'Uptime'; -
若查询MySQL服务器的慢查询次数,则可以执行如下语句:
SHOW STATUS LIKE 'Slow_queries';慢查询次数参数可以结合慢查询日志找出慢查询语句,然后针对慢查询语句进
表结构优化或者查询语句优化。 -
查看运行期间分别增、删、改、查了多少条数据
SHOW STATUS LIKE 'Innodb_rows_%;
3、查看SQL的查询成本
一条 SQL 查询语句在执行前需要确定查询执行计划,如果存在多种执行计划的话,MySQL会计算每个执行计划所需要的成本,从中选择成本最小的一个作为最终执行的执行计划。
如果我们想要查看某条 SQL语句的查询成本,可以在执行完这条SQL语句之后,通过查看当前会话中的last_query_cost变量值来得到当前查询的成本。它通常也是我们评价一个查询的执行效率的一个常用指标。这个查询成本对应的是SQL语句所需要读取的页的数量。
以下面表结构为例:
CREATE TABLE student_info(
	id INT(11) NOT NULL AUTO_INCREMENT,
	student_id INT NOT NULL,
	NAME VARCHAR(20) DEFAULT NULL,
	course_id INT NOT NULL,
	class_id INT(11) DEFAULT NULL,
	create_time DATETIME DEFAULT CURRENT_TIMESTAMP ON UPDATE CURRENT_TIMESTAMP,
	PRIMARY KEY(id)
)ENGINE=INNODB AUTO_INCREMENT = 1 DEFAULT CHARSET=utf8;
如果我们想要查询id=900001 的记录,然后看下查询成本,我们可以直接进行查找:
SELECT student_id, class_id, NAME, create_time
FROM student_info WHERE id = 900001;
运行结果(1条记录,运行时间为0.042s)
然后再看下查询优化器的成本,实际上我们只需要检索一个页即可:
#执行结果
mysql> SHOW STATUS LIKE 'LAST_QUERY_COST';
+-----------------+----------+
| Variable_name   | Value    |
+-----------------+----------+
| Last_query_cost | 1.000000 |
+-----------------+----------+
1 row in set (0.00 sec)

mysql>
我们再改成查询id在900001到 9000100之间的学生记录:
SELECT student_id, class_id, NAME, create_time
FROM student_info WHERE id BETWEEN 900001 AND 900100;
运行结果(100条记录,运行时间为0.046s)
然后再看下查询优化器的成本,这时我们大概需要进行21个页的查询。
#执行结果
mysql> SHOW STATUS LIKE 'LAST_QUERY_COST';
+-----------------+-----------+
| Variable_name   | Value     |
+-----------------+-----------+
| Last_query_cost | 20.290422 |
+-----------------+-----------+
1 row in set (0.00 sec)

mysql>
能看到页的数量是刚才的20倍,但是查询的效率并没有明显的变化,实际上这两个 SQL 查询的时间基本上一样,就是因为采用了顺序读取的方式将页面一次性加载到缓冲池中,然后再进行查找。虽然页数量(last_query_cost)增加了不少,但是通过缓冲池的机制,并没有增加多少查询时间。
使用场景:它对于比较开销是非常有用的,特别是我们有好几种查询方式可选的时候。
SQL查询是一个动态的过程,从页加载的角度来看,我们可以得到以下两点结论:
位置决定效率。如果页就在数据库缓冲池中,那么效率是最高的,否则还需要从内存或者磁盘中进行读取,当然针对单个页的读取来说,如果页存在于内存中,会比在磁盘中读取效率高很多。批量决定效率。如果我们从磁盘中对单一页进行随机读,那么效率是很低的(差不多10ms),而采用顺序读取的方式,批量对页进行读取,平均一页的读取效率就会提升很多,甚至要快于单个页面在内存中的随机读取。所以说,遇到/O并不用担心,方法找对了,效率还是很高的。我们首先要考虑数据存放的位置,如果是经常使用的数据就要尽量放到
缓冲池中,其次我们可以充分利用磁盘的吞吐能力,一次性批量读取数据,这样单个页的读取效率也就得到了提升。
4、定位执行慢的SQL:慢查询日志
MySQL的慢查询日志,用来记录在MySQL中响应时间超过阀值的语句,具体指运行时间超过long-query_time值的sQL,则会被记录到慢查询日志中。long_query_time的默认值为10,意思是运行10秒以上(不含10秒)的语句,认为是超出了我们的最大忍耐时间值。
它的主要作用是,帮助我们发现那些执行时间特别长的SQL 查询,并且有针对性地进行优化,从而提高系统的整本效率。当我们的数据库服务器发生阻塞、运行变慢的时候,检查一下慢查询日志,找到那些慢查询,对解决问题很有帮助。比如一条sql执行超过5秒钟,我们就算慢SQL,希望能收集超过5秒的sql,结合explain进行全面分析。
默认情况下,MySQL数据库没有开启慢查询日志,需要我们手动来设置这个参数。如果不是调优需要的话,一般不建议启动该参数,因为开启慢查询日志会或多或少带来一定的性能影响。
慢查询日志支持将日志记录写入文件。
1、开启慢查询日志参数
1.开启slow_query_log
在使用前,我们需要先看下慢查询是否已经开启,使用下面这条命令即可:
SHOW VARIABLES LIKE '%slow_query_log%';
slow_query_log_file列的值为/var/lib/mysql/localhost-slow.log,表示慢查询日志保存在localhost-slow.log文件中。slow_query_log=0FF没有打开(默认关闭),slow_query_log=ON就是打开慢查询日志功能。
慢查询日志是默认关闭,把慢查询日志打开,注意设置变量值的时候需要使用global级别,否则会报错:
SET GLOBAL slow_query_log = 'ON';
2.修改long_query_time阈值
接下来我们来看下慢查询的时间阈值设置,也就是用时多少秒的SQL算是慢查询(默认是10秒钟),使用如下命令:
SHOW VARIABLES LIKE '%long_query_time%';
修改慢查询时间阈值。测试发现:设置global的方式对当前session的long_query_time失效。对新连接的客户端有效。所以可以一并执行下述语句:
#设置GLOBAL级别时间阈值为1秒
SET GLOBAL long_query_time = 1;
#查看GLOBAL级别慢查询时间阈值
SHOW GLOBAL VARIABLES LIKE '%long_query_time%';
#设置SESSION级别时间阈值为1秒
SET long_query_time = 1;
#查看SESSION级别慢查询时间阈值
SHOW VARIABLES LIKE '%long_query_time%';
补充:以上通过命令设置的方式只是零时生效,重启服务就会失效,如需要永久生效通过以下方式修改配置文件参数,修改my.cnf文件,[mysqld]下增加或修改参数long_query_time、slow_query_log和slow_query_log_file后,然后重启MySQL服务器。:
[mysqld]
slow_query_log = ON 	# 开启慢查询目志的开关
slow_query_log_File = /var/lib/mysql/atguigu-slow.log 	#慢查询日志的目录和文件名信息
long_query_time = 3	 #设置慢查询的阈值为3秒,超出此设定值的SQL即被记录到慢查询志
log-_output = FILE		#把日志写入日志文件
如果不指定存储路径,慢查询日志将默认存储到MySQL数据库的数据文件夹下。如果不指定文件名,默认文件名为hostname-slow.log。
2、查看慢查询数目
查询当前系统中有多少条慢查询记录:
SHOW GLOBAL STATUS LIKE '%Slow_queries%';
3、案例演示-数据准备
步骤1.建表
CREATE TABLE student'(
id INT(11) NOT NULL AUTO_INCREMENT,`stuno' INT NOT NULL,
name`
VARCHAR(20) DEFAULT NULL,
`age INT(3) DEFAULT NULL,`classId' INT(11) DEFAULT NULL,
PRIMARY KEY (^id^)
) ENGINE=INNODB AUTO_INCREMENT=1 DEFAULT CHARSET=utf8;
步骤2:设置参数log_bin_trust_function_creators
创建函数,假如报错:
This function has none of DETERMINISTIC…
命令开启:允许创建函数设置:
SET GLOBAL log_bin_trust_function_creators = 1; #不加global只是当前窗口有效。
步骤3:创建函数
随机产生字符串:(同上一章)
DELIMITER //
CREATE FUNCTION rand_string(n INT)
RETURNS VARCHAR(255)	#该函数会返回一个字符串
BEGIN
	DECLARE chars_str VARCHAR(100) DEFAULT 'abcdefghijklmnopqrstuvwxyzABCDEFJHIJKLMNOPQRSTUVWXYZ';
	DECLARE return_str VARCHAR(255) DEFAULT '';
	DECLARE i INT DEFAULT 0;
	WHILE i < n DO
	SET return_str = CONCAT(return_str,SUBSTRING(chars_str,FLOOR(1+RAND()*52),1));
	SET i = i + 1;
	END WHILE;
	RETURN return_str;
END//
DELIMITER;

#测试
SELECT rand_string(10);
产生随机数值:(同上一章)
DELIMITER //
CREATE FUNCTION rand_num(from_num INT ,to_num INT)
RETURNS INT(11)
BEGIN
	DECLARE i INT DEFAULT 0;
	SET i = FLOOR(from_num +RAND()*(to_num - from_num + 1));
	RETURN i;
END //
DELIMITER;

#测试
SELECT rand_num(10,100);
步骤4:创建存储过程与调用
DELIMITER //
CREATE PROCEDURE insert_stu1(statr INT, max_num INT)
BEGIN
	DECLARE i INT DEFAULT 0;
	SET autocommit = 0;	#设置手动提交事务
	REPEAT 	#循环
	SET i= i + 1;	#赋值
	INSERT INTO student (stuno, NAME ,age ,classId )
	VALUES((statr+i),rand_string(6),rand_num(10,100),rand_num(10,1000));
	UNTIL i = max_num
	END REPEAT;
	COMMIT;	#提交事务
END//
DELIMITER

#从100001号开始,添加四百万条数据
CALL insert_stu1(100001,4000000)
4、测试及分析
1.测试
mysql> SELECT * FROM student WHERE stuno = 3455655;
+---------+---------+--------+------+---------+
| id      | stuno   | name   | age  | classId |
+---------+---------+--------+------+---------+
| 3355654 | 3455655 | VZjZtX |   63 |      85 |
+---------+---------+--------+------+---------+
1 row in set (1.41 sec)

mysql> SELECT * FROM student WHERE name = 'oQmLUr';
+---------+---------+--------+------+---------+
| id      | stuno   | name   | age  | classId |
+---------+---------+--------+------+---------+
|  886199 |  986200 | OQMlUR |   55 |     991 |
| 1360814 | 1460815 | Oqmlur |   56 |     525 |
| 2480069 | 2580070 | oqMLuR |   10 |     529 |
| 2592506 | 2692507 | OQMlUR |   53 |     879 |
| 3271900 | 3371901 | Oqmlur |   52 |     330 |
| 3620841 | 3720842 | Oqmlur |   54 |     418 |
| 3830842 | 3930843 | oQmLUr |   96 |     768 |
| 3913474 | 4013475 | Oqmlur |   54 |     430 |
| 3949181 | 4049182 | oqMLuR |   96 |     295 |
+---------+---------+--------+------+---------+
9 rows in set (1.50 sec)

mysql>
从上面的结果可以看出来,查询学生编号为“3455655”的学生信息花费时间为1.41秒。查询学生姓名为“oQmLUr”的学生信息花费时间为1.50秒。已经达到了秒的数量级,说明目前查询效率是比较低的,下面的小节我们分析一下原因。
2.分析
mysql> show status like 'slow_queries';
+---------------+-------+
| Variable_name | Value |
+---------------+-------+
| Slow_queries  | 4     |
+---------------+-------+
1 row in set (0.00 sec)

mysql>
命令查询,有4条语句查询超过一秒钟,为啥有四条?上面不是才查了两条吗?因为设置为1秒后,还做过别的查询。。。
补充说明:min_examined_row_limit
除了上述变量,控制慢查询志的还有个系统变量:min_examined_row_limit。这个变量的意思是,查询扫描过的最少记录数。这个变量和查询执行时间,共同组成了判别一个查询是否是慢查询的条件。如果查询扫描过的记录数大于等于这个变量的值,并且查询执行时间超过 long_query_time 的值,那么,这个查询就被记录到慢查询日志中;反之,则不被记 录到慢查询日志中。
mysql> show variables like 'min%';
+------------------------+-------+
| 	Variable_name          | Value |
+------------------------+-------+
| min_examined_row_limit | 0     |
+------------------------+-------+
1 row in set (0.01 sec)

mysql>
这个值默认是0。与long_query_time=10合在一起,表示只要查询的执行时间超过10秒钟,哪怕一个记录也没有扫描过,都要被记录到慢查询日志中。你也可以根据需要,通过修改“my.ini”文件,来修改查询时长,或者通过SET指令,用SQL语句修改“min_examined_row_limit”的值。
min_examined_row_limit 到底是什么?它是 MySQL 判断 “要不要记录慢查询” 的第二个门槛。
MySQL 判断慢查询的两个条件:
要想一个查询被记录到慢查询日志,必须同时满足两个条件:
- 时间条件:查询时间 > long_query_time(默认 10 秒)
- 扫描行数条件:查询扫描的行数 >= min_examined_row_limit(默认 0)
两个条件必须同时满足,才会记慢查询!
默认情况(min_examined_row_limit = 0)是什么意思?
默认:只要查询超过 10 秒,不管它查了 0 行、1 行、还是 100 万行,全都记录进慢查询日志!因为:扫描行数 >= 0 永远成立所以等于只看时间。
- min_examined_row_limit = 0
- long_query_time = 10 秒
如果把 min_examined_row_limit 改成 1000
配置变成:
- long_query_time = 10 秒
- min_examined_row_limit = 1000
规则就变成:
只有同时满足下面两个条件,才记录慢查询:
1.查询时间超过 10 秒
2.并且查询扫描了至少 1000 行数据
如果一个查询:
- 跑了 11 秒 ✔
- 但只扫描了 10 行 ❌
则不会记录!
为什么要设计这个变量?因为有些查询:跑得很慢(超过 10 秒)但根本没扫几行(不是性能问题)比如:锁等待、网络延迟、睡眠查询,这些不是 SQL 性能问题,不想让它污染慢查询日志。所以用 min_examined_row_limit过滤掉:跑得慢,但没扫几行的无效查询。
5、慢查询日志分析工具:mysqldumpslow
在生产环境中,如果要手工分析日志,查找、分析SQL,显然是个体力活,MySQL提供了日志分析工具mysqldumpslow。
查看mysqldumpslow的帮助信息
[root@localhost ~]# mysqldumpslow --help;
Usage: mysqldumpslow [ OPTS... ] [ LOGS... ]

Parse and summarize the MySQL slow query log. Options are

  --verbose    verbose
  --debug      debug
  --help       write this text to standard output

  -v           verbose
  -d           debug
  -s ORDER     what to sort by (al, at, ar, c, l, r, t), 'at' is default
                al: average lock time
                ar: average rows sent
                at: average query time
                 c: count
                 l: lock time
                 r: rows sent
                 t: query time
  -r           reverse the sort order (largest last instead of first)
  -t NUM       just show the top n queries
  -a           don't abstract all numbers to N and strings to 'S'
  -n NUM       abstract numbers with at least n digits within names
  -g PATTERN   grep: only consider stmts that include this string
  -h HOSTNAME  hostname of db server for *-slow.log filename (can be wildcard),
               default is '*', i.e. match all
  -i NAME      name of server instance (if using mysql.server startup script)
  -l           don't subtract lock time from total time

[root@localhost ~]#
mysqldumpslow 命令的具体参数如下:
- -a:不将数字抽象成N,字符串抽象成S
- -s:
是表示按照何种方式排序:- oc:访问次数
- l:锁定时间
- r:返回记录
- t:
查询时间 - al:平均锁定时间
- ar:平均返回记录数
- at:平均查询时间(默认方式)
- ac:平均查询次数
- t:即为返回前面多少条的数据;
- g:后边搭配一个正则匹配模式,大小写不敏感的;
举例:我们想要按照查询时间排序,查看前五条SQL语句,这样写即可:
[root@localhost ~]# mysqldumpslow -s t -t 5 /var/lib/mysql/localhost-slow.log

Reading mysql slow query log from /var/lib/mysql/localhost-slow.log
Count: 1  Time=457.77s (457s)  Lock=0.00s (0s)  Rows=0.0 (0), root[root]@[192.168.10.10]
  CALL insert_stu1(N,N)

Count: 1  Time=3.29s (3s)  Lock=0.01s (0s)  Rows=1.0 (1), root[root]@[192.168.10.10]
  select COUNT(*) FROM student
  LIMIT N, N

Count: 2  Time=1.53s (3s)  Lock=0.00s (0s)  Rows=9.0 (18), root[root]@localhost
  SELECT * FROM student WHERE name = 'S'

Count: 2  Time=1.39s (2s)  Lock=0.00s (0s)  Rows=1.0 (2), root[root]@localhost
  SELECT * FROM student WHERE stuno = N

Count: 1  Time=1.70s (1s)  Lock=0.00s (0s)  Rows=9.0 (9), root[root]@[192.168.10.10]
  SELECT * FROM student WHERE name = 'S' LIMIT N, N

[root@localhost ~]#
从上面输出我们就得到以下几条慢查询SQL
CALL insert_stu1(N,N);
select COUNT(*) FROM student LIMIT N, N;
SELECT * FROM student WHERE name = 'S';
SELECT * FROM student WHERE stuno = N;
SELECT * FROM student WHERE name = 'S' LIMIT N, N;
可是查询条件中的数值或者字符都被S和N替换了。此时我们就可以再加上一个参数:-a:不将数字抽象成N,字符串抽象成S,重新查询:
[root@localhost ~]# mysqldumpslow -s t -t 5 -a /var/lib/mysql/localhost-slow.log

Reading mysql slow query log from /var/lib/mysql/localhost-slow.log
Count: 1  Time=457.77s (457s)  Lock=0.00s (0s)  Rows=0.0 (0), root[root]@[192.168.10.10]
  CALL insert_stu1(100001,4000000)

Count: 1  Time=3.29s (3s)  Lock=0.01s (0s)  Rows=1.0 (1), root[root]@[192.168.10.10]
  select COUNT(*) FROM student
  LIMIT 0, 1000

Count: 2  Time=1.53s (3s)  Lock=0.00s (0s)  Rows=9.0 (18), root[root]@localhost
  SELECT * FROM student WHERE name = 'oQmLUr'

Count: 2  Time=1.39s (2s)  Lock=0.00s (0s)  Rows=1.0 (2), root[root]@localhost
  SELECT * FROM student WHERE stuno = 3455655

Count: 1  Time=1.70s (1s)  Lock=0.00s (0s)  Rows=9.0 (9), root[root]@[192.168.10.10]
  SELECT * FROM student WHERE name = 'oQmLUr' LIMIT 0, 1000

[root@localhost ~]#
能看到开启了慢查询日志,并设置了相应的慢查询时间阈值之后,只要大于这个阈值的SQL语句都会保存在慢查询日志中,然后我们就可以通过mysqldumpslow工具提取想要查找的SQL语句了。
工作常用参考:
- 得到返回记录集最多的10个SQL
mysqldumpslow -s r -t 10 /var/lib/mysql/localhost-slow.log - 得到访问次数最多的10个SQL
mysqldumpslow -s c -t 10 /var/lib/mysql/localhost-slow.log - 得到按照时间排序的前10条里面含有左连接的查询语句
mysqldumpslow -s t -t 10 -g "left join" /var/lib/mysql/localhost-slow.log - 另外建议在使用这些命令时结合 | 和more使用,否则有可能出现爆屏情况
mysqldumpslow -s r -t 10 /var/lib/mysql/localhost-slow.log | more
6、关闭慢查询日志
MySQL服务器停止慢查询日志功能有两种方法:
方式1:永久性方式
修改my.cnf或者my.ini文件,把[mysqld]组下的slow_query_log值设置为OFF,修改保存后,再重启MySQL服务,即可生效;
[mysqld]
slow_query_log = OFF
或者,把slow_query_log一项注释掉或删除
[mysqld]
#slow_query_log = OFF
重启MySQL服务,执行如下语句查询慢日志功能。
SHOW VARIABLES LIKE '%sloW%'; #查询慢查询志所在目录
SHOW VARIABLES LIKE '%long_query_time%'; #查询超时时长
可以看到,MySQL系统中的慢查询日志是关闭的。
方式2:临时性方式使用
SET语句来设置。
(1)停止MySQL慢查询日志功能,具体SQL语句如下。
SET GLOBAL slow_query_log = off;
(2)重启MySQL服务,使用SHOW语句查询慢查询日志功能信息,具体SQL语句如下
SHOW VARIABLES LIKE '%slow%';
#以及
SHOW VARIABLES LIKE '%long_query_time%';
7、删除慢查询日志
使用SHOW语句显示慢查询日志信息,具体SQL语句如下。
SHOW VARIABLES LIKE 'slow_query_log%';
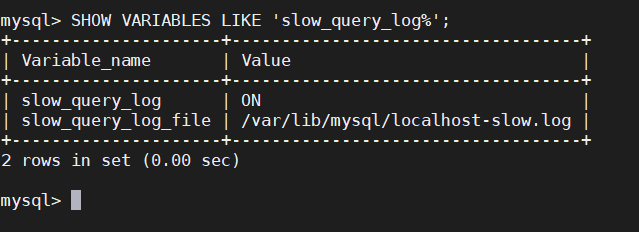
从执行结果可以看出,慢查询日志的目录默认为MySQL的数据目录,在该目录下手动删除慢查询日志文件即可。使用命令mysqladmin flush-logs来重新生成查询日志文件,具体命令如下,执行完毕会在数据目录下重新生成慢查询日志文件。
mysqladmin -uroot -p flush-logs slow
提示
慢查询日志都是使用mysqladmin flush-logs命令来删除重建的。使用时一定要注意,一旦执行了这个命令,慢查询日志都只存在新的日志文件中,如果需要旧的查询日志,就必须事先备份。
5、SHOW PROFILE
Show Profile是MySQL提供的可以用来分析当前会话中SQL都做了什么、执行的资源消耗情况的工具,可用于sql调优的测量。默认情况下处于关闭状态,并保存最近15次的运行结果。
既查看 SQL 执行流程,又统计每个步骤的执行成本(耗时),但它的核心用途是:按执行阶段拆分时间,看时间都花在哪一步。
我们可以在会话级别开启这个功能
mysql> show variables like 'profiling';
+---------------+-------+
| Variable_name | Value |
+---------------+-------+
| profiling     | OFF   |
+---------------+-------+
1 row in set (0.00 sec)

mysql>
通过设置profiling= 'ON'来开启show profile:
set profiling = 'ON';
然后执行相关的查询语句。接着看下当前会话都有哪些profiles,使用下面这条命令:
mysql> show profiles;
+----------+------------+---------------------------------------------+
| Query_ID | Duration   | Query                                       |
+----------+------------+---------------------------------------------+
|        1 | 0.00164950 | show variables like 'profiling'             |
|        2 | 0.00013450 | SELECT * FROM student WHERE stuno = 3455655 |
|        3 | 0.00033050 | SELECT DATABASE()                           |
|        4 | 0.00306875 | show databases                              |
|        5 | 0.00369325 | show tables                                 |
|        6 | 1.61765275 | SELECT * FROM student WHERE stuno = 3455655 |
|        7 | 1.51113275 | SELECT * FROM student WHERE name = 'oQmLUr' |
+----------+------------+---------------------------------------------+
7 rows in set, 1 warning (0.00 sec)

mysql>
能看到当前会话一共有7个查询。如果我们想要查看最近一次查询的开销,可以使用:
mysql> show profile;
+--------------------------------+----------+
| Status                         | Duration |
+--------------------------------+----------+
| starting                       | 0.000063 |
| Executing hook on transaction  | 0.000004 |
| starting                       | 0.000007 |
| checking permissions           | 0.000013 |
| Opening tables                 | 0.000084 |
| init                           | 0.000009 |
| System lock                    | 0.000008 |
| optimizing                     | 0.000008 |
| statistics                     | 0.000014 |
| preparing                      | 0.000018 |
| executing                      | 1.510617 |
| end                            | 0.000023 |
| query end                      | 0.000017 |
| waiting for handler commit     | 0.000011 |
| closing tables                 | 0.000065 |
| freeing items                  | 0.000075 |
| logging slow query             | 0.000052 |
| cleaning up                    | 0.000046 |
+--------------------------------+----------+
18 rows in set, 1 warning (0.00 sec)

mysql>
对输出内容做解释:
| 名称 | 解释 |
|---|---|
| starting | 含义:查询开始,MySQL 初始化查询线程。 |
| Executing hook on transaction | 执行事务相关的钩子函数(内部机制)。 |
| starting | 第二次启动查询准备(内部流程)。 |
| checking permissions | 检查当前用户是否有权限访问涉及的表 / 库。用户是否有权限执行这条 SQL |
| Opening tables | 打开表、获取表结构、表元数据信息。 |
| init | 查询初始化,做执行前的准备工作。 |
| System lock | 系统级表锁(内部锁操作)。 |
| optimizing | 查询优化器对 SQL 进行优化,生成最优执行计划。 |
| statistics | 收集统计信息,确定索引、估算扫描行数。 |
| preparing | 准备执行语句,生成最终执行方案。 |
| executing | 真正执行 SQL 的阶段:读取数据、过滤、计算、排序、连接等。 |
| end | 查询执行结束。 |
| query end | SQL 语句执行完成。 |
| waiting for handler commit | 等待存储引擎提交事务(InnoDB 内部操作)。 |
| closing tables | 关闭打开的表,释放表资源。 |
| freeing items | 释放查询过程中使用的内存、临时结构等。 |
| logging slow query | 判断是否为慢查询,并记录到慢查询日志。 |
| cleaning up | 最后清理,释放所有剩余资源。 |
我们也可以查看指定的Query ID的开销,比如show profile for query 7查询结果是一样的。在 SHOW PROFILE中我们可以查看不同部分的开销,比如 cpu、block.io 等:
mysql> show profile cpu,block io for query 7;
+--------------------------------+----------+----------+------------+--------------+---------------+
| Status                         | Duration | CPU_user | CPU_system | Block_ops_in | Block_ops_out |
+--------------------------------+----------+----------+------------+--------------+---------------+
| starting                       | 0.000063 | 0.000050 |   0.000008 |            0 |             0 |
| Executing hook on transaction  | 0.000004 | 0.000003 |   0.000001 |            0 |             0 |
| starting                       | 0.000007 | 0.000007 |   0.000001 |            0 |             0 |
| checking permissions           | 0.000013 | 0.000011 |   0.000001 |            0 |             0 |
| Opening tables                 | 0.000084 | 0.000085 |   0.000000 |            0 |             0 |
| init                           | 0.000009 | 0.000007 |   0.000000 |            0 |             0 |
| System lock                    | 0.000008 | 0.000007 |   0.000000 |            0 |             0 |
| optimizing                     | 0.000008 | 0.000008 |   0.000000 |            0 |             0 |
| statistics                     | 0.000014 | 0.000014 |   0.000000 |            0 |             0 |
| preparing                      | 0.000018 | 0.000019 |   0.000000 |            0 |             0 |
| executing                      | 1.510617 | 1.228585 |   0.000000 |            0 |             0 |
| end                            | 0.000023 | 0.000016 |   0.000000 |            0 |             0 |
| query end                      | 0.000017 | 0.000017 |   0.000000 |            0 |             0 |
| waiting for handler commit     | 0.000011 | 0.000012 |   0.000000 |            0 |             0 |
| closing tables                 | 0.000065 | 0.000066 |   0.000000 |            0 |             0 |
| freeing items                  | 0.000075 | 0.000074 |   0.000000 |            0 |             0 |
| logging slow query             | 0.000052 | 0.000051 |   0.000000 |            0 |             0 |
| cleaning up                    | 0.000046 | 0.000048 |   0.000000 |            0 |             0 |
+--------------------------------+----------+----------+------------+--------------+---------------+
18 rows in set, 1 warning (0.00 sec)

mysql>
通过上面的结果,我们可以弄清楚每一步骤的耗时,以及在不同部分,比如CPU、block.io的执行时间,这样我们就可以判断出来SQL到底慢在哪里。
show profile的常用查询参数:
- ALL:显示所有的开销信息
- BLOCK IO:显示块IO开销。
- CONTEXT SWITCHES:上下文切换开销。
- CPU:显示CPU开销信息。
- IPC:显示发送和接收开销信息。
- MEMORY:显示内存开销信息。
- PAGEFAULTS:显示页面错误开销信息。
- SOURCE:显示和Source_function,Source_file,Source_line相关的开销信息。
- SWAPS:显示交换次数开销信息。
日常开发需注意的结论:
1. converting HEAP to MyISAM:查询结果太,内存不够,数据往磁盘上搬了。
2. Creating tmp table:创建临时表。先拷贝数据到临时表,用完后再删除临时表。
3. Copying to tmp table on disk:把内存中临时表复制到磁盘上,警惕!
4. locked。
如果在show profile诊断结果中出现了以上4条结果中的任何一条,则sql语句需要优化。
注意:
不过SHOW PROFILE命令将被弃用,我们可以从 information_schema 中的profiling数据表进行查看。
6、分析查询语句:EXPLAIN
1、概述
定位了查询慢的SQL之后,我们就可以使用EXPLAIN或DESCRIBE工具做针对性的分析查询语句。DESCRIBE语句的使用方法与EXPLAIN语句是一样的,并且分析结果也是一样的。
DESCRIBE可以简写成DESC
MySQL中有专门负责优化SELECT语句的优化器模块,主要功能:通过计算分析系统中收集到的统计信息,为客户端请求的Query提供它认为最优的执行计划(他认为最优的数据检索方式,但不见得是DBA认为是最优的,这部分最耗费时间)。
这个执行计划展示了接下来具体执行查询的方式,比如多表连接的顺序是什么,对于每个表采用什么访问方法来具体执行查询等等。MySQL为我们提供了EXPLAIN语句来帮助我们查看某个查询语句的具体执行计划,看懂EXPLAIN语句的各个输出项,可以有针对性的提升我们查询语句的性能。
EXPLAIN能做什么?
- 表的读取顺序
- 数据读取操作的操作类型
- 哪些索引可以使用
哪些索引被实际使用- 表之间的引用
每张表有多少行被优化器查询
注意版本情况:
- MySQL 5.6.3以前只能
EXPLAIN SELECT;MYSQL 5.6.3以后就可以EXPLAIN SELECT、UPDATE、DELETE。 - 在5.7以前的版本中,想要显示
partitiojs需要使用explain partitions命令;想要显示filtered需要使用explain extended命令。在5.7版本后,默认explain直接显示partitions和filtered中的信息。

2、基本语法
EXPLAIN或DESCRIBE语句的语法形式如下:
EXPLAIN SELECT select_options
或者
DESCRIBE SELECT select_options
如果我们想看看某个查询的执行计划的话,可以在具体的查询语句前边加一个EXPLAIN,就像这样:
mysql> EXPLAIN SELECT 1;
+----+-------------+-------+------------+------+---------------+------+---------+------+------+----------+----------------+
| id | select_type | table | partitions | type | possible_keys | key  | key_len | ref  | rows | filtered | Extra          |
+----+-------------+-------+------------+------+---------------+------+---------+------+------+----------+----------------+
|  1 | SIMPLE      | NULL  | NULL       | NULL | NULL          | NULL | NULL    | NULL | NULL |     NULL | No tables used |
+----+-------------+-------+------------+------+---------------+------+---------+------+------+----------+----------------+
1 row in set, 1 warning (0.00 sec)

mysql>
输出的上述信息就是所谓的执行计划。在这个执行计划的辅助下,我们需要知道应该怎样改进自己的查询语句以使查询执行起来更高效。其实除了以SELECT开头的查询语句,其余的DELETE、INSERT、REPLACE以及UPDATE语句等都可以加上EXPLAIN,用来查看这些语句的执行计划,只是平时我们对SELECT语句更感兴趣。
注意:执行EXPLAIN时并没有真正的执行该后面的语句,因此可以安全的查看执行计划。
EXPLAIN语句输出的各个列的作用如下:
| 列名 | 描述 |
|---|---|
| id | 在一个大的查询语句中每个SELECT关键字都对应一个唯一的id |
| select_type | SEIECT关键字对应的那个查询的类型 |
| table | 表名 |
| partitions | 匹配的分区信息 |
| type | 针对单表的访问方法 |
| possible_keys | 可能用到的索引 |
| key | 实际上使用的索引 |
| key_len | 实际使用到的索引长度 |
| ref | 当使用索引列等值查询时,与索引列进行等值匹配的对象信息 |
| rows | 预估的需要读取的记录条数 |
| filtered | 某个表经过搜索条件过滤后剩余记录条数的百分比 |
| Extra | 一些额外的信息 |
3、数据准备
1.创建两个数据表
CREATE TABLE s1 (
	id INT AUTO_INCREMENT,
	key1 VARCHAR(100),
	key2 INT,
	key3 VARCHAR(100),
	key_part1 VARCHAR(100),
	key_part2 VARCHAR(100),
	key_part3 VARCHAR(100),
	common_field VARCHAR(100),
	PRIMARY KEY (id),
	INDEX idx_key1 (key1),
	UNIQUE INDEX idx_key2 (key2),
	INDEX idx_key3 (key3),
	INDEX idx_key_part(key_part1, key_part2, key_part3)
)ENGINE=INNODB CHARSET=utf8;

CREATE TABLE s2(
	id INT AUTO_INCREMENT,
	key1 VARCHAR(100),
	key2 INT,
	key3 VARCHAR(100),
	key_part1 VARCHAR(100),
	key_part2 VARCHAR(100),
	key_part3 VARCHAR(100),
	common_field VARCHAR(100),
	PRIMARY KEY (id),
	INDEX idx_key1 (key1),
	UNIQUE INDEX idx_key2 (key2),
	INDEX idx_key3 (key3),
	INDEX idx_key_part(key_part1, key_part2, key_part3)
)ENGINE=INNODB CHARSET=utf8;
2.设置参数 log_bin_trust_function_creators
创建函数时假如报错,需开启如下命令:允许创建函数设置:
SET GLOBAL log_bin_trust_function_creators=1; #不加global只是当前会话窗口有效。
3.创建函数
DELIMITER //
CREATE FUNCTION rand_string1(n INT)
	RETURNS VARCHAR(255)#该函数会返回一个字符串
BEGIN
	DECLARE chars_str VARCHAR(100) DEFAULT
		'abcdefghijklmnopqrstuvwxyzABCDEFJHIJKLMNOPQRSTUVWXYZ';
	DECLARE return_str VARCHAR(255) DEFAULT '';
	DECLARE i INT DEFAULT 0;
	WHILE i < n DO
	SET return_str = CONCAT(return_str,SUBSTRING(chars_str,FLOOR(1+RAND()*52),1));
	SET i =i+ 1;
	END WHILE;
	RETURN return_str;
END //
DELIMITER;
4.创建存储过程:
#创建向s1表中插入数据的存储过程:
DELIMITER //
CREATE PROCEDURE insert_s1 (IN min_num INT (10),IN max_num INT (10))
BEGIN
	DECLARE i INT DEFAULT 0;
	SET autocommit = 0;
	REPEAT
	SET i = i + 1;
	INSERT INTO s1 VALUES(
	(min_num + i),
	rand_string1(6),
	(min_num + 30 * i + 5),
	rand_string1(6),
	rand_string1(10),
	rand_string1(5),
	rand_string1(10),
	rand_string1(10));
	UNTIL i = max_num
	END REPEAT;
	COMMIT;
END //
DELIMITER ;


#创建向s2表中插入数据的存储过程:
DELIMITER //
CREATE PROCEDURE insert_s2 (IN min_num INT (10),IN max_num INT (10))
BEGIN
	DECLARE i INT DEFAULT 0;
	SET autocommit = 0;
	REPEAT
	SET i = i + 1;
	INSERT INTO s2 VALUES(
	(min_num + i),
	rand_string1(6),
	(min_num + 30 * i + 5),
	rand_string1(6),
	rand_string1(10),
	rand_string1(5),
	rand_string1(10),
	rand_string1(10));
	UNTIL i = max_num
	END REPEAT;
	COMMIT;
END //
DELIMITER


#调用存储过程:s1表添加1万条记录,s2表添加1万条记录
CALL insert_s1(10001,10000);
CALL insert_s2(10001,10000);
4、EXPLAIN各列作用
1、table
查询的每一行记录都对应着一个单表
不论我们的查询语句有多复杂,里边儿包含了多少个表,到最后也是需要对每个表进行单表访问的,所以MySQL规定EXPLAIN语句输出的每条记录都对应着某个单表的访问方法,该条记录的table列代表着该表的表名(有时不是真实的表名字,可能是简称。包括临时表)。
mysql> explain select * from s1;
+----+-------------+-------+------------+------+---------------+------+---------+------+------+----------+-------+
| id | select_type | table | partitions | type | possible_keys | key  | key_len | ref  | rows | filtered | Extra |
+----+-------------+-------+------------+------+---------------+------+---------+------+------+----------+-------+
|  1 | SIMPLE      | s1    | NULL       | ALL  | NULL          | NULL | NULL    | NULL | 9895 |   100.00 | NULL  |
+----+-------------+-------+------------+------+---------------+------+---------+------+------+----------+-------+
1 row in set, 1 warning (0.00 sec)

mysql>
这个查询语句只涉及对s1表的单表查询,所以EXPLAIN输出中只有一条记录,其中的table列的值是s1,表明这条记录是用来说明对s1表的单表访问方法的。
下边我们看一个连接查询的执行计划:
mysql> EXPLAIN SELECT * FROM s1 INNER JOIN s2;
+----+-------------+-------+------------+------+---------------+------+---------+------+------+----------+-------------------------------+
| id | select_type | table | partitions | type | possible_keys | key  | key_len | ref  | rows | filtered | Extra                         |
+----+-------------+-------+------------+------+---------------+------+---------+------+------+----------+-------------------------------+
|  1 | SIMPLE      | s1    | NULL       | ALL  | NULL          | NULL | NULL    | NULL | 9895 |   100.00 | NULL                          |
|  1 | SIMPLE      | s2    | NULL       | ALL  | NULL          | NULL | NULL    | NULL | 9895 |   100.00 | Using join buffer (hash join) |
+----+-------------+-------+------------+------+---------------+------+---------+------+------+----------+-------------------------------+
2 rows in set, 1 warning (0.00 sec)

mysql>
可以看到这个连接查询的执行计划中有两条记录,这两条记录的table列分别是s1和s2,这两条记录用来分别说明对s1表和s2表的访问方法是什么。
2、id
在一个大的查询语句中每个SELECT关键字都对应一个唯一的id
我们写的查询语句一般都以SELECT关键字开头,比较简单的查询语句里只有一个SELECT关键字,比如下边这个查询语句:
SELECT * FROM s1 WHERE key1 = 'a';
稍微复杂一点的连接查询中也只有一个SELECT关键字,比如:
 SELECT * FROM s1 INNER JOIN s2
 ON s1.key1 = s2.key1
 WHERE s1.common_field = 'a';
但是下边两种情况下在一条查询语句中会出现多个SELECT关键字:
- 查询中包含子查询的情况,比如下边这个查询语句中就包含
2个SELECT关键字:SELECT * FROM s1 WHERE key1 IN (SELECT key3 FROM s2); - 查询中包含
UNION语句的情况,比如下边这个查询语句中也包含2个SELECT关键字:SELECT * FROM s1 UNION SELECT * FROM s2;
查询语句中每出现一个SELECT关键字,MySQL就会为它分配一个唯一的id值。这个id值就是EXPLAIN语句的第一个列,比如下边这个查询中只有一个SELECT关键字,所以EXPLAIN的结果中也就只有一条id列为1的记录:
mysql> EXPLAIN SELECT * FROM s1 WHERE key1 = 'a';
+----+-------------+-------+------------+------+---------------+----------+---------+-------+------+----------+-------+
| id | select_type | table | partitions | type | possible_keys | key      | key_len | ref   | rows | filtered | Extra |
+----+-------------+-------+------------+------+---------------+----------+---------+-------+------+----------+-------+
|  1 | SIMPLE      | s1    | NULL       | ref  | idx_key1      | idx_key1 | 303     | const |    1 |   100.00 | NULL  |
+----+-------------+-------+------------+------+---------------+----------+---------+-------+------+----------+-------+
1 row in set, 1 warning (0.00 sec)

mysql>
对于连接查询来说,一个SELECT 关键字后边的FROM子句中可以跟随多个表,所以在连接查询的执行计划中,每个表都会对应一条记录,但是这些记录的id值都是相同的,比如:
mysql> EXPLAIN SELECT * FROM s1 INNER JOIN s2;
+----+-------------+-------+------------+------+---------------+------+---------+------+------+----------+-------------------------------+
| id | select_type | table | partitions | type | possible_keys | key  | key_len | ref  | rows | filtered | Extra                         |
+----+-------------+-------+------------+------+---------------+------+---------+------+------+----------+-------------------------------+
|  1 | SIMPLE      | s1    | NULL       | ALL  | NULL          | NULL | NULL    | NULL | 9895 |   100.00 | NULL                          |
|  1 | SIMPLE      | s2    | NULL       | ALL  | NULL          | NULL | NULL    | NULL | 9895 |   100.00 | Using join buffer (hash join) |
+----+-------------+-------+------------+------+---------------+------+---------+------+------+----------+-------------------------------+
2 rows in set, 1 warning (0.00 sec)

mysql>
可以看到,上述连接查询中参与连接的s1和s2表分别对应一条记录,但是这两条记录对应的id值都是1。这里需要记住的是,在连接查询的执行计划中,每个表都会对应一条记录,这些记录的id列的值是相同的,出现在前边的表表示驱动表,出现在后边的表表示被驱动表。所以从上边的EXPLAIN输出中我们可以看出,查询优化器准备让s1表作为驱动表,让s2表作为被驱动表来执行查询。
对于包含子查询的查询语句来说,就可能涉及多个SELECT关键字,所以在包含子查询的查询语句的执行计划中,每个SELECT关键字都会对应一个唯一的id值,比如这样:
mysql> EXPLAIN SELECT * FROM s1 WHERE key1 IN (SELECT key1 FROM s2) OR key3 = 'a';
+----+-------------+-------+------------+-------+---------------+----------+---------+------+------+----------+-------------+
| id | select_type | table | partitions | type  | possible_keys | key      | key_len | ref  | rows | filtered | Extra       |
+----+-------------+-------+------------+-------+---------------+----------+---------+------+------+----------+-------------+
|  1 | PRIMARY     | s1    | NULL       | ALL   | idx_key3      | NULL     | NULL    | NULL | 9895 |   100.00 | Using where |
|  2 | SUBQUERY    | s2    | NULL       | index | idx_key1      | idx_key1 | 303     | NULL | 9895 |   100.00 | Using index |
+----+-------------+-------+------------+-------+---------------+----------+---------+------+------+----------+-------------+
2 rows in set, 1 warning (0.01 sec)

mysql>
从输出结果中我们可以看到,s1表在外层查询中,外层查询有一个独立的SELECT关键字,所以第一条记录的id值就是1,s2表在子查询中,子查询有一个独立的SELECT关键字,所以第二条记录的id值就是2。
但是需要特别注意,查询优化器可能对涉及子查询的查询语句进行重写,从而转换为连接查询。所以如果我们想知道查询优化器对某个包含子查询的语句是否进行了重写,直接查看执行计划就好了,比如说:
mysql> EXPLAIN SELECT * FROM s1 WHERE key1 IN (SELECT key2 FROM s2 WHERE common_field = 'a');
+----+-------------+-------+------------+--------+---------------+----------+---------+-----------------+------+----------+------------------------------------+
| id | select_type | table | partitions | type   | possible_keys | key      | key_len | ref             | rows | filtered | Extra                              |
+----+-------------+-------+------------+--------+---------------+----------+---------+-----------------+------+----------+------------------------------------+
|  1 | SIMPLE      | s1    | NULL       | ALL    | idx_key1      | NULL     | NULL    | NULL            | 9895 |   100.00 | Using where                        |
|  1 | SIMPLE      | s2    | NULL       | eq_ref | idx_key2      | idx_key2 | 5       | dbtest2.s1.key1 |    1 |    10.00 | Using index condition; Using where |
+----+-------------+-------+------------+--------+---------------+----------+---------+-----------------+------+----------+------------------------------------+
2 rows in set, 2 warnings (0.00 sec)

mysql>
可以看到,虽然我们的查询语句是一个子查询,但是执行计划中s1和s2表对应的记录的id值全部是1,这就表明了查询优化器将子查询转换为了连接查询。
对于包含UNION子句的查询语句来说,每个SELECT关键字对应一个id值也是没错的,不过还是有点儿特别的东西,比方说下边这个查询:
mysql> EXPLAIN SELECT * FROM s1 UNION SELECT * FROM s2;
+----+--------------+------------+------------+------+---------------+------+---------+------+------+----------+-----------------+
| id | select_type  | table      | partitions | type | possible_keys | key  | key_len | ref  | rows | filtered | Extra           |
+----+--------------+------------+------------+------+---------------+------+---------+------+------+----------+-----------------+
|  1 | PRIMARY      | s1         | NULL       | ALL  | NULL          | NULL | NULL    | NULL | 9895 |   100.00 | NULL            |
|  2 | UNION        | s2         | NULL       | ALL  | NULL          | NULL | NULL    | NULL | 9895 |   100.00 | NULL            |
| NULL | UNION RESULT | <union1,2> | NULL       | ALL  | NULL          | NULL | NULL    | NULL | NULL |     NULL | Using temporary |
+----+--------------+------------+------------+------+---------------+------+---------+------+------+----------+-----------------+
3 rows in set, 1 warning (0.00 sec)

mysql>
这个语句的执计划的第三条记录是什么?为何id值是NULL,而且table列也很奇怪?UNION!它会把多个查询的结果集合并起来并对结果集中的记录进行去重,怎么去重呢?MySQL使用的是内部的临时表。正如上边的查询计划中所示,UNION子句是为了把id为1的查询和id为2的查询的结果集合并起来并去重,所以在内部创建了一个名为<union1,2>的临时表(就是执行计划第三条记录的table列的名称),id为NULL表明这个临时表是为了合并两个查询的结果集而创建的。
跟UNION对比起来,UNION ALL就不需要为最终的结果集进行去重,它只是单纯的把多个查询的结果集中的记录合并成一个并返回给用户,所以也就不需要使用临时表。所以在包含UNION ALL子句的查询的执行计划中,就没有那个id为NULL的记录,如下所示:
mysql> EXPLAIN SELECT * FROM s1  UNION ALL SELECT * FROM s2;
+----+-------------+-------+------------+------+---------------+------+---------+------+------+----------+-------+
| id | select_type | table | partitions | type | possible_keys | key  | key_len | ref  | rows | filtered | Extra |
+----+-------------+-------+------------+------+---------------+------+---------+------+------+----------+-------+
|  1 | PRIMARY     | s1    | NULL       | ALL  | NULL          | NULL | NULL    | NULL | 9895 |   100.00 | NULL  |
|  2 | UNION       | s2    | NULL       | ALL  | NULL          | NULL | NULL    | NULL | 9895 |   100.00 | NULL  |
+----+-------------+-------+------------+------+---------------+------+---------+------+------+----------+-------+
2 rows in set, 1 warning (0.00 sec)

mysql>
小结:
id如果相同,可以认为是一组,从上往下顺序执行在所有组中,id值越大,优先级越高,越先执行关注点:id号每个号码,表示一趟独立的查询,一个sql的查询趟数越少越好
3、select_type
一条大的查询语句里边可以包含若干个SELECT关键字,每个SELECT关键字代表着一个小的查询语句,而每个SELECT关键字的FROM子句中都可以包含若干张表(这些表用来做连接查询),每一张表都对应着执行计划输出中的一条记录,对于在同一个SELECT关键字中的表来说,它们的id值是相同的。
MySQL为每一个SELECT关键字代表的小查询都定义了一个称之为select_type的属性,意思是我们只要知道了某个小查询的select_type属性,就知道了这个小查询在整个大查询中扮演了一个什么角,我们看下select_type都能取哪些值,请看官方文档:
| 名称 | 描述 |
|---|---|
| SIMPLE | Simple SELECT (not using UNION or subqueries) |
| PRIMARY | Outermost SELECT |
| UNION | Second or later SELECT statement in a UNION |
| UNION RESULT | Result of a UNION |
| SUBQUERY | First SELECT in subquery |
| DEPENDENT SUBQUERY | First SELECT in subquery, dependent on outer query |
| DEPENDENT UNION | Second or later SELECT statement in a UNION, dependent on outer query |
| DERIVED | Derived table |
| MATERIALIZED | Materialized subquery |
| UNCACHEABLE SUBQUERY | A subquery for which the result cannot be cached and must be re-evaluated for each rowof the outer query |
| UNCACHEABLE UNION | The second or later select in a UNION that belongs to an uncacheable subquery (seeUNCACHEABLE SUBQUERY) |
-
SIMPLE
查询语句中不包含UNION或者子查询的查询都算作是SIMPLE类型,比方说下边这个单表查询的select_type的值就是SIMPLE:mysql> explain select * from s1; +----+-------------+-------+------------+------+---------------+------+---------+------+------+----------+-------+ | id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra | +----+-------------+-------+------------+------+---------------+------+---------+------+------+----------+-------+ | 1 | SIMPLE | s1 | NULL | ALL | NULL | NULL | NULL | NULL | 9895 | 100.00 | NULL | +----+-------------+-------+------------+------+---------------+------+---------+------+------+----------+-------+ 1 row in set, 1 warning (0.00 sec) mysql>当然,连接查询也算是SIMPLE 类型,比如:
mysql> explain select * from s1 inner join s2; +----+-------------+-------+------------+------+---------------+------+---------+------+------+----------+-------------------------------+ | id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra | +----+-------------+-------+------------+------+---------------+------+---------+------+------+----------+-------------------------------+ | 1 | SIMPLE | s1 | NULL | ALL | NULL | NULL | NULL | NULL | 9895 | 100.00 | NULL | | 1 | SIMPLE | s2 | NULL | ALL | NULL | NULL | NULL | NULL | 9895 | 100.00 | Using join buffer (hash join) | +----+-------------+-------+------------+------+---------------+------+---------+------+------+----------+-------------------------------+ 2 rows in set, 1 warning (0.00 sec) mysql> -
PRIMARY
对于包含UNION、UNION ALL或者子查询的大查询来说,它是由几个小查询组成的,其中最左边的那个查询的select_type值就是PRIMARY,比说:mysql> explain select * from s1 union select * from s2; +----+--------------+------------+------------+------+---------------+------+---------+------+------+----------+-----------------+ | id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra | +----+--------------+------------+------------+------+---------------+------+---------+------+------+----------+-----------------+ | 1 | PRIMARY | s1 | NULL | ALL | NULL | NULL | NULL | NULL | 9895 | 100.00 | NULL | | 2 | UNION | s2 | NULL | ALL | NULL | NULL | NULL | NULL | 9895 | 100.00 | NULL | | NULL | UNION RESULT | <union1,2> | NULL | ALL | NULL | NULL | NULL | NULL | NULL | NULL | Using temporary | +----+--------------+------------+------------+------+---------------+------+---------+------+------+----------+-----------------+ 3 rows in set, 1 warning (0.00 sec) mysql>从结果中可以看到,最左边的小查询
SELECT * FROM s1对应的是执行计划中的第一条记录,它的select_type值就是PRIMARY。 -
UNION
对于包含UNION或者UNION ALL的大查询来说,它是由几个小查询组成的,其中除了最左边的那个小查询以外,其余的小查询的select_type值就是UNION,可以对比上一个例子的效果。 -
UNION RESULT
MySQL选择使用临时表来完成UNION查询的去重工作,针对该临时表的查询的select_type就是UNION RESULT,例子上边有。 -
SUBQUERY
如果包含子查询的查询语句不能够转为对应的“多表连接”的形式,并且该子查询是不相关子查询(能独立查询,不依赖外层),并且查询优化器决定采用将该子查询物化的方案来执行该子查询时,该子查询的第一个SELECT关键字代表的那个查询的select_type就是SUBQUERY,比如下边这个查询:mysql> EXPLAIN SELECT * FROM s1 WHERE key1 IN (SELECT key1 FROM s2) OR key3 = 'a'; +----+-------------+-------+------------+-------+---------------+----------+---------+------+------+----------+-------------+ | id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra | +----+-------------+-------+------------+-------+---------------+----------+---------+------+------+----------+-------------+ | 1 | PRIMARY | s1 | NULL | ALL | idx_key3 | NULL | NULL | NULL | 9895 | 100.00 | Using where | | 2 | SUBQUERY | s2 | NULL | index | idx_key1 | idx_key1 | 303 | NULL | 9895 | 100.00 | Using index | +----+-------------+-------+------------+-------+---------------+----------+---------+------+------+----------+-------------+ 2 rows in set, 1 warning (0.00 sec) mysql> -
DEPENDENT SUBQUERY
如果包含子查询的查询语句不能够转为对应的“多表连接”的形式,并且该子查询是相关子查询(不能独立查询,依赖外层),则该子查询的第个SELECT关键字代表的那个查询的select_type就是DEPENDENT SUBQUERY,比如下边这个查询:mysql> EXPLAIN SELECT * FROM s1 WHERE key1 IN (SELECT key1 FROM s2 WHERE s1.key2 = s2.key2) OR key3 = 'a'; +----+--------------------+-------+------------+--------+-------------------+----------+---------+-----------------+------+----------+-------------+ | id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra | +----+--------------------+-------+------------+--------+-------------------+----------+---------+-----------------+------+----------+-------------+ | 1 | PRIMARY | s1 | NULL | ALL | idx_key3 | NULL | NULL | NULL | 9895 | 100.00 | Using where | | 2 | DEPENDENT SUBQUERY | s2 | NULL | eq_ref | idx_key2,idx_key1 | idx_key2 | 5 | dbtest2.s1.key2 | 1 | 10.00 | Using where | +----+--------------------+-------+------------+--------+-------------------+----------+---------+-----------------+------+----------+-------------+ 2 rows in set, 2 warnings (0.00 sec) mysql>需要注意的是,
select_type为DEPENDENT SUBQUERY的查询可能会被执行多次。 -
DEPENDENT UNION
在包含UNION或者UNION ALL的大查询中,如果各个小查询都依赖于外层查询的话,那除了最左边的那个小查询之外,其余的查询的select_type的值就是DEPENDENT UNION。比说下边这个查询:mysql> EXPLAIN SELECT * FROM s1 WHERE key1 IN (SELECT key1 FROM s2 WHERE key1 = 'a' UNION SELECT key1 FROM s1 WHERE key1 = 'b'); +----+--------------------+------------+------------+------+---------------+----------+---------+-------+------+----------+--------------------------+ | id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra | +----+--------------------+------------+------------+------+---------------+----------+---------+-------+------+----------+--------------------------+ | 1 | PRIMARY | s1 | NULL | ALL | NULL | NULL | NULL | NULL | 9895 | 100.00 | Using where | | 2 | DEPENDENT SUBQUERY | s2 | NULL | ref | idx_key1 | idx_key1 | 303 | const | 1 | 100.00 | Using where; Using index | | 3 | DEPENDENT UNION | s1 | NULL | ref | idx_key1 | idx_key1 | 303 | const | 1 | 100.00 | Using where; Using index | | NULL | UNION RESULT | <union2,3> | NULL | ALL | NULL | NULL | NULL | NULL | NULL | NULL | Using temporary | +----+--------------------+------------+------------+------+---------------+----------+---------+-------+------+----------+--------------------------+ 4 rows in set, 1 warning (0.00 sec) mysql>这个查询比较复杂,大查询里包含了一个子查询,子查询里又是由
UNION连起来的两个小查询。从执行计划中可以看出来,SELECT key1 FROM s2 WHERE key1 = 'a'这个小查询由于是查询中第一个查询,所以它的select_type是DEPENDENT SUBQUERY,SELECT key1 FROM s1 WHERE key1 = 'b'这个查询的select_type就是DEPENDENT UNION。 -
DERIVED
对于采用物化的方式执行的包含派生表的查询,该派生表对应的子查询的select_type就是DERIVED,比方说下边这个查询:mysql> EXPLAIN SELECT * FROM (SELECT key1, COUNT(*) AS c FROM s1 GROUP BY key1) AS derived_s1 WHERE c > 1; +----+-------------+------------+------------+-------+---------------+----------+---------+------+------+----------+-------------+ | id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra | +----+-------------+------------+------------+-------+---------------+----------+---------+------+------+----------+-------------+ | 1 | PRIMARY | <derived2> | NULL | ALL | NULL | NULL | NULL | NULL | 9895 | 100.00 | NULL | | 2 | DERIVED | s1 | NULL | index | idx_key1 | idx_key1 | 303 | NULL | 9895 | 100.00 | Using index | +----+-------------+------------+------------+-------+---------------+----------+---------+------+------+----------+-------------+ 2 rows in set, 1 warning (0.00 sec) mysql>从执行计划中可以看出,id为2的记录就代表子查询的执行方式,它的
select_type是DERIVED,说明该子查询是以物化的方式执行的。id为1的记录代表外层查询,注意看它的table列显示的是<derived2>,表示该查询是针对将派生表物化之后的表进行查询的。被包在 FROM () 括号里 → 这叫【派生表】比如derived_s1
派生表 → 对应的select_type就是DERIVED
括号里生成的临时表 = DERIVED,MySQL 必须:- 先执行括号里的查询(id=2,DERIVED)
- 把结果存成一张临时表
- 再对外层查询(id=1,PRIMARY)
为什么给派生表起了个别名
derived_s1,但是mysql没有用而是用的derived2
答:起的别名 derived_s1 是给 SQL 语法用的,不是给执行计划用的!执行计划里永远用<derived+id>,不会显示自定义的别名!derived = 派生表。2 = 来自 id=2 的查询,如果这个派生表是id为3的第三条执行计划生成的,那么名字就是derived3小贴士:如果派生表可以通过和外层查询合并的方式执行的话,执行计划又是另一番景象,不妨可以试试
-
MATERIALIZED
当查询优化器在执行包含子查询的语句时,选择将子查询物化之后与外层查询进行连接查询时,该子查询对应的select_type属性就是MATERIALIZED,比如下边这个查询:mysql> EXPLAIN SELECT * FROM s1 WHERE key1 IN (SELECT key1 FROM s2); #子查询被转为了物化表 +----+--------------+-------------+------------+--------+---------------------+---------------------+---------+-----------------+------+----------+-------------+ | id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra | +----+--------------+-------------+------------+--------+---------------------+---------------------+---------+-----------------+------+----------+-------------+ | 1 | SIMPLE | s1 | NULL | ALL | idx_key1 | NULL | NULL | NULL | 9895 | 100.00 | Using where | | 1 | SIMPLE | <subquery2> | NULL | eq_ref | <auto_distinct_key> | <auto_distinct_key> | 303 | dbtest2.s1.key1 | 1 | 100.00 | NULL | | 2 | MATERIALIZED | s2 | NULL | index | idx_key1 | idx_key1 | 303 | NULL | 9895 | 100.00 | Using index | +----+--------------+-------------+------------+--------+---------------------+---------------------+---------+-----------------+------+----------+-------------+ 3 rows in set, 1 warning (0.00 sec) mysql>执行计划的第三条记录的id值为2,说明该条记录对应的是一个单表查询,从它的
select_type值为
MATERIALIZED可以看出,查询优化器是要把子查询先转换成物化表。然后看执行计划的前两条记录的id值都为1,说明这两条记录对应的表进行连接查询,需要注意的是第二条记录的table列的值是
<subquery2>,说明该表其实就是id为2对应的子查询执之后产生的物化表,然后将s1和该物化表进连接查询。subquery2: id = 2 的那条查询生成的【
物化临时表】,和DERIVED里面的的 <derived2>几乎一个道理,只是名字换了下!- subquery = 子查询
- 2 = 来自 id = 2 的查询结果
下面这两个不常遇见,就省略了
- UNCACHEABLE SUBQUERY
不常用 - UNCACHEABLE UNION
不常用
小结
- SIMPLE:最简单的查询
- 没有 UNION
- 没有子查询
- 就是单表查询,或者普通 JOIN
- 一句话:干干净净一条 SELECT
- PRIMARY:最外层、最外面的那个SELECT。一般出现在:
- 有子查询
- 有 UNION
最外面那层查询,标记为 PRIMARY。
- UNION:UNION里,排在后面的SELECT
SELECT ...    -- PRIMARY 或 SIMPLE
UNION
SELECT ...    --  UNION
-
UNION RESULT:MySQL 把 UNION 结果
合并、去重的临时表- 执行计划里专门一行,表示 “合并完成”。
-
SUBQUERY:普通子查询
- 子查询里的第一个 SELECT,不依赖外层表,能先独立执行完。比如:
SELECT * FROM t1
WHERE id = (SELECT id FROM t2)
括号里的就是 SUBQUERY。
- 子查询里的第一个 SELECT,不依赖外层表,能先独立执行完。比如:
-
DEPENDENT SUBQUERY:相关子查询 / 依赖子查询
- 子查询
依赖外层查询的数据,不能先一次性跑完,要逐行执行,性能通常很差。比如:SELECT * FROM t1 WHERE EXISTS (SELECT 1 FROM t2 WHERE t2.id=t1.id)子查询用到了 t1.id,必须等外层 t1 每一行出来才能查。
- 子查询
-
DEPENDENT UNION
- UNION 里的后面查询,同时又属于相关子查询,依赖外层。
-
DERIVED:派生表
- FROM 子句里的子查询,生成一张临时表。
SELECT *
FROM (SELECT * FROM t1) AS t;
括号里这层就是 DERIVED
- FROM 子句里的子查询,生成一张临时表。
-
MATERIALIZED:物化子查询
- MySQL 把子查询结果存成一张临时表,用来优化,比 DERIVED 更智能。
-
UNCACHEABLE SUBQUERY
- 不能缓存的子查询每次外层行变了,子查询都必须重新执行,无法复用结果,
性能极烂。
- 不能缓存的子查询每次外层行变了,子查询都必须重新执行,无法复用结果,
-
UNCACHEABLE UNION
- UNION 中的查询,属于不能缓存的子查询。
极简速记
- SIMPLE:普通查询
- PRIMARY:最外层查询
- SUBQUERY:普通子查询
- DEPENDENT SUBQUERY:相关子查询
(慢,要优化) - DERIVED:from 里的子查询(派生表)
- UNION / UNION RESULT:联合查询
4、partitions
代表分区表中的命中情况,非分区表,该项为NULL。一般情况下我们的查询语句的执行计划的partitions列的值都是NULL。
表示查询将在哪些分区表的分区上进行数据检索。
- NULL:表没有使用分区(非分区表),
最常见的默认值 - 具体分区名称 / 多个分区名:表是分区表,显示这条查询命中、需要扫描的分区列表,多个分区用逗号分隔
创建分区表:
CREATE TABLE user_partitions (
	id INT AUTO_INCREMENT,
	NAME VARCHAR(12),
	PRIMARY KEY(id))
	PARTITION BY RANGE(id)(		#按照 id 的数值范围来分区
		PARTITION p0 VALUES LESS THAN(100),	#创建一个叫 p0 的分区,存储所有 id 小于 100 的数据
		PARTITION p1 VALUES LESS THAN MAXVALUE	#创建一个叫 p1 的分区,存储剩下所有数据(兜底)
);

#这是一张 按 id 范围分区的用户表数据会自动放进两个分区里:
	id < 100 → 放 p0
	其他所有 id → 放 p1
插入数据时:
   id=50 → 自动进 p0
    id=99 → 自动进 p0
    id=100 → 自动进 p1
    id=1000 → 自动进 p1
    id=999999 → 自动进 p1
查询id大于200(200>100,p1分区)的记录,查看执行计划,partitions是p1,符合我们的分区规则
mysql> DESC SELECT * FROM user_partitions WHERE id>200;
+----+-------------+-----------------+------------+-------+---------------+---------+---------+------+------+----------+-------------+
| id | select_type | table           | partitions | type  | possible_keys | key     | key_len | ref  | rows | filtered | Extra       |
+----+-------------+-----------------+------------+-------+---------------+---------+---------+------+------+----------+-------------+
|  1 | SIMPLE      | user_partitions | p1         | range | PRIMARY       | PRIMARY | 4       | NULL |    1 |   100.00 | Using where |
+----+-------------+-----------------+------------+-------+---------------+---------+---------+------+------+----------+-------------+
1 row in set, 1 warning (0.00 sec)
5、tpye☆
执行计划的一条记录就代表着MySQL对某个表的执行查询时的访间方法,又称“访问类型”,其中的type列就表明了这个访问方法是啥,是较为重要的一个指标。比如,看到type列的值是ref,表明MySQL即将使用ref访问方法来执行对s1表的查询。
完整的访问方法如下:system > const > eq_ref > ref > fulltext > ref_or_null > index_merge > unique_subquery > index_subquery > range > index > ALLL,越靠前,越是期望值,最糟糕的就是ALL。ALL:全表扫描,从头到尾把整张表遍历一遍,一行一行检查是否符合WHERE条件。
| 名称 | 描述 |
|---|---|
| system | 性能:顶级。 表只有 1 行(系统表 / 极小数表)。日常基本见不到 |
| const | 性能:优秀 。主键 / 唯一索引,只查一行。速度极快 |
| eq_ref | 性能:优秀。JOIN 关联,被驱动表用主键 / 唯一索引。一行对一行,极快 |
| ref | 性能:优秀。普通索引等值查询(=)。速度很快 |
| fulltext | 性能:特殊优秀。全文索引(MATCH AGAINST)。业务场景专用,不在普通索引排序里 |
| ref_or_null | 性能:优秀 → 良好。和 ref 差不多,只是多查了 NULL。效率接近 ref |
| index_merge | 性能:良好。同时用多个索引,合并结果。常见于 OR 查询。效率不如 ref,但比 range 强 |
| unique_subquery | 性能:良好。IN 子查询内部用到唯一索引。效率接近 eq_ref |
| index_subquery | 性能:一般。IN 子查询内部用到普通索引。效率接近 ref,但稍弱 |
| range | 性能:良好。索引范围查询(> < between in 等)。优化合格线 |
| index | 性能:很差。索引全扫描。只比全表扫描强一点 |
| ALL | 性能:最差。全表扫描、必须优化 |
-
system
当表中只有一条记录并且该表使用的存储引擎的统计数据是精确的,比如MyISAM、Memory,那么对该表的访问方法就是system。比方说我们新建一个存储引擎为MyISAM的表,并为其插入一条记录:mysql> CREATE TABLE t(i int) Engine=MyISAM; Query OK, 0 rows affected (0.01 sec) mysql> INSERT INTO t VALUES(1); Query OK, 1 row affected (0.01 sec) mysql>然后我们看一下查询这个表的执行计划:
mysql> DESC SELECT * FROM t;
+----+-------------+-------+------------+--------+---------------+------+---------+------+------+----------+-------+
| id | select_type | table | partitions | type   | possible_keys | key  | key_len | ref  | rows | filtered | Extra |
+----+-------------+-------+------------+--------+---------------+------+---------+------+------+----------+-------+
|  1 | SIMPLE      | t     | NULL       | system | NULL          | NULL | NULL    | NULL |    1 |   100.00 | NULL  |
+----+-------------+-------+------------+--------+---------------+------+---------+------+------+----------+-------+
1 row in set, 1 warning (0.00 sec)

mysql> INSERT INTO t VALUES(1);
Query OK, 1 row affected (0.00 sec)

mysql> DESC SELECT * FROM t;
+----+-------------+-------+------------+------+---------------+------+---------+------+------+----------+-------+
| id | select_type | table | partitions | type | possible_keys | key  | key_len | ref  | rows | filtered | Extra |
+----+-------------+-------+------------+------+---------------+------+---------+------+------+----------+-------+
|  1 | SIMPLE      | t     | NULL       | ALL  | NULL          | NULL | NULL    | NULL |    2 |   100.00 | NULL  |
+----+-------------+-------+------------+------+---------------+------+---------+------+------+----------+-------+
1 row in set, 1 warning (0.00 sec)
表只有 1 行,MySQL 不用 “扫描”,直接读取这一行,优化器直接当成常量处理,所以是system 。system 是 MySQL 对「
表只有 1 行」的特殊优化。一旦表变成 >1 行,这个特殊优化消失。上面添加第二条数据就变成ALL是为什么?
答:一旦表里 ≥2 行数据:system 这个特殊优化立刻失效,但是t表没有任何索引,MySQL 只能从头到尾扫描每一行,所以变成了ALL。InooDB中:
mysql>  CREATE TABLE tt(i INT) ENGINE=INNODB;
Query OK, 0 rows affected (0.01 sec)

mysql>  INSERT INTO tt VALUES(1);
Query OK, 1 row affected (0.01 sec)

mysql> EXPLAIN SELECT * FROM tt;
+----+-------------+-------+------------+------+---------------+------+---------+------+------+----------+-------+
| id | select_type | table | partitions | type | possible_keys | key  | key_len | ref  | rows | filtered | Extra |
+----+-------------+-------+------------+------+---------------+------+---------+------+------+----------+-------+
|  1 | SIMPLE      | tt    | NULL       | ALL  | NULL          | NULL | NULL    | NULL |    1 |   100.00 | NULL  |
+----+-------------+-------+------------+------+---------------+------+---------+------+------+----------+-------+
1 row in set, 1 warning (0.00 sec)

mysql>
为什么 InnoDB 1 行 = ALL?(重点!)
t表的存储引擎是MyISAM,MyISAM 会把表总行数存在元数据里,表里几行,MySQL 瞬间知道,只有 1 行 → 直接给 system 最优级别。而InnoDB 不存总行数!InnoDB 为了事务、MVCC 并发,不缓存表有多少行,必须去扫一下表才知道有几行,所以:哪怕只有 1 行,InnoDB 也要扫一遍表 → type=ALLMySQL 官方规则:
InnoDB 表永远不会出现 system只有 MyISAM、Memory 表才会有 system。system 只在【表只有 1 行】时出现,多一行都不行!
下面是上面数据准备章节中的表的索引结构,用来解释下面剩下的几列参数的
#s1
PRIMARY KEY (id)             -- 主键索引(聚簇索引)
UNIQUE KEY idx_key2 (key2)    -- 唯一二级索引
KEY idx_key1 (key1)           -- 普通二级索引
KEY idx_key3 (key3)           -- 普通二级索引
KEY idx_key_part (key_part1, key_part2, key_part3)
                              -- 普通联合二级索引

#s2
PRIMARY KEY (id)             -- 主键索引(聚簇索引)
UNIQUE KEY idx_key2 (key2)    -- 唯一二级索引
KEY idx_key1 (key1)           -- 普通二级索引
KEY idx_key3 (key3)           -- 普通二级索引
KEY idx_key_part (key_part1, key_part2, key_part3)
                              -- 普通联合二级索引
- const
当我们根据主键或者唯一二级索引列与常数进行等值匹配时,对单表的访问方法就是const
主键等值匹配、唯一索引等值匹配,type 一律是 const!mysql> EXPLAIN SELECT * FROM s1 WHERE id = 10005; +----+-------------+-------+------------+-------+---------------+---------+---------+-------+------+----------+-------+ | id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra | +----+-------------+-------+------------+-------+---------------+---------+---------+-------+------+----------+-------+ | 1 | SIMPLE | s1 | NULL | const | PRIMARY | PRIMARY | 4 | const | 1 | 100.00 | NULL | +----+-------------+-------+------------+-------+---------------+---------+---------+-------+------+----------+-------+ 1 row in set, 1 warning (0.00 sec) mysql> EXPLAIN SELECT * FROM s1 WHERE key2 = 10066; +----+-------------+-------+------------+-------+---------------+----------+---------+-------+------+----------+-------+ | id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra | +----+-------------+-------+------------+-------+---------------+----------+---------+-------+------+----------+-------+ | 1 | SIMPLE | s1 | NULL | const | idx_key2 | idx_key2 | 5 | const | 1 | 100.00 | NULL | +----+-------------+-------+------------+-------+---------------+----------+---------+-------+------+----------+-------+ 1 row in set, 1 warning (0.00 sec) mysql> - eq_ref
在连接查询时,如果被驱动表是通过主键或者唯一二级索引列等值匹配的方式进行访问的(如果该主键或者唯一二级索引是联合索引的话,所有的索引列都必须进行等值比较),则对该被驱动表的访问方法就是eq_ref
join 时,被驱动表用 主键 / 唯一二级索引 做等值匹配,一次只匹配 1 行它是 join 查询性能最好的 type!mysql> EXPLAIN SELECT * FROM s1 INNER JOIN s2 ON s1.id = s2.id; +----+-------------+-------+------------+--------+---------------+---------+---------+---------------+------+----------+-------+ | id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra | +----+-------------+-------+------------+--------+---------------+---------+---------+---------------+------+----------+-------+ | 1 | SIMPLE | s1 | NULL | ALL | PRIMARY | NULL | NULL | NULL | 9895 | 100.00 | NULL | | 1 | SIMPLE | s2 | NULL | eq_ref | PRIMARY | PRIMARY | 4 | dbtest2.s1.id | 1 | 100.00 | NULL | +----+-------------+-------+------------+--------+---------------+---------+---------+---------------+------+----------+-------+ 2 rows in set, 1 warning (0.00 sec) mysql> - ref
当通过普通的二级索引列与常量进行等值匹配时来查询某个表,那么对该表的访问方法就可能是ref
普通二级索引 + 等值匹配 = type = refmysql> EXPLAIN SELECT * FROM s1 WHERE key1 = 'a'; +----+-------------+-------+------------+------+---------------+----------+---------+-------+------+----------+-------+ | id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra | +----+-------------+-------+------------+------+---------------+----------+---------+-------+------+----------+-------+ | 1 | SIMPLE | s1 | NULL | ref | idx_key1 | idx_key1 | 303 | const | 1 | 100.00 | NULL | +----+-------------+-------+------------+------+---------------+----------+---------+-------+------+----------+-------+ 1 row in set, 1 warning (0.00 sec) mysql> - fulltext
对建立了 FULLTEXT 全文索引的字段使用 MATCH…AGAINST 进行全文检索时,表的访问类型为 fulltext,专门用于高效的全文搜索场景。mysql> ALTER TABLE s1 ADD FULLTEXT INDEX ft_common_field (common_field); Query OK, 0 rows affected (0.23 sec) Records: 0 Duplicates: 0 Warnings: 0 mysql> EXPLAIN SELECT * FROM s1 WHERE MATCH(common_field) AGAINST('test'); +----+-------------+-------+------------+----------+-----------------+-----------------+---------+-------+------+----------+-------------------------------+ | id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra | +----+-------------+-------+------------+----------+-----------------+-----------------+---------+-------+------+----------+-------------------------------+ | 1 | SIMPLE | s1 | NULL | fulltext | ft_common_field | ft_common_field | 0 | const | 1 | 100.00 | Using where; Ft_hints: sorted | +----+-------------+-------+------------+----------+-----------------+-----------------+---------+-------+------+----------+-------------------------------+ 1 row in set, 1 warning (0.00 sec) mysql> - ref_or_null
当对普通二级索引进行等值匹配查询,该索引列的值也可以是NULL值时,那么对该表的访问方法就可能是ref_or_null
普通二级索引 + 等值匹配 + 允许查 NULL = ref_or_nullmysql> EXPLAIN SELECT * FROM s1 WHERE key1 = 'a' OR key1 IS NULL; +----+-------------+-------+------------+-------------+---------------+----------+---------+-------+------+----------+-----------------------+ | id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra | +----+-------------+-------+------------+-------------+---------------+----------+---------+-------+------+----------+-----------------------+ | 1 | SIMPLE | s1 | NULL | ref_or_null | idx_key1 | idx_key1 | 303 | const | 2 | 100.00 | Using index condition | +----+-------------+-------+------------+-------------+---------------+----------+---------+-------+------+----------+-----------------------+ 1 row in set, 1 warning (0.00 sec) mysql> - index_merge(索引合并)
单表访问方法时在某些场景下可以使用Intersection、Union、Sort-Union这三种索引合并的方式来执行查询- Intersection:交集(并且 AND):WHERE key1 = ‘a’ AND key3 = ‘b’
- Union:并集(或者 OR):WHERE key1 = ‘a’ OR key3 = ‘a’
- Sort-Union:OR 但需要先排序再合并:WHERE key1 < ‘a’ OR key3 < ‘a’
用 OR 连接多个条件,每个条件都有自己的独立索引,MySQL 就会同时使用多个索引 → index_merge(索引合并)mysql> EXPLAIN SELECT * FROM s1 WHERE key1 = 'a' OR key3 = 'a'; +----+-------------+-------+------------+-------------+-------------------+-------------------+---------+------+------+----------+---------------------------------------------+ | id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra | +----+-------------+-------+------------+-------------+-------------------+-------------------+---------+------+------+----------+---------------------------------------------+ | 1 | SIMPLE | s1 | NULL | index_merge | idx_key1,idx_key3 | idx_key1,idx_key3 | 303,303 | NULL | 2 | 100.00 | Using union(idx_key1,idx_key3); Using where | +----+-------------+-------+------------+-------------+-------------------+-------------------+---------+------+------+----------+---------------------------------------------+ 1 row in set, 1 warning (0.00 sec) mysql> - unique_subquery
类似于两表连接中被驱动表的eq_ref访问方法,unique_subquery类似是针对在一些包含IN子查询的查询语句中,如果查询优化器决定将IN子查询转换为EXISTS子查询,而且子查询可以使用到主键进行等值匹配的话,那么该子查询执行计划的type列的值就是unique_subquery
IN 子查询 + 子查询用主键匹配 = type = unique_subquerymysql> EXPLAIN SELECT * FROM s1 WHERE key2 IN (SELECT id FROM s2 WHERE s1.key1 = s2.key1) OR key3 = 'a'; +----+--------------------+-------+------------+-----------------+------------------+---------+---------+------+------+----------+-------------+ | id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra | +----+--------------------+-------+------------+-----------------+------------------+---------+---------+------+------+----------+-------------+ | 1 | PRIMARY | s1 | NULL | ALL | idx_key3 | NULL | NULL | NULL | 9895 | 100.00 | Using where | | 2 | DEPENDENT SUBQUERY | s2 | NULL | unique_subquery | PRIMARY,idx_key1 | PRIMARY | 4 | func | 1 | 10.00 | Using where | +----+--------------------+-------+------------+-----------------+------------------+---------+---------+------+------+----------+-------------+ 2 rows in set, 2 warnings (0.00 sec) mysql> - index_subquery
index_subquery与unique_subquery类似,只不过访问子查询中的表时使用的是普通的索引。 - range
如果使用索引获取某些范围区间的记录,那么就可能使用到range访问方法
IN、BETWEEN、>、<、>=、<= 这类 “范围类” 查询,只要走索引,type 一律是 range。mysql> EXPLAIN SELECT * FROM s1 WHERE key1 IN ('a', 'b', 'c'); +----+-------------+-------+------------+-------+---------------+----------+---------+------+------+----------+-----------------------+ | id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra | +----+-------------+-------+------------+-------+---------------+----------+---------+------+------+----------+-----------------------+ | 1 | SIMPLE | s1 | NULL | range | idx_key1 | idx_key1 | 303 | NULL | 3 | 100.00 | Using index condition | +----+-------------+-------+------------+-------+---------------+----------+---------+------+------+----------+-----------------------+ 1 row in set, 1 warning (0.00 sec) mysql> EXPLAIN SELECT * FROM s1 WHERE key1 > 'a' AND key1 < 'b'; +----+-------------+-------+------------+-------+---------------+----------+---------+------+------+----------+-----------------------+ | id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra | +----+-------------+-------+------------+-------+---------------+----------+---------+------+------+----------+-----------------------+ | 1 | SIMPLE | s1 | NULL | range | idx_key1 | idx_key1 | 303 | NULL | 366 | 100.00 | Using index condition | +----+-------------+-------+------------+-------+---------------+----------+---------+------+------+----------+-----------------------+ 1 row in set, 1 warning (0.00 sec) mysql> - index
当我们可以使用索引覆盖,但需要扫描全部的索引记录时,该表的访问方法就是index
能用到索引覆盖,但因为索引顺序不对,无法快速查找,只能全索引遍历 → type = indexmysql> EXPLAIN SELECT key_part2 FROM s1 WHERE key_part3 = 'a'; +----+-------------+-------+------------+-------+---------------+--------------+---------+------+------+----------+--------------------------+ | id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra | +----+-------------+-------+------------+-------+---------------+--------------+---------+------+------+----------+--------------------------+ | 1 | SIMPLE | s1 | NULL | index | idx_key_part | idx_key_part | 909 | NULL | 9895 | 10.00 | Using where; Using index | +----+-------------+-------+------------+-------+---------------+--------------+---------+------+------+----------+--------------------------+ 1 row in set, 1 warning (0.00 sec) mysql> - ALL
最熟悉的全表扫描
无条件查询全表 → 全表扫描 → type = ALL(最差级别)mysql> EXPLAIN SELECT * FROM s1; +----+-------------+-------+------------+------+---------------+------+---------+------+------+----------+-------+ | id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra | +----+-------------+-------+------------+------+---------------+------+---------+------+------+----------+-------+ | 1 | SIMPLE | s1 | NULL | ALL | NULL | NULL | NULL | NULL | 9895 | 100.00 | NULL | +----+-------------+-------+------------+------+---------------+------+---------+------+------+----------+-------+ 1 row in set, 1 warning (0.00 sec) mysql>
结果值从好到坏依次是:
system > const > eq_ref > ref > fulltext > ref_or_null > index_merge > unique_subquery > index_subquery > range > index > ALLL
其中比较重要的几个提取出来(见上面红色字体)。SQL性能优化的目标:至少要达到range级别,要求是ref级别,最好是consts级别。(阿里巴巴开发手册要求)
6、possible_keys和key
在EXPLAIN语句输出的执行计划中,possible_keys列表示在某个查询语句中,对某个表执行单表查询时可能用到的索引有哪些。一般查询涉及到的字段上若存在索引,则该索引将被列出,但不一定被查询使用。key列表示实际用到的索引有哪些,如果为NULL,则没有使用索引。比方说下边这个查询:
mysql> EXPLAIN SELECT * FROM s1 WHERE key1 > 'z' AND key3 = 'a';
+----+-------------+-------+------------+------+-------------------+----------+---------+-------+------+----------+-------------+
| id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra |
+----+-------------+-------+------------+------+-------------------+----------+---------+-------+------+----------+-------------+
| 1 | SIMPLE | s1 | NULL | ref | idx_key1,idx_key3 | idx_key3 | 303 | const | 1 | 5.00 | Using where |
+----+-------------+-------+------------+------+-------------------+----------+---------+-------+------+----------+-------------+
1 row in set, 1 warning (0.00 sec)
mysql>
上述执行计划的possible_keys列的值是idx_key1,idx_key3,表示该查询可能使用到idx_key1,idx_key3两个索引,然后key列的值是idx_key3,表示经过查询优化器计算使用不同索引的成本后,最后决定使用idx_key3来执行查询比较划算。
7、key_len☆
实际使用到的索引长度(即:字节数),检查是否充分的利用上了索引,值越大越好,主要针对于联合索引,有一定的参考意义。
mysql> EXPLAIN SELECT * FROM s1 WHERE id = 10005;
+----+-------------+-------+------------+-------+---------------+---------+---------+-------+------+----------+-------+
| id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra |
+----+-------------+-------+------------+-------+---------------+---------+---------+-------+------+----------+-------+
| 1 | SIMPLE | s1 | NULL | const | PRIMARY | PRIMARY | 4 | const | 1 | 100.00 | NULL |
+----+-------------+-------+------------+-------+---------------+---------+---------+-------+------+----------+-------+
1 row in set, 1 warning (0.00 sec)
mysql> EXPLAIN SELECT * FROM s1 WHERE Key2 = 10126;
+----+-------------+-------+------------+-------+---------------+----------+---------+-------+------+----------+-------+
| id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra |
+----+-------------+-------+------------+-------+---------------+----------+---------+-------+------+----------+-------+
| 1 | SIMPLE | s1 | NULL | const | idx_key2 | idx_key2 | 5 | const | 1 | 100.00 | NULL |
+----+-------------+-------+------------+-------+---------------+----------+---------+-------+------+----------+-------+
1 row in set, 1 warning (0.00 sec)
mysql>
id和key2都是int类型,为什么id = 10005的key_len是4,Key2 = 10126的key_len是5?
MySQL 索引长度规则:
- NOT NULL 字段:直接用类型本身长度
- INT → 4
- 允许 NULL 的字段:类型长度 + 1 字节(用来存 NULL 标记)
- INT + NULL → 4 + 1 = 5
mysql> EXPLAIN SELECT * FROM s1 WHERE key_part1 = 'a';
+----+-------------+-------+------------+------+---------------+--------------+---------+-------+------+----------+-------+
| id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra |
+----+-------------+-------+------------+------+---------------+--------------+---------+-------+------+----------+-------+
| 1 | SIMPLE | s1 | NULL | ref | idx_key_part | idx_key_part | 303 | const | 1 | 100.00 | NULL |
+----+-------------+-------+------------+------+---------------+--------------+---------+-------+------+----------+-------+
1 row in set, 1 warning (0.00 sec)
mysql> ExPLAIN SELECT * FROM s1 wHERE key_part1 = 'a' AND key_part2 = 'b';
+----+-------------+-------+------------+------+---------------+--------------+---------+-------------+------+----------+-------+
| id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra |
+----+-------------+-------+------------+------+---------------+--------------+---------+-------------+------+----------+-------+
| 1 | SIMPLE | s1 | NULL | ref | idx_key_part | idx_key_part | 606 | const,const | 1 | 100.00 | NULL |
+----+-------------+-------+------------+------+---------------+--------------+---------+-------------+------+----------+-------+
1 row in set, 1 warning (0.00 sec)
mysql> ExPLAIN SELECT * FROM s1 wHERE key_part1 = 'a' AND key_part2 = 'b' AND key_part3 = 'c';
+----+-------------+-------+------------+------+---------------+--------------+---------+-------------------+------+----------+-------+
| id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra |
+----+-------------+-------+------------+------+---------------+--------------+---------+-------------------+------+----------+-------+
| 1 | SIMPLE | s1 | NULL | ref | idx_key_part | idx_key_part | 909 | const,const,const | 1 | 100.00 | NULL |
+----+-------------+-------+------------+------+---------------+--------------+---------+-------------------+------+----------+-------+
1 row in set, 1 warning (0.01 sec)
mysql>
为什么同一个索引idx_key_part,key_len一个是303,一个是606,一个是909?
核心答案:因为联合索引用的字段越多,key_len 就越长!WHERE 里用的索引字段越多,key_len 就越大,代表索引利用越充分!,这就是前面说的,越大越好针对于联合索引有参考意义。
- 为什么是303
WHERE key_part1 = ‘a’,只用了第 1 个索引字段,key_part1定义的长度是VARCHAR(100),utf8中一个字符等于三个字节就是300,且key_part1允许为null再加1,等于301。且varchar 是变长字符串,MySQL 必须用2个字节记录:这个字段里实际存了多少个字符。所以key_len为303。 - 为什么是606
WHERE key_part1=‘a’ AND key_part2=‘b’,用了第 1 + 第 2 个索引字段,所以:key_len = 303 + 303 = 606 - 为什么是909
WHERE key_part1=‘a’ AND key_part2=‘b’ AND key_part3=‘c’,用了全部 3 个索引字段,key_len = 303×3 = 909
mysql> EXPLAIN SELECT * FROM s1 WHERE key_part3 = 'a';
+----+-------------+-------+------------+------+---------------+------+---------+------+-------+----------+-------------+
| id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra |
+----+-------------+-------+------------+------+---------------+------+---------+------+-------+----------+-------------+
| 1 | SIMPLE | s1 | NULL | ALL | NULL | NULL | NULL | NULL | 10089 | 10.00 | Using where |
+----+-------------+-------+------------+------+---------------+------+---------+------+-------+----------+-------------+
1 row in set, 1 warning (0.00 sec)
mysql>
为什么联合索引idx_key_part中有key_part3字段,key_len值却为null?
灵魂答案:因为联合索引有「最左匹配原则」!跳过前面的字段,直接查最后一个字段,索引直接失效!,所以本条查询根本就没有使用索引查询,或者说索引失效。所以key_len为null
idx_key_part (key_part1, key_part2, key_part3)是索引结构。顺序是:第1位:key_part1,第2位:key_part2,第3位:key_part3。
联合索引,必须从左往右依次使用,跳过前面的字段,后面的全部失效!就像: 必须先穿内裤,再穿裤子,最后穿外套。
不能直接穿外套 → 索引直接废了!
提问:如果在gbk字符集中,上面的key_len的值又该是多少?一个字符:utf8=3字节,gbk=2字节。
8、ref
ref 表示:当前索引列,和哪个值做比较。ref = 与索引字段进行等值匹配的对象(通常是常量 const,或者列名)
mysql>  EXPLAIN SELECT * FROM s1 WHERE key1 = 'a';
+----+-------------+-------+------------+------+---------------+----------+---------+-------+------+----------+-------+
| id | select_type | table | partitions | type | possible_keys | key      | key_len | ref   | rows | filtered | Extra |
+----+-------------+-------+------------+------+---------------+----------+---------+-------+------+----------+-------+
|  1 | SIMPLE      | s1    | NULL       | ref  | idx_key1      | idx_key1 | 303     | const |    1 |   100.00 | NULL  |
+----+-------------+-------+------------+------+---------------+----------+---------+-------+------+----------+-------+
1 row in set, 1 warning (0.00 sec)

mysql>
索引字段 key1 是和一个常量做等值匹配,WHERE key1 = ‘a’;
‘a’ 就是一个常量(const)。
ref = const 是什么?
答:这就是 “与 s1 索引字段做等值比较的对象” —— 来自于一个常量(const)!
mysql> EXPLAIN SELECT * FROM s1 INNER JOIN s2 ON s1.id = s2.id;
+----+-------------+-------+------------+--------+---------------+---------+---------+---------------+-------+----------+-------+
| id | select_type | table | partitions | type   | possible_keys | key     | key_len | ref           | rows  | filtered | Extra |
+----+-------------+-------+------------+--------+---------------+---------+---------+---------------+-------+----------+-------+
|  1 | SIMPLE      | s1    | NULL       | ALL    | PRIMARY       | NULL    | NULL    | NULL          | 10089 |   100.00 | NULL  |
|  1 | SIMPLE      | s2    | NULL       | eq_ref | PRIMARY       | PRIMARY | 4       | dbtest2.s1.id |     1 |   100.00 | NULL  |
+----+-------------+-------+------------+--------+---------------+---------+---------+---------------+-------+----------+-------+
2 rows in set, 1 warning (0.00 sec)

mysql>
s2 表的索引字段 id,正在和 s1 表的 id 字段做等值匹配。
ref = dbtest2.s1.id 是什么?
答:这就是 “与 s2 索引字段做等值比较的对象” —— 来自 s1 表的 id 字段!
mysql> EXPLAIN SELECT * FROM s1 INNER JOIN s2 ON s2.key1 = UPPER(s1.key1);
+----+-------------+-------+------------+------+---------------+----------+---------+------+-------+----------+-----------------------+
| id | select_type | table | partitions | type | possible_keys | key      | key_len | ref  | rows  | filtered | Extra                 |
+----+-------------+-------+------------+------+---------------+----------+---------+------+-------+----------+-----------------------+
|  1 | SIMPLE      | s1    | NULL       | ALL  | NULL          | NULL     | NULL    | NULL | 10089 |   100.00 | NULL                  |
|  1 | SIMPLE      | s2    | NULL       | ref  | idx_key1      | idx_key1 | 303     | func |     1 |   100.00 | Using index condition |
+----+-------------+-------+------------+------+---------------+----------+---------+------+-------+----------+-----------------------+
2 rows in set, 1 warning (0.00 sec)

mysql>
ref = func 表示:索引列不是和常量、也不是和普通字段匹配,而是和一个 函数结果 做等值匹配!
ref: func 到底是什么?
答:s2 表的索引列 key1,正在和 一个函数计算后的结果值 做等值匹配。
ref = null:NULL没用到索引,或不是等值查询(>、<、LIKE 等)
9、rows☆
rows = MySQL 预估要扫描的行数,数字越小,SQL 越快!数字越大,SQL 越慢!
mysql> EXPLAIN SELECT * FROM s1 WHERE key1 > 'z';
+----+-------------+-------+------------+-------+---------------+----------+---------+------+------+----------+-----------------------+
| id | select_type | table | partitions | type  | possible_keys | key      | key_len | ref  | rows | filtered | Extra                 |
+----+-------------+-------+------------+-------+---------------+----------+---------+------+------+----------+-----------------------+
|  1 | SIMPLE      | s1    | NULL       | range | idx_key1      | idx_key1 | 303     | NULL |  406 |   100.00 | Using index condition |
+----+-------------+-------+------------+-------+---------------+----------+---------+------+------+----------+-----------------------+
1 row in set, 1 warning (0.00 sec)

mysql>
意思是:MySQL 预估要扫描 406 行数据,才能找到需要的结果。它是预估值,不是精确值
10、filtered
某个表经过搜索条件过滤后剩余记录条数的百分比
存储引擎查到的数据里,MySQL 预估有多少百分比的数据能满足 WHERE 条件。
越大越好,100 最好,越小说明越浪费、效率越低。
用最直白的人话翻译
- MySQL 先按索引 / 全表扫描出一批数据(看 rows)
- 然后再在这些数据里做过滤,看哪些真正符合 WHERE
- filtered 就是 “过滤后剩下的比例”
举例1:
`ows: 406
filtered: 100.00
意思是:
1.扫描了 406 行
2.这 406 行 100% 都满足 key1 > ‘z’
3.没有多余数据,非常高效
举例2:
rows: 10089
filtered: 10.00
意思是:
1.全表扫了 10089 行
2.最后只有 10% 的数据满足条件
3.90% 都是白扫的,浪费性能
mysql> EXPLAIN SELECT * FROM s1 WHERE key1 > 'z' AND common_field = 'a';
+----+-------------+-------+------------+-------+--------------------------+----------+---------+------+------+----------+------------------------------------+
| id | select_type | table | partitions | type  | possible_keys            | key      | key_len | ref  | rows | filtered | Extra                              |
+----+-------------+-------+------------+-------+--------------------------+----------+---------+------+------+----------+------------------------------------+
|  1 | SIMPLE      | s1    | NULL       | range | idx_key1,ft_common_field | idx_key1 | 303     | NULL |  406 |    10.00 | Using index condition; Using where |
+----+-------------+-------+------------+-------+--------------------------+----------+---------+------+------+----------+------------------------------------+
1 row in set, 1 warning (0.00 sec)

mysql>
如果使用的是索引执行的单表扫描,那么计算时需要估计出满足除使用到对应索引的搜索条件外的其他搜索条件的记录有多少条。
- 用了索引(这里是 idx_key1)
- 索引只负责查 key1 > ‘z’ 这一个条件
- 另一个条件 common_field = ‘a’
索引管不着 - MySQL 要预估:在索引查出来的数据里,有多少比例能同时满足 common_field = ‘a’
mysql> ExPLAIN SELECT * FROM s1 INNER JOIN s2 ON s1.key1 = s2.key1 wHERE s1.common_field = 'a';
+----+-------------+-------+------------+------+--------------------------+----------+---------+-----------------+-------+----------+-------------+
| id | select_type | table | partitions | type | possible_keys            | key      | key_len | ref             | rows  | filtered | Extra       |
+----+-------------+-------+------------+------+--------------------------+----------+---------+-----------------+-------+----------+-------------+
|  1 | SIMPLE      | s1    | NULL       | ALL  | idx_key1,ft_common_field | NULL     | NULL    | NULL            | 10089 |    10.00 | Using where |
|  1 | SIMPLE      | s2    | NULL       | ref  | idx_key1                 | idx_key1 | 303     | dbtest2.s1.key1 |     1 |   100.00 | NULL        |
+----+-------------+-------+------------+------+--------------------------+----------+---------+-----------------+-------+----------+-------------+
2 rows in set, 1 warning (0.00 sec)

mysql>
对于单表查询来说,这个filtered列的值没什么意义,我们更关注在连接查询中驱动表对应的执行计划记录的filtered值,它决定了被驱动表要执行的次数(即:rows*filtered)
翻译:对于单表查询来说,filtered 没什么意义;我们更关注连接查询里,驱动表的 filtered 值,它决定了被驱动表要执行多少次。
驱动表 s1:
- rows: 10089 → 全表有 10089 条数据(
实际只有10000条,但是10089是预估值,而不是准确值)
filtered: 10.00 → 只有 10% 满足 common_field = ‘a’
驱动表最终返回的行数 = rows × filtered = 10089 × 10% ≈ 1009 行
11、Extra☆
顾名思义,Extra列是用来说明一些额外信息的,包含不适合在其他列中显示但十分重要的额外信息。我们可以通过这些额外信息来更准确的理解MySQL到底将如何执行给定的查询语句。MySQL提供的额外信息有好几十个,就不一个一个介绍了,只挑比较重要的额外信息介绍。
一句话终极定义Extra = MySQL 给你的 “额外备注”,专门告诉你:查询过程中发生了什么重要事情。这里的信息,直接决定 SQL 是快还是慢!
-
No tables used
当查询语句的没有ROM子句时将会提示该额外信息mysql> EXPLAIN SELECT 1; +----+-------------+-------+------------+------+---------------+------+---------+------+------+----------+----------------+ | id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra | +----+-------------+-------+------------+------+---------------+------+---------+------+------+----------+----------------+ | 1 | SIMPLE | NULL | NULL | NULL | NULL | NULL | NULL | NULL | NULL | NULL | No tables used | +----+-------------+-------+------------+------+---------------+------+---------+------+------+----------+----------------+ 1 row in set, 1 warning (0.00 sec) mysql> -
Impossible WHERE
查询语句的WHERE子句永远为FALSE时将会提示该额外信息mysql> EXPLAIN SELECT * FROM s1 WHERE 1 != 1; +----+-------------+-------+------------+------+---------------+------+---------+------+------+----------+------------------+ | id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra | +----+-------------+-------+------------+------+---------------+------+---------+------+------+----------+------------------+ | 1 | SIMPLE | NULL | NULL | NULL | NULL | NULL | NULL | NULL | NULL | NULL | Impossible WHERE | +----+-------------+-------+------------+------+---------------+------+---------+------+------+----------+------------------+ 1 row in set, 1 warning (0.00 sec) mysql> -
Using where:
当我们使用全表扫描来执行对某个表的查询,并且该语句的WHERE子句中有针对该表的搜索条件时,在Extra列中会提示该额外信息。mysql> EXPLAIN SELECT * FROM s1 WHERE common_field = 'a'; +----+-------------+-------+------------+------+-----------------+------+---------+------+-------+----------+-------------+ | id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra | +----+-------------+-------+------------+------+-----------------+------+---------+------+-------+----------+-------------+ | 1 | SIMPLE | s1 | NULL | ALL | ft_common_field | NULL | NULL | NULL | 10089 | 10.00 | Using where | +----+-------------+-------+------------+------+-----------------+------+---------+------+-------+----------+-------------+ 1 row in set, 1 warning (0.00 sec) mysql>当使用索引访问来执行对某个表的查询,并且该语句的WHERE子句中,有除了该索引包含的列之外的其他搜索条件时,在Extra列中也会提示
Using where。mysql> EXPLAIN SELECT * FROM s1 WHERE key1 = 'a' AND common_field = 'a'; +----+-------------+-------+------------+------+--------------------------+----------+---------+-------+------+----------+-------------+ | id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra | +----+-------------+-------+------------+------+--------------------------+----------+---------+-------+------+----------+-------------+ | 1 | SIMPLE | s1 | NULL | ref | idx_key1,ft_common_field | idx_key1 | 303 | const | 1 | 10.00 | Using where | +----+-------------+-------+------------+------+--------------------------+----------+---------+-------+------+----------+-------------+ 1 row in set, 1 warning (0.00 sec) mysql> -
No matching min/max row
当查询列表处有MIN或者MAX聚合函数,但是并没有符合WHERE子句中的搜索条件的记录时,将会提示该额外信息mysql> EXPLAIN SELECT MIN(key1) FROM s1 WHERE key1 = 'abcdefg'; +----+-------------+-------+------------+------+---------------+------+---------+------+------+----------+-------------------------+ | id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra | +----+-------------+-------+------------+------+---------------+------+---------+------+------+----------+-------------------------+ | 1 | SIMPLE | NULL | NULL | NULL | NULL | NULL | NULL | NULL | NULL | NULL | No matching min/max row | +----+-------------+-------+------------+------+---------------+------+---------+------+------+----------+-------------------------+ 1 row in set, 1 warning (0.00 sec) mysql> -
Using index
当我们的查询列表以及搜索条件中只包含属于某个索引的列,也就是在可以使用覆盖索引的情况下,在Extra列将会提示该额外信息。比方说下边这个查询中只需要用到idx_key1而不需要回表操作:mysql> EXPLAIN SELECT key1 FROM s1 WHERE Key1 = 'a'; +----+-------------+-------+------------+------+---------------+----------+---------+-------+------+----------+-------------+ | id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra | +----+-------------+-------+------------+------+---------------+----------+---------+-------+------+----------+-------------+ | 1 | SIMPLE | s1 | NULL | ref | idx_key1 | idx_key1 | 303 | const | 1 | 100.00 | Using index | +----+-------------+-------+------------+------+---------------+----------+---------+-------+------+----------+-------------+ 1 row in set, 1 warning (0.00 sec) mysql> -
Using index condition
Using index condition表示MySQL索引下推生效了。
有些搜索条件中虽然出现了索引列,但却不能使用到索引。比如下列key1 LIKE '%a’这个查询就不会使用索引。mysql> EXPLAIN SELECT * FROM s1 WHERE key1 > 'z' AND key1 LIKE '%a'; +----+-------------+-------+------------+-------+---------------+----------+---------+------+------+----------+-----------------------+ | id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra | +----+-------------+-------+------------+-------+---------------+----------+---------+------+------+----------+-----------------------+ | 1 | SIMPLE | s1 | NULL | range | idx_key1 | idx_key1 | 303 | NULL | 406 | 100.00 | Using index condition | +----+-------------+-------+------------+-------+---------------+----------+---------+------+------+----------+-----------------------+ 1 row in set, 1 warning (0.00 sec) mysql>先讲两个条件的区别
- key1 > ‘z’
✅ 能用于索引查找(确定范围)索引是有序的,可以快速找到大于 z 的数据。 - key1 LIKE ‘%a’
❌ 不能用于索引查找(无法定位)因为 % 写在前面,索引不知道从哪开始找。只能用来过滤,不能用来定位。索引时已经排好序的,用什么什么结尾来查询是办法用索引,但是如果是'a%'以a开头查找是可以用到索引的。
key1 LIKE ‘a%’ → 用得到索引(用来定位、找范围)
key1 LIKE ‘%a’ → 用不到索引(没法定位,只能事后过滤) - key1 > ‘z’
- 没有索引下推会发生什么?(笨办法)
1.根据 key1 > ‘z’ 找到 406 条数据
2.这 406 条全部回表(读取完整数据)
3.回到 MySQL 服务器层,再逐个判断 LIKE ‘%a’
4.把不符合的扔掉
回表次数多,浪费资源! - 索引下推:
1.根据 key1 > ‘z’ 找到 406 条数据
2.不回表!
3.直接在索引里就判断 key1 LIKE '%a'
4.过滤掉不符合的数据
5.只把符合的数据回表
回表次数大大减少,速度更快!
-
Using where; Using join buffer (hash join)
在连接查询执行过程中,当被驱动表不能有效的利用索引加快访问速度,MySQL一般会为
其分配一块名叫join buffer的内存块来加快查询速度,也就是基于块的嵌套循环算法mysql> EXPLAIN SELECT * FROM s1 INNER JOIN s2 ON s1.common_field = s2.common_field; +----+-------------+-------+------------+------+---------------+------+---------+------+-------+----------+--------------------------------------------+ | id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra | +----+-------------+-------+------------+------+---------------+------+---------+------+-------+----------+--------------------------------------------+ | 1 | SIMPLE | s2 | NULL | ALL | NULL | NULL | NULL | NULL | 9895 | 100.00 | NULL | | 1 | SIMPLE | s1 | NULL | ALL | NULL | NULL | NULL | NULL | 10089 | 10.00 | Using where; Using join buffer (hash join) | +----+-------------+-------+------------+------+---------------+------+---------+------+-------+----------+--------------------------------------------+ 2 rows in set, 1 warning (0.00 sec) mysql> -
Using where; Not exists
当我们使用左(外)连接时,如果WHERE子句中包含要求被驱动表的某个列等于NULL值的搜索条件,而且那个列又是不允许存储NULL值的,那么在该表的执行计划的Extra列就会提示Not exists额外信息mysql> EXPLAIN SELECT * FROM s1 LEFT JOIN s2 ON s1.key1 = s2.key1 WHERE s2.id IS NULL; +----+-------------+-------+------------+------+---------------+----------+---------+-----------------+-------+----------+-------------------------+ | id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra | +----+-------------+-------+------------+------+---------------+----------+---------+-----------------+-------+----------+-------------------------+ | 1 | SIMPLE | s1 | NULL | ALL | NULL | NULL | NULL | NULL | 10089 | 100.00 | NULL | | 1 | SIMPLE | s2 | NULL | ref | idx_key1 | idx_key1 | 303 | dbtest2.s1.key1 | 1 | 10.00 | Using where; Not exists | +----+-------------+-------+------------+------+---------------+----------+---------+-----------------+-------+----------+-------------------------+ 2 rows in set, 1 warning (0.00 sec) mysql> -
Using union(idx_key1,idx_key3); Using where
如果执行计划的Extra列出现了Using intersect(...)提示,说明准备使用Intersect索引
合并的方式执行查询,括号中的...表示需要进行索引合并的索引名称;
如果出现了Using union(...)提示,说明准备使用Union索引合并的方式执行查询;
出现了Using sort_union(...)提示,说明准备使用Sort-Union索引合并的方式执行查询。mysql> EXPLAIN SELECT * FROM s1 WHERE key1 = 'a' OR key3 = 'a'; +----+-------------+-------+------------+-------------+-------------------+-------------------+---------+------+------+----------+---------------------------------------------+ | id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra | +----+-------------+-------+------------+-------------+-------------------+-------------------+---------+------+------+----------+---------------------------------------------+ | 1 | SIMPLE | s1 | NULL | index_merge | idx_key1,idx_key3 | idx_key1,idx_key3 | 303,303 | NULL | 2 | 100.00 | Using union(idx_key1,idx_key3); Using where | +----+-------------+-------+------------+-------------+-------------------+-------------------+---------+------+------+----------+---------------------------------------------+ 1 row in set, 1 warning (0.00 sec) mysql> -
Zero limit
当我们的LIMIT子句的参数为0时,表示压根儿不打算从表中读出任何记录,将会提示该额外信息mysql> EXPLAIN SELECT * FROM s1 LIMIT 0; +----+-------------+-------+------------+------+---------------+------+---------+------+------+----------+------------+ | id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra | +----+-------------+-------+------------+------+---------------+------+---------+------+------+----------+------------+ | 1 | SIMPLE | NULL | NULL | NULL | NULL | NULL | NULL | NULL | NULL | NULL | Zero limit | +----+-------------+-------+------------+------+---------------+------+---------+------+------+----------+------------+ 1 row in set, 1 warning (0.00 sec) mysql> -
Using filesort
很多情况下排序操作无法使用到索引,只能在内存中(记录较少的时候)或者磁盘中(记录较多的时候)进行排序,MySQL把这种在内存中或者磁盘上进行排序的方式统称为文件排序(英文名:filesort)。如果某个查询需要使用文件排序的方式执行查询,就会在执行计划的Extra列中显示Using filesort提示mysql> EXPLAIN SELECT * FROM s1 ORDER BY common_field LIMIT 10; +----+-------------+-------+------------+------+---------------+------+---------+------+-------+----------+----------------+ | id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra | +----+-------------+-------+------------+------+---------------+------+---------+------+-------+----------+----------------+ | 1 | SIMPLE | s1 | NULL | ALL | NULL | NULL | NULL | NULL | 10089 | 100.00 | Using filesort | +----+-------------+-------+------------+------+---------------+------+---------+------+-------+----------+----------------+ 1 row in set, 1 warning (0.00 sec) mysql>这个查询语句可以利用idx_key1索引直接取出key1列的10条记录,然后再进行回表操作就好了。但是很多情况下排序操作无法使用到索引,只能在内存中(记录较少的时候)或者磁盘中(记录较多的时候)进行排序,MySQL把这种在内存中或者磁盘上进行排序的方式统称为文件排序(英文名:
filesort)。如果某个查询需要使用文件排序的方式执行查询,就会在执行计划的Extra列中显示Using filesort提示 -
Using temporary
在许多查询的执行过程中,MySQL可能会借助临时表来完成一些功能,比如去重、排序之类的,比如我们在执行许多包含DISTINCT、GROUP BY、UNION等子句的查询过程中,如果不能有效利用索引来完成查询,MySQL很有可能寻求通过建立内部的临时表来执行查询。如果查询中使用到了内部的临时表,在执行计划的Extra列将会显示Using temporary提示mysql> EXPLAIN SELECT DISTINCT common_field FROM s1; +----+-------------+-------+------------+------+---------------+------+---------+------+-------+----------+-----------------+ | id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra | +----+-------------+-------+------------+------+---------------+------+---------+------+-------+----------+-----------------+ | 1 | SIMPLE | s1 | NULL | ALL | NULL | NULL | NULL | NULL | 10089 | 100.00 | Using temporary | +----+-------------+-------+------------+------+---------------+------+---------+------+-------+----------+-----------------+ 1 row in set, 1 warning (0.00 sec) mysql>执行计划中出现
Using temporary并不是一个好的征兆,因为建立与维护临时表要付出很大成本的,所以我们最好能使用索引来替代掉使用临时表。比如:扫描指定的索引idx_key1即可mysql> EXPLAIN SELECT key1, COUNT(*) AS amount FROM s1 GROUP BY key1; +----+-------------+-------+------------+-------+---------------+----------+---------+------+-------+----------+-------------+ | id | select_type | table | partitions | type | possible_keys | key | key_len | ref | rows | filtered | Extra | +----+-------------+-------+------------+-------+---------------+----------+---------+------+-------+----------+-------------+ | 1 | SIMPLE | s1 | NULL | index | idx_key1 | idx_key1 | 303 | NULL | 10089 | 100.00 | Using index | +----+-------------+-------+------------+-------+---------------+----------+---------+------+-------+----------+-------------+ 1 row in set, 1 warning (0.00 sec) mysql>
12、小结
- EXPLAIN不考虑各种Cache
- EXPLAIN不能显示MySQL在执行查询时所作的优化工作
- EXPLAIN不会告诉你关于触发器、存储过程的信息或用户自定义函数对查询的影响情况
- 部分统计信息是估算的,并非精确值
7、EXPLAIN的进一步使用
1、EXPLAIN的四种输出格式
谈谈EXPLAIN的输出格式。EXPLAIN可以输出四种格式:传统格式,JSON格式,TREE格式以及可视化输出。可以根据需要选择适用于自己的格式。
1、传统格式
传统格式简单明了,输出是一个表格形式,概要说明查询计划。
mysql> EXPLAIN SELECT s1.key1, s2.key1 FROM s1 LEFT JOIN s2 ON s1.key1 = s2.key1 WHERE s2.common_field IS NOT NULL;
+----+-------------+-------+------------+-------+---------------+----------+---------+-----------------+-------+----------+-------------+
| id | select_type | table | partitions | type  | possible_keys | key      | key_len | ref             | rows  | filtered | Extra       |
+----+-------------+-------+------------+-------+---------------+----------+---------+-----------------+-------+----------+-------------+
|  1 | SIMPLE      | s1    | NULL       | index | idx_key1      | idx_key1 | 303     | NULL            | 10089 |   100.00 | Using index |
|  1 | SIMPLE      | s2    | NULL       | ref   | idx_key1      | idx_key1 | 303     | dbtest2.s1.key1 |     1 |    90.00 | Using where |
+----+-------------+-------+------------+-------+---------------+----------+---------+-----------------+-------+----------+-------------+
2 rows in set, 1 warning (0.00 sec)

mysql>
2、JSON格式
第1种格式中介绍的EXPLAIN语句输出中缺少了一个衡量执行计划好坏的重要属性一一成本。而JSON格式是四种格式里面输出信息最详尽的格式,里面包含了执行的成本信息。
-
JSON格式:在EXPLAIN单词和真正的查询语句中间加上FORMAT=JSON。
EXPLAIN FORMAT = JSON SELECT .... -
EXPLAIN的Column与JSON的对应关系:(来源于MySQL5.7文档)
Column JSON Name Meaning id select_id The SELECT identifier select_type None The SELECT type table table_name The table for the output row partitions partitions The matching partitions type access_type The join type possible_keys possible_keys The possible indexes to choose key key The index actually chosen key_len key_length The length of the chosen key ref ref The columns compared to the index rows rows Estimate of rows to be examined filtered filtered Percentage of rows filtered by table condition Extra None Additional information
这样我们就可以得到一个json格式的执行计划,里面包含该计划花费的成本,比如这样:
#传统格式
mysql> EXPLAIN SELECT * FROM s1 INNER JOIN s2 ON s1.key1 = s2.key2 WHERE s1.common_field = 'a';
+----+-------------+-------+------------+--------+---------------+----------+---------+-----------------+-------+----------+-----------------------+
| id | select_type | table | partitions | type   | possible_keys | key      | key_len | ref             | rows  | filtered | Extra                 |
+----+-------------+-------+------------+--------+---------------+----------+---------+-----------------+-------+----------+-----------------------+
|  1 | SIMPLE      | s1    | NULL       | ALL    | idx_key1      | NULL     | NULL    | NULL            | 10089 |    10.00 | Using where           |
|  1 | SIMPLE      | s2    | NULL       | eq_ref | idx_key2      | idx_key2 | 5       | dbtest2.s1.key1 |     1 |   100.00 | Using index condition |
+----+-------------+-------+------------+--------+---------------+----------+---------+-----------------+-------+----------+-----------------------+
2 rows in set, 2 warnings (0.00 sec)

#JSON格式
mysql> EXPLAIN FORMAT = JSON SELECT * FROM s1 INNER JOIN s2 ON s1.key1 = s2.key2 WHERE s1.common_field = 'a' \G;
*************************** 1. row ***************************
EXPLAIN: {
  "query_block": {
    "select_id": 1,		# 整个查询语句只有1个SELECT关键字,该关键字对应的id号为1
    "cost_info": {
      "query_cost": "1386.26"		# 整个查询的执行成本预计为1386.26,优化器的打分,越小越快,
    },
    "nested_loop": [   #几个表之间采用嵌套循环连接算法执行
      {
      	# 对标传统方式中的第一条数据
        "table": {
          "table_name": "s1",		# s1是驱动表
          "access_type": "ALL",		# 访问方法为ALL,意味着使用全表扫描访问
          "possible_keys": [	# 可能使用的索引
            "idx_key1"
          ],
          "rows_examined_per_scan": 10089, # 传统方式中的rows
          "rows_produced_per_join": 1008,	# 传统方式中rows * filtered的结果
          "filtered": "10.00",		# 传统方式中的filtered
          "cost_info": {
            "read_cost": "932.26",
            "eval_cost": "100.89",
            "prefix_cost": "1033.15",	#read_cost+ eval_cost的结果
            "data_read_per_join": "1M"		#读取的数据量的大小
          },
          "used_columns": [	# 要查询的字段,SELECT 和FROM之间的内容。
            "id",
            "key1",
            "key2",
            "key3",
            "key_part1",
            "key_part2",
            "key_part3",
            "common_field"
          ],
          "attached_condition": "((`dbtest2`.`s1`.`common_field` = 'a') and (`dbtest2`.`s1`.`key1` is not null))"	#可以理解成WHERE后面的查询条件
        }
      },
      {
      # 对标传统方式中的第二条数据
        "table": {
          "table_name": "s2",	# s2表是被驱动表
          "access_type": "eq_ref",
          "possible_keys": [
            "idx_key2"
          ],
          "key": "idx_key2",
          "used_key_parts": [
            "key2"
          ],
          "key_length": "5",
          "ref": [
            "dbtest2.s1.key1"	# 与key2列进行等值匹配的对象
          ],
          "rows_examined_per_scan": 1,
          "rows_produced_per_join": 1008,
          "filtered": "100.00",
          "index_condition": "(cast(`dbtest2`.`s1`.`key1` as double) = cast(`dbtest2`.`s2`.`key2` as double))",
          "cost_info": {
            "read_cost": "252.23",
            "eval_cost": "100.89",
            "prefix_cost": "1386.27",     #s1、s2表的read_cost、eval_cost相加之和,累计到这一步的总成本
            "data_read_per_join": "1M"
          },
          "used_columns": [
            "id",
            "key1",
            "key2",
            "key3",
            "key_part1",
            "key_part2",
            "key_part3",
            "common_field"
          ]
        }
      }
    ]
  }
}
1 row in set, 2 warnings (0.00 sec)

ERROR:
No query specified

mysql>
看一下s1表的cost_info,分析分它们的成本是怎么计算出来的:
"cost_info": {
  "read_cost": "932.26",
  "eval_cost": "100.89",
  "prefix_cost": "1033.15",
  "data_read_per_join": "1M"
},
-
read_cost是由下边两部分组成:
-IO成本- 检测
rows x (1 - filter)条记录的CPU成本小贴士:rows和filter都是我们前边介绍执行计划的输出列,在JSON格式的执行计划中,rows相当于rows_examined_per_scan,filtered名称不变。
- 检测
-
eval_cost是这样计算的:
检测rows x filter条记录的成本。 -
prefix_cost就是单独查询s1表的成本,也就是:
read_cost + eval_cost -
data_read_per-join表示在此次查询中需要读取的数据量。
对于s2表的"cost_info"部分是这样的:
"cost_info": {
  "read_cost": "252.23",
  "eval_cost": "100.89",
  "prefix_cost": "1386.27",
  "data_read_per_join": "1M"
}
由于s2表是被驱动表,所以可能被读取多次,这的read_cost和eval_cost是访问多次s2表后累加起来的值,主要关注里边儿的prefix_cost的值代表的是整个连接查询预计的成本,也就是单次查询s1表和多次查询s2表后的成本的和,也就是:
932.26 + 100.89 + 252.23 + 100.89 = 1386.27
3、TREE格式
TREE格式是8.0.16版本之后引入的新格式,主要根据查询的各个部分之间的关系和各部分的执行顺序 来描述如何查询。
mysql> EXPLAIN FORMAT = TREE SELECT * FROM s1 INNER JOIN s2 ON s1.key1 = s2.key2 WHERE s1.common_field = 'a' \G;
*************************** 1. row ***************************
EXPLAIN: -> Nested loop inner join  (cost=1386.27 rows=1009)
    -> Filter: ((s1.common_field = 'a') and (s1.key1 is not null))  (cost=1033.15 rows=1009)
        -> Table scan on s1  (cost=1033.15 rows=10089)
    -> Single-row index lookup on s2 using idx_key2 (key2=s1.key1), with index condition: (cast(s1.key1 as double) = cast(s2.key2 as double))  (cost=0.25 rows=1)

1 row in set, 1 warning (0.00 sec)

ERROR:
No query specified

mysql>
拆解:
最外层
Nested loop inner join  (cost=1386.27 rows=1009)
嵌套循环连接,总成本:1386.27,最终返回行数:1009 行

先执行【驱动表 s1】
-> Filter: ((s1.common_field = 'a') and (s1.key1 is not null))  (cost=1033.15 rows=1009)
    -> Table scan on s1  (cost=1033.15 rows=10089)

第一步:全表扫描s1→Table scan on s1表示全表扫描 s1(type: ALL),扫描 10089 行
Filter: s1.common_field = 'a'
第二步:过滤→ Filter: s1.common_field = 'a',过滤后剩下 1009 行

再执行【被驱动表 s2】
-> Single-row index lookup on s2 using idx_key2 (key2=s1.key1)  (cost=0.25 rows=1)
对 s2 做单行索引查找
	使用索引:idx_key2
    匹配条件:key2 = s1.key1
    每次只查 1 行
    速度极快
Table scan = 全表扫描= 传统 EXPLAIN 里的 type: ALL
Index scan = 全索引扫描= 传统 EXPLAIN 里的 type: index
Single-row index lookup = 索引查找(最快)= 传统 EXPLAIN 里的 type: ref / eq_ref
4、可视化输出
可视化输出,可以通过MySQL Workbench可视化查看MySQL的执行计划。通过点击Workbench的放大镜图标,即可生成可视化的查询计划。
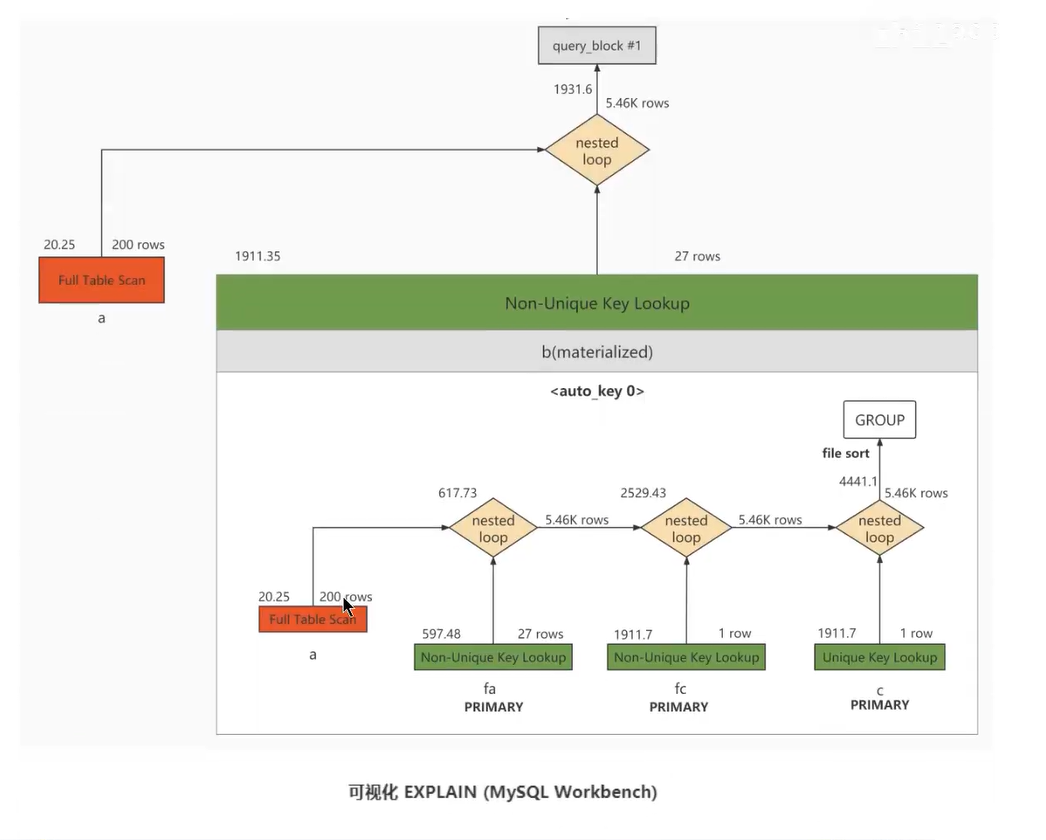
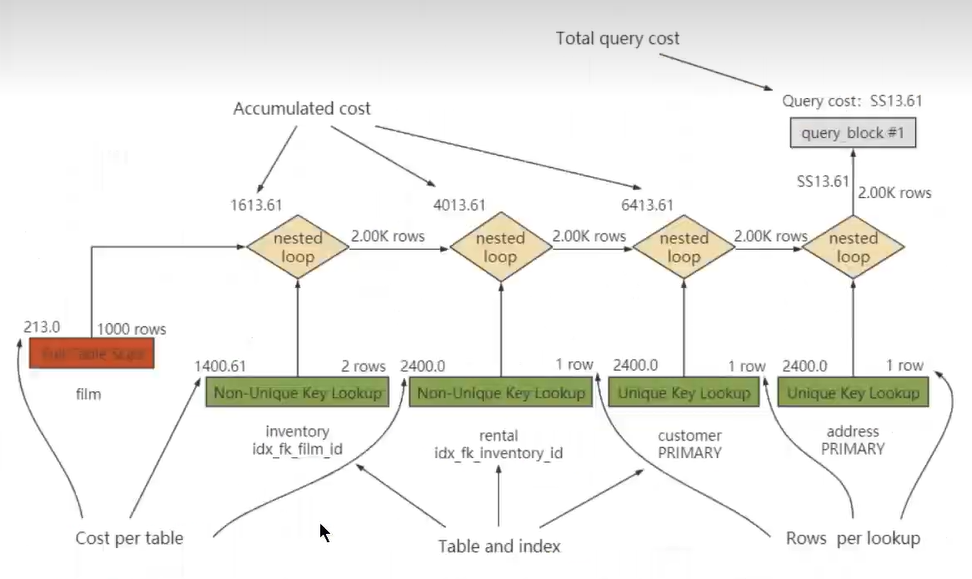
上图按从左到右的连接顺序显示表。红色框表示全表扫描,而绿色框表示使用索引查找。对于每个表,显示使用的索引。还要注意的是,每个表格的框上方是每个表访问所发现的行数的估计值以及访问该表的成本。
SHOW WARNINGS的使用
在我们使用EXPLAIN语句查看了某个查询的执行计划后,紧接着还可以使用SHOW WARNINGS语句查看与这个查询的执行计划有关的一些扩展信息。
翻译:MySQL 优化器会把它内部重写、改写、优化后的真实执行逻辑,还原成标准、可读的 SQL 语法展示出来,让我们能直观看到自己写的 SQL 被优化器做了哪些修改、加了哪些隐式处理,从而看清查询真正的执行逻辑。
比如这样:
mysql> EXPLAIN SELECT s1.key1, s2.key1 FROM s1 LEFT JOIN s2 ON s1.key1 = s2.key1 WHERE s2.common_field IS NOT NULL;
+----+-------------+-------+------------+-------+---------------+----------+---------+-----------------+-------+----------+-------------+
| id | select_type | table | partitions | type  | possible_keys | key      | key_len | ref             | rows  | filtered | Extra       |
+----+-------------+-------+------------+-------+---------------+----------+---------+-----------------+-------+----------+-------------+
|  1 | SIMPLE      | s1    | NULL       | index | idx_key1      | idx_key1 | 303     | NULL            | 10089 |   100.00 | Using index |
|  1 | SIMPLE      | s2    | NULL       | ref   | idx_key1      | idx_key1 | 303     | dbtest2.s1.key1 |     1 |    90.00 | Using where |
+----+-------------+-------+------------+-------+---------------+----------+---------+-----------------+-------+----------+-------------+
2 rows in set, 1 warning (0.00 sec)

mysql> SHOW WARNINGS \G;
*************************** 1. row ***************************
  Level: Note
   Code: 1003
Message: /* select#1 */ select `dbtest2`.`s1`.`key1` AS `key1`,`dbtest2`.`s2`.`key1` AS `key1`
			from `dbtest2`.`s1` join `dbtest2`.`s2`
			where ((`dbtest2`.`s2`.`key1` = `dbtest2`.`s1`.`key1`)
			and (`dbtest2`.`s2`.`common_field` is not null))
1 row in set (0.00 sec)

ERROR:
No query specified

mysql>
注意观察,优化器把LEFT JOIN改成了JOIN。
8、分析优化器执行计划:trace
OPTIMIZER_TRACE是MySQL5.6引入的一项跟踪功能,它可以跟踪优化器做出的各种决策(比如访问表的方法、各种开销计算、各种转换等),并将跟踪结果记录到INFORMATION_SCHEMA.OPTIMIZER_TRACE表中。
此功能默认关闭。开启trace,并设置格式为 JSON,同时设置trace最大能够使用的内存大小,避免解析过程中因为默认内存过小而不能够完整展示。
#开启trace
mysql> SET optimizer_trace="enabled=on",end_markers_in_json=ON;
Query OK, 0 rows affected (0.00 sec)

#设置内存占用大小
mysql> SET optimizer_trace_max_mem_size=1000000;
Query OK, 0 rows affected (0.00 sec)

#执行测试
mysql> select * from student where id < 10;
+----+--------+--------+------+---------+
| id | stuno  | name   | age  | classId |
+----+--------+--------+------+---------+
|  1 | 100002 | ybOMuO |   74 |     181 |
|  2 | 100003 | NmZjZu |   98 |     678 |
|  3 | 100004 | yqjZtW |   54 |     662 |
|  4 | 100005 | RkzSOr |   41 |     715 |
|  5 | 100006 | BBaytw |   15 |     999 |
|  6 | 100007 | PbKxjB |   16 |     815 |
|  7 | 100008 | RMiHLI |   23 |     745 |
|  8 | 100009 | ohVhZB |   70 |     748 |
|  9 | 100010 | LtKvYJ |   24 |     963 |
+----+--------+--------+------+---------+
9 rows in set (0.01 sec)

#最后,查询information_schema.optimizer_trace就可以知道MySQL是如何执行sQL的:
mysql> SELECT * FROM information_schema.optimizer_trace \G;
*************************** 1. row ***************************
                            QUERY: select * from student where id < 10  # 实际执行的原始SQL语句
                            TRACE: {
  "steps": [  # 优化器执行的完整步骤
    {
      "join_preparation": {  # 第一阶段:SQL准备阶段(解析、展开)
        "select#": 1,  # 查询编号,对应EXPLAIN的id
        "steps": [
          {
            "expanded_query": "/* select#1 */ select `student`.`id` AS `id`,`student`.`stuno` AS `stuno`,`student`.`name` AS `name`,`student`.`age` AS `age`,`student`.`classId` AS `classId` from `student` where (`student`.`id` < 10)"  # 优化器展开后的完整SQL
          }
        ] /* steps */
      } /* join_preparation */
    },
    {
      "join_optimization": {  # 第二阶段:SQL优化阶段(核心)
        "select#": 1,
        "steps": [
          {
            "condition_processing": {  # 条件处理(WHERE条件优化)
              "condition": "WHERE",
              "original_condition": "(`student`.`id` < 10)",  # 原始条件
              "steps": [
                {
                  "transformation": "equality_propagation",  # 等值传递优化
                  "resulting_condition": "(`student`.`id` < 10)"
                },
                {
                  "transformation": "constant_propagation",  # 常量传递优化
                  "resulting_condition": "(`student`.`id` < 10)"
                },
                {
                  "transformation": "trivial_condition_removal",  # 无用条件移除
                  "resulting_condition": "(`student`.`id` < 10)"
                }
              ] /* steps */
            } /* condition_processing */
          },
          {
            "substitute_generated_columns": {  # 替换生成列(无生成列则为空)
            } /* substitute_generated_columns */
          },
          {
            "table_dependencies": [  # 表依赖关系分析
              {
                "table": "`student`",
                "row_may_be_null": false,  # 行是否可能为NULL
                "map_bit": 0,
                "depends_on_map_bits": [
                ] /* depends_on_map_bits */
              }
            ] /* table_dependencies */
          },
          {
            "ref_optimizer_key_uses": [  # 等值匹配可用索引(这里没有)
            ] /* ref_optimizer_key_uses */
          },
          {
            "rows_estimation": [  # 行数评估、索引成本计算(核心)
              {
                "table": "`student`",
                "range_analysis": {  # 范围查询分析
                  "table_scan": {  # 全表扫描方案评估
                    "rows": 3966984,  # 全表扫描预估行数
                    "cost": 407358  # 全表扫描成本(极高)
                  } /* table_scan */,
                  "potential_range_indexes": [  # 可用索引列表
                    {
                      "index": "PRIMARY",  # 主键索引
                      "usable": true,  # 索引可用
                      "key_parts": [
                        "id"
                      ] /* key_parts */
                    }
                  ] /* potential_range_indexes */,
                  "setup_range_conditions": [
                  ] /* setup_range_conditions */,
                  "group_index_range": {
                    "chosen": false,
                    "cause": "not_group_by_or_distinct"
                  } /* group_index_range */,
                  "skip_scan_range": {
                    "potential_skip_scan_indexes": [
                      {
                        "index": "PRIMARY",
                        "usable": false,
                        "cause": "query_references_nonkey_column"
                      }
                    ] /* potential_skip_scan_indexes */
                  } /* skip_scan_range */,
                  "analyzing_range_alternatives": {  # 分析各种索引方案
                    "range_scan_alternatives": [
                      {
                        "index": "PRIMARY",
                        "ranges": [
                          "id < 10"
                        ] /* ranges */,
                        "index_dives_for_eq_ranges": true,
                        "rowid_ordered": true,
                        "using_mrr": false,
                        "index_only": false,
                        "rows": 9,  # 索引扫描预估返回9行
                        "cost": 1.87278,  # 索引扫描成本(极低)
                        "chosen": true  # 最终选择该索引
                      }
                    ] /* range_scan_alternatives */,
                    "analyzing_roworder_intersect": {
                      "usable": false,
                      "cause": "too_few_roworder_scans"
                    } /* analyzing_roworder_intersect */
                  } /* analyzing_range_alternatives */,
                  "chosen_range_access_summary": {  # 最终索引选择结果
                    "range_access_plan": {
                      "type": "range_scan",  # 范围扫描
                      "index": "PRIMARY",  # 选择主键索引
                      "rows": 9,
                      "ranges": [
                        "id < 10"
                      ] /* ranges */
                    } /* range_access_plan */,
                    "rows_for_plan": 9,
                    "cost_for_plan": 1.87278,
                    "chosen": true
                  } /* chosen_range_access_summary */
                } /* range_analysis */
              }
            ] /* rows_estimation */
          },
          {
            "considered_execution_plans": [  # 评估最终执行计划
              {
                "plan_prefix": [
                ] /* plan_prefix */,
                "table": "`student`",
                "best_access_path": {  # 最优访问路径
                  "considered_access_paths": [
                    {
                      "rows_to_scan": 9,
                      "access_type": "range",  # 访问类型:range
                      "range_details": {
                        "used_index": "PRIMARY"  # 使用主键索引
                      } /* range_details */,
                      "resulting_rows": 9,
                      "cost": 2.77278,
                      "chosen": true  # 确认为最优
                    }
                  ] /* considered_access_paths */
                } /* best_access_path */,
                "condition_filtering_pct": 100,
                "rows_for_plan": 9,
                "cost_for_plan": 2.77278,
                "chosen": true
              }
            ] /* considered_execution_plans */
          },
          {
            "attaching_conditions_to_tables": {  # 把条件绑定到表上
              "original_condition": "(`student`.`id` < 10)",
              "attached_conditions_computation": [
              ] /* attached_conditions_computation */,
              "attached_conditions_summary": [
                {
                  "table": "`student`",
                  "attached": "(`student`.`id` < 10)"
                }
              ] /* attached_conditions_summary */
            } /* attaching_conditions_to_tables */
          },
          {
            "finalizing_table_conditions": [  # 最终表条件确认
              {
                "table": "`student`",
                "original_table_condition": "(`student`.`id` < 10)",
                "final_table_condition   ": "(`student`.`id` < 10)"
              }
            ] /* finalizing_table_conditions */
          },
          {
            "refine_plan": [  # 执行计划优化
              {
                "table": "`student`"
              }
            ] /* refine_plan */
          }
        ] /* steps */
      } /* join_optimization */
    },
    {
      "join_execution": {  # 第三阶段:SQL执行阶段
        "select#": 1,
        "steps": [
        ] /* steps */
      } /* join_execution */
    }
  ] /* steps */
}
MISSING_BYTES_BEYOND_MAX_MEM_SIZE: 0  # 超出最大内存大小丢失的字节数(0=正常)
          INSUFFICIENT_PRIVILEGES: 0  # 是否权限不足(0=有权限)

1 row in set (0.00 sec)

ERROR:
No query specified

mysql>
9、MySQL监控分析视图-sys schema
关于MySQL的性能监控和问题诊断,我们一般都从performance_schema中去获取想要的数据,在MySQL5.7.7版本中新增sys schema,它将performance_schema和information_schema中的数据以更容易理解的式总结归纳为”视图”,其目的就是为了降低查询performance_schema的复杂度,能够快速的定位问题。下面看看这些库中都有哪些监控表和视图,掌握了这些,在我们开发和运维的过程中就起到了事半功倍的效果。
1、Sys schema视图摘要
主机相关:以host_summary开头,主要汇总了IO延迟的信息。Innodb相关:以innodb开头,汇总了innodb buffer信息和事务等待innodb锁的信息。I/O相关:以io开头,汇总了等待l/O、I/O使用量情况。内存使用情况:以memory开头,从主机、线程、事件等角度展示内存的使用情况连接与会话信息:processlist和session相关视图,总结了会话相关信息。表相关:以schema_table开头的视图,展示了表的统计信息。索引信息:统计了索引的使用情况,包含冗余索引和未使用的索引情况。语句相关:以statement开头,包含执全表扫描、使用临时表、排序等的语句信息。用户相关:以user开头的视图,统计了用户使用的文件l/O、执行语句统计信息。等待事件相关信息:以wait开头,展示等待事件的延迟情况。
2、Sys schema视图使用场景
索引情况
-
查询冗余索引
SELECT * FROM sys.schema_redundant_indexes; -
查询未使用过的索引
SELECT * FROM sys.schema_unused_indexes; -
查询索引的使用情况
SELECT index_name,rows_selected,rows_inserted,rows_updated,rows_deleted
FROM sys.schema_index_statistics WHERE table_schema='[表名]';
表相关
- 查询表的访问量
SELECT table_schema,table_name,SUM(io_read_requests+io_write_requests) AS io FROM sys.schema_table_statistics GROUP BY table_schema,table_name ORDER BY io DESC; - 查询占用bufferpool较多的表
SELECT object_schema,object_name,allocated, DATA FROM sys.innodb_buffer_stats_by_table ORDER BY allocated LIMIT 10; - 查看表的全表扫描情况
SELECT * FROM sys.statements_with_full_table_scans WHERE db ='[表名]';
语句相关
-
监控SQL执行的频率
SELECT db,exec_count, QUERY FROM sys.statement_analysis ORDER BY exec_count DESC; -
监控使用了排序的SQL
SELECT db,exec_count,first_seen, last_seen, QUERY FROM sys.statements_with_sorting LIMIT 1; -
监控使用了临时表或者磁盘临时表的SQL
SELECT db,exec_count,tmp_tables, tmp_disk_tables, QUERY
FROM sys.statement_analysis WHERE tmp_tables>0 OR tmp_disk_tables >0
ORDER BY (tmp_tables+tmp_disk_tables) DESC;
IO相关
- 查看消耗磁盘IO的文件
SELECT FILE,avg_read,avg_write,avg_read+avg_write AS avg_io
FROM sys.io_global_by_file_by_bytes ORDER BY avg_read LIMIT 10;
Innodb相关
- 行锁阻塞情况
SELECT * FROM sys.innodb_lock_waits;
风险提示:
通过sys库去查询时,MySQL会消耗大量资源去收集相关信息,严重的可能会导致业务请求被阻塞,从而引起故障。建议产上不要频繁的去查询sys或者performance_schema、information_schema来完成监控、巡检等工作。

AtomGit 是由开放原子开源基金会联合 CSDN 等生态伙伴共同推出的新一代开源与人工智能协作平台。平台坚持“开放、中立、公益”的理念,把代码托管、模型共享、数据集托管、智能体开发体验和算力服务整合在一起,为开发者提供从开发、训练到部署的一站式体验。
更多推荐



 10
 0
- 0


 已为社区贡献1条内容

所有评论(0)