常用知识点
1、 FPGA(现场可编程门阵列)
→ 优点:可定制化强、功耗可控、适合特定场景加速;
→ 缺点:开发门槛高、通用性差、能效比虽好但不如专用芯片;
2、高主频多核GPU
→ 优点:并行计算能力强,适合训练和高吞吐推理;
→ 缺点:功耗高、体积大、不适合边缘设备(如手机、IoT终端);
3、专用神经网络处理器(NPU)
→ 专为AI推理设计,架构针对矩阵运算、低精度计算优化;
→ 极高能效比(如手机SoC中的NPU、寒武纪、华为达芬奇架构等);
→ 实时性好,延迟低,功耗控制优异,完美匹配“边缘设备 + 实时推理 + 能效比最优”三重需求;
4、高性能通用CPU
→ 优点:通用性强,编程灵活;
→ 缺点:AI推理效率低、功耗高、延迟大;
| 硬件类型 | 特点 | 适合场景 | 能效比 / 实时性 |
|---|---|---|---|
| FPGA | 可编程、可定制,延迟较低 | 特定场景加速、原型验证 | 能效比中等,开发成本高 |
| 高主频多核 GPU | 并行计算能力强 | 云端训练、高性能推理 | 功耗高,不适合边缘低功耗场景 |
| 专用 NPU | 专为神经网络算子(卷积、矩阵乘)设计 | 边缘端 AI 推理(手机、摄像头、IoT) | 能效比最优,延迟低,专门优化 |
| 高性能通用 CPU | 通用性强 | 通用计算、轻量模型 | 算力弱、能效比差,不适合实时推理 |
5、SPI(Serial Peripheral Interface)
结构:主从结构(一个主机,多个从机)
特点:主机固定,由主机发起通信,从机被动响应
6、USB(Universal Serial Bus)
结构:主从结构(主机Host + 从设备Device)
特点:主机角色固定,设备只能作为从机,不可切换为主机(除非是OTG,但标准USB不支持动态切换)
7、 UART(Universal Asynchronous Receiver/Transmitter)
结构:点对点通信,无主从概念,双方对等(虽然常被配置为一发一收)
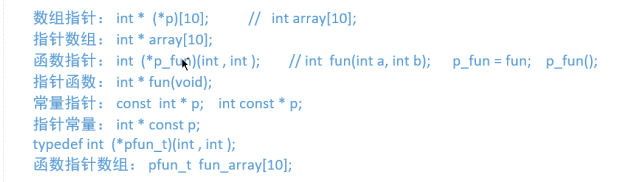
8、各种指针
9、I²C(Inter-Integrated Circuit)
结构:主从结构,支持多主机、多从机
特点:支持多主控(Multi-master),通过仲裁机制实现“主设备动态切换”,当多个主机同时发起通信时,通过SDA线电平竞争决定谁获得总线控制权
| 总线 | 主从结构 | 主设备是否可动态切换 | 说明 |
|---|---|---|---|
| SPI | 主从结构 | ❌ 不可动态切换 | 通信时固定一个主设备(Master),其余为从设备,主设备角色无法在通信中切换。 |
| USB | 主从结构(Host/Device) | ❌ 不可动态切换 | 主机(Host)和设备(Device)角色固定,OTG 模式虽可切换,但不属于 “动态主从切换” 的典型总线设计。 |
| UART | 点对点通信 | ❌ 无主从概念 | UART 是全双工点对点协议,没有 “主设备 / 从设备” 的角色划分,仅为收发关系。 |
| I2C | 主从结构 | ✅ 可动态切换 | 多主机架构支持:任意设备都可申请成为主设备,通过仲裁机制(冲突检测)决定当前主设备,通信中主从角色可动态变更。 |
10、在 RTOS(实时操作系统)中,任务状态转换遵循严格规则
| 状态转换 | 是否可能 | 原因说明 |
|---|---|---|
| 就绪态 → 阻塞态 | ❌ 不可能 | 就绪态的任务尚未获得 CPU 执行权,无法主动执行代码(如调用 delay、sem_wait 等阻塞 API),因此不可能直接进入阻塞态。 |
| 运行态 → 阻塞态 | ✅ 可能 | 运行态任务主动执行阻塞操作(如等待信号量、延时、I/O)时,会放弃 CPU,进入阻塞态。 |
| 阻塞态 → 就绪态 | ✅ 可能 | 阻塞条件满足(如信号量释放、超时到达)时,任务被唤醒,从阻塞态移至就绪态,等待调度。 |
| 运行态 → 就绪态 | ✅ 可能 | 高优先级任务就绪、时间片耗尽或任务主动让出 CPU(如 yield)时,运行态任务会切回就绪态。 |
11、SIMD与SIMT的区别
| 对比维度 | SIMD(单指令多数据) | SIMT(单指令多线程) |
|---|---|---|
| 核心定位 | CPU 端的数据级并行技术 | GPU 端的线程级 + 数据级并行混合技术 |
| 并行载体 | 向量寄存器(如 AVX、NEON),无独立线程 | 线程(束),每个线程有独立 PC / 寄存器,同一 warp 执行同指令 |
| 并行逻辑 | 单指令同时操作多组数据(数据并行) | 单指令驱动多个线程执行,通过切换线程隐藏访存延迟(延迟隐藏) |
| 执行特点 | 数据必须规整,指令执行无分支,依赖 CPU 调度 | 允许线程分支(硬件掩码处理),天然适配非规整计算,依赖 GPU 线程调度 |
| 资源占用 | 占用 CPU 向量单元,资源消耗低 | 占用 GPU 流处理器,线程数极大(千级),资源消耗高 |
| 适用场景 | CPU 上的轻量并行计算(如音视频编解码、矩阵运算) | GPU 上的大规模并行计算(如深度学习、图形渲染、高性能计算) |
12、clang编译器
| 优化技术 | 依赖源码 | 核心特点 |
|---|---|---|
| O3 | 是 | 激进编译期优化,可能增大体积 |
| BOLT | 否 | 二进制后优化,直接处理可执行文件 |
| PGO | 是 | 基于性能数据的编译期优化 |
| ThinLTO | 是 | 链接期跨模块优化 |
13、中断优先级仅在中断嵌套中生效,与系统调用无关
14、Linux 内存分配核心机制
| 操作 | 核心机制 | 关键结论 |
|---|---|---|
| malloc() | 用户态内存池 + 虚拟内存 | 可申请大于物理内存的空间,不直接调用系统调用 |
| mmap() | 惰性加载 + 文件映射 | 不立即加载物理内存,访问时才缺页加载 |
| free() | 归还用户态内存池 | 不立即回收给内核,由分配器管理 |
15、ARMv8-A (AArch64) 架构的寄存器设计与指令集特性
| 特性 / 指令 | 正确描述 | 易错点 |
|---|---|---|
| 系统寄存器 | 分级管理:EL0 无法直接读 EL1 寄存器(如 SCTLR_EL1)。 | 跨等级访问会触发权限错误。 |
| SP 寄存器 | 堆栈指针(SP)是专用寄存器,编码与 X31 相同但逻辑独立。 | SP != X31,不能通用。 |
| NEON 寄存器 | 独立向量寄存器空间,与 GPRs (X0-X30) 物理隔离。 | NEON 不能直接读写通用寄存器。 |
| LDP 指令 | AArch64 的加载配对指令,在连续地址场景下效率极高。 | 比连续执行两次 LDR 快一倍。 |

AtomGit 是由开放原子开源基金会联合 CSDN 等生态伙伴共同推出的新一代开源与人工智能协作平台。平台坚持“开放、中立、公益”的理念,把代码托管、模型共享、数据集托管、智能体开发体验和算力服务整合在一起,为开发者提供从开发、训练到部署的一站式体验。
更多推荐
 31
 0
- 0


 已为社区贡献1条内容

所有评论(0)