ai(四) 分类
4 分类:概率生成模型
分类概念
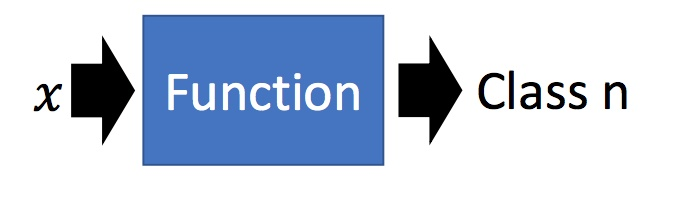
分类:找一个 f u n c t i o n function function 函数,输入对象 x x x 特征, 输出是该对象在 n n n 个类别中对应的类别。
回归模型vs概率模型
回归模型
如果把分类当作回归硬解:
1.二分类
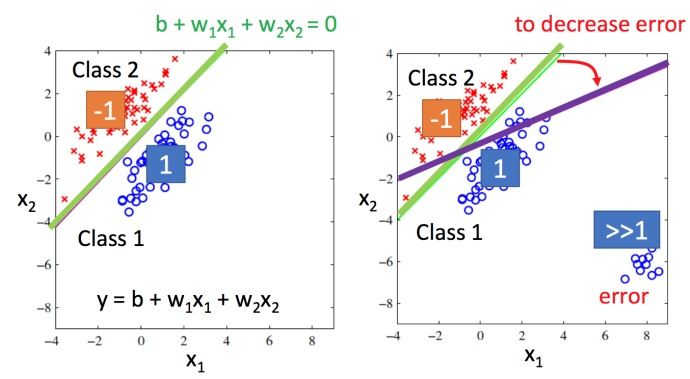
举一个二分类的例子:输入神奇宝贝的特征
x
x
x,判断属于类别1或者类别2。
用回归处理:
- 类别1 → \rightarrow → y y y预测值为1
- 类别2
→
\rightarrow
→
y
y
y 预测值为-1
训练模型:接近1的当作类别1,接近-1的当作类别2.
这样处理二分类出现的问题: - 当数据比较集中时候,如左图,模型准确度较高。
- 如果数据比较分散,如右图,绿色线是理想的 b + w 1 x 1 + w 2 x 2 = 0 b+w_1x_1+w_2x_2=0 b+w1x1+w2x2=0 的位置,但是由于回归模型的判断模型好坏的机制会导致模型训练的时候,为了减少error而将函数进行偏移(如图中紫色的线)
2.多分类问题
如果用回归问题解决多分类问题会导致不同类别间存在某种关系,但实际这个关系是不存在的。
所以分类问题不能通过回归解决。
理想模型
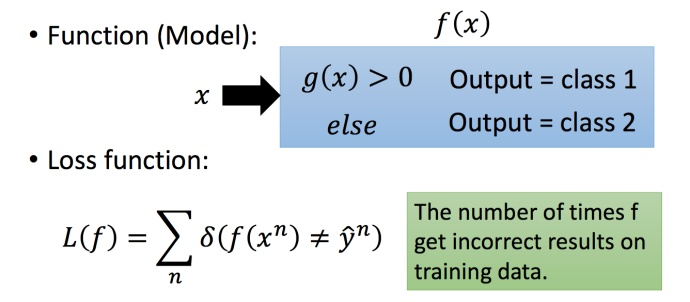
二分类问题为例:
模型定义:
f
(
g
(
x
)
)
f(g(x))
f(g(x))
损失函数定义:在训练集上面测试错误的次数。
优化模型的方法:SVM,Perceptron(感知机),后面介绍。
概率生成模型(generative model)
简称生成模型。
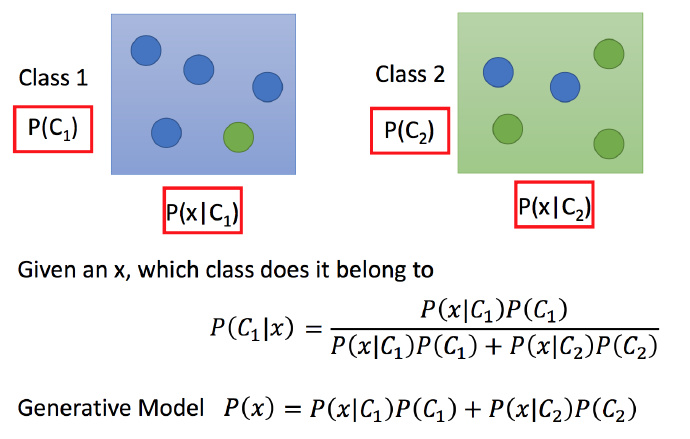
-
先验概率:
- P ( C 1 ) P(C_1) P(C1): 所有类别中选到 C 1 C_1 C1类别的概率
- P ( C 2 ) : P(C_2): P(C2): 所有类别中选到 C 2 C_2 C2类别的概率
-
条件概率:
- P ( x ∣ C 1 ) P(x|C_1) P(x∣C1) :抽到类别 C 1 C_1 C1中的 x x x的概率
- P ( x ∣ C 2 ) P(x|C_2) P(x∣C2) :抽到类别 C 2 C_2 C2中的 x x x的概率
-
后验概率:
- P ( C 1 ∣ x ) P(C_1|x) P(C1∣x):抽到 x x x是属于 C 1 C_1 C1类别的概率
-
P
(
C
2
∣
x
)
P(C_2|x)
P(C2∣x):抽到
x
x
x是属于
C
2
C_2
C2类别的概率
生成模型:(以二分类为例)知道 P ( C 1 ) 、 P ( C 2 ) 、 P ( x ∣ C 1 ) 、 P ( x ∣ C 2 ) P(C_1)、P(C_2)、P(x|C_1)、P(x|C_2) P(C1)、P(C2)、P(x∣C1)、P(x∣C2) 【红色方框中的值】的值,就可以计算 P ( C 1 ∣ x ) 、 P ( C 2 ∣ x ) P(C_1|x)、P(C_2|x) P(C1∣x)、P(C2∣x)。那个数值大就属于哪个分类。根据训练数据集来估计红色方框中的值。
-
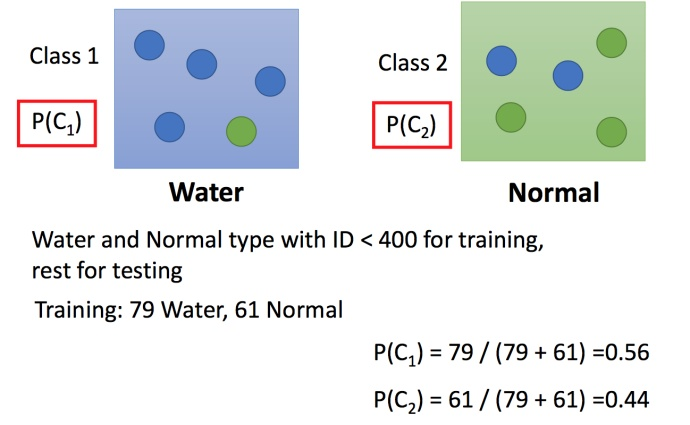
P ( C 1 ) 、 P ( C 2 ) P(C_1)、P(C_2) P(C1)、P(C2): 直接通过训练数据集计算
-
P ( x ∣ C 1 ) P(x|C_1) P(x∣C1) 、 P ( x ∣ C 2 ) P(x|C_2) P(x∣C2) :利用已有训练数据,估测出期望 μ \mu μ、 ∑ \sum ∑ ,根据高斯分布计算
高斯分布:
高斯分布:相当于函数
f
u
n
c
t
i
o
n
function
function 输入是向量
x
x
x 输出是选中
x
x
x 的概率。(并不完全等价于概率,只是和概率成正比)
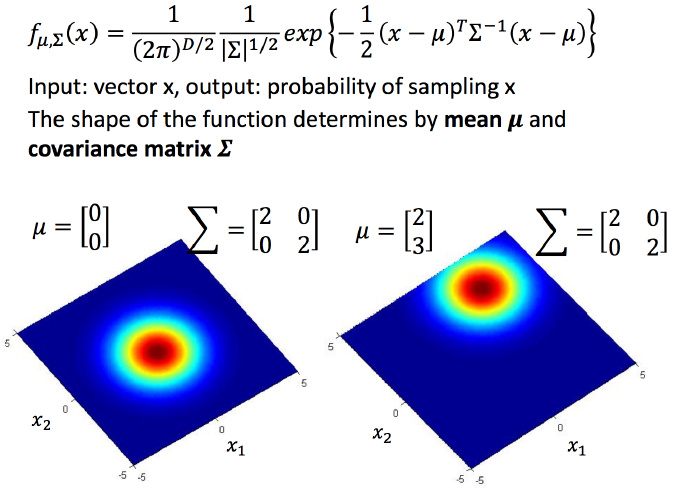
- 参数:
- μ \mu μ :期望 → \rightarrow → 决定概率分布的最高点
-
∑
\sum
∑ :协方差矩阵
→
\rightarrow
→ 决定概率分布的离散程度
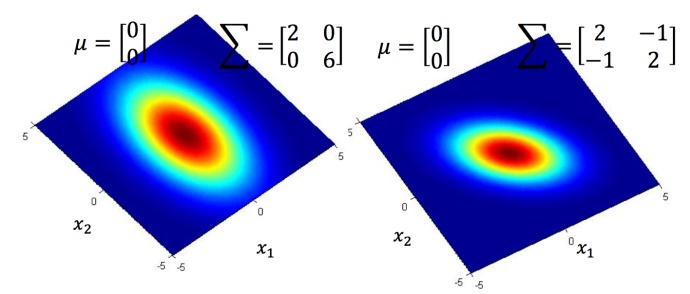
测试集的点会在任意期望和协方差构成的高斯分布中,不同处是在不同的高斯分布图中测试集的点的概率大小不同。这时使用到似然函数(Likelihood function)(根据已有数据进行参数估计)
机器学习 - 似然函数:概念、应用与代码实例-腾讯云开发者社区-腾讯云
似然函数:用于量化在给定某参数时,观察到某样本数据的”可能性“,数学定义:
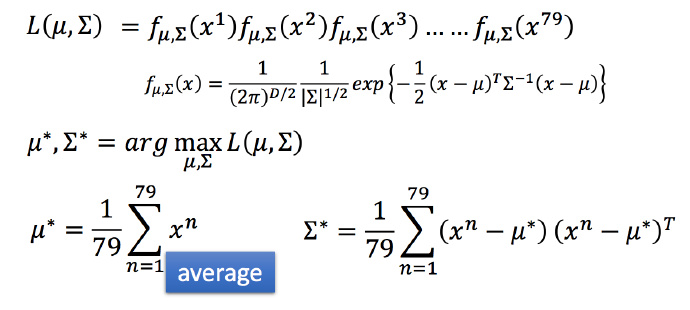
最大似然估计(Maximum Likelihood Estimation,MLE):最大化似然函数找到最“适合”参数。
举例:给定参数
μ
\mu
μ 、
∑
\sum
∑ 后,通过
L
(
μ
,
∑
)
L(\mu,\sum)
L(μ,∑) 计算训练集中所有数据出现的概率.这里
L
(
μ
,
∑
)
L(\mu,\sum)
L(μ,∑)就是似然函数。使
L
(
μ
,
∑
)
L(\mu,\sum)
L(μ,∑)最大的
L
(
μ
,
∑
)
L(\mu,\sum)
L(μ,∑)记做
L
(
μ
∗
,
∑
∗
)
L(\mu^*,\sum^*)
L(μ∗,∑∗) ,也就是最大似然估计。
(具体计算“最适合”参数的方法没了解)
![[attachment/Pasted image 20260322175301.png]]
生成模型应用
神奇宝贝属性预测
- 输入:一只神奇宝贝的特征(整体强度,生命值,攻击力,防御力,特殊攻击力,特殊防御力,速度等)
- 输出:属于水属性或者是一般属性
假设:训练数据集(79只水属性,61只一般属性)
计算模型参数:四个概率
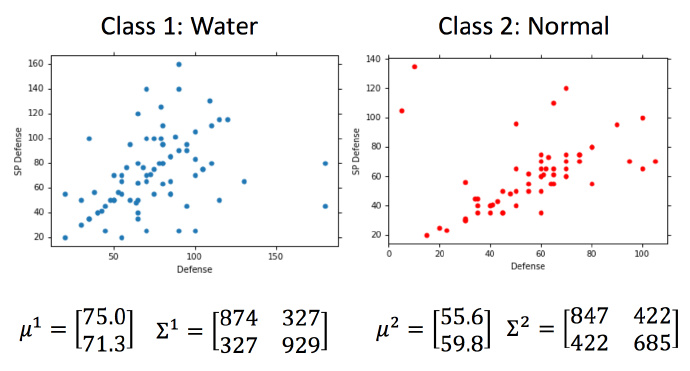
根据参数计算需要的数值:
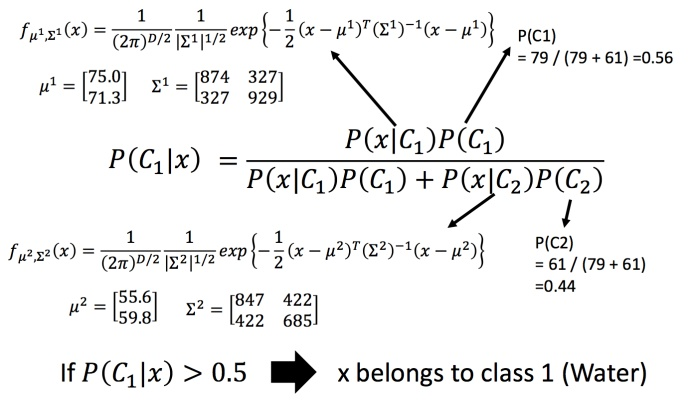
得到模型结果:
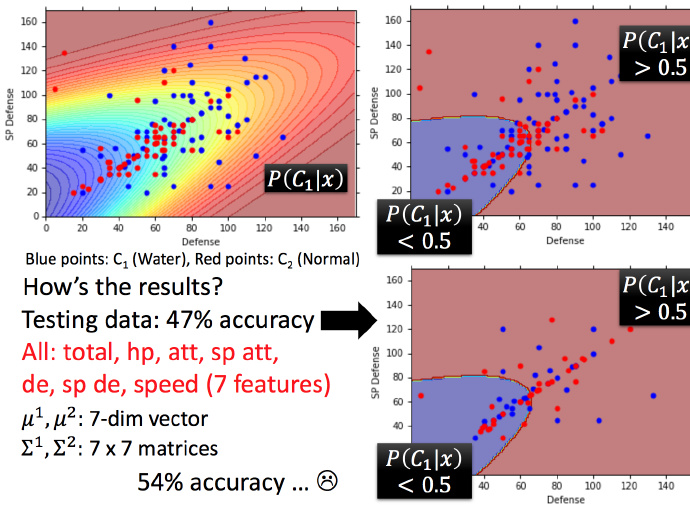
左上角的图中: 蓝色 → \rightarrow → 水属性 红色 → \rightarrow → 一般属性 ,越红的地方说明是水属性的可能越高。
右上角是在训练集上的结果。 - 红色部分: P ( C 1 ∣ x ) P(C_1|x) P(C1∣x) >0.5 ,属于类别1 → \rightarrow → 水属性
- 蓝色部分
→
\rightarrow
→ 一般属性
右下角是在测试集上的结果,准确度:47%
47%的准确率是只处理二维(两个属性)的情况,如果加入更多的特征,比如处理7维,在测试集上的准确度也只能达到54%.
模型优化:
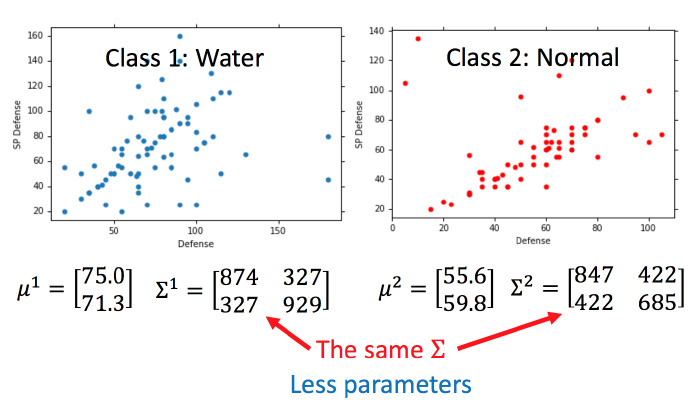
一般不会为每个高斯分布计算不同的协方差矩阵。协方差矩阵中参数的多少和特征
x
x
x成正比。比如:3个特征
x
x
x,对应协方差矩阵中参数个数为9个。如果模型参数过多容易过拟合,所以为两个不同类别的高斯分布相同的协方差矩阵。
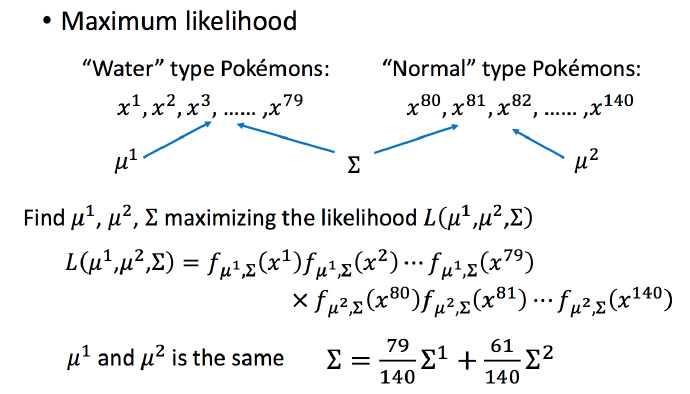
μ
1
\mu_1
μ1和
μ
2
\mu_2
μ2的计算方法不变,还是直接将特征相加求平均。
∑
\sum
∑ 计算不同(没了解具体怎么算)。
经过上面的简化获得新的模型,在测试集上面的测试结果(7维,54%
→
\rightarrow
→ 73%):
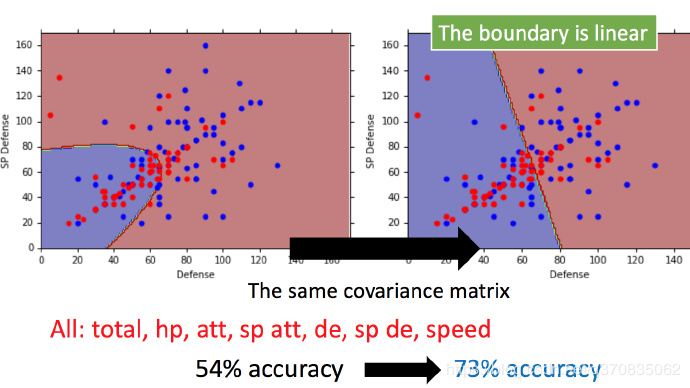
新分类的边界是线性 → \rightarrow → 这种分类叫做线性模型。
概率模型-建模三部曲
简化为前面的三大步:实际找到可以产生较为准确的输入特征对应分类的概率的函数。
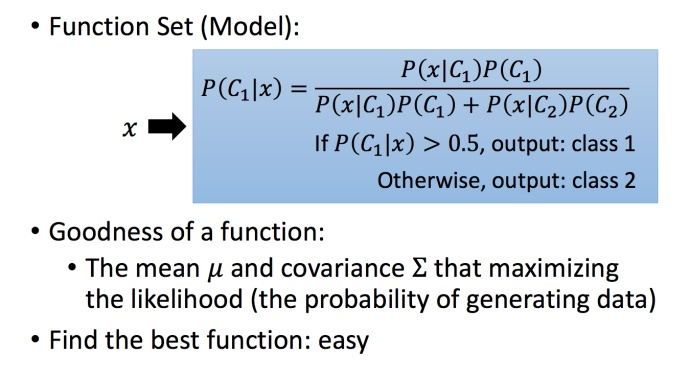
为什么是通过高斯分布作为几率模型?(各个特征间存在一定的联系)
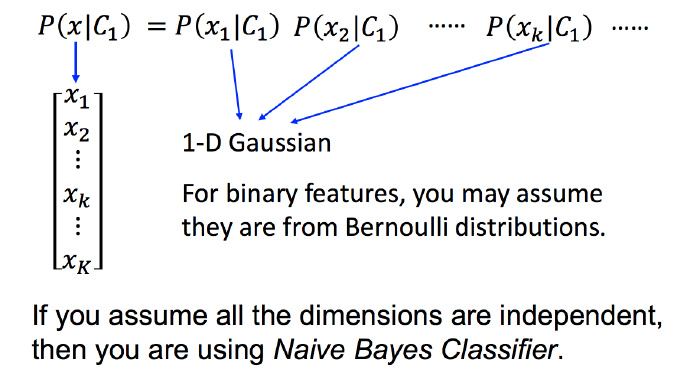
如果每个维度用概率分布模型产生产生出来的几率是相互独立的,可以将
P
(
x
∣
C
1
)
P(x|C_1)
P(x∣C1) 进行上面的拆分,会使协方差矩阵除去对角线都是0,减少参数量,但是这种行为不可取。一般不同维度间会有一定的关联。
- 二元分类:通常不会用高斯分布,可以假设是符合 Bernoulli distribution(伯努利分布)
- 假设所有的feature都是相互独立产生的,这种分类叫做 Naive Bayes Classifier(朴素贝叶斯分类器)
对后验概率进行处理:
exp 是 指数函数 (Exponential function) 的缩写:
exp
(
−
z
)
\exp(-z)
exp(−z) 时,它等同于:
e
−
z
或者
1
e
z
e^{-z} \quad \text{或者} \quad \frac{1}{e^z}
e−z或者ez1
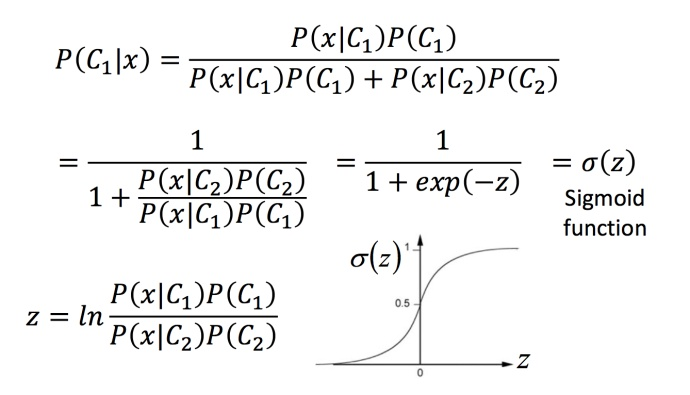
对z进行处理:(推导过程,记下最后结论好了)
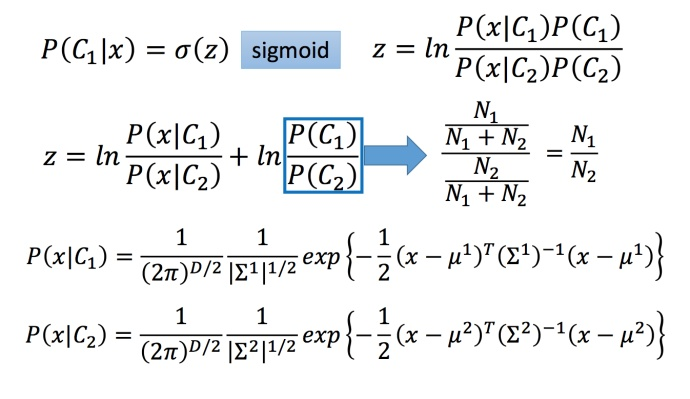
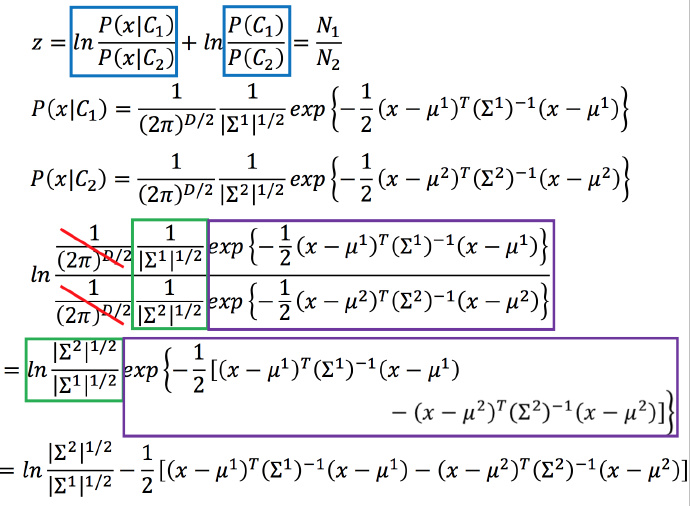
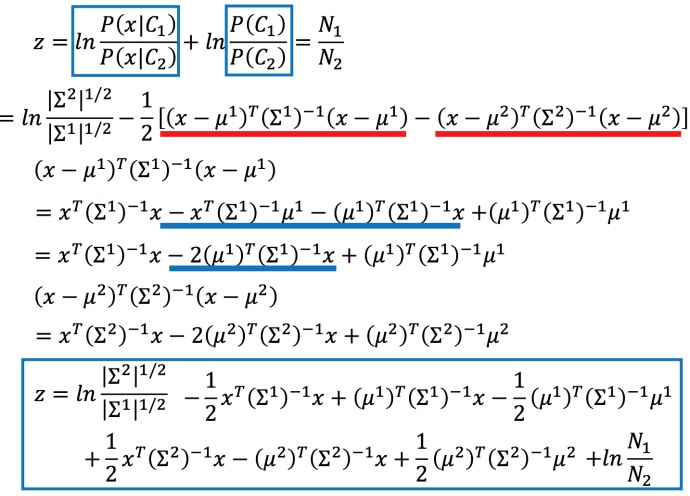
一般协方差矩阵是共用的,所以根据条件
∑
1
=
∑
2
=
∑
\sum^1=\sum^2=\sum
∑1=∑2=∑继续对
z
z
z进行化简:
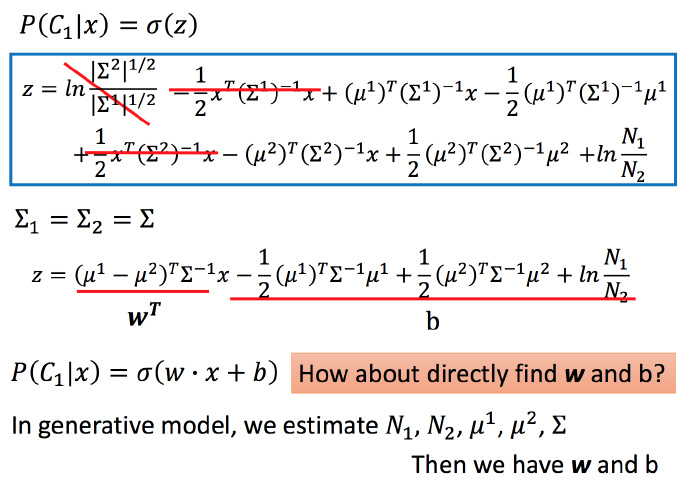
-
w
T
=
(
μ
1
−
μ
2
)
T
∑
−
1
w^T=(\mu^1-\mu^2)^T\sum^{-1}
wT=(μ1−μ2)T∑−1 ,后面3项都是标量作为
b
b
b
得到最终化简结果: P ( C 1 ∣ x ) = σ ( w ⋅ x + b ) P(C1|x)=σ(w⋅x+b) P(C1∣x)=σ(w⋅x+b)
结论:知道 N 1 . N 2 , μ 1 , μ 2 , ∑ N_1.N_2,\mu^1,\mu^2,\sum N1.N2,μ1,μ2,∑ 就能够计算出 w , b w,b w,b .
如果是作为线性模型处理为什么要先计算一大堆的概率后再得出 w , b w,b w,b,后面介绍其他方法。

AtomGit 是由开放原子开源基金会联合 CSDN 等生态伙伴共同推出的新一代开源与人工智能协作平台。平台坚持“开放、中立、公益”的理念,把代码托管、模型共享、数据集托管、智能体开发体验和算力服务整合在一起,为开发者提供从开发、训练到部署的一站式体验。
更多推荐



 7
 0
- 0


 已为社区贡献6条内容

所有评论(0)