Tokenization分词
一、简介
Tokenizer(分词器)是将自然语言文本映射为数字表示(tokens/IDs) 的工具,核心完成 3 件事:
- 🔴 分词(Tokenization):将文本拆分为最小语义单元(token,如单词、子词、字符);
- 🔴 编码(Encoding):将每个 token 映射为唯一的整数 ID;
- 🔴 解码(Decoding):将整数 ID 还原为文本(逆向操作)。
展示分词可视化结果的网站https://tiktokenizer.vercel.app/
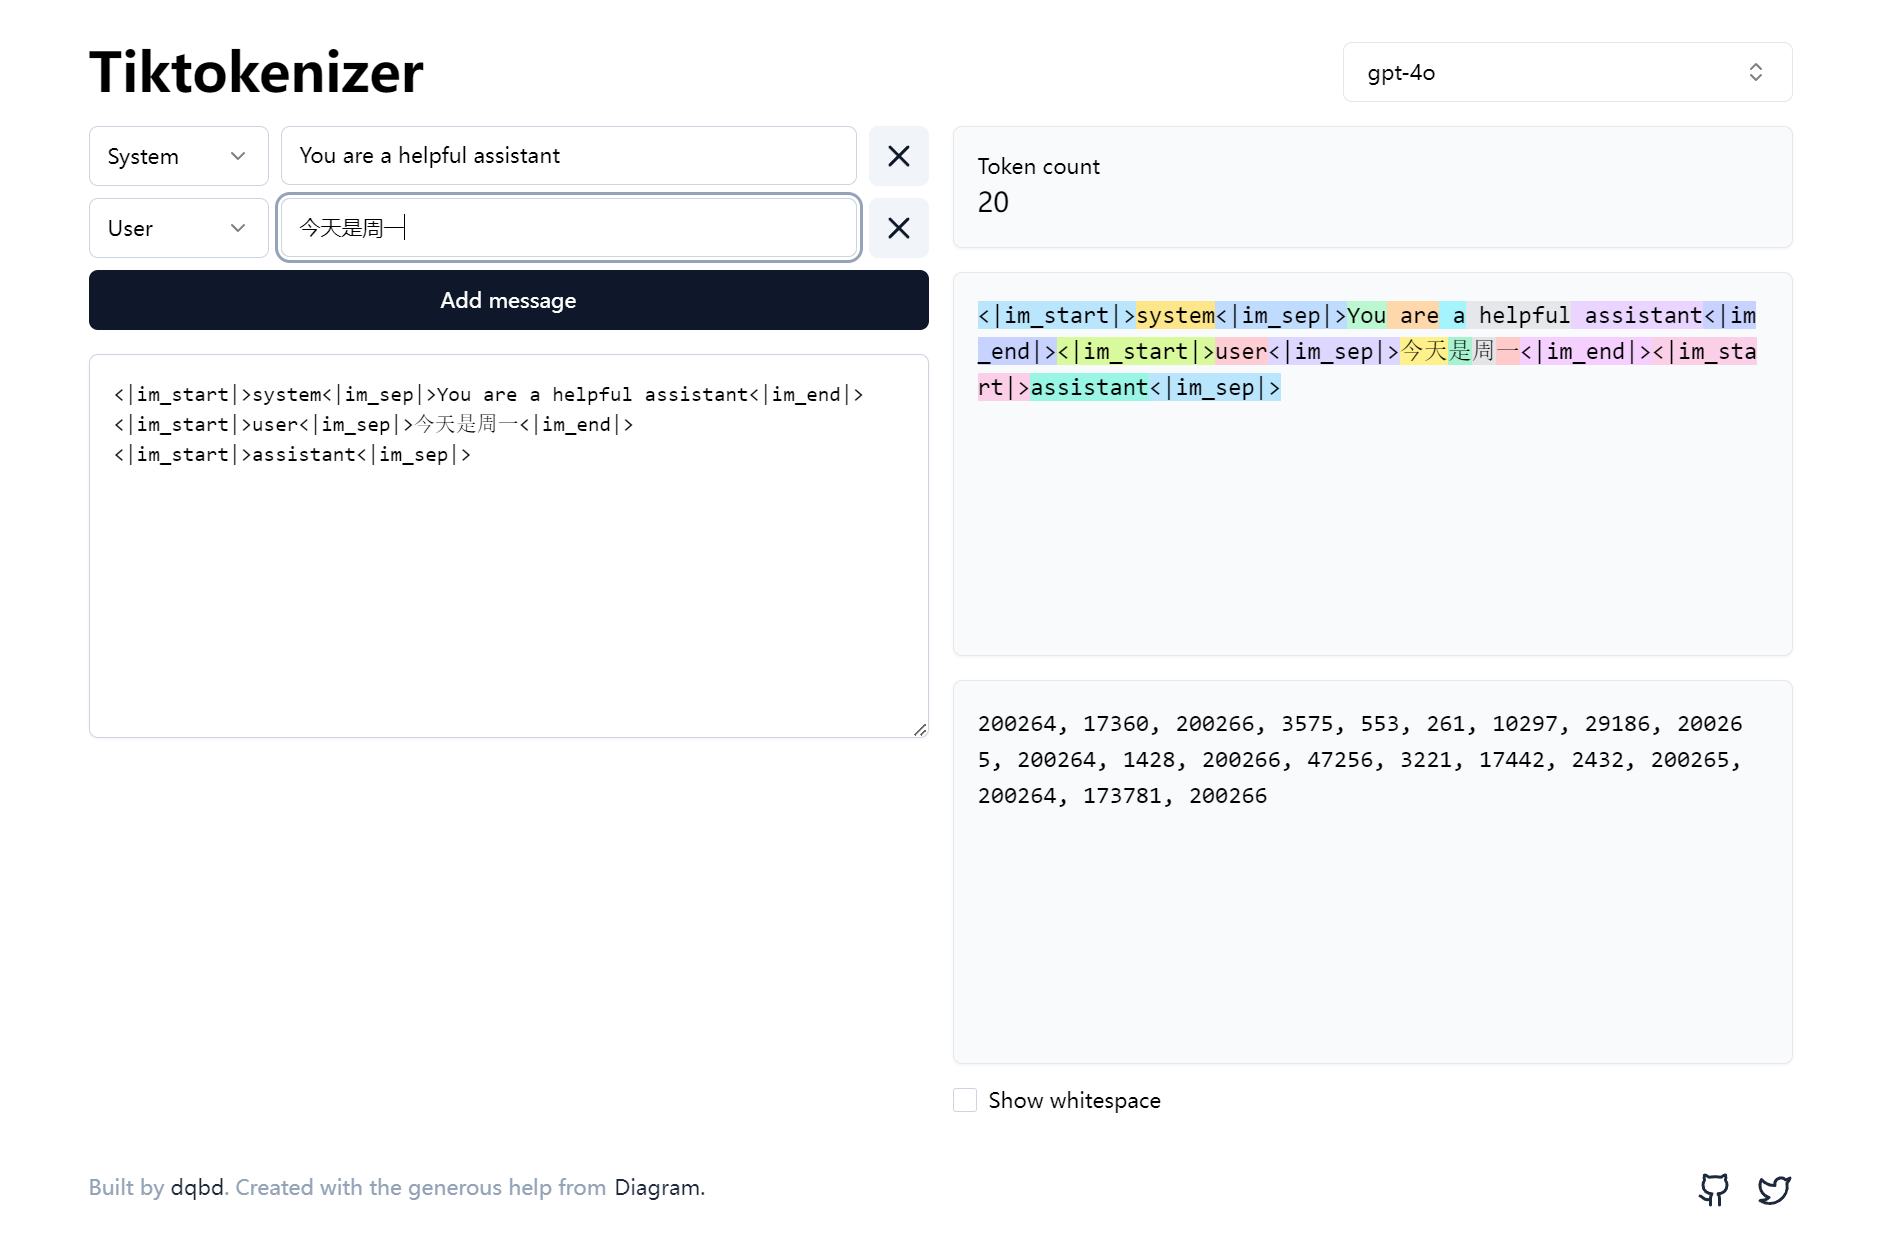
分词粒度: 不同模型采用不同的分词粒度,直接影响模型效果和效率:
| 分词粒度 | 定义 | 示例(文本:"Hello, world!") | 适用模型 | 重点特点 |
|---|---|---|---|---|
| 字符级(Character) | 按单个字符拆分 | ["H", "e", "l", "l", "o", ",", " ", "w", "o", "r", "l", "d", "!"] | 小模型、低资源语言 | 粒度最细,词汇表小,但语义信息少 |
| 单词级(Word) | 按空格 / 标点拆分单词 | ["Hello", ",", "world", "!"] | 基础 NLP 任务(如文本分类) | 语义清晰,但词汇表大(生僻词易 OOV) |
| 子词级(Subword) | 拆分为常用子词(如 BPE) | ["Hello", ",", "world", "!"](GPT)/ ["He", "ll", "o", ",", "world", "!"](BERT) | 大模型(BERT/LLaMA/GPT) | 平衡词汇表大小和OOV 率,工业级首选 |
术语解释
| 术语 | 定义 | 重点说明 |
|---|---|---|
| Vocabulary(词汇表) | token 与 ID 的映射字典(如 {"[PAD]":0, "hello":123}) | 每个分词器有专属词汇表,模型训练 / 推理必须用同一套 |
| OOV(Out of Vocabulary) | 未出现在词汇表中的 token | 子词分词可大幅降低 OOV 率,单词级分词 OOV 率高 |
| Special Tokens(特殊 token) | 模型定义的特殊标识,如: - - - - - | 不同模型的特殊 token 不同,编码时必须正确添加 |
| Max Length(最大长度) | 分词器允许的最大 token 数 | 超过则截断,不足则填充,需匹配模型输入限制(如 BERT 最大 512) |
| Truncation(截断) | 超过最大长度时,截断文本(从左 / 右 / 中间) | 需指定截断策略(如 truncation="longest_first") |
| Padding(填充) | 不足最大长度时,用[PAD]填充 | 需指定填充方向(如 padding="max_length") |
三种主流的subword分词方法:BPE、WordPiece 和 Unigram Language Model
- BPE:从字符级开始,迭代合并高频子词
- WordPiece:从单词级开始,拆分低频词为子词
- Unigram Language Model:基于概率选择最优子词集合
二、Hugging Face Tokenizers 库( 重点)
1. 核心优势
- 高性能:Rust 底层实现,批量处理速度比纯 Python 快 10-100 倍;
- 全覆盖:支持所有主流分词算法(BPE/WordPiece/Unigram);
- 易扩展:可自定义词汇表、特殊 token;
- 无缝衔接:与 transformers 库深度集成,支持所有预训练模型。
2. 核心使用流程实例
步骤 1:加载预训练分词器(最常用) ,可从huggingface自动下载加载模型,也可事先下载至本地加载本地模型
从huggingface加载保存默认位置
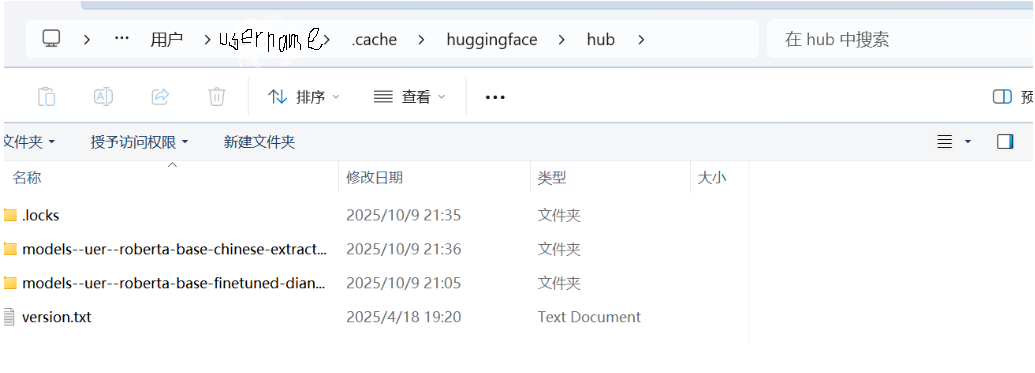
模型加载
# 从HuggingFace加载模型
tokenizer = AutoTokenizer.from_pretrained("bert-base-cased")
tokenizer.save_pretrained("./bert-base-cased")
#从本地加载模型
tokenizer = AutoTokenizer.from_pretrained("./bert-base-cased")
步骤 2:编码文本(核心操作)
from transformers import AutoTokenizer

text = "I'm a happy man"

# 🔴 基础编码:返回token IDs
input_ids = tokenizer.encode(text,add_special_tokens=True)
print(input_ids)


# 🔴 详细编码:返回所有信息(推荐)
# tokenizer()包含分词 转换为ID 添加特殊token([CLS]、[SEP])填充/截断 生成attention_mask和
#                                                                    token_type_ids

inputs = tokenizer(
    text,
    max_length=21,
    padding='max_length',
    truncation=True,
    return_offsets_mapping=True
)

print(inputs)

# {
#     'input_ids': [101, 1045, 1005, 1049, 1037, 3407, 1050, 102, 0, 0, ...],
#     'token_type_ids': [0, 0, 0, 0, 0, 0, 0, 0, 0, 0, ...],
#     'attention_mask': [1, 1, 1, 1, 1, 1, 1, 1, 0, 0, ...],
#     'offset_mapping': [(0,0), (0,1), (1,3), (4,5), (7,12), (13,16), (0,0), (0,0), ...]
# }
关键输入:
input_ids- 文本的数字化表示- 将文本分词后转换为对应的 ID 序列
- 每个数字代表词表中的一个 token
- 例如:"I'm a happy man" → [101, 1045, 1005, 1049, 1037, 3407, 1050, 102]
- 101 = [CLS](特殊开始符)
- 1045 = I
- 1005 = '
- 102 = [SEP](特殊结束符)
- token_type_ids - 句子分类标记
- 用于区分不同的句子
- 单句话:全为 0
- 两句话(如问答):第一句为 0,第二句为 1
- 例如:[0, 0, 0, 0, 0, 0, 0, 0](所有 token 都属于同一句)
- attention_mask - 注意力掩码
- 标记哪些 token 是真实内容,哪些是填充(padding)
- 1 = 真实 token,0 = 填充 token
- 例如:[1, 1, 1, 1, 1, 1, 1, 1, 0, 0, ..., 0](前 8 个是真实,后面是填充)
- 作用:告诉模型在计算注意力时忽略填充部分
- offset_mapping - 位置映射
- 记录每个 token 在原始文本中的起始和结束位置
- 格式:[(start, end), ...]
步骤 3:解码(逆向操作)
# 索引转回文本(自动忽略特殊token)
text = tokenizer.decode(input_ids)
print(text)
其他操作:
句子分词tokenize:将文本拆分为模型可识别的最小单位(token)
# 基础分词(返回token列表)
tokens = tokenizer.tokenize("Hello, I love Transformer!")
print(tokens)  # 输出:['Hello', ',', 'I', 'love', 'Trans', '##former', '!']

# 批量分词
batch_tokens = tokenizer.tokenize(["Sentence 1", "Sentence 2"])
查看词典vocab
# 查看词典大小
print(f"词典大小:{tokenizer.vocab_size}")  # bert-base-cased 词典大小约30522

# 查看指定token的索引
print(tokenizer.vocab["Hello"])  # 输出对应数字索引
print(tokenizer.vocab["[CLS]"])  # 特殊token(BERT的句子起始符)

# 遍历词典(前5个)
for idx, (token, index) in enumerate(tokenizer.vocab.items()):
    if idx < 5:
        print(f"Token: {token}, Index: {index}")
索引转换
#编码:token → 数字索引(模型输入)
input_ids = tokenizer.convert_tokens_to_ids(tokens)
# 转换为token
tokens = tokenizer.convert_ids_to_tokens(input_ids)
填充(padding)截断 (truncation): Transformer 模型要求输入长度固定,对短文本填充(padding)、长文本截断(truncation)
from transformers import AutoTokenizer
text = "I'm a happy man"

# 从本地加载模型
tokenizer = AutoTokenizer.from_pretrained("./bert-base-cased")

#tokenizer()包含分词 转换为 ID 添加特殊token([CLS]、[SEP])填充/截断 生成attention_mask和
#token_type_ids

inputs = tokenizer(
    text,
    max_length=21,
    padding='max_length',
    truncation=True,
    return_offsets_mapping=True
)

print(inputs)

# {
#     'input_ids': [101, 1045, 1005, 1049, 1037, 3407, 1050, 102, 0, 0, ...],
#     'token_type_ids': [0, 0, 0, 0, 0, 0, 0, 0, 0, 0, ...],
#     'attention_mask': [1, 1, 1, 1, 1, 1, 1, 1, 0, 0, ...],
#     'offset_mapping': [(0,0), (0,1), (1,3), (4,5), (7,12), (13,16), (0,0), (0,0), ...]
# }
完整实例
"""
功能:LLM 输入预处理完整流程(以LLaMA-2为例)
"""
from transformers import AutoTokenizer

# 1. 加载预训练分词器(LLaMA-2)
tokenizer = AutoTokenizer.from_pretrained("meta-llama/Llama-2-7b-chat-hf")
# LLaMA无默认PAD token,需手动设置
tokenizer.pad_token = tokenizer.eos_token  # 用eos_token替代pad_token

# 2. 定义提示词模板(LLaMA-2对话模板)
def build_prompt(user_query):
    return f"<s>[INST] {user_query} [/INST] "

# 3. 批量处理用户输入
user_queries = [
    "介绍一下人工智能",
    "如何学习Python编程?",
    "大语言模型的核心原理是什么?"
]
prompts = [build_prompt(q) for q in user_queries]

# 4. 编码(适配LLaMA-2输入)
encoded = tokenizer(
    prompts,
    truncation=True,
    padding=True,
    max_length=128,
    return_tensors="pt",
    return_attention_mask=True
)

# 5. 输出核心信息
print("Input IDs形状:", encoded["input_ids"].shape)  # (3, 128)
print("Attention Mask形状:", encoded["attention_mask"].shape)  # (3, 128)

# 6. 解码验证
for i in range(len(prompts)):
    decoded = tokenizer.decode(encoded["input_ids"][i], skip_special_tokens=False)
    print(f"\n解码后提示词{i+1}:", decoded)
AtomGit 是由开放原子开源基金会联合 CSDN 等生态伙伴共同推出的新一代开源与人工智能协作平台。平台坚持“开放、中立、公益”的理念,把代码托管、模型共享、数据集托管、智能体开发体验和算力服务整合在一起,为开发者提供从开发、训练到部署的一站式体验。
更多推荐
 13
 0
- 0


 已为社区贡献2条内容

所有评论(0)